9月9日,路透社放出一条消息:DeepSeek已经邀请中信证券,为登陆科创板做准备。公司没有官宣,上市时间、募资金额和估值也都没有确定,但钱已经先动了起来。有媒体写到,市场上出现了层层包装DeepSeek融资份额的特殊目的载体,越靠外层,投资人付出的中间费用越高;还有人据称拿着数百万元的"见面费"守在杭州,最后连梁文锋本人都没见到。这些细节没有得到DeepSeek确认,未必每一笔都能坐实,却把资本的焦虑写得很明白:大家担心的已经不是DeepSeek值不值得投,而是自己还能不能挤进去。
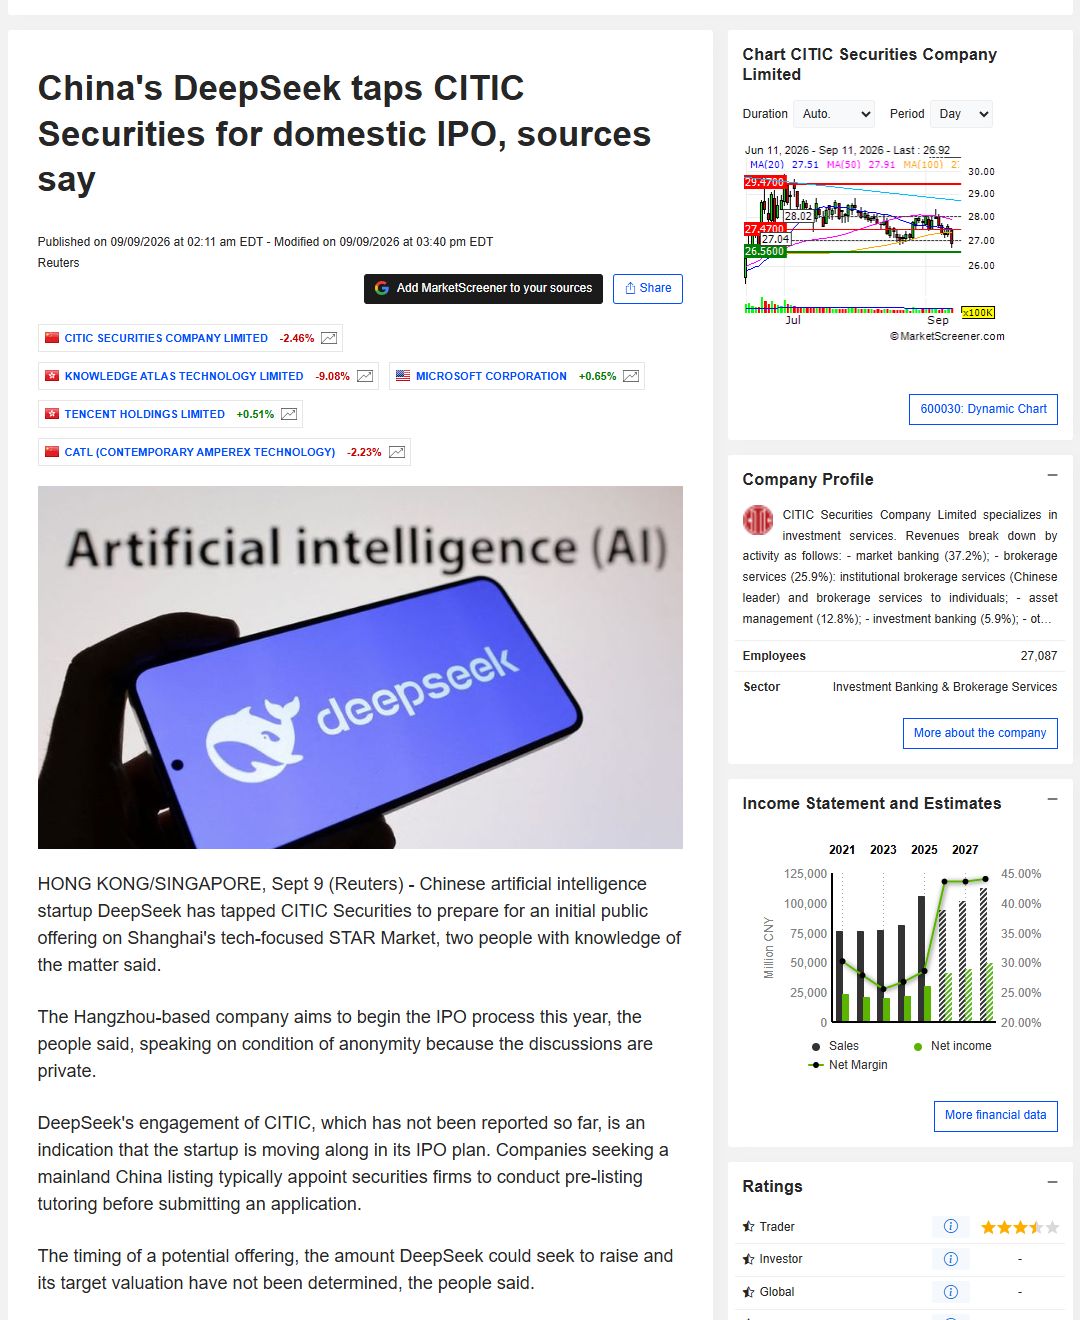
图:路透社称DeepSeek已邀请中信证券筹备科创板IPO;上市时间、募资额与估值尚未确定。
这件事真正有意思的地方,不是有人愿意出多少钱,而是钱奔跑的方向变了。两三年前,梁文锋带着"只做基础模型"的想法去接触投资人,得到的回答并不热烈。风险投资机构要退出,要看产品,要知道收入什么时候出现;梁文锋却要把钱投进一项可能几年没有结果、失败以后连残次品都卖不出去的研究里。到了今天,投资人开始隔着几层载体寻找DeepSeek的份额,梁文锋反而坐到了桌子的另一端,据媒体报道,他还会亲自审核部分最终投资人。一个曾经很难向资本解释的选择,忽然成了资本最想购买的东西。
梁文锋最早想买的,是一群人的试错机会
2024年7月,DeepSeek V2发布不久,《暗涌》记者把梁文锋按在一连串商业问题面前:一家量化基金为什么要做大模型?研究经费从哪里来?没有两三亿美元,连牌桌都上不了,怎么持续投入?不做应用,又靠什么赚钱?
这不是记者故意刁难。任何一个正常投资人坐在桌子对面,都会问同样的问题。做基础模型要买卡、招人、训练,一轮结果不好,前面花掉的钱不会变成库存,更不能打折清仓;而做应用至少能找到客户、签下合同,把明年的故事先换成今年的回款。
梁文锋给出的回答,很不像一个正在融资的创业者。他承认,按照优先做研究的思路,很难从有退出要求的风险投资机构那里拿钱;他甚至直说,如果一定要为基础研究找一个商业理由,可能根本找不到,因为投入回报比太低。但他紧接着又说,DeepSeek有算力,也有一支工程师团队,相当于已经拿到了一半筹码。另一半筹码,是时间,以及怎样允许一群人使用时间。
梁文锋后来回忆,他们对算力的准备不是某一天拍桌子决定的。最早是一张卡,2015年变成100张,2019年变成1000张,到了2021年又变成一万张。外界总想从这一串数字里找到某个精密的商业计划,他却说,主要是因为一群人想知道AI的能力边界究竟在哪里;卡就像买回家的钢琴,前提不只是买得起,还要有人急着在上面弹东西。
真正进入DeepSeek以后,这种说法变成了具体的工作方式。做出V2的团队里,有应届毕业生,有还没毕业的博士生,也有毕业没几年的年轻人;MLA的想法最早来自一名年轻研究员的个人兴趣,团队围着它跑了几个月,才把想法变成能工作的东西。有人发现一个方向,不需要先写一份层层审批的资源申请,可以直接调用训练集群,也可以拉上感兴趣的人一起试。
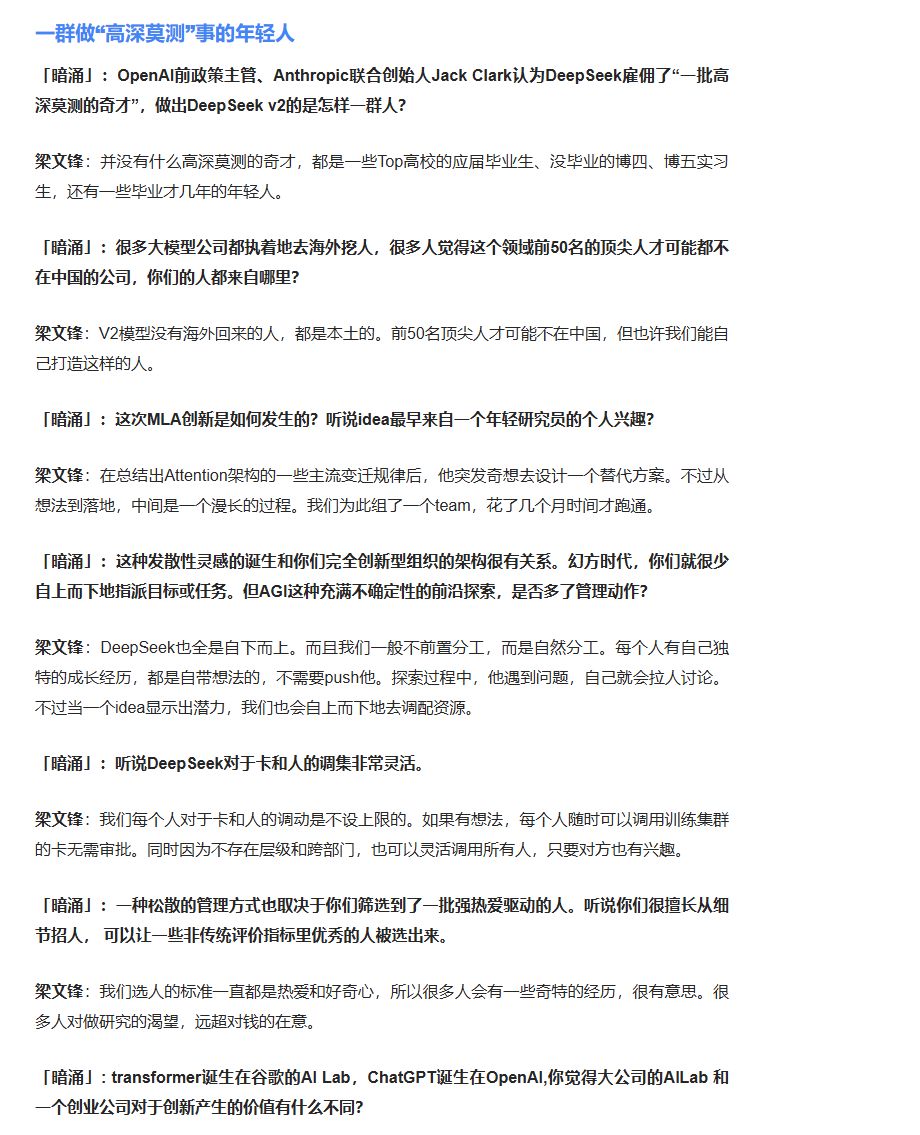
图:梁文锋在访谈中谈到,V2团队以本土年轻研究者为主,MLA从个人兴趣走到落地用了数月。
这套组织方式听上去浪漫,执行起来却很贵。年轻人会走弯路,训练会失败,许多尝试最后什么都留不下。梁文锋自己也没有粉饰这一点,他说"创新就是昂贵且低效的",有时还伴随着浪费。
但他还是选择了这种浪费,因为模型能力不是销售部门按季度拆出来的任务。一个真正有效的新方法,常常先是某个人不肯放下的念头,然后是一群人花几个月验证,最后才在训练结果里露出来。管理可以要求每张卡都有产出,却不能提前命令一个突破在月底发生。所以,梁文锋当年拒绝的不是赚钱,而是另一种更隐蔽的东西:不愿意为了更快出现收入,把这群人的时间提前切成产品排期、客户需求和销售指标。
他把应用让给别人,也把自己逼进了一条窄路
记者继续追问:DeepSeek为什么不亲自做应用,是不是没有运营基因?梁文锋说,当前是技术创新的爆发期,不是应用的爆发期;DeepSeek负责基础模型和前沿创新,其他公司可以在上面建设面向企业和消费者的产品。这句话后来经常被当成技术理想主义。可站在一家公司的账本前,它的意思非常现实:DeepSeek把最靠近客户的那部分收入,主动让了出去。
模型开放以后,云厂商可以把它部署在自己的机房里卖算力,软件公司可以把它装进客服、知识库和合同审查,服务商可以收实施费和运维费。客户嘴里说"我们正在使用DeepSeek",账单却可能由另一家公司开出。DeepSeek得到了用户、声量和兼容它的产品,却不天然拥有每一次调用产生的收入。
一家正常公司看到这种局面,通常会立即往下游走。先做一个应用,再搭一个销售团队,然后用客户和合同把流量围起来。梁文锋没有这样做,因为一支应用团队一旦开始运转,就不会只消耗工资:销售会带回客户承诺,产品要给承诺排期,实施要去现场连接系统,客服要处理每一次故障,昨天签下的合同会决定明天谁必须去做什么。这些工作都能产生收入,也都会抢走模型研究最需要的东西------不被眼前结果支配的时间。
梁文锋因此把DeepSeek逼进了一条很窄的路。它不能像普通软件公司那样,模型差一点也靠合同、流程和服务把客户留住;它必须不断做出足够强的模型,让别人即使拿走了应用收入,也舍不得换掉下面那层能力。只要能力停下来,开放带来的生态不会成为忠诚,反而会成为迁移工具:今天能接DeepSeek的平台,明天同样可以接入新的第一名。这不是一条稳妥的路,更像一种近乎偏执的交换:DeepSeek不要每个环节的钱,只要每个环节最终都离不开它。
用户没有忠诚,只有没做完的工作
梁文锋为什么敢做这种交换?因为AI用户选择产品的方法,正在和传统软件用户变得不一样。一家企业替换合同系统,要迁移数据、调整流程、重新培训人员,几年前签下的合同也可能还没有到期。即使市场上出现更好的产品,旧系统仍然可以依靠更换成本活很久。模型没有这么厚的墙,开发者换一个接口,普通用户打开另一个页面,很多时候就能完成迁移。
程序员的电脑上可能同时开着Claude、OpenAI和DeepSeek。他不会先召开一次模型选型会,再决定这个月忠于谁;他只会把卡住自己的代码丢进去,看谁先找到问题。产品经理也一样,明早要交方案时,他在意的不是哪家公司拥有更大的生态,而是哪一个模型读完材料以后,没有漏掉最关键的限制条件。
一个模型能把事情做到九成,另一个只能做到七成,这不是相差二十分那么简单。剩下三成要由人逐行检查、补充条件、承担错误;模型省下的那一点调用费,很快会被返工吃掉。在真正的工作里,七成正确不是第二名,而是一份没有完成的工作。
有开发者记录过一次很现实的迁移:把聊天产品的生产流量切到DeepSeek以后,每月模型账单从大约400美元降到45美元,迁移只花了一个下午。另一组在调价前完成的14项任务对照测试却得到相反结果:多Agent工作流放大了token消耗,V4.1的整体账单高出约36%。两份结果因为任务和计价条件不同,不能直接对冲,却说明了同一件事:用户不会只为"DeepSeek"三个字付钱,他会看任务做成了没有、自己还要返工多久、最后总共花了多少。
Claude与OpenAI之间来回流动的开发者,也在重复这个动作。哪一个模型在编程、长文或者复杂任务里更可靠,工作就往哪边搬;下一代模型反超,工作又搬回来。具体的第一名会改变,用户的选择标准不会改变。
AI市场里,第一名交付结果,第二名交付返工。
这就是DeepSeek真正的商业逻辑。它不是先搭好一个生态,再希望生态把模型养大;它要先把能力推到足够高,让用户、开发者和应用公司为了完成工作,主动围到它身边。生态可以放大第一名,却很难把第二名长期抬在台上。
扎克伯格花出去的钱,替梁文锋回答了一个问题
如果能力如此重要,一个更直接的问题就出现了:有钱的大公司为什么不把第一名买下来?谷歌拥有搜索、Android、YouTube和数据中心,Meta拥有Facebook、Instagram、WhatsApp和几十亿用户。模型训练需要的钱、卡、人和入口,它们几乎一样不缺。如果生态能够直接兑换成能力,这场比赛原本不该留给创业公司多少位置。
可ChatGPT刚刚出现时,谷歌的搜索框没有拦住用户打开另一个网页。后来Gemini重新回到前沿竞争,也不是因为Android突然多出了几亿用户,而是模型终于能完成更多任务。入口一直在那里,用户重新选择它,是因为入口后面的东西变强了。
Meta的动作更能说明问题。它把Llama开放出去,积累了庞大的开发者社区,模型也能被放进自己拥有的多个超级应用;但在Llama 4反响没有达到预期、旗舰模型Behemoth曾因能力问题推迟发布以后,扎克伯格没有继续开一场生态大会解决问题。他重组AI团队,拿出143亿美元投资Scale AI,又把Alexandr Wang和一批人才拉进新的超级智能团队。
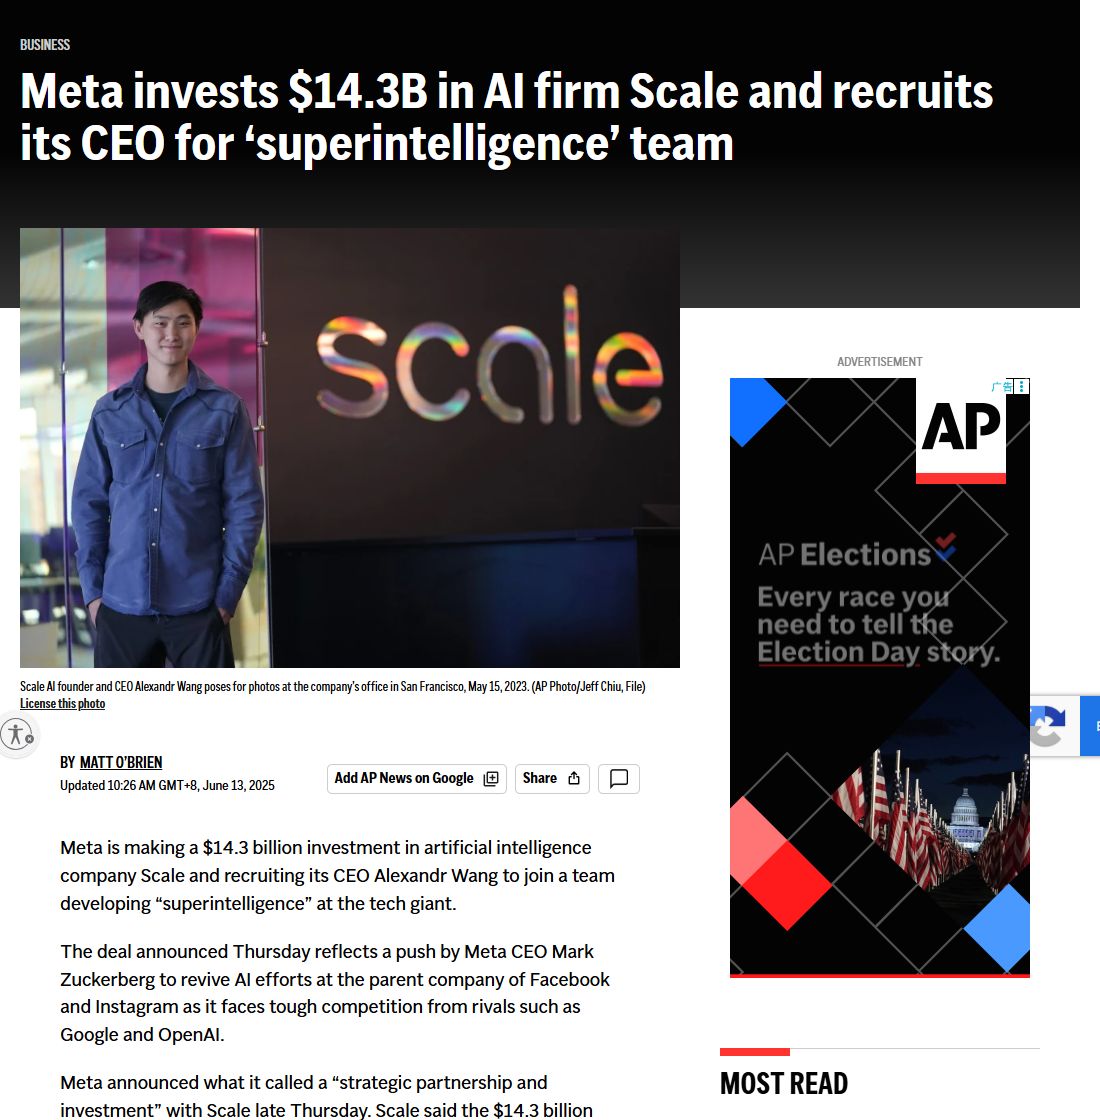
图:Meta投资Scale AI并引入其CEO Alexandr Wang,继续加码超级智能团队。
这不是一家缺钱的公司补钱,也不是一家缺流量的公司补流量。它拥有梁文锋当年没有的一切,最后仍然要回到最原始的动作:换人、改组织、重新训练,再赌一次结果。
钱当然重要。没有钱,买不到足够的芯片,留不住顶尖人才,也承受不了一次次训练失败。但钱更像让人继续试错的燃料,它不能替研究员产生那个念头,不能替组织判断哪条路值得再跑几个月,更不能要求突破按照财务计划准时到达。
梁文锋早就说过,如果投入越多就必然创新越多,大厂本来可以包揽所有创新。Google和Meta并没有"做不成AI",它们仍然站在前沿;它们真正证明的是另一件事:资本和生态是成为第一名的必要条件,却从来不是第一名的保证书。
梁文锋还在赌,今天的应用只是临时工
能力一旦成为用户最后的选择标准,今天围绕模型长出来的应用,就要面对一个让软件公司不太舒服的问题:它们现在完成的工作,有多少只是因为模型还不够强?拿合同审查来说,今天往往要先有人整理制度、配置规则、连接合同库,再由模型完成其中一段判断。产品经理设计页面,实施人员进入企业现场,法务反复确认边界,最后才让系统跑起来。这些岗位并不是多余的,它们正在替模型补上对业务、系统和责任的理解。
可模型每向前一步,就会自己拿走其中一部分工作。它能读懂制度,就少一层人工整理;它能调用业务系统,就少一层固定接口;它能发现条件不足并继续追问,就少一段事先画死的流程。过去需要一个软件模块完成的事,可能变成AI接到任务后的一个动作。
权限、数据安全、责任和验收不会因此凭空消失,企业软件也不会一夜之间全部作废。但产品价值会不断向更难被替代的地方移动,而那些只负责弥补模型能力缺口的页面、流程和人工配置,会越来越薄。
梁文锋不急着组建一支庞大的应用队伍,赌的正是这种变化。他不想让DeepSeek花几年时间,认真维护一批可能被下一代模型取消的中间步骤。别人在今天的缝隙里修城墙,他在等模型把缝隙继续推窄。
IPO没有让梁文锋改变,只是让他的赌局更贵了
到了2026年,这场赌局的价格已经不是2021年那一万张卡可以概括的了。路透社称,DeepSeek寻求新资金,是为了计算基础设施、模型研发,以及人才招募和留任。把这几个用途放在一起看,它们几乎还是梁文锋当年那套组织的三个部件:卡、年轻人,以及让年轻人继续试错的时间。
与此同时,DeepSeek仍在密集推动模型。7月31日发布V4 Flash,8月中旬推进V4 Pro和接口调价,8月底开放视觉权重,9月10日又发布V4.1 Flash。IPO消息出来的前后,它没有突然变成一家忙着讲会员故事的消费互联网公司,动作仍然围绕模型、效率和价格展开。
但上市会给梁文锋带来一个过去可以暂时躲开的问题。私人投资人可以接受几年没有答案,公开市场每三个月都要看一次报表;研究团队需要容忍失败,股东却天然希望投入能够变成可计算的回报。IPO能够替DeepSeek买时间,也会让更多人开始给这段时间计价。
这正是梁文锋接下来最难的地方。他需要资本,却不能让资本把研究员的训练卡重新切成销售指标;他需要留住人才,却不能把组织变成靠职级和流程维持运转的大公司;他还要继续开放,因为开放让DeepSeek进入更多场景,却又不能让所有使用永远只停留在别人的账单上。这些问题都存在,但它们不是同一个优先级。只要DeepSeek仍然能做出最强的一批模型,接口、订阅、授权和应用都有重新设计的机会,别人的平台也会主动兼容它;一旦能力掉下去,今天聚集起来的开发者不会因为开源情怀留下,投资人更不会因为曾经排过队就停止计算回报。
所以这不是"技术理想终于向商业投降"的故事。更接近事实的解释是:梁文锋仍然把商业放在能力之后,只是他终于接受,想让能力继续往前走,就必须先向资本购买更多失败的资格。2024年,记者问他,技术既然没有绝对秘密,DeepSeek的护城河在哪里。梁文锋回答,技术可以被理解,但重新组织团队、追赶下一代技术,需要时间和成本。两年以后,IPO恰好回到了这句话。
梁文锋真正想从资本市场买走的,不是一个更大的DeepSeek,而是下一位年轻研究员提出新想法以后,团队还有几个月把它跑通。
如果那个想法让DeepSeek继续站在第一名的位置,用户、应用和收入都会追过来。如果没有跑通,今天谈论的生态、估值和商业模式,不过是在替一个失去领先的模型清点旧账。
作者
合同吴彦祖
长期关注ToB软件、合同管理与企业AI落地。