系列文章
LangChain 1.0 入门(一):Runnable 统一接口全解析(含完整代码+逐行输出解读)
LangChain 1.0 入门(二):LangChain 全模型标准化接入最佳实践(小白参数详解版)
LangChain 1.0 入门(三):稳定性双核心------重试机制+速率限速器参数详解与实战
LangChain 1.0 入门(四): Messages 深度解析------大模型对话上下文核心单元
LangChain 1.0 入门(五):提示词工程、partial变量、ChatPromptTemplate、Hub模板库
LangChain 1.0 入门(六):标准化内容块 Content Blocks------彻底解决多模型、多模态适配痛点(全代码实战版)
LangChain 1.0 入门(七):批处理、并发控制与流式传输
LangChain 1.0 入门(八):结构化输出全解|全解析器实战+生产最佳实践
LangChain 1.0 入门(九):Agent 核心概念与技术架构
前言
大语言模型能把一段话说得像人写的,但说话和做事是两回事。你让它写一条 SQL,它写得出来;你让它连上数据库把这条 SQL 跑出结果,它做不到。输出停在文本层,碰不到文本之外的东西。
Agent(智能体)要解决的就是这个断层。它以大语言模型为大脑,能感知环境、做推理规划、调用外部工具,把多步任务一路做下去。和普通程序的区别,落在任务怎么拆、工具怎么选、下一步怎么根据真实反馈调整。这些动作在运行时才决定,而不是在写代码的时候就定死。
有个常见的误解,是把它当成"更聪明的模型"。用的还是同一个模型,区别在于围绕它搭起来的那套结构:工具、记忆、循环、约束。
一、Agent 是什么
LangChain 给过一个相当精确的定义:
Agent 以大语言模型作为其推理引擎,并依据 LLM 的推理结果来决定如何与外部工具进行交互、以及采取何种具体行动。
官方文档现在的说法更短:
An agent is a model calling tools in a loop until a given task is complete.
(Agent 就是一个在循环中调用工具、直到给定任务完成的模型。)
紧接着还有另一半:A harness is everything around that loop。harness 指循环之外的一切,包括提示词、工具,以及任何塑造模型行为的中间件(middleware)。合起来是官方给出的等式:
Agent = Model + Harness
这个等式把 Agent 拆成了两块可以分开施工的东西。Model 出推理能力,Harness 负责"在对的时刻把对的上下文交给模型"。后者是原文对 harness 职责的写法,也是后面所有工程细节的落点。
回过头再看那句经典定义,几个限定词都有分量。
"以 LLM 作为推理引擎"说的是决策发生在哪。它发生在模型这里,不在开发者写的 if-else 分支里。这是 Agent 和工作流编排最根本的分野:编排好的流程,下一步走哪条由代码决定;Agent 的下一步由模型在运行时判断。
"依据推理结果决定交互方式"说的是工具的地位。工具不是等着被调用的函数库,而是一组候选动作。模型得先看清当前处境、判断缺什么信息或要产生什么效果,再从清单里挑一个并给出参数,这个挑选过程本身就是一次推理。
"与外部工具交互"说的是能力边界。模型只能输出文本,工具能读数据库、发请求、写文件、提交代码。两边接上,单一 LLM 的知识限制和功能边界就打开了。
再往下挖一层,有个判断听起来反直觉,但很关键:Agent 本质上是一种高级的提示工程应用范式。
这个判断并没有贬低 Agent。它解释了为什么两个人用同一个模型搭出来的 Agent,效果能差出几个量级。这套架构的全部"智能",最终都要靠提示词模板传达给模型:当前任务是什么、有哪些工具可用、每个工具怎么用、上一步结果是什么、输出必须符合什么格式、什么时候该停。模板设计得好不好,直接决定模型能不能像人一样去分解任务、挑工具、整合结果。
所以 Agent 工程的重心,通常不在模型选型上反复纠结,而在工具描述、上下文构造、循环控制这些地方。官方用 harness 这个词指代的就是这部分工作,并且明确它包含"提示词、工具与中间件"。两种说法讲的是一件事:harness 是被工程化、有明确边界的提示工程。第四章要讲的 create_agent,官方对它的定位正是"a highly configurable harness"。
二、自主决策是怎么发生的
理解 Agent 最难的一处,是理解它"如何自主决策"。项目经理这个类比能帮上忙。
在 LangChain 1.0 的视角下,Agent 更像一个拥有万能工具箱的超级项目经理:
- LLM(大模型)是大脑,也就是项目经理。它负责思考、规划、决定下一步做什么。但它不能联网,也算不来复杂数学,除非借助工具。
- Tools(工具)是手脚,也就是执行专员。谷歌搜索负责看世界,计算器负责算数,数据库负责查档案。
- Agent 则是大脑加手脚,再加一套循环机制。通过不断的"思考---行动---观察"把问题解决掉。
三者的分工可以这样对照:
| 组件 | 类比 | 负责什么 | 不负责什么 |
|---|---|---|---|
| LLM | 项目经理 | 理解目标、拆解步骤、选择工具、整合结果、判断何时收工 | 联网、精确计算、直接读写外部系统 |
| Tools | 执行专员 | 按指令完成一个具体动作并返回真实结果 | 决定自己什么时候该被调用 |
| 循环机制 | 协作流程 | 把执行结果回灌给大脑,驱动下一轮决策 | 替代任何一方的判断 |
换成官方术语会更精确:LLM 是 Model,其余三项(工具、循环,以及约束这一切的提示词与中间件)都属于 Harness。类比解释的是职责怎么分,harness 解释的是代码边界画在哪。前者帮你理解 Agent 为什么能自主,后者帮你理解自己到底要写哪些代码。
循环机制
单次 LLM 调用只能基于当下已知的上下文做一次判断。真实任务的信息却是逐步暴露的:不查,就不知道接下来该查什么;不执行,就不知道方案行不行。
循环机制处理的就是这件事。它把上一步拿到的真实结果变成下一步的决策依据,模型据此修正路线,而不是沿着最初的猜测一路走到黑。
这也是它和固定 Chain 的分水岭。Chain 的执行路径由开发者预先写死,适合步骤稳定、分支能穷举的场景;Agent 的路径在运行时由模型动态决定,适合步骤不好预先枚举、需要看中间结果再调整的场景。代价是不确定性:同样的输入,两次执行可能走出不同路径。
循环长什么样
把循环机制展开,就是经典的 ReAct 范式:
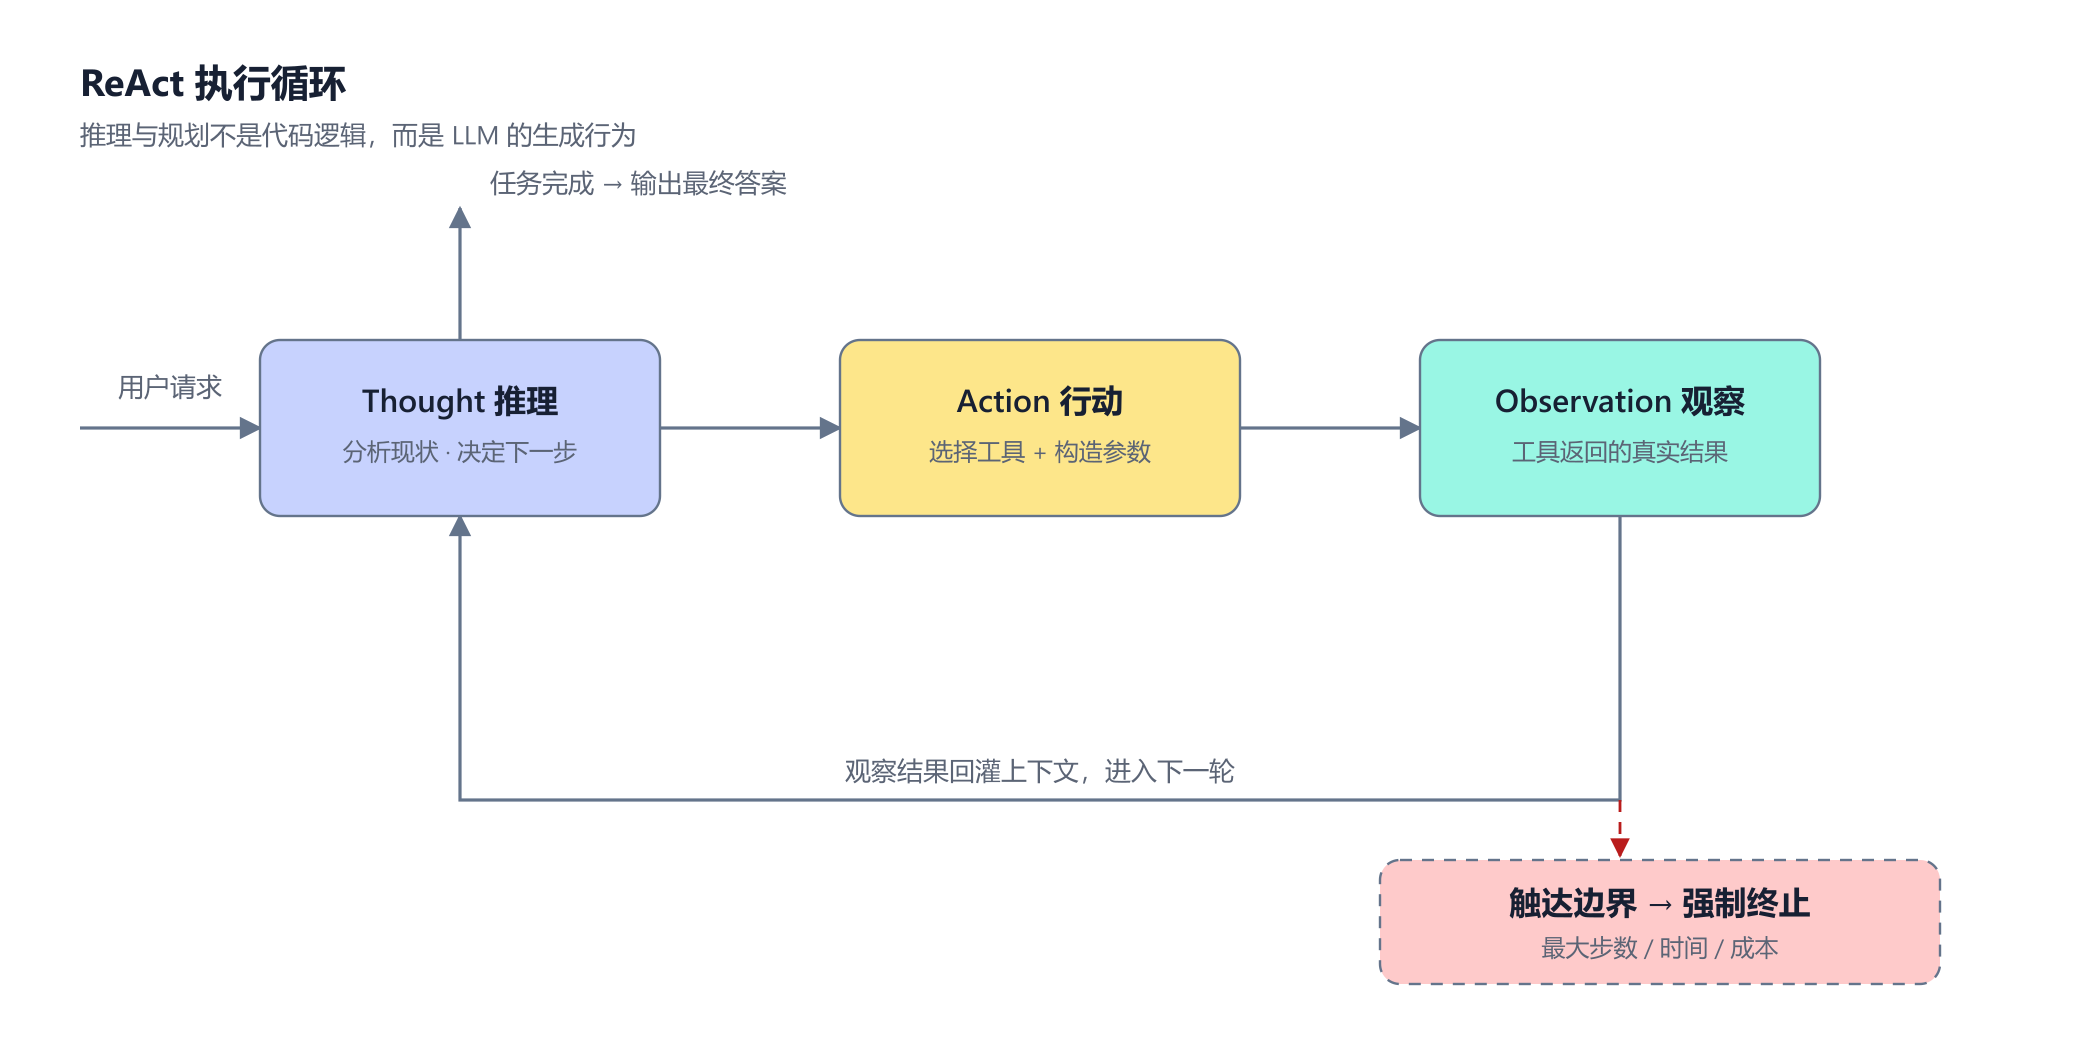
图 1:ReAct 执行循环。三个动作构成闭环,两个出口分别是"任务完成"与"触达边界"。
三个动作的含义不难懂。思考是判断当前处于什么状态、还缺什么;行动是选定工具并构造参数;观察是把工具返回的真实结果原样收回上下文。
需要留意的是终止条件。循环有两个出口,一个是模型判断任务已完成并输出最终答案,另一个是撞上外部设定的边界,比如最大步数、时间上限、成本预算。后一个出口在生产环境里格外重要,理由留到第七节讲。它在 LangChain 里的具体实现,4.3 节细说。
三、五模块架构
现代 Agent 的技术架构由五个核心模块构成,共同形成一条"感知---思考---行动"的闭环。
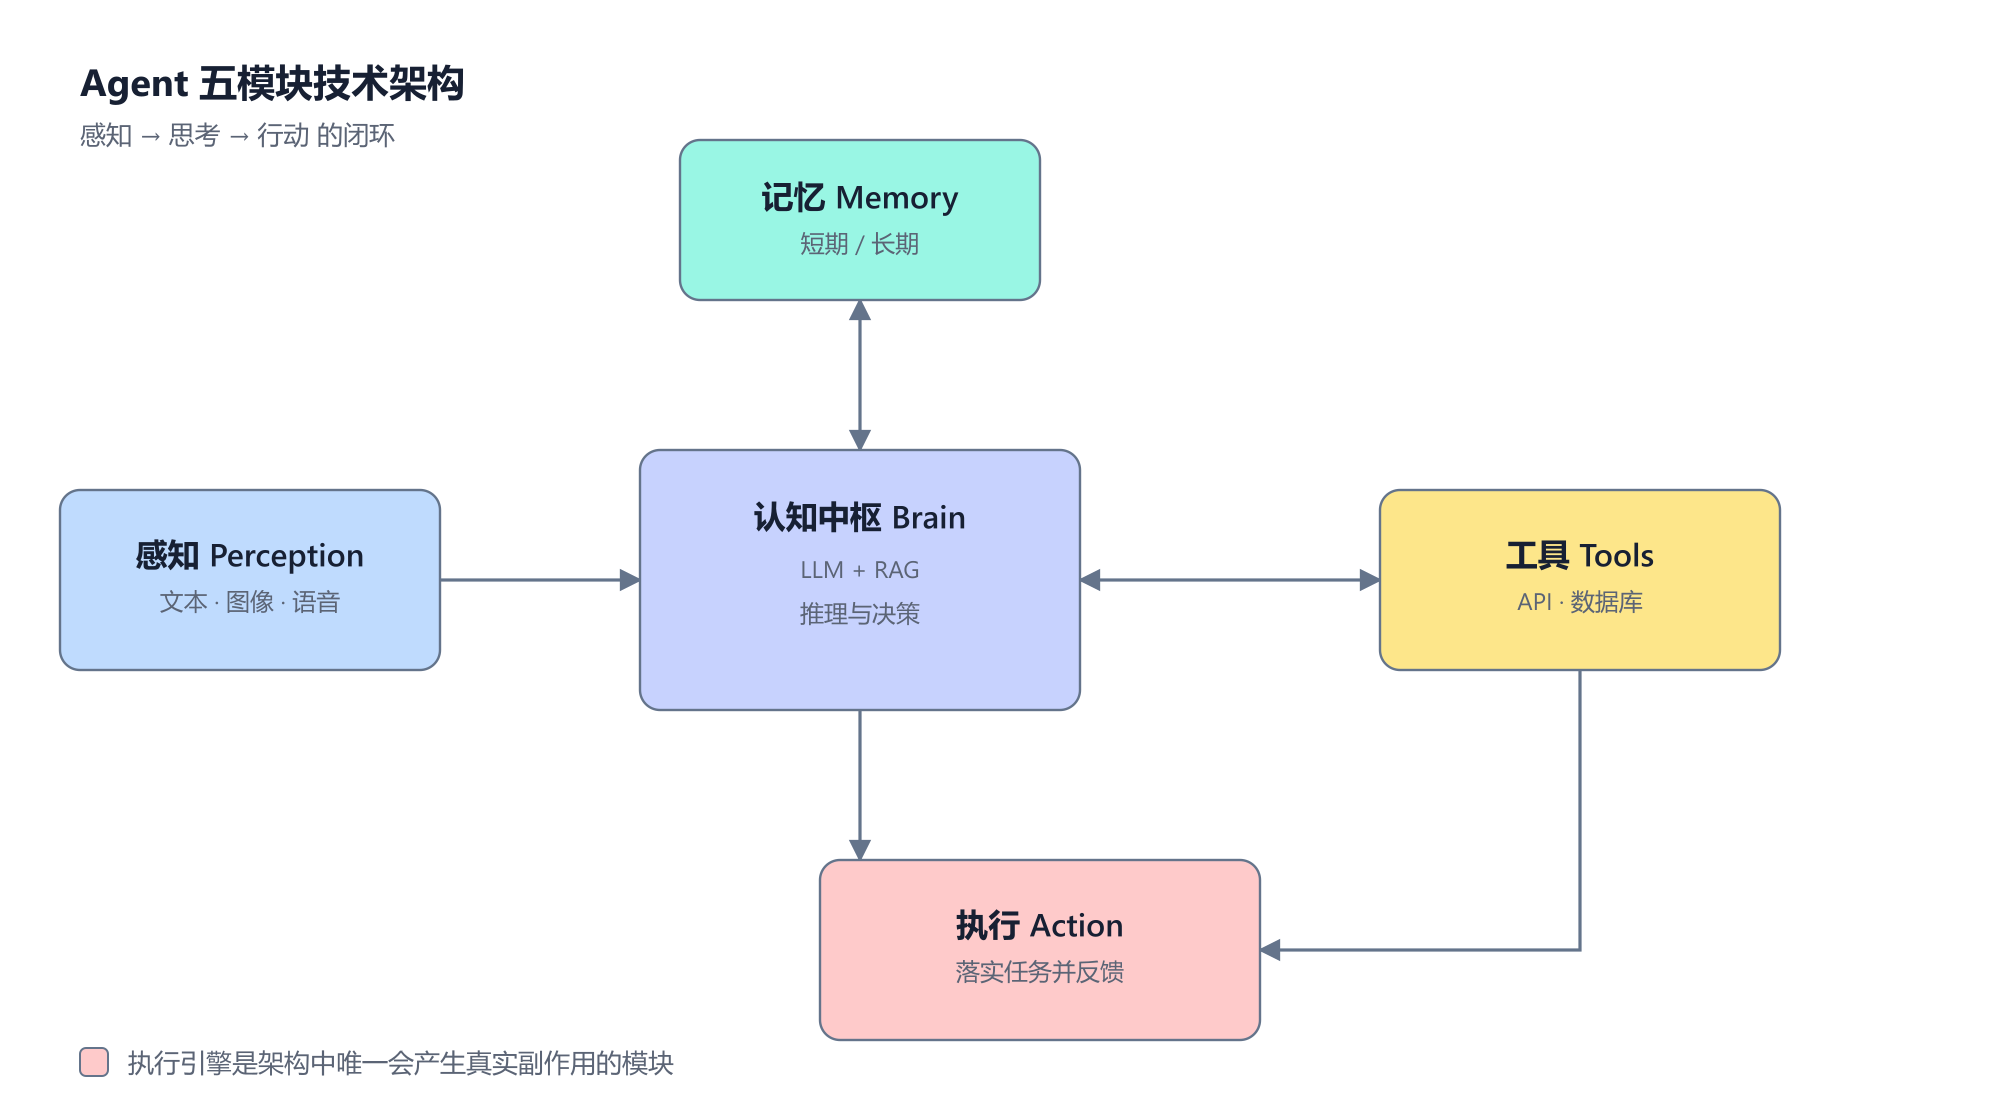
图 2:五个核心模块的协作关系。认知中枢是枢纽,记忆与工具与之双向交互,执行引擎是唯一产生真实副作用的模块。
1. 感知(Perception)
负责接收文本、图像、语音等多模态输入。它要做的不只是把数据收进来,还得把不同形态的输入统一成模型能消费的表示,并完成意图识别与输入规范化。
这一层做得糙,后面的规划再强也白搭。模型对目标的理解一旦偏了,整条循环都在朝错误方向使劲。
2. 认知中枢(Brain / Planning)
基于大语言模型和检索增强生成(RAG)做推理和决策。它在架构里的位置有点尴尬:既是最聪明的部分,也是最大的短板。
LLM 有两个绕不开的缺陷,拿不到实时信息,也执行不了具体操作。RAG 补前半段,把外部知识检索进上下文;工具调用补后半段,把决策变成真实世界的动作。两者合起来,认知中枢的"想"才有可能落地。
规划策略上有个基本取舍。一次性把完整计划列出来,快,但中途遇到意外就得推翻重来;边想边做、每步根据观察调整,稳,但更慢更贵。实际系统往往混着用,先给一个粗粒度框架,再在执行中细化。
3. 记忆(Memory)
短期记忆维持对话连贯,长期记忆积累经验与偏好。两者的差别不只是时间跨度:
| 类型 | 载体 | 作用 | 关键工程问题 |
|---|---|---|---|
| 短期记忆 | 上下文窗口 | 维持当前任务的连贯性 | 窗口是稀缺资源,必须决定什么留在窗口内 |
| 长期记忆 | 向量库 / 结构化存储 | 跨会话积累经验与用户偏好 | 写入什么、何时写、怎么检索、怎么遗忘 |
长期记忆真正难的地方在"遗忘"。什么都记,检索时噪声会淹没信号;记错了,错误认知又被反复强化。一个只往里塞、从不清理的记忆系统,用久了反而拖累 Agent 的表现。
4. 工具(Tools)
通过 API 调用、数据库访问等方式和外部系统交互。这是 Agent 能力边界的外部延伸,也是提示工程见效最直接的战场。
一个工具对模型来说,可见的部分只有三样:名字、描述、参数结构。模型就靠这三样判断什么时候该用它、该怎么传参。所以工具描述是写给模型看的文档,写得含糊,模型就会选错工具或者传错参数。
官方文档说得更直接:
Tools should be well-documented: their name, description, and argument names become part of the model's prompt.
(工具应当被认真写文档:它们的名字、描述和参数名都会成为模型提示词的一部分。)
"become part of the model's prompt"这句值得留意。写工具文档在 Agent 开发里不是注释工作,它就是提示词工程本身。你写的 docstring 会一字不差地进到模型上下文里,直接影响它选哪个工具、传什么参数。用 @tool 装饰器时,函数名和参数名不该随手起,原因在这儿。
5. 执行(Action)
负责执行具体任务并反馈结果。整个架构里只有这个模块会产生真实副作用:写文件、改数据、发请求、提交代码,都发生在这里。
也正因为如此,权限控制、参数校验、超时与重试、幂等设计、操作审计这些传统后端的基本功,在这一层一个都不能少。Agent 的不确定性决定了它一定会犯错,架构的责任是让错误可控、可回滚、可追溯。
串起来看一遍
用户说:"帮我分析一下上个月产品差评的主要原因。"
感知模块解析出意图与时间范围。认知中枢把它拆成"取差评数据 → 归类 → 找共性 → 出结论"几步,并判断需要查数据库。记忆系统提供产品线信息,以及该用户一贯偏好的报告格式。执行引擎调用数据库查询工具拿到原始差评。认知中枢归纳出几类主因,发现缺少竞品对比,于是再调一次搜索工具。结果回灌,整合成报告。
五个模块在这里都用上了。
四、落到代码:Agent 与 LangChain 的结合
前三章讲的是通用架构,不依赖任何具体框架。但要把这套架构跑起来,需要一个框架把模型、工具、记忆、循环接到一起。在 LangChain 1.0 里承担这层胶水职责的是 create_agent,它的参数清单几乎逐一对应上一章那五个模块。
4.1 create_agent 的九个参数
| 参数 | 类型 | 必填 | 默认值 | 核心作用 | 最佳实践 |
|---|---|---|---|---|---|
model |
str / 实例 | 必填 | - | 推理引擎 | 生产环境传实例,配置走 .env |
tools |
list | 必填 | [] |
执行能力 | 描述清晰,按需添加 |
system_prompt |
str | 选填 | None |
行为准则 | 明确角色和约束 |
middleware |
list | 选填 | [] |
功能扩展 | 组合日志、安全、摘要 |
checkpointer |
Saver | 选填 | None |
短期记忆 | 生产用 PostgresSaver |
store |
Store | 选填 | None |
长期记忆 | 跨会话用 PostgresStore |
state_schema |
TypedDict | 选填 | AgentState |
扩展状态 | 用 TypedDict,非 Pydantic |
context_schema |
TypedDict | 选填 | None |
动态上下文 | 配合 middleware 使用 |
response_format |
BaseModel | 选填 | None |
结构化输出 | API 对接场景启用 |
对照第三章的模块划分,映射关系一目了然:
| 参数 | 对应模块 | 说明 |
|---|---|---|
model |
认知中枢 | 决策的发生地 |
tools |
工具生态 | 能力边界的外部延伸 |
system_prompt |
认知中枢 | 写在参数里的行为约束 |
middleware |
横切各模块 | 日志、安全、摘要等通用关注点 |
checkpointer / store |
记忆系统 | 分别对应短期与长期 |
state_schema / context_schema |
状态与上下文 | 决定 Agent 能看到什么 |
response_format |
输出契约 | 让产出可以被程序消费 |
先说 model 怎么准备,因为它是唯一的必填项,也是唯一会碰密钥的地方。
官方允许两种传法:模型标识符字符串("provider:model")或者一个已初始化的模型实例。上表 model 那行写的"生产环境用实例化配置",指的就是后者。原因不在于语法,而在于配置该放在哪。
先建一个 .env:
bash
# .env ------ 一次配置,全局复用
BASIC_MODEL=gpt-3.5-turbo          # 模型名称
API_KEY=sk-xxxxxx                  # 接口密钥
BASE_URL=https://xxx.xxx.xxx/v1    # 兼容 OpenAI 格式的接口地址
python
import os

from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain.agents import create_agent

load_dotenv()

llm = ChatOpenAI(
    model=os.getenv("BASIC_MODEL"),
    api_key=os.getenv("API_KEY"),
    base_url=os.getenv("BASE_URL"),
)

agent = create_agent(model=llm, tools=tools)这么写的好处很实际。密钥不进代码库,.env 加进 .gitignore 就行;换模型或换供应商只改配置文件,业务代码一行不动;任何兼容 OpenAI 接口的服务都能接进来,换个 base_url 即可,不用动调用逻辑。
langchain_openai 这个名字容易让人误会,它其实是"OpenAI 兼容协议"的客户端,不是只能连 OpenAI。国内多数厂商和自建 vLLM 服务都走这套协议,所以这个加载范式在实际项目里通用性很高。
顺带提醒一句:别为了跑通示例把假密钥写死在代码里 。写死的 key 迟早会被提交进版本库,而清理一次泄漏的 key 比配置 .env 麻烦得多。
一个最小的订单查询 Agent 长这样:
python
from langchain.agents import create_agent

agent = create_agent(
    model=llm,                      # 模型实例,由 .env 配置驱动
    tools=[order_query_tool],       # 工具
    system_prompt="你是一个订单查询助手,能够查询订单状态和明细。",  # 系统提示
    middleware=[order_query_middleware],    # 中间件
    checkpointer=checkpointer,      # 检查点,短期记忆
    store=store,                    # 状态存储,长期记忆
    state_schema=OrderQueryState,   # 扩展状态(如需要)
    context_schema=AgentContext,    # 上下文状态(如需要)
    response_format=ResponseModel   # 结构化输出(如需要)
)
关于
middleware还是middlewares:官方文档里create_agent的参数名是单数middleware,所有官方示例都写middleware=[...]。如果你手上的示例代码写成了middlewares=,那是笔误,照抄会直接抛TypeError。
官方参数不止表里这九个,至少还有一个 name 值得知道:给 agent 起个标识符,把它作为子图嵌进多智能体系统时尤其有用。
python
agent = create_agent(model=llm, tools=tools, name="research_assistant")顺带说一个选型问题。官方现在提供两条路径,create_agent 和 create_deep_agent。后者把常用能力预先组装好了,规划(write_todos)、文件系统工具、子智能体、记忆都开箱即用。官方的取舍建议很干脆:要最大能力、少配置,选 Deep Agents;要精细控制,选 LangChain agents。本文讲后者,因为把 create_agent 的参数逐个过一遍,才看得清前面那套五模块架构究竟落到了哪些代码上。
参数虽多,需要理解透的主要是两组。
checkpointer 与 store:短期和长期记忆的分工。 官方把这条界限划得很清楚。
checkpointer管线程内。短期记忆是 agent state 的一部分,由 checkpointer 持久化,按thread_id组织,让一条会话随时可以恢复。官方特别提醒,用thread_id持久化对话历史的前提是 agent 配了 checkpointer。部署在 LangSmith 上会自动提供一个,本地必须自己传,比如checkpointer=InMemorySaver()。生产环境换数据库版本,官方示例是PostgresSaver。store管跨线程。长期记忆建在 LangGraph store 之上,以 JSON 文档形式按 namespace 加 key 组织,跨会话可召回,常用 user_id 之类做 namespace。生产环境同样是数据库版本,官方示例是PostgresStore。
有个细节容易忽略:store 不只给框架内部用。工具里可以通过 runtime.store 直接读写它。"记住用户偏好"这类能力,本质上是你自己写一个工具去操作 store,框架只负责把 store 注入到你手上。
state_schema 与 context_schema:两个 schema,两种用途。 这两个参数名字相近,最容易混。区别在生命周期。state_schema 是跨轮次持续存在、会被写回持久化的状态,默认就是 AgentState,里面有一个 append-only 的 messages 字段;context_schema 是单次调用的静态上下文,通过 invoke(..., context=...) 传入,官方把它定位为给工具和中间件做依赖注入的手段。数据库连接、user_id、开关标志都走这里,别硬编码,也别用全局变量。
至于类型选择,官方文档的示例其实给的是"都可以"。state_schema 用继承 AgentState 的 TypedDict 子类;context_schema 在不同页面里分别示范过 @dataclass、TypedDict,甚至 Pydantic BaseModel。而 response_format 要的是严格校验后的结构化输出,用 BaseModel 定义,结果从 result["structured_response"] 取。
记住这条分工就够了:持久化状态用 TypedDict 系(要能按 reducer 合并),一次性依赖注入用你顺手的类型,对外输出契约用 Pydantic。选择看用途,不看风格偏好。
4.2 中间件:官方的能力装配位
上表里 middleware 只占一行,但它是这套架构里弹性最大的一处。官方给它的定位是"塑造模型行为的一切",也就是 harness 里除去模型和工具的那部分。
理解中间件的价值,官方在 PII 那一节的一句话说得最好:
Some policies can't live in a prompt---they need to be enforced deterministically regardless of what the model does.
(有些策略没法靠提示词保证------无论模型做什么,它们都必须被确定性地强制执行。)
这句话点破了中间件和提示词的差别。提示词是请求模型遵守,中间件是强制系统执行。凡是不能让模型自由裁量的规则,比如脱敏、限流、人工审批、成本上限,都该放进中间件,别写在 system prompt 里赌它听话。
官方预置的中间件覆盖了生产环境绝大多数需求,按用途归类:
| 用途 | 官方预置中间件 | 解决什么 |
|---|---|---|
| 容错 | ModelRetryMiddleware / ToolRetryMiddleware / ToolErrorMiddleware |
指数退避重试;把工具异常转成模型看得见的错误消息,让它自己改参数重试,而不是整轮崩掉 |
| 降级 | ModelFallbackMiddleware |
主模型不可用时自动切备用模型 |
| 成本与循环控制 | ModelCallLimitMiddleware / ToolCallLimitMiddleware |
限制模型调用与工具调用次数,防止成本失控 |
| 上下文管理 | SummarizationMiddleware / ContextEditingMiddleware |
接近 token 上限时自动摘要历史;清理旧工具输出、只保留最近 N 条 |
| 安全与合规 | PIIMiddleware / HumanInTheLoopMiddleware |
检测处理个人身份信息;在关键工具调用前暂停,等人审批 |
| 能力扩展 | FilesystemMiddleware / ShellToolMiddleware / SubagentMiddleware / TodoListMiddleware |
给 agent 文件系统、shell、子智能体、任务清单 |
| 检索与选工具 | FilesystemFileSearchMiddleware / LLMToolSelectorMiddleware |
Glob/Grep 文件检索;工具太多时先用 LLM 筛一遍 |
| 测试 | LLMToolEmulator |
用 LLM 模拟工具返回,不执行真实工具也能跑通流程 |
两点实务提醒。中间件的顺序有意义,官方在 ToolError 示例里特意说明,重试中间件要放在更内层(middleware 列表里更靠前),异常才会在重试耗尽后继续冒泡到错误处理中间件。另外中间件有版本门槛,比如 ToolErrorMiddleware 需要 langchain>=1.3.14,RubricMiddleware 需要 deepagents>=0.6.5 且仍是 beta。官方文档会标注这类要求,抄代码前扫一眼。
4.3 ReAct 范式与执行循环
ReAct(Reasoning + Acting)强调"推理---行动---观察"的闭环:Agent 先形成 Thought(推理),据此选择并调用工具(Action),再吸收工具返回的 Observation(观察),进入下一轮决策。闭环在得到最终答案、达到迭代上限或时间上限时终止。
这个循环第二章已经出现过,这里补实现细节,以及几个容易想岔的地方。
它不是代码逻辑,是模型的生成行为,这一点最容易被忽略。循环里的 Thought 步骤并非由确定性算法执行,而是由 prompt 触发 LLM 生成的推理文本。"怎么想"这件事没有写在代码里,它写在提示词里,存在于模型的权重里。开发者的控制力集中在两处:怎么设计 prompt 引导思考,怎么组织上下文喂给它。
由此能推出一个不太舒服但必须接受的结论:模型能力是 ReAct 性能的天花板。框架再精巧,也只是把模型的推理结果忠实执行下去。推理本身错了,执行得再准也是错的。
LangGraph 用状态机与检查点承托这个循环。同样的闭环,用一个 while 循环手写也能实现,但会丢掉三样东西。状态机与检查点保证每次行动的原子性、状态的可见性与轨迹的可回放性:原子性让"调用工具并写入结果"成为一个不可分割的步骤,不会因中途异常留下错乱状态;状态可见性让每一步的完整状态都可被检查;轨迹可回放让线上问题能像录像一样重演,不用靠翻日志猜。排查线上问题时,状态可见和轨迹回放省下的时间最多。
官方文档里那张循环图把路径画得很清楚:__start__ → before_model → model →(tools 或 __end__),而 tools 执行完又回到 before_model。这个回路解释了一件事:一轮循环和一次图步数从来不是一比一。一次完整的"推理---行动---观察"要依次穿过 before_model、model、tools,任何按步数计的阈值都不能直接当成工具调用次数。
在 LangChain 里,这个认知循环被实现为:
- Thought(推理):大模型基于当前输入和历史记录进行思考,决定下一步行动。
- Action(行动):大模型选择一个工具并构造输入参数,形成一个
AgentAction。 - Observation(观察):工具被执行,返回结果作为观察值,并与
AgentAction一起被添加到中间步骤(intermediate_steps)中。 - 循环决策:Agent 把新的观察结果纳入上下文,进入下一轮"推理---行动"循环,直到达到最终目标或触发终止条件。
intermediate_steps 这个设计值得多看一眼。它把"曾经做过什么、得到了什么"结构化地留下来,既是下一轮推理的输入,也是轨迹回放的依据。Agent 的每一次行动都被记录、被累积、被后续决策反复引用。这也是闭环反馈系统和"连续调几次函数"的实质差别。
4.4 粗粒度兜底:recursion_limit
create_agent 建出来的 Agent 默认会一直循环,直到模型自己认为任务完成。这在生产环境不可接受,得显式设定边界:
python
# ============ 限制最大 3 次循环 ============
config = {
    "configurable": {"thread_id": "limit_demo"},  # 线程 ID,checkpointer 靠它区分会话
    "recursion_limit": 3  # 最多 3 次迭代,或使用中间件精确跟踪并终止循环
}

result = agent.invoke(
    {"messages": [{"role": "user", "content": "LangChain 1.0 发布日期"}]},
    config=config
)这里有个容易误解的地方:recursion_limit 是 LangGraph 图级别的配置,不是 Agent 的语义参数。我第一次看到这个参数名时,也以为它管的是工具调用轮数,实际不是。官方在 GRAPH_RECURSION_LIMIT 这个错误的说明里把它描述成"图在触发停止条件前能达到的最大步数",并提示两种诱因,一是代码写出了环(a → b → a 这类无限循环),二是"复杂图本来就可能自然撞到默认上限"。所以调它的正确姿势不是拍一个数,而是先看 trace 里真实的步数消耗。
触顶的后果也要注意:抛异常中断,Agent 没机会优雅收尾。所以代码注释里那句"或使用中间件进行精确跟踪和终止循环"才是更该投入的方向。
4.5 精细控制:中间件与上下文管理
recursion_limit 是粗粒度兜底。官方真正提供的是按业务语义计数的中间件:
python
from langchain.agents import create_agent
from langchain.agents.middleware import (
    ModelCallLimitMiddleware,
    ToolCallLimitMiddleware,
    SummarizationMiddleware,
)

# 摘要专用的小模型,.env 里加一行 SUMMARY_MODEL 即可
summary_llm = ChatOpenAI(
    model=os.getenv("SUMMARY_MODEL"),
    api_key=os.getenv("API_KEY"),
    base_url=os.getenv("BASE_URL"),
)

agent = create_agent(
    model=llm,
    tools=tools,
    middleware=[
        # 成本闸门:限制模型调用与工具调用次数
        ModelCallLimitMiddleware(max_calls=10),
        ToolCallLimitMiddleware(max_calls=5),
        # 上下文闸门:逼近 token 上限时自动摘要历史
        SummarizationMiddleware(
            model=summary_llm,
            trigger=("tokens", 4000),
            keep=("messages", 20),
        ),
    ],
    checkpointer=checkpointer,
)
摘要那行特意用了一个更便宜的小模型。这是个容易忽略的成本点:摘要会随对话变长反复触发,用主模型跑等于每一轮都额外付一次旗舰模型的价钱,而摘要对模型能力的要求并不高。
两者的分工很清楚:
| 手段 | 层级 | 触顶行为 | 适用场景 |
|---|---|---|---|
recursion_limit |
LangGraph 图配置 | 抛异常中断整轮 | 兜底防线,防死循环 |
ModelCallLimitMiddleware / ToolCallLimitMiddleware |
中间件 | 按预设策略优雅停止 | 成本控制、防重复调用 |
上下文控制更值得展开,因为它顺带解决了第七节要讲的"上下文膨胀"。官方把上下文工程称为"构建有效 agent 的主要挑战"(a main challenge),并点出了诱因:像 web_search、RAG 这类返回长度不固定的工具,长结果会迅速填满上下文窗口。
官方给了三条路,按代价从低到高:
- 裁剪消息。用
@before_model钩子保留首条消息加最近若干条,其余丢弃。便宜,但真的会丢信息。 - 摘要消息。用
SummarizationMiddleware在逼近上限时把较早的对话压成摘要,保留最近 N 条原文。信息损失小,代价是一次额外的模型调用。 - 清理工具输出。用
ContextEditingMiddleware加ClearToolUsesEdit,把旧的工具返回替换成占位符(默认[cleared]),只保留最近几次工具结果。
第三条往往最对症,因为撑爆上下文的元凶通常不是对话本身,而是那些又长又只在一轮内有用的工具返回值。
python
from langchain.agents.middleware import ContextEditingMiddleware, ClearToolUsesEdit

agent = create_agent(
    model=llm,
    tools=[search_tool, database_tool],
    middleware=[
        ContextEditingMiddleware(
            edits=[
                ClearToolUsesEdit(
                    trigger=2000,   # 超过这个 token 数就触发
                    keep=3,         # 最近 3 次工具结果永不清理
                    exclude_tools=[],  # 可指定某些工具的输出不清理
                    placeholder="[cleared]",
                ),
            ],
        ),
    ],
)
最后补一个官方明确提醒的坑:摘要只是文本层面的压缩,不会压缩图片和音视频。被摘要掉的旧多模态消息只剩文字摘要,而 keep 保留的近期消息仍带原始多模态块。图片密集的应用应当把媒体放进对象存储,消息历史里只传 URL 或文件引用。踩了这个坑的表现是"模型突然看不见图了",很难倒查。
五、六步执行闭环
把五个模块的协作拉直,Agent 的运行是一条六步闭环:
环境感知 → 任务规划 → 工具调用 → 执行反馈 → 自我反思 → 优化调整
前四步是把这一件事做完,后两步是让下一次做得更好。
环境感知要搞清楚当前世界是什么状态、用户到底想要什么。任务规划把模糊目标拆成可执行的动作序列,并确定优先级与依赖关系。工具调用为每个动作选合适的工具、构造正确的参数。执行反馈拿到真实结果,不做粉饰地回灌给模型,反馈一旦失真,后面全是空中楼阁。
自我反思对照目标检查当前结果:哪里没达成、哪一步走了弯路、失败的原因是什么。优化调整则把反思的结论落到两个地方。落到当次任务内,就是换工具、改参数、调整策略、重新规划;落到跨任务,就是写入长期记忆、沉淀工具的正确用法、修订提示词模板。
前者让 Agent 会干活,后者让 Agent 越用越好用。缺了后两步的系统,仍然只是一个能自动调几次函数的工作流,谈不上持续学习和改进。
六、和传统 AI 模型比,差在哪
Agent 已经超出传统 AI 模型的范围,成为能自主完成多步骤复杂任务的智能数字助手。它的核心特征集中在三处:自主性增强、执行能力和持续学习。
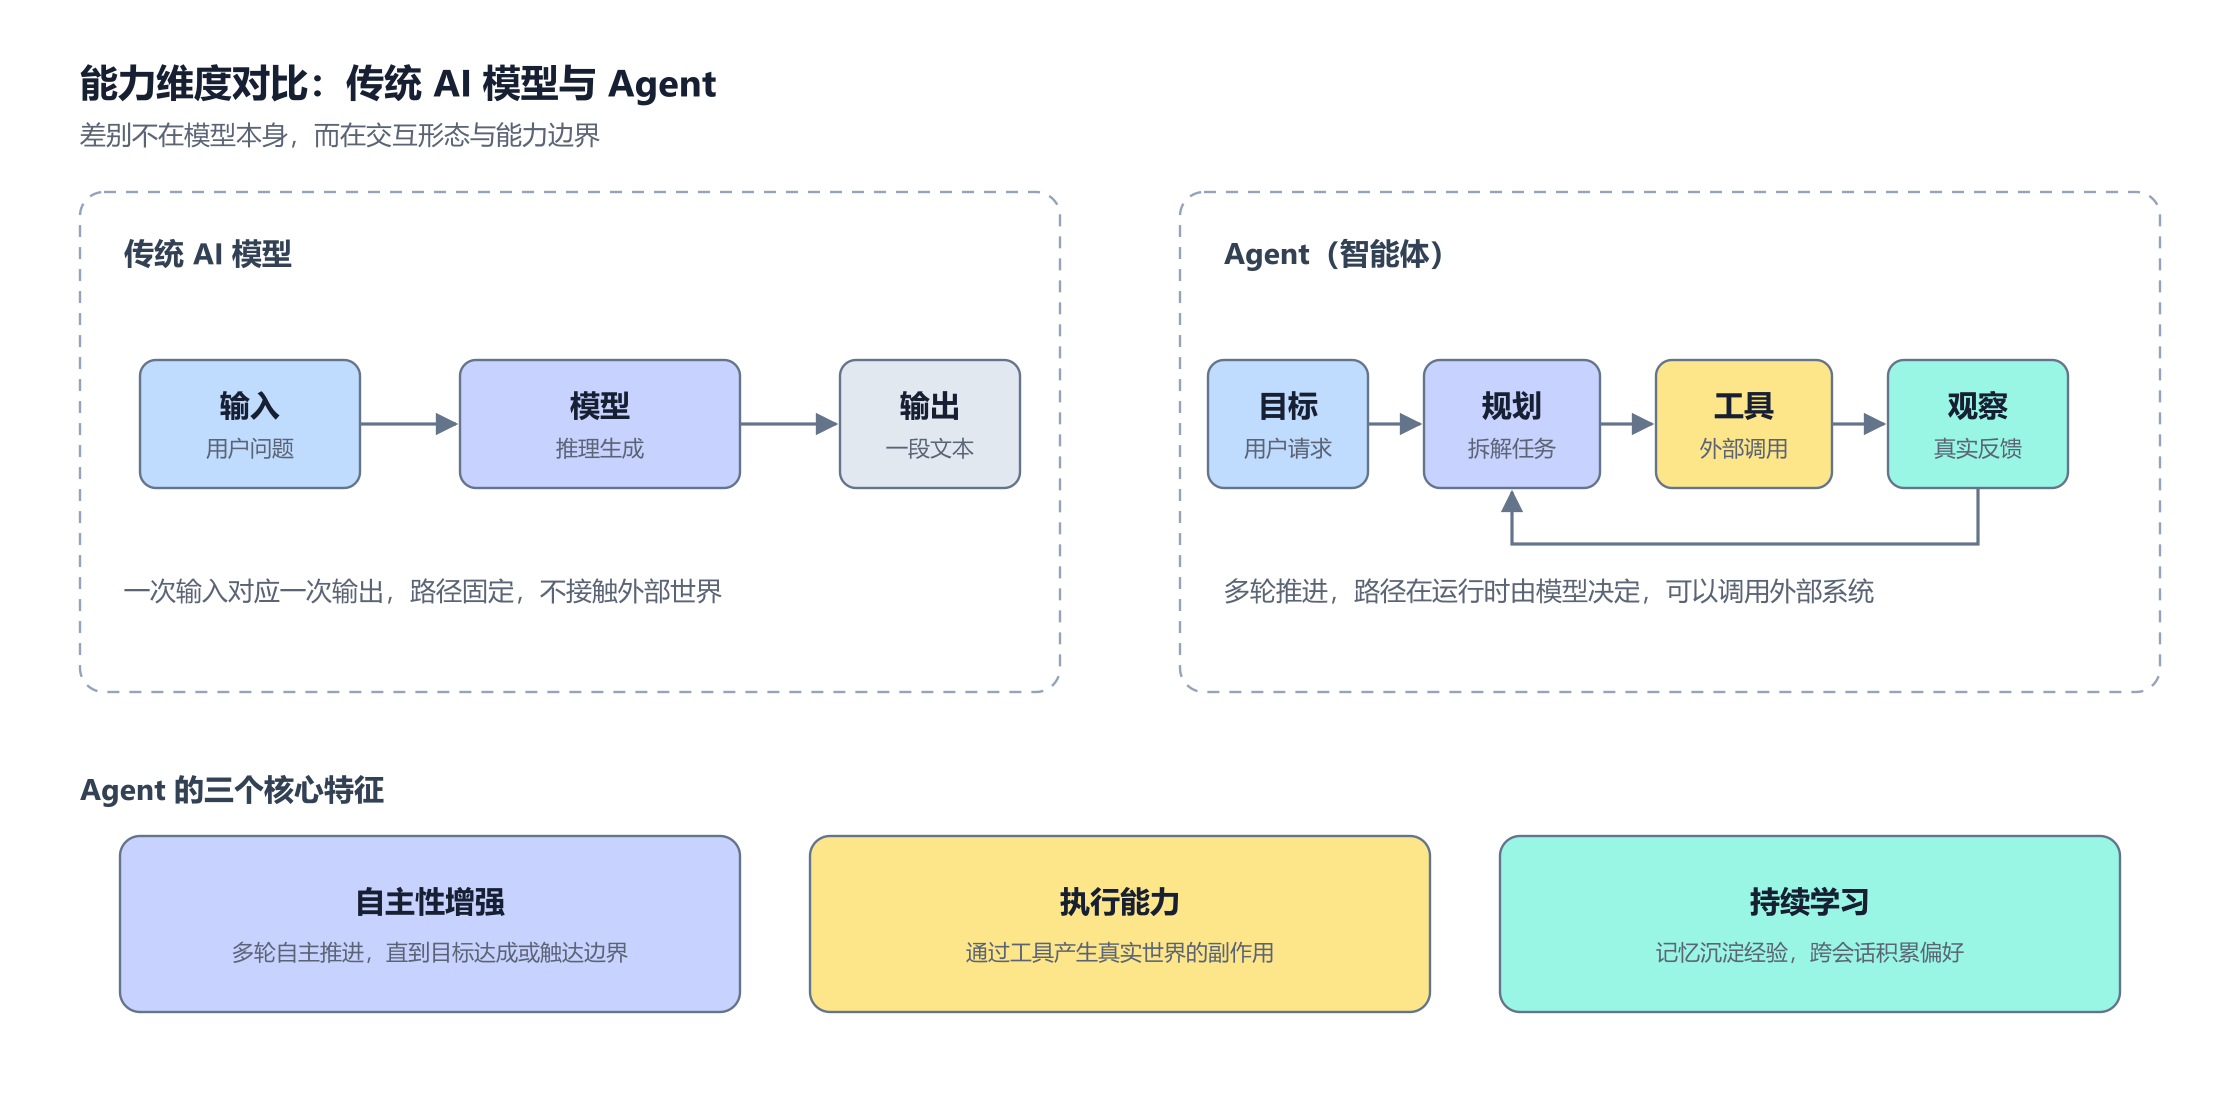
图 3:两者最直观的差别在交互形态。左边是"输入 → 模型 → 输出"的直线,右边是带反馈回路的循环。
展开成维度表:
| 维度 | 传统 AI 模型 | Agent |
|---|---|---|
| 交互形态 | 单轮问答,一次输入一次输出 | 多轮自主推进,直到目标达成或触达边界 |
| 决策主体 | 开发者预先写死流程与分支 | 模型在运行时根据观察动态决定路径 |
| 能力边界 | 限于模型内部知识与训练截止时间 | 通过工具延伸到实时信息、私有数据和外部系统 |
| 状态管理 | 基本无状态,会话之间互不相干 | 短期记忆维持连贯,长期记忆积累偏好与经验 |
| 错误处理 | 出错即返回错误 | 观察结果后自我修正、换策略重试 |
| 产出物 | 一段文本 | 文本 + 真实副作用(文件、工单、数据变更、代码提交) |
| 失败模式 | 答错 | 答错、选错工具、参数错误、循环不收敛、越权操作 |
最后一行单拎出来说。Agent 的能力变强了,失败模式也跟着变多,而且新增的那几种大多不是"回答得不好",而是"做错了事"。能力越大,需要提前画好的边界就越多。
七、上生产前的六个问题
概念讲清楚之后,真正决定 Agent 能不能上生产的是下面这些细节。LangChain 官方已经为其中大部分问题提供了预置中间件,下面每条都标出对应的手段。
循环不收敛。 模型可能反复调用同一个工具,只在参数上做微小调整,或者陷入"查了觉得不够、再查还是不够"的循环。这其实是官方文档里 GRAPH_RECURSION_LIMIT 这个错误最常见的成因。分层防御:recursion_limit 兜底(触顶抛异常),ToolCallLimitMiddleware 与 ModelCallLimitMiddleware 做成本闸门(优雅停止),再自己写中间件检测重复调用。连续两轮拿到相同或高度相似的观察结果时,强制中断比继续烧 token 划算。
上下文膨胀。 每一轮的工具返回都会塞进上下文。官方在讲 FilesystemMiddleware 时把上下文工程称为"构建有效 agent 的主要挑战",并点明诱因:web_search、RAG 这类返回长度不固定的工具,长结果会迅速吃掉上下文窗口。官方对策按代价排序是裁剪消息、SummarizationMiddleware 摘要、ContextEditingMiddleware 清理旧工具输出。工程上还应该把大结果落到外部存储,官方 Deep Agents 的做法就是超长工具结果自动落到文件系统,上下文里只留摘要或引用。
工具设计比提示词更影响成败。 描述模糊,模型选错工具;参数 schema 太宽松,模型传错类型;工具数量过多,选择准确率随之下降。前面引用过官方那句话:工具的名字、描述和参数名都会成为模型提示词的一部分。所以这是提示词工程,不是注释工作。工具多到一定程度时,官方还有个 LLMToolSelectorMiddleware,先用一个 LLM 筛出相关工具再交给主模型。
错误级联。 一步的幻觉会被后续步骤当成既定事实继续推理,越走越偏,最后交付一个看起来很完整但根基错误的结论。官方推荐分层处理:ToolErrorMiddleware 把工具异常转成模型看得见的错误消息,让它自己修正参数重试(注意别把原始异常信息直接透给模型,可能含敏感细节);ToolRetryMiddleware 处理瞬时故障;关键节点用 HumanInTheLoopMiddleware 在写入类操作前强制暂停审批。
可观测性。 Agent 是不确定的多步系统。线上出问题时,如果没记录每一步的输入、输出、工具调用与耗时,连复现都做不到。官方给的方案是 LangSmith 追踪,前面提到的 checkpointer 还额外提供了状态级回放。有完整的 trace,才能判断该调 recursion_limit 还是该修逻辑。
权限与安全。 有了执行权,就有了破坏力。回到 4.2 节那句话:有些策略没法靠提示词保证,必须被确定性地强制执行。PII 脱敏、权限校验、审计日志都该做成中间件。最小权限、工具白名单、沙箱隔离同样不能省,官方 ShellToolMiddleware 提供了 Host、Docker、Codex 三级执行策略。一个能自主修改生产数据库的 Agent,如果没有边界约束,风险远大于它能带来的效率提升。
最后
回到最初那个类比。Agent 不是更聪明的大脑,而是大脑、手脚与循环机制的组合。
换成官方的话:Agent = Model + Harness。大语言模型提供推理能力,harness(工具、记忆、循环、中间件)把这种推理能力变成能在真实世界里自我修正地完成任务的系统。这几样缺一个,系统就会退化。没有工具,它只是个能说不能做的聊天机器人;没有循环,它只能一次性作答;没有记忆,它每次都从零开始;没有中间件,它的行为没人管得住,也没人查得清。
这些能力的实现路径,最后都要落回提示词模板与系统设计:怎么描述任务、怎么描述工具、怎么组织上下文、怎么划定边界。官方那句 harness 的定义,"在对的时刻把对的上下文交给模型",基本就是这句话的英文版。
搭 Agent 的时候有三个问题值得反复问:决策发生在哪一步?它依据什么信息做出判断?边界在哪里?
有一说一,第三个问题最容易被跳过。
参考资料
文中的框架定义、API 参数、中间件能力与工程建议都对照过以下官方文档:
| 主题 | 官方文档 |
|---|---|
Agent 定义、create_agent 参数、内置能力 |
Agents --- Docs by LangChain |
| 快速上手与完整示例 | Quickstart |
短期记忆、checkpointer、上下文压缩 |
Short-term memory |
长期记忆、store、namespace/key 结构 |
Long-term memory |
依赖注入、context_schema、ToolRuntime |
Runtime |
| 预置中间件全清单(重试/摘要/PII/HITL 等) | Prebuilt middleware |
recursion_limit 与循环上限 |
GRAPH_RECURSION_LIMIT |
| 环境变量加载模型、批处理与流式 API | LangChain 1.0 入门(七):批处理、并发控制与流式传输(作者:艾醒,CC 4.0 BY-SA) |
官方文档更新频繁,参数签名与版本门槛(如
ToolErrorMiddleware需langchain>=1.3.14)可能随版本变化。落地前建议直接查官方 API Reference,或接入官方提供的文档 MCP 服务获取实时内容。