- 用一句话来概括
对于移动双传感器 中分辨率不同以及跨模态 错位共存的问题,本文提出了BeyondFusion****自对齐潜扩散框架 ,在不需要估计变形场、不需要做几何配准的情况下,实现了可见光引导下的红外超分辨率 以及红外-可见光融合 。该方法在公开基准 、合成错位 和真实的手机拍摄场景 下都具有较好的鲁棒性,并且提高了下游的人脸检测准确率。
- 论文信息
-
英文题目: BeyondFusion: Self-Aligned Latent Diffusion for Calibration-Free Infrared Super-Resolution and Infrared-Visible Fusion | 面向无标定红外超分辨率与红外-可见光融合的自对齐潜扩散
-
发表: arXiv 2026
-
**作者:**Minchong Chen1、Xiaoyun Yuan1*、Minyu Cao、Jianing Zhang、Jun Zhang、Shuyang Liu*、Xiaokang Yang
-
作者单位:
-
上海交通大学计算机学院、人工智能研究院、教育部人工智能重点实验室
-
清华大学
-
南开大学现代光学研究所
- 论文摘要
目前可见光引导红外超分辨率 以及红外-可见光融合 的方法大都采用像素级对齐的方式,但是真实的移动设备上的双摄像头之间存在着视角、视场、分辨率以及曝光时间的不同。BeyondFusion 将这两个问题合并到一个潜空间 生成的过程中来解决,并且使用了跨模态自对齐模块 (CMSA ),使得两种模式可以在自注意机制下建立起一种模糊的关系,之后再加上错位增强 和单步潜扩散技术,在保持热信息的同时也加入了可靠的可见光结构和语义线索。
- 核心创新点
创新一:两个任务共用一个生成框架
论文把可见光引导红外超分辨率 以及红外-可见光融合 看作一个跨模态的过程的不同结果,并且可以单独进行训练也可以一起在前向过程中被优化和生成。
创新二:注意力实现跨模态自我对齐
CMSA 将红外和可见光潜令牌放到一起用共享自注意序列来传递信息,并且不需要再做对齐矩阵、形状场或者几何变换这样的事情了,这样就可以避免由于错位造成的重影、重复边沿以及结构变形等问题。
创新三:未标注数据进行训练和验证
论文用平移、缩放、旋转和透视变换来模拟空间偏差,并且在公开的数据集、合成错位 的数据集、真实的双目相机运动以及下游的人脸检测任务中对模型进行检验,而不仅仅是在理想的配准输入下进行测试。
- 方法详解
5.1 问题描述和整个结构
输入的是没有经过几何校正或者没有进行硬件同步的红外图像 和可见光图像 ,产生的是高清晰度的红外图象 和融合图像 。Variance autoencoders(VAE)把两种模式进行编码之后再把模式维度折叠到批次维度上:
其中, 为VAE编码器, 为批大小, 用两种方式来说明,、、 分别是潜特征所经过的通道数目、宽度以及高度。
公式解读: 此方法保证了预训练扩散U-Net 的输入尺寸不发生变化,并且让二者以各自为独立样本的形式被对待,在CMSA所在的注意层才进行相互作用。
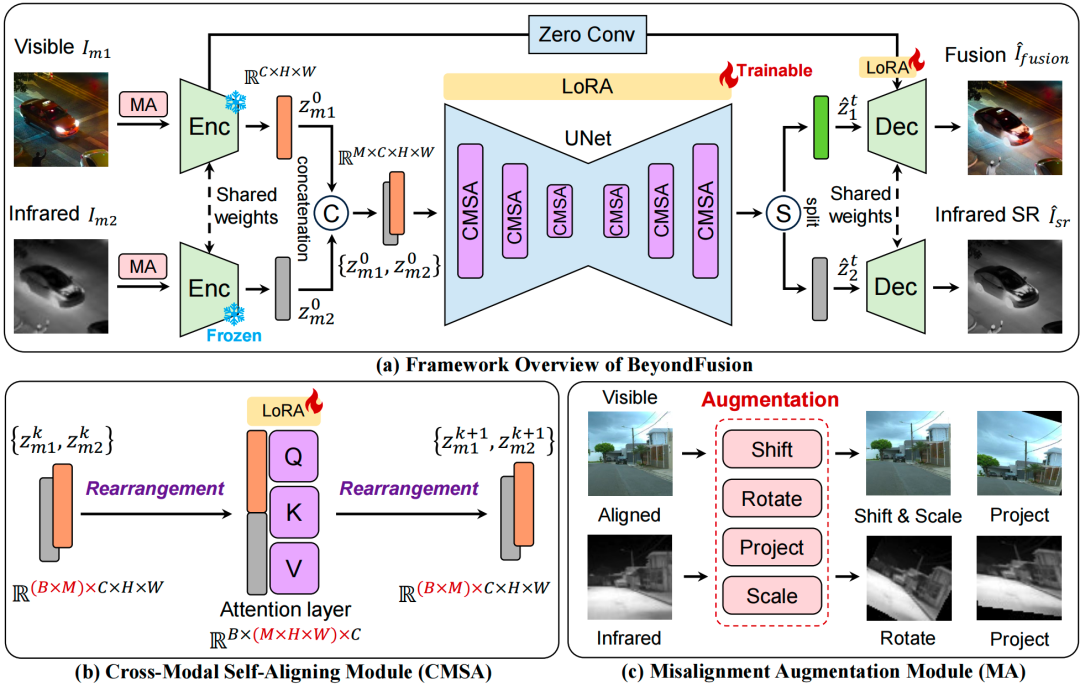
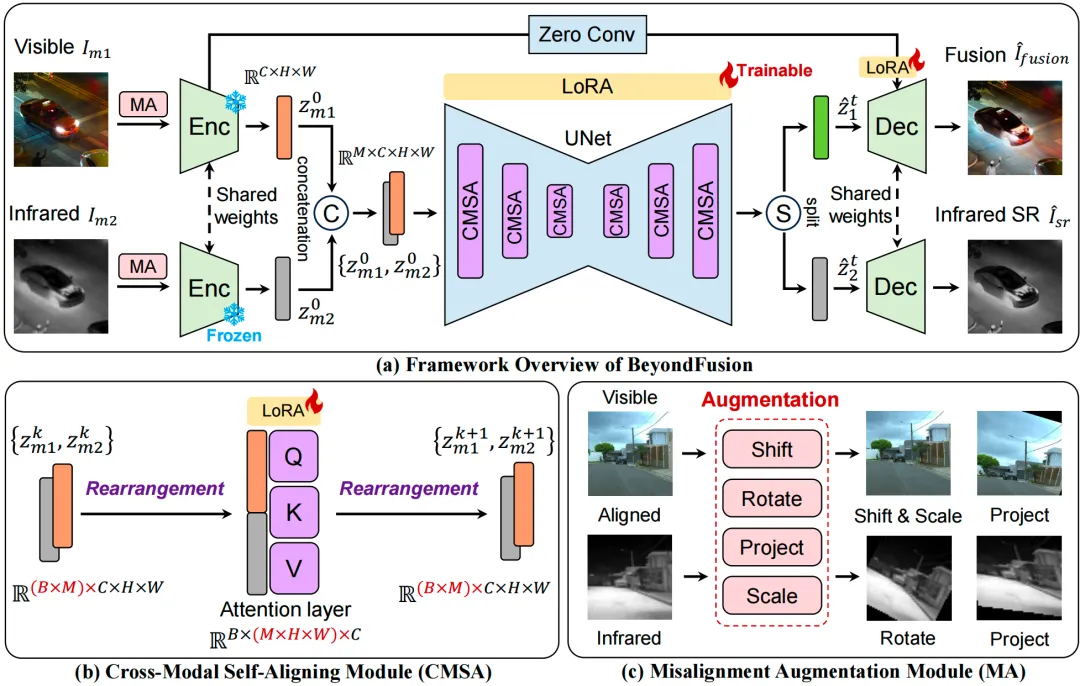
图 1:****BeyondFusion 的总体结构、CMSA 和错位增强模块;主要介绍双模态编码、共用注意机制交互、两条路径解码,并且有平移、旋转、透视和缩放增强。
5.2 跨模态自对齐模块CMSA
第 个自注意力层接受折叠后的特征 。CMSA 重新激活了模态维,并把这两种模态的空间令牌合并为一个序列:
其中,、、 就是这一层次上的特征尺寸, 使用的是原来的U-Net自注意力机制,查询、键、值和输出投影都沿用了原有的层,并且通过低秩适配来更新它们。
公式解读: 可见光和红外令牌在同一个注意空间里建立了软对应关系,模型会自己选择出哪些结构上的线索需要被传递下去,在此之后才会把原来的布局重新恢复好以便于后面的U-Net层进行工作。
5.3 双任务共用解码
去噪的结果分成超分和融合两条路径的潜在变量,然后用一个共享VAE解码器产生结果:
其中, 为共享解码器, 给出红外重建特征, 保留融合后的结构和颜色;四个解码器下采样的块特征被零初始化 卷积注入和解码块是一样的。
公式解读: 两个任务共用一个跨模态去噪过程以及解码器,并且通过不同的潜在变量和跳跃特征来获取结果,不需要创建两个独立的网络。
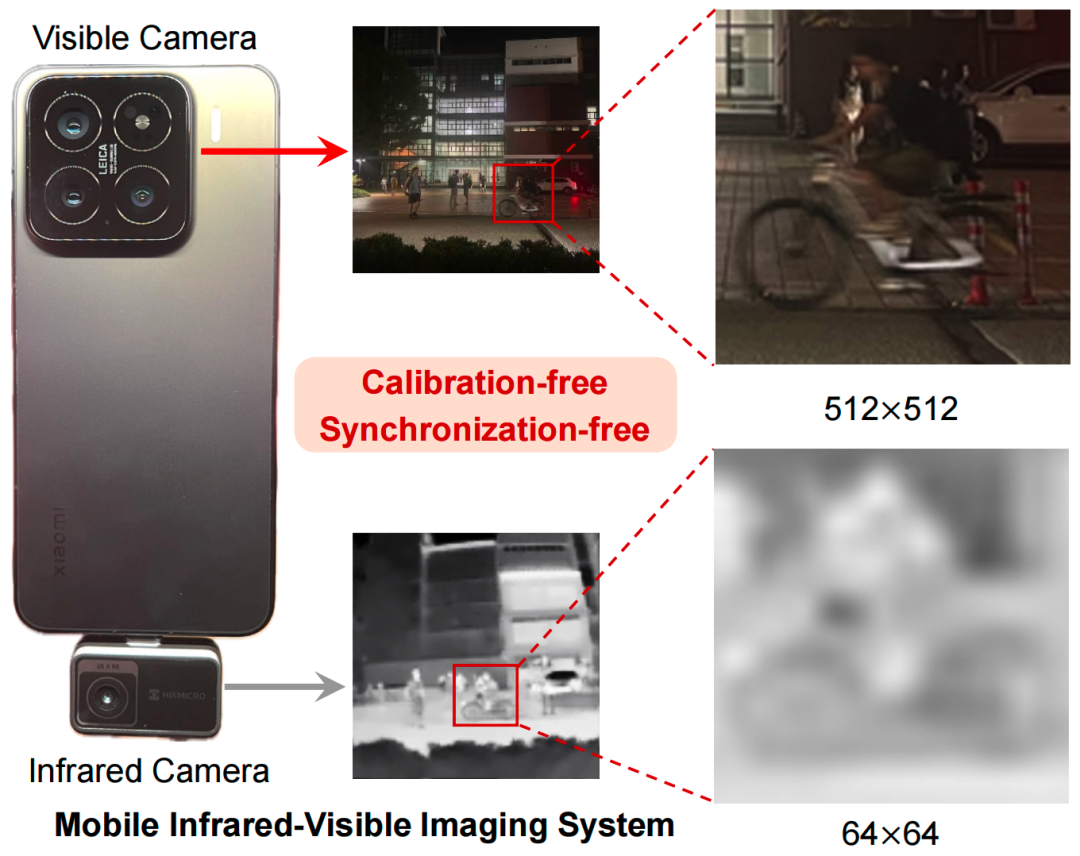
图 2: 真实的移动红外-可见光采集系统;两个摄像头没有进行校准以及同步处理,可见光部分的数据输入为 ,把红外输入标准化为 。
5.4 错位增强和分类器自由引导
在训练过程中给图像加上平移、缩放、旋转以及透视的变化,并且要防止模型记住固定的像素邻域,在推理的时候使用分类器自由引导的方法来指导:
其中, 与 为正负分支预测,正负样本的比例为 ,引导尺度 。
公式解读: 模型把潜空间放大大于正向目标和未超过分数以及没有融合的目标之间的差别,并且把这两种结果结合起来进行解码。
5.5 损失函数
其中, 与 既限制了重建误差又考虑到了感知相似性; 取YUV强度分量, 取色通道; 是Mask-Diffuser 生成了融合监督;,,其他部分的权重都是 。
公式解读: 超分支兼顾了像素保真和感知质量,而融合分支则更接近于融合监督下的亮度以及内容,并且可以从可见光输入中保留色彩信息。
❝
用一句话来概括这个方法就是: 不是先把两张图片硬性对齐,而是在两者扩散注意力的过程中使它们自己找到对应的点,并从中提取出超分辨率以及融合后的结果。
- 实验结果
6.1 实验条件
红外超分 用到的是IRVI 、LLVIP 、M3FD 以及PBVS2025TISR挑战赛第二赛道的数据,一共 对训练样本、 对测试样本;对于融合任务而言,采用MSRS 、M3FD 、LLVIP 和M3SVD 四种数据集,一共 对训练样本、 对测试样本。网络输入是 ,超分红外再降低抽样的频率至 ,加入高斯噪声之后再把输入放大一些,并且进行融合测试 、 和 红外源 。用的是Adam算法,学习率为 、批大小 ,使用一张NVIDIA A800单卡,在 GB GPU 上进行训练时,U-Net 和VAE 解码器的LoRA 系数为 和 。该文没有提及训练轮次,超分辨率评价标准有PSNR 、SSIM 、LPIPS 、MUSIQ 和MANIQA 等五种,融合效果用EN 、SD 、SF 、SCD 以及AG 来表示,比较的方法有CoReFusion 、CoRPLE、SwinFuSR 、SwinPaste 、SeeSR、OSEDiff 、DifIISR 、CDDFuse 、Mask-Difuser 和C-OPDR等。
6.2 定量的结果
在红外超分 的情况下,带增强的BeyondFusion 得到最好的LPIPS ,PSNR 分贝值和结构相似性指数 ,MANIQA 、MUSIQ 都是次优级;和OSEDiff 、DifIISR 相比,PSNR 提高了 dB 和 dB。真实移动数据上的MUSIQ 、MANIQA 均为最佳。
在融合实验中,如果红外分辨率是 或 并且在进行输入对齐的时候,除了SCD 之外其他各项都表现最好;而在错位的 条件下,EN 、SD 、SF 、SCD 、AG 分别代表 、、、、,比C-OPDR更全面,后者分别为 、、、、。
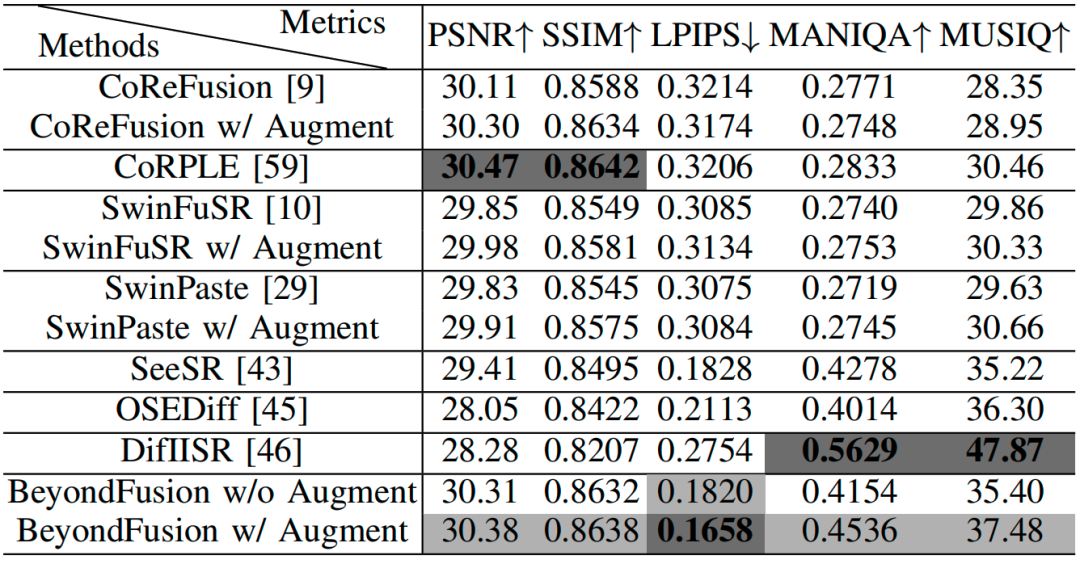
表 1:****红外图像超分辨率定性对比;灰度、浅灰度代表各项指标最好的和第二好的情况。
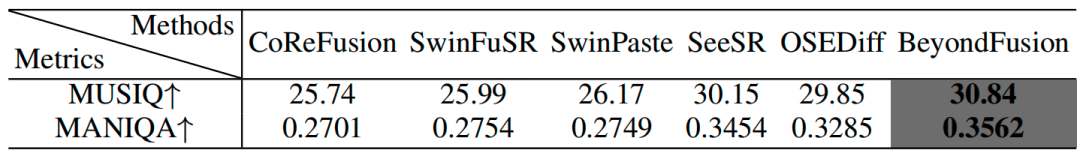
表 2: 用真实的移动红外数据集做无参考的图像质量对比。
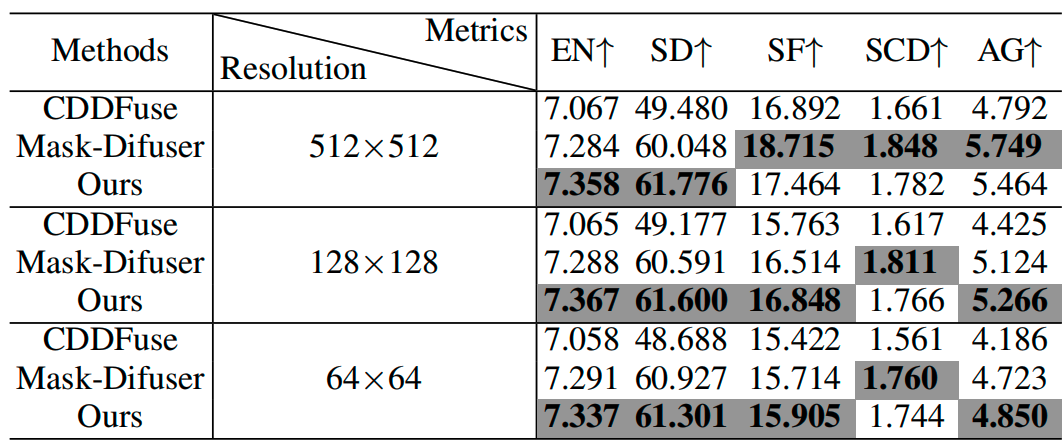
表 3: 对比三种不同分辨率的红外和RGB图像融合的效果。
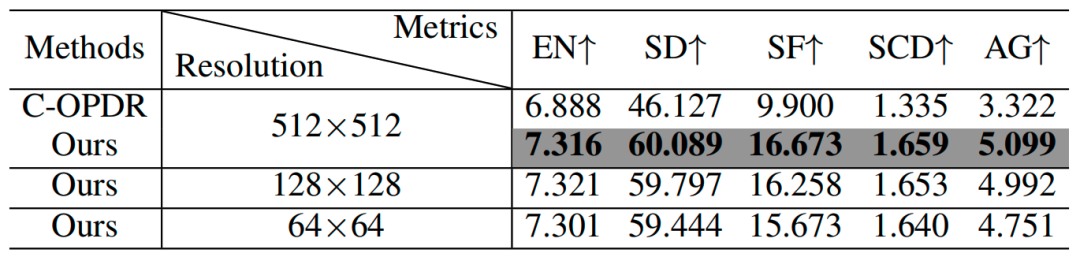
表 4: 错位红外-RGB图像融合效果对比。
6.3 定性的结论
在公开测试集中,非扩散的方法很容易过度平滑,而部分扩散的基础线会产生尖锐但是结构不一的细节;BeyondFusion更清楚地还原出建筑物支架、道路指示牌、电线杆以及树木等细微之处,在视角偏差、低红外分辨率以及可见光炫光的情况下仍然可以降低错位高亮、重影以及碎裂纹理,并且保留人物轮廓和衣服纹理。
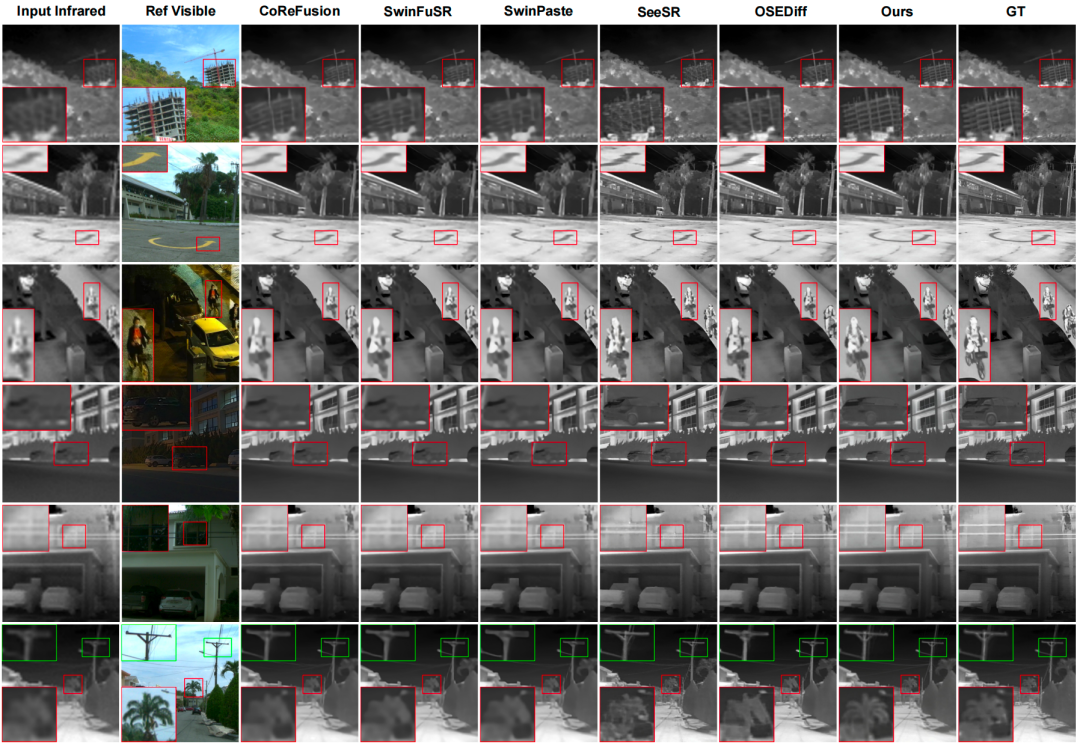
图 3: 测试集红外超分 定性对比;BeyondFusion 使得红外图像更加清晰,并且与真实情况更为接近。
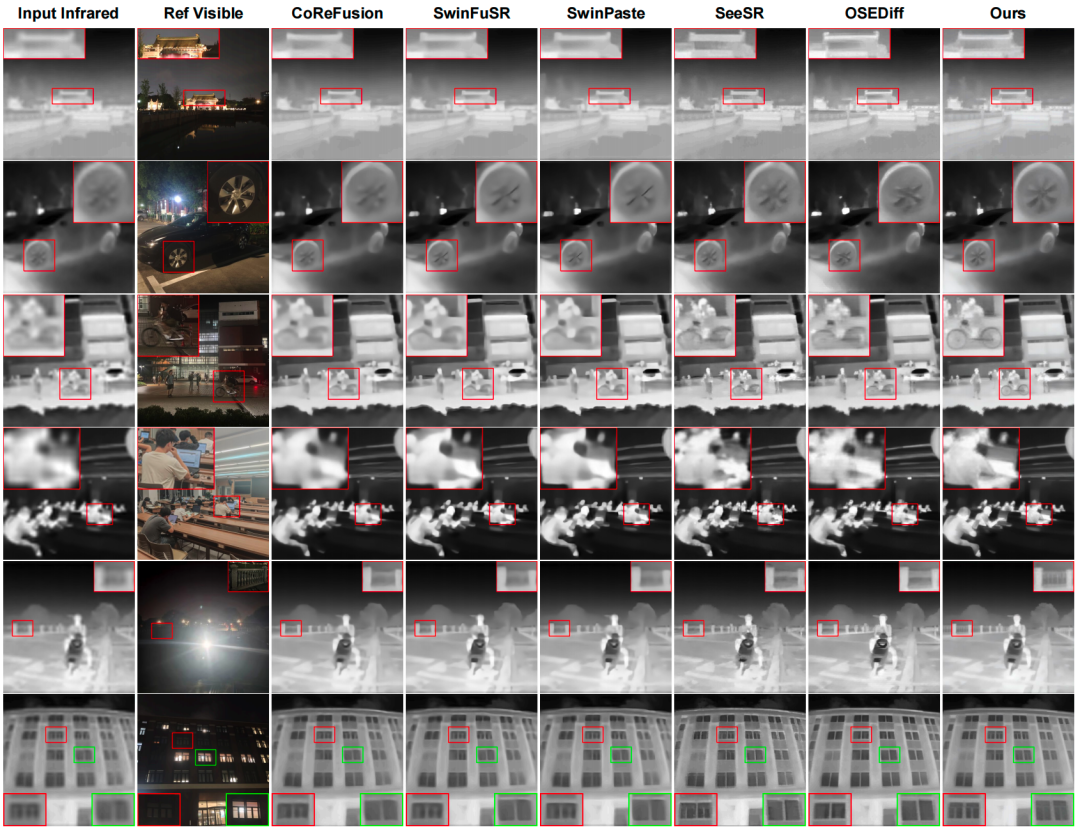
图 4: 真实的移动数据上进行红外超分辨率对比实验,并且要体现出该模型对于没有被校准的数据也能很好的进行推广的效果。
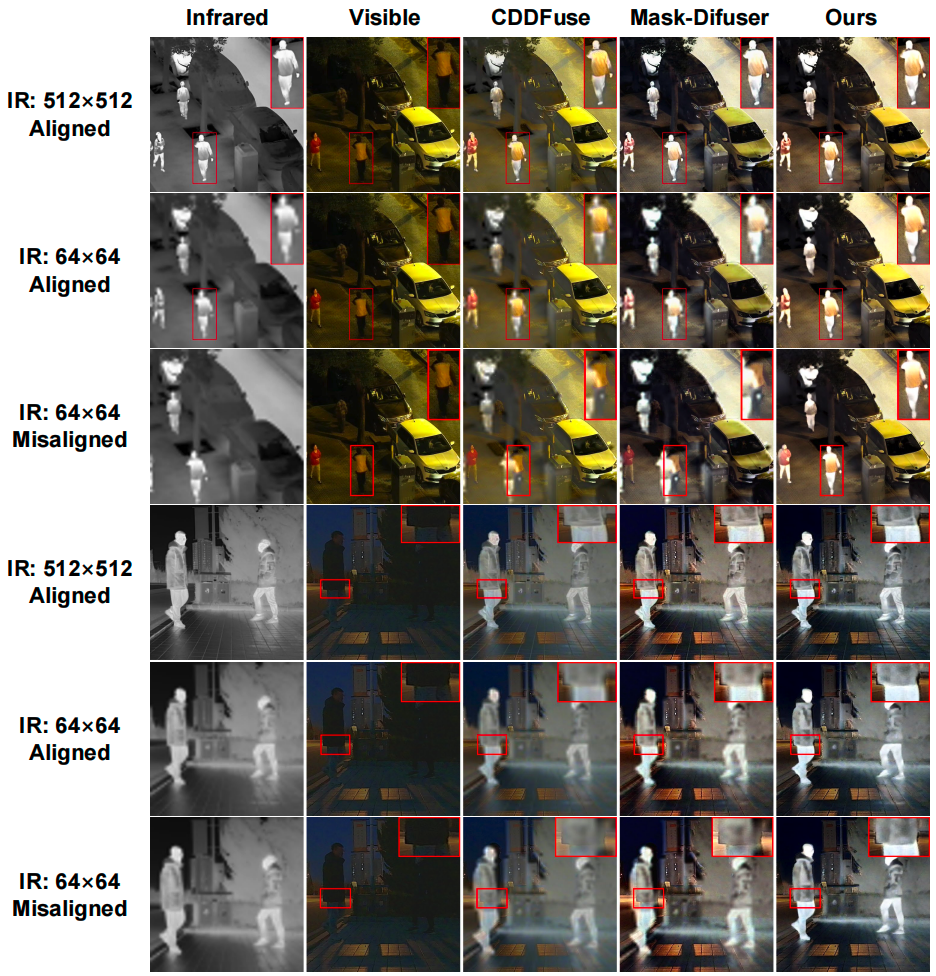
图 5: 在对齐、低分辨率以及错位的情况下进行融合比较,并且主要看边缘和纹理是否完好无损。
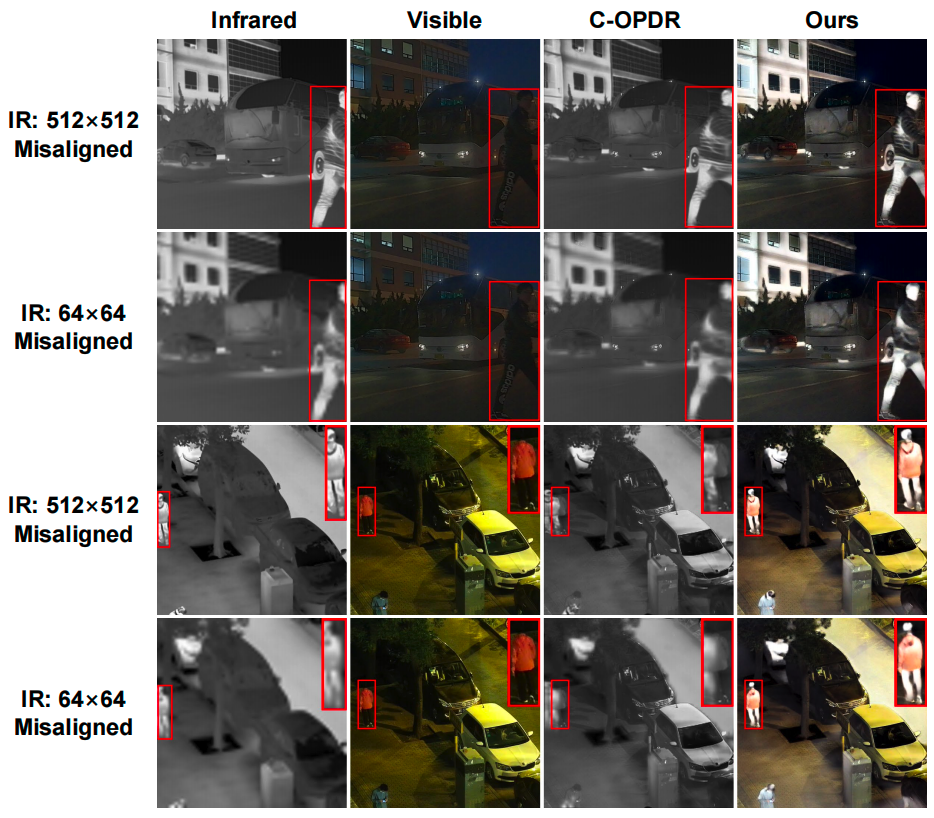
图 6: 合成未对齐的输入融合比较;BeyondFusion在错位以及分辨率降低的情况下仍然能较好地保留出热显性和可见光结构。
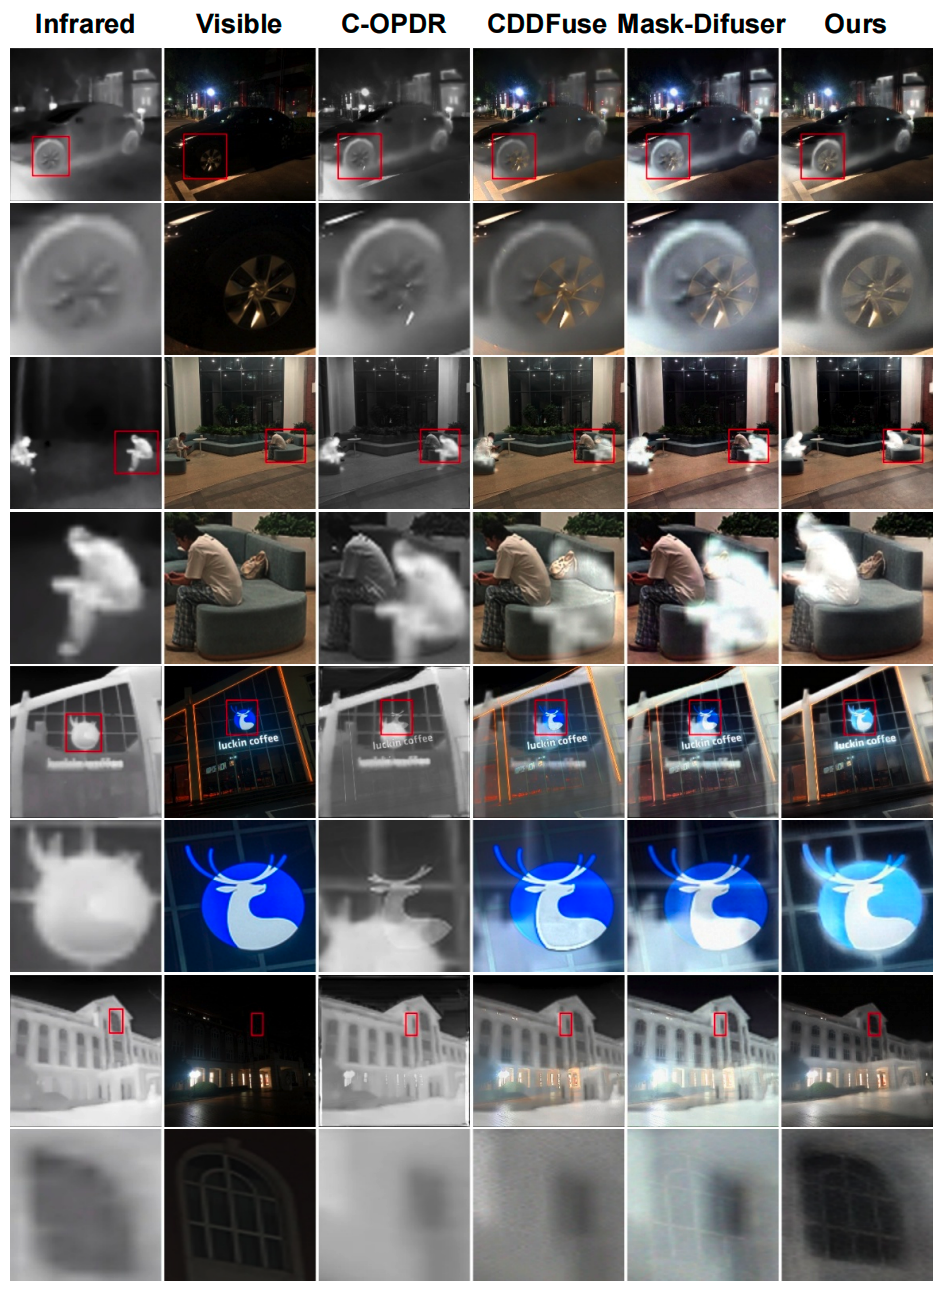
图 7: 真实的手机数据上进行红外和可见光的融合对比,并且可以证明该模型对于实际存在的红外错位图具有较好的鲁棒性。
6.4 下游的任务结果
本文用到的是Grounded-SAM 进行预训练,并且通过设置相同的文本提示词"人",实现了零样本的人脸检测 。在对齐的 红外输入 情况下,BeyondFusion 的 为 ,与CDDFuse 、Mask-Difuser 相比提高 至 ;在错位的情况下对应的结论是 ,与C-OPDR相比提高 至 。
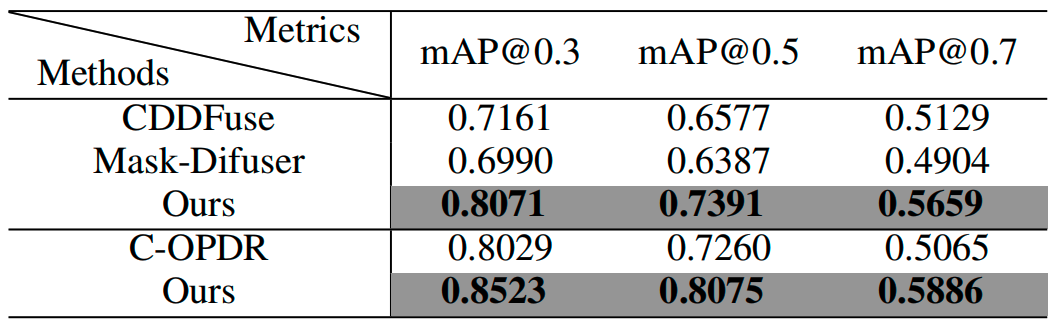
表 6: IoU 阈值是 、 和 时的人脸识别技术相比。
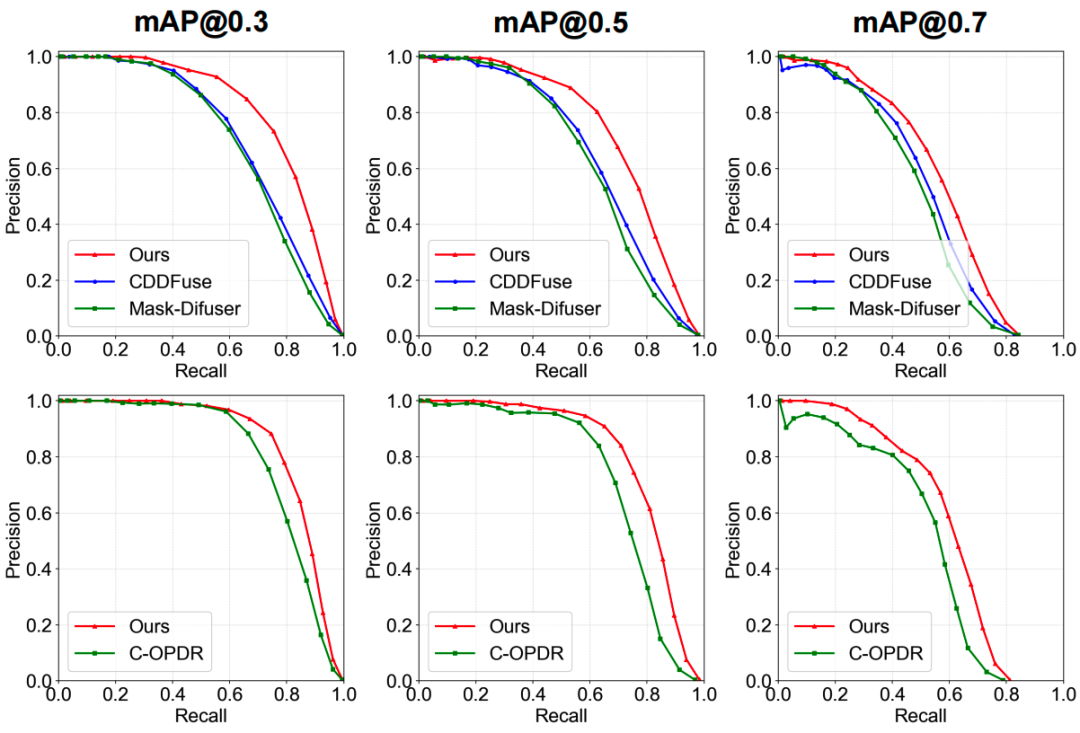
图 8: 在三种不同IoU阈值下的人脸识别准确率-召回率曲线图。
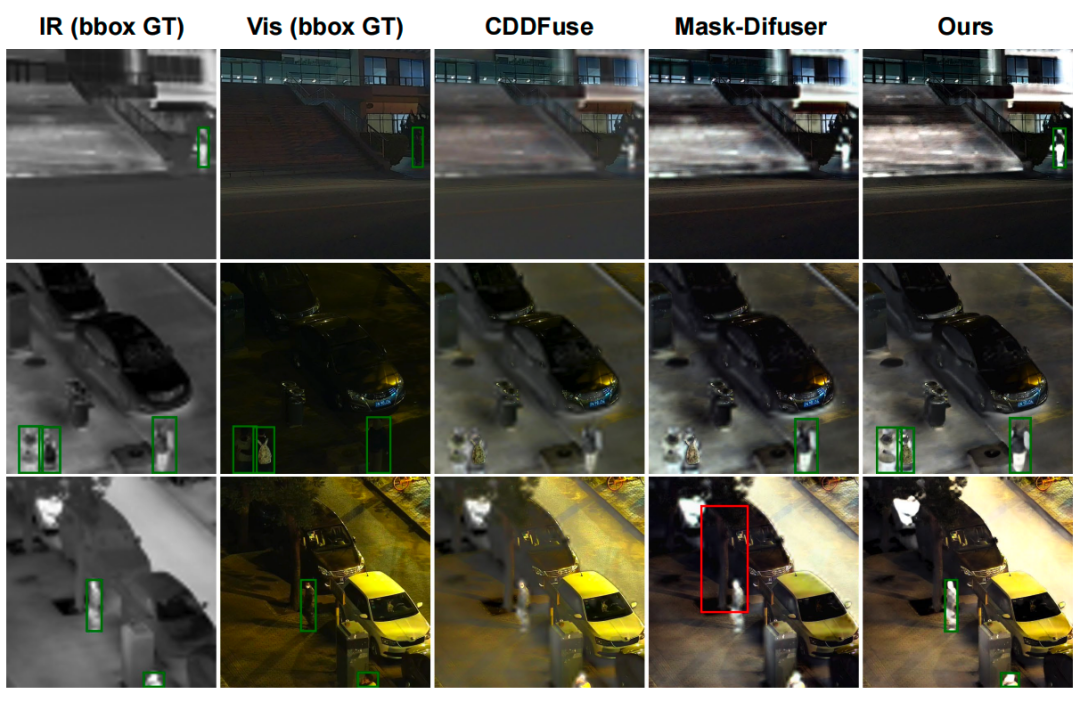
图 9: 和CDDFuse 、Mask-Difuser等方法相比,绿色框表示正确的识别结果,红色框表示错误的识别结果。
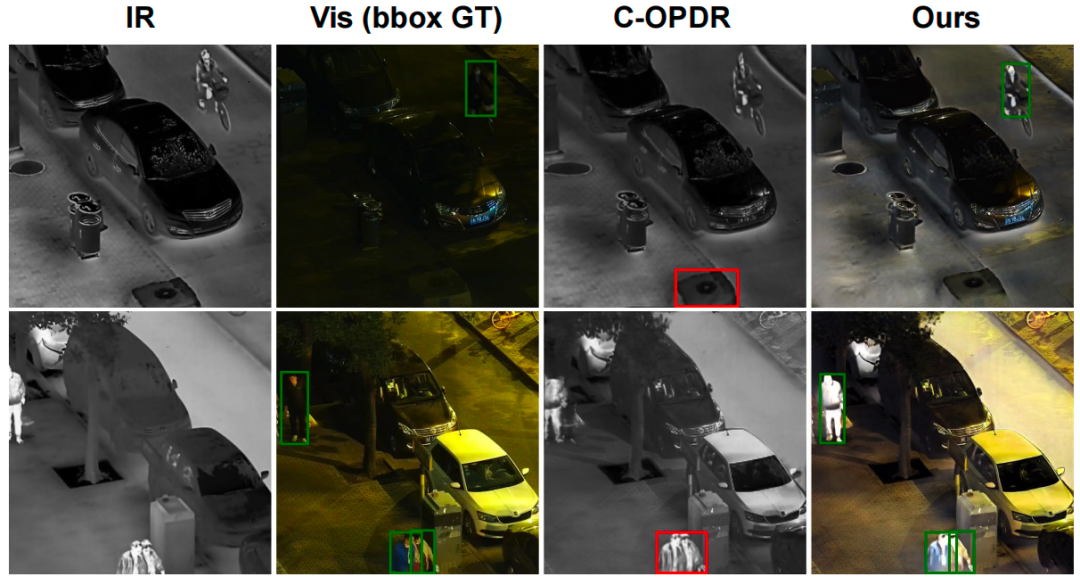
图 10: 和C-OPDR的检测可视化的不同之处;在错位情况下行人结构以及检测的结果。
6.5 联合训练和消融实验
联合训练得到的结果是PSNR 分贝值和结构相似性指数 、LPIPS ,比单独训练时稍低,后者为 dB、、。EN融合联合训练之后稍微大一些, 对 ,其他各项指标也都有所降低,表明共享框架的成本很小。
CMSA 全部的时候,LPIPS 在去除错位增强 之后从 降至 ,MUSIQ 从 提升至 ;特征拼接版本的整体效果最差,在融合消融实验里加入了错位增强 和CMSA 之后SCD 从 提升至 ,但是没有增强版的EN 、SD 、SF 、AG数值更高的情况说明各个单项都没有可以参照的标准,并不是所有的一起好转。
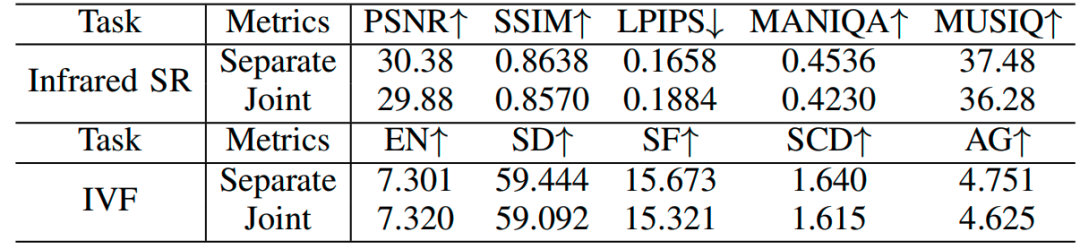
表 5: 两种方式即单独训练和联合训练所得到的结果进行对比。
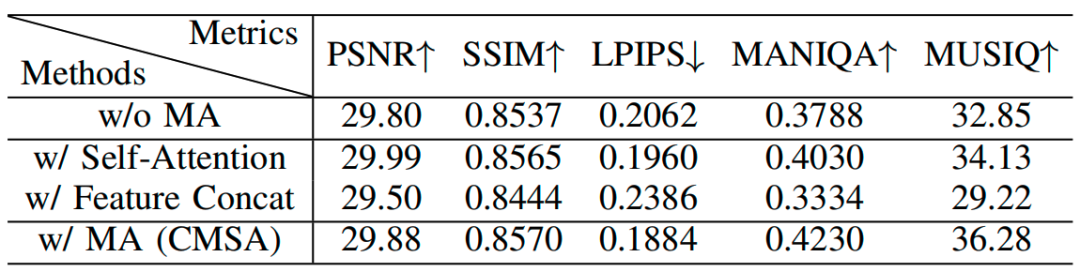
表 7:****BeyondFusion 组件和交互方式对于红外超分任务的消融分析。
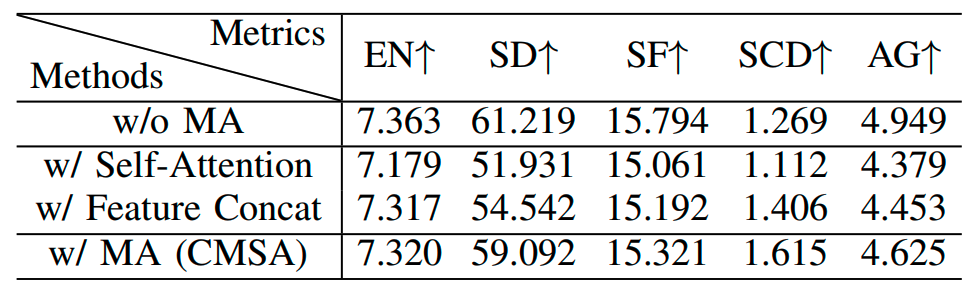
表 8:****BeyondFusion 组件和交互方式对于红外-可见光融合任务的消融情况。
- 总结和展望
总结
BeyondFusion 将红外超分 辨以及红外-可见光融合 都放在一个共享的潜在扩散空间里,在此空间下使用CMSA 使得不同类型的令牌可以在注意机制中进行隐式的交互,并且通过错位增强 来提高对真实运动拍摄场景的适应能力。公开基准 、真实的双目摄像头数据以及行人检测等结果都显示出了这样一个事实:不需要显式的像素配准就可以同时获得红外结构恢复的效果、融合的质量以及高层次的任务的价值。该文还给低层次视觉的设计提供了一个新的思路,即用共享生成的过程来组织各种各样的模式、分辨率和退化的观察。
❝
一句话总结:****BeyondFusion 最重要的贡献就是把"先配准后融合"的方式改为"在潜空间 里一边生成一边自我对齐",并且同一个模型可以同时处理红外超分和融合的结果。
往期推荐