57.5% 的"用户满意"其实是任务失败:你的 LLM 评测可能全是假的
现在做 Agent 评测的标准配方是:用一个 LLM 扮演用户去撩你的 Agent,再用另一个 LLM 当裁判给对话打分。 便宜、快、可扩展,不用人标注。
亚马逊的两篇论文把这个配方拆了。
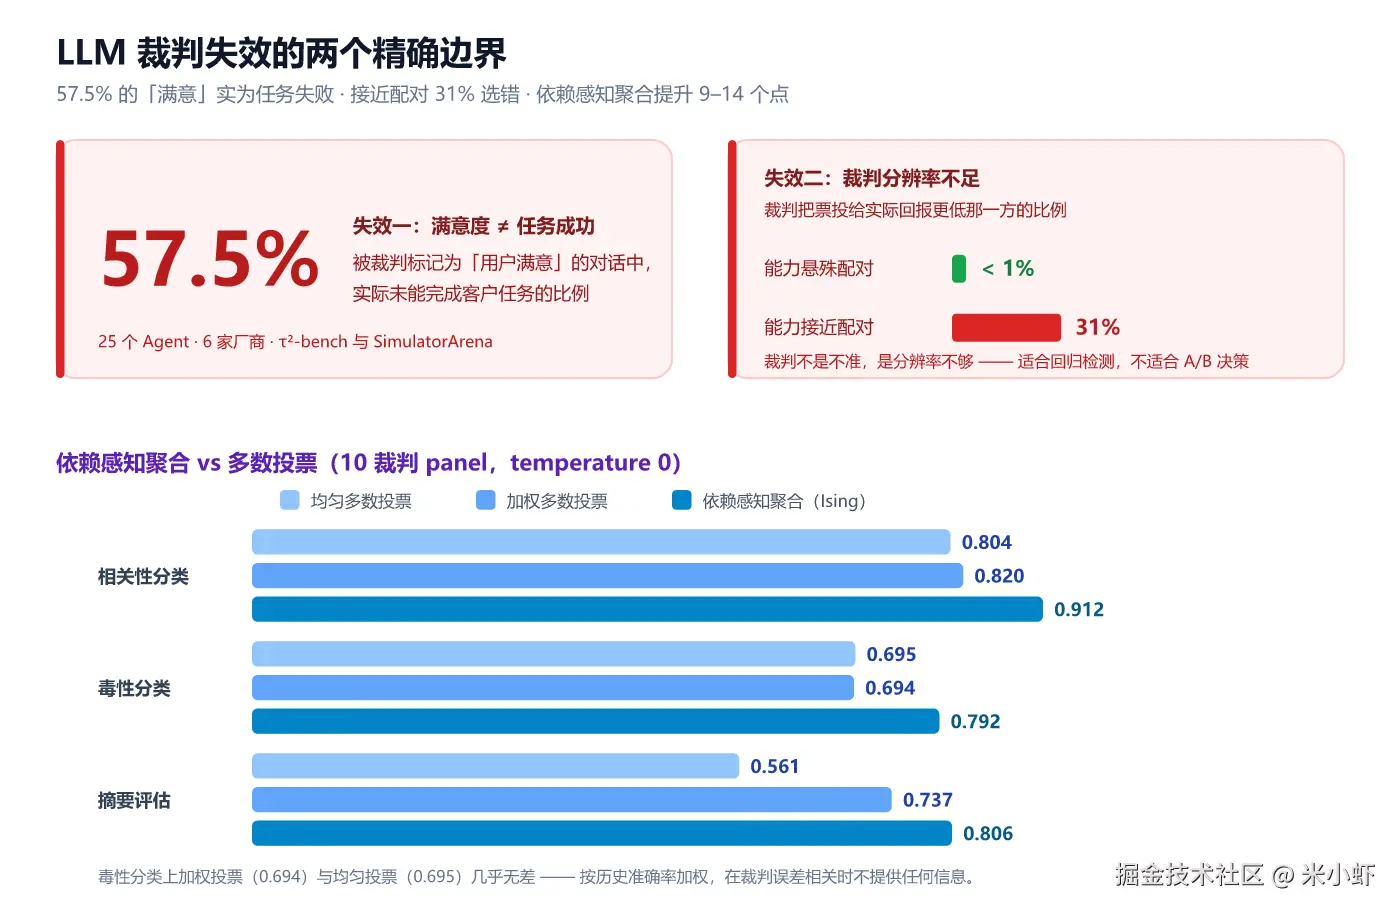
第一篇用 25 个 Agent(来自 6 家厂商)、在 τ²-bench 和 SimulatorArena 上跑了一遍,结果是:裁判标记为"用户满意"的对话里,57.5% 其实没完成用户的任务。 而当两个 Agent 能力接近时,裁判在 31% 的配对上把票投给了实际回报更低的那个------同一个裁判,在能力悬殊的配对上出错率不到 1%。
第二篇(ICML 2026)从原理上解释了为什么会这样,并给出了修法:多裁判多数投票的隐含假设是"各裁判的误差相互独立",而现实是同一谱系的模型在重复同一个错误。 他们用 Ising 模型建模裁判之间的成对相关性,在三个任务上把准确率从 0.820 / 0.694 / 0.737 提到 0.912 / 0.792 / 0.806。
这篇文章讲清楚三件事:评测在哪些地方具体失效、背后的统计假设错在哪、以及明天上班就能做的修复。
一、旧范式的原罪:一个没人检查的"条件独立"假设
先说一个几乎所有 LLM-as-judge 流水线都在用、但没人写下来的假设。
erlang
  多数投票(uniform majority vote):

      10 个裁判,8 个说"通过",2 个说"不通过"
      → 结论:通过(置信度看起来像 80%)

  加权多数投票(weighted majority vote):

      按历史准确率给每个裁判加权,再投票
      → 结论:通过(置信度看起来更高)
这两种做法都建立在同一个简化模型上:
css
      假设:P(裁判 i 判错 | 裁判 j 判错) = P(裁判 i 判错)

      即:裁判们的误差是条件独立的
这个假设对 LLM 裁判几乎必然不成立。 原因不是玄学,是工程事实:
| 共享来源 | 导致的后果 |
|---|---|
| 同一个 prompt 模板 | 对评分标准(rubric)的解读方式一致 → 一起判错 |
| 同一训练谱系 / 模型家族 | 对同一类措辞敏感 → 一起判错 |
| 相同的 few-shot 示例 | 继承同一套评估偏见 → 一起判错 |
| 同一个基座模型的不同微调版 | 盲区高度重合 → 一起判错 |
于是"8 票赞成"里可能只有 2 个独立证据,其余 6 票是同一个错误的回声。票数让证据看起来比实际强得多。
css
  看起来:  ✓ ✓ ✓ ✓ ✓ ✓ ✓ ✗ ✗   = 8 票独立同意
  实际上:  [A][A][A][A][A][B][B][C][C]
            └─── 5 票同一个错误 ───┘└─2─┘└─2─┘
                                    = 只有 3 个独立信源
二、失效一:满意度 ≠ 任务成功(57.5%)
亚马逊的第一篇论文直接压力测试了"LLM 用户模拟器 + LLM 裁判"这套组合。规模:25 个 Agent、6 家提供商、τ²-bench 与 SimulatorArena 两个基准。
结论的第一部分是:
57.5% 被评为"满意"的对话,实际上未能完成客户的任务。
为什么会这样?因为裁判看到的是对话的表面质量(礼貌、流畅、像模像样地确认需求),而任务是否真正完成,需要对照一个外部状态------订单有没有下、退款有没有发起、数据库有没有更新。
LLM 裁判擅长判断"这段话像不像一次好的服务",不擅长判断"这件事到底办没办成"。 这两件事在大多数情况下相关,但在关键的失败案例上完全脱钩:一个把用户糊弄得很舒服、但什么都没做的 Agent,恰恰是裁判打分最高的那种。
这里有个更狠的推论:用 LLM 裁判优化 Agent,本质上是在优化"让裁判觉得舒服"这个代理目标。 如果你的奖励信号是"用户满意度评分",你会稳定地训练出一个更会道歉、更会确认、更会总结,但任务完成率不变的 Agent。
三、失效二:接近的候选,裁判基本分不对
第二部分是这个研究里最有用的数字,因为它给出了失效的精确边界。
| 两个被比较的 Agent | 裁判选错的比例 |
|---|---|
| 能力悬殊的配对 | < 1% |
| 能力接近的配对 | 31% |
裁判不是"不准",是"分辨率不够"。 当差距大时它很可靠;当差距缩到某个区间内,它的判断退化成接近随机,而且是在三分之一的配对上偏向错误的那个。
这个结论的工程含义极其重要,因为它决定了你什么时候可以相信评测结果:
css
  裁判可信区间                    裁判失效区间
  ├──────────────────┤├───────────────────────┤
  A 明显强于 B                    A 与 B 接近
  差异 > 阈值                     差异 < 阈值
  错误率 < 1%                     错误率 31%
  ✓ 可以用来做选型的粗筛          ✗ 不能用来做 A/B 决策
  ✓ 可以用来判断"有没有崩"        ✗ 不能用来判断"哪个版本更好"
换句话说:LLM 裁判适合做回归检测(有没有变糟),不适合做增量优化(哪个版本更好)。 而绝大多数团队恰恰是反过来用的------每天拿它比较两个只差一点点的 checkpoint。
四、失效三:裁判偏袒自家
同一项研究还观察到:裁判倾向于给同模型家族的 Agent 更高的分。
这是自偏好(self-preference bias)的一个直接实例,也是最容易被利用的一种------如果你知道评测用某个家族的模型做裁判,那么选用同家族模型做 Agent 就自带加分。
这一点在跨厂商对比时要特别小心:当裁判来自 A 厂商、被评的 Agent 也来自 A 厂商时,分数里有一部分不是能力。
五、原理层:把裁判团当成一个网络,而不是一堆投票器
现在讲 ICML 2026 那篇论文的解法。核心思想只有一句话:
把裁判团建模成一个网络------每个裁判有自己的可靠度,裁判对之间还有关系。
数学工具是 Ising 模型(统计物理里表示二值变量间成对依赖的经典模型)。在这个场景里,它同时学习两件事:
| 学习对象 | 含义 |
|---|---|
| 裁判的个体可靠度 | 这个裁判单独看有多准 |
| 裁判对的成对相关性 | 这两个裁判是不是在重复同一个错误 |
关键是它是无监督的------不需要人工标注的真值来训练。做法是把每个样本的真实标签当成隐变量,与参数一起推断:
css
  输入:M 个裁判对 N 个样本的二值判定  { y_ij },无 gold label

  隐变量:z_i ∈ {0,1}          第 i 个样本的真实标签
  参数:  θ_j                   裁判 j 的可靠度
          J_jk                  裁判 j 与 k 的成对依赖

  交替优化:
      1) 固定参数,用当前估计组合各裁判的投票 → 估计 P(z_i = 1)
      2) 固定 P(z),重新估计 θ_j 与 J_jk
      3) 重复至收敛

  真值标签只在最后用于"测量"实验准确率,不参与训练
两个变体:
- 标准模型 :假设裁判间的关系模式在正负标签上一致。最终决策仍是一个加权投票,但权重为相关性做了折减------可解释。
- 类别依赖模型(class-dependent) :允许关系结构随标签变化。适合"裁判在明确样本上广泛一致、在模糊样本上分裂成可识别的簇"这种情况。更有表达力,但需要更多数据来可靠估计额外参数。
六、实测:三个任务,9--14 个点的提升
实验设置:10 个裁判组成的 panel,temperature = 0(消除采样随机性,保证同输入必得同输出)。
| 任务 | 均匀多数投票 | 加权多数投票 | 依赖感知聚合 |
|---|---|---|---|
| 相关性分类(检索) | 0.804 | 0.820 | 0.912 |
| 毒性分类 | 0.695 | 0.694 | 0.792 |
| 摘要评估 | 0.561 | 0.737 | 0.806 |
三个读法:
① 摘要评估上均匀多数投票只有 0.561,几乎等于抛硬币。 而加权投票已经能到 0.737------说明这个任务上裁判质量差异极大,均匀投票把好裁判和差裁判等权了。
② 毒性分类上加权投票(0.694)和均匀投票(0.695)几乎没差。 这说明"按历史准确率加权"在这个任务上没有提供任何信息------裁判之间的误差是相关的,给一个"历史上很准"的裁判更高权重,只是在放大它所在那个簇的共同偏见。
③ 提升在三个任务上都稳定在 9--14 个点,且都来自同一件事:折减冗余的一致性。
论文也给了一句非常实用的话:这些提升需要足够的评估日志和足够大的裁判团,才能可靠估计裁判间的关系。 这不是一个"加两个裁判就能用"的技巧。
七、工程死结:这个方法什么时候会失效
把两篇论文的限制合起来,边界很清楚:
| 死结 | 说明 | 后果 |
|---|---|---|
| 需要足够大的 panel | 要估计 M 个裁判的 M(M−1)/2 对关系,10 个裁判就是 45 对 | 3--5 个裁判的小 panel 估计不出稳定结构 |
| 需要足够的样本量 | 依赖结构是从历史日志里估出来的 | 新任务、新领域冷启动期间不可用 |
| 类别依赖变体更吃数据 | 额外参数需要更多样本 | 小样本上标准变体更稳 |
| 只解决聚合,不解决裁判本身的能力上限 | 如果所有裁判都看不见"任务是否完成",加权也救不回来 | 57.5% 那个问题不会因为换聚合方式而消失 |
| 自偏好无法被统计方法消除 | 相关性建模能发现"这两个裁判总是一致",但不能告诉你它们一致是因为都对还是都偏 | 仍需跨家族裁判 + 人工抽检 |
最后一条最关键:依赖感知聚合是一个更好的"加权器",不是一个更好的"裁判"。 如果你的裁判根本观测不到正确的信号(比如它只能看到对话文本、看不到数据库状态),再好的聚合也只是把错误加权得更精细。
八、明天就能做的六件事
按性价比排序,前两条是论文明确点名的"廉价修复":
1. 加一个无裁判的完成位(completion bit)。 这是论文给出的最便宜的解法:不要靠裁判判断"有没有结束",用一个确定性的信号------比如轨迹是否自然终止、是否触发了结束工具、数据库状态是否变更。 光这一个 bit 就能抓住大部分截断类回归(truncation regression),而这恰恰是 LLM 裁判最常漏判的一类。成本几乎为零,收益确定。
2. 在与真值校准之前,不要信任裁判。 裁判的分数不是绝对量。先在一个有 ground truth 的小集合上测出它的偏差与分辨率阈值,再决定它的分数能不能用来做决策。校准之前的裁判输出是序数,不是基数。
3. 明确区分"回归检测"和"增量决策"两种用途。 用同一套裁判做这两件事是错的。悬殊对比错误率 <1%,接近对比 31%------把裁判用在它分辨率够的区间。
4. 跨模型家族组 panel,并记录谱系。 别用三个同源模型假装是三个独立裁判。记录每个裁判的家族、尺寸、训练来源,作为后续建模相关性的先验。
5. 用历史日志估计相关性,折减冗余一致。 如果你已经在大规模跑 LLM 裁判,你的日志里不只有投票,还有一致与不一致的模式。把这些模式变成信号------先做最简单的:算一下裁判对的皮尔逊相关,把高度相关的对合并计一票。完整实现再上 Ising。
6. 保留一个恒定的人工抽检集。 比例可以很小(1--2%),但它必须是恒定的------同一个集合,每次评测都过一遍。它的作用不是提供统计显著性,而是当所有自动指标同时漂移时,给你一个还在的锚。
九、我的判断
第一,57.5% 这个数字真正的杀伤力不在"裁判不准",而在"它精准地奖励了错误的行为"。 一个没完成任务但让用户感觉良好的 Agent,在这套评测里拿高分------这意味着你用这个信号做 RL,会稳定地优化出更好的糊弄能力。这比单纯的"评测噪声"严重得多:噪声只是让你看不清,系统性偏差会带你朝错误的方向走,而且走得越快越远。
第二,"悬殊 <1%、接近 31%"应该改变你对评测的定位。 LLM 裁判是一个低分辨率 仪器。低分辨率仪器不是坏仪器------用来检测"有没有崩"它非常好用,用来比较"哪个版本好 2 个点"它就是噪声源。绝大多数团队的错误不是用了裁判,而是把低分辨率仪器当高分辨率用。
第三,Ising 模型这个解法的真正价值是提供了一个可观测的量:裁判间的相关性结构。 即使你不实现它,"算一下我的裁判对之间有多相关"这个动作本身就有诊断价值------它能告诉你,你花三倍成本请的第三个裁判,到底带来了新信息,还是只是第二个裁判的回声。
第四,最该抄走的是那个 completion bit。 它提醒了一件容易被忘的事:能用确定性信号判定的事,永远不要交给模型去判。 "任务有没有结束"这种事,本来就该有个 bit,而不是让裁判读一遍对话去猜。在评测流水线里,这个原则应该被推到极致------凡是能写断言的,就别写 prompt。
参考
- Agent 评测失效研究 :25 个 Agent / 6 家提供商,τ²-bench 与 SimulatorArena;57.5% 误判、31% 接近配对选错、自偏好观察。经 AGI Hunt 于 2026 年 9 月 15 日汇总报道,具体论文标题与作者以原论文为准。
- 依赖感知聚合:Krishna Balasubramanian(UC Davis,Amazon Scholar)、Sasha Podkopaev(AWS)、Shiva Prasad Kasiviswanathan,《Dependence-aware label aggregation for LLM-as-a-judge via Ising models》,ICML 2026。实验为 10 裁判 panel、temperature 0。详见 Amazon Science 官方博客。
- 相关背景:τ²-bench(工具调用型 Agent 基准)、SimulatorArena;此前关于 benchmark 可复现性的讨论(如 LoCoMo 答案键错误率、judge 接受故意错答的比例)。
免责说明:57.5% 与 31% 等数字来自上述研究的报道汇总,本文按"据报道"口径引用,具体实现细节(judge 模型、prompt、任务子集)需以原论文为准。Ising 聚合的准确率数字来自论文在三个特定分类任务上的实验,迁移到你的任务前需重新校准。