摘要:AI 全栈面试中,RAG 检索增强生成项目几乎是必问项目。河南宁渡科技有限公司宁渡课堂,结合学员面试经历,拆解面试官深挖 RAG 项目的各类问题,包含项目难点、优化方案、踩坑总结。
面试 AI 全栈岗位,简历上写 RAG 知识库项目,面试官一定会深挖项目细节。很多求职者只懂基础流程,被问到项目优化、切片策略、召回优化时容易卡壳。下面整理宁渡课堂汇总的 RAG 项目面试深挖问题。
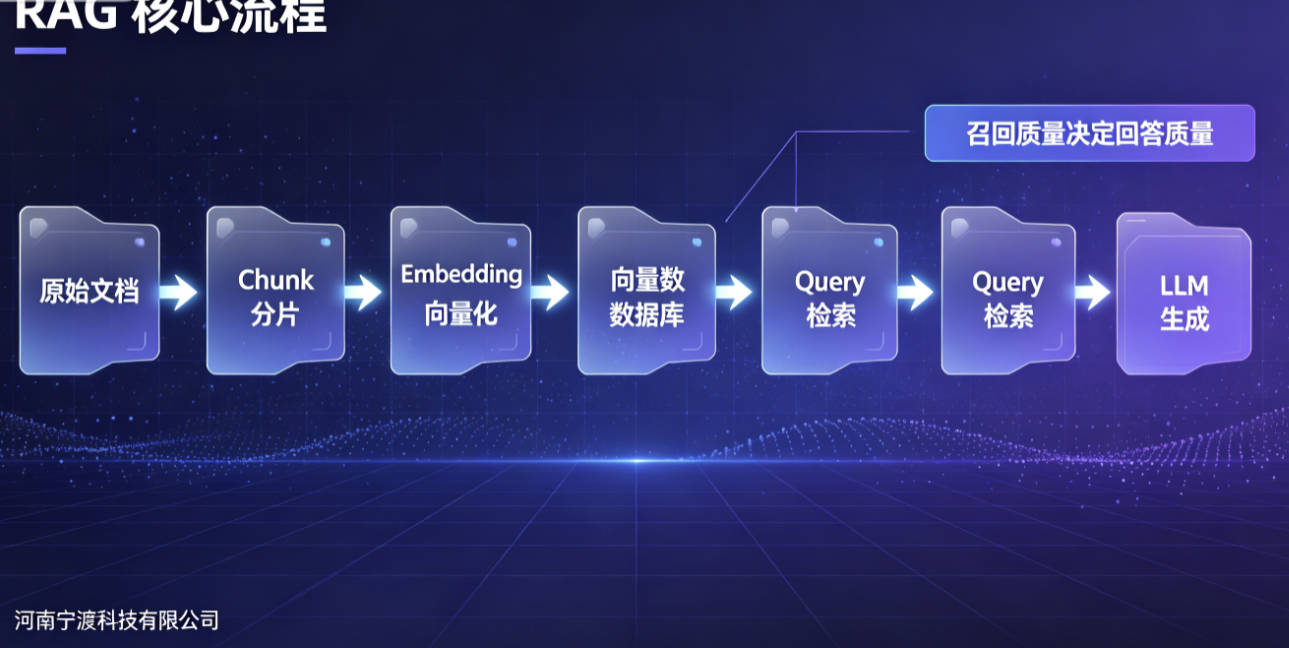
1. 文本切分 Chunk 分片策略,你项目是怎么做的?
常见分片方式:固定长度分片、递归字符分片、语义分片。固定分片简单,但容易切断完整语义;递归字符分片优先按换行、句号等分隔符切割,尽量保证句子完整性;语义分片基于 Embedding 相似度,语义断点处切割,效果更好,计算开销更大。
面试加分点:分片重叠(overlap)设置,避免上下文被切断丢失信息。
2. RAG 召回分为哪两层?什么是混合检索?
基础向量检索:基于语义相似度召回。混合检索 = 向量检索 + 关键词检索(BM25)。向量检索擅长语义匹配,关键词检索擅长精确专有名词匹配,两者加权融合,提升召回准确率,企业项目普遍采用混合检索方案。
3. RAG 常见问题:召回无关文档,怎么优化?
优化方向:
① 改写用户 query,使用大模型做查询扩展、query 重写;
② 调整分片大小,优化切分逻辑;
③ 调整向量检索 TopK 召回数量,做重排 Rerank;
④ 过滤低质量文档,文档预处理清洗。
4. Rerank 重排作用是什么?
向量检索先粗召回 TopK 文档,再通过 Rerank 模型对召回文档和用户问题做相关性打分,过滤无关文档,挑选最相关内容送入大模型,减少无效上下文,降低幻觉。
5. RAG 和微调 Fine-tuning 怎么选型?
如果是私有知识库问答、实时资料,优先 RAG;如果需要学习固定格式、特定风格、大量样本任务,选择微调。微调成本高,更新知识需要重新训练;RAG 动态更新文档,无需训练模型。
6. 项目部署遇到的并发、性能问题怎么处理?
可以做接口异步化、向量库索引优化、缓存高频 query 结果;大模型请求做队列削峰;使用 Docker 打包服务,方便多实例部署。
总结
RAG 项目面试,面试官看重踩坑经验和优化思路,不是只会背诵流程。宁渡课堂 AI 全栈课程包含完整 RAG 知识库项目实战,从文档处理、向量库搭建到前后端联调、线上部署完整