一、反直觉的数字:分数涨了,参数没动
2026年9月15日,机器之心报道了Aether AI的RSIAgent。
同一时间,arXiv挂出了论文2609.
15364。
RSIAgent在OSWorld 2.
0上拿到78.
98%的Partial Score。
这个数字超过了GPT-6 Astra的72.
60%。
在Agents' Last Exam上,RSIAgent达到84.
82%。
GPT-6 Astra在同一基准上是82.
26%。
最反直觉的地方在于:底层模型参数一个都没更新。
RSIAgent不是新模型,而是一套训练无关的多智能体框架。
它把Kimi-K3和GLM-5.
3这些开源模型推过了闭源旗舰。
Aether AI给出的解释只有一句话:不Scale Model,Scale Experience。
本文拆解这套框架的三层设计:递归闭环、两阶段探索、可演化记忆。
先给结论:环境经验正在成为比模型参数更便宜的杠杆。
这个判断决定了RSIAgent的一切设计选择。
后文先用数字坐实反直觉,再逐层拆机制。
读者可以直接跳到代码骨架看最小闭环。
完整阅读可以理解Scaling Experience的完整版图。
二、Scaling Experience:另一条规模化路径
过去几年,大模型的能力跃迁几乎都围绕Scaling一词。
Scaling Law说的是:模型越大、数据越多,能力越强。
这条路径本质上是先训练、再部署。
模型进入新软件、新工具、新环境后,往往需要重新收集数据并额外训练。
Aether AI想试另一种Scaling:不继续Scale Model,而是Scale Experience。
模型参数先不动,让Agent自己进入环境探索、试错、验证。
再把得到的经验不断积累下来。
RSIAgent就是这套思路在数字环境里的具体实践。
它把Agent与环境的交互过程,变成一种持续学习过程。
核心是让Agent自己决定学什么、自己验证结果。
这与人类的学习范式高度一致:先广泛试错,再沉淀经验。
Scaling Experience的隐含假设是环境比数据更便宜。
真实环境能给出可验证的反馈,这是离线数据没有的。
模型部署后不再变强,是旧范式的最大浪费。
RSIAgent把部署后的每一次交互都变成训练素材。
这让Agent的能力边界随时间持续外扩。
参数规模决定了能力的起点,经验决定了能力的增量。
两者不是替代关系,而是不同杠杆。
对于算力有限的开源社区,经验杠杆尤其重要。
三、递归闭环:三个Agent与一份会演化的记忆
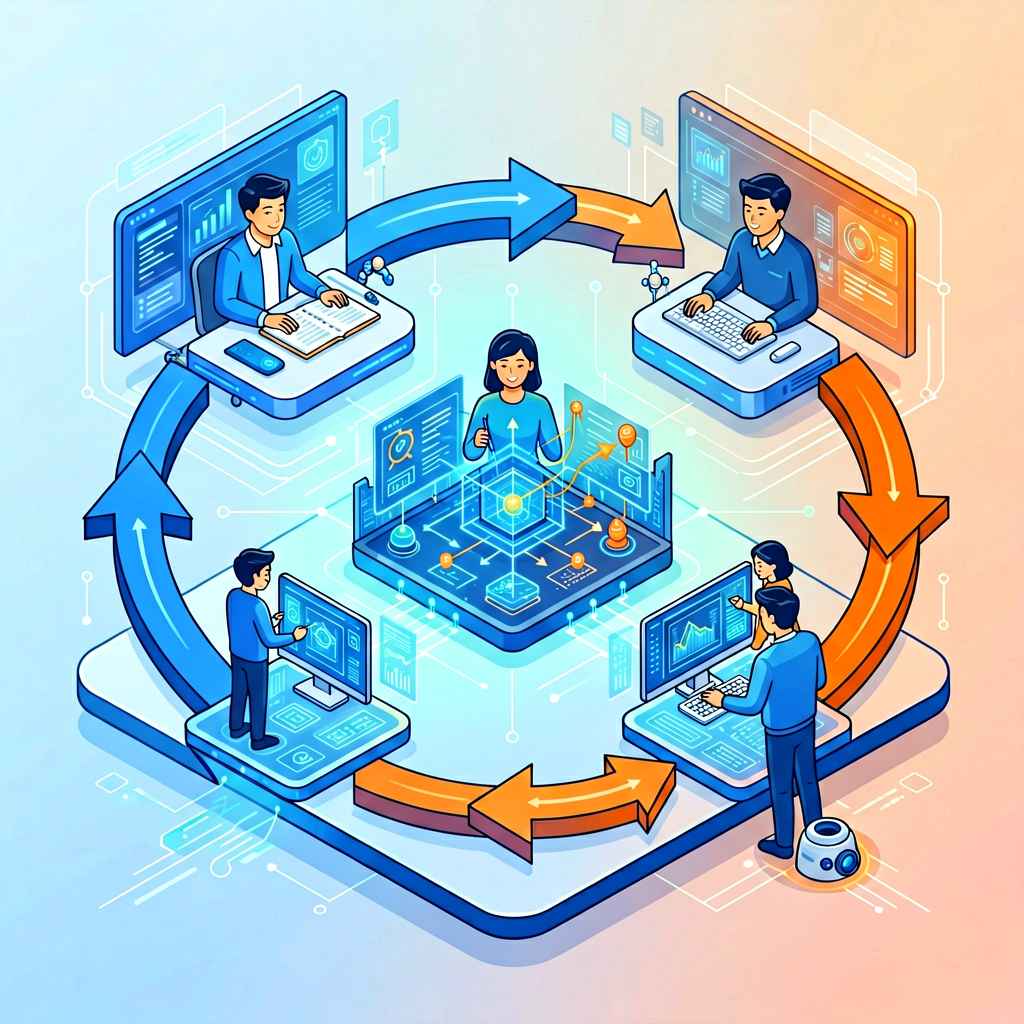
RSIAgent围绕一份不断演化的Memory,构建了多智能体递归闭环。
闭环由三个角色组成:curriculum agent、actor agent、verifier agent。
curriculum agent决定下一步应该探索什么。
actor agent进入环境执行任务并积累经验。
verifier agent根据真实环境反馈,判断结果是否可靠。
有效知识被持续写入Memory。
Agent不再只是被动完成任务,而是能自主选择学习方向。
它能获取经验,并不断扩展自己的环境知识。
这套闭环可以无限迭代:每一轮探索都成为下一轮的输入。
记忆不是历史经验的简单存储,而是逐步成为环境的因果结构。
这正是递归自我提升(RSI)的含义。
三个角色的分工值得单独说明。
curriculum agent像老师,负责设计学习课程。
actor agent像学生,负责动手执行任务。
verifier agent像考官,负责验收结果是否真实有效。
三者缺一不可,任何一方的偏差都会污染记忆。
课程设计偏了,探索会浪费在无效区域。
执行不完整,经验会缺失关键动作。
验证不可靠,错误结论会被当成真理沉淀。
RSIAgent的Memory沉淀的是因果关系。
它记录动作、条件、结果三者之间的稳定联系。
这种结构化记忆比原始轨迹更可复用。
后续任务可以直接查询因果链,而不是重放完整轨迹。
四、Broad-to-Deep:两阶段自探索策略
RSIAgent采用Broad-to-Deep的两阶段自探索策略。
Broad阶段是广泛递归自探索,用于发现多样的环境结构。
它先快速建立整体能力覆盖,类似预训练阶段。
Deep阶段是聚焦深度自探索,用于挖掘难点、隐藏约束和边界条件。
它围绕关键难点进行针对性强化,类似后训练阶段。
Broad和Deep各有不可替代的作用。
消融实验证明:移除任何一方,都会大幅影响探索的广度或深度。
两阶段策略让RSIAgent既覆盖了环境的整体面貌,又啃下了硬骨头。
Broad探索采用并行方式,一次性探索多条路线。
Deep探索则聚焦单一难点,直到发现隐藏规则。
这个设计很像人类学习:先泛读建立框架,再精读攻克难点。
两阶段的比例不是固定不变的。
任务越陌生,Broad阶段占比越高。
任务越熟悉,Deep阶段占比越高。
curriculum agent会动态调整两阶段的节奏。
它根据记忆的覆盖度决定何时切换。
这种自适应调度避免了探索资源的浪费。
实验数据支持了这个设计。
移除Broad阶段,环境覆盖出现明显空洞。
移除Deep阶段,难点任务的成功率停滞不前。
两个阶段叠加,才拿到OSWorld 2.
0的78.
98%。
这是Scaling Experience的第二个关键机制。
五、数据:开源模型如何反超闭源旗舰
RSIAgent的评测数据是本文的核心证据。
基于GLM-5.
3,RSIAgent把OSWorld 2.
0从71.
97%提升到78.
98%。
这个分数大幅超过GPT-6 Astra的72.
60%。
基于Kimi-K3,同样的策略也带来了显著提升。
在Agents' Last Exam的Near-term分项上,RSIAgent达到84.
82%。
GPT-6 Astra在同一分项上是82.
26%。
这意味着即使不更新模型参数,Agent也能突破底层模型的能力边界。
团队还把RSIAgent应用到GameCraft-Bench的自主游戏开发任务。
在mechanics、depth、visuals、art和overall quality上都带来提升。
这证明主动探索与自我进化机制,能迁移到不同类型的交互环境。
两组数字放在一起看更有意思。
OSWorld 2.
0考验的是真实桌面环境的操作能力。
Agents' Last Exam考验的是开放式智能体任务的难度上限。
一个偏执行,一个偏推理,两个方向都涨了。
这说明经验积累不是单一能力的提升,而是整体能力的抬升。
RL训练过的模型通常只擅长训练时见过的任务分布。
RSIAgent的经验记忆则能泛化到新环境。
因为它沉淀的是因果关系,而不是任务答案。
因果知识可以迁移到结构相似的新环境。
这是Scaling Experience最被低估的价值。
六、RSI轮次:探索越多,进化越明显
RSIAgent最直观的效果随轮次累积而放大。
简单任务经过少量RSI轮次就能快速收敛。
复杂任务需要更多轮主动探索,才能逐步发现隐藏变量。
部分初始成功率只有0到40%的任务,最终可以提升到100%。
这个进化曲线接近人类学习的幂律特征。
先期投入回报低,越过临界点后快速拉升。
对工程实践来说,这意味着要留足探索轮次预算。
过早中断RSI循环,会错过能力质变点。
轮次预算应该按任务复杂度动态分配。
简单任务给少量轮次,复杂任务给大量轮次。
curriculum agent会根据收敛速度调整节奏。
收敛快说明探索有效,可以加快进度。
收敛慢说明遇到瓶颈,需要切换探索策略。
RSIAgent的论文给出了轮次与分数的对应关系。
这个数据可以直接用来设计自己的探索预算。
需要注意的是,轮次增加也会带来成本。
每轮探索都调用底层模型与环境交互。
预算管理要在能力收益与推理成本之间平衡。
先跑小规模实验找到曲线拐点,再放大投入。
七、一个可运行的闭环骨架
下面是RSIAgent核心闭环的最小Python骨架。
它演示了curriculum、actor、verifier三角色的协作方式。
```python
import json
from dataclasses import dataclass, field
from typing import List

@dataclass
class Experience:
    action: str
    condition: str
    outcome: str
    valid: bool = False

@dataclass
class Memory:
    items: List[Experience] = field(default_factory=list)

    def store(self, exp: Experience) -> None:
        if exp.valid:
            self.items.append(exp)

    def retrieve(self, condition: str) -> List[Experience]:
        return [e for e in self.items if e.condition == condition]

class CurriculumAgent:
    def next_task(self, memory: Memory, round_no: int) -> str:
        explored = {e.condition for e in memory.items}
        if round_no < 5:
            return "broad:sample_unseen"
        missing = self._hard_cases(memory)
        return f"deep:{missing}" if missing else "broad:expand"

    def _hard_cases(self, memory: Memory) -> str:
        failed = [e for e in memory.items if e.outcome == "failed"]
        return failed[-1].condition if failed else ""

class ActorAgent:
    def run(self, task: str) -> Experience:
        condition = task.split(":")[-1]
        success = "unseen" not in condition
        return Experience(
            action=f"try_{task}",
            condition=condition,
            outcome="success" if success else "failed",
        )

class VerifierAgent:
    def verify(self, exp: Experience) -> bool:
        return exp.outcome == "success" and len(exp.action) > 3

def rsi_loop(rounds: int = 12) -> Memory:
    memory = Memory()
    curriculum = CurriculumAgent()
    actor = ActorAgent()
    verifier = VerifierAgent()
    for r in range(rounds):
        task = curriculum.next_task(memory, r)
        exp = actor.run(task)
        exp.valid = verifier.verify(exp)
        memory.store(exp)
        print(f"round={r} task={task} valid={exp.valid} total={len(memory.items)}")
    return memory

if __name__ == "__main__":
    memory = rsi_loop()
    print(json.dumps(
        [e.__dict__ for e in memory.items],
        ensure_ascii=False,
        indent=2,
    ))
```
真实实现里,actor调用的是真实环境接口。
verifier读取的是环境的真实反馈,而不是字符串判断。
记忆沉淀的是动作、条件、结果之间的因果关系。
这个骨架的价值在于:展示了RSI三角色循环的最小形态。
运行它会看到curriculum从broad逐步切到deep。
你可以把它当脚手架,替换成真实环境的API调用。
替换actor的实现,环境反馈就能进入记忆。
替换verifier的实现,验收标准就能自定义。
骨架本身不依赖任何外部库,可直接运行。
八、Scaling Experience的工程启示
RSIAgent给Agent工程带来的第一个启示:参数不是唯一杠杆。
在模型推理成本高企的今天,环境经验是可以复用的资产。
第二个启示:验证器是整个闭环的守门人。
没有可靠的环境反馈,经验沉淀就是噪音积累。
第三个启示:课程设计决定了探索效率。
Broad-to-Deep的分阶段策略,比随机探索收敛快得多。
第四个启示:记忆需要结构化。
RSIAgent沉淀的不是原始轨迹,而是可复用的因果关系。
这与传统的RAG记忆有本质区别。
RAG检索的是相似文本,RSIAgent复用的是动作条件结果的因果链。
工程落地时,先回答三个问题。
第一个问题:你的环境能不能给出可验证的反馈。
第二个问题:你的记忆能不能结构化表达因果关系。
第三个问题:你的课程能否动态调整探索方向。
三个答案都是肯定,RSIAgent的思路就值得移植。
如果反馈不可靠,先补验证器,再谈经验积累。
这是整套机制的地基。
九、与RAG记忆和RL训练的边界
RSIAgent经常被拿来和RAG、RL对比,三者的边界需要澄清。
RAG解决的是知识检索问题,记忆的是文档片段。
RSIAgent解决的是环境适应问题,记忆的是因果知识。
RAG的检索结果是静态文本,RSIAgent的记忆是可执行规则。
RL解决的是策略优化问题,通过奖励信号调参。
RSIAgent解决的是经验积累问题,通过验证信号沉淀记忆。
RL要更新模型参数,RSIAgent完全不动参数。
RL需要大量轨迹采样,RSIAgent每轮探索都直接沉淀。
RL的奖励设计是难点,RSIAgent的验证器是难点。
两者可以互补:先RSIAgent积累环境知识,再用RL微调模型。
这种组合在论文中被视为未来方向。
边界清晰后,选型就不容易混淆。
需要实时问答能力,用RAG。
需要交互环境中的持续进化,用RSIAgent。
需要特定策略的最优解,用RL。
三者的组合正在成为生产级Agent的标准配置。
十、因果智能的更大版图
RSIAgent只是Aether AI因果路线的数字环境载体。
Causal-Copilot探索如何让Agent自主完成因果分析。
C-World构建开放式工具使用环境,让Agent持续测试并收集经验。
Auto-scaling Continuous Memory研究如何让经验沉淀为可扩展的长期记忆。
Hybrid Self-Evolving Structured Memory进一步统一这些能力。
StructAgent把这些能力统一到长程数字智能体中。
无论数字智能体调用工具,还是机器人在物理世界操作。
本质都是同一个问题:一次行动如何改变环境。
这些变化又由哪些真正的因果机制决定。
RSIAgent让Agent从被动训练走向主动因果发现与学习。
它主动识别真正影响结果的变量。
它理解行动与结果之间的因果结构。
这比从历史数据学习相关性更进一步。
因果知识具有更强的迁移性。
换一个相似环境,因果结构依然成立。
这是RSIAgent能泛化到游戏环境的原因之一。
Aether AI的版图显示,这条路还很长。
但RSIAgent证明了数字环境是因果学习的最佳试验场。
十一、落地清单与三个长期坑
如果你想把RSIAgent的思路用到自己的Agent系统,建议按序落地。
第一步:为Agent接入真实环境的可验证反馈通道。
第二步:实现curriculum、actor、verifier三角色,而不是一个全能Agent。
第三步:设计结构化记忆,明确动作条件结果的schema。
第四步:先用小环境验证闭环,再扩展到复杂任务。
第五步:监控每轮探索的成功率与记忆增长曲线。
第六步:根据收敛速度动态调整Broad与Deep的比例。
三个长期坑要特别注意。
第一个坑:验证器不可靠时,经验会污染记忆。
错误结论一旦沉淀,后续探索全部建立在沙地上。
第二个坑:Broad阶段不足,Deep探索会陷入局部最优。
没见过全貌就深挖,容易在错误区域浪费轮次。
第三个坑:记忆无限增长后,检索成本会吃掉收益。
需要为记忆设计衰减、归档或压缩机制。
RSIAgent的论文给出了这些问题的部分答案。
更完整的工程答案,还需要社区继续迭代。
先跑通最小闭环,再逐条解决三个坑。
这是把Scaling Experience搬进自己系统的最稳路径。
十二、结语:经验正在成为新的规模轴
Scaling Model统治了AI过去五年的叙事。
Scaling Experience正在成为新的候选答案。
RSIAgent用一组反直觉的数字证明了可行性。
开源模型不动参数,也能在基准上反超闭源旗舰。
这不是模型之间的竞争,而是范式之间的竞争。
对开发者而言,这意味着新的机会窗口。
算力不再是能力的唯一门票,环境与验证设计同样重要。
会设计探索闭环的团队,可以用小模型做出大结果。
这个判断值得每一个做Agent的人认真对待。
本文的拆解到此结束,代码骨架可以直接复用。
如果你在移植过程中踩到坑,欢迎对照本文的三个坑自查。
Scaling Experience的故事才刚刚开始。