第 05 篇:结构化输出 ------ 让模型稳定返回 JSON
系列:《Java 大模型应用开发入门》第 05 篇。
源码定位:
com.example.llm.util.AiJsonUtils、com.example.llm.dto.chat.ResponseFormat、com.example.llm.service.AiInvoker#chatJson、com.example.llm.prompt.Prompts。
一、背景
第 04 篇结束时,我们拿到了一个能稳定对话的客户端。但它产出的是散文:
json
{ "content": "好的,我来帮你分析一下这个问题。首先......其次......希望对你有帮助!" }散文对人类友好,对程序是灾难。你真正想要的是:
json
{ "label": "物流", "confidence": 0.9 }这是大模型应用开发的分水岭。
在大模型应用里,模型输出的唯一可信接口是结构化数据。只要输出还依赖自然语言的措辞,你的业务代码就永远处在「可能解析失败」的状态。
这篇解决的就是这个问题。而且我们要做的不只是「打开 JSON Mode」,而是建立四层防护。
二、目标
- 理解 JSON Mode 能保证什么、不能保证什么;
- 学会写「让模型必须按结构输出」的提示词;
- 用 Jackson 把模型输出反序列化成 Java 对象;
- 处理模型的三种「手滑」:Markdown 包裹、前后加废话、字段名不符;
- 实现解析失败后自动纠错重问的兜底机制;
- 让模型输出真正接入业务对象,而不是停留在字符串。
三、前置
- 第 04 篇的
AiClient/WebClientAiClient已就绪; AiProperties已能读到模型配置。
四、核心概念
JSON Mode 保证什么,不保证什么
在请求体里加上:
json
{ "response_format": { "type": "json_object" } }上游会用约束解码强制模型输出合法 JSON。它保证一件事:输出是一个语法合法的 JSON 对象。
它不保证的是:
- 字段名符合你的预期(你可能得到
{"category":"物流"},而不是{"label":"物流"}); - 字段类型正确(
confidence可能是字符串"0.9"); - 字段齐全(可能只返回
{"label":"物流"},没有reason); - 语义正确(可能把「物流」判成「其他」);
- 所有厂商都支持(部分兼容实现直接报 400)。
所以结论是:JSON Mode 只是语法保险,业务校验一层都不能省。
一个必须知道的坑:提示词里要出现 "json"
OpenAI 官方文档明确要求:使用 json_object 模式时,提示词里必须包含 "json" 字样,否则会报错:
Invalid parameter: 'messages' must contain the word 'json' in some form这个坑很隐蔽,因为它只在你换了一种写法的时候才出现。比如你把提示词从「请返回 JSON」改成「请按要求输出结构化结果」,代码就突然挂了。
本工程的 Prompts 里,所有结构化提示词都显式带了 "JSON" 字样。
四层防护
第 1 层  提示词约束      ── system 里写清字段名、类型、示例
第 2 层  response_format ── 让上游保证语法合法
第 3 层  解析清洗        ── 剥掉 Markdown 包裹和前后废话再交给 Jackson
第 4 层  失败重问        ── 解析失败时追加一句纠错提示,重问一次
第 4 层性价比最高。多花一次调用(约 0.0005 元),换来结构化成功率大幅提升,比让业务随机失败划算得多。
提示词的五段式
本工程把所有提示词集中在 Prompts 类里,每条都遵循同样的五段结构:
① 角色:你是谁
② 任务:做什么
③ 约束:只返回 JSON、不要 Markdown、缺失返回 null、禁止编造
④ 输出结构:给出字段名与示例
⑤ 输入数据:用醒目标记包裹
为什么提示词要集中管理?因为它是 AI 应用里修改最频繁、最容易出事故的资产。散落在各个 Service 里,改一个字段名要全局搜索,还容易漏。
集中到一个类,至少有三个好处:
- 改提示词只动一个文件,代码评审时一眼能看出这次只改了什么;
- 可以写单元测试,比如检查「所有提示词必须包含 JSON 字样」;
- 未来要接提示词管理平台或者做 A/B 测试,有统一的接入点。
五、代码实操
声明响应格式
java
@Data
@NoArgsConstructor
@AllArgsConstructor
public class ResponseFormat {

    /** 格式类型,目前常用 json_object。 */
    private String type;

    public static ResponseFormat jsonObject() {
        return new ResponseFormat("json_object");
    }
}
在客户端里按需挂上(第 04 篇已经接好):
java
ChatCompletionRequest request = ChatCompletionRequest.of(model, messages, temperature);
request.setMaxTokens(aiProperties.getMaxTokens());
if (jsonMode) {
    request.setResponseFormat(ResponseFormat.jsonObject());
}
写好提示词
摘要用的 Prompts.SUMMARY_SYSTEM:
java
public static final String SUMMARY_SYSTEM = """
        你是一名专业的文本摘要助手。
        要求:
        1. 只依据用户提供的文本内容做摘要,禁止编造文本中不存在的信息;
        2. 保留关键事实、数字与结论;
        3. 必须只返回一个 JSON 对象,不要输出 Markdown 代码块,不要输出任何解释性文字。

        输出 JSON 结构(字段名必须完全一致):
        {"summary": "150 字以内的摘要", "keyPoints": ["要点1", "要点2"], "keywords": ["关键词1", "关键词2"]}
        """;
几处措辞是有讲究的:
| 措辞 | 为什么这么写 |
|---|---|
| 「必须只返回一个 JSON 对象」 | 加强约束 |
| 「不要输出 Markdown 代码块」 | 直接堵住最高频的 ```````json```` 包裹 |
| 「不要输出任何解释性文字」 | 堵住「好的,结果如下:」这种开场白 |
| 「字段名必须完全一致」 | 明确告诉模型别自作主张改字段名 |
| 「禁止编造文本中不存在的信息」 | 抽取和摘要场景最重要的约束 |
分类用的提示词带 Few-shot 示例:
java
public static String classifySystem(List<String> labels) {
    String labelText = String.join("、", labels);
    return """
            你是一名文本分类助手。
            要求:
            1. 只能从下列固定标签中选择一个,禁止自创标签:%s
            2. 必须只返回一个 JSON 对象,不要输出 Markdown 代码块,不要输出任何解释性文字;
            3. confidence 是 0 到 1 之间的小数,表示你对本次判断的把握程度。

            输出 JSON 结构:
            {"label": "标签", "confidence": 0.9, "reason": "一句话说明判断依据"}

            参考示例:
            输入:我的快递三天没动了,什么时候能到  ->  {"label": "物流", "confidence": 0.95, "reason": "询问包裹运输进度"}
            输入:这个东西质量太差了,我要投诉你们  ->  {"label": "投诉", "confidence": 0.93, "reason": "表达不满并要求投诉"}
            """.formatted(labelText);
}
labels 是从配置读的,所以标签体系可以不重启就改:
yaml
ai:
  classify:
    labels: [咨询, 投诉, 退款, 物流, 其他]
防御性清洗:处理模型的三种「手滑」
即使开了 JSON Mode,模型偶尔还是会给你这些:
① 好的,结果如下:
   ```json
   {"label":"物流"}
② {"label":"物流"}
希望对你有帮助!
③ ```JSON
{"label":"物流"}
所以解析这一步必须先清洗,再交给 Jackson:
java
public final class AiJsonUtils {

    private static final Pattern FENCE =
            Pattern.compile("```(?:json)?\\s*([\\s\\S]*?)```", Pattern.CASE_INSENSITIVE);

    /** 从模型输出中抠出 JSON 主体。 */
    public static String extractJson(String raw) {
        if (raw == null) {
            return "";
        }
        String text = raw.trim();

        // ① 剥掉 Markdown 代码块
        Matcher matcher = FENCE.matcher(text);
        if (matcher.find()) {
            text = matcher.group(1).trim();
        }

        // ② 从第一个 { 截到最后一个 } ------ 一次搞定前后废话
        int start = text.indexOf('{');
        int end = text.lastIndexOf('}');
        if (start >= 0 && end > start) {
            return text.substring(start, end + 1);
        }
        return text;
    }

    public static <T> T parse(String raw, Class<T> type, ObjectMapper mapper) {
        String json = extractJson(raw);
        try {
            return mapper.readValue(json, type);
        } catch (Exception e) {
            throw new AiBadResponseException(
                    "模型输出无法解析为 " + type.getSimpleName() + ":" + e.getMessage(), brief(raw));
        }
    }
}
indexOf('{') 加 lastIndexOf('}') 这一招很实用,它一次解决两个问题:前面有「好的,结果如下:」会被切掉;后面有「希望对你有帮助!」也会被切掉。
要注意它的适用边界:这招只适用于「整体就是一个 JSON 对象」的场景。如果输出里含多个 JSON,或者正文本身带 {}(比如抽取任务抽到的文本里有花括号),就得换更严谨的方案,比如按括号配对扫描。
失败重问
这是本篇的核心机制:
java
public <T> AiResult<T> chatJson(List<Message> messages, double temperature, Class<T> type) {
    ChatCompletionResponse first = resilience.execute(() -> aiClient.chat(messages, temperature, true));
    try {
        T parsed = AiJsonUtils.parse(first.firstContent(), type, objectMapper);
        return new AiResult<>(parsed, prompt(first), completion(first), first.firstFinishReason());
    } catch (AiBadResponseException e) {
        log.warn("结构化输出解析失败,追加纠错提示后重问一次: {}", e.getMessage());
        List<Message> retryMessages = new ArrayList<>(messages);
        retryMessages.add(Message.user(RETRY_HINT));
        ChatCompletionResponse second = resilience.execute(
                () -> aiClient.chat(retryMessages, temperature, true));
        T parsed = AiJsonUtils.parse(second.firstContent(), type, objectMapper);
        return new AiResult<>(parsed,
                prompt(first) + prompt(second),           // ← Token 要累加
                completion(first) + completion(second),
                second.firstFinishReason());
    }
}
纠错提示写得很直白:
java
private static final String RETRY_HINT = "上一次的输出无法被解析为 JSON。"
        + "请只输出一个合法的 JSON 对象,不要输出 Markdown 代码块,不要输出任何解释文字。";
三个设计要点:
- 只重问一次。重问是补救,不是重试。无限重问会变成成本黑洞;
- Token 必须累加。否则成本统计会漏掉重问那次,账单对不上;
- 重问时带上原始消息。只发纠错提示,模型不知道原来问的是什么。
为什么用「追加一条 user 消息」而不是「重新提问」?因为追加消息能保留原上下文,模型知道「我上次答错了什么」。这也符合对话语义 ------ 模型在上下文里能看到自己刚才的输出。
定义结果 DTO
java
public class SummaryDtos {

    @Data
    public static class Request {
        @NotBlank(message = "text 不能为空")
        private String text;
        private Integer maxLength;
    }

    @Data
    public static class Result {
        private String summary;
        private List<String> keyPoints;
        private List<String> keywords;

        // 以下字段由本地填充,不从模型读取
        private Boolean chunked;
        private Integer chunkCount;
        private Boolean degraded;
    }
}
注意最后那三个字段:它们是本地状态,不是模型输出。
把它们和模型字段放在同一个 DTO 里,可以省掉一层包装,但必须在注释里写清楚,否则接手的人会以为「模型也会返回 chunked」。
归一化:不要信任模型输出
拿到对象之后,还有一步不能省:
java
private SummaryDtos.Result normalize(SummaryDtos.Result result) {
    if (result.getSummary() == null || result.getSummary().isBlank()) {
        throw new AiBadResponseException("模型返回的摘要为空", null);
    }
    if (result.getKeyPoints() == null) {
        result.setKeyPoints(new ArrayList<>());
    }
    if (result.getKeywords() == null) {
        result.setKeywords(new ArrayList<>());
    }
    return result;
}
为什么「摘要为空」要抛异常,而不是返回空对象?因为空摘要对业务没有意义,返回它等于把问题推到下游。抛异常会触发兜底逻辑(第 09 篇的降级),下游拿到的是一个明确的「AI 不可用」信号,而不是一个「看起来成功但内容为空」的假成功。
这条原则很通用:宁可明确失败,也不要静默返回无意义的结果。
六、验证
验证 JSON Mode 生效
bash
curl -X POST http://127.0.0.1:8080/ai/chat/json \
  -H "Content-Type: application/json" \
  -d '{"prompt":"请返回一个 JSON:{\"lang\":\"Java\",\"version\":21}","temperature":0.2}'
实测输出:
json
{
  "code": 0,
  "message": "成功",
  "traceId": "5d3ea7a2254346af",
  "data": {
    "content": "{\"status\":\"ok\",\"received\":\"请返回一个 JSON:{\\\"lang\\\":\\\"Java\\\",\\\"version\\\":21}\",\"note\":\"JSON Mode 已生效:这是本地模拟服务返回的结构化占位数据。\"}",
    "model": "mock-gpt-4o-mini",
    "finishReason": "stop",
    "promptTokens": 47,
    "completionTokens": 48,
    "totalTokens": 95,
    "latencyMs": 12
  }
}
注意 data.content 是一个字符串,它的内容恰好是合法 JSON。
这里有个常见误解:JSON Mode 返回的 content 仍然是字符串,只不过内容是合法 JSON。你还需要自己反序列化一次。这正是 AiJsonUtils 存在的原因。
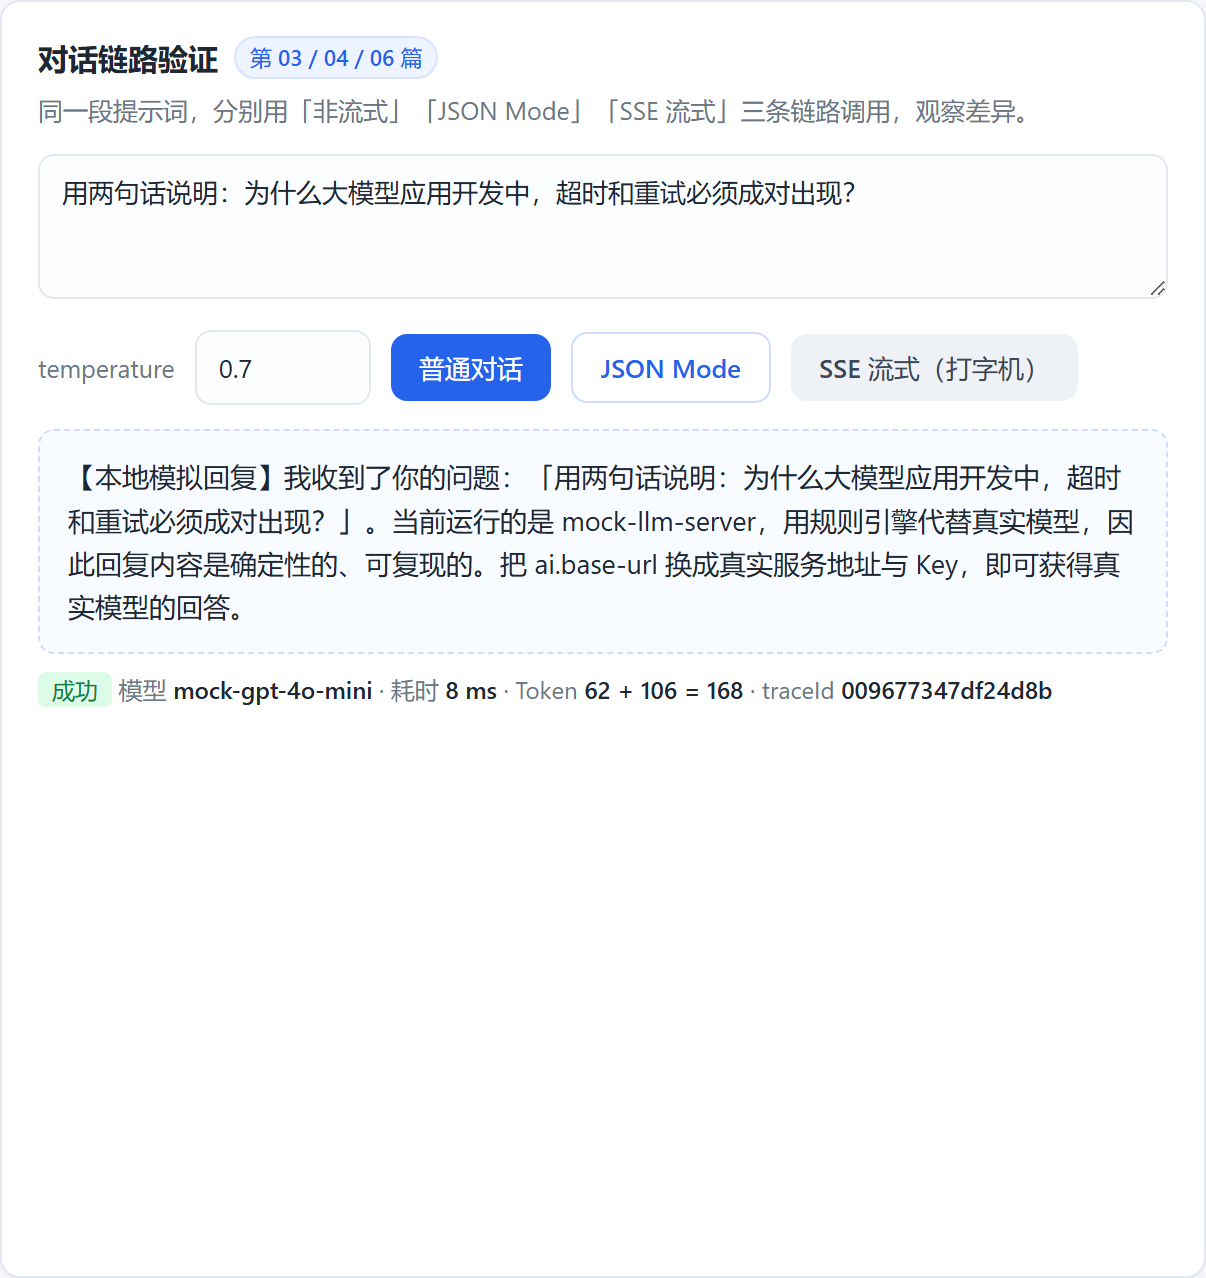
对比一下不开 JSON Mode 的 /ai/chat:
"content": "【本地模拟回复】我收到了你的问题:「请返回一个 JSON:......」当前运行的是 mock-llm-server,......"一个是 JSON,一个是散文。这就是第 05 篇要解决的差距。
验证「字符串到 Java 对象」
/ai/chat/json 只证明上游能返回 JSON。真正的验证要看业务接口有没有把 JSON 变成 Java 对象:
bash
curl -X POST http://127.0.0.1:8080/ai/summarize \
  -H "Content-Type: application/json" \
  -d '{"text":"本次发布主要完成了三件事。第一,重构了大模型客户端,把超时、重试、限流统一收口到一处。第二,新增结构化输出能力,业务可以直接拿到 Java 对象。第三,补齐了链路追踪,每个请求都有 traceId,可以按 traceId 回放整条调用链。上线后接口平均耗时从 1.8 秒降到 0.9 秒,失败率从 3.2% 降到 0.4%。","maxLength":150}'
实测输出:
json
{
  "code": 0,
  "message": "成功",
  "traceId": "448cb236346d438a",
  "data": {
    "summary": "本次发布主要完成了三件事。第一,重构了大模型客户端,把超时、重试、限流统一收口到一处。第二,新增结构化输出能力,业务可以直接拿到 Java 对象。第三,补齐了链路追踪,每个请求都有 traceId,可以按 traceId 回放整条调用链。上线后接口平均耗时从 1.8 秒降到 0.9 秒,失败率从 3.2% 降到 0.4%。",
    "keyPoints": [
      "本次发布主要完成了三件事",
      "第一,重构了大模型客户端,把超时、重试、限流统一收口到一处",
      "第二,新增结构化输出能力,业务可以直接拿到 Java 对象",
      "第三,补齐了链路追踪,每个请求都有 traceId,可以按 traceId 回放...",
      "上线后接口平均耗时从 1.8 秒降到 0.9 秒,失败率从 3.2% 降到 0...."
    ],
    "keywords": ["降到", "本次发布", "主要完成", "了三件事", "重构了大"],
    "chunked": false,
    "chunkCount": 1,
    "degraded": false
  }
}
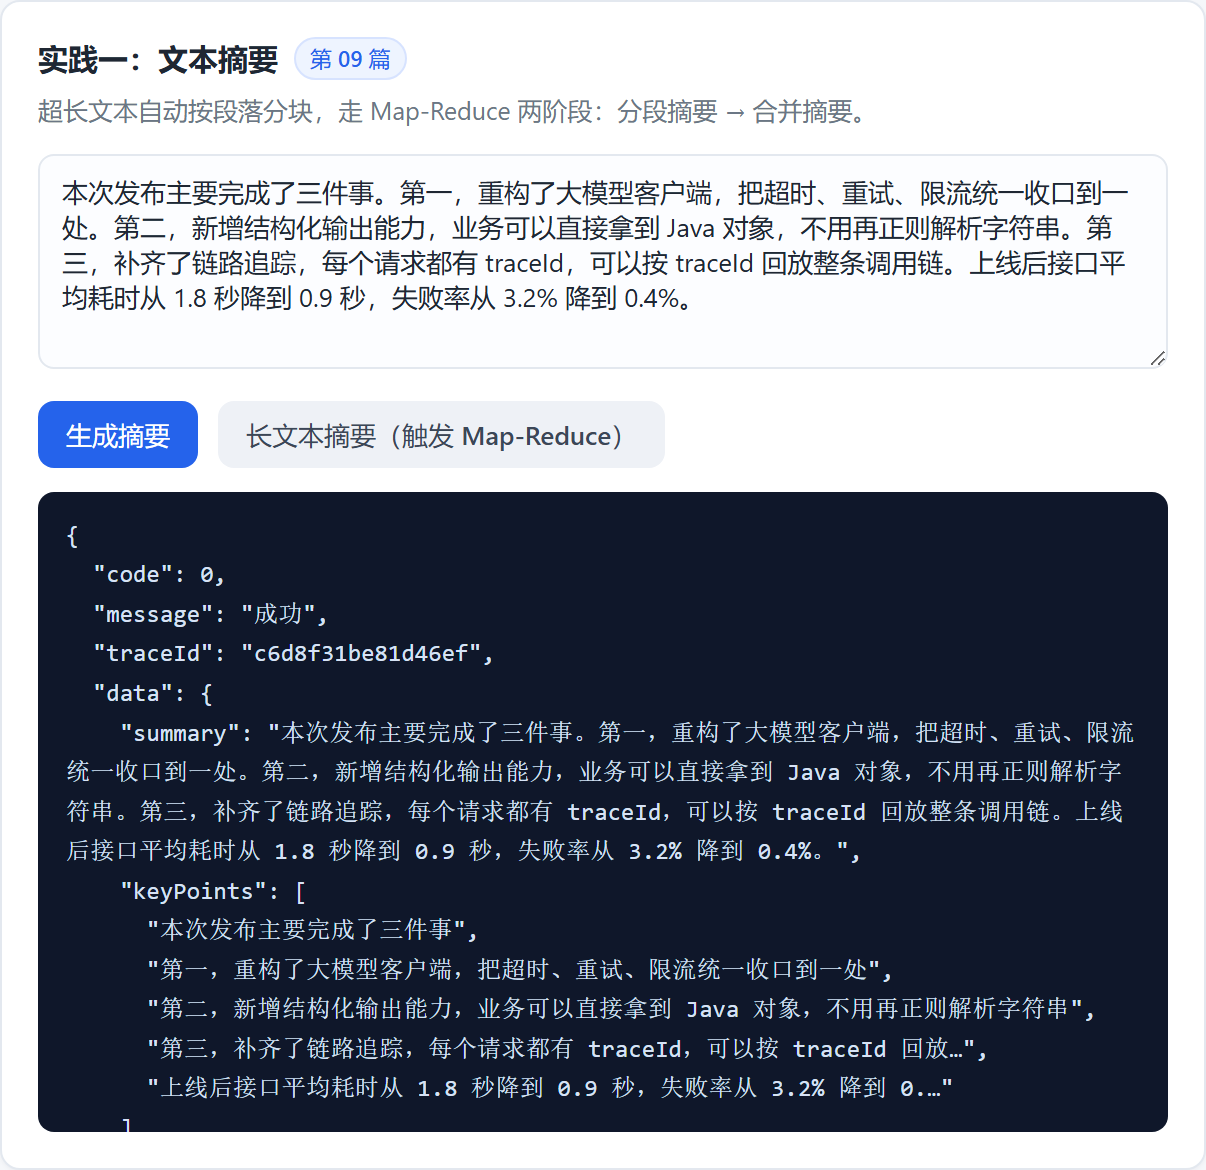
这个 JSON 是 SummaryDtos.Result 对象被 Jackson 序列化的结果。keyPoints 是一个真正的 List<String>,不是一段需要你去正则解析的文本 ------ 这就是结构化输出落地后的样子。
关于
keywords字段:它是 mock 服务用简化的 n-gram 词频算法产出的,所以看起来像碎词。这恰好是上面「JSON Mode 不保证内容好」的实证。真实模型会给出语义更准的关键词,比如「重构」「超时」「重试」「限流」「链路追踪」。
mock 的价值是让你在没有 API Key 时也能验证链路,而不是验证智能。
演示页上的效果
打开演示页,点「JSON Mode」按钮:
尝试制造解析失败
把 ai.summary.max-input-chars 改小然后传一个超大文本,或者临时把 AiJsonUtils.extractJson 的清洗逻辑注释掉,你会看到日志:
WARN c.e.llm.service.AiInvoker - 结构化输出解析失败,追加纠错提示后重问一次: 模型输出无法解析为 SummaryDtos.Result:...紧接着是第二次调用的日志。这就是第 4 层防护在工作。
如果想观察「重问也失败」的情况,可以临时把 RETRY_HINT 改成一句无用的话,日志里最终会抛出 AiBadResponseException,并被第 09 篇的降级逻辑接住。
七、常见坑
| 坑 | 表现 | 解法 |
|---|---|---|
| 以为 JSON Mode 返回的是对象 | 拿 content 当对象用,编译报错 |
它仍是 String,需要反序列化 |
| 提示词里没有 "json" 字样 | 开了 json_object 直接 400 |
提示词里显式出现 JSON |
| 开着 JSON Mode 就不校验字段 | 偶发 NPE(字段缺失) | 归一化加默认值和空值校验 |
| 不剥 Markdown 包裹 | `Unrecognized token '````解析失败 | AiJsonUtils.extractJson 清洗 |
只取 { 到 } 却不考虑含花括号的正文 |
抽取任务解析出错 | 抽取场景改用括号配对扫描,或要求模型输出前先转义 |
| 重问不累加 Token | 成本统计偏低,账单对不上 | 重问的 Token 必须加起来 |
| 无限重问 | 上游故障时变成成本黑洞 | 只重问 1 次,失败即降级 |
| 提示词散落在各 Service | 改一个字段要全局搜索,易漏 | 集中到 Prompts 类 |
temperature 用默认 0.7 |
同一输入结果不稳定 | 结构化任务用 0~0.2(本工程固化在 Service 里) |
把 degraded / chunked 当成模型字段 |
误解日志与接口语义 | DTO 里注释清楚哪些是本地状态 |
八、小结与下一篇
这篇做完的事:
- 澄清了 JSON Mode 只保证语法合法,业务校验一层不能省;
- 学会了五段式提示词的写法,并把提示词集中到
Prompts类; - 用
AiJsonUtils处理了模型的三类「手滑」; - 实现了解析失败自动纠错重问,并正确处理了 Token 累加;
- 定义了结果 DTO 与归一化逻辑,让模型输出真正接入 Java 对象;
- 验证了
/ai/chat/json与/ai/summarize两条链路。
现在模型能返回稳定的结构了。但用过 ChatGPT 的人都知道,它是一个字一个字往外蹦的。
而我们现在的接口是「等全部生成完再一次返回」,用户盯着空白屏幕等 5 秒,体验很差。
而且这条路上藏着两个非常隐蔽的坑:Reactor 的 map 不允许返回 null,data: [DONE] 不是 JSON。踩中任何一个,整条流都会直接崩掉。
下一篇把这条流打通:SSE 流式输出。
下一篇 → 第 06 篇:SSE 流式输出 ------ Spring Boot 返回打字机效果
跟着敲的建议:留意上面
keywords字段的结果。它是本系列唯一一处「故意保留 mock 局限」的地方,也是理解「结构 vs 语义」区别的最好例子。