Marigold v2 论文讲解和代码讲解
Marigold 论文讲解主要讲解论文的理论知识,而代码讲解是包含整体框架和实现细节。
文章目录
- [Marigold v2 论文讲解和代码讲解](#Marigold v2 论文讲解和代码讲解)
- 前言
- 一、论文描述
-
- [1. 成果和优势描述](#1. 成果和优势描述)
- 2.贡献
- 二、模型框架图
- 三、消融实验
前言
Marigold 目前有两个版本,这里我重点讲解一下最新的第二个版本。这是我把知识收集的地方,所有的领域基础哲学是有限的,变化是无限的。随着ai的发展,我发现有好多文献去看,好多技术去学习,但是实践过程交给ai,阅读量几乎是原来的十倍不止。柯洁说过,ai给我带来了便利,但是我们的工作时长却没有减少,甚至比以前更累。我发现我应该慢下来,而写文章的停顿,查阅资料整理,正是我慢下来,静下来的方法。这是论文连接。
一、论文描述
该篇论文是关于深度估计的文章,发表于2026年ACM TOG ,监督式学习方法,利用扩散模型生成图像深度。
图1:标题信息
1. 成果和优势描述
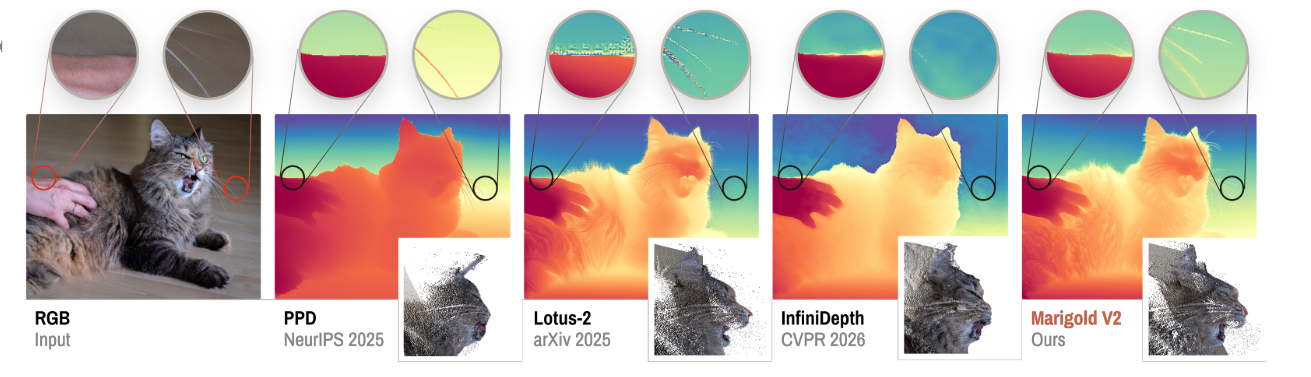
图2:成果图 Marigoldv1 版本的图像效果就非常卓越,这里把动物的胡须毛发,树叶等细节再一次丰富。所以改进点:**预测深度图中丢失的细粒度细节和过度平滑的边界**
2.贡献
- 图像编辑 Dit 转化成深度估计任务,QLoRA实现微调。
- IREPA-depth: 从深度图中提取语义特征,提高视觉质量。
- 加入Skinhorm 和表征对齐损失:保留语义,提高边缘清晰。
效果层面达到了sota水平之外,把千问图像编辑模型加入进来,实现单卡训练。这里的训练分成两个阶段。
二、模型框架图
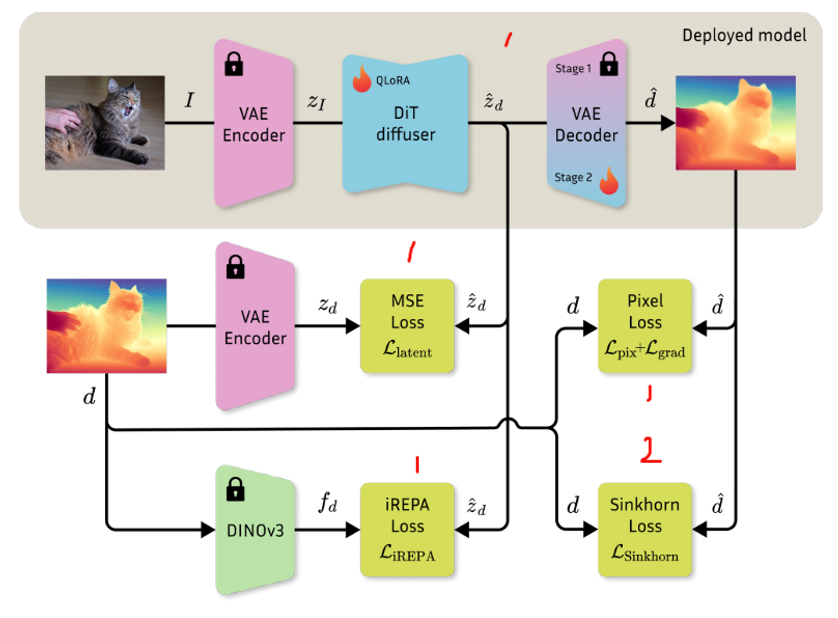
图3:模型架构图 整个模型训练分成两个阶段。
Stage 1: 只有QLoRA适配器的权重被微调,通过IREPAdepth进行正则化,这已经产生了一个强大的模型。
Stage 2: 通过添加Sinkhorn loss 和解冻VAE解码器进一步完善它。推理过程中模型只需要通过VAE和DiT进行一次前向传播
1.模型详细描述
我们来看上面深色区域,输入图片 img 通过冻结的VAE编码器,获得潜在特征 Z I ZI ZI. 然后将潜在特征送入Dit进行预测 Z ^ d \hat{Z}d Z^d,将其送入VAE解码器,生成深度图。Marigold v1 使用的是stable diffusion v2,这里使用的是QwenImageEdit ,所以VAE和DiT都直接换了。
下面部分主要讲解损失:深度图通过VAE编码器和DINO v3编码器,分别生成相应的特征 Zd 和 fd,将 Zd 和 Z ^ d \hat{Z}d Z^d 做损失,形成深度编码器VAE约束, Z ^ d \hat{Z}d Z^d 和 fd 做损失就是iREPA loss,新创建的,这是通过语义对齐,对提升精度没有帮助,但是可以提高图像质量。预测的深度图 d ^ \hat{d} d^ 和输入的d进行MSE到达像素级别的约束,还会加一个Sinkhorn损失。关于像素级别的约束都加入了梯度约束,在梯度方向空间加入约束对像素密集估计任务有帮助。
IREPA loss 是DINO语义对齐损失,Sinkhorn这个像素损失解决的问题:深度标签是带噪声的,合成的数据集hypersim也存在噪声,而Sinkhorn允许模型去预测这些噪声。后面详解计算过程。
2.SinkLoss
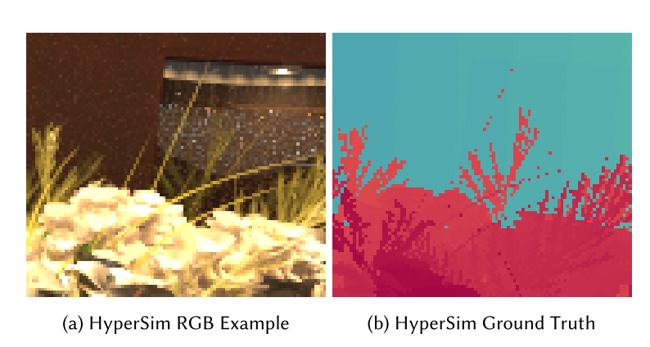
图3:深度噪声图
细线、毛发、栅栏、树叶,这些边缘部分,深度标签可能有一两个像素的随机偏差,像素监督会把这种标注噪声强行喂给模型,引入了噪声,我们需要预测这些噪声。
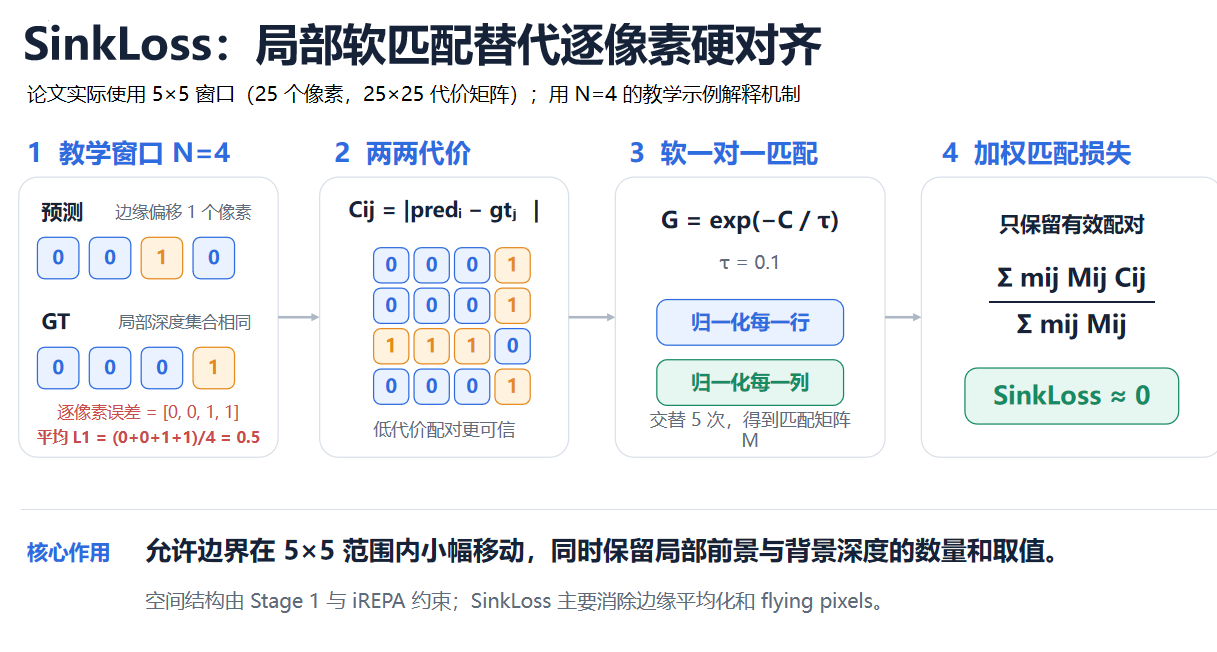
SinkLoss: 把图片铺成k²个block,每个块进行 Skinkhor-Knopp 匹配,建立 K² prediction 和 K ² target 一对一匹配。 只需要网格在每个块内产生与GT相同深度的深度值集合。不需要严格的空间对齐。下面是计算机制
三、消融实验
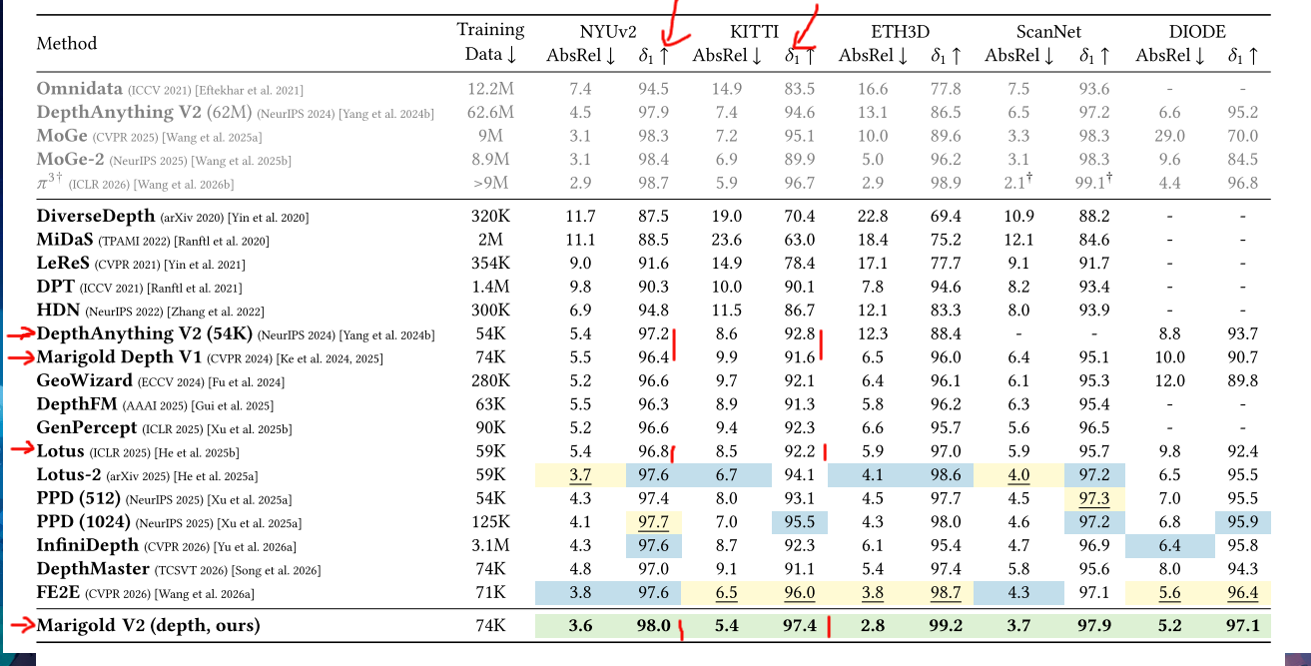
图4:模型结果对比
我们从模型结果对比来看,无论室内还是室外,数据指标δ1都是sota系列,当然这里没有列出DA3. 我关注kitti上面的泛化能力,发现居然达到了97之多。
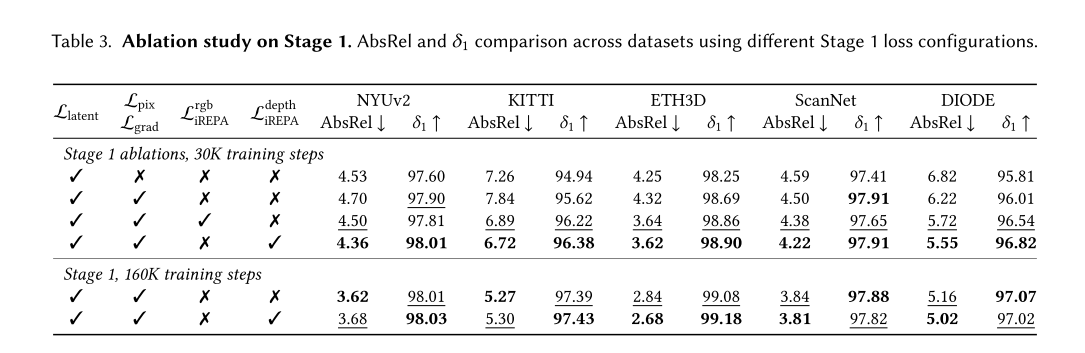
图5:组件消融
从损失项来看,latent loss 是基座模型的。pixel grad 损失加上可以提到0.3%,RGB iREPA和Depth IREPA 指标上是depth通过Dino能获得更好的结果。当把训练步数从30K增长到160K,指标上能达到97.43差不多一个点的提升(kitti),但是iREPA的收益就变得非常小。