目录
- 前言
- [1. 模拟数据定义](#1. 模拟数据定义)
- [2. 构造训练路径](#2. 构造训练路径)
- [3. 速度预测网络](#3. 速度预测网络)
- 4.训练
- [5. 从噪声逐步生成](#5. 从噪声逐步生成)
- [6. 相同起点,一步与多步比较](#6. 相同起点,一步与多步比较)
前言
之前已经介绍过DDMP以及流模型见如下四篇链接: 【扩散模型DDPM】扩散模型入门理解(1), 【扩散模型DDPM】扩散模型入门理解(2),【扩散模型DDPM】扩散模型入门理解(3),【流匹配模型Flow Maching】流匹配模型入门理解(1)现在看一下流模型的代码,这个代码在DDPM代码的基础上比较好理解,见扩散模型理解(3)。
1. 模拟数据定义
python
import math
import numpy as np
import matplotlib.pyplot as plt
import torch
from torch import nn
from sklearn.datasets import make_moons

np.random.seed(42)
torch.manual_seed(42)
device = torch.device("cuda:3" if torch.cuda.is_available() else "cpu")
if device.type == "cpu":
    torch.set_num_threads(min(4, torch.get_num_threads()))
print("device:", device)

points, _ = make_moons(n_samples=10000, noise=0.05, random_state=42)
points = (points - points.mean(axis=0)) / points.std(axis=0)
data = torch.tensor(points, dtype=torch.float32, device=device)

def plot_points(ax, points, title):
    if isinstance(points, torch.Tensor):
        points = points.detach().cpu().numpy()
    ax.scatter(points[:, 0], points[:, 1], s=3, alpha=0.4)
    ax.set_title(title)
    ax.set_xlim(-3.5, 3.5)
    ax.set_ylim(-3.5, 3.5)
    ax.set_aspect("equal")

fig, ax = plt.subplots(figsize=(4, 4))
plot_points(ax, data[:1500], "Real data")
plt.tight_layout()
plt.show()
2. 构造训练路径
固定同一批起点和终点,查看不同 t t t 的插值;这不是训练好的模型生成的轨迹。
x t = ( 1 − t ) z + t x d a t a x_t=(1-t)z+t x_{\mathrm{data}} xt=(1−t)z+txdata
这里展示的是人为构造的训练插值,还不是网络生成的结果。
python
def interpolate(x_data, t, noise):
    t = t[:, None]  # [batch] -> [batch, 1],同一个 t 用于两个坐标
    return (1 - t) * noise + t * x_data

x_demo = data[:1500]
noise_demo = torch.randn_like(x_demo)
fig, axes = plt.subplots(1, 5, figsize=(15, 3))
for ax, time in zip(axes, [0.0, 0.25, 0.5, 0.75, 1.0]):
    t = torch.full((len(x_demo),), time, device=device)
    plot_points(ax, interpolate(x_demo, t, noise_demo), f"t = {time:.2f}")
plt.tight_layout()
plt.show()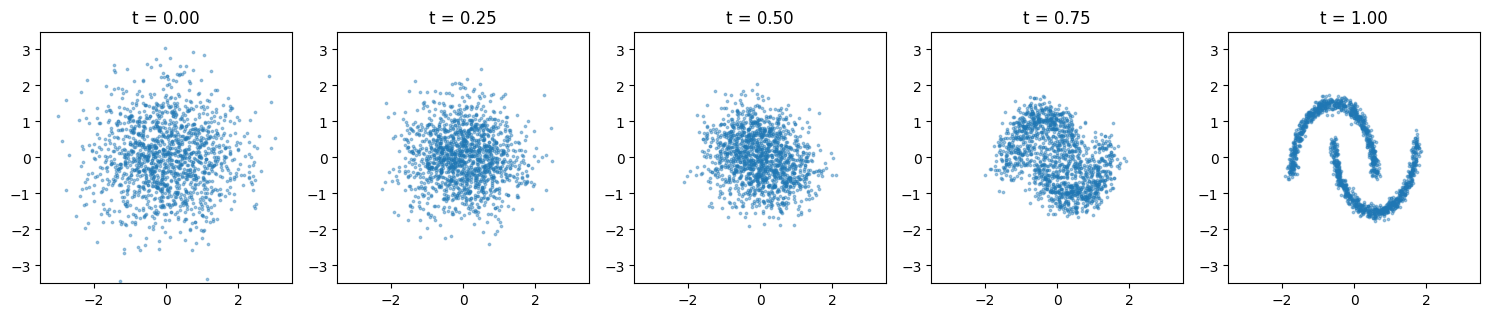
3. 速度预测网络
与之前 NoisePredictor 的结构相同; t t t 已位于 0 , 1 0,1 0,1,不再除以 T T T(之前 DDPM 的时间是整数编号,现在 Flow Matching 的时间已经是一个 0~1 之间的小数。)。输出两个坐标方向的速度。
python
class VelocityPredictor(nn.Module):
    def __init__(self):
        super().__init__()
        self.register_buffer("freq", torch.arange(1, 9).float() * math.pi)
        self.net = nn.Sequential(
            nn.Linear(18, 128), nn.SiLU(),
            nn.Linear(128, 128), nn.SiLU(),
            nn.Linear(128, 128), nn.SiLU(),
            nn.Linear(128, 2),
        )

    def forward(self, x_t, t):
        phase = t.float()[:, None] * self.freq[None, :]
        time_embedding = torch.cat([phase.sin(), phase.cos()], dim=1)
        return self.net(torch.cat([x_t, time_embedding], dim=1))

model = VelocityPredictor().to(device)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
4.训练
每个数据点随机抽取一个连续时间;随机噪声与数据独立配对。这个地方注意: 噪声跟原始数据是独立配对的,也就是说噪声和数据没有一一对应的关系是随机的,这个地方可以用OT(最有传输)提前配对,后面再处理,这是另一种模型方式。路径对时间求导得到目标速度
u t = d x t d t = x d a t a − z u_t=\frac{dx_t}{dt}=x_{\mathrm{data}}-z ut=dtdxt=xdata−z
因此损失为 ∥ v θ ( x t , t ) − ( x d a t a − z ) ∥ 2 \|v_\theta(x_t,t)-(x_{data}-z)\|^2 ∥vθ(xt,t)−(xdata−z)∥2。不同端点可能给出冲突的速度标签,所以不要求训练损失降到零。
python
batch_size = 256
train_steps = 4000
loss_history = []
model.train()

for step in range(1, train_steps + 1):
    x_data = data[torch.randint(len(data), (batch_size,), device=device)]
    t = torch.rand(batch_size, device=device)
    noise = torch.randn_like(x_data)

    x_t = interpolate(x_data, t, noise)
    target_velocity = x_data - noise
    predicted_velocity = model(x_t, t)
    loss = (predicted_velocity - target_velocity).square().mean()

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    loss_history.append(loss.item())

    if step % 500 == 0:
        print(f"step {step:4d} | mean loss {np.mean(loss_history[-500:]):.4f}")

plt.figure(figsize=(6, 3))
plt.plot(loss_history, alpha=0.3, label="Batch loss")
window = 100
smoothed = np.convolve(loss_history, np.ones(window) / window, mode="valid")
plt.plot(np.arange(window, len(loss_history) + 1), smoothed, label="100-step mean")
plt.xlabel("Training step")
plt.ylabel("Velocity MSE")
plt.legend()
plt.tight_layout()
plt.show()
5. 从噪声逐步生成
训练完成后,我们从纯噪声出发,通过 100 步 Euler 采样 逐步生成数据。这里每一步都重新调用同一个网络 v θ v_\theta vθ,并且只在初始化时抽取一次噪声,后续每一步不再额外加噪。
使用最简单的 Euler 更新公式:
x t + Δ t = x t + Δ t v θ ( x t , t ) \boxed{x_{t+\Delta t}=x_t+\Delta t\,v_\theta(x_t,t)} xt+Δt=xt+Δtvθ(xt,t)
这里设置生成过程走 100 步 ,所以时间步长 Δ t = 0.01 \Delta t=0.01 Δt=0.01。注意:这 100 步是采样精度 的设置,不是训练中离散时间步的数量。
python
model.eval()
n_steps = 100          # 采样步数
dt = 1.0 / n_steps     # 时间步长 Δt = 0.01

# 只在初始化时抽取一次噪声
z = torch.randn(1500, 2, device=device)
x_t = z.clone()

with torch.no_grad():
    for i in range(n_steps):
        t = torch.full((len(x_t),), i * dt, device=device)
        v = model(x_t, t)          # 每一步重新调用同一个网络
        x_t = x_t + dt * v         # Euler 更新

fig, ax = plt.subplots(figsize=(4, 4))
plot_points(ax, x_t, "Generated (100-step Euler)")
plt.tight_layout()
plt.show()
从上面的代码可以看到,整个生成过程就是一个确定性的 ODE 积分:给定初始噪声 z z z,沿着网络预测的速度场 v θ v_\theta vθ 走 100 步,最终得到近似数据分布的样本。
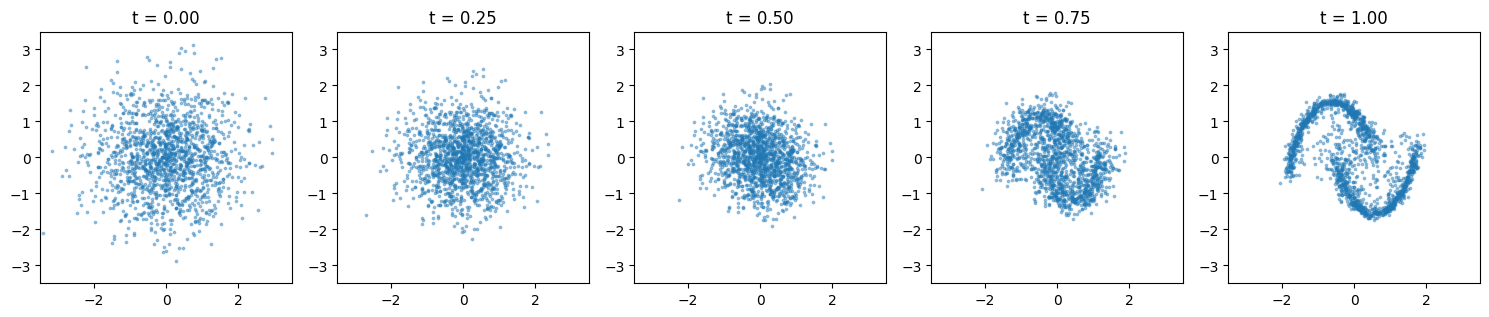
这个地方非常好理解,比DDPM的反向高斯采样好理解多了,DDPM需要推导公式再去更新,流模型的更新就是当前位置加上时间乘以速度,这个地方个人理解非常好!非常清爽。下面的部分也说明了,流模型不一定生成的快还是得一步一步的,但是流模型的这种形式更加清晰简洁。现在也是非常火这个模型。
6. 相同起点,一步与多步比较
一步使用 d t = 1 d_t=1 dt=1;直线训练不保证学到的生成流能用一步准确求解。
python
with torch.no_grad():
    t_zero = torch.zeros(len(initial_noise), device=device)
    one_step = initial_noise + model(initial_noise, t_zero)

fig, axes = plt.subplots(1, 3, figsize=(12, 4))
plot_points(axes[0], data[:1500], "Real data")
plot_points(axes[1], one_step, "1 Euler step")
plot_points(axes[2], generated, "100 Euler steps")
plt.tight_layout()
plt.show()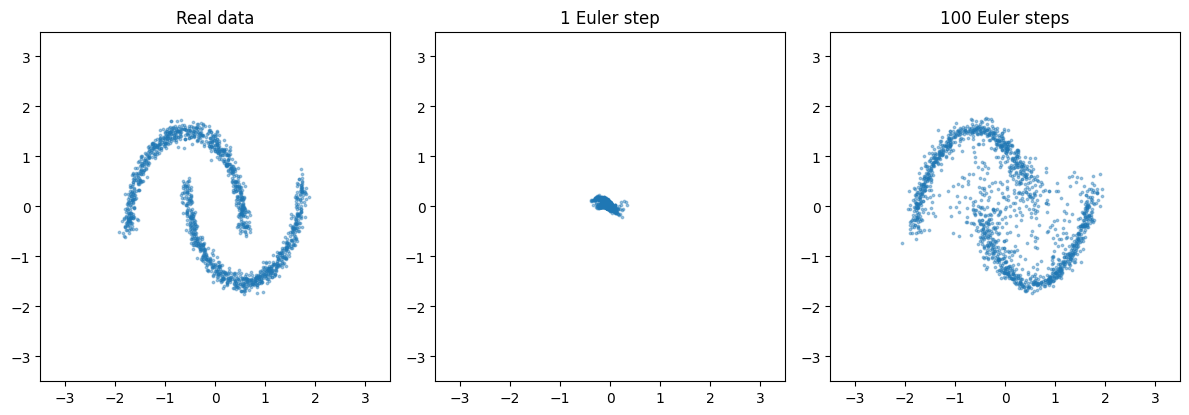
后面再更新条件模型。