****论文题目:****FiDeSR: High-Fidelity and Detail-Preserving One-Step Diffusion Super-Resolution(FiDeSR:高保真保细节一步扩散超分辨率)
会议:CVPR 2026
****摘要:****基于扩散的方法最近推动了真实世界图像超分辨率(SR)的显著进步。然而,现有的方法仍然难以同时保持精细的细节和确保高保真重建,这往往导致视觉质量不佳。在本文中,我们提出了一种高保真的一步扩散超分辨率框架FiDeSR。在训练过程中,我们引入了一种细节感知加权策略,该策略自适应地强调模型表现出较高预测误差的区域。在推理过程中,低频和高频自适应增强器在不需要模型重新训练的情况下进一步细化重建,从而实现灵活的增强控制。为了进一步提高重建精度,FiDeSR引入了残差-残差噪声细化,纠正了扩散噪声中的预测误差,并增强了细节恢复。与现有的基于扩散的方法相比,FiDeSR实现了卓越的真实SR性能,产生了同时具有高感知质量和忠实内容恢复的输出。
源代码将在以下网址发布:https://githorb.com/Ar0Kim/FiDeSR。
FiDeSR:兼顾高保真与细节保留的一步扩散超分辨率
一、研究背景与问题动机
图像超分辨率(Super-Resolution, SR)的目标是从低质量(LQ)输入中恢复出高质量(HQ)图像。真实世界场景下的图像往往受到未知的复杂退化(噪声、模糊、压缩伪影等)的影响,这催生了**真实世界图像超分辨率(Real-ISR)**这一研究方向。
近年来,扩散模型(Diffusion Models)凭借强大的生成先验,在 Real-ISR 任务上取得了显著进展。然而,传统多步扩散方法(如 StableSR 需要 200 步,DiffBIR/SeeSR 需要 50 步)推理耗时极长、计算代价高昂。为此,研究者提出了一步扩散超分辨率方法,通过知识蒸馏将多步过程压缩为单步前向推理。
然而,现有一步扩散方法仍然面临两大核心挑战:
挑战一:高保真度问题(High-Fidelity)
基于 VAE 条件化的一步扩散方法容易引入结构扭曲和低频不一致,难以在恢复高频细节的同时保持图像内容的忠实性。以 AddSR 为例,其输出常出现形状变形和全局色调偏移。
挑战二:细节恢复不足(Insufficient Detail Restoration)
- 扩散过程中的噪声注入会破坏高频信息,而 VAE 编码器将像素级表示压缩到紧凑隐空间,进一步放大了高频损失。
- 多步扩散通过多次迭代去噪来补偿这种损失,但一步扩散只有单次前向传播,导致高频细节恢复严重不足(如 OSEDiff 产生过度平滑的纹理)。
- 现有一步模型(如 PiSA-SR)采用 U-Net 预测单一全局残差的策略,但 U-Net 每阶段只预测一个全局残差,导致高频重建不稳定,出现残差伪影(如 PiSA-SR 生成过度增强的纹理)。
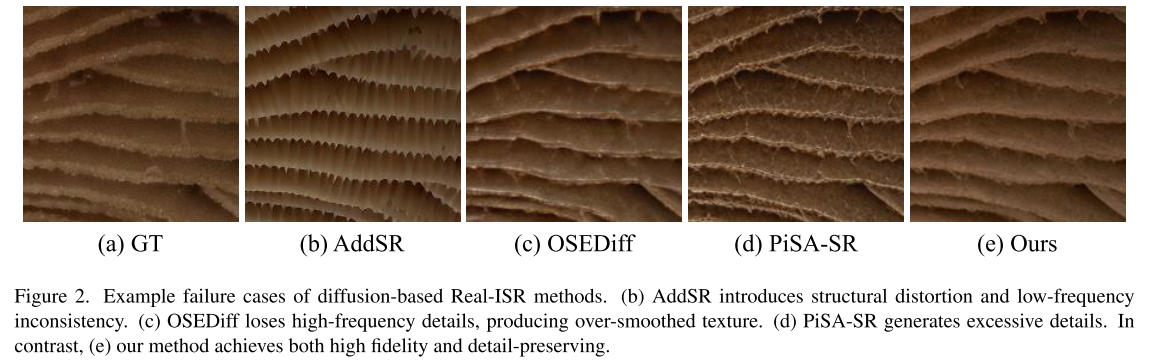
📌 此处配 Figure 2(论文中展示 AddSR、OSEDiff、PiSA-SR 失败案例的对比图)
二、FiDeSR 方法总览
针对上述问题,本文提出 FiDeSR(High-Fidelity and Detail-Preserving One-Step Diffusion Super-Resolution),引入三个核心组件:
| 组件 | 作用阶段 | 解决的问题 |
|---|---|---|
| 细节感知加权(DAW) | 训练阶段 | 引导模型聚焦难以重建的细节区域 |
| 潜在残差精化块(LRRB) | 训练+推理 | 精化粗残差预测,减少高频伪影 |
| 潜在频率注入模块(LFIM) | 推理阶段 | 自适应增强低/高频分量,无需重训练 |
整体框架分为训练过程 和推理过程两个阶段:
- 训练阶段 :LQ 图像经 VAE 编码得到隐表示
,扩散网络预测粗残差 r,经 LRRB 精化得到
- 推理阶段 :在上述流程基础上,额外引入 LFIM,对
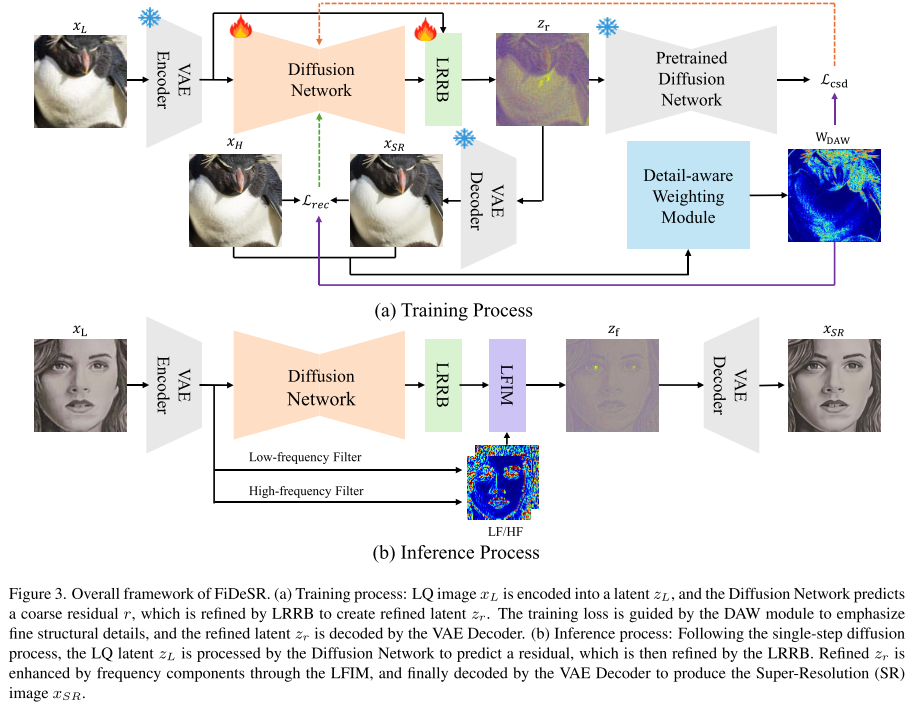
📌 此处配 Figure 3(FiDeSR 整体框架图,包含训练与推理流程)
三、核心组件详解
3.1 细节感知加权(Detail-aware Weighting, DAW)
DAW 的核心思想是:在训练中让损失自适应地聚焦于视觉复杂、当前模型预测误差较大的区域,而非均匀对待所有像素。
细节图 D 的构建:对 HQ 目标图像 分别应用 Sobel(捕捉边缘锐度)、Laplacian(捕捉局部对比度)、局部方差(捕捉纹理方差)三种空间滤波器,取均值:
误差图 E 的构建:综合像素级误差(L1 距离)和感知误差(LPIPS):
其中 p 控制感知误差的贡献比例。
难度权重图 通过对细节图和误差图做逐元素相乘得到:
该权重图对每个空间位置的损失贡献进行自适应缩放,高权重赋予视觉复杂或细节丰富的区域 。 同时应用于重建损失(MSE + LPIPS)和分类器分数蒸馏损失(CSD Loss):
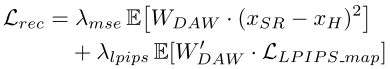
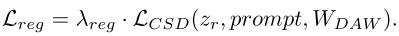
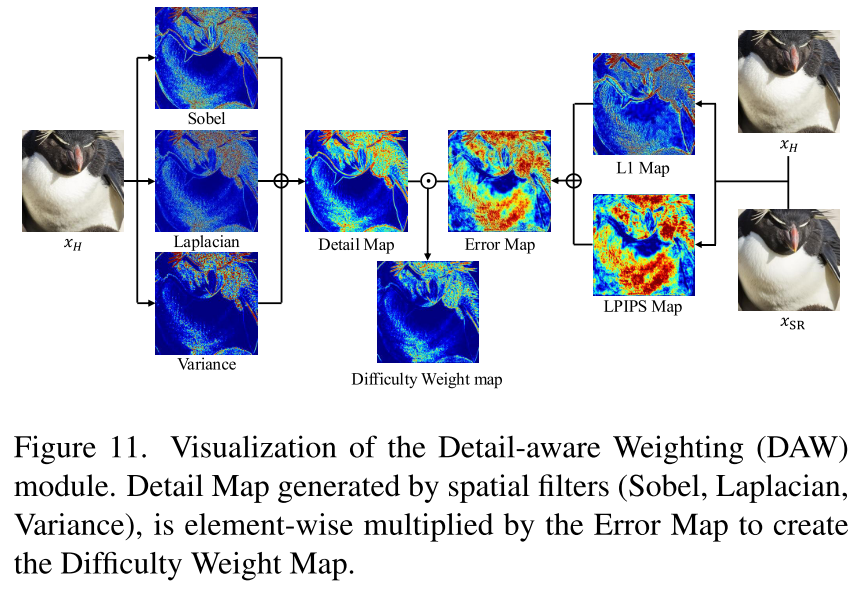
📌 此处配 Figure 11(DAW 模块可视化,展示细节图、误差图和难度权重图的生成流程)
3.2 潜在残差精化块(Latent Residual Refinement Block, LRRB)
问题根源 :现有一步扩散方法(如 PiSA-SR)让 U-Net 直接预测 LQ 隐空间到 HQ 隐空间的全局残差 r,然后执行 。这种单一全局残差预测缺乏迭代修正能力,容易产生不稳定的高频重建和残差伪影。
LRRB 的设计 :受 ESRGAN 中 RRDB(残差中残差密集块)启发,但与其在像素空间操作不同,LRRB 在隐空间中专门针对扩散引起的残差不稳定性进行精化:
- 将 LQ 隐表示
- 经 1×1 卷积映射到中间隐空间,通过多个密集块模块处理
- 再经 1×1 卷积输出修正量
- 精化残差:
- 最终精化隐表示:
这一两阶段过程使模型获得了更大的灵活性,能够对残差进行更精确、更复杂的调整,从而得到更准确的精化隐表示 。
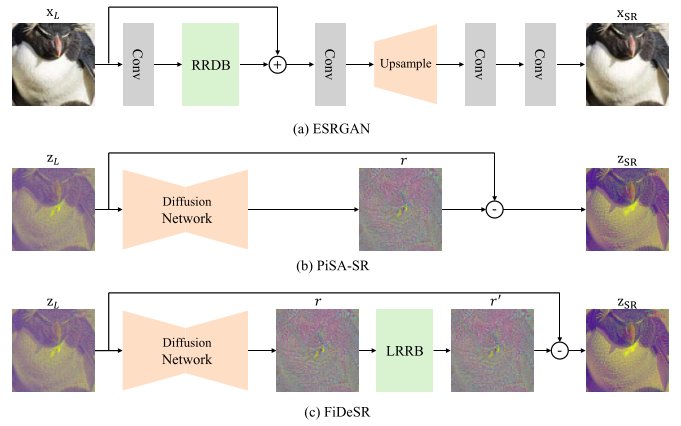
📌 此处配 Figure 4(ESRGAN、PiSA-SR 与 FiDeSR 的流程对比图)ESRGAN、PISA-SR和我们的FiDeSR之间的管道比较。(A)ESRGAN采用基于RRDB的像素空间恢复。(B)PISA-SR使用一步扩散网络来预测潜在空间中的全局残差。(C)我们的FiDeSR引入了潜在残差精化块(LRRB),它逐步精化残差。
3.3 潜在频率注入模块(Latent Frequency Injection Module, LFIM)
LFIM 仅在推理阶段 使用,无需重新训练模型,提供灵活的增强控制。
对精化后的隐表示 ,通过基于 FFT 的 Butterworth 滤波器将其分解为低频分量
和高频分量
,随后通过空间门控 和通道门控进行选择性注入:
低频注入(LFIM on LF):稳定全局结构、色调和光照一致性
- 空间门控
- 通道门控
- 注入公式:
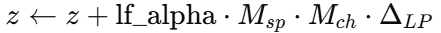
高频注入(LFIM on HF):增强纹理、边缘和微观细节
- 空间门控通过细节依赖指数
- 通道门控选择与 LF 门控互补的频率丰富通道
- 注入公式:
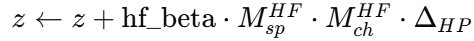
默认参数设置为 lf_alpha = 0.2, hf_beta = 0.2,在全局结构一致性和感知细节增强之间取得平衡。
四、实验设置
训练数据:LSDIR、DIV2K、Flickr2K,以及 FFHQ 前 10K 张图像,使用 Real-ESRGAN 退化流水线生成 LQ-HQ 对。
测试数据:
- 合成数据集:DIV2K 验证集裁剪的 3000 张 512×512 图像,退化为 128×128 LQ 输入
- 真实世界数据集:RealSR、DRealSR(LQ 128×128 → HQ 512×512)
评价指标:
- 全参考指标(需要 GT):PSNR、SSIM、LPIPS、DISTS、FID
- 无参考指标(无需 GT):CLIP-IQA、NIQE、MUSIQ、MANIQA
实现细节:基于 Stable Diffusion 2.1-base,VAE 和 U-Net 权重冻结,为 U-Net 添加可训练的 LoRA 层(rank=8)。在 2 块 NVIDIA H100 GPU 上训练 200K 步,batch size=8,AdamW 优化器,学习率 5×10⁻⁵。损失权重 \\lambda_{mse}=1,\\lambda_{lpips}=2。
五、实验结果与分析
5.1 与现有方法的定量对比
FiDeSR 在三个测试数据集上与多种多步和一步扩散方法进行了全面对比(对比方法包括 StableSR-200s、SeeSR-50s、DiffBIR-50s、PASD-20s、AddSR-4s、OSEDiff-1s、SinSR-1s、PiSA-SR-1s)。
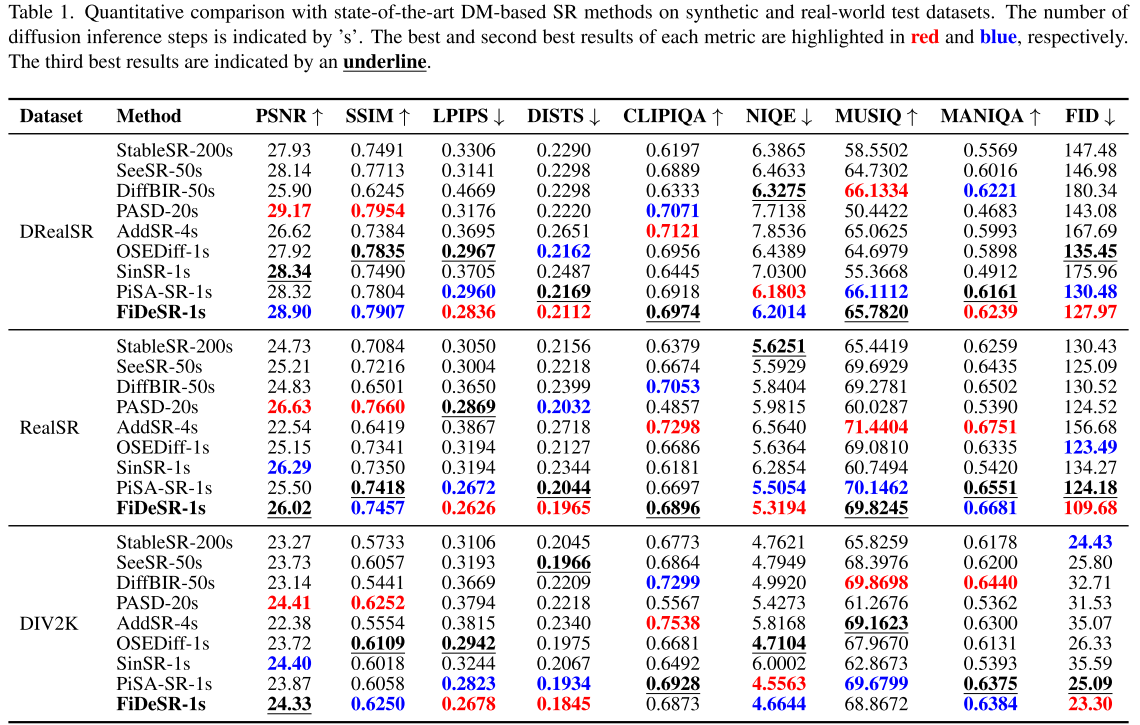
📌 此处配 Table 1(各方法在 DRealSR、RealSR、DIV2K 三个数据集上的完整定量对比)
核心结论:
- DRealSR 数据集:FiDeSR 以 PSNR=28.90、LPIPS=0.2836、DISTS=0.2112、FID=127.97 全面领先,SSIM=0.7907 排名第二(仅次于 PASD-20s 的 0.7954,但 PASD 需要 20 步推理)。
- RealSR 数据集 :LPIPS=0.2626(最优)、DISTS=0.1965(最优)、FID=109.68(最优),相比第二名 PiSA-SR 的 FID=124.18 降低约 11.7%,显示出与真实图像分布最为接近的重建质量。
- DIV2K 合成数据集:LPIPS=0.2678(最优)、DISTS=0.1845(最优)、FID=23.30(最优)。
- FiDeSR 仅需 1 步推理,推理时间 0.078s,参数量 1.29B,与其他一步方法(SinSR: 0.097s,OSEDiff: 0.087s,PiSA-SR: 0.057s)保持竞争力。
值得注意的是,FiDeSR 在全参考指标(PSNR/SSIM/LPIPS)和无参考指标(MANIQA/MUSIQ)上同时取得优秀成绩,而这两类指标通常存在感知-失真权衡(perception-distortion tradeoff),FiDeSR 的平衡能力尤为突出。
5.2 与 GAN 方法的对比
FiDeSR 同样优于 GAN 类方法(Real-ESRGAN、BSRGAN、LDL):
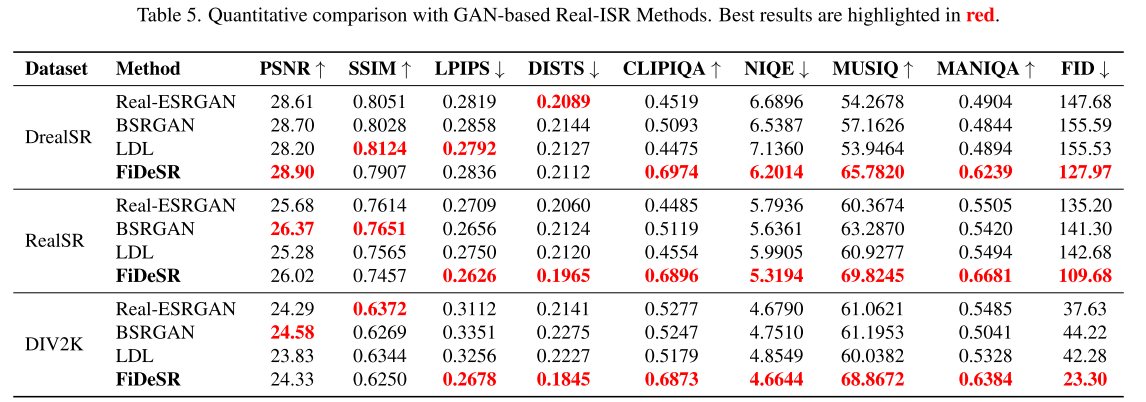
📌 此处配 Table 5(与 GAN-based Real-ISR 方法的定量对比)
- 在 LPIPS 和 DISTS 方面大幅超越 GAN 方法,感知相似度更高
- 在 CLIP-IQA、NIQE、MUSIQ、MANIQA 等无参考指标上明显领先,生成图像更接近自然图像统计分布
- GAN 方法普遍存在过平滑纹理、细节不准确和结构重建不稳定的问题
5.3 定性对比
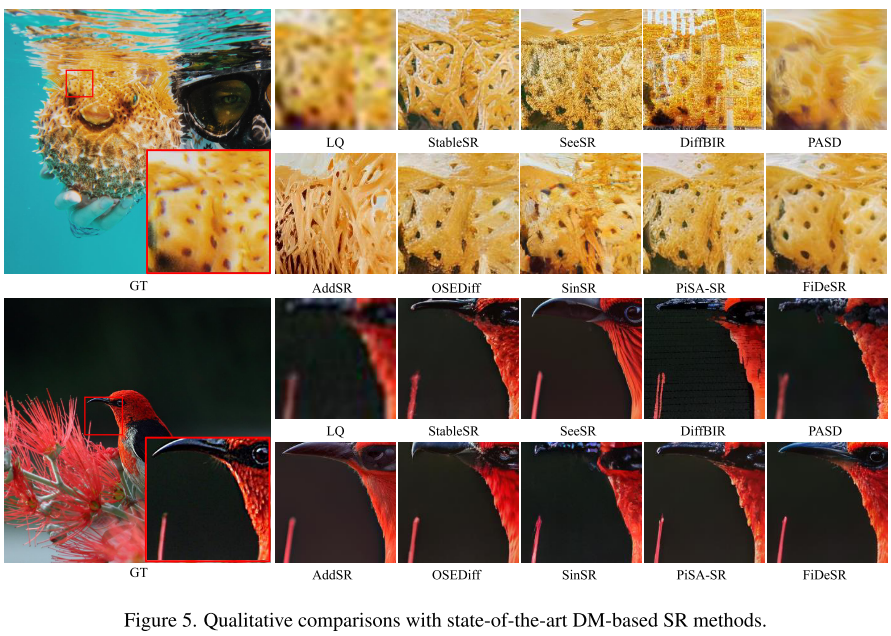
📌 此处配 Figure 5(与 SOTA 扩散方法的视觉对比,包含蜥蜴皮肤、鸟类羽毛等细节丰富的样例)
视觉对比结论:
- SeeSR 等多步方法虽细节丰富,但易引入噪声伪影,损害保真度
- AddSR 偏离真实结构,局部细节缺失
- DiffBIR 存在明显噪声伪影
- PASD 纹理模糊、结构一致性差
- OSEDiff 保留了部分粗糙结构,但高频重建不足
- PiSA-SR 感知锐度有所提升,但在复杂区域引入过度增强或不一致纹理
- FiDeSR 在结构完整性和精细细节方面均最接近真实图像(GT),同时不引入多余伪影
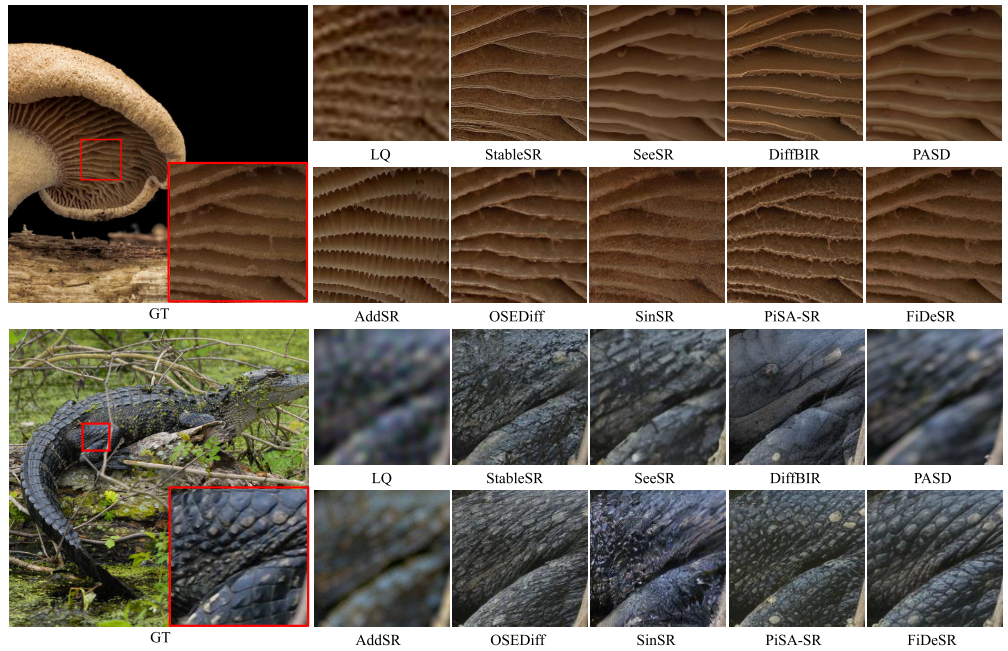
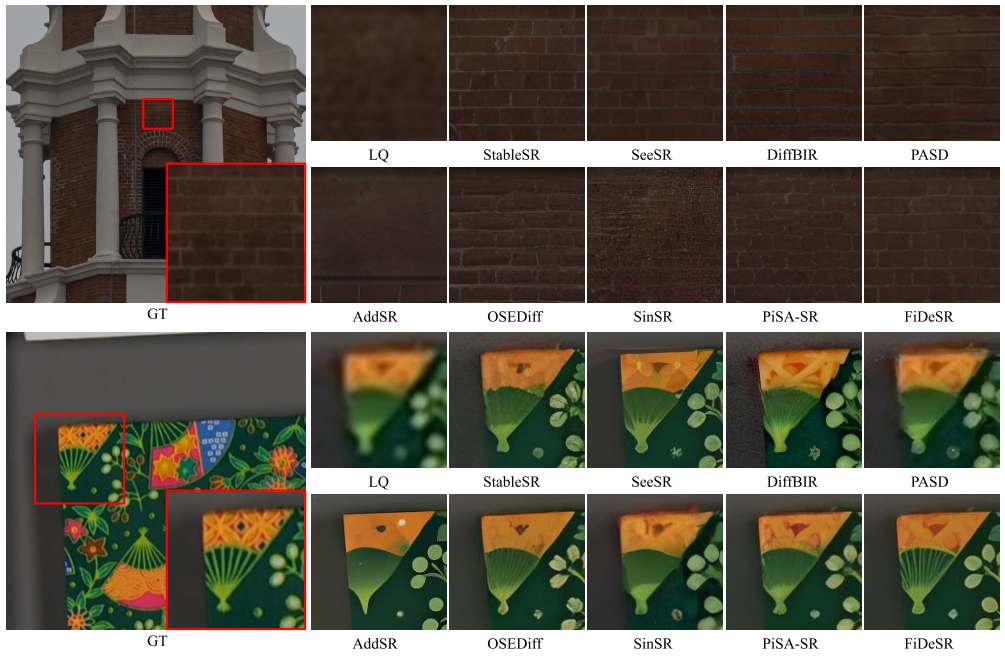
📌 (更多数据集上的补充视觉对比)
5.4 消融实验
LRRB 和 DAW 的贡献:
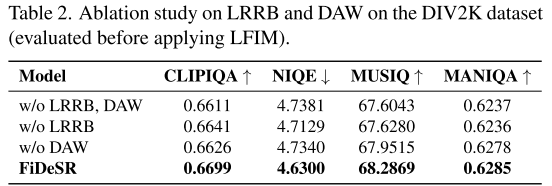
📌 此处配 Table 2(LRRB 和 DAW 的消融实验,在 DIV2K 上的感知指标对比)
在 DIV2K 数据集上,逐步移除各组件后感知指标均下降:
- 移除 LRRB:CLIPIQA 从 0.6699 降至 0.6641,MUSIQ 从 68.2869 降至 67.6280
- 移除 DAW:CLIPIQA 从 0.6699 降至 0.6626,MANIQA 从 0.6285 降至 0.6278
- 两者同时移除时性能最差,说明两个模块具有互补效应
LRRB 的高频噪声预测精化效果:
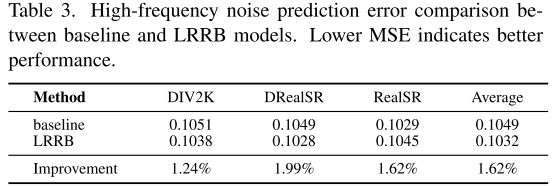
📌 此处配 Table 3(LRRB 对高频噪声预测误差的改善对比)
引入 LRRB 后,在三个数据集上高频噪声预测 MSE 平均降低 1.62%(DIV2K: -1.24%,DRealSR: -1.99%,RealSR: -1.62%),并且误差改善集中在边缘和精细纹理等感知重要区域。
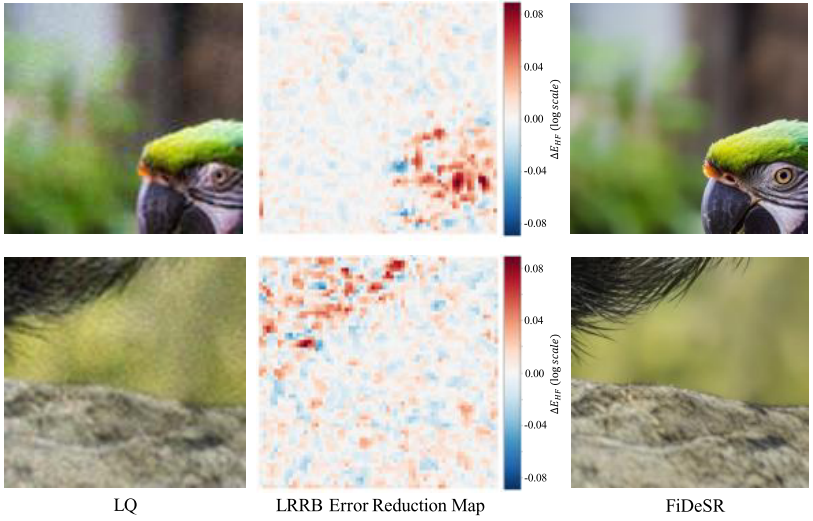
📌 此处配 Figure 10(LRRB 高频噪声预测误差改善的空间分布可视化)
LFIM 低/高频注入的效果:
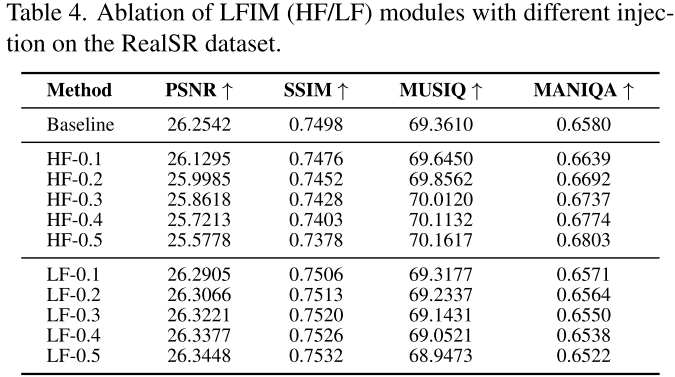
📌此处配 Table 4(LFIM 不同注入强度的消融实验)
在 RealSR 数据集上:
- LF 注入:随注入强度增大,PSNR 和 SSIM 单调提升(LF-0.5 时 PSNR=26.3448,SSIM=0.7532),确认低频信息有助于稳定全局结构
- HF 注入:随注入强度增大,MUSIQ 和 MANIQA 显著提升(HF-0.5 时 MUSIQ=70.1617,MANIQA=0.6803),但 PSNR 和 SSIM 有所下降,体现感知-失真权衡
- 两者组合使用可灵活控制保真度与感知锐度的平衡
5.5 用户研究
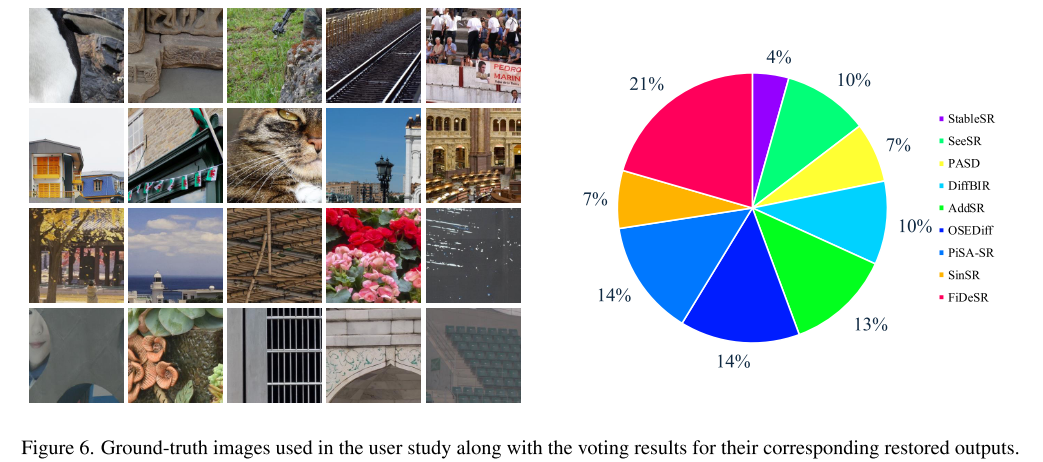
📌 此处配 Figure 6(用户研究投票饼图)
从 DIV2K、DRealSR、RealSR 各随机选取图像共 20 张,邀请 20 名志愿者选出感知真实感与内容保真度最优的结果。FiDeSR 以 21% 的投票率位居第一,远超排名第二的 StableSR(14%),证明了其在主观视觉质量上的优越性。
5.6 复杂度分析
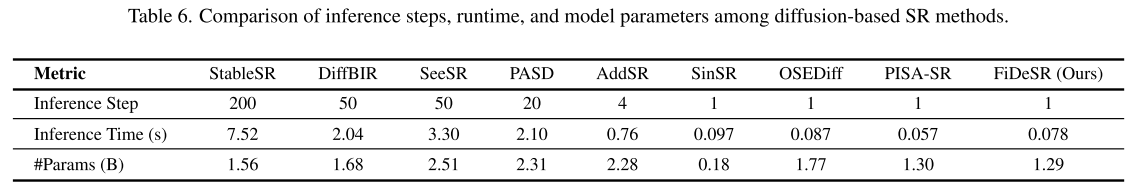
📌 此处配 Table 6(各方法推理步数、推理时间和参数量对比)
FiDeSR 在引入 LRRB 和 LFIM 的情况下仍保持竞争性的推理速度:
- 相比无 LRRB 的基线,引入 LRRB 仅增加 0.01B 参数(约占总量 1.29B 的 0.8%)
- 推理时间仅增加 0.0063s(约 8.1% 的额外开销)
- 整体推理时间 0.078s,处于一步方法的合理范围内
六、结论与展望
FiDeSR 通过三个互补的技术组件------DAW、LRRB、LFIM------系统性地解决了一步扩散超分辨率中高保真度与细节保留的双重挑战:
- DAW 在训练时自适应聚焦难以重建的细节区域,引导模型合理分配学习资源
- LRRB 将单一全局残差预测升级为两阶段精化过程,显著减少高频重建伪影
- LFIM 在推理时通过频率感知的选择性注入,灵活平衡结构保真度与感知锐度,且无需重新训练
FiDeSR 在 DRealSR、RealSR 和 DIV2K 三个基准上,以单步推理实现了优于现有一步和多步扩散方法的综合性能,在 FID 指标上尤为突出,显示出与真实图像分布的高度一致性。
未来展望:论文指出,FiDeSR 的设计思路------频率感知引导与残差精化的结合------为高效真实世界 SR 开辟了新方向,有望扩展至视频超分辨率或多模态图像恢复任务。