利用 Stable Diffusion 的生成先验来做判别式的分割任务!
论文:SD-FSMIS: Adapting Stable Diffusion for Few-Shot Medical Image Segmentation
代码:https://github.com/Galaxy-Knight-Lee/SD-FSMIS
0、摘要
小样本医学图像分割 (Few-Shot Medical Image Segmentation,FSMIS)旨在仅利用少量标注样本,实现医学图像中新目标类别的分割,以此解决医学影像领域普遍存在的数据稀缺与域偏移难题。(小样本分割意义)
尽管扩散模型(DM)在视觉任务中表现优异,但该模型用于小样本医学图像分割的潜力仍有待深入挖掘(没做过的领域试试?)。本文认为,大规模扩散模型所学习得到的丰富视觉先验 ,可为构建更鲁棒、数据高效的分割方法提供强有力基础。(预训练模型)
本文提出 SD-FSMIS 这一全新框架,将预训练的 Stable Diffusion(SD)模型有效适配至小样本医学图像分割任务。该方法对其条件生成架构进行复用,并引入两大核心模块:支持集 - 查询集交互模块(Support-Query Interaction,SQI)与视觉 - 文本条件转换模块(Visual-to-Textual Condition Translator,VTCT)。
具体而言,SQI 模块 提供了一种简洁且高效的方案,将 Stable Diffusion 适配至小样本分割范式;VTCT 模块则将来自支持集的视觉线索转换为隐式文本嵌入,用于引导扩散模型,实现对生成过程的精准条件约束。
大量实验表明,在标准实验设置下,SD-FSMIS 取得了与当前前沿方法相媲美的结果;令人惊喜的是,该方法在难度更高的跨域场景中同样具备优异泛化能力。上述结果表明,适配大规模生成模型能够推动数据高效、鲁棒的医学图像分割技术发展,具备巨大研究潜力。
1、引言
1.1、研究意义与当前挑战
(1)在各类医学领域中获取大规模、高质量的像素级标注样本 ,难度极大、成本高昂且十分耗时。此外,成像协议、扫描仪型号、解剖形态差异,或是训练阶段未曾见过的病变类型,均会引发域偏移问题,严重干扰模型在临床场景中的落地部署。(标注难问题)
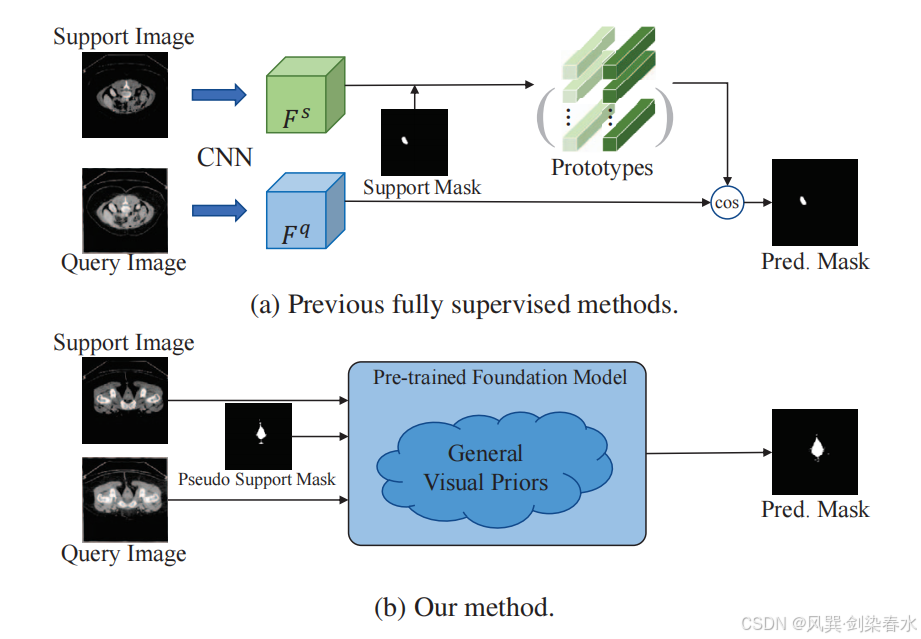
(2)小样本学习 旨在仅利用少量标注样本训练模型,使其具备识别新类别并泛化到新样本的能力;(优势)传统小样本医学图像分割 方法大多仍聚焦于设计更精巧的匹配网络,例如采用原型网络与注意力机制的相关模型,如 图 1a 所示。但此类模型受限于自身固有的架构缺陷,当面对复杂或未见过的样本变化时,会出现性能下降。这种脆弱性严重制约了模型的临床实用性与鲁棒性。(挑战)
(3)本文提出范式层面的思路转变,其概念示意如 图 1b。本文不再基于有限数据去设计愈发复杂的任务专属网络结构,而是借助大规模预训练基础模型中蕴含的强大、可泛化的视觉先验知识 。(聚焦先验,大力出奇迹)
Figure 1 | 本文所提方法与现有方法的对比:
( a ) 以往全监督方法从零开始构建任务专用网络,需要像素级标注。这类方法基于有限的支持集生成类别原型,并通过特征匹配完成分割。由于缺乏强先验且仅在有限数据上训练,该类模型通常鲁棒性较弱,难以应对复杂的视觉变化。
( b ) 本文不新建网络,而是对性能强大的预训练基础模型进行适配,无需依赖人工标注。本框架利用模型海量且具备泛化能力的视觉先验,实现更优的鲁棒性与泛化性能,在难度较高的跨域场景中效果尤为突出。
1.2、本文贡献
(1)本文提出一种全新的小样本医学图像分割(FSMIS)范式,利用预训练文生图扩散模型中丰富且具备泛化性的视觉先验,解决跨域泛化这一核心难题。该范式将研究重心从从零设计任务专用网络,转向对高性能基础模型进行高效适配;
(2)本文提出 SD-FSMIS,一个简洁新颖的适配框架。该框架包含用于隐空间融合的支持集 - 查询集交互(SQI)模块,以及视觉转文本条件转换器(VTCT)模块;后者可将视觉线索转化为类文本条件信号,实现对扩散模型的精准引导;
(3)大量实验表明,本文方法不仅在标准小样本医学图像分割任务 中取得具有竞争力的性能,更重要的是,在难度较高的跨域场景下显著优于现有最优方法。该结果从实验层面验证了所提方法在应对复杂多变医学影像时具备更优异的泛化能力与鲁棒性;
2、方法
2.1、问题定义
小样本语义分割旨在训练模型,使其仅利用少量标注数据即可对新类别图像完成分割,且无需对模型重新训练。具体而言,训练集 D t r a i n D_{train} Dtrain 包含拥有充足标注样本的基类集合 C t r a i n C_{train} Ctrain;测试集 D t e s t D_{test} Dtest 包含仅有少量标注样本的新类集合 C t e s t C_{test} Ctest,满足 C t r a i n ∩ C t e s t = ∅ C_{train} \cap C_{test} = \emptyset Ctrain∩Ctest=∅。
本文采用小样本语义分割任务中通用的 基于片段(episode) 的训练方式。训练集与测试集均被划分为多个片段,每个片段包含一个支持集 S S S 和与之对应的同类别查询集 Q Q Q。每一类的支持集包含 K K K 组图像 - 掩码对,记为 S = { ( I s i , M s i ) } i = 1 K S = \{(I_s^i, M_s^i)\}_{i=1}^{K} S={(Isi,Msi)}i=1K;对应的查询集记为 Q = ( I q , M q ) Q=(I^q,M^q) Q=(Iq,Mq)。其中, I ∈ R H × W × 1 I \in \mathbb{R}^{H \times W \times 1} I∈RH×W×1 代表灰度图像, M ∈ { 0 , 1 } H × W M \in \{0,1\}^{H \times W} M∈{0,1}H×W 代表对应的二值掩码。从支持集 S S S 学习类别信息,再对查询图像预测掩码。
参照 ADNet,本文针对小样本医学图像分割采用 1-way 1-shot 元学习策略 。此外,本文使用 ADNet 提出的体素级聚类方法生成伪标签作为训练标注。该方法能够更好利用医学图像的体数据特征,且无需对数据进行显式标注。
2.2、网络架构
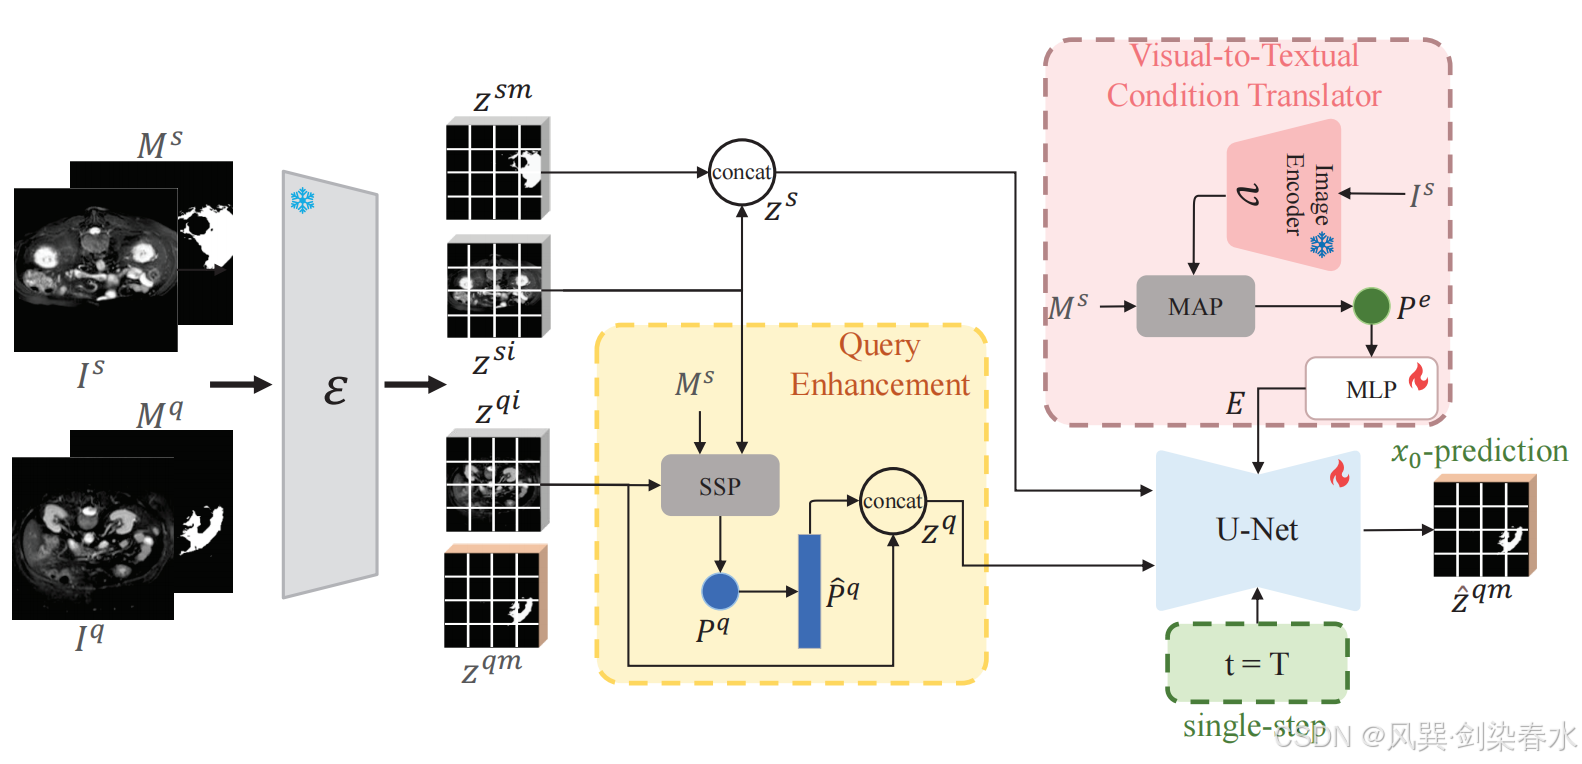
为将 Stable Diffusion 应用于 FSMIS 任务,本文提出一种新方法 SD-FSMIS。整体架构如 图 2 所示,包含两大创新核心模块:支持集 - 查询集交互(SQI)模块 与视觉转文本条件转换器(VTCT)模块 ,二者协同完成小样本学习流程。**网络的核心依托 Stable Diffusion 学习得到的强大生成先验,**该模型原始训练基于大规模 LAION-5B 数据集。本文仅对模型组件进行少量针对性修改,将其改造为高效的小样本分割框架。
VAE 编码器与解码器。
本文采用 Stable Diffusion 的预训练 VAE 模块,将图像与掩码映射至同一隐空间,并在该空间内执行条件去噪过程。训练全程冻结 VAE 权重,保留其在原始训练阶段学到的丰富视觉特征。本文在附录中探究了 VAE 对医学图像与二值掩码的重建能力。
VAE 原本面向三通道 RGB 输入设计,将其适配至单通道医学图像及其对应的二值分割掩码是一项关键难点。为解决该问题,本文将输入图像与掩码沿通道维度复制三份,构造伪 RGB 表征。此外,图像与掩码的像素值均归一化至 − 1 , 1 -1,1 −1,1 区间,以匹配 VAE 的输入分布要求。
推理阶段,扩散过程输出预测掩码的隐表征后,由冻结的 VAE 解码器将其映射回像素空间。该步骤得到三通道输出,随后对各通道求平均,得到最终单通道分割预测掩码。
U-Net 的适配。
为使 U-Net 能够接收支持集与查询集隐变量作为输入,本文参照文献 15 的方法,新增一层输入卷积层,用于级联来自支持集的特征。
Figure 2 | SD-FSMIS 整体框架与训练流程:首先利用 VAE 编码器对支持集与查询集进行编码。查询隐变量 z q i z^{q_i} zqi 经由查询增强模块得到 z q z^q zq;同时将支持集隐变量 z s i z^{s_i} zsi 及其掩码隐变量 z s m z^{s_m} zsm 沿通道维度拼接,得到 z s z^s zs。上述特征随后输入 U-Net,在视觉转文本条件转换器模块 生成的文本嵌入 E E E 的条件约束下,输出查询掩码隐变量 z ^ q m \hat{z}^{q_m} z^qm。
2.3、支持集 - 查询集交互模块(SQI)
如 图 2 所示, **SQI 模块用于将支持集信息融入查询特征处理流程。**首先采用冻结的 VAE 编码器 E \mathcal{E} E 对支持集(图像 I s I^s Is、掩码 M s M^s Ms)与查询集(图像 I q I^q Iq、掩码 M q M^q Mq)进行编码,得到对应的隐表征 z ∈ R 1 × c × h × w z \in \mathbb{R}^{1 \times c \times h \times w} z∈R1×c×h×w。具体地,记 z s i z^{si} zsi 为支持图像隐变量, z s m z^{sm} zsm 为支持掩码隐变量, z q i z^{qi} zqi 为查询图像隐变量。将 z s i z^{si} zsi 与 z s m z^{sm} zsm 沿通道维度拼接,得到组合支持隐变量 z s = c o n c a t ( z s i , z s m ) z^s = \mathrm{concat}(z^{si},z^{sm}) zs=concat(zsi,zsm),作为 U-Net 的输入。
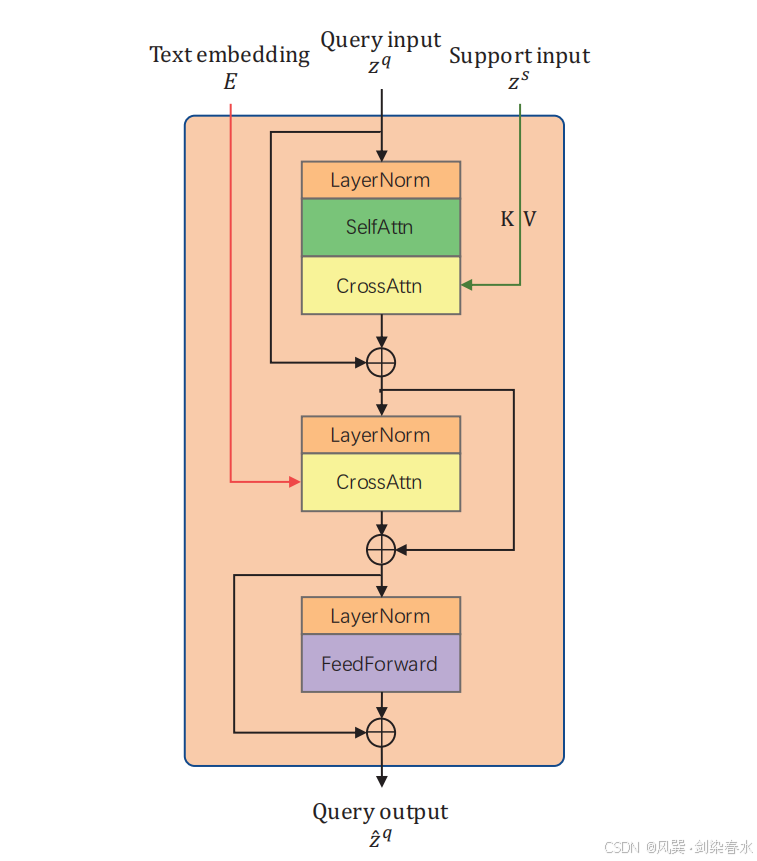
支持信息注入(SII)。 Stable Diffusion 中的 U-Net 采用基础 Transformer 块,将条件信息(通常为文本嵌入)与图像特征融合。每个块依次执行自注意力(SAttn)、交叉注意力(CAttn)与前馈网络(FFN) 。受文献 46 启发,本文对该结构进行修改,向查询特征注入支持集信息,如 图 3 所示。在对查询输入 z q z^q zq 执行标准自注意力之后,新增一层交叉注意力,使查询输入对支持输入 z s z^s zs(作为键 K K K 与值 V V V)进行注意力计算;经过该增强后的查询输入,再与文本嵌入 E E E 执行原有交叉注意力。修改后的运算如下:
z ^ q = F F N ( C A t t n ( C A t t n ( S A t t n ( z q ) , z s ) , E ) ) . (1) \hat{z}^q = \mathrm{FFN}\big(\mathrm{CAttn}\big(\mathrm{CAttn}\big(\mathrm{SAttn}(z^q), z^s\big), E\big)\big). \tag{1} z^q=FFN(CAttn(CAttn(SAttn(zq),zs),E)).(1)
Figure 3 | 改进的 BasicTransformerBlocks 架构:
查询特征增强(QE)。 为进一步强化支持集与查询集之间的交互,本文采用基于原型的查询隐变量增强策略。QE 模块 的结构如 图 2 黄色框区域所示。
首先,本文参考 SSP 方法提取查询原型 P q P^q Pq。具体而言,依托支持掩码 M s M^s Ms,对支持图像隐变量 z s i z^{si} zsi 执行掩码平均池化(MAP),从支持集中计算前景原型 P s ∈ R 1 × c P^s \in \mathbb{R}^{1\times c} Ps∈R1×c:
P s = ∑ i , j M i , j s ⊙ z i , j s i ∑ i , j M i , j s , (2) P^s = \frac{\sum_{i,j} M_{i,j}^s \odot z_{i,j}^{si}}{\sum_{i,j} M_{i,j}^s}, \tag{2} Ps=∑i,jMi,js∑i,jMi,js⊙zi,jsi,(2)式中, M i , j s M_{i,j}^s Mi,js 为空间位置 ( i , j ) (i,j) (i,j) 处的掩码取值; z i , j s i z_{i,j}^{si} zi,jsi 为对应位置的隐特征向量; ⊙ \odot ⊙ 代表逐元素相乘。(这大小似乎不匹配呀)
其次,计算 P s P^s Ps 与 z q i z^{qi} zqi 之间的余弦相似度,生成概率图 prob。将相似度得分 prob 高于阈值 τ \tau τ(本文中取 τ = 0.7 \tau=0.7 τ=0.7)对应的查询隐变量 z q i z^{qi} zqi 取均值,得到查询原型 P q ∈ R 1 × c P^q \in \mathbb{R}^{1\times c} Pq∈R1×c:
P q = m e a n { z i , j q i ∣ p r o b i , j > τ } . (3) P^q = \mathrm{mean}\{z_{i,j}^{qi} \mid prob_{i,j} > \tau\}. \tag{3} Pq=mean{zi,jqi∣probi,j>τ}.(3)将该查询原型 P q P^q Pq 在空间维度上扩展,使其维度与 z q i z^{qi} zqi 保持一致,得到 P ^ q ∈ R 1 × c × h × w \hat{P}^q \in \mathbb{R}^{1\times c\times h\times w} P^q∈R1×c×h×w。将扩展后的查询原型与原始查询图像隐变量沿通道维度拼接,得到 z q t ∈ R 1 × 2 c × h × w z^{qt} \in \mathbb{R}^{1\times 2c\times h\times w} zqt∈R1×2c×h×w:
z q t = c o n c a t ( z q i , P ^ q ) . (4) z^{qt} = \mathrm{concat}(z^{qi}, \hat{P}^q). \tag{4} zqt=concat(zqi,P^q).(4)
2.4、视觉 - 文本条件转换器(VTCT)
已有研究常采用空文本嵌入 ,但该方式无法提供具体引导,也不能充分利用模型强大的文本条件机制。为此,本文提出视觉 - 文本条件转换器 ,该模块可作为 "视觉到语义" 的桥梁。受 ODISE 启发,VTCT 的目标是将支持集的视觉线索直接转换为类文本嵌入,使稳定扩散模型能够原生识别。
VTCT 模块的结构如 图 2 红色框区域所示。为有效提取支持集的语义信息,首先采用预训练并冻结的图像编码器 V \mathcal{V} V,从支持图像 I s I^s Is 中提取特征 F s F^s Fs。随后利用掩码 M s M^s Ms 执行掩码平均池化(MAP),聚合 F s F^s Fs 内的前景特征,得到类别专属原型 P e ∈ R 1 × d i m g P^e \in \mathbb{R}^{1\times d_{img}} Pe∈R1×dimg。其中, d i m g d_{img} dimg 为所选图像编码器 V \mathcal{V} V 的特征维度。
最后,该封装了支持类别核心视觉信息的原型 P e P^e Pe 被送入可学习的多层感知机(MLP)。该 MLP 将 P e P^e Pe 投影至扩散模型 U-Net 所需的目标嵌入空间,生成隐式文本嵌入 E ∈ R 1 × 1 × d t e x t E \in \mathbb{R}^{1\times1\times d_{text}} E∈R1×1×dtext; d t e x t d_{text} dtext 为 U-Net 交叉注意力层所要求的文本嵌入维度。
该策略通过 "使用解剖结构自身的表征语言",精准引导 Stable Diffusion 强大的生成先验向着目标解剖结构生成,提供具备内容感知能力的引导,其针对性与有效性远优于简单的空提示词。
2.5、训练目标
本文所设计的训练目标旨在发挥扩散模型在分割任务中的优势。在该方法中,模型以图像隐变量作为输入,经由 U-Net 处理后得到预测结果。核心思路为:将预测隐变量与真值掩码隐变量进行比对,以此训练网络实现精准分割。
具体而言,本文将查询掩码隐变量 z q m z^{qm} zqm 作为预测 z ^ q m \hat{z}^{qm} z^qm 的目标。参照 DiffewS,采用均方误差衡量预测值与目标值之间的差异,损失函数定义如下:
L = 1 h × w ∑ i = 1 h ∑ j = 1 w ( z i , j q m − z ^ i , j q m ) 2 . (5) \mathcal{L} = \frac{1}{h \times w}\sum_{i=1}^{h}\sum_{j=1}^{w} \left(z_{i,j}^{qm} - \hat{z}_{i,j}^{qm}\right)^2. \tag{5} L=h×w1i=1∑hj=1∑w(zi,jqm−z^i,jqm)2.(5)
2.6、SD- FSMIS 推理
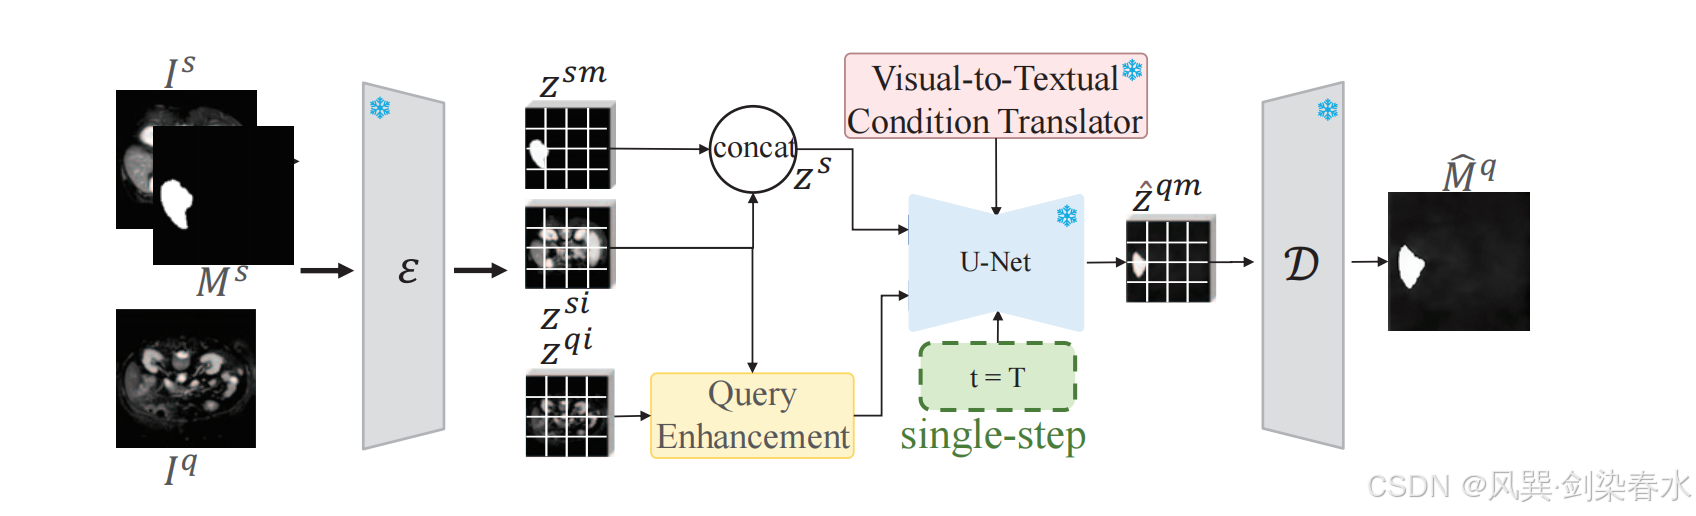
图 4 展示了 SD-FSMIS 的推理流程。具体而言,首先利用 VAE 编码器 E \mathcal{E} E 将支持集与查询集编码至隐空间。将支持图像隐变量与掩码隐变量拼接后输入 U-Net,以提供类别信息。在生成的文本嵌入 E E E 的条件下,对查询隐变量 z q z^q zq 执行单步分割,并通过解码器 D \mathcal{D} D 解码得到图像;对该图像的三个通道取均值,得到最终掩码 M ^ q \hat{M}^q M^q。
Figure 4 | SD- FSMIS 推理流程概述:
3、实验与结果
3.1、数据集
参照 RPT 47 中的评估方案,本文在 Abd-MRI 与 Abd-CT 数据集上验证模型性能。
3.2、评估指标与实验设置
本文主要采用 Dice 相似系数(Dice Similarity Coefficient, DSC)衡量分割精度,该指标是本任务的标准评价指标。所有实验均在单样本(1-shot)设置下开展,实验结果取 5 折交叉验证的平均值,以保证统计稳健性。
为评估所提方法的泛化能力,本文采用已有研究提出的两种具有挑战性的跨域实验设置:
设置 1: 训练集中可包含属于测试类别的切片,但仅作为无标注背景区域;模型基于伪掩码完成训练。
设置 2: 将训练集中含有测试类别的切片从数据集中移除。该设置保证模型在训练阶段完全未接触目标解剖结构,模拟更贴近临床实际、难度更高的场景。
3.3、实施细节
本文框架基于 Stable Diffusion v1.5 模型搭建。输入图像统一缩放至 256 × 256 256 \times 256 256×256,与现有方法保持一致。VTCT 模块内的图像编码器为 DINOv2-small。参照 RPT 生成伪掩码,作为扩散模型适配训练的监督信号。模型在单张 NVIDIA A6000 显卡上,每一折迭代训练 15k 次;每折训练时长约 6 小时,显存占用约 18GB。优化器选用 AdamW,权重衰减设为 1 e − 2 1\mathrm{e}{-2} 1e−2,批大小为 1。U-Net 训练学习率为 1 e − 5 1\mathrm{e}{-5} 1e−5,可学习 MLP 层采用更高的学习率 5 e − 5 5\mathrm{e}{-5} 5e−5。对于扩散过程,本文采用单步 DDIM 调度器,时间步 t t t 设置为 999。
3.4、实验结果
**Table 1 | Abd-MRI 与 Abd-CT 数据集上,不同方法在设置 1、设置 2 下的定量对比结果:**最优结果以粗体标注,次优结果添加下划线。由于 DiffewS 原本面向自然图像设计,本文对其重新实现,并在本文的医学数据集与实验方案下完成训练,以保证对比的直接性与公平性。
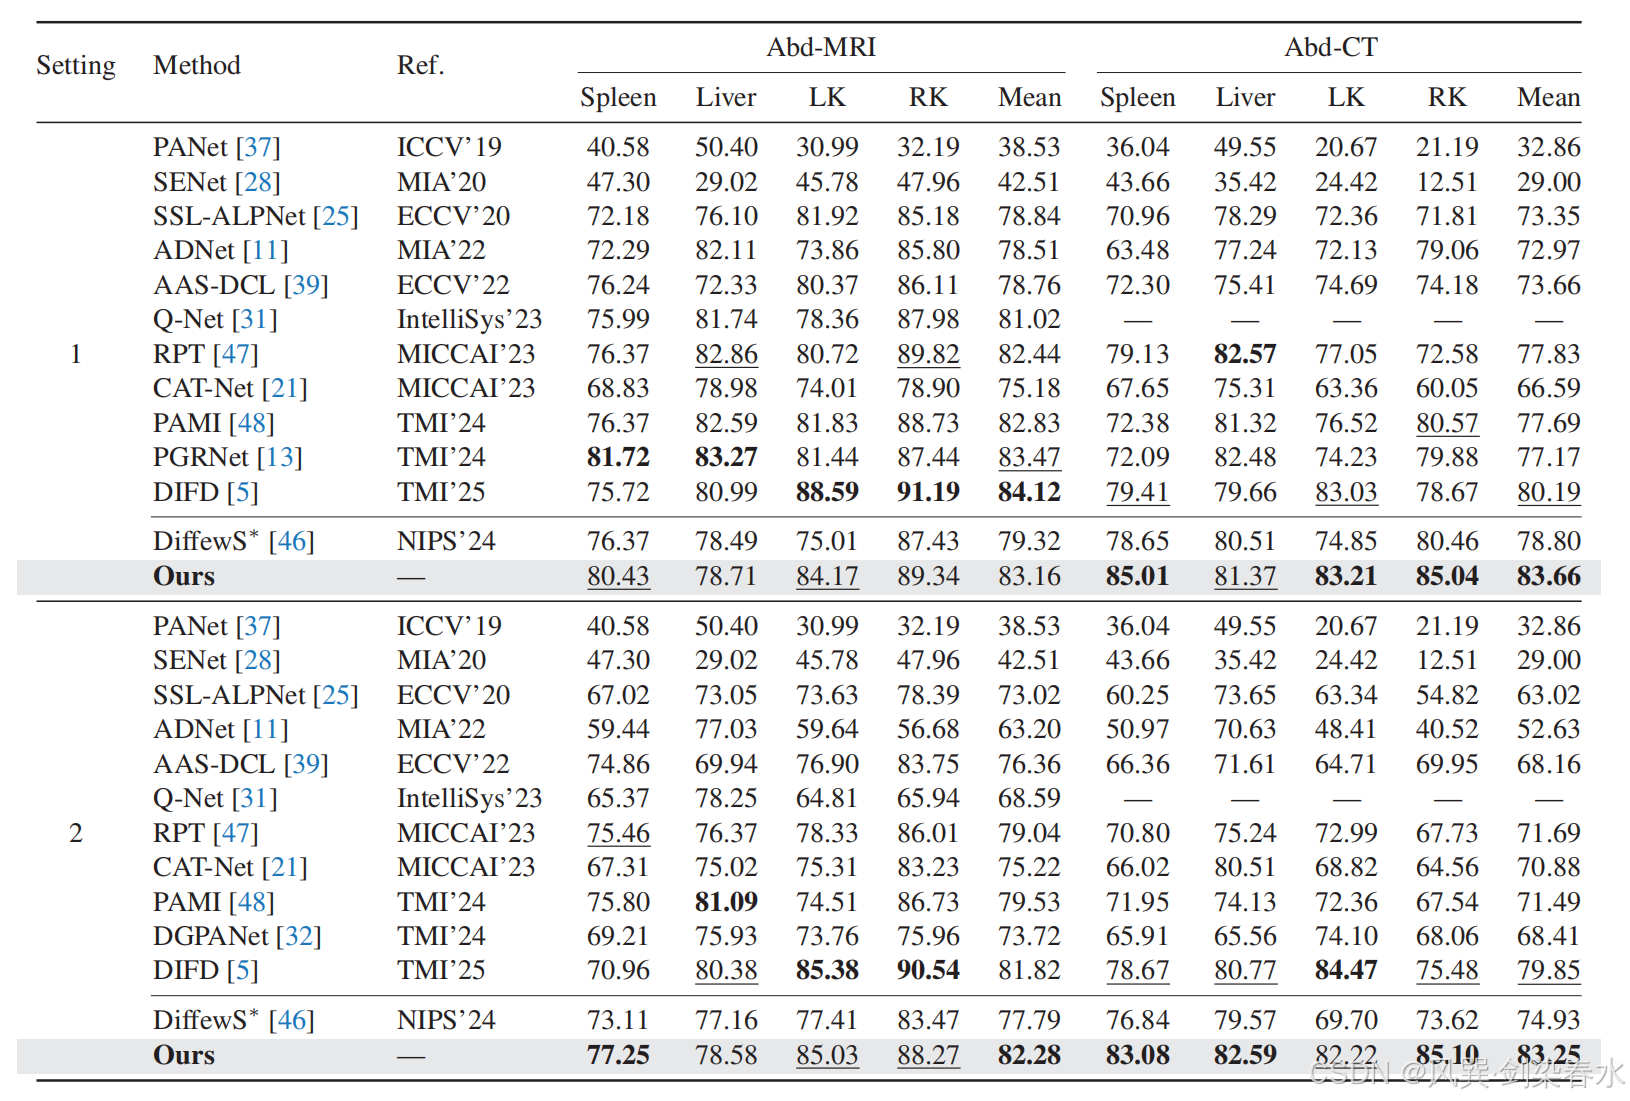
Figure 5 | 本文方法与 DiffewS 方法在 Abd-MRI 数据集、Abd-CT 数据集上的定性对比:
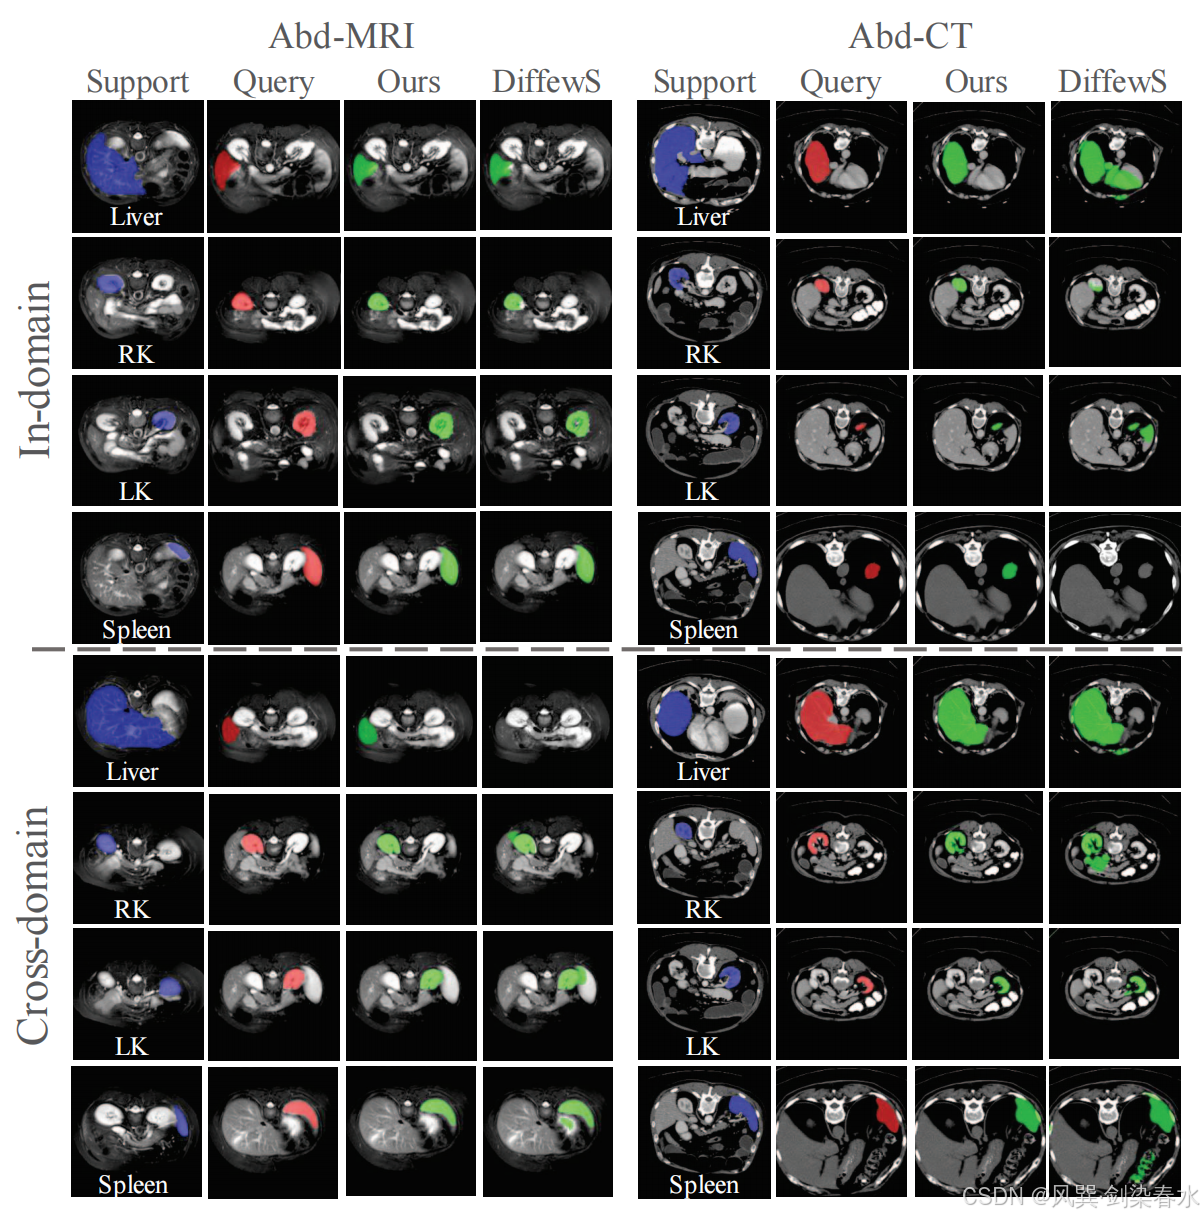
**Table 2 | 设置 1 下不同跨域方法的定量对比结果:**最优结果以粗体标注,次优结果添加下划线。由于 DiffewS 原本面向自然图像设计,本文对其重新实现,并在本文采用的医学数据集与实验方案下完成训练。
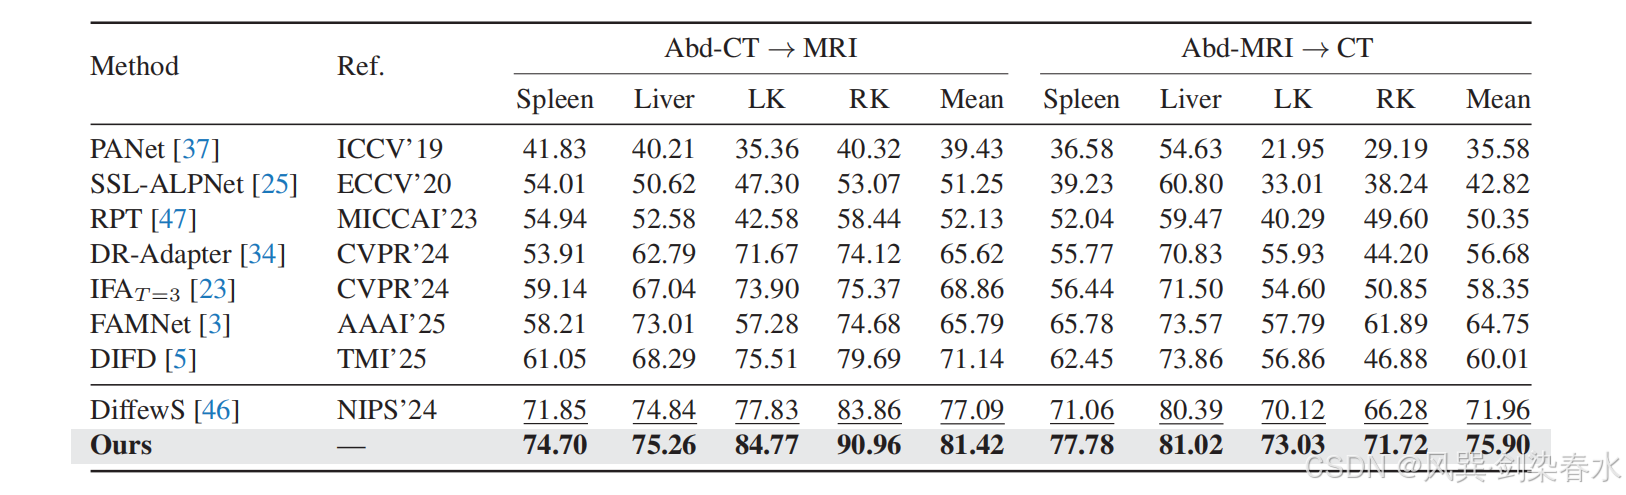
Table 3 | 所提方法中各组成部分在设置 1 下对 Abd-CT 数据集所取得的消融效果:
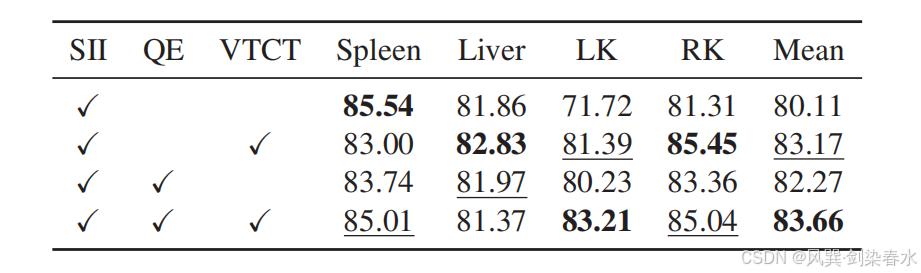
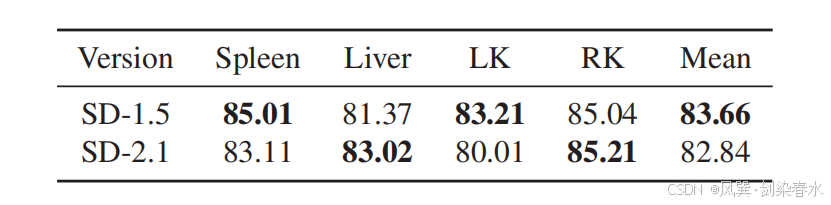
Table 4 | 在设置 1 下对不同版本的 Stable Diffusion 在 Abd-CT 数据集上的性能比较:
只用 Dice 系数就可以么(●'◡'●)