文件监控 Agent 为什么总在关键时刻掉链子
你大概率写过或想写过这样一个东西:盯着一个文件夹,新文件进来自动分类、重复文件丢进回收站、某个目录一变更就告警。十几行 watchdog 就能跑起来,看起来是 AI Agent 里最简单的一类。
但凡是把它当真用在跑的生产脚本,几乎都踩过同一类坑:要么日志被事件刷爆、重复动作执行几十遍;要么一个 glob 写错,把整个 Downloads 清空进回收站;要么两个目录互相搬家,CPU 直接拉满。
「监控目录 → 触发动作」这个链路,真正的复杂度不在「怎么监听」,而在两层你一开始不会想到的地方:事件层 (操作系统给你的事件和你以为的事件不是一回事)和动作层(Agent 每一个文件操作都是不可逆的)。本文把这两层拆开,配可运行代码讲清楚每个坑的根因和解决方法。
文件事件到底从哪来
要真正填掉上面的坑,得先搞清楚一个事实:你监控的从来不是「文件本身」,而是操作系统的「文件系统事件子系统」。这块底层机制长什么样,直接决定了所有坑的根源------它不按你的想法工作,是因为它的设计目标就不是「告诉应用发生了什么」。
1. 内核是唯一真相源,事件是 syscall 的副作用
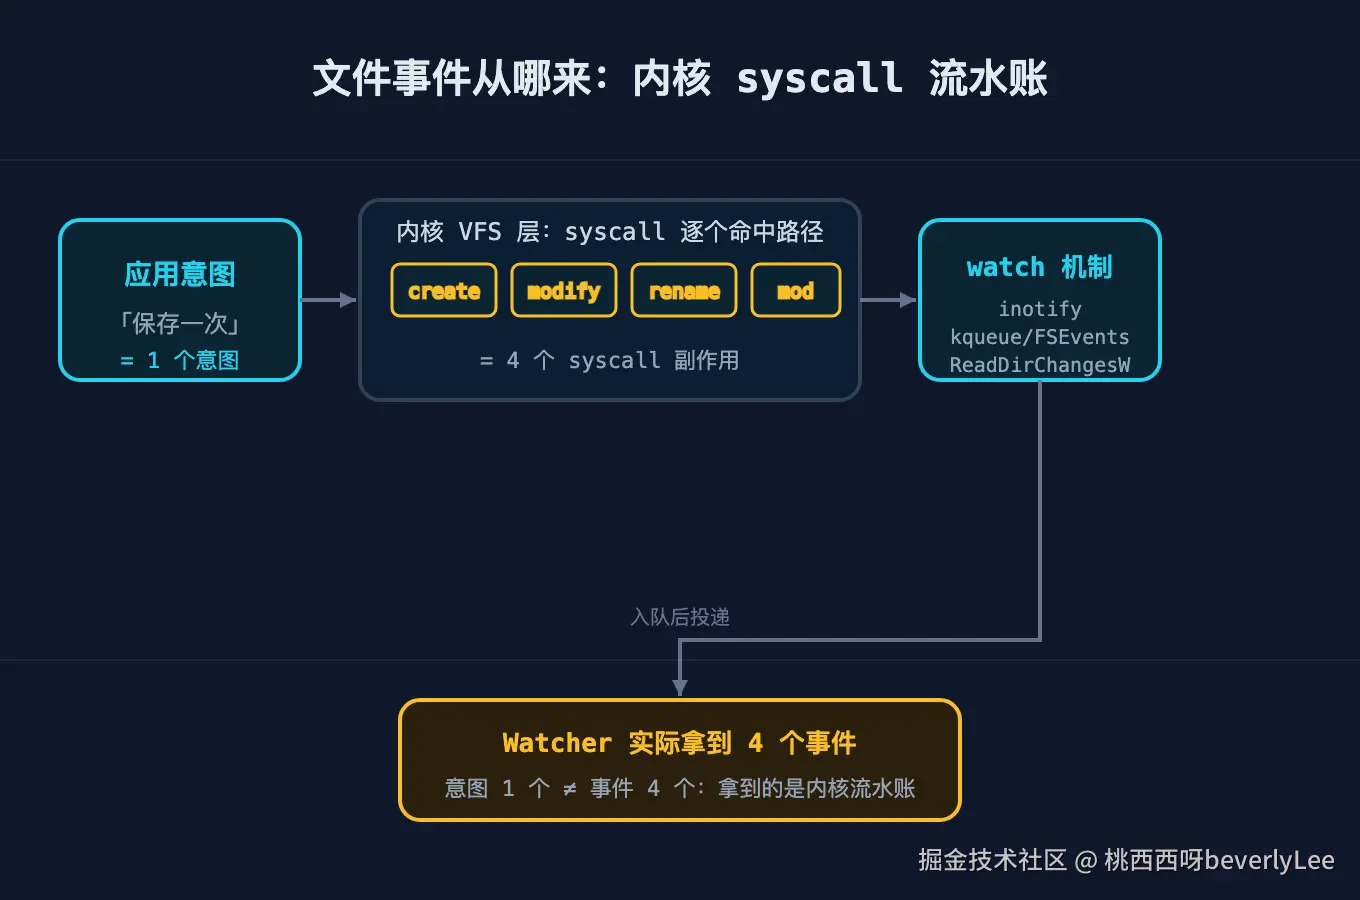
write / rename / unlink 这些全是系统调用。它们先进入内核的 VFS 层,由内核更新 inode 和目录项(dentry)之后才算数。inotify(Linux)、kqueue(macOS/BSD)、FSEvents(macOS)、ReadDirectoryChangesW(Windows)这些 watch 机制,本质都是在内核侧挂一个回调:每当有 syscall 命中你 watch 的路径,内核就把这次操作记一条事件,塞进用户态能读的事件队列。
所以事件是「某时刻某路径出现了某种底层操作」的原始记录,不是「应用想干什么」的声明。这就是为什么「保存一次 = 4 个事件」:编辑器每做一次底层操作(写临时文件、改属性、改名),内核就记一次。你的 Watcher 拿到的是内核的 syscall 流水账,不是编辑器的「我保存了」这个意图。
2. rename 是原子的,原地写不是
为什么保存会是一连串 create .tmp → modify .tmp → move → modify?这是编辑器在兜底。「原地 overwrite 一个正在被读的文件」在崩溃瞬间会留下半截文件(内容损坏)。POSIX 的正确做法是:把新内容写进 xxx.tmp → fsync 落盘 → rename(xxx.tmp, xxx)。rename 在同一文件系统上是原子操作 (POSIX 保证),要么旧文件在、要么新文件在,没有中间态。代价就是多了 3 个事件------你监控到的,正是这 3 个事件的副作用。 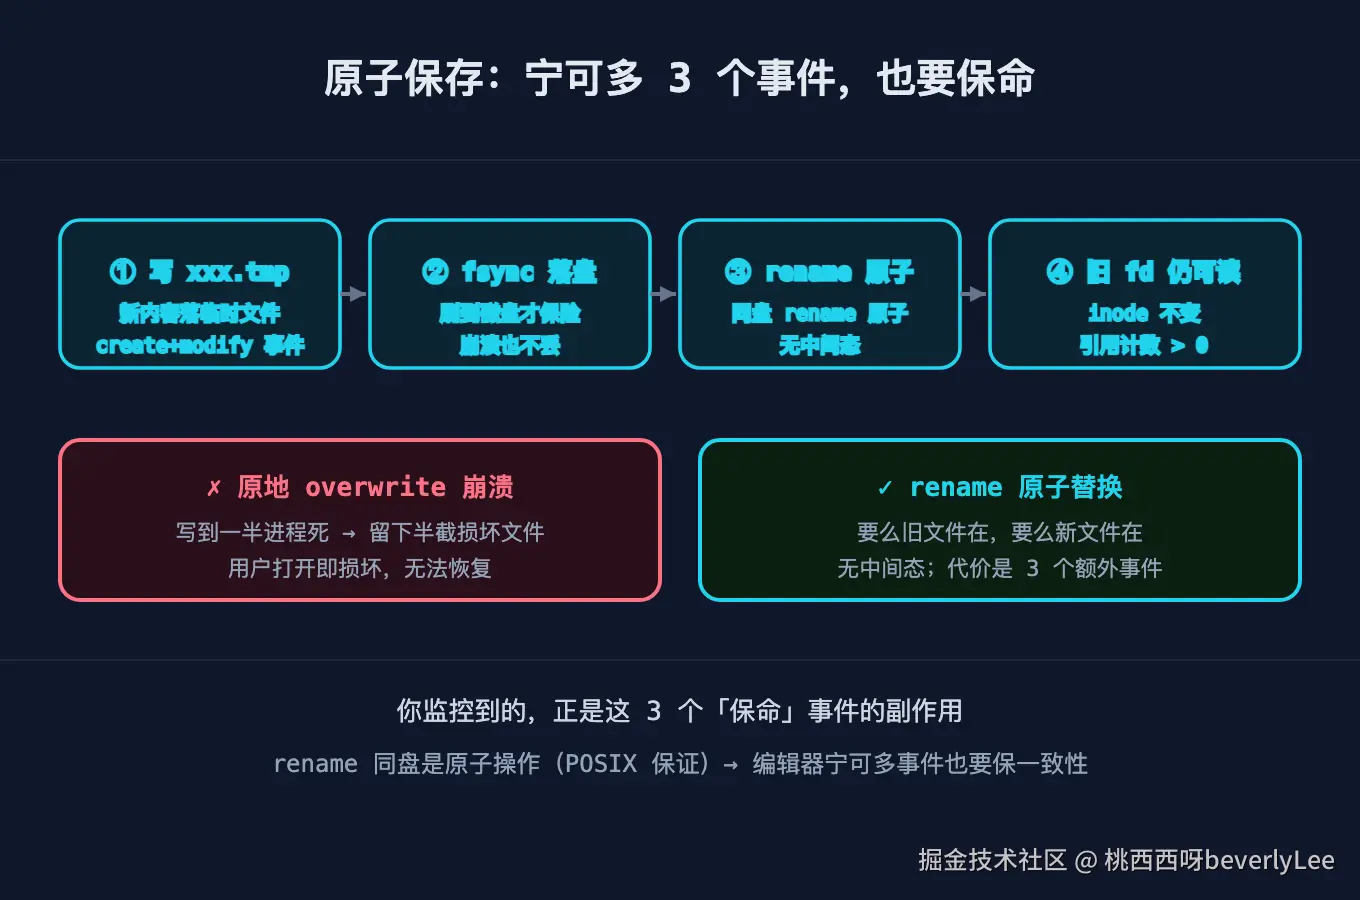
3. 事件是 at-least-once,而且还会丢
inotify 有默认 watch 上限,队列满了内核直接丢事件并打 IN_Q_OVERFLOW 标记(「我漏了,你自己重扫」)。于是现实是:事件可能重复 (同一 modify 来好几遍),也可能丢失 (队列溢出)。两者叠加,正好是消息队列里的 at-least-once 语义------你既不能假设收全,也不能假设只收到一次。这给了「防抖 + 幂等」一个理论支点:消费者必须自己把 at-least-once 收敛成「有效一次」。
4. macOS 的 FSEvents 是「流」不是「次」
Linux inotify 是每次 syscall 一个事件;macOS FSEvents 是「一段时间内的变化流」,内核会自动 coalesce(合并) 同一文件的多次改动成一个通知,而且是按「设备 + 时间点」给的,watcher 要自己维护游标(cursor)。好处是 macOS 上 debounce 天然有部分合并;代价是你错过了中间态细节。watchdog 在不同 OS 后端不同、行为差异很大------这是跨平台 Agent 的隐形坑,别用 Linux 的直觉去写 macOS 的窗口。
5. 删除不可逆的深层原因:幽灵依赖
误删为什么可怕,不止「找不回」。可能有进程正 mmap 这个文件、或持有 fd 在读。os.remove 后,文件在目录项消失(新进程打不开),但旧进程仍读得到(inode 引用计数 > 0,磁盘空间暂不释放)------你以为删了,磁盘没空,还埋了雷。回收站(shutil.move 同盘内 rename)至少保留原路径语义,且 rename 不碰 inode,持 fd 的进程不受影响。这就是为什么「删除走回收站」比「删除走 os.remove」在语义上更干净。
6. 移动死循环是反馈环,不是信号质量问题
事件层三道闸(排除 / 防抖 / 幂等)处理的是「信号质量」:噪声、重复、风暴。但A到B搬家死循环是「系统结构问题」------你的动作改变了你正在监控的对象,于是监控自己成了反馈环的一部分(控制论里的正反馈)。信号再干净也救不了,只能靠拓扑约束(动作落点在监控树外)。
一、监控 Agent 的不稳定,根因是对「文件事件」建模错了
把「文件监控」当成一个可靠触发器,是一个危险的错觉。OS 的文件系统事件有三个性质,全部来自于它底层的实现:
- 离散性 :你以为「保存一次文件」是一个事件,实际上它可能是一连串
create .tmp → modify .tmp → move → modify,一次保存 = 4 个事件。 - 顺序性不可靠:同一份内容被不同程序修改,事件序列差异极大,IDE、编辑器、下载器各有各的写法,没有统一规范。
- 幂等性缺失 :事件天然会重复投递,网络盘、符号链接、某些编辑器的「保存即重写」会让同一个
modify在 2 秒内来好几遍。
这三件事的基于同样的原因是:文件事件不是「发生了什么」的声明,而是「某个时刻某个路径出现了某种底层操作」的原始信号。它嘈杂、冗余、且不可直接信任。
于是「文件监控 Agent」的稳定,取决于你能不能在两个地方各架一道闸:
css
文件事件 ──▶ [事件层 Watcher] ──▶ 去噪/防抖/幂等 ──▶ 确定性事件
│
▼
[动作层 RuleEngine] ──▶ 白名单/规则 ──▶ 回收站/移动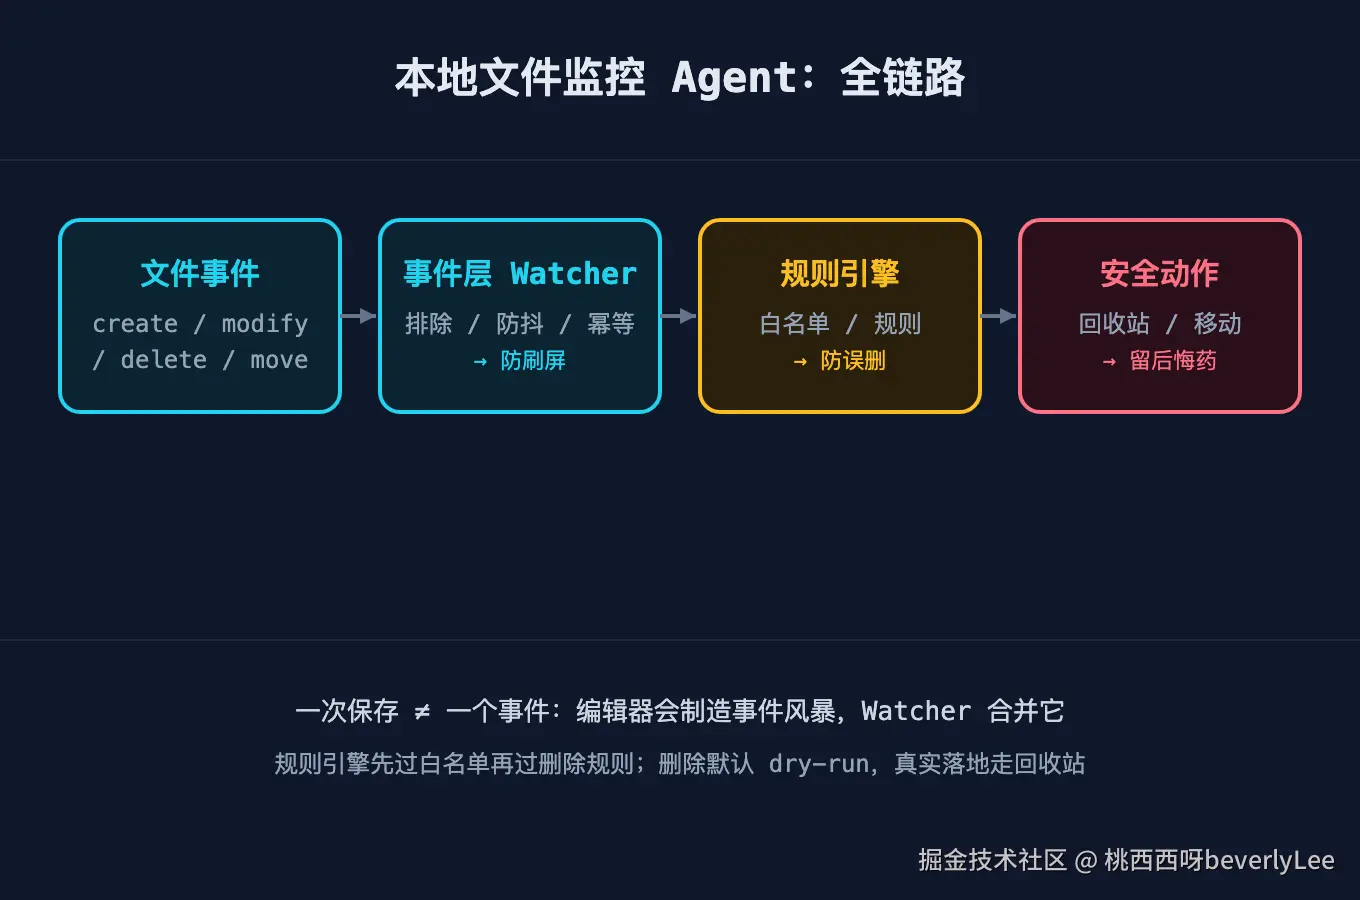 下面按「事件层」和「动作层」两个失败模式,把坑一个一个说清楚。
二、事件层被冲垮
坑 1:事件风暴刷屏,一次保存触发四次误判
最经典的坑。你监听 Downloads,用编辑器保存一个文件,期望「保存一次 → 分类一次」。但看日志会发现,分类动作跑了 4 次,或者更糟------跑出了 4 个互相矛盾的判定。
根因如上所述:一次保存 = 多个底层事件。
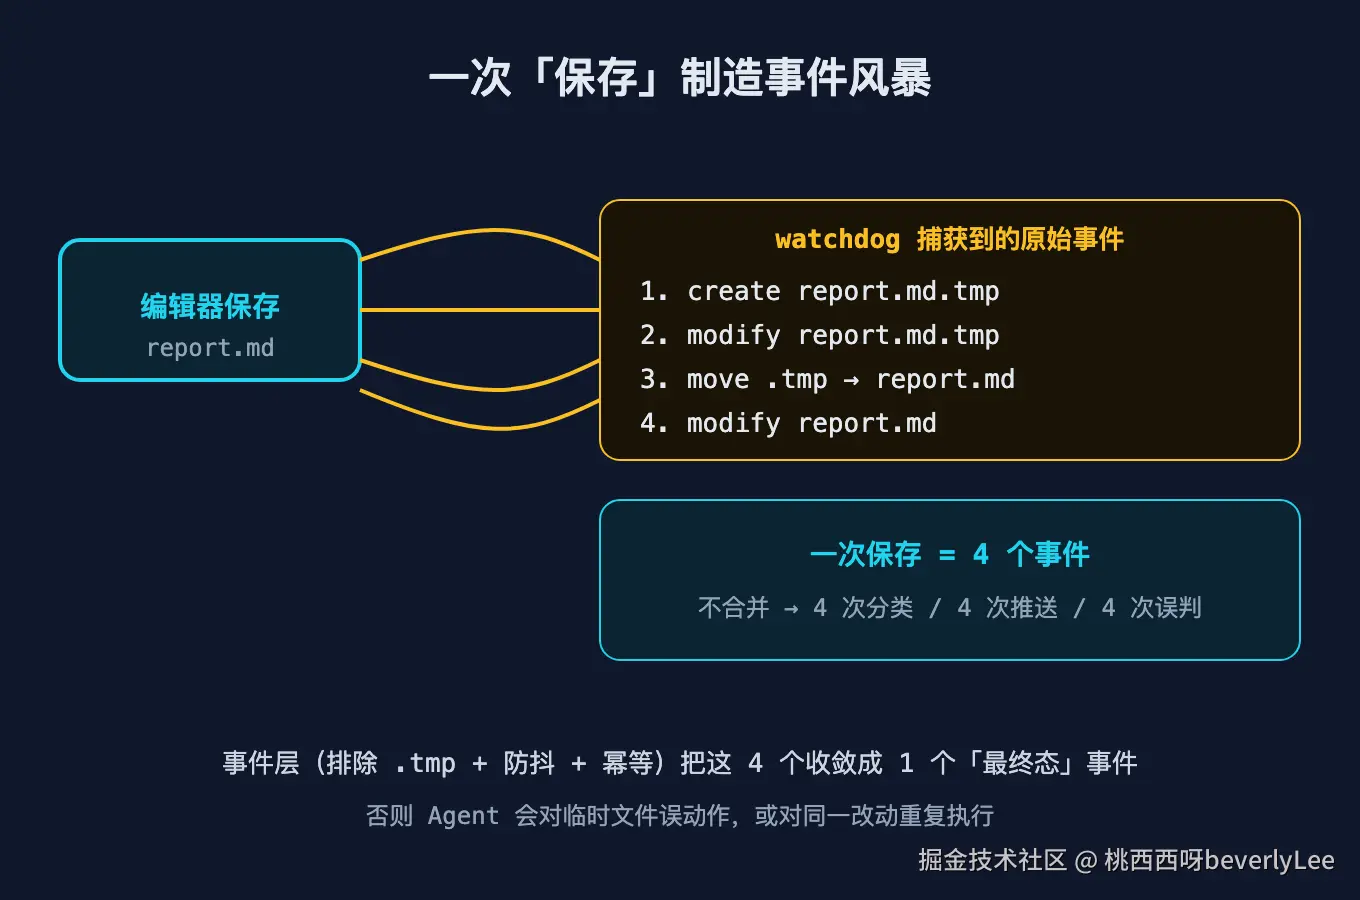
如果你的分类动作挂在「任何事件」上,前三个 .tmp 事件就会让动作层先跑三遍空判定,最后那个 modify 才是有效的。更容易忽略的是:很多编辑器的「保存」是「先写临时文件、再 rename 覆盖」,create .tmp 和 move 之间可能有几十毫秒,动作层如果真去读 .tmp,会读到一个半截文件。
解法不是「少监听」,而是「事件层先把噪声收敛成每个文件每个窗口一个确定性事件」。
核心是两道闸:排除 + 防抖。
排除(黑名单路径,丢掉噪音):
python
DEFAULT_EXCLUDES = (
    ".git/", "node_modules/", "__pycache__/",
    ".DS_Store", "~", ".tmp", "/.cache/", "Library/Caches/",
)
def _is_excluded(path: str) -> bool:
    return any(seg in path for seg in DEFAULT_EXCLUDES)
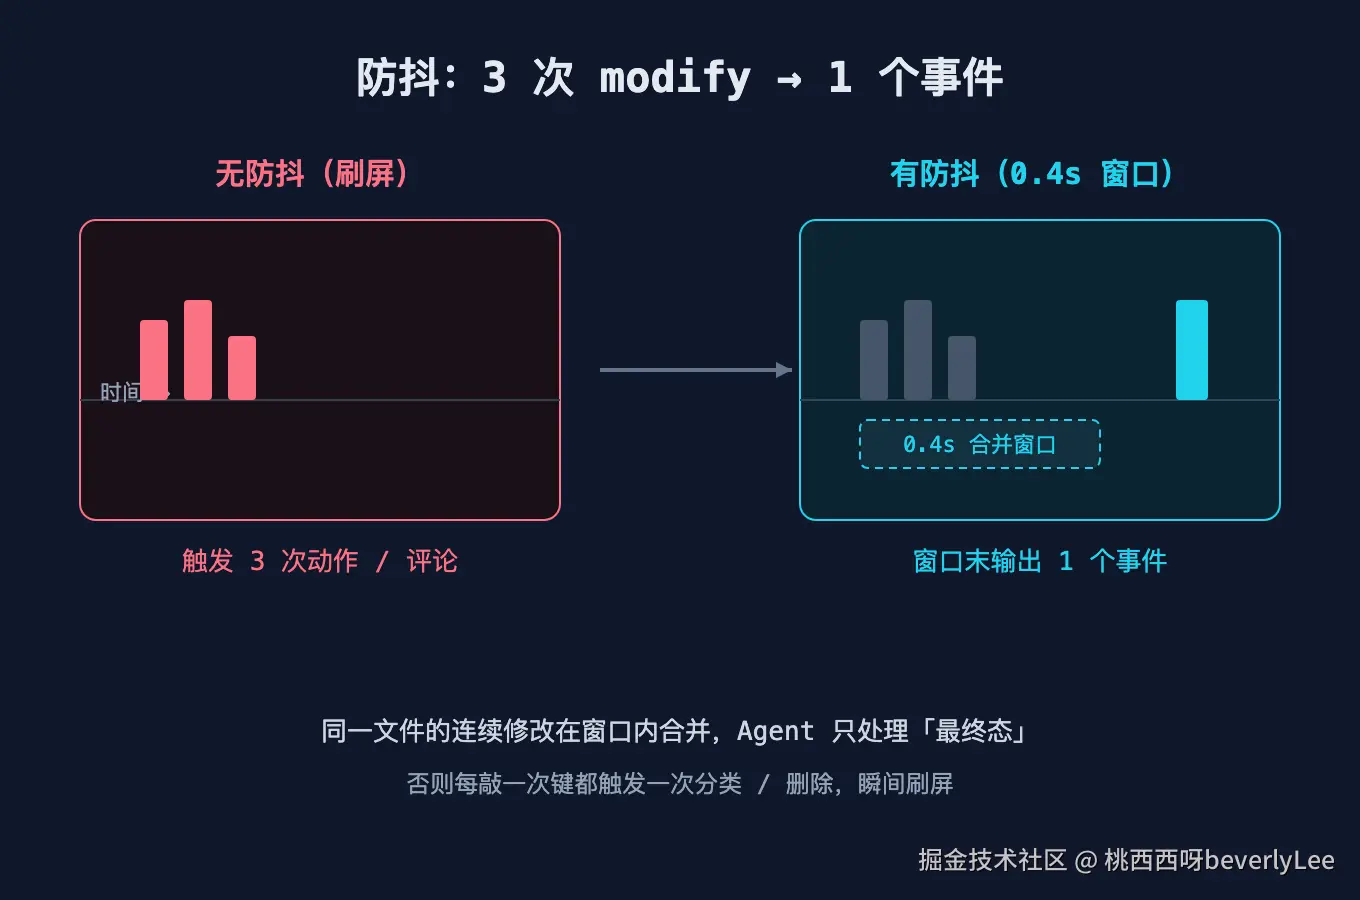
防抖(同路径 0.4s 窗口合并成 1 个事件,只在窗口末输出):
python
def handle_event(self, ev):
    if self._is_excluded(ev.path):
        return                      # 噪音直接丢
    key = (ev.path, ev.op)
    self._buffer[key] = ev         # 覆盖式写入,天然合并
    # flush() 在超过 debounce 窗口时被调用,只输出 _buffer 里最新的一条
01_file_watcher.py 的 self-test 验证了这件事:连续 3 次 modify 落在同一窗口内,最终只产出 1 个事件。
防抖的窗口怎么定?太短(如 50ms)挡不住一次保存的 4 个事件;太长(如 5s)会让实时性变差。0.4s 是经验值------足够覆盖一次保存的全部底层操作,又不至于让人觉得到达延迟。flush() 必须靠外部时钟驱动(watchdog 的 timer 或主循环),不能用「收到事件就立即处理」的写法,否则防抖形同虚设。
坑 2:重复投递幂等缺失,同一动作执行 N 遍
事件会重复。这不是「网络不稳定」才有的问题,是默认就会发生的。某些编辑器在保存时对一个文件产生完全相同的两个 modify,间隔不到 1 秒;网络盘同步回来也可能重放历史事件。
如果你没有幂等,动作层会把同一个文件分类两次、移动两次、甚至删除判定两次。看这张对比图:无防抖时 3 次触发各自落动作;有防抖时窗口末只输出 1 个。
幂等要独立一道闸 dedup,它和防抖不是一回事:
- 防抖解决「短时间内同一窗口的连续事件」------靠「覆盖 buffer」自然合并;
- 幂等解决「分属不同窗口、但内容相同的重复事件」------靠「记录上次处理的
(path, op)和时间戳,TTL 内直接丢弃」。
python
DEDUP_TTL = 2.0
def _dedup_key(self, ev):
    return (ev.path, ev.op)
def _in_dedup(self, ev):
    last = self._seen.get(self._dedup_key(ev))
    if last and (self.clock.now() - last) < self.dedup_ttl:
        return True          # 2 秒内重复投递,丢弃
    return False
self-test 里验证:同一 (path, op) 在 2 秒内第二次出现,被判定为重复并丢弃。注意 TTL 必须 > 你的防抖窗口,否则防抖刚放出来的事件会被幂等误杀------这是两个闸的耦合点,调参时一起看。
坑 3:噪音路径污染,.git 改动也能触发你的 Agent
这是最容易被忽视、却最普遍的坑。你监听仓库根目录图个省事,结果 git checkout、git pull、IDE 的索引更新,会让 .git/、node_modules/、__pycache__/ 里成千上万个文件变更,全涌进事件层。轻则日志爆炸,重则你的动作层对着 .git/objects/xx/xxxx 这种二进制做分类、做内容判定,白白烧 CPU,还可能因为读到半截 pack 文件报错。
根因是「监听范围」和「关注范围」被你默认当成了一回事。解法就是把 DEFAULT_EXCLUDES 当成硬约束------任何事件先过排除,没过就直接 return,绝不进 buffer 。这条在代码里是 handle_event 的第一行,优先级最高。
三、动作层把文件系统搞崩
事件层只解决「别被冲垮」,但真正会让你半夜被叫起来的是动作层------因为它动的是真实文件。
坑 4:一个 glob 写错,误删整目录(最危险)
事件层再干净,动作层的一行 if path.endswith(".pdf"): delete 就能把事情搞大。最常见的事故:本意删 ~/Downloads/*.pdf,写成 path == "*.pdf"(永远 False,无害)还算走运;写成 path.startswith("Downloads") 且目标是删除时,可能把整个 Downloads 当匹配项清掉。
看这张图:左边「直接 os.remove」0.1 秒清空 Downloads 不可逆;右边「三道闸」每一刀都能拦。
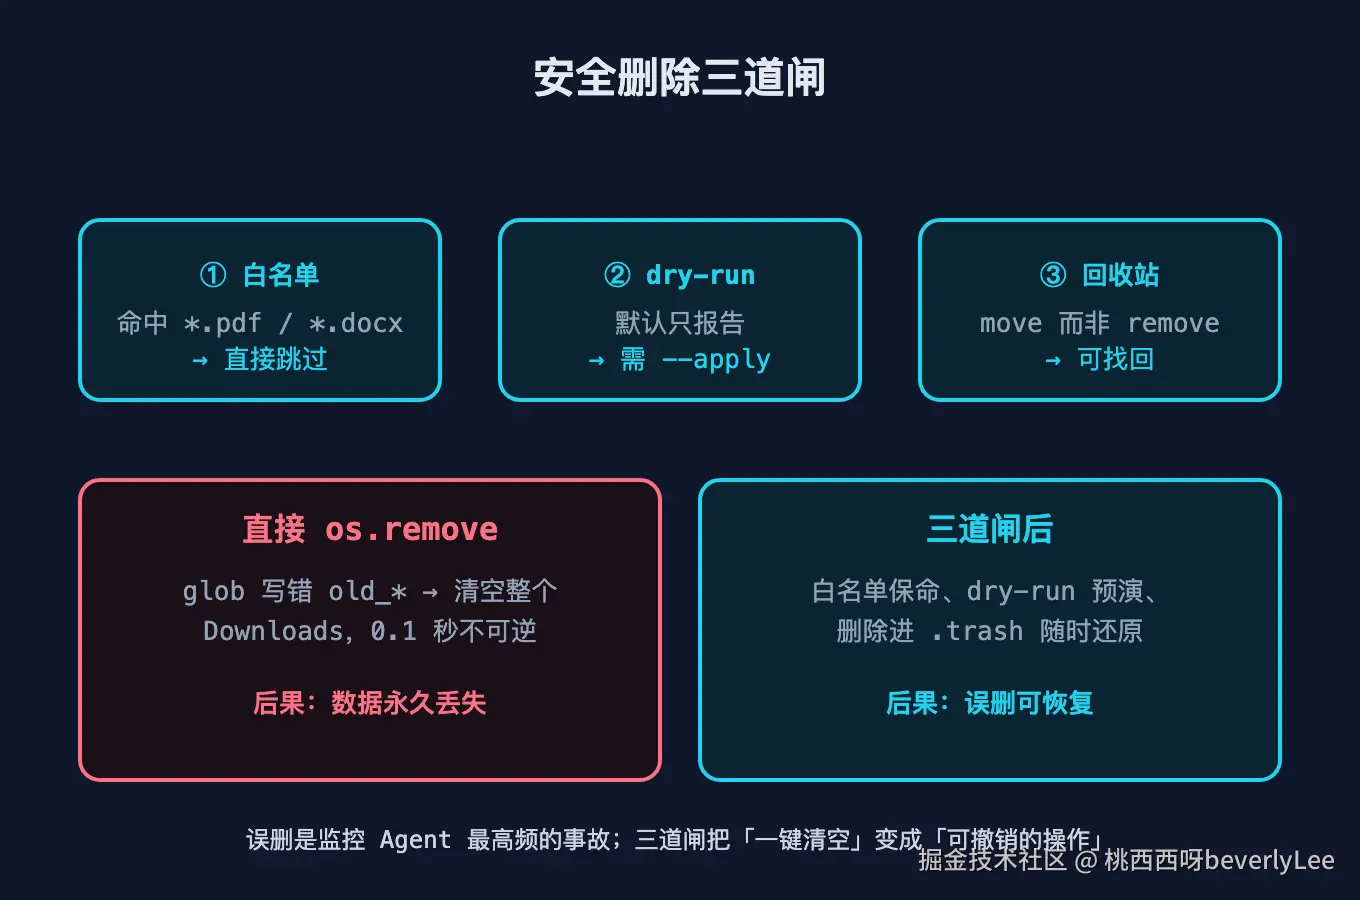 动作层防误删,要三道闸叠加,缺一不可:
第一道闸:白名单优先。 命中白名单的文件,任何删除规则都碰不了它,优先级高于一切。
python
def _whitelisted(self, path):
    return any(fnmatch.fnmatch(path, w) for w in self.whitelist)
# evaluate 第一句:if self._whitelisted(path): return Verdict(protected=True)第二道闸:dry-run 默认开启。 没有显式 --apply,引擎只报告「我会做什么」,绝不落任何动作。这是防止手滑的最后保险。
python
def __init__(self, rules, whitelist, trash_dir, dry_run=True):
    self.dry_run = dry_run      # 默认 True,必须显式 --apply 才关
第三道闸:删除走回收站,不走 os.remove。 删除 = shutil.move 进 .trash/,同名冲突加 .bak 后缀,永远可找回。
python
def _delete(self, path):
    if self.dry_run:
        return Verdict(deleted=False, reason="dry-run")
    dest = os.path.join(self.trash_dir, os.path.basename(path))
    if os.path.exists(dest):
        dest += ".bak"
    shutil.move(path, dest)     # 可找回,不是 os.remove
    return Verdict(deleted=True)
02_rule_engine.py 的 self-test 验证了三件事:白名单 *.pdf 受保护不被删;dry-run 不产生任何副作用;--apply 时真删且原路径清空但回收站里能找回。os.remove 在你 debug 时很方便,但在「被事件驱动自动执行」的 Agent 里,它就是定时炸弹。
坑 5:监控目录互相搬家,移动死循环
你写了一个规则:「把 A/ 里的 *.jpg 搬到 B/」。但如果 B/ 也在监控范围内,文件搬过去触发 B/ 的 create 事件,你的规则可能又把它搬回 A/,于是文件在A和B之间无限跳动,watchdog 的主循环被事件淹没,CPU 100%。
看这张图:监控目录A和B互相搬 *.jpg,死循环,解法把目标目录排除在监控外。 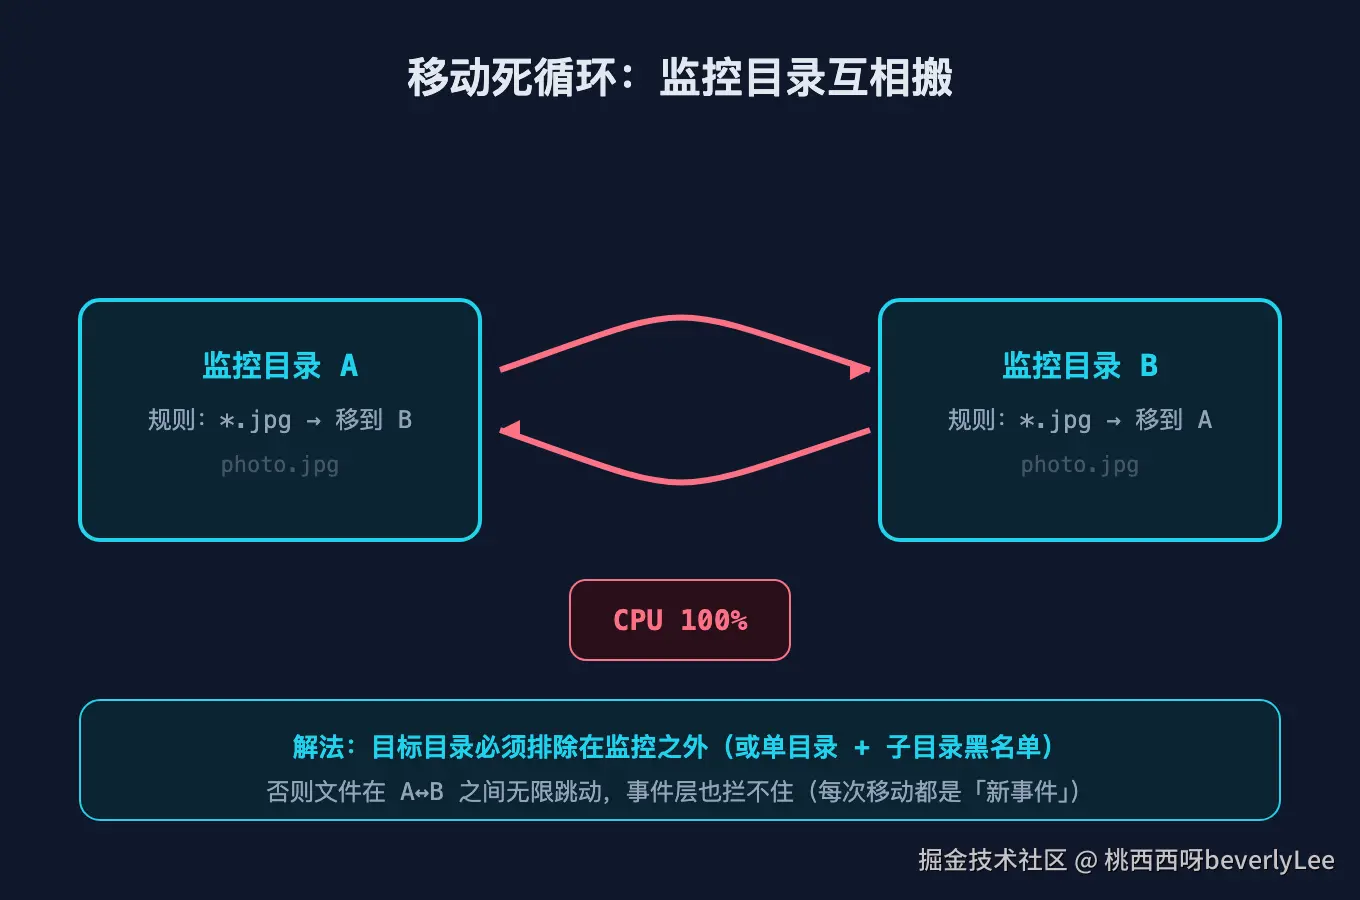 事件层的排除/防抖对此完全无效------因为每一次搬运都是「真实的、离散的、不同的」事件,既不过排除名单,也不算重复投递。这是规则设计层面的错误,不是事件质量问题。
解法只有两条,都在规则设计期就定死:
- 目标目录(动作落点)必须排除在监控范围外;
- 或只用单监控目录 + 子目录黑名单,动作只在同一棵树内的「非监控子目录」落地。
代码层面,这意味着 DEFAULT_EXCLUDES 里必须包含你的所有「动作落点目录」,且规则引擎的 dest 永远指向监控树之外。
四、两种失败问题归结到同一个原因
| 大症状 | 失败模式 | 根因(共享总根) |
|---|---|---|
| 监控 Agent 上线就出事 | A. 事件层被冲垮(刷屏/重复/噪音) | 把 OS 文件事件当「可靠离散信号」建模 |
| 监控 Agent 搞崩文件系统 | B. 动作层误删/死循环 | 对「不可逆动作」没有分层兜底 |
解法不是「更努力地写监听代码」,而是承认:事件层负责把噪声收敛成确定性事件,动作层负责让每一个操作都可拦截、可找回。二者之间那道清晰的边界,才是监控 Agent 能不能活过第一周的关键。
本文配的两个脚本,把这套边界落成了可运行代码:01_file_watcher.py 用「排除 + 防抖 + 幂等」三道闸收敛事件,02_rule_engine.py 用「白名单 + dry-run + 回收站」三道闸守动作。直接 --self-test 能看到每道闸的行为。
复现
2 个可运行脚本(clone 即可 python3 01_file_watcher.py --self-test):
五、结尾
如果你读了我前一篇《AI 客服为什么翻车》,会发现这两件事是同一个问题:Agent 不可靠,往往不是「模型不够聪明」,而是它和真实世界的交界处(那里是工具调用、是文件事件)没有被正确建模。客服翻在「工具返回了它就信」,文件监控翻在「事件来了它就动」。你在使用中最容易翻车的 Agent 是什么?可能是那些「替你做决定并自动执行」的------比如自动回复、自动下单、自动改数据库。它们的交界更复杂,兜底更难。这个系列我会接着拆。