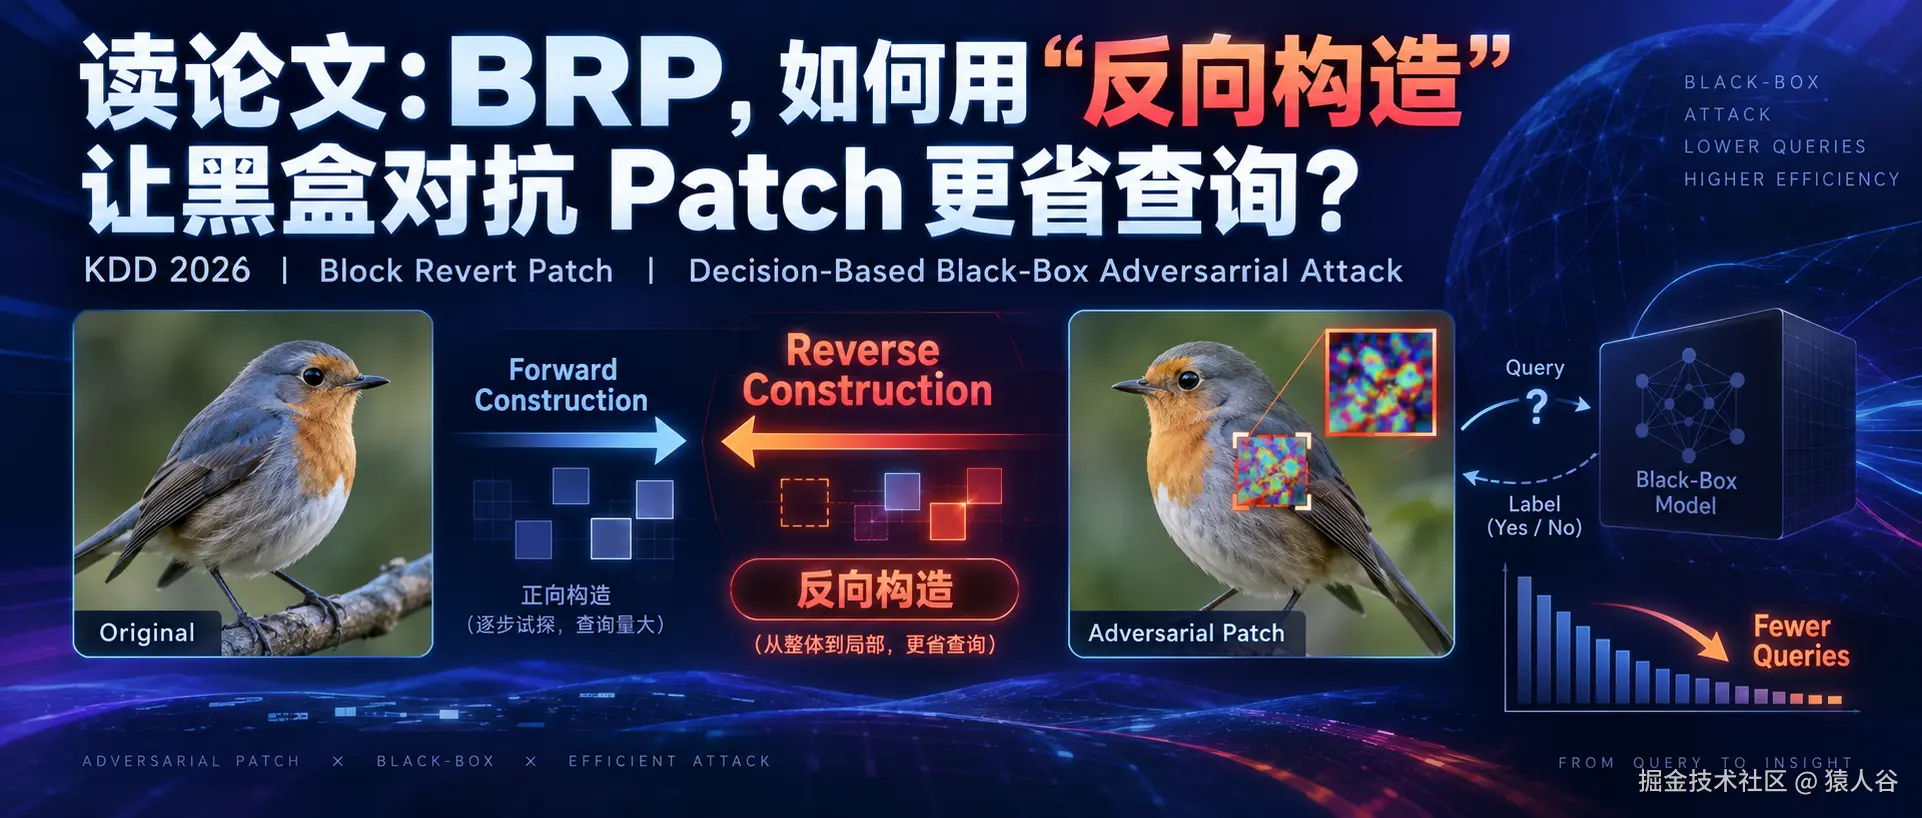
 在深度学习安全领域,对抗攻击一直是一个非常重要的研究方向。
一个训练良好的图像分类模型,看起来已经能够非常准确地识别猫、狗、汽车、交通标志,但只要人为设计一些特殊扰动,就有可能让模型产生完全错误的判断。
其中有一类攻击尤其值得关注:
Adversarial Patch,对抗补丁。
与传统的"整张图加入微小扰动"不同,对抗 Patch 允许攻击者只修改图像中的一个局部区域,通过一个相对集中的图案,就改变模型最终的预测结果。
更重要的是,这类 Patch 往往更容易被迁移到真实物理环境中,例如打印出来、贴到物体上,再通过摄像头重新采集,因此不仅具有攻击研究价值,也是评价视觉模型鲁棒性的重要工具。
但如果攻击者连模型的概率、梯度、Logits 都看不到,只能得到最终预测类别:
Dog
Cat
Car
这时还能不能高效地生成一个足够小的 adversarial patch?
KDD 2026 的论文:
BRP: Query-Efficient Block Revert Patch for Decision-Based Black-Box Adversarial Attack
给出了一个很有意思的答案。
论文没有尝试设计一个更加复杂的梯度估计器,也没有继续沿着"不断向原图添加攻击扰动"的传统路径前进,而是提出了一个非常直接、甚至有些"反过来想"的思路:
不要问"应该往原图里加什么",而是先从一个已经攻击成功的状态开始,再不断问"哪些东西可以删掉"。
这就是论文提出的核心思想:
Reverse Construction,反向构造。
我认为,这也是整篇论文最值得关注的地方。 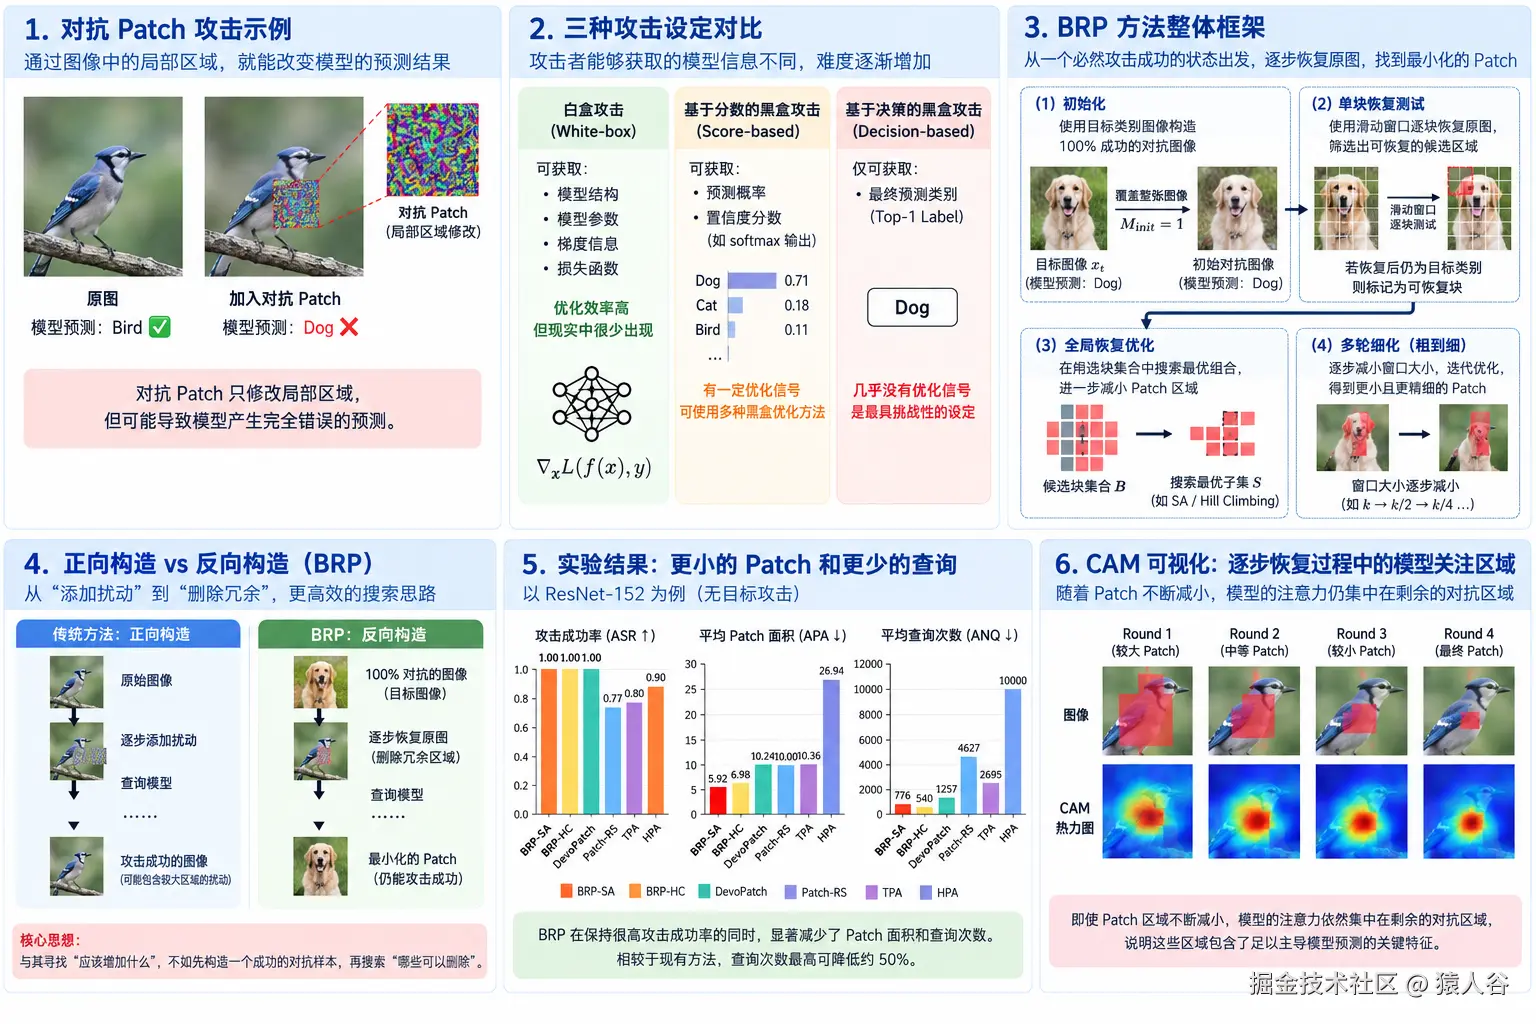
1. 先看论文发表在哪里
这篇论文发表于:
The 32nd ACM SIGKDD Conference on Knowledge Discovery and Data Mining,KDD 2026,会议于 2026 年 8 月 9 日至 13 日在韩国济州岛举行。论文共 12 页,同时公开了源代码。
KDD 是数据挖掘、机器学习与数据科学领域非常重要的国际顶级会议之一。在国内较常见的学术评价体系中,KDD 属于 CCF A 类国际学术会议。
论文作者包括:
- Zenghui Yang
- Xingquan Zuo
- Gang Chen
- Hai Huang
- Tianle Zhang
作者来自北京邮电大学和 Victoria University of Wellington。
2. 这篇论文研究的到底是什么问题?
先把问题说简单一点。
假设我们有一张图片:
一只鸟。
模型原本正确预测为:
Bird。
攻击者想在图片上放一个局部 Patch,让模型误认为:
Dog。
于是得到:
text
原图
   ↓
Bird

加入 Patch
   ↓
Bird + [特殊区域]

模型
   ↓
Dog
这就是 adversarial patch。
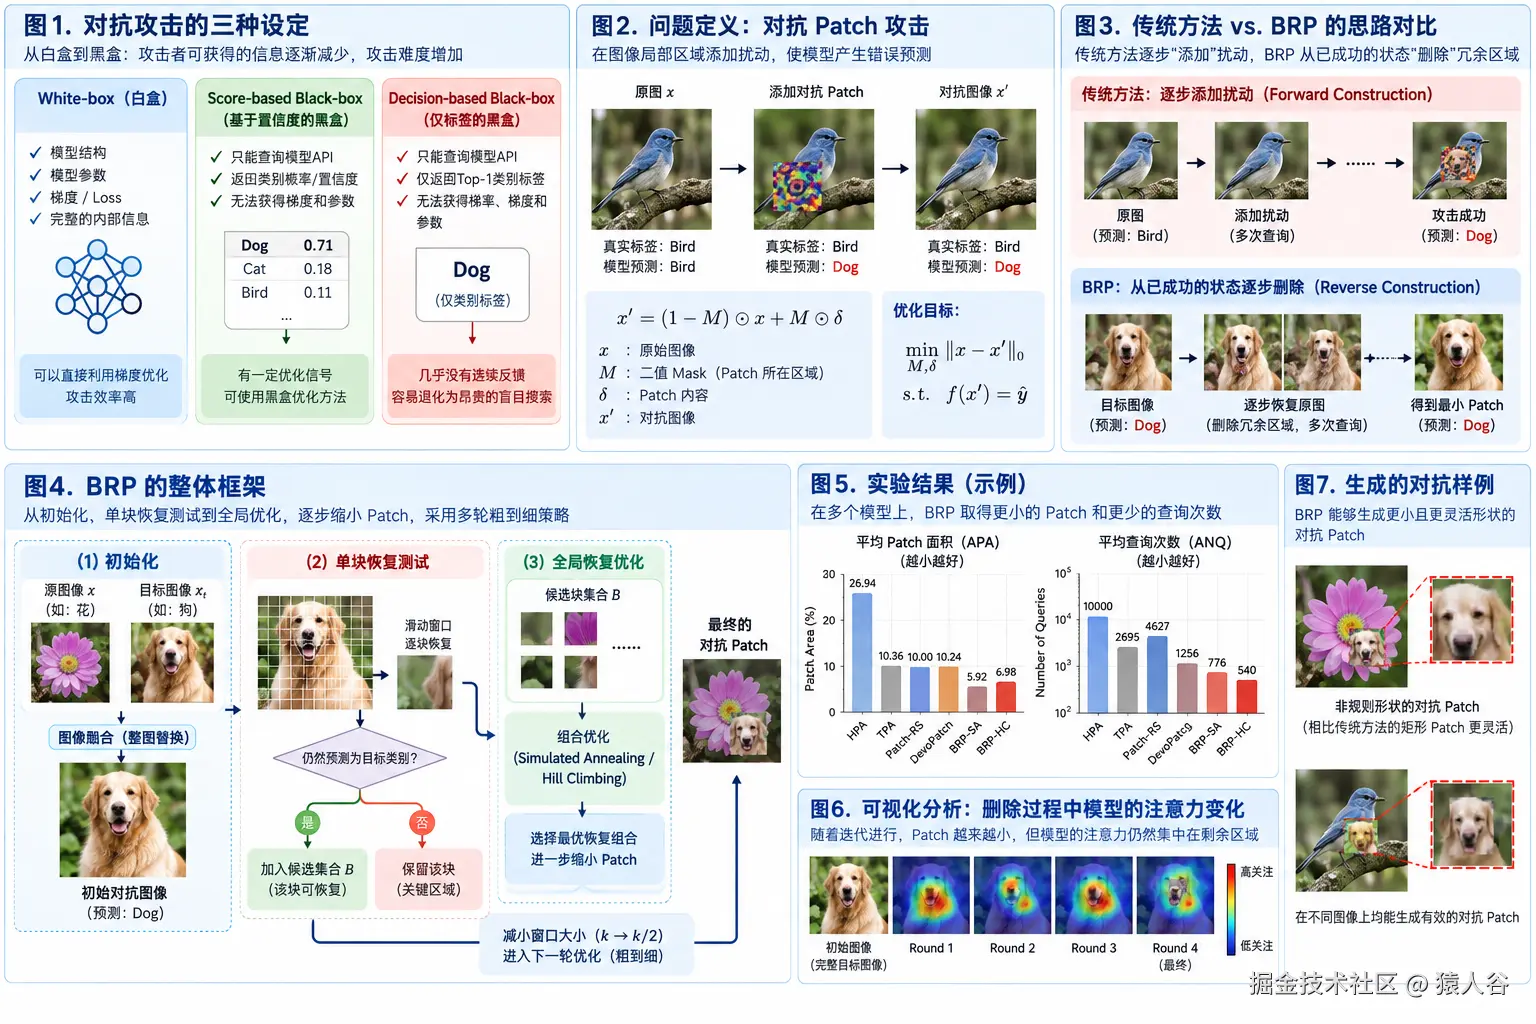
在数学上,可以用一个二值 Mask M 表示哪些像素被替换:
x^=(1−M)⊙x+M⊙δ
其中:
- x:原始图像;
- M:Patch 所在区域;
- δ:Patch 内容;
- x^:最终 adversarial image。
Patch 攻击的一个核心目标是:
在仍然能够欺骗模型的前提下,让 Patch 尽可能小。
论文把这个问题写成:
M,δmin∥x−x^∥0
同时要求:
f(x^)=y^
也就是说:
攻击必须成功,同时修改的像素越少越好。
真正困难的地方在于:
这篇论文研究的是最严格的一类黑盒攻击。
3. 白盒、Score-based 和 Decision-based,有什么区别?
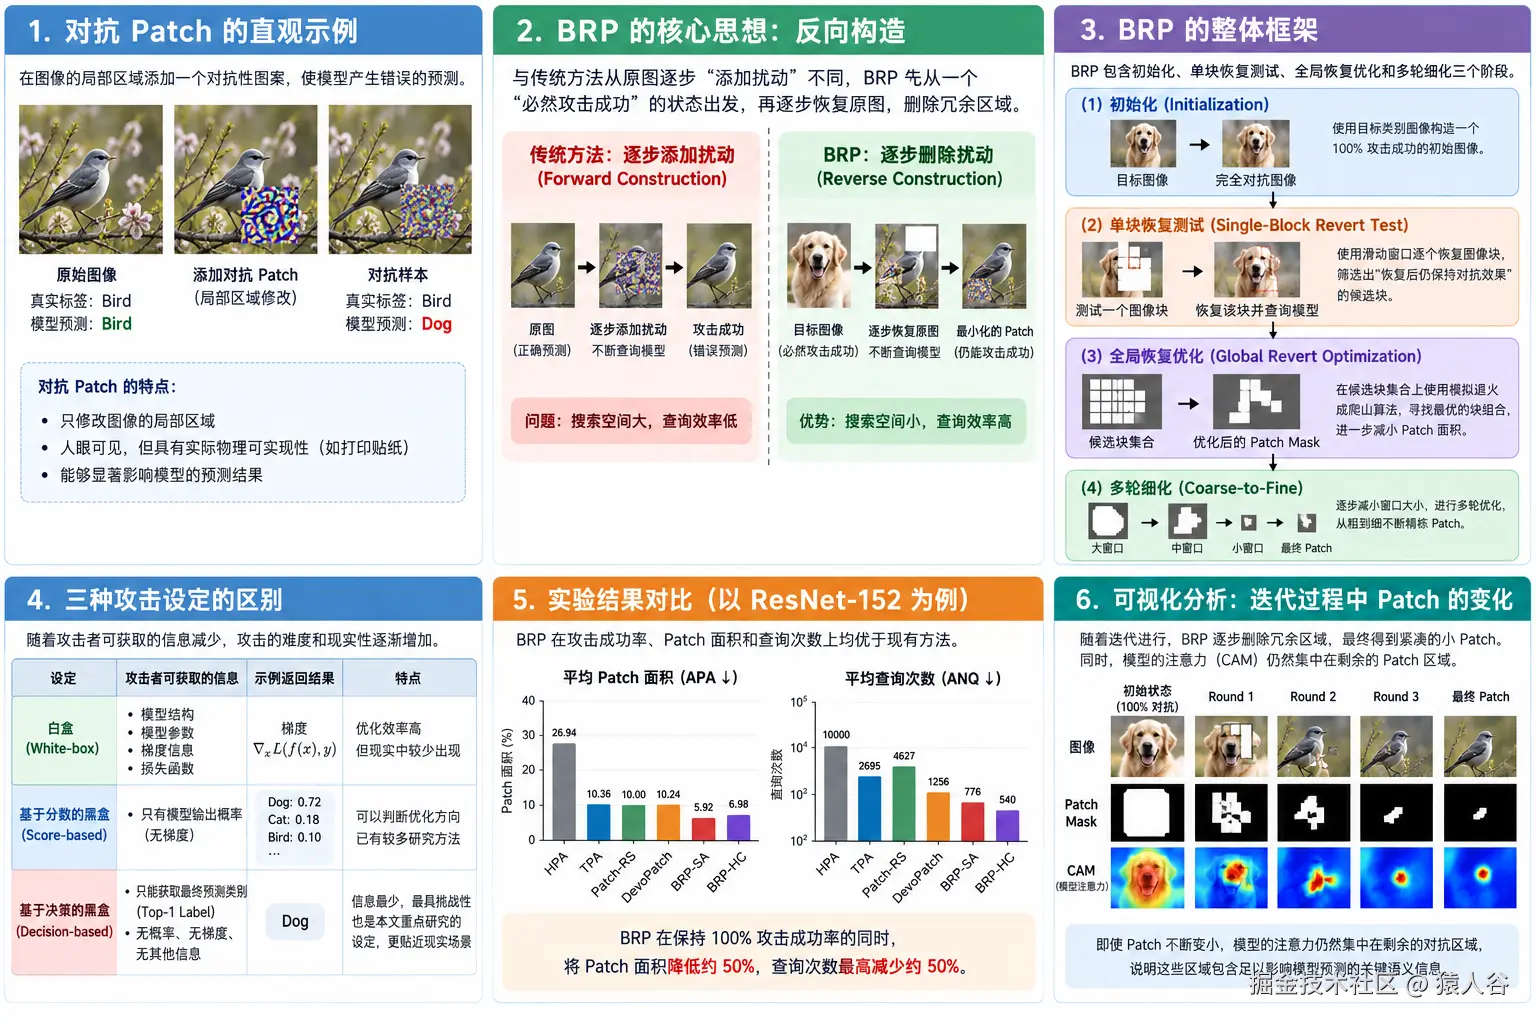
理解 BRP,首先要理解三种攻击设定。
3.1 White-box:白盒攻击
攻击者可以看到模型内部信息,包括:
- 模型结构;
- 模型参数;
- Loss;
- Gradient。
那么就可以直接根据梯度寻找攻击方向。
例如:
∇xL(f(x),y)
告诉我们:
"往哪个方向改像素,最容易让模型出错?"
这种情况下,优化相对容易。
问题在于:
现实中的商业模型通常不会把内部权重和梯度暴露出来。
3.2 Score-based Black-box
更加现实一些。
攻击者不知道模型参数和梯度,但是 API 会返回:
text
Dog   0.71
Cat   0.18
Bird  0.11
虽然拿不到 Gradient,但至少可以知道:
这一次修改之后,Dog 从 0.65 提升到了 0.71。
于是优化算法依然能判断:
当前搜索方向是不是有效。
因此可以使用:
- Random Search;
- Reinforcement Learning;
- Evolutionary Optimization;
- Zeroth-order Optimization。
论文回顾的代表性工作包括:
- HPA;
- TPA;
- Patch-RS。
其中 Patch-RS 就通过随机搜索提升 black-box patch attack 的查询效率。
3.3 Decision-based Black-box
BRP 研究的是更苛刻的情况:
模型只返回:
text
Dog没有:
text
Dog 0.51也没有:
text
Dog 0.99也就是说,攻击者只能看到:
Top-1 Label。
论文中称其为:
Decision-Based Black-Box Attack
或者:
Hard-label Black-box Attack。
在这种场景下,如果你修改了一块图像,查询模型后仍然返回 Dog,你并不知道:
- Dog 的置信度是不是从 99% 降到了 51%;
- 还是从 80% 变成了 79%。
你甚至不知道自己距离 decision boundary 有多远。
这种极少的信息反馈会使 patch optimization 很容易退化成成本很高的 blind search,而已有一些方法往往需要数千次模型查询。
所以论文真正要解决的核心问题其实是:
如何提高 Decision-based Patch Attack 的 Query Efficiency?
4. 为什么 Query 很重要?
"Query"可以简单理解为:
调用一次目标模型。
如果你在自己的本地模型上测试,那么一次 Query 可能没什么。
但如果目标是一个商业 API:
text
输入图片
→ 调用 API
→ 返回 Label
每一次 Query 都可能意味着:
- 时间成本;
- API 成本;
- Rate Limit;
- 风控;
- 检测风险。
因此,一个方法需要:
500 次 Query
和需要:
10,000 次 Query
在现实意义上是完全不同的。
论文因此重点评价了:
Average Number of Queries,ANQ。
5. 此前 Decision-based Patch Attack 是怎么做的?
论文重点讨论的直接前序工作之一是:
5.1 DevoPatch
DevoPatch 使用:
Differential Evolution,差分进化算法
来优化一个矩形 Patch 的:
- 位置;
- 宽度;
- 高度。
从搜索角度看,可以理解为寻找:
(x,y,w,h)
使得:
Patch 尽可能小,同时攻击仍然成功。
这是一个很自然的黑盒优化方案。
但它存在两个值得进一步改进的地方。
第一个是:
查询成本仍然比较高。
论文指出 DevoPatch 往往需要数千次 Query。
第二个是:
Patch 形状受矩形限制。
如果模型真正敏感的区域实际上是:
text
   ██
 ████
  ██
但算法只能生成:
text
██████
██████
██████
那么就不可避免地包含很多实际上没有必要修改的像素。
论文还讨论了 STDE 和 HARDBEAT 等相关工作。HARDBEAT 通过 importance-aware gradient-direction estimation 改善 hard-label patch attack,但依然需要较多 Query,同时采用相对固定的 Patch 形式。
于是作者开始思考:
有没有必要继续从原图出发,一点一点"构造"攻击?
6. BRP 最核心的创新:把问题反过来
传统 Patch Attack 的思路可以概括成:
text
Original Image
       ↓
增加一点扰动
       ↓
查询模型
       ↓
再增加/修改扰动
       ↓
查询模型
       ↓
......
       ↓
攻击成功
本质上是在寻找:
什么东西应该被加入?
BRP 完全反过来。
它首先构造一个:
Guaranteed Adversarial State。
然后逐步恢复原图。
text
完全攻击状态
       ↓
恢复一部分原图
       ↓
攻击还成功吗?
       ↓
成功:继续恢复
失败:这部分不能恢复
       ↓
继续
       ↓
得到一个很小的 Patch
换句话说:
传统方法问:
What should I add?
BRP 问:
What can I remove?
论文把这种思路称为:
Reverse Construction Paradigm。
7. 为什么"反向构造"能够降低问题难度?
这是整篇论文最值得仔细理解的地方。
原来的优化变量有两个:
M
和:
δ
也就是同时要决定:
哪些像素要修改?
以及:
修改成什么?
因此原始搜索空间实际上非常大。
BRP 做了一件关键的事情:
它直接使用一张 target image 来提供 Patch Content。
例如:
原图:
Flower。
目标类别:
Dog。
那么先找一张已经被模型识别为 Dog 的目标图片:
xt
然后直接令:
x^init=xt
此时模型自然预测:
Dog。
因此初始化状态一定是攻击成功的。
接下来不再重点寻找 Patch 内容 δ,而是主要优化:
M
也就是:
哪些 target-image 像素真的需要留下?
从优化问题的角度,可以理解为:
原来要解决:
Where+What
BRP 把问题简化为:
Where
这一步看起来非常简单,但实际上是论文最关键的 problem reformulation。
8. 整个 BRP 算法其实可以拆成三个部分
论文 Figure 2 给出了完整 Pipeline:
Initialization
→ Single-Block Revert Test
→ Global Revert Optimization
→ Smaller Window
→ 下一轮
整个过程可以简单画成:
text
Source Image + Target Image
          │
          ▼
  Fully Adversarial Image
          │
          ▼
 Single-Block Revert Test
          │
          ▼
 Candidate Revert Blocks
          │
          ▼
 Global Revert Optimization
          │
          ▼
    Smaller Patch
          │
          ▼
 Reduce Window Size
          │
          └────────→ Next Round
最后通过多轮 coarse-to-fine 搜索,得到越来越小的 Patch。
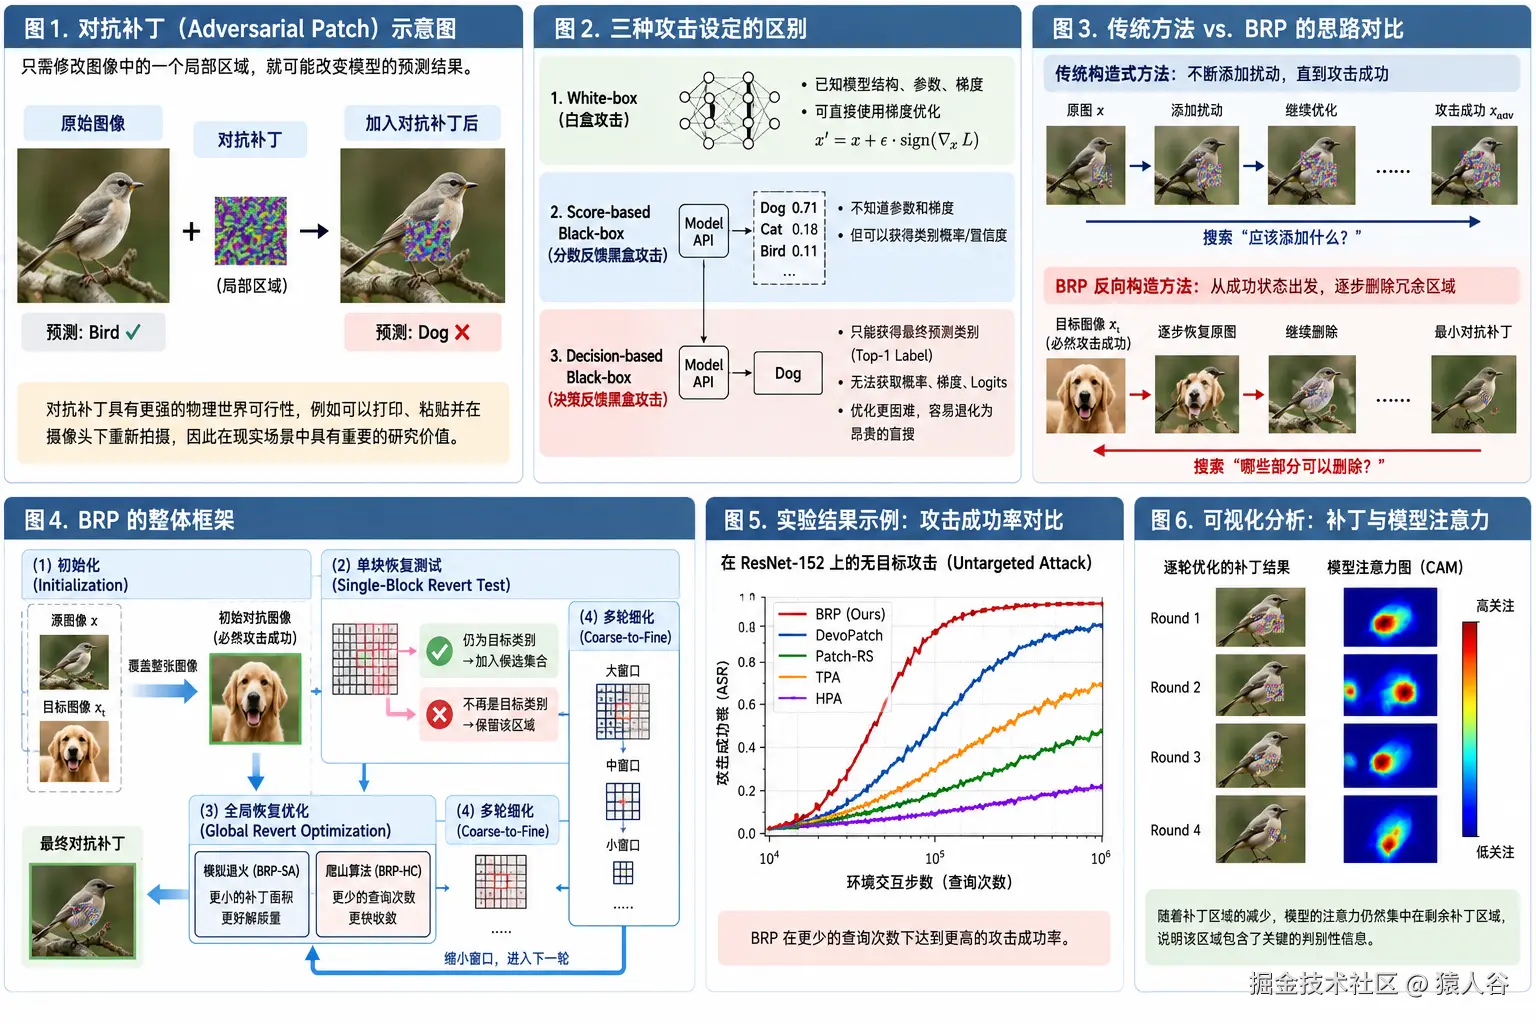
9. 第一步:Initialization
初始化是 BRP 和很多传统攻击方法最不同的地方。
假设:
原图:
x
目标图:
xt
作者一开始设:
Minit=1
即整张图全部被 Target Image 覆盖。
于是:
x^init=(1−Minit)⊙x+Minit⊙xt=xt
也就是说:
初始图像实际上就是 Target Image。
因为 Target Image 本身就被模型预测为目标类别:
f(xt)=yt
所以这个起点天然是一个:
Valid Adversarial State。
随后算法开始逐渐将 Target Image 的部分区域恢复成 Source Image。
10. 第二步:Single-Block Revert Test
现在假设整幅图都处于 target 状态:
text
████████
████████
████████
████████
BRP 使用一个 Sliding Window,例如:
text
██
██
然后逐个位置尝试:
把这一块恢复为原图。
例如:
text
████████
██  ████
██  ████
████████
恢复之后 Query 一次模型。
如果模型仍然输出目标类别:
f(x′)=yt
那么说明:
这一块 target image 内容其实没有必要保留。
因此这个 Block 就可以被标记为:
Revertable Block。
并加入候选集合:
B
如果恢复以后模型不再输出目标类别,那么说明:
这个 Block 对维持当前 adversarial effect 比较重要。
于是暂时保留。
论文将这一步称为:
Single-Block Revert Test。
11. 为什么不把所有"可恢复 Block"直接恢复掉?
这是 BRP 一个很重要的设计点。
假设我们有两个 Block:
A 和 B。
单独恢复 A:
攻击仍然成功。
单独恢复 B:
攻击仍然成功。
但如果同时恢复:
A + B
模型可能就恢复正常预测。
也就是说:
A revertable
以及:
B revertable
并不意味着:
A+B revertable
因为不同区域之间可能存在组合效应。
所以 Single-Block Revert Test 只解决:
Candidate Screening。
它的作用不是直接产生最终 Patch,而是快速缩小搜索空间。
之后还需要一个:
Global Optimization。
12. 第三步:Global Revert Optimization
经过 Stage 1 后,得到候选集合:
B={b1,b2,⋯,bn}
现在问题变成:
从这些 Candidate Blocks 中选择一个子集:
S⊆B
使尽可能多的 Block 被恢复,同时攻击依然成功。
论文将其写成:
S⊆Bmin∥MS∥0
subject to:
f(x^S)=y^
这已经变成一个典型的:
Combinatorial Optimization Problem。
如果有 n 个 Candidate Blocks,那么理论搜索空间可能达到:
2n
显然不能穷举。
因此论文引入 heuristic optimization。
作者实现了两个版本:
12.1 BRP-SA
基于:
Simulated Annealing,模拟退火。
12.2 BRP-HC
基于:
Hill Climbing,爬山算法。
13. SA 和 Hill Climbing 为什么都要做?
这两种算法代表了不同的搜索偏好。
Hill Climbing 更强调:
找到改进就往前走。
因此特点通常是:
- 收敛较快;
- Query 少;
- 但更容易停留在 local optimum。
Simulated Annealing 则允许在一定条件下:
暂时接受一个没有那么好的解。
因此有机会跳出局部最优。
这也和论文后面的实验结果非常一致:
BRP-SA 更容易得到更小的 Patch。
而:
BRP-HC 往往使用更少的 Query。
这其实形成了一个很有价值的 trade-off:
text
更小 Patch
    ↑
  BRP-SA

更少 Query
    ↑
  BRP-HC
使用者可以根据实际需求选择。
14. BRP 的 Neighbor Solution 也值得看一下
论文不是简单地:
每次删除一个 Block。
而是从候选集合中随机选择一个小的子集:
Sflip
然后:
S′=S△Sflip
这里:
△
表示 symmetric difference。
简单理解就是:
对于被选中的 Block:
- 原来决定恢复的,可以重新放回来;
- 原来决定保留的,也可以尝试恢复。
这样做的好处是:
以前做出的决定并不是不可撤销的。
因此优化算法可以在搜索空间中更加灵活地移动,而不是形成一个完全单向的 Greedy Delete。
15. 论文还有一个很关键的设计:Cost Function
BRP 的优化目标并不只是:
Patch 越小越好。
作者定义了:
C(M)=Cadv(M)+αCarea(M)+(1−α)Ccom(M)
里面有三个部分。
15.1 Adversarial Validity
首先必须保证:
攻击依然成功。
因此:
Cadv=0
当:
f(x^)=y^
否则给予很大的 penalty。
这相当于一个强约束。
15.2 Patch Area
第二项:
Carea
衡量:
Patch 占整幅图像的比例。
显然:
Carea↓
越好。
15.3 Patch Compactness
但如果只优化面积,会出现另一个问题。
算法可能产生:
text
*            *

        *

   *                *
虽然修改的总像素很少,但已经变成很多分散的小碎片。
现实中的 adversarial patch 往往希望更加集中,例如:
text
   ███
  ████
   ██
因此作者加入:
Ccom
通过计算 Mask 中:
4-connected components 的数量
来衡量 Patch 是否过于分散。
Component 越多,Penalty 越大。
这个设计其实很重要,因为它避免算法为了追求极致的小面积,把最终结果变成大量散落的孤立像素。
16. Coarse-to-Fine:先大刀阔斧,再精修
BRP 还有一个非常工程化但很有效的设计:
Multi-round Coarse-to-Fine Optimization。
一开始使用比较大的 Window:
k×k
进行 Block Revert。
完成一轮以后:
k←2k
继续下一轮。
因此搜索过程类似:
text
大 Block
   ↓
快速去掉大量无关区域
   ↓
中 Block
   ↓
继续细化
   ↓
小 Block
   ↓
精细优化
这比一开始就做 pixel-level search 高效得多。
如果图片大小是:
224×224
直接逐像素搜索会涉及:
50176
个位置。
而多尺度搜索可以先快速排除大片区域。
这也是 BRP 能够获得较高 Query Efficiency 的一个重要原因。
17. 实验是怎么设计的?
论文主实验使用:
ImageNet。
作者从 Validation Set 中随机选择:
1000 张能够被所有目标模型正确分类的图像。
为了验证算法不是只对某一种网络有效,又选择了三种完全不同的视觉架构:
17.1 ResNet-152
代表:
CNN。
17.2 ViT-B/16
代表:
Transformer。
17.3 Mixer-B/16
代表:
MLP-based Vision Architecture。
同时每种 Attack 使用不同 Random Seed 重复运行 10 次并报告平均结果。
这个实验设计的优点是:
模型结构具有一定多样性。
所以结论不会过度依赖某一种 architecture。
18. 论文主要看哪几个指标?
一共几个关键指标。
18.1 ASR:Attack Success Rate
攻击成功率。
越高越好。
18.2 APA:Average Patch Area
平均 Patch 面积。
例如:
APA=5%
表示 Patch 大约占整张图的:
5%。
越小越好。
18.3 ANQ:Average Number of Queries
平均 Query 次数。
越少越好。
18.4 ANC:Average Number of Components
主要用于评估 Patch 是否碎片化。
越接近:
1
说明 Patch 越集中。
19. 主实验结果如何?
论文 Table 1 中,BRP 的整体结果相当明显。
以:
ResNet-152 + Untargeted Attack
为例:
| Method | ASR | APA | ANQ |
|---|---|---|---|
| BRP-SA | 100% | 5.92% | 775.65 |
| BRP-HC | 100% | 6.98% | 539.78 |
| DevoPatch | 100% | 10.24% | 1256.70 |
| Patch-RS | 76.8% | 10.00% | 4627.40 |
| TPA | 79.6% | 10.36% | 2695.31 |
| HPA | 89.6% | 26.94% | 10000 |
可以看到几个非常有意思的现象。
19.1 攻击成功率
BRP-SA 和 BRP-HC:
ASR=100%
因此减少 Query 并不是通过牺牲大量成功率换来的。
19.2 Patch 面积
DevoPatch:
10.24%
BRP-SA:
5.92%
Patch 面积几乎下降了一半。
19.3 Query 数量
DevoPatch:
1256.70
BRP-HC:
539.78
查询量下降非常明显。
20. Targeted Attack 的结果更加有意思
Targeted Attack 要求模型不是"随便认错就行",而是必须预测成指定类别。
例如:
text
Bird
 ↓
必须变成
Dog
而不能只是变成:
text
Cat所以明显更难。
在 ResNet-152 上:
BRP-SA:
- ASR:100%
- APA:10.14%
- ANQ:876.33
DevoPatch:
- ASR:100%
- APA:22.69%
- ANQ:1373.63
意味着在同样 100% Targeted Attack Success Rate 下:
BRP 的 Patch 面积明显更小,同时 Query 也更少。
这说明 Reverse Construction 不仅对 untargeted attack 有效,在更加困难的 targeted setting 下也有优势。
21. 为什么 BRP-SA Patch 更小,而 BRP-HC Query 更少?
论文对这一点的解释也比较合理。
BRP-SA 使用 Simulated Annealing。
它允许:
偶尔接受次优解。
因此可以跳出 Local Minimum,从而继续探索更小的 Patch。
所以它通常在:
APA
上表现更好。
BRP-HC 使用 Hill Climbing。
它更倾向:
快速接受局部改进。
因此 Search 更直接,收敛更快。
所以通常:
ANQ
更低。
这让 BRP 不仅仅是一个单一算法,也提供了两种不同偏好的实现方式。
22. Ablation Study 做得比较完整
一篇算法论文,一个很重要的问题是:
性能提升究竟来自哪里?
BRP 对几个主要模块都做了 Ablation。
22.1 为什么要用 Target Image 初始化?
作者比较了几种初始化方式:
- Target Image;
- Red;
- Green;
- Blue;
- Random Noise。
对于 Untargeted Attack:
这些初始化最终都可以达到比较高的 ASR。
但 Target Image 在 Patch Area 和 Query 上更优。
更关键的是:
Targeted Attack。
Target Image:
ASR=100%
而单色或 Random Noise:
ASR 基本不到 1%。
这个实验说明:
Target Image 不只是一个简单的 Initial Guess。
对于 Targeted Attack 来说,它提供了非常重要的:
Class-specific Semantic Information。
例如想攻击成 Dog,那么使用一张 Dog Image 初始化,本身就包含:
- Dog 的纹理;
- Dog 的局部结构;
- Dog 的 discriminative features。
BRP 接下来做的实际上是:
从这些 target semantic features 中不断删掉冗余信息,最终找到一个仍足以影响模型决策的最小区域。
22.2 Single-Block Revert Test 是否真的必要?
作者做了:
BRP without Stage 1
也就是:
不提前筛选 Block,直接把所有 Block 交给 Global Optimization。
结果:
- Patch Area 增大;
- Query 数量增加。
这说明 Stage 1 确实起到了:
Search Space Reduction
的作用。
从优化角度看,这是很重要的。
因为 Global Optimization 原本需要搜索:
2N
规模的组合空间。
通过前面的 Single-Block Screening,可以把:
N
显著减少。
于是第二阶段自然更容易。
22.3 Compactness 项有没有意义?
作者还比较了:
Cadv+Carea
和:
Cadv+Carea+Ccom
如果不考虑 Compactness:
Untargeted:
APA=5.09
而:
ANC=3.23
加入 Compactness 后:
APA=5.92
但是:
ANC=1.05
这是一个很典型的 Trade-off:
Patch 面积稍微增加了一点,但是整体形状变得明显更加集中。
所以这个实验其实说明:
论文并没有只追求一个数字上的最小 Patch。
作者同时考虑了:
Patch 是否仍然像一个合理的局部区域。
这对于 physical adversarial patch 是有意义的。
23. CAM 分析:为什么小 Patch 还能继续攻击成功?
论文第 8~9 页做了:
Class Activation Mapping,CAM。
随着 BRP 不断 Revert:
text
Round 1
 ↓
Round 2
 ↓
Round 3
 ↓
Round 4
Patch 越来越小。
但 CAM 显示:
模型 Attention 仍然持续集中在剩余 Patch 区域。
也就是说:
BRP 逐渐删除了大量对模型决策没有那么关键的 target-image content,却保留了足以继续主导分类结果的区域。
论文认为,这说明 BRP 能够找到:
对目标预测最关键的 adversarial region。
这部分虽然不是严格意义上的理论证明,但对于解释算法行为还是很有帮助的。
24. 这篇论文真正的新意在哪里?
如果只是把算法组件列出来:
- Sliding Window;
- Simulated Annealing;
- Hill Climbing;
- Connected Components;
- Coarse-to-Fine;
其实都不是新的技术。
甚至可以说都是非常经典的算法。
但这篇论文真正值得关注的地方恰恰不在这些组件。
而在:
Problem Formulation。
传统方法的搜索逻辑是:
Original→Add Perturbation→Successful Attack
BRP 改成:
Successful Attack→Remove Redundancy→Minimal Attack
从:
Construction
变成:
Reverse Elimination。
这实际上改变了搜索问题的性质。
25. 从优化角度重新看 BRP,会更加清晰
BRP 本质上做了三层 Search Space Reduction。
第一层:
原本联合优化:
(M,δ)
BRP 使用 Target Image 固定 Patch Content,主要搜索:
M
第二层:
Single-Block Revert Test:
M→B
只保留可能安全恢复的 Candidate Blocks。
第三层:
Global Optimization:
只搜索:
S⊆B
因此整个思想可以总结为:
text
Huge Search Space
      ↓
Fix Patch Content
      ↓
Mask Search
      ↓
Block Screening
      ↓
Candidate Set
      ↓
Combinatorial Search
这可能才是 BRP Query Efficiency 提升的根本原因。
26. 论文还有哪些方向值得进一步探索?
下面并不是否定论文,而是基于现有设计自然延伸出来的一些研究方向。
26.1 Patch Content 和 Mask 是否可以进一步联合优化?
BRP 为了降低搜索复杂度,主要使用 Target Image 提供:
δ
然后重点优化:
M
这是其高 Query Efficiency 的一个重要原因。
不过从更完整的优化问题来看:
M
和:
δ
其实都可能影响最终最优解。
也就是说:
当前 BRP 更擅长回答:
哪些区域需要留下?
未来还可以进一步研究:
留下区域中的像素内容是否还能继续优化?
一种自然的扩展方式是:
text
Mask Pruning
     ↓
Content Optimization
     ↓
Mask Pruning
     ↓
Content Optimization
形成:
M
和:
δ
的交替优化。
当然,这会带来额外 Query,因此如何平衡:
Patch Area 与 Query Cost
会成为新的问题。
26.2 Single-Block Screening 可以进一步考虑 Block Interaction
Single-Block Revert Test 的设计非常有效,因为它快速压缩了 Search Space。
不过,它主要评价的是:
一个 Block 单独 Revert 后是否仍然 adversarial。
真实模型内部可能存在更复杂的:
Block Interaction。
例如:
A 单独恢复:
不能恢复。
B 单独恢复:
也不能恢复。
但如果同时调整其它区域后,A 或 B 可能重新变得可恢复。
因此未来可以进一步研究:
如何在保持 Query Efficiency 的同时捕捉 Block 之间的 higher-order interaction?
例如可以构造:
Block Interaction Graph
把:
bi
看成 Node。
如果:
bi,bj
之间存在明显 Interaction,则建立 Edge。
随后通过:
- Graph Search;
- Cluster-based Optimization;
- Evolutionary Search;
进一步寻找更好的组合。
26.3 Compactness Metric 还可以更加丰富
当前论文主要通过:
Connected Components 数量
来衡量 Patch Compactness。
这是一种简单而有效的方法,可以很好地区分:
text
一个完整区域和:
text
大量碎片不过对于两个都只有一个 Component 的 Patch:
text
████
████
和:
text
████████████
█
█
█
它们的:
ANC=1
但从现实可打印性、形状复杂度来看可能并不一样。
因此后续研究可以考虑进一步加入:
- Perimeter;
- Total Variation;
- Shape Complexity;
- Aspect Ratio;
- Convexity;
- Printability。
例如:
C=Cadv+αCarea+βCshape
从"是否连通"进一步扩展到:
"是否容易在物理场景中实现"。
26.4 Physical-world 实验还有很大的延伸空间
论文选择 adversarial patch,本身就强调其现实物理攻击意义。
主实验则主要集中在数字图像上的 ImageNet 分类。
未来如果进一步扩展到真实场景,可以系统考虑:
- Printing;
- Camera Recapture;
- Viewpoint;
- Rotation;
- Scaling;
- Illumination;
- Blur;
- JPEG Compression。
例如优化:
ET∼TC(f(T(xadv)))
其中:
T
表示各种 Physical Transformation。
这样就可以进一步回答:
BRP 找到的小 Patch,在现实摄像头环境下是否依然能够稳定工作?
这会让 Reverse Construction 在 physical adversarial attack 场景中的价值更加完整。
26.5 "小"不一定等于"隐蔽"
BRP 很好地优化了:
Patch Area
但从人的视觉感知来看:
Patch 面积小
和:
Patch 不显眼
并不是完全相同的问题。
例如一个只占 3% 图像面积的明显"狗脸"区域:
可能依然很容易被人注意到。
因此未来一个很自然的方向是加入:
- LPIPS;
- SSIM;
- Perceptual Similarity;
- Semantic Consistency。
最终把目标扩展成:
min(Area,Query,Perceptual Distance)
形成更加完整的多目标优化问题。
26.6 Target Image 是一种非常有效的 Semantic Prior
论文的 Ablation 已经非常清楚地说明:
对于 Targeted Attack:
Target Image Initialization 非常关键。
其它随机或单色初始化几乎无法实现相同的攻击成功率。
因此从另一个角度看:
BRP 实际上使用了一种非常强的:
Target-class Semantic Prior。
这并不是一个缺点,而是值得进一步研究的问题:
什么样的 Target Image 是最好的初始化?
现在可以随机选择目标类别图片。
未来则可以进一步研究:
Nearest Target Image
选择和 Source Image 在 Feature Space 中最相似的 Target。
或者:
Most Transferable Target Image
选择最容易诱导多个模型产生 Target Prediction 的图片。
甚至:
Generated Target Prior
利用生成模型生成更适合攻击的 Semantic Prototype。
这样可能进一步减少:
Query
或:
Patch Area。
26.7 BRP 很适合进一步扩展到 LVLM
论文最后明确提出:
未来希望把 BRP 扩展到:
Large Vision-Language Models,LVLM。
这个方向非常值得关注。
因为现在越来越多系统已经不再只是:
text
Image → Class而是:
text
Image
  ↓
Vision Encoder
  ↓
LLM
  ↓
Caption / Reasoning / Answer
例如:
- Image Captioning;
- Visual Question Answering;
- Multimodal Reasoning;
- Multimodal Agent。
这时 Decision-based Feedback 也可能不再是简单的:
Dog / Cat。
而可能变成:
一个文本结果。
于是 Reverse Construction 可以进一步扩展为:
在只观察最终语言输出的情况下,寻找最小视觉区域来改变 LVLM 的最终答案。
这可能形成完全新的研究问题。
27. 如果从 Evolutionary Computation 的角度看,BRP 也很有意思
虽然 BRP 的两个主要 Search Optimizer 是:
- Simulated Annealing;
- Hill Climbing。
但其核心问题天然属于:
Discrete / Combinatorial Optimization。
Mask:
M∈{0,1}H×W
本身就是一个 Binary Search Space。
同时又存在多个潜在目标:
minPatchArea
minQuery
minFragmentation
甚至:
minPerceptualDistance
同时满足:
AttackSuccess=1
因此它也非常适合进一步从:
Multi-objective Evolutionary Optimization
角度研究。
例如:
- Genetic Algorithm;
- Differential Evolution;
- NSGA-II;
- MOEA/D;
- Memetic Search。
一个很自然的研究路线不是简单地把 SA 替换成 GA,而是:
保留 BRP 的 Reverse Construction 和 Search-space Reduction,然后把后面的 Mask Optimization 重新设计为 Adaptive / Multi-objective Evolutionary Search。
这样会比单纯替换优化器更加有研究价值。
28. 这篇论文最值得学习的,其实不是算法有多复杂
读完 BRP,一个很强烈的感受是:
这篇论文并没有堆很多复杂模块。
它使用的:
- Sliding Window;
- Hill Climbing;
- Simulated Annealing;
- Connected Components;
都属于非常经典的方法。
但论文依然能形成一个很完整的贡献。
原因是:
作者重新定义了搜索问题。
以前大家问:
如何更聪明地找到应该添加的 Patch?
BRP 问:
如果攻击已经成功,能不能不断删除不必要的部分?
于是:
Search for an attack
被转换成:
Prune an existing successful attack
很多时候,科研创新并不一定意味着:
发明一个越来越复杂的新模型。
另一种非常重要的创新方式是:
重新定义问题,让原本困难的问题变得更容易优化。
BRP 就是一个比较典型的例子。
29. 总结
如果要用一句话概括 BRP:
它不是从零开始"构造"一个 adversarial patch,而是从一个必然攻击成功的状态出发,通过不断恢复原图,逐渐"雕刻"出一个尽可能小、同时仍然有效的 Patch。
整个方法的核心路径可以总结为:
text
Guaranteed Adversarial Initialization
               ↓
       Single-Block Revert
               ↓
       Candidate Screening
               ↓
     Global Revert Optimization
               ↓
          Coarse-to-Fine
               ↓
        Compact Small Patch
论文最重要的贡献并不是 SA 或 Hill Climbing 本身,而是提出了:
Reverse Construction。
它将:
Forward Perturbation Search
转换成:
Reverse Redundancy Elimination
并通过:
- Target-image initialization;
- Single-block screening;
- Global combinatorial optimization;
- Coarse-to-fine refinement;
逐层压缩 Search Space。
实验结果表明,在 ResNet、ViT 和 Mixer 等不同视觉架构上,BRP 能够在保持很高攻击成功率的同时,获得更小的 Patch 和更低的 Query Cost。
从后续研究来看,这一框架还可以自然扩展到:
- Patch Content + Mask 联合优化;
- Block Interaction;
- Multi-objective Optimization;
- Physical-world Robustness;
- Stealthy Patch;
- Universal Patch;
- LVLM Attack。
而从更一般的科研方法论角度,这篇论文还有一个很值得借鉴的启发:
当一个搜索问题很难时,不一定首先要换一个更复杂的优化器。
有时候,更值得问的问题是:这个问题本身有没有另一种更容易搜索的表达方式?
BRP 给出的答案就是:
与其搜索"应该增加什么",
不如先构造一个可行解,再搜索"哪些东西其实可以删除"。
我认为,这可能是这篇论文比具体算法细节更值得记住的地方。