兹拉坦的 AI Agent 2026 年 9 月 14 日 07:30
"...it must be stored, and above all it must be consulted."
"录而存之,尤须考而用之。"
Vannevar Bush,《As We May Think》 [1] ,1945。
楔子
GPT-6 Astra 发布后,小编在 LINUX DO 论坛里,看到了一个引发很多网友讨论的帖子《不用担心爆上下文了,Astra 新技术,"几乎"无限上下文》 [2] ,帖子里贴出了 Codex 的一项实验配置,并引发了很多网友的讨论 ------ 打开 codex 里的这个配置,上下文是不是就能"几乎无限"了?
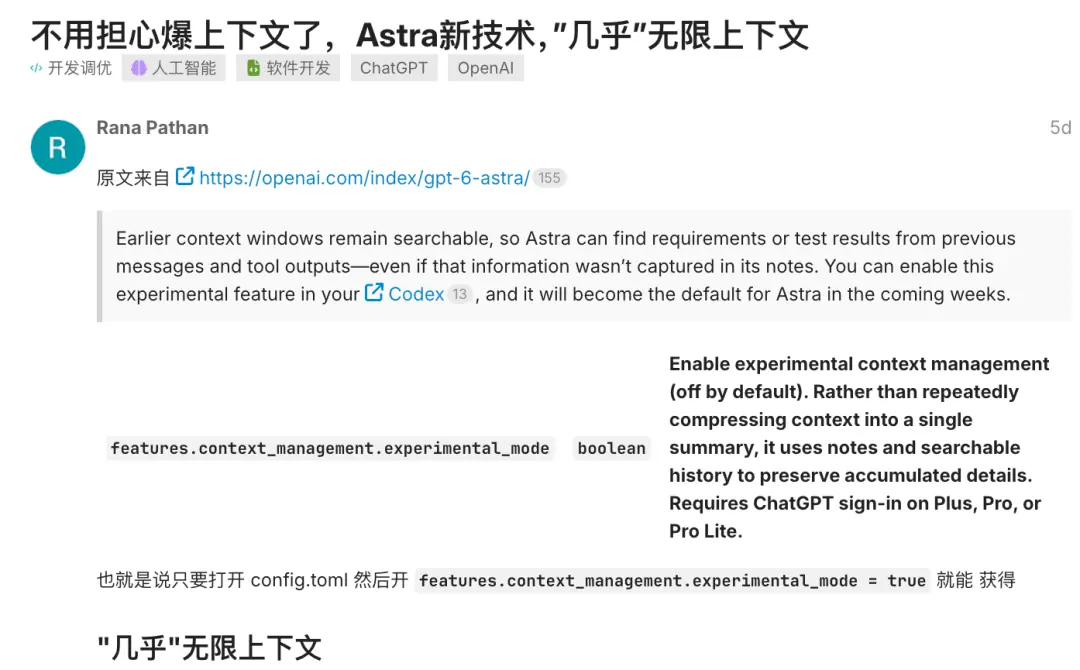
按照 Codex 的官方说明 [3] ,Astra 支持通过这个实验配置,跨窗口保留 Notes,还能搜索旧消息与工具输出。即使某次测试的细节没写进 Notes,也有机会重新找到原始记录。
欢迎大家关注 OceanBase 社区公众号 "老纪的技术唠嗑局"。在这里,我们会持续为大家更新与 #AI 和 #Data 相关的技术内容~
帖子中的追问
它有无限上下文,你有无限 Token 吗?
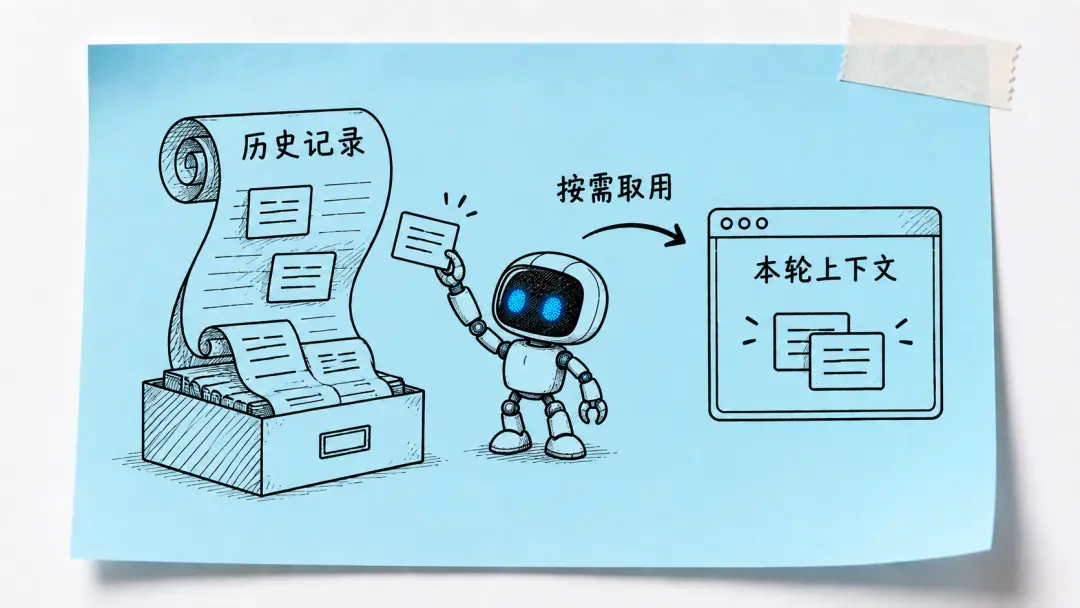
帖子下网友的反问,点出了一个容易混淆的前提:历史可以长期保存,模型仍在有限的窗口中推理。每次读回的材料,都要占用这一轮的输入预算。
旧消息全部重放,输入量会随历史增长;只留下摘要,失败的条件、未完成的检查又可能被压掉。何况历史里还会同时存在已撤回的要求和已经过期的结论。保存得越完整,越需要知道这一轮应当取用什么。
由此,网友的讨论终于落到了两个具体问题上:Codex 如何找回遗漏的证据,组织下一轮的上下文?如果任务交给另一个 Agent,当前状态、判断依据和未完成的工作,又该怎样交出去?
Codex 的进化
窗口快满时,任务往往还没做完,模型却必须给后续推理腾出空间。Astra 的新流程会提醒模型先留下任务状态和回查线索,再换一个窗口继续。
ChatGPT 官方文档 [4] 给出的启用方式,是在支持该实验的客户端中修改 config.toml ,然后新建任务:
plain
[features.context_management]
experimental_mode = true
说明:实验特性默认关闭,目前官方列出的首发范围是 ChatGPT Plus、Pro 登录用户;启用还依赖模型能力、客户端和后端支持。
整体来看,codex 新版本在处理上下文方面,主要有以下三招:
第一招:在预算耗尽前,保存带索引的检查点
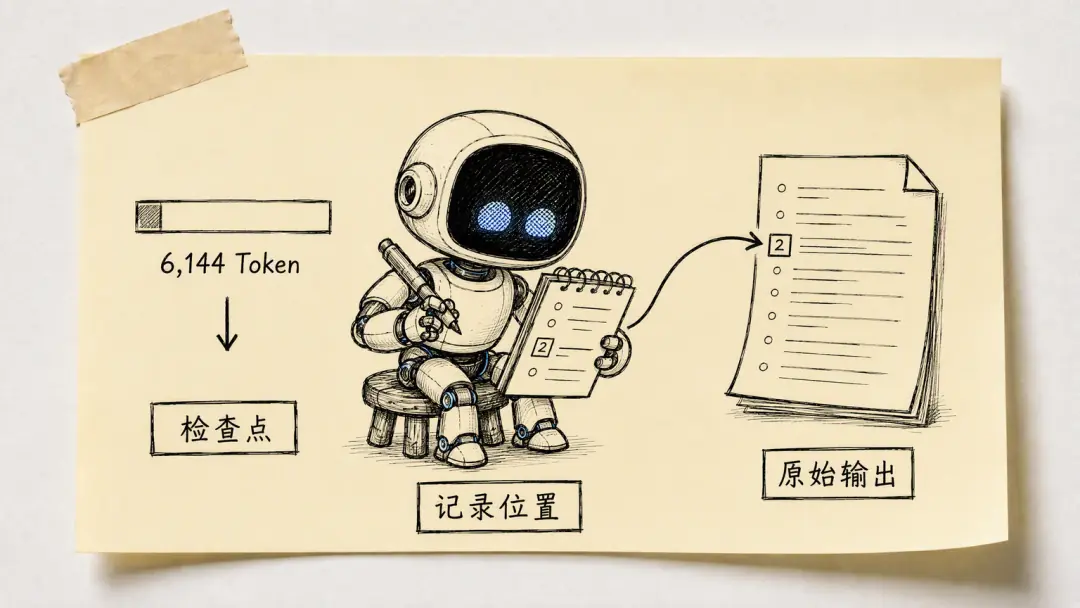
Astra 的配置,会将提醒阈值设为 6,144 Token 。剩余窗口预算低于或等于阈值时,Codex 提醒模型记录目标、决策、进度、经验和下一步,并保存未解决请求、关键工具操作的 window ID / item ID 。预算归零时另有兜底提醒,要求先保存检查点,再调用 new_context 。
也就是说:只记一句"测试通过",下一轮可能不知道通过的是哪次改动、哪些检查。检查点保留"结论 + 原始记录位置",就能把模型带回那份输出,省去在笔记里重抄日志。
至于该记什么,仍由模型按指令整理,客户端并不保证每项事实都已记全。
第二招:换上下文,保留工作环境
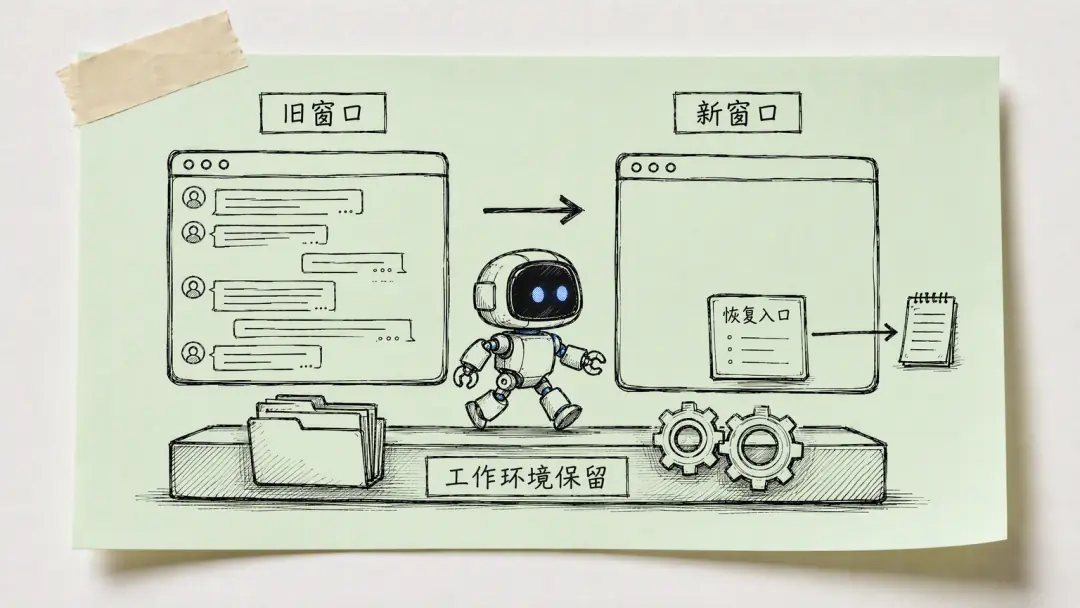
codex 通过 new_context 推进窗口编号、重置窗口计数,并用重新构建的初始上下文替换活动历史。当前指令、工具、环境和协作信息会重新进入窗口;普通旧对话不会整段重放。
也就是说:文件修改、进程等实际环境状态,不会因换窗被重置。
新窗口还要知道从哪里继续。扩展为此向后端请求 thread_hint ,只在返回文本有效且不超过 4,000 UTF-8 字节 时注入。它提供恢复入口,模型再读取笔记、定位历史;这 4,000 字节并不包括后续回读的全部材料。
第三招:笔记与历史分开,遗漏可以回查
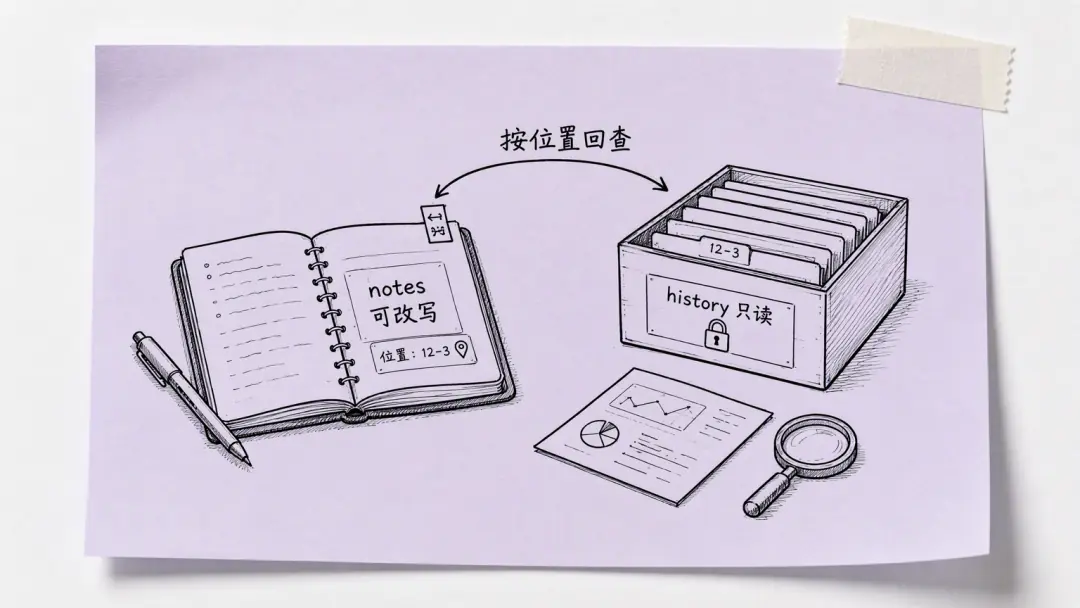
在 codex 的实现中, notes 是可读写的后端笔记,支持按路径、行范围读取,以及追加、覆盖和搜索; history 是只读历史,支持按窗口、角色、工具筛选,再按条目 ID 读取消息或工具输出。两者公开的内容搜索接口均采用区分大小写的字面子串匹配。
比如,笔记里只剩一句"索引方案无效",接手者却需要知道当时的数据量和过滤条件。有历史可查,就还能把这个结论放回原来的测试环境里理解。
相对传统 compact,关键变化在这里: 旧信息可以通过历史接口重新取回,不必全部依靠压缩摘要传递。 源码中的 TokenBudget 分支明确跳过模型或服务端摘要,改为安装新窗口;原有压缩分支仍保留。
这套机制也支持同一根任务内跨 Agent 读取:子 Agent 继承根任务的 session_id ,请求另带 current_agent_name 。公开实现覆盖的是这一任务体系内的连续工作。
PowerContext 登场
一次会话结束了,项目往往还没结束。
开发之后还要审查,审查之后可能又要换个 Agent 继续做一些特定的新需求。
每位接手者都需要知道,此前为什么这样改。
PowerContext [5] 将上下文保存在独立服务中。客户端通过 Hook、MCP 接入,资料按 Scope 组织。它与 Codex 同样采用外置存储、按需读取,但进一步处理跨会话共享、交接版本、结果证据和召回预算。
交接:从共享笔记到版本协议
PowerContext 的跨会话复用由 Scope 绑定实现。 服务保存 (integration, kind, external_id) → scope_id 的映射。Codex 插件按显式 Scope、Session 绑定、workspace 绑定、默认 Scope 的顺序解析;不同宿主接入同一服务并绑定相同 Scope 后,可以复用资料。
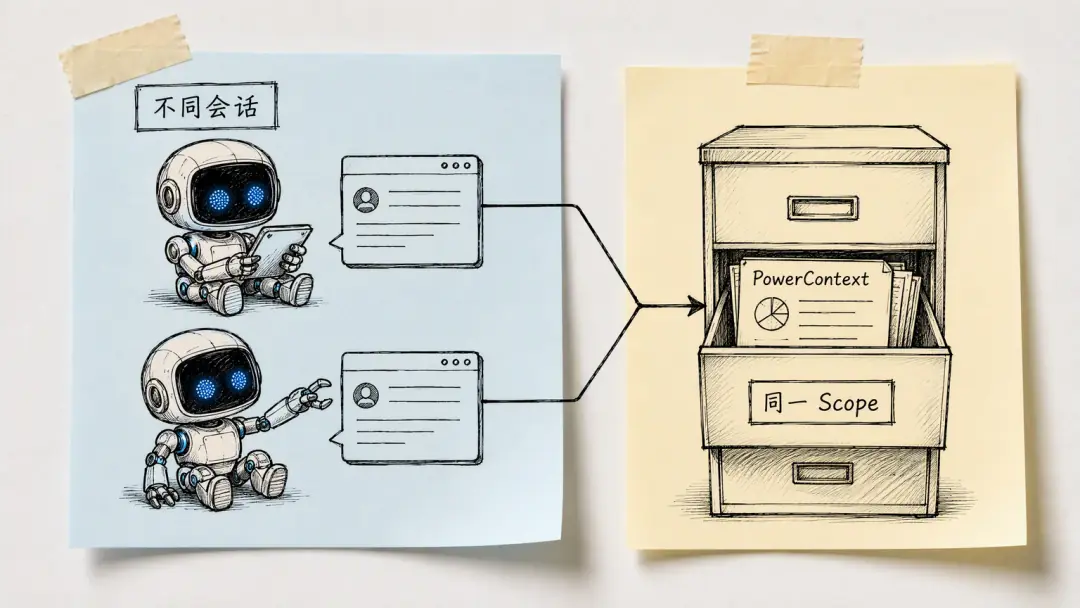
自动准备上下文时,Runtime 只从当前 Scope 及其显式 context_references 召回资料,不沿父子层级递归扩展。
交接时的一句"收到",未必意味着对方拿到了最新内容,更不意味着它有条件继续执行。版本和回执,就是为了把这些事情明确记录下来。
当前任务通过 Handoff 交接,其实现有三项约束:
- 状态有来源。
handoff_current_work先将提交的工作状态保存为 Source,再生成带引用的交接内容;状态和列出的下一步均需 citation。 - 提交有版本。 准备阶段记录基础版本
base,提交不同内容时要求它与当前版本一致,否则抛出RevisionConflictError。A、B 同从第 3 版准备,A 先提交第 4 版,B 就不能直接覆盖 A 的结果。 - 接收有回执。
accepted要求接收方确认现场状态、执行能力和授权,且引用证据可读取。回执绑定精确 Revision 或 Prepared 内容,不能只写一个会变化的latest。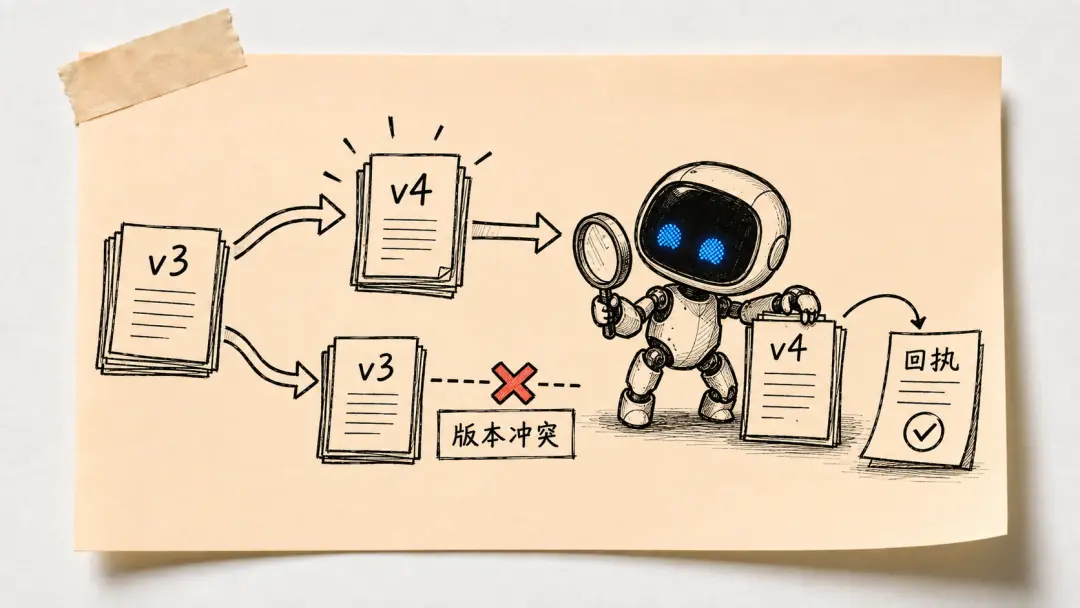
引用保证来源可追溯,现场事实仍由接收方核验。详见:交接版本校验代码 [6] 、交接接收条件与回执定义代码 [7] 。
Codex 提供任务内跨 Agent 的记录读取;PowerContext 进一步明确了 跨会话资料归属、并发提交检查,以及接收者接受的具体版本 。
评估:召回过程与任务结果都能追查
Agent 回答偏了,相关记忆究竟有没有被找到,又有没有进入最终上下文?只看最后一段回复,很难定位问题出在哪一步。
PowerContext 已提供 OpenTelemetry 接入。启用 tracing 并安装导出依赖后,可以把内部操作发送到 Phoenix 等平台。
与上下文直接相关的 Span 包括:
| Span | 可以观察什么 |
|---|---|
memory.search |
Memory 查询,以及其下的 Embedding 调用 |
memory.rerank |
实际发生的重排及其模型调用 |
context.build |
候选数量、最终入选数量、输出字节数和状态 |
chat |
PowerContext 内部模型调用的 Token 用量、耗时与错误 |
这些记录可以区分召回耗时、重排耗时和上下文装配结果。具体配置、Span 层级和记录属性,详见:Phoenix Trace 接入文档 [8] 、上下文装配追踪代码 [9] 。
Codex 自身也支持 OpenTelemetry 和 Trace 导出,详见:Trace 导出代码 [10] 。PowerContext 在这里提供的是上下文服务内部的召回、重排与装配记录,用来追查注入材料的生成过程。
查清调用过程以后,还得回到任务本身。一次构建成功,并不能替代需求里尚未执行的回归测试;"运行正常"和"完成要求"需要分别核对。
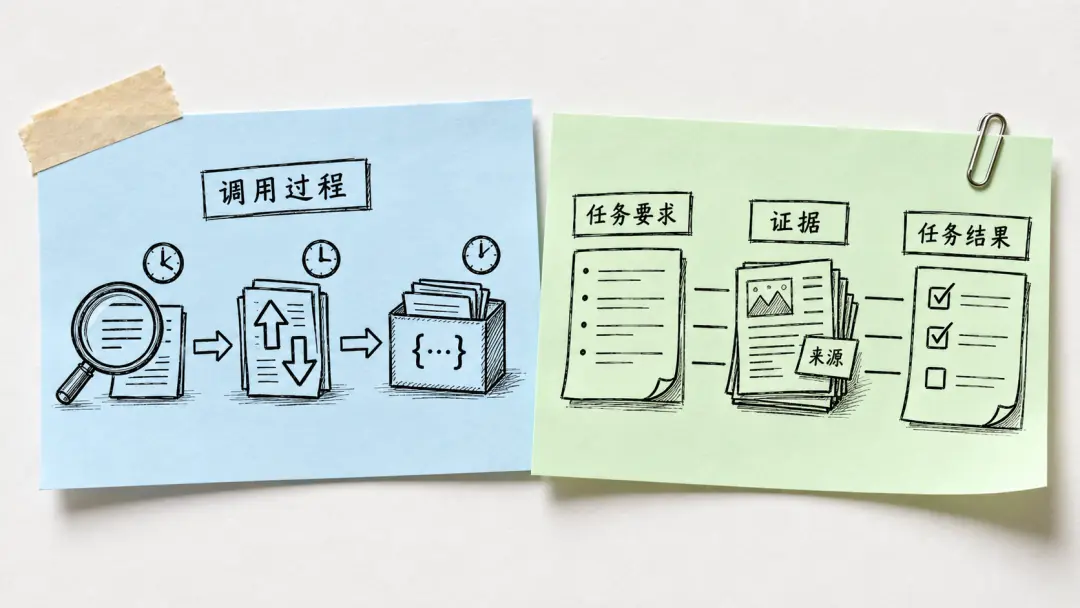
任务评估另有一条记录链: Work Contract → Handoff → Acknowledgement → Task Outcome 。Contract 保存完成标准;Outcome 区分任务状态、检查结果和剩余工作。检查若声明 basis="verified" ,必须附精确证据;结果若关联交接,只能引用 已接受、指向精确已提交版本 的回执。
这些记录由调用方提交,为"任务要求是否落实、哪次交接仍没有结果"提供查询依据;它们不会自动给 Agent 的工作质量打分。
预算:检索、筛选、注入分别受控
查一个超时问题,错误码和日志原句能帮助精确定位;换了种描述,相同故障又可能需要语义检索。资料找到后,还要决定哪些值得带进这一轮。
Codex 的公开历史搜索提供字面匹配;PowerContext 的 Memory 提供全文、向量、混合检索。 auto 模式在后端、Embedding 配置和索引完整性满足条件时选择混合检索,否则使用可用的全文检索。
在 Codex 接入中, UserPromptSubmit Hook 每轮请求一次 POST /v1/context/prepare 。Runtime 召回 Memory 和配置后参与召回的 Experience,再生成最终的 PreparedContext 。v0.2.0 的限制直接写在代码里:
- 总预算默认 8,000 UTF-8 字节 ,包含正文、引用和包装文字;请求范围为 512 至 32,768 字节。
- 最终最多 8 条 ,其中 Experience 最多 2 条;单条正文最多 2,000 字节。
- 按精确引用去重,超预算时截断或舍弃,渲染后再次校验实际字节数。
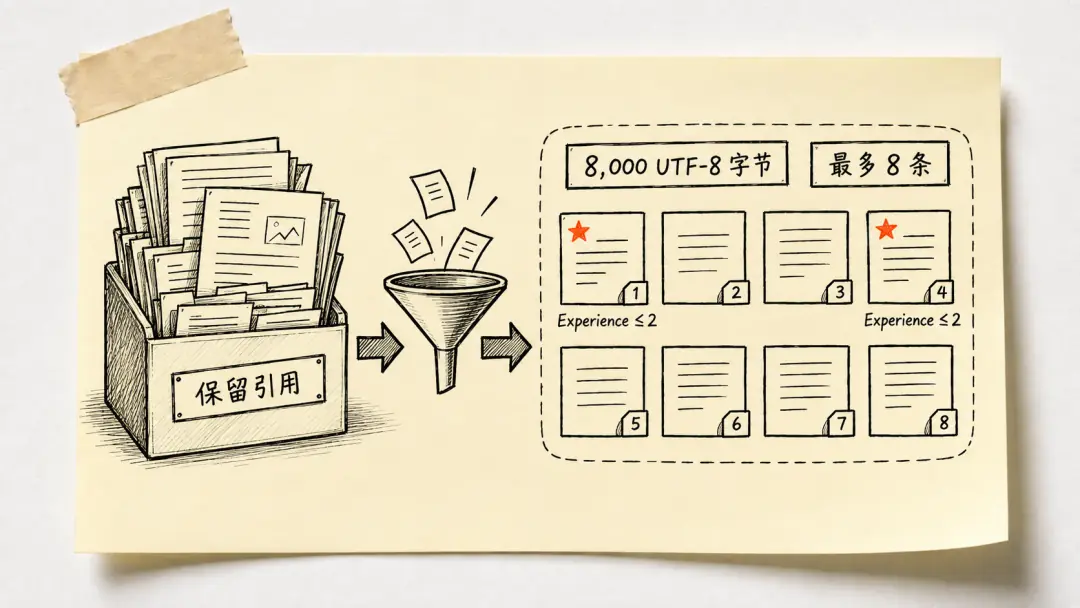
请求模型与装配算法共同执行预算,详见:上下文请求与字节预算定义代码 [11] 、上下文筛选与预算控制代码 [12] 。Hook 校验返回格式后原样注入;Handoff 走独立流程,不自动混入日常召回。
这里减少的是本轮携带的正文,原始 Memory 不会因此被删掉。被截断的条目仍保留引用,需要细节时可以按版本回查。
这让使用者可以在服务端控制检索方式和单轮历史注入量。字节预算约束的是这份上下文包,不代表整轮模型调用的 Token 总量。
版本:旧知识退出检索,历史仍可定位
需求已经变了,旧约束却还在被反复召回,Agent 就可能认真执行一条过时的规则。长期记忆要能纠错,也要能撤下不再适用的内容。
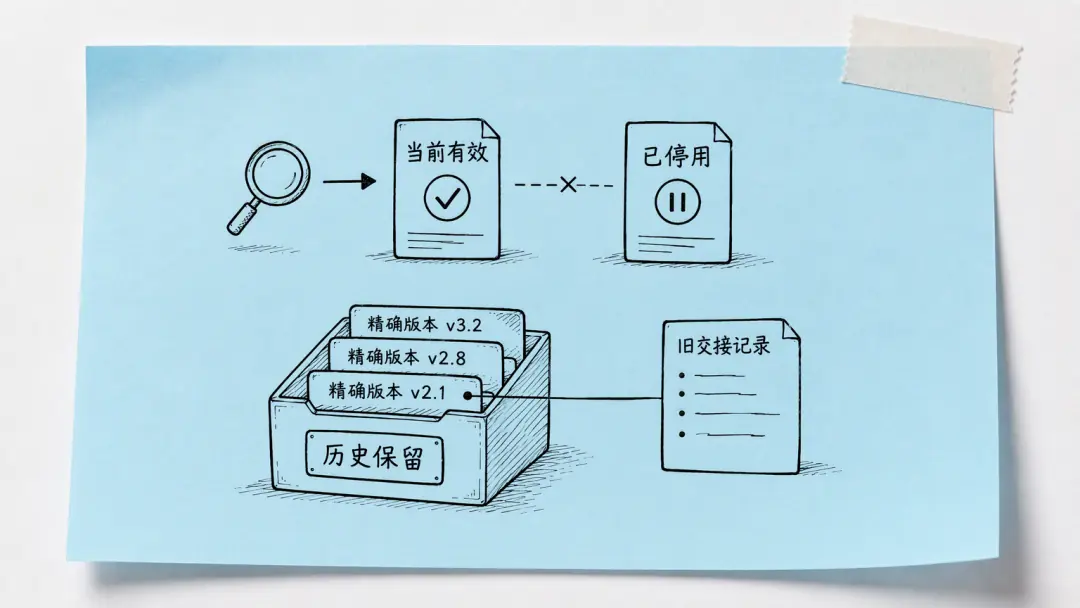
Memory 用 entry_id 标识条目,用 entry_version_id 标识内容版本。更新产生新版本;停用将条目标记为 inactive ,保留历史内容。查询面向当前版本,搜索索引只包含启用条目,过期规则因此可以退出日常召回。
历史交接里的引用仍指向当时的精确版本。回读时,服务检查条目身份、版本和内容哈希,防止旧引用被替换成新内容;重建索引时还会复用未变条目的向量,仅对需要更新的部分计算 Embedding。
相比可覆盖的笔记接口,这套条目、版本和状态机制更适合长期项目:当前召回使用有效知识,历史复盘保留当时依据。
留给后来者
在《As We May Think》 [13] 中,Bush 谈到过一种知识传承:前人留给后来者的,除了已有成果,还有通向成果的关联路径。
模型会不断更新。一次排查为何中止、一个方案为何被放弃、某条规则何时失效,这些判断却是具体项目一点点积累出来的。
它们需要能被接手、核验和修订,才能在下一次工作里继续发挥作用。
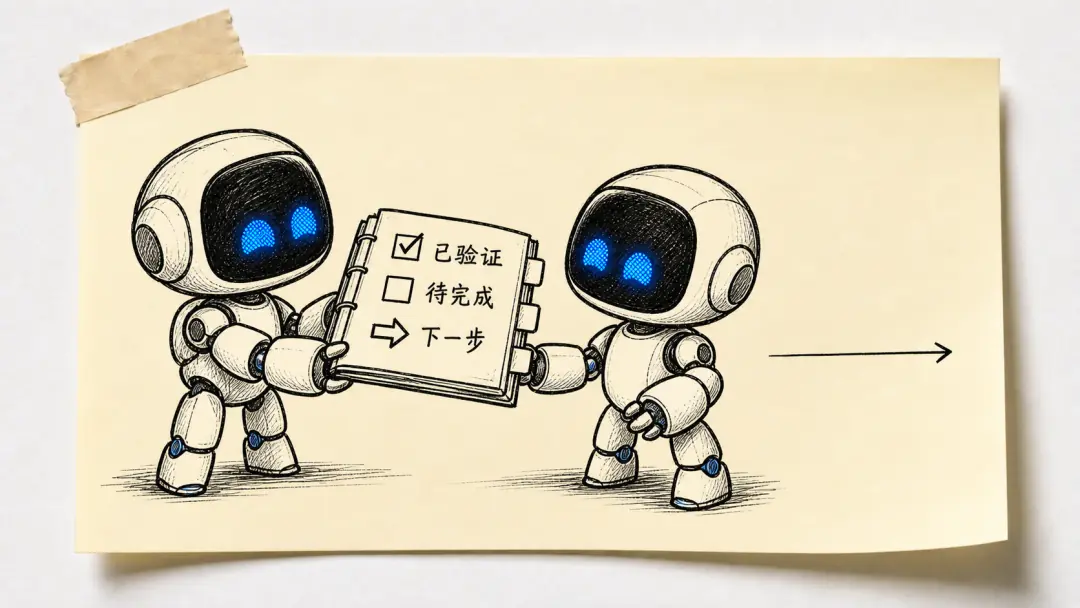
更换 Agent 时,除了比较模型能力,我们可能也需要清点一下:这个项目积累的经验,究竟有多少能够随我们一同迁移。
参考资料
1
《As We May Think》: www.theatlantic.com/magazine/ar...
2
《不用担心爆上下文了,Astra 新技术,"几乎"无限上下文》: linux.do/t/topic/285...
3
Codex 的官方说明: learn.chatgpt.com/docs/models...
4
ChatGPT 官方文档: learn.chatgpt.com/docs/models...
5
PowerContext: github.com/oceanbase/p...
6
交接版本校验代码: github.com/oceanbase/p...
7
交接接收条件与回执定义代码: github.com/oceanbase/p...
8
Phoenix Trace 接入文档: github.com/oceanbase/p...
9
上下文装配追踪代码: github.com/oceanbase/p...
10
Trace 导出代码: github.com/openai/code...
11
上下文请求与字节预算定义代码: github.com/oceanbase/p...
12
上下文筛选与预算控制代码: github.com/oceanbase/p...
13
《As We May Think》: www.theatlantic.com/magazine/ar...
往期内容推荐
微信扫一扫赞赏作者
PowerContext · 目录
作者提示: 个人观点,仅供参考
阅读原文