目录
前言
学习赵老师讲授的强化学习的数学原理视频,本篇文章记录第八讲 Part 5:值函数近似(Sarsa 和 Q-learning),记录个人学习笔记,和大家一起分享交流😄
1. Outline
刚刚我们介绍了第二节,这一节内容说实话比较多,如果大家看幻灯片页数就会发现本讲内容已经过半,虽然我们只介绍了一节,这一节我们介绍了 value function approximation 的目标函数、算法、思想 等,并给出了较多例子,相信大家现在已经有比较好的理解了,下面我们就来介绍 3、4、5 节。
这三节讲算法,第二节主要讲思想,第二节做的是估计给定策略的 state value ,而 Sarsa 这一部分要估计 action value ,Q-learning 和 Deep Q-learning 则要估计 optimal action value。
2. Sarsa with function approximation
下面看 Sarsa 和 value function approximation 结合 后怎么做,话不多说,直接上算法:
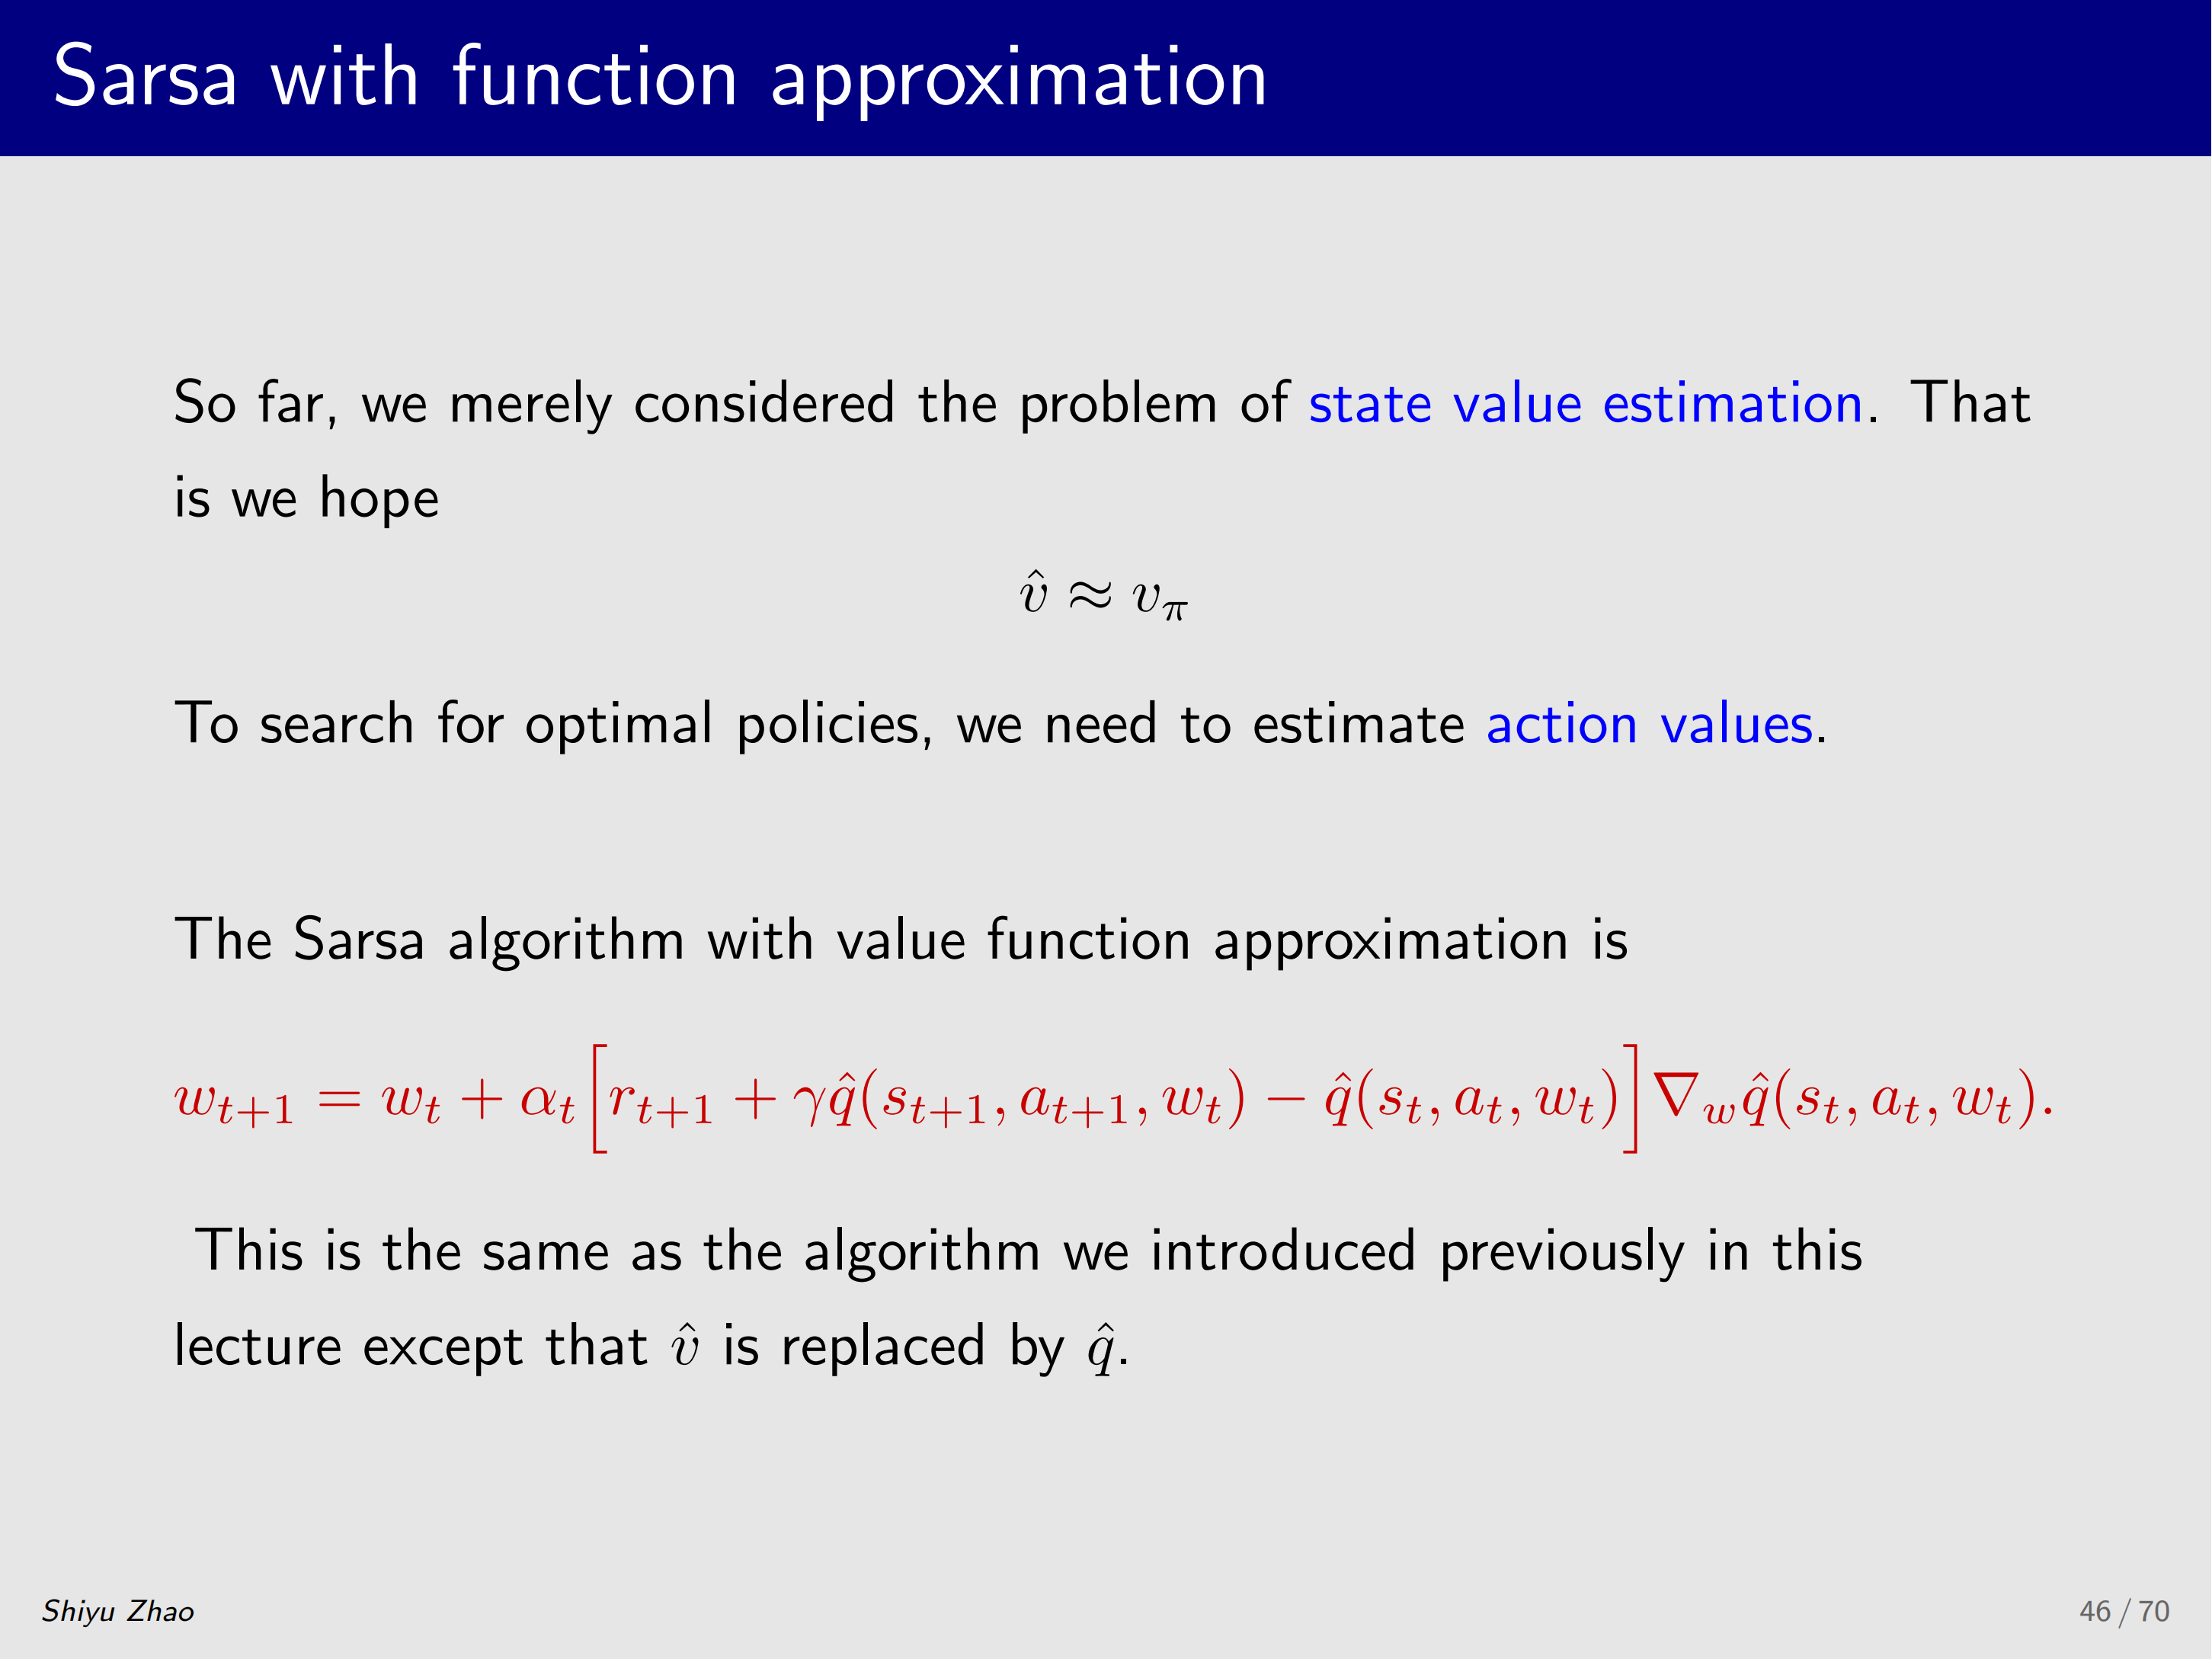
w t + 1 = w t + α t r t + 1 + γ q \^ ( s t + 1 , a t + 1 , w t ) − q \^ ( s t , a t , w t ) ∇ w q ^ ( s t , a t , w t ) . \textcolor{red}{w_{t+1} = w_t + \alpha_t \left r_{t+1} + \\gamma \\hat{q}(s_{t+1}, a_{t+1}, w_t) - \\hat{q}(s_t, a_t, w_t) \\right \nabla_w \hat{q}(s_t, a_t, w_t).} wt+1=wt+αtrt+1+γq\^(st+1,at+1,wt)−q\^(st,at,wt)∇wq^(st,at,wt).
这就是 Sarsa 和 value function approximation 结合的算法,与刚才的 TD 算法一样,只是把 v v v 换成了 q q q ,刚才是 v ^ ( s t ) \hat{v}(s_t) v^(st) 现在换成了 q ^ ( s t , a t , w t ) \hat{q}(s_t,a_t,w_t) q^(st,at,wt) ,至于这个算法为什么设计成这样、它在做什么,这里就不再介绍了,因为第二节已经非常详细地介绍过了。
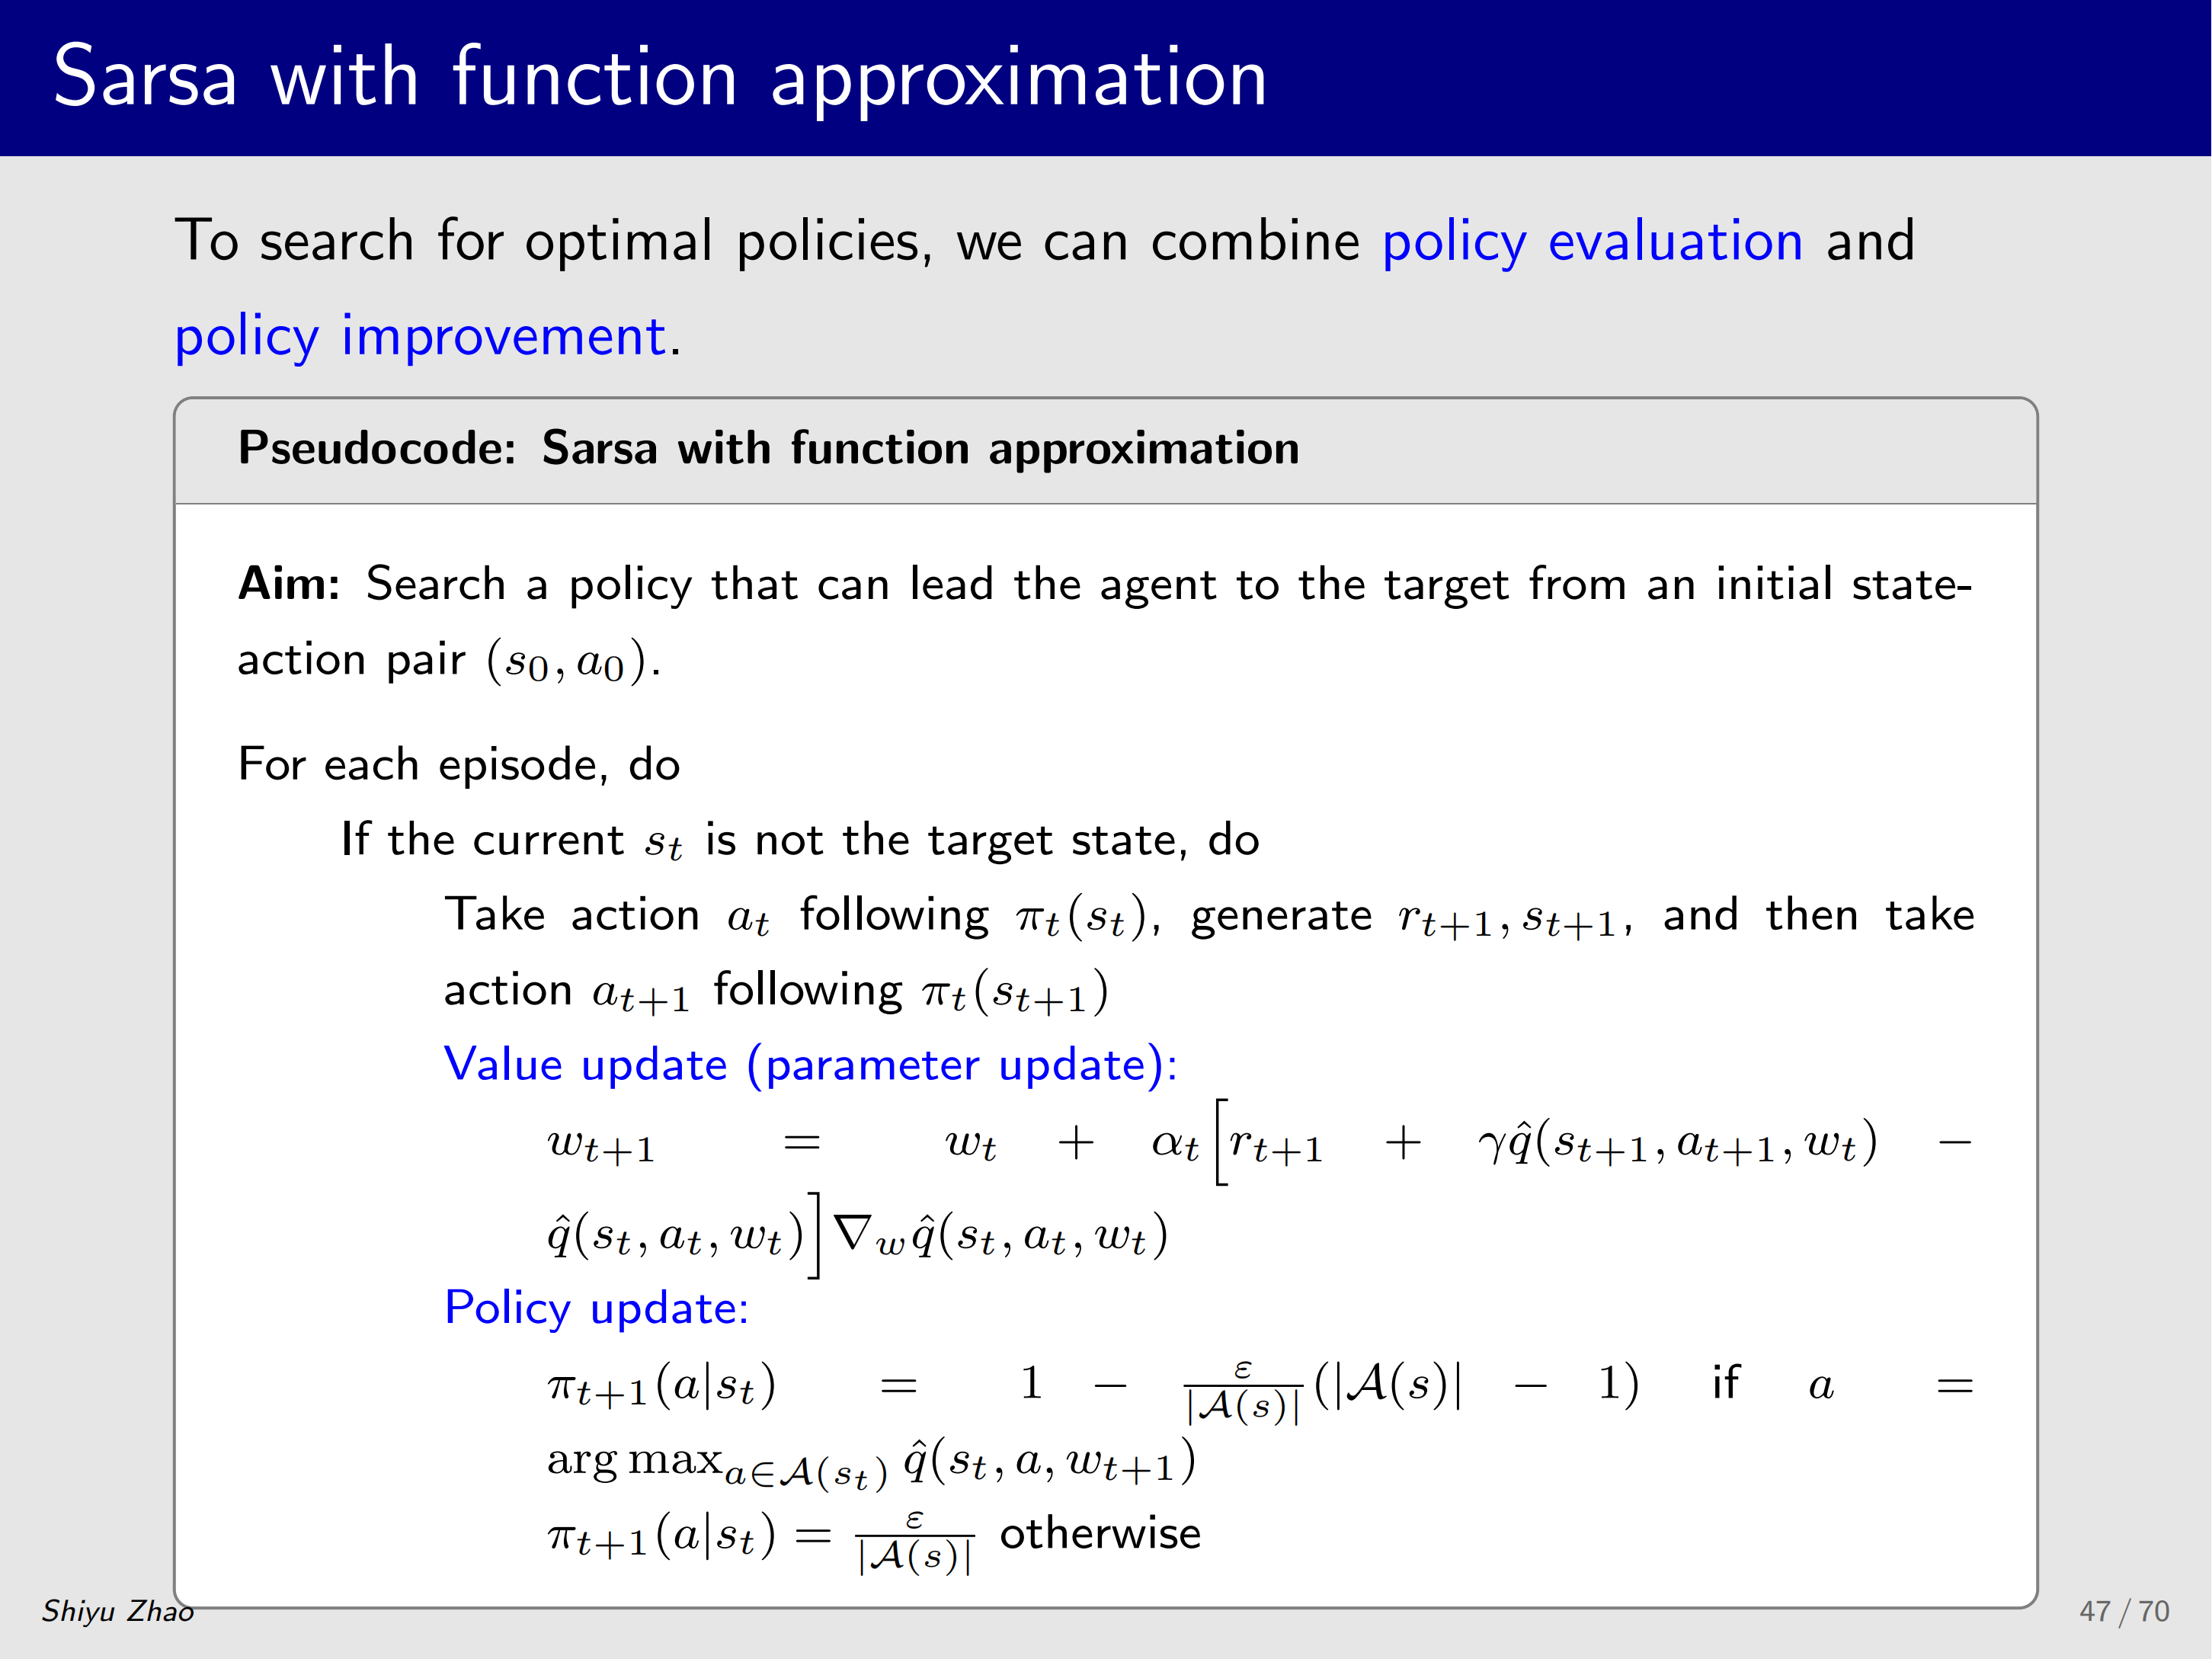
下面给出它的 pseudocode,这里值得指出的是:刚才那个算法实际上仍是在做 policy evaluation ,也就是:给定一个策略 π \pi π ,能够估计出它的 action value,下面我们会把它与 policy improvement 结合,这样就能够去搜索最优的策略。
伪代码:带函数逼近的 Sarsa
目标 :搜索一种策略,使代理能够从初始状态-动作对 ( s 0 , a 0 ) (s_0, a_0) (s0,a0) 到达目标。
对于每一个回合(episode),执行
如果当前 s t s_t st 不是目标状态,执行
按照 π t ( s t ) \pi_t(s_t) πt(st) 采取动作 a t a_t at,生成 r t + 1 , s t + 1 r_{t+1}, s_{t+1} rt+1,st+1,然后按照 π t ( s t + 1 ) \pi_t(s_{t+1}) πt(st+1) 采取动作 a t + 1 a_{t+1} at+1。
值更新(参数更新):
w t + 1 = w t + α t r t + 1 + γ q \^ ( s t + 1 , a t + 1 , w t ) − q \^ ( s t , a t , w t ) ∇ w q ^ ( s t , a t , w t ) w_{t+1} = w_t + \alpha_t \left r_{t+1} + \\gamma \\hat{q}(s_{t+1}, a_{t+1}, w_t) - \\hat{q}(s_t, a_t, w_t) \\right \nabla_w \hat{q}(s_t, a_t, w_t) wt+1=wt+αtrt+1+γq\^(st+1,at+1,wt)−q\^(st,at,wt)∇wq^(st,at,wt)
策略更新:
π t + 1 ( a ∣ s t ) = 1 − ϵ ∣ A ( s ) ∣ ( ∣ A ( s ) ∣ − 1 ) if a = arg max a ∈ A ( s t ) q ^ ( s t , a , w t + 1 ) π t + 1 ( a ∣ s t ) = ϵ ∣ A ( s ) ∣ otherwise \begin{align*} \pi_{t+1}(a|s_t) &= 1 - \frac{\epsilon}{|\mathcal{A}(s)|}(|\mathcal{A}(s)| - 1) \quad \text{if} \quad a = \arg\max_{a \in \mathcal{A}(s_t)} \hat{q}(s_t, a, w_{t+1}) \\10pt \pi_{t+1}(a|s_t) &= \frac{\epsilon}{|\mathcal{A}(s)|} \quad \text{otherwise} \end{align*} πt+1(a∣st)πt+1(a∣st)=1−∣A(s)∣ϵ(∣A(s)∣−1)ifa=arga∈A(st)maxq^(st,a,wt+1)=∣A(s)∣ϵotherwise
先看 pseudocode,首先,对每一个 episode:如果当前状态 s t s_t st 不是 target state,则执行以下步骤,这个任务对应的是: 从一个状态出发,找到一条到达目标状态的好路径,所以第一步是要生成数据。
在 s t s_t st 处根据策略执行 action a t a_t at ,与环境交互得到 r t + 1 , s t + 1 r_{t+1},s_{t+1} rt+1,st+1 ,之后在 s t + 1 s_{t+1} st+1 处再根据该状态的策略采样得到 a t + 1 a_{t+1} at+1 ,然后根据这些数据做 value update,也就是我们刚才所给出的算法。
注意这里我们 并不是直接指定 q ^ ( s t , a t ) \hat{q}(s_t,a_t) q^(st,at) 的新值,而是更新它的参数 w w w---这是与 tabular Sarsa 的唯一区别 。有了新参数之后就可以做 policy update,这个和之前的 tabular 的 Sarsa 是一模一样的,也就是说:在 s t s_t st 选择 q value 最大的那个 action,并给它较大的概率,其它 action 给较小的概率(这里的策略是 ε \varepsilon ε-Greedy),值得注意的是,在 tabular 情况下,直接索引即可得到 q 值;现在需要把 s s s 和对应的 a a a 代入函数算出函数值再比较。
我们来看一个例子,这个例子是把 Sarsa 和 linear function approximation 结合 ,也就是 q ^ = ϕ T w \hat{q} = \phi^T w q^=ϕTw ,具体内容可以参考教材,仿真参数如下:
γ = 0.9 , ε = 0.1 , r boundary = r forbidden = − 10 , r target = 1 , α = 0.001. \gamma = 0.9, \, \varepsilon=0.1, \, r_{\text{boundary}}=r_{\text{forbidden}}=-10, \, r_{\text{target}}=1, \, \alpha=0.001. γ=0.9,ε=0.1,rboundary=rforbidden=−10,rtarget=1,α=0.001.
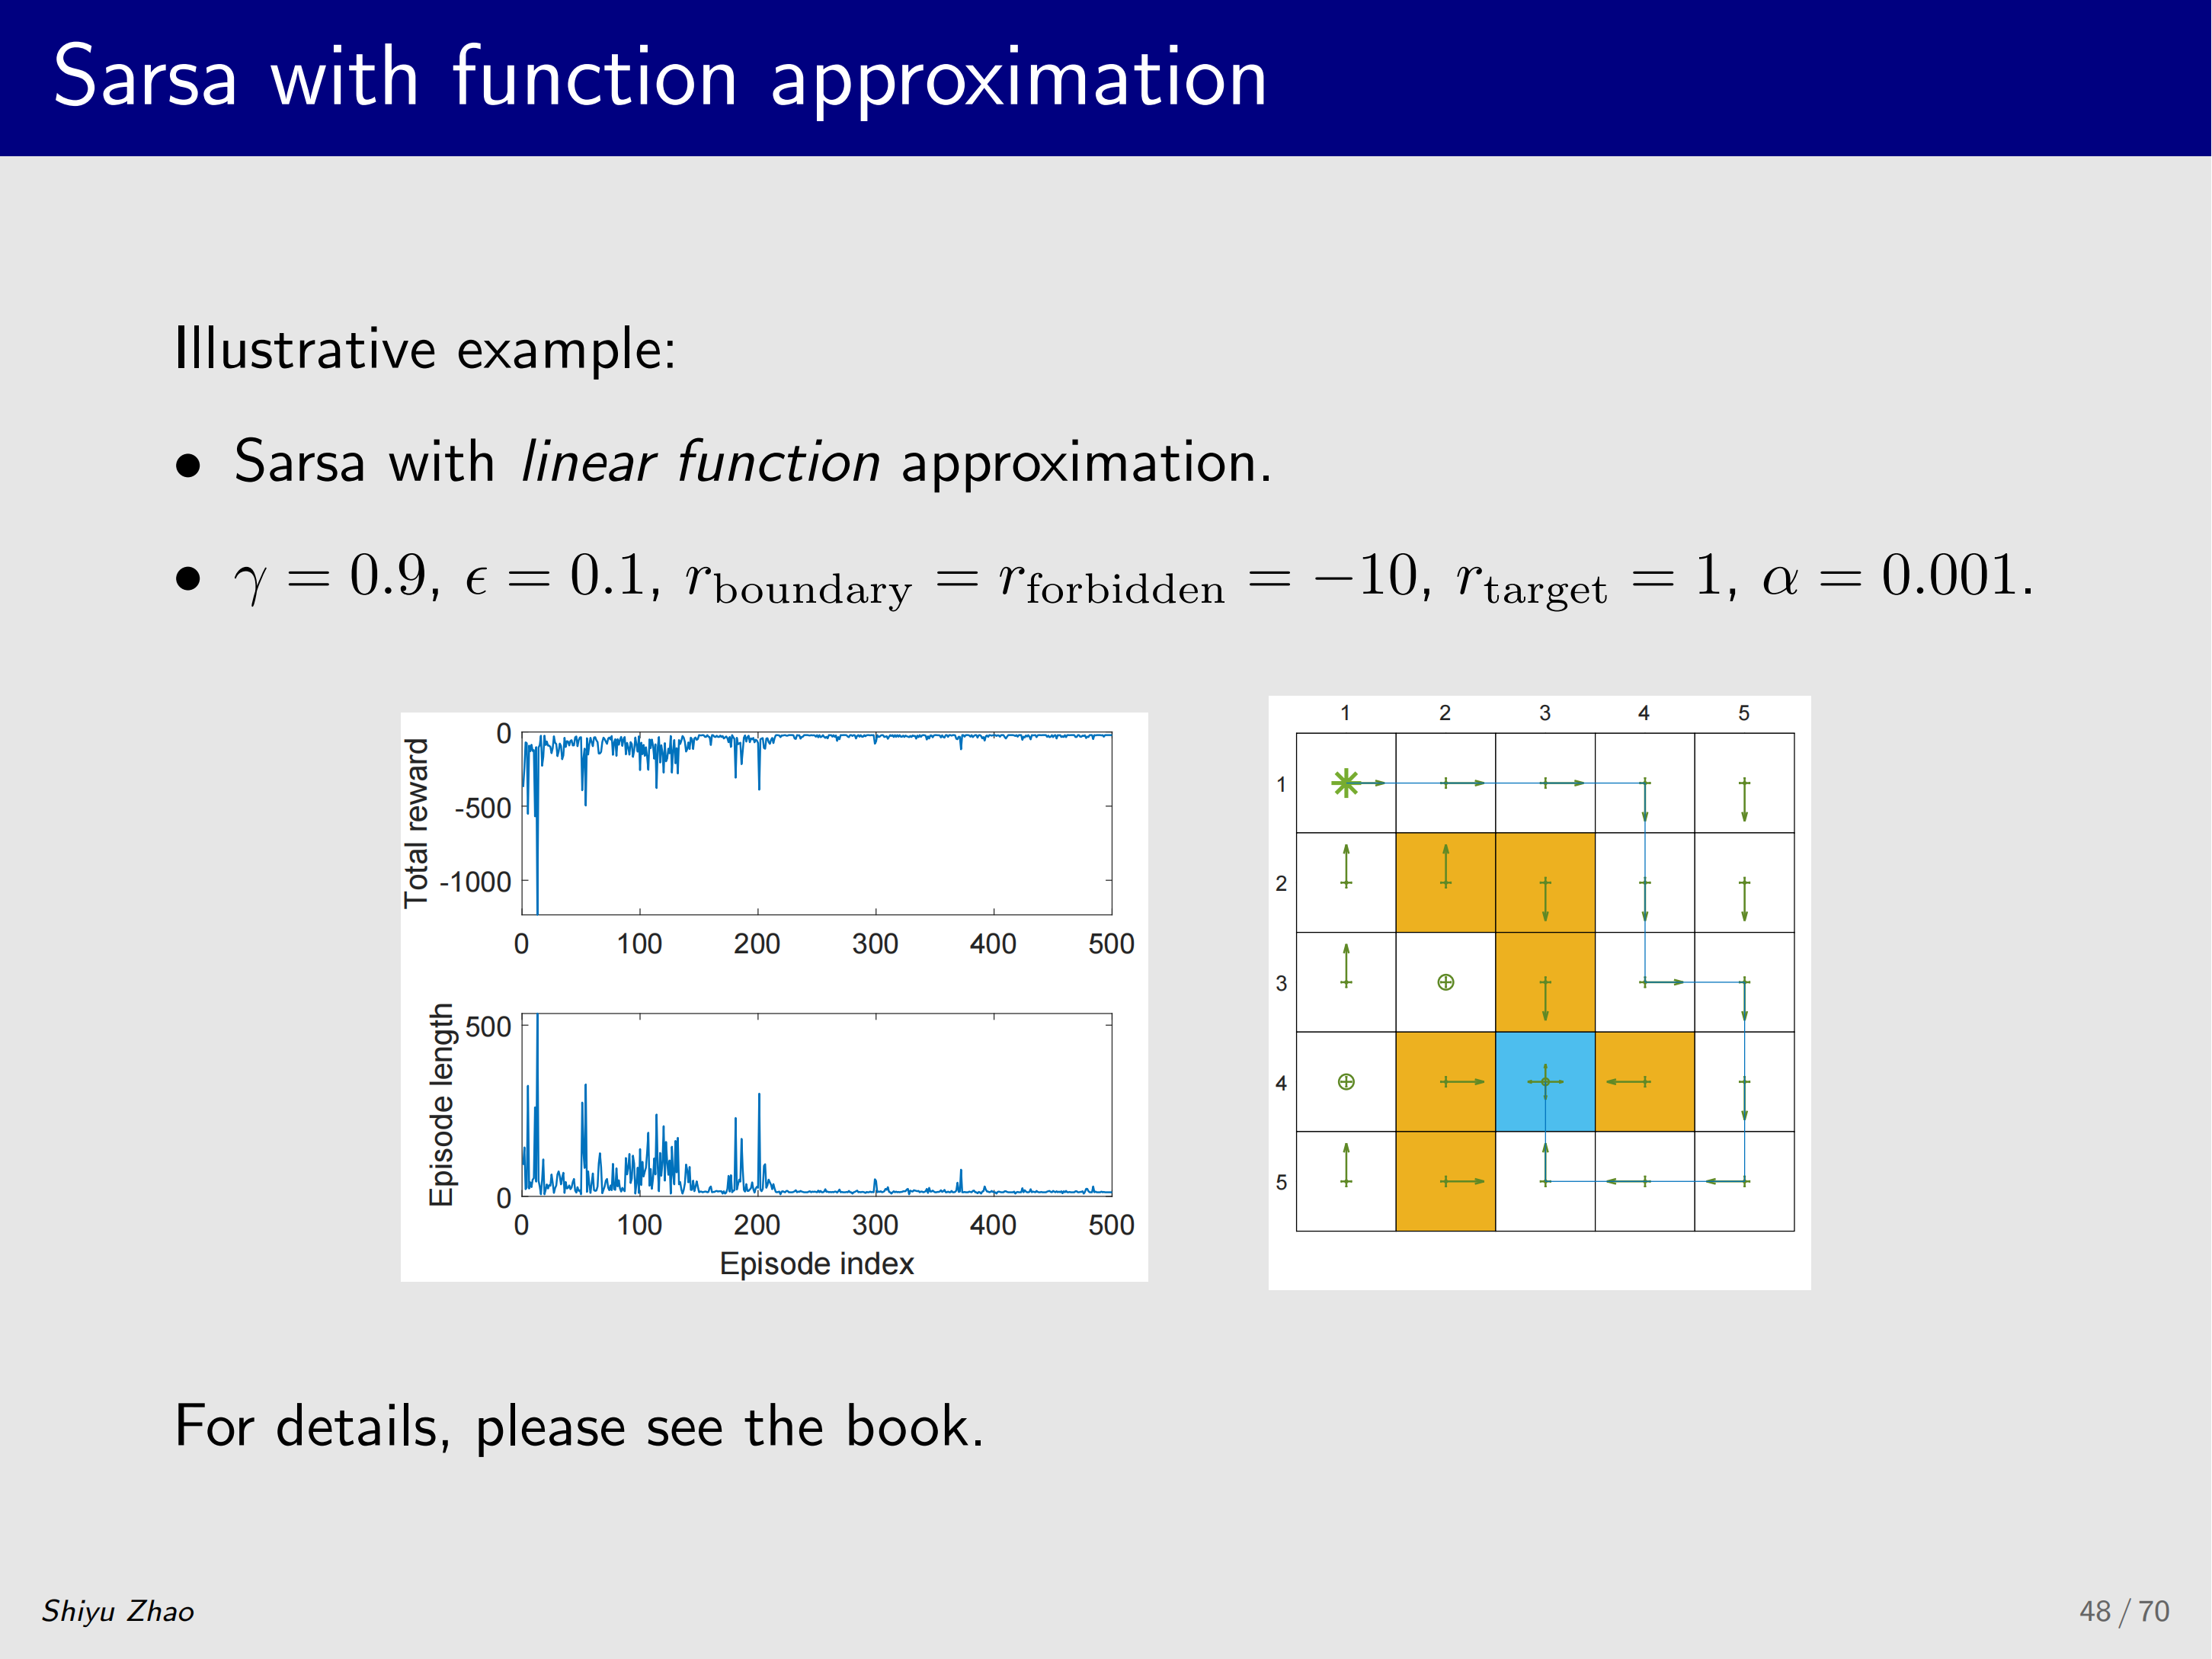
仿真的结果如图所示,正如我们刚才所说的,这里的任务是从一个状态出发到达目标状态,大家可以看到:最后如果沿着概率较大的方向,确实能到达目标状态。其它一些状态的策略不是很好也没关系,因为我们的目的不是找到所有状态(或 action)的最优策略。
左图可以看到收敛过程:最开始 reward 较负,之后逐渐增大;episode 长度一开始也较长,因为策略不好,所以可能要走很多弯路,最后逐渐缩短并收敛。
刚刚我们介绍了 Sarsa 与 value function approximation 结合,大家可能注意到,这部分篇幅很短,只有几页幻灯片,为什么呢?因为前面已经打下了非常好的基础,所以这里不需要介绍太多。
3. Q-learning with function approximation
下面介绍 Q-learning 和 function approximation 结合 ,同样非常快,最后我们会重点介绍 Deep Q-learning。
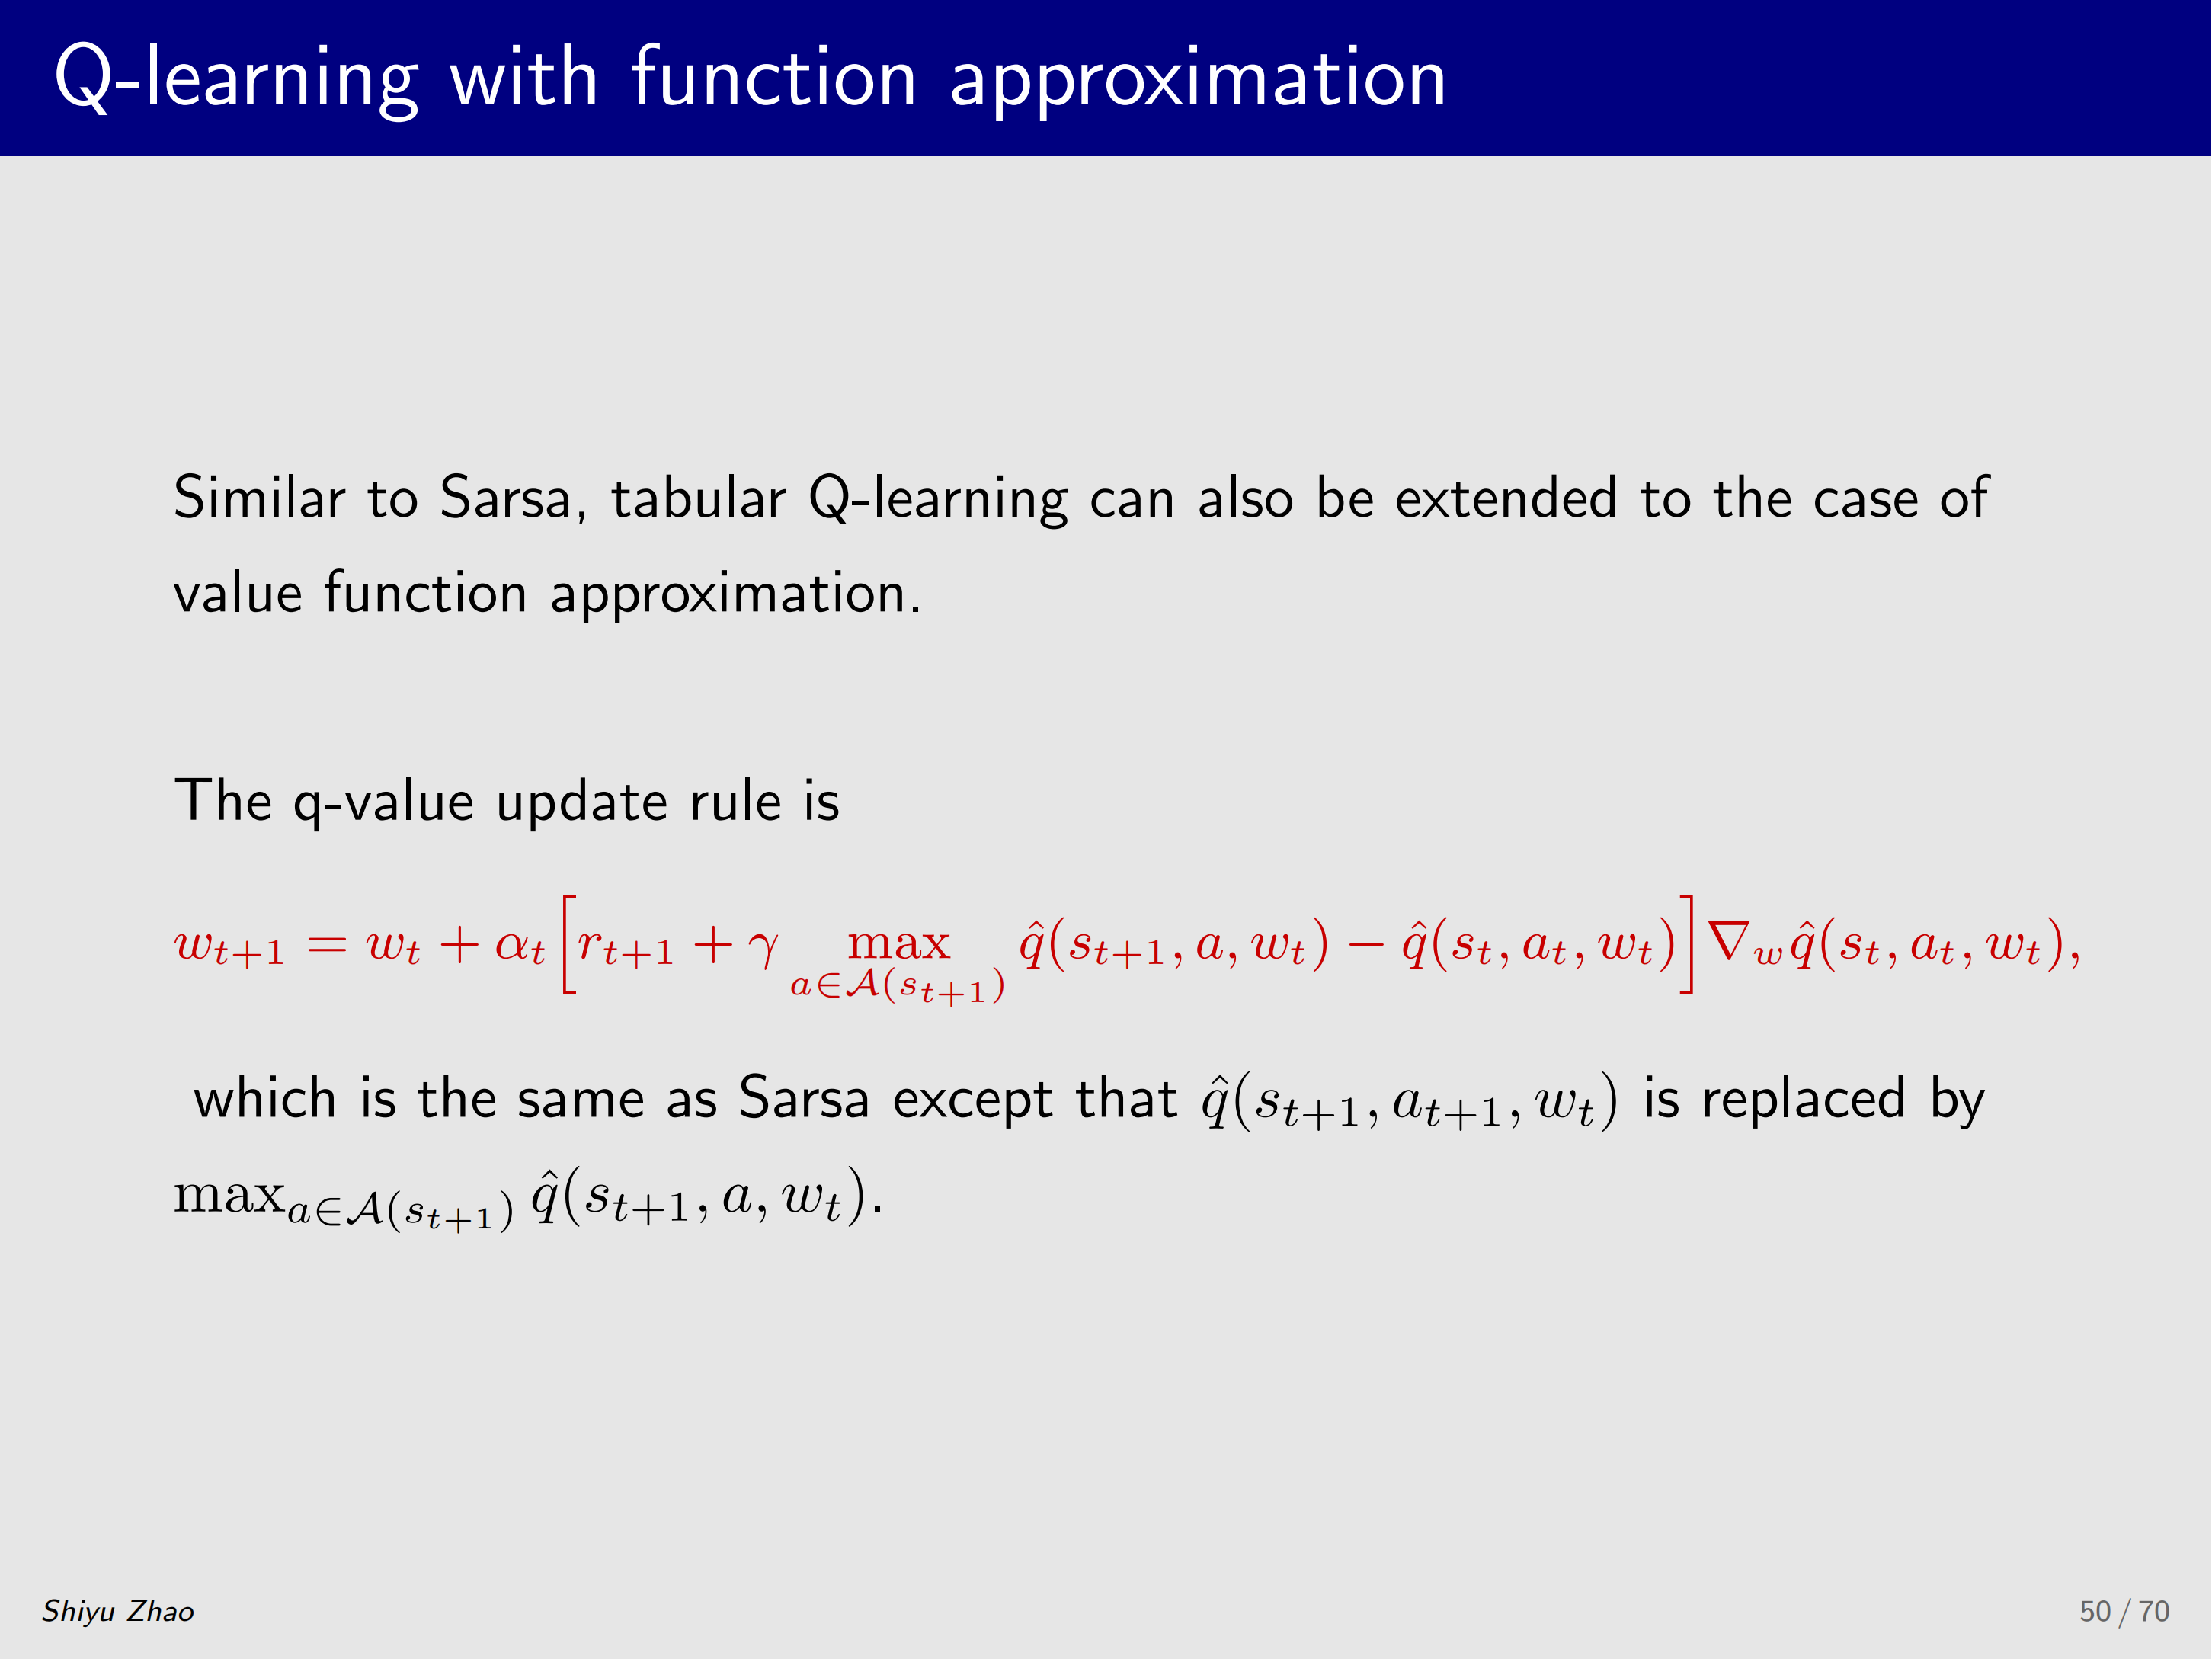
w t + 1 = w t + α t r t + 1 + γ max a ∈ A ( s t + 1 ) q \^ ( s t + 1 , a , w t ) − q \^ ( s t , a t , w t ) ∇ w q ^ ( s t , a t , w t ) , \textcolor{red}{w_{t+1} = w_t + \alpha_t \left r_{t+1} + \\gamma \\max_{a \\in \\mathcal{A}(s_{t+1})} \\hat{q}(s_{t+1}, a, w_t) - \\hat{q}(s_t, a_t, w_t) \\right \nabla_w \hat{q}(s_t, a_t, w_t),} wt+1=wt+αtrt+1+γa∈A(st+1)maxq\^(st+1,a,wt)−q\^(st,at,wt)∇wq^(st,at,wt),
同样直接上算法。上式就是 Q-learning 与 value function approximation 结合 的算法,与刚才 Sarsa 非常类似,唯一的区别是:Sarsa 用的是采样 a t + 1 a_{t+1} at+1(即 q ^ ( s t + 1 , a t + 1 , w t ) \hat{q}(s_{t+1}, a_{t+1}, w_t) q^(st+1,at+1,wt)),而这里 对 a a a 取最大化(即 max a q ^ ( s t + 1 , a , w t ) \max_a \hat{q}(s_{t+1}, a, w_t) maxaq^(st+1,a,wt))。熟悉 tabular Q-learning 的同学都知道,这实际上就是它的 TD target。
下面给出 Q-learning 的 pseudocode,这里值得指出的是:下面先给出一个 on-policy 版本 ,之后在介绍 Deep Q-learning 时,我们会特意给一个 off-policy 的版本,Q-learning 两种都可以,既可以 on-policy 也可以 off-policy,把两个版本分开介绍,大家就能明白 on-policy 和 off-policy 分别该怎么实现。
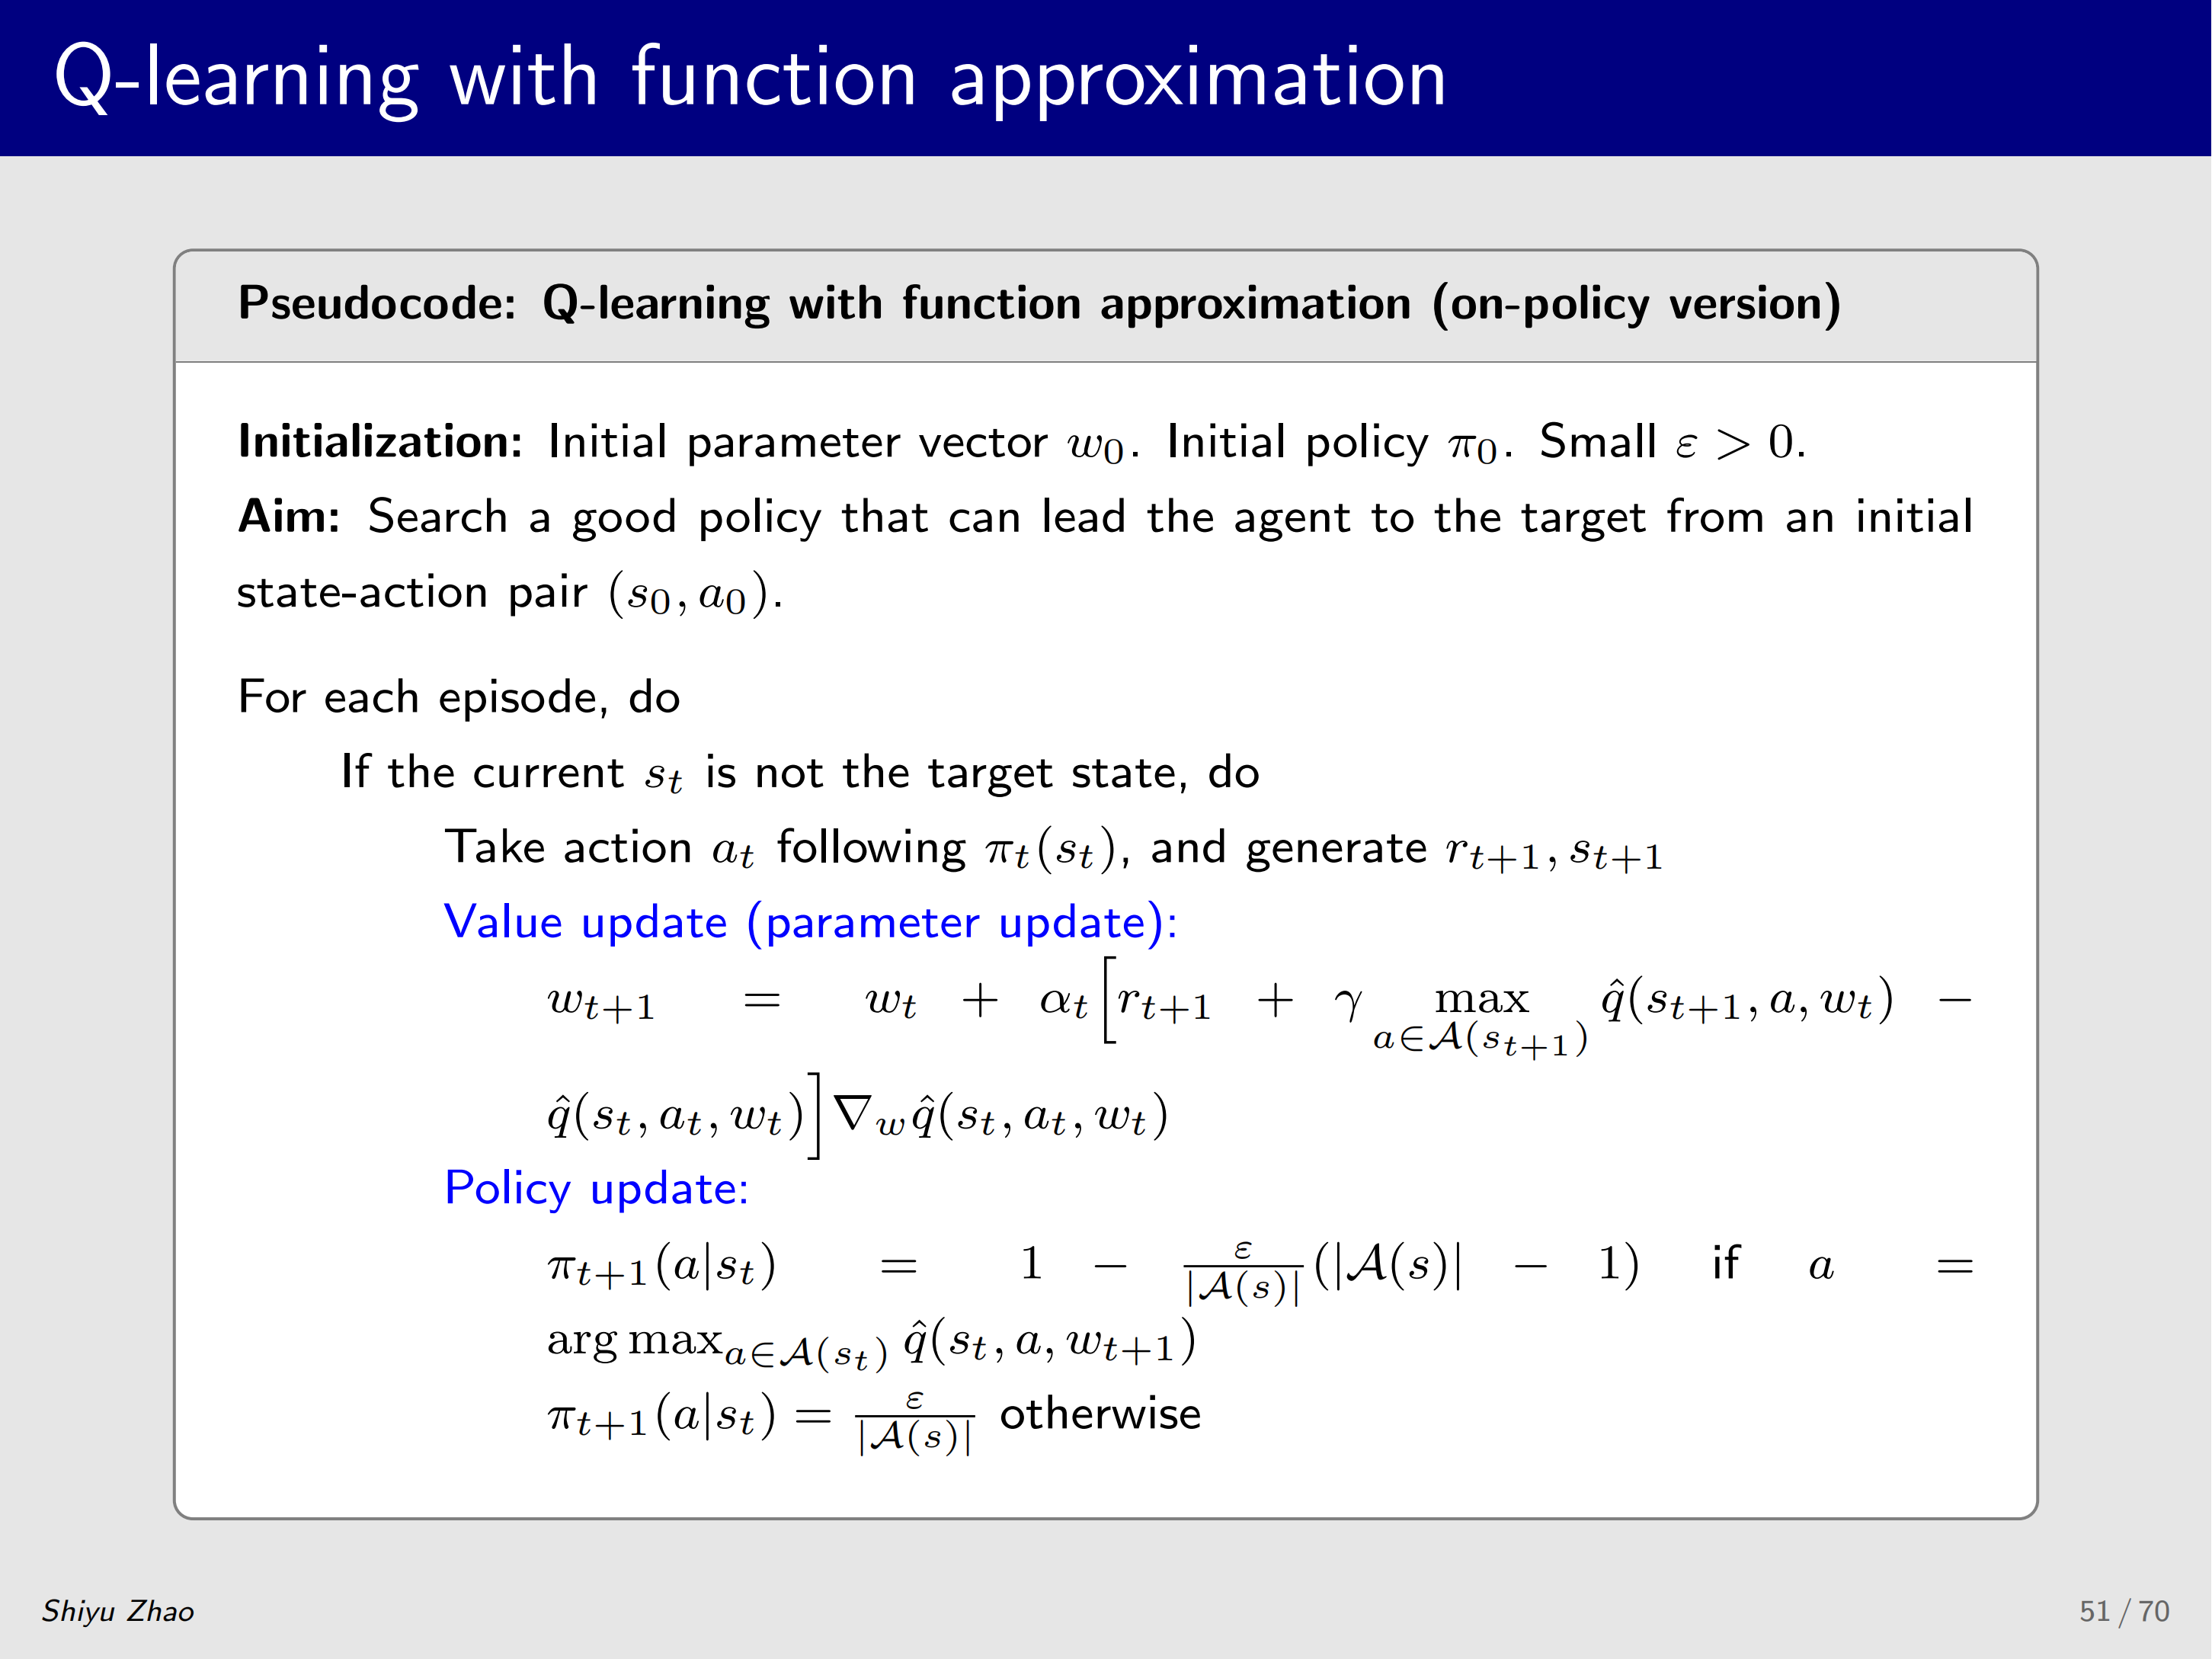
伪代码:带函数逼近的 Q-learning(同策略版本)
初始化 :初始参数向量 w 0 w_0 w0。初始策略 π 0 \pi_0 π0。小的 ϵ > 0 \epsilon > 0 ϵ>0。
目标 :搜索一个好的策略,使其能够引导智能体从初始状态-动作对 ( s 0 , a 0 ) (s_0, a_0) (s0,a0) 到达目标。
对于每一个回合(episode),执行
如果当前 s t s_t st 不是目标状态,执行
根据 π t ( s t ) \pi_t(s_t) πt(st) 采取动作 a t a_t at,并生成 r t + 1 , s t + 1 r_{t+1}, s_{t+1} rt+1,st+1
值更新(参数更新):
w t + 1 = w t + α t r t + 1 + γ max a ∈ A ( s t + 1 ) q \^ ( s t + 1 , a , w t ) − q \^ ( s t , a t , w t ) ∇ w q ^ ( s t , a t , w t ) w_{t+1} = w_t + \alpha_t \left r_{t+1} + \\gamma \\max_{a \\in \\mathcal{A}(s_{t+1})} \\hat{q}(s_{t+1}, a, w_t) - \\hat{q}(s_t, a_t, w_t) \\right \nabla_w \hat{q}(s_t, a_t, w_t) wt+1=wt+αtrt+1+γa∈A(st+1)maxq\^(st+1,a,wt)−q\^(st,at,wt)∇wq^(st,at,wt)
策略更新:
π t + 1 ( a ∣ s t ) = 1 − ϵ ∣ A ( s ) ∣ ( ∣ A ( s ) ∣ − 1 ) if a = arg max a ∈ A ( s t ) q ^ ( s t , a , w t + 1 ) π t + 1 ( a ∣ s t ) = ϵ ∣ A ( s ) ∣ otherwise \begin{align*} \pi_{t+1}(a|s_t) &= 1 - \frac{\epsilon}{|\mathcal{A}(s)|}(|\mathcal{A}(s)| - 1) \quad \text{if} \quad a = \arg\max_{a \in \mathcal{A}(s_t)} \hat{q}(s_t, a, w_{t+1}) \\10pt \pi_{t+1}(a|s_t) &= \frac{\epsilon}{|\mathcal{A}(s)|} \quad \text{otherwise} \end{align*} πt+1(a∣st)πt+1(a∣st)=1−∣A(s)∣ϵ(∣A(s)∣−1)ifa=arga∈A(st)maxq^(st,a,wt+1)=∣A(s)∣ϵotherwise
这里考虑的问题是:从一个状态出发找到目标状态。对每个 episode 做下面的事:如果当前状态不是 target state,则执行以下步骤,第一步:搜集 sample,在当前状态 s t s_t st 根据策略 π t \pi_t πt 得到 action a t a_t at ,然后与环境交互,观察 r t + 1 r_{t+1} rt+1 和 s t + 1 s_{t+1} st+1 。
收集完数据之后要做的就是 value update,也就是刚才给出的算法,同样地,这里更新的是它的参数,之后更新策略:在状态 s t s_t st ,把不同的动作 a a a 代入函数计算各自的 q value,哪个 q value 大就给较大的概率,其余 action 给较小的概率,这个策略也是 ε \varepsilon ε-Greedy。
下面来看一个例子:
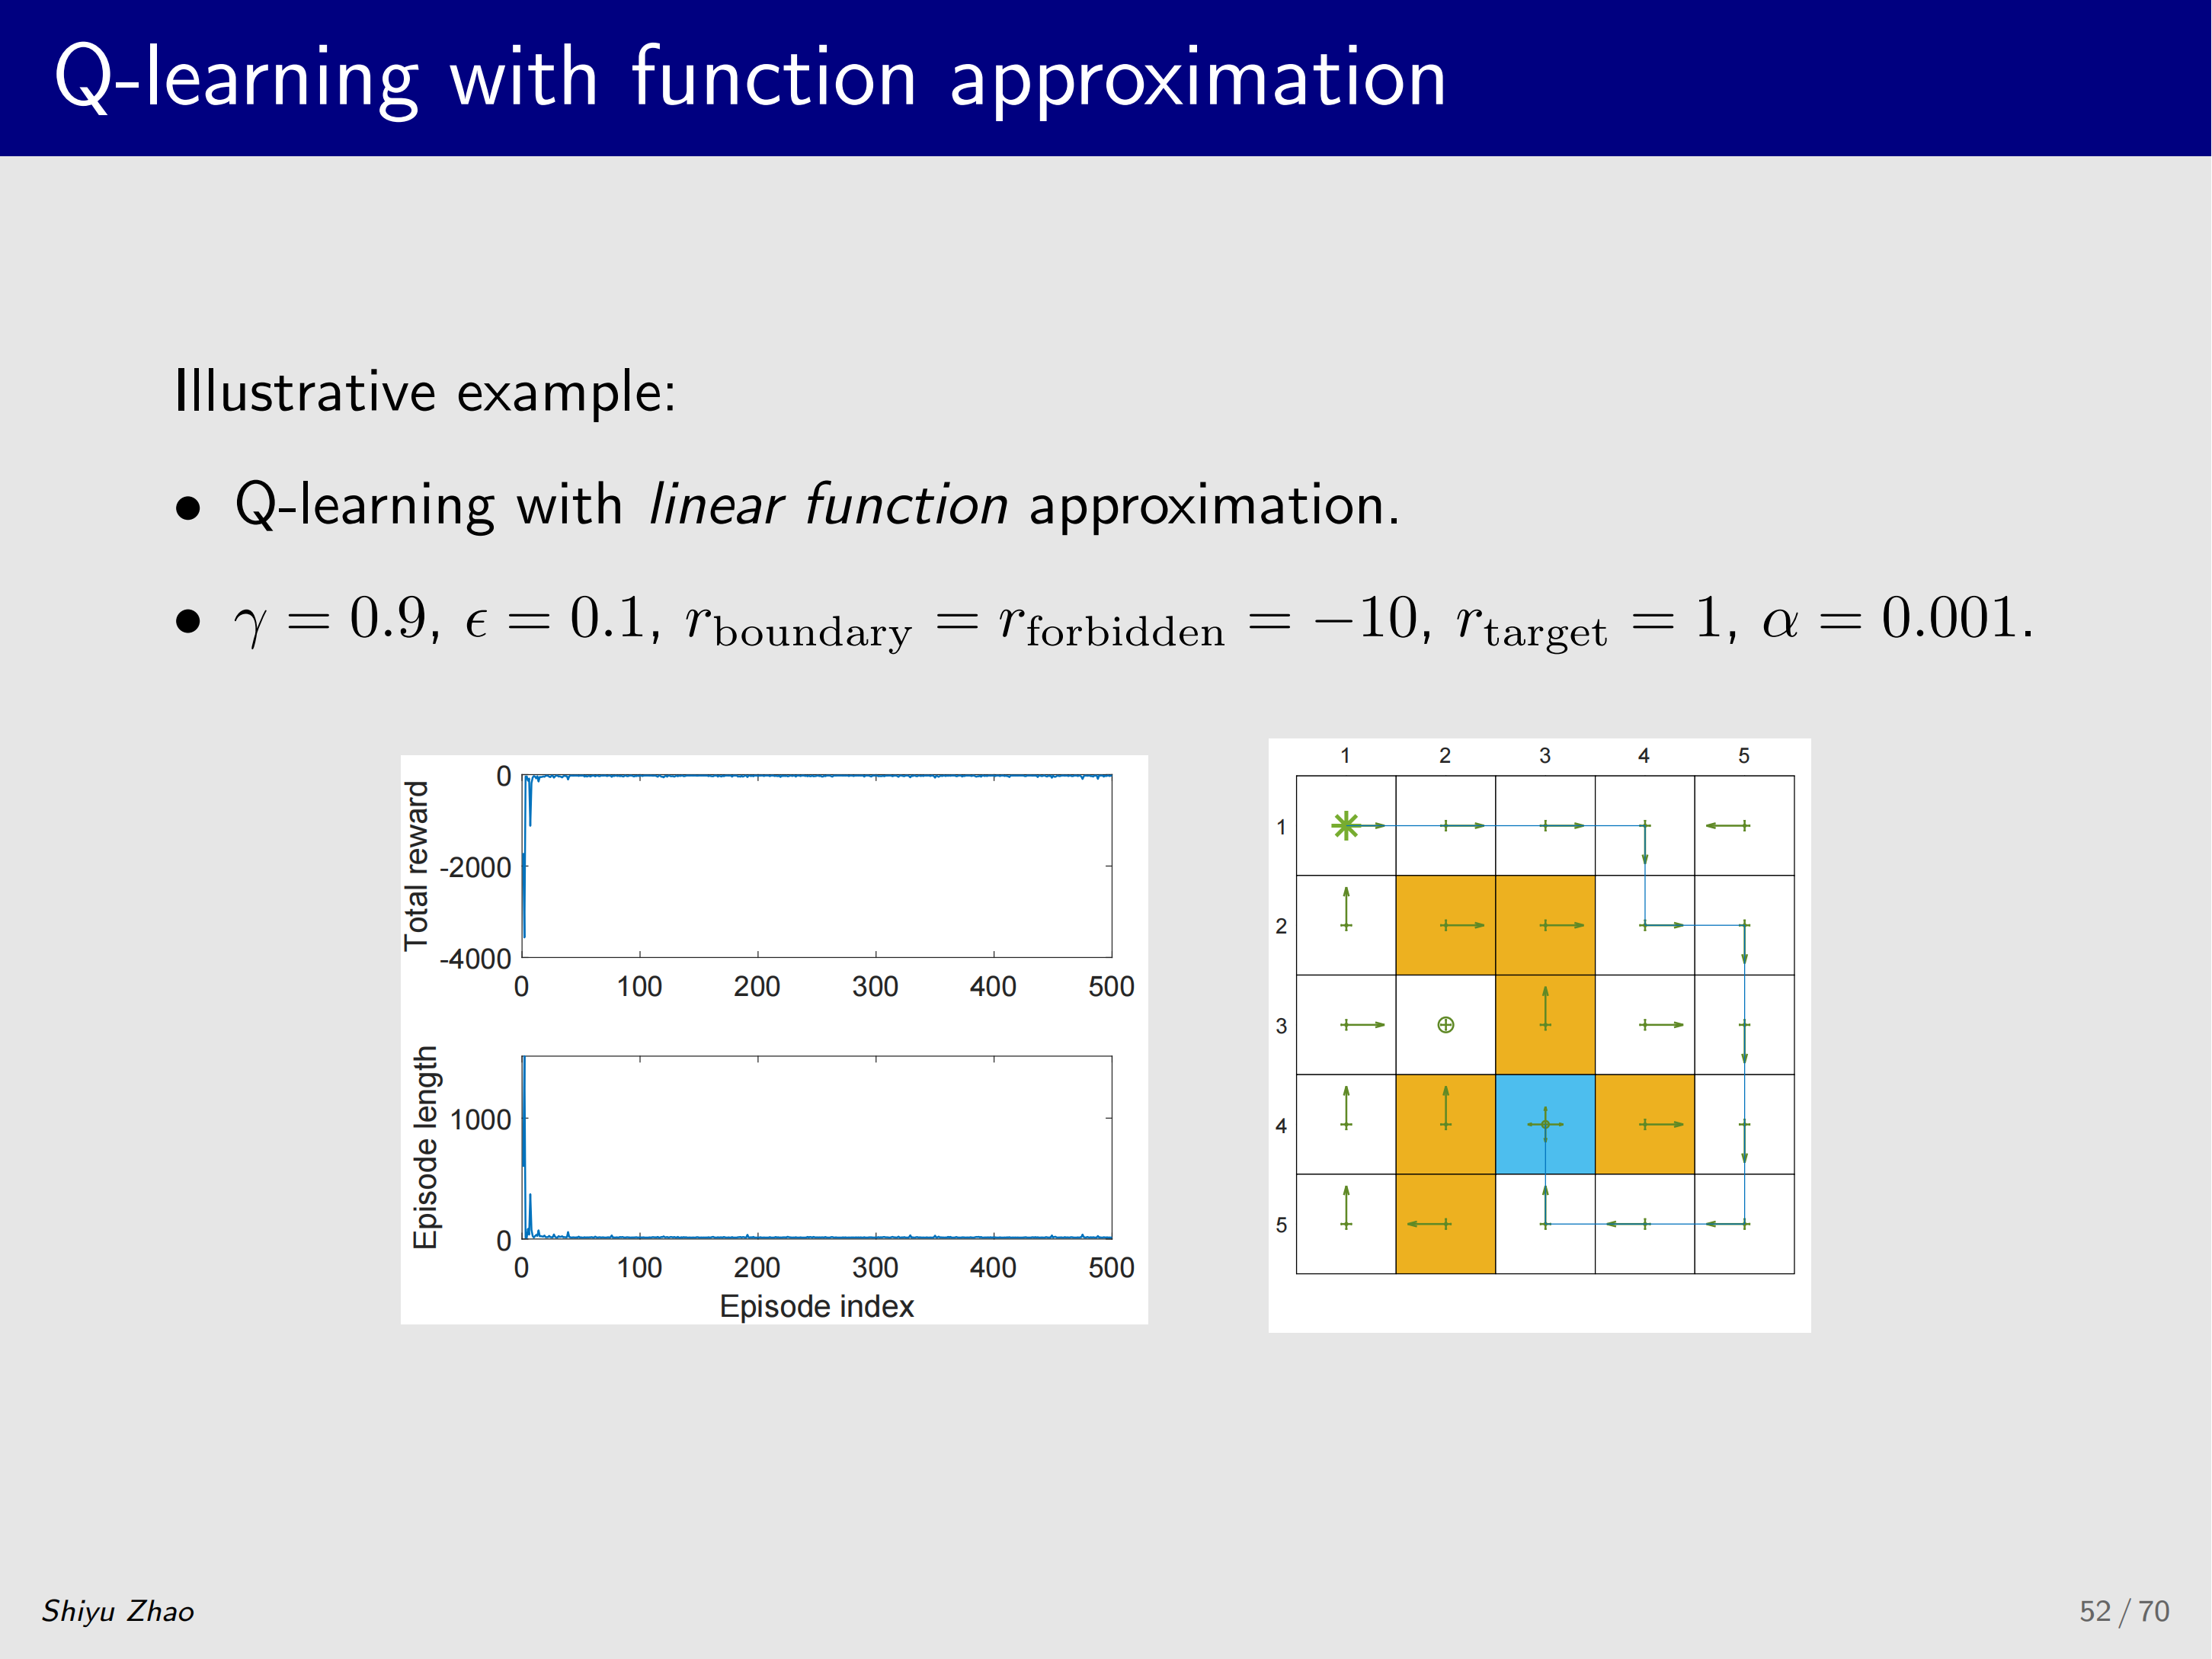
这个例子是 Q-learning 和 linear function approximation 相结合 ,也就是 q ^ = ϕ T w \hat{q}=\phi^Tw q^=ϕTw ,这里的任务是:从 s 1 s_1 s1 出发,找到一条到达目标的较好路径,大家看到最后的策略也是比较好的。左图是收敛过程:最开始 reward 较负,很快收敛到较大的值;episode length 一开始因策略不好而较长,随后很快收敛到较短的、正确的路径。
结语
本讲第五部分将上一讲的 Sarsa 与 Q-learning 自然地推广到函数近似框架,篇幅虽短却水到渠成---这正是前四部分扎实铺垫的回报。两个算法的更新公式与 TD + 函数近似如出一辙,只是将 v ^ \hat{v} v^ 换为 q ^ \hat{q} q^、TD target 分别采用 r t + 1 + γ q ^ ( s t + 1 , a t + 1 , w t ) r_{t+1} + \gamma\hat{q}(s_{t+1},a_{t+1},w_t) rt+1+γq^(st+1,at+1,wt)(Sarsa)与 r t + 1 + γ max a q ^ ( s t + 1 , a , w t ) r_{t+1} + \gamma\max_a\hat{q}(s_{t+1},a,w_t) rt+1+γmaxaq^(st+1,a,wt)(Q-learning)。与 tabular 版本的本质区别在于:更新对象从 "某个格子里的 q 值" 变成了 "整个函数的参数 w w w",策略改进时也不再直接查表,而是将各动作代入函数计算后再比较。
两个线性近似的仿真都顺利完成了 "从起点到达目标" 的任务,reward 曲线回升、episode length 曲线下降,与 tabular 版本的收敛行为一脉相承。这里给出的是 on-policy 版本的 Q-learning;下一部分,我们将引入经验回放与 target network 两大技术,正式迎来 off-policy 版本的 Deep Q-learning---函数近似的旅程将在此达到高潮🤗。