目录
[一、 理解图计算](#一、 理解图计算)
[二、 实现工作流的核心概念](#二、 实现工作流的核心概念)
[3.3.1 State(状态)- 快递的 "包裹信息"](#3.3.1 State(状态)- 快递的 "包裹信息")
[3.3.2 Nodes(节点)- 快递站点](#3.3.2 Nodes(节点)- 快递站点)
[3.3.3 Edges(边)- 快递运输路线](#3.3.3 Edges(边)- 快递运输路线)
[三、LangGraph 入门教程:构建 AI 工作流](#三、LangGraph 入门教程:构建 AI 工作流)
[3.1. 编码前的版本说明](#3.1. 编码前的版本说明)
[3.2.1 Graph API 编码思路](#3.2.1 Graph API 编码思路)
[3.2.2 代码实现](#3.2.2 代码实现)
[步骤 1:定义 State](#步骤 1:定义 State)
[步骤 2:定义 StateGraph 图](#步骤 2:定义 StateGraph 图)
[步骤 3:定义 Nodes(节点)](#步骤 3:定义 Nodes(节点))
[步骤 4:添加 Nodes到图](#步骤 4:添加 Nodes到图)
[步骤 5:添加 Edges(边)](#步骤 5:添加 Edges(边))
[步骤 6:StateGraph 图编译](#步骤 6:StateGraph 图编译)
[3.2.3 完整代码](#3.2.3 完整代码)
一、 理解图计算
如何实现工作流逻辑?图计算是一种用节点和边来表示复杂系统的方法。在 AI 领域,它特别适合构建多步骤、有状态的智能工作流。
想象一个快递配送系统,下图展示了包裹从输入(揽收站)到输出(配送站)的过程:
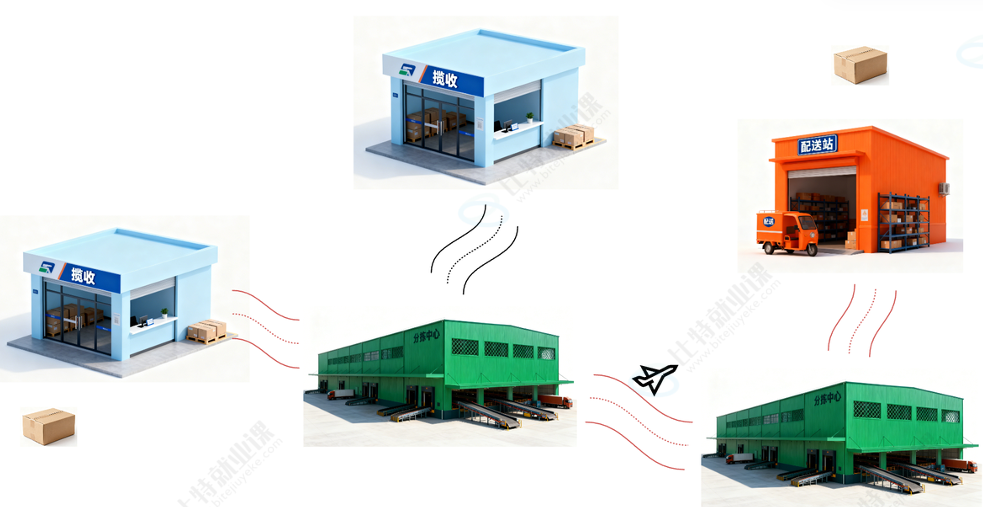
- 配送站、揽收站、分拣中心 = 节点(Node)
- 运输路线 = 边(Edge)
- 包裹信息 = 状态(State)
- 完整配送网 = 图(Graph)
二、 实现工作流的核心概念
3.3.1 State(状态)- 快递的 "包裹信息"
State 就像快递包裹上的标签,记录着包裹的当前位置、目的地、配送状态等信息。在整个配送过程中,所有站点都能查看和更新这个信息。
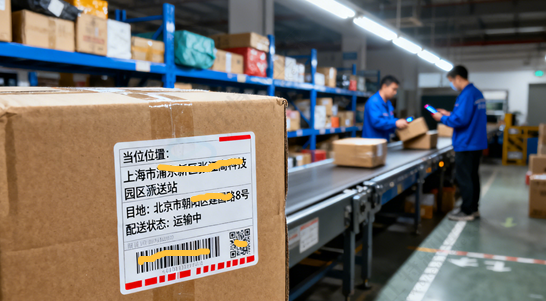
状态特性:
- 共享性:所有节点(快递站点)都能读取和修改
- 持久性:在整个工作流(快递运输)执行期间持续存在
- 结构化:有明确的字段定义
所有配送站点共享的包裹信息卡就是 LangGraph 中的 State!
3.3.2 Nodes(节点)- 快递站点
节点就像快递配送网络中的各个站点,每个站点负责特定的处理步骤。例如:
- 揽收站:接收包裹,初始化信息
- 分拣中心:根据目的地分类包裹
- 派送站:最终配送至收件人
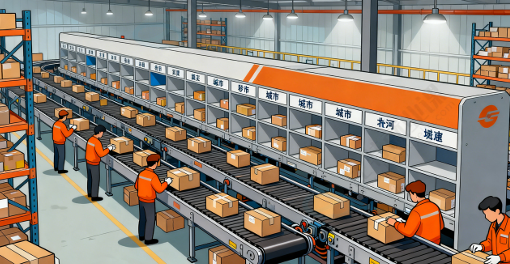
节点特征:
- 单一职责:每个节点只做一件事
- 输入输出:接收状态,返回状态更新
- 独立性:节点间不直接通信,通过 State 交互
3.3.3 Edges(边)- 快递运输路线
边定义了包裹在站点之间的流动路径,就像快递公司的运输路线图。对于路线,一般类型有:
- 开始 / 结束路线:流程的开始和结束点(包裹的开始站,与结束站)
- 固定路线:包裹可以从揽收站→分拣中心(所有包裹都走这条路),而不能从配送站→揽收站,而是配送站→家。
- 条件路线:根据目的地选择不同的分拣中心
实际上在 LangGraph 中,边就定义了节点之间的连接关系,决定了工作流的执行顺序。边的类型有:
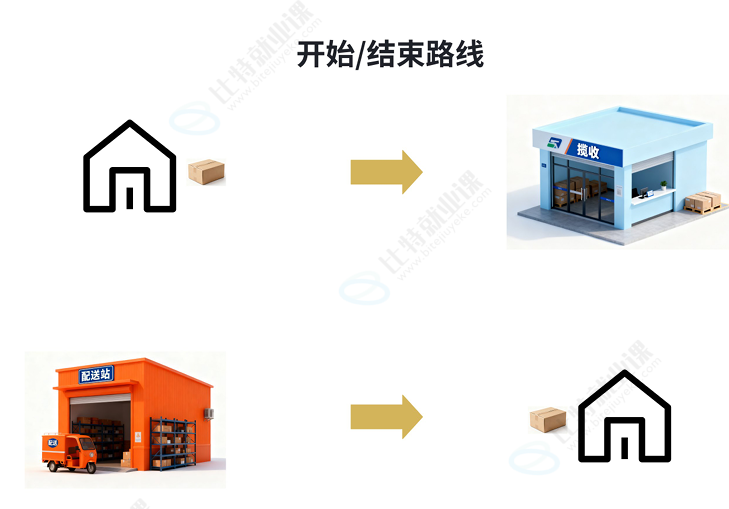
- 固定边:总是从 A 到 B 下一步
- 条件边:根据状态决定下一步
以及图的开始和结束点,标志了工作流的入口和出口。
因此,LangGraph 通过节点(每个处理步骤)、边(步骤之间的连接)和状态(保存执行过程),就可以构建出一个任务工作流(图)。
三、LangGraph 入门教程:构建 AI 工作流
3.1. 编码前的版本说明
LangGraph 放弃了对 Python3.9 的支持,所有 LangChain 包现在都需要 Python3.10 或更高版本。
使用 python --version 查看 Python 版本。如低于 3.9,需要重装。
3.2.智能快递配送系统
3.2.1 Graph API 编码思路
构建 Graph 图,首先需要【定义状态】,然后【定义并添加节点和边】,最后【编译】它。编译提供了对图形结构的一些基本检查(没有孤立节点等)
LangGraph 所谓的 "编译" 与传统意义上的语言编译完全不同,LangGraph 编译本质是在运行时动态构建和验证一个复杂的图,而非翻译代码。
| 特性 | LangGraph 的编译 | Java 的编译 | C++ 的编译 |
|---|---|---|---|
| 本质 | 配置组装与验证 | 语言翻译与转换(到中间码) | 语言翻译与转换(到本地机器码) |
| 发生阶段 | 应用程序运行时(初始化阶段) | 应用程序开发时(构建阶段) | 应用程序开发时(构建阶段) |
| 主要目的 | 1. 构建可执行的工作流对象2. 进行结构验证 | 1. 将高级语言转为低级语言(字节码)2. 进行语法和深度语义检查 | 1. 将高级语言转为特定平台的本地机器码2. 进行彻底的语法、语义检查与优化3. 链接所有模块,生成完整的可执行文件 |
3.2.2 代码实现
步骤 1:定义 State
定义图时要做的第一件事是定义图的状态 。状态将是图中所有节点和边的输入,可以是 TypedDict 或 Pydantic 模型(Pydantic 的性能不如 TypedDict)。如下所示:
python
from typing import TypedDict,Annotated
from operator import add


#Package表示的是包裹状态
class PackageState(TypedDict):
    package_id:str                      #包裹id
    origin:str                          #发货地
    destination:str                     #目的地

    status:str                          #包裹配送状态:"待揽收", "运输中", "派送中", "已签收"
    history:Annotated[list[str], add]   #包裹的流转历史
    total_distance:Annotated[int,add]   #总里程

    # 配送详情
priority: str # "普通", "加急"这里TypedDict 是 Python 类型提示里的工具,用来描述一个「固定 key、每个 key 对应固定类型」的字典结构。它在这里的作用是告诉编译器这里定义的PackageState是一个字典结构,凡是类型标注为 PackageState 的字典,静态检查器就认为它必须包含下面这些 key,并且每个 key 的值类型要匹配。
这里history与total_distance分别是liststr与int类型,相同的是它们都需要支持追加功能。而普通的更新会直接覆盖旧值。
为什么加了Annotatedlist\[str, add] 就能实现追加?
这里的
add就是operator.add(LangGraph 里的归约器 reducer) LangGraph 框架读到这个注解,自动调用它合并状态。
pythonimport operator add = operator.addadd的模拟实现:
pythondef add(old_val, new_val): return old_val + new_va如果传递进来的两个参数为list则会完成合并并返回新的list;如果参数为两int则会完成累加。需要注意的是两个参数的类型必须一致。
回到上文,代码中**Annotatedlist\[str, add]/Annotatedint,add**的作用是
- 第一个参数
list[str]/int:Python 类型提示,告诉类型检查器这个字段是字符串列表/整型- 第二个参数
add:附加元数据,Python 本身完全忽略它!- LangGraph 会读取这个元数据:当节点返回新 state 的时候,发现这个字段带了 reducer 函数
add,就不直接覆盖,而是调用 add (旧值,新值)得到合并后的新状态。除了使用operator.add,我们也可以自定义合并逻辑:
pythondef my_reducer(old_val, new_val): # 自定义合并规则 return old_val + new_val class PackageState(TypedDict): history: Annotated[list[str], my_reducer]
步骤 2:定义 StateGraph 图
StateGraph 是一个有状态图计算框架,它基于有向图模型构建,专门设计用于处理多步骤、有状态的工作流程。
StateGraph 用来将复杂的工作流程可视化、模块化,让开发者能够像设计快递配送网络一样设计软件系统。通过这种思维方式,即使是复杂的多步骤 AI 应用也变得清晰可控。
我们需要使用 langgraph.graph.state.StateGraph 来定义。StateGraph 仅是一个构建器类,可以使用 State 来构建。如下所示:
python
from langgraph.graph import StateGraph

Package_delivery=StateGraph(PackageState)注意:构造StateGraph 需要传入一个State状态,这里仅是构建出 StateGraph,还无法直接用于执行。
步骤 3:定义 Nodes(节点)
接着我们可以定义各个配送站点(节点)。在 LangGraph 中,节点就是一个 Python 函数(同步或异步)。注意
- 节点 接收 状态 作为参数。
- 节点 不需要返回整个
State模式,只需一个更新。(LangGraph 框架会自动完成更新)
从前文的业务我们可以得出一共需要三个节点:揽收站、分拣中心、配送站。所以我们需要定义三个Nodes也就是三个Python 函数。
如下所示:
python
#揽收站:
def PickupStation(state:PackageState):
    """揽收站"""
    return{
        "status":"已揽收",
        "history":[f"包裹在{state["origin"]}揽收"]
    }

#分拣中心
def Sortingcenter(state:PackageState):
    """分拣中心"""
    destination=state["destination"]
    if "北京" in destination:
        nextdestination="北京分拣中心"
    elif "上海" in destination:
        nextdestination = "上海分拣中心"
    elif "广东" in destination:
        nextdestination="广东分拣中心"
    else:
        nextdestination = "其他分拣中心"
    return{
        "status":"已分拣",
        "history": [f"分拣至{nextdestination}"],
    }

#配送站
def Deliverystation(state:PackageState):
    """配送站"""
    return {
        "status": "已签收",
        "history": [f"包裹在{state['destination']}签收"]
    }
步骤 4:添加 Nodes到图
接下来,我们需要将各节点,组织进图中,即添加节点到 StateGraph 中。可以使用 add_node() 将新节点添加到 StateGraph。
add_node 是向状态图注册节点 的核心接口,把一个可执行逻辑(普通函数 / Runnable)绑定成图中的命名节点,后续用节点名在 add_edge / add_conditional_edges 定义流转关系。
| 参数名 | 类型 | 描述 |
|---|---|---|
| node | 字符串 或 StateNode 对象 | 作用:指定节点要运行的函数或可执行对象 使用方式: * 如果传入字符串,代表节点名称,图内必须唯一,后面 add_edge 就用这个名字引用节点,此时会使用 action 参数作为实际的执行函数 * 如果传入 StateNode 对象,则直接使用该对象定义节点 |
| action | StateNode 对象或 None(默认值) | 作用:定义与节点关联的动作(执行逻辑) 使用方式: * 当 node 参数是字符串时,action 会作为该节点的实际执行函数 * 当 node 参数已经是 StateNode 对象时,action 通常为 None |
| ...... |
代码如下:
python
#将三个节点添加到图中
Package_delivery.add_node("揽收站",PickupStation)
Package_delivery.add_node("分拣中心",Sortingcenter)
Package_delivery.add_node("配送站",Deliverystation)
步骤 5:添加 Edges(边)
各节点(站点)准备好后,则需要为快递运输规划路线。如:
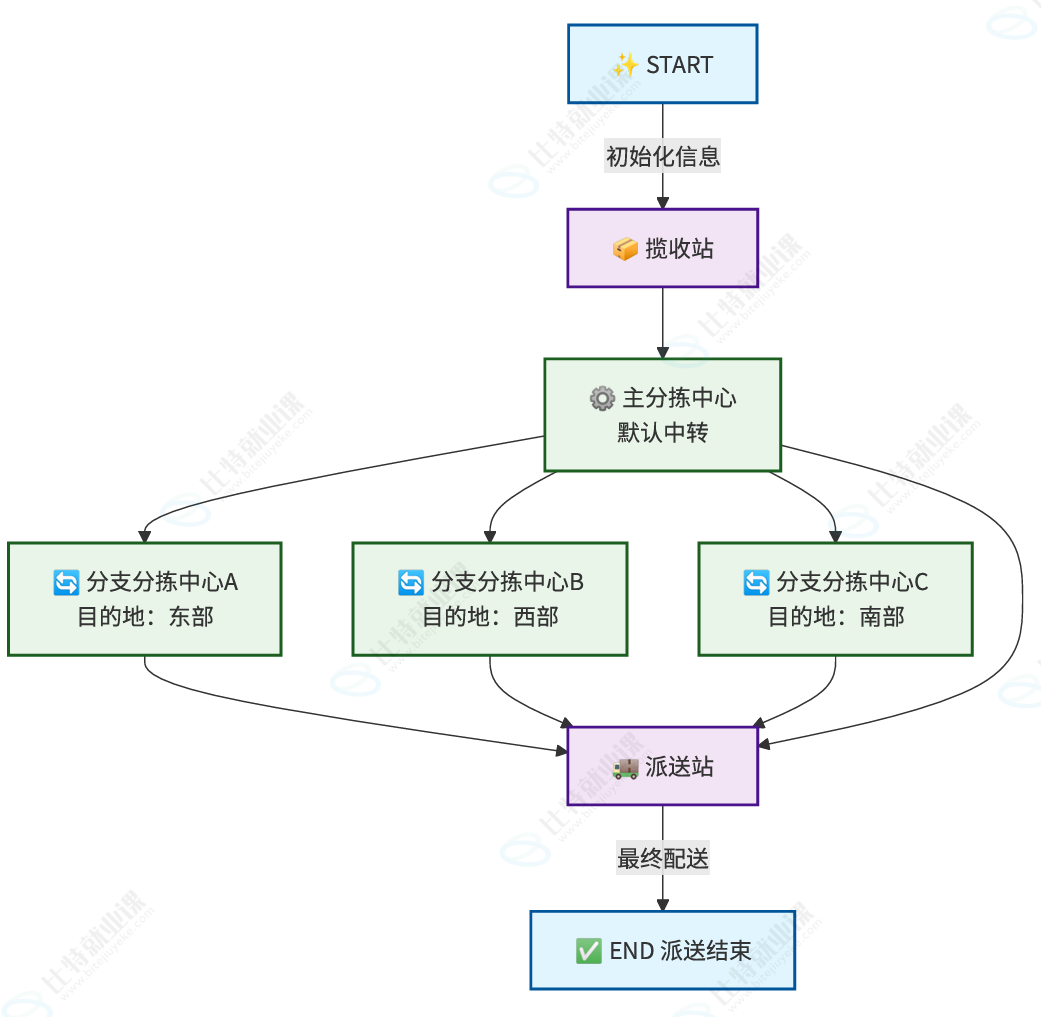
实际上,这就是为图定义边。边有几种关键类型:
- 普通边 / 固定边(Normal Edges):直接从一个节点转到下一个节点。
- 条件边(Conditional Edges):调用函数来确定下一步要转到哪个节点。
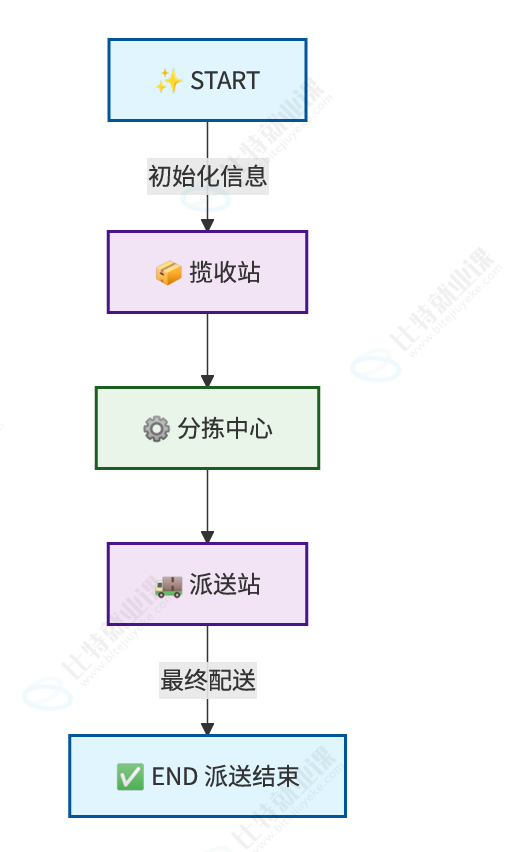
例如,设置最简单运输路线:快递由揽收站接收,下一站固定为分拣中心,最后到派送中进行派送。 这就是固定边,如下图所示:
再例如,我们可以根据以下条件,判断快递如何运输:
- 包裹是加急件 → 走空运线路
- 包裹不是加急件 → 走标准线路 这就是条件边,如下图所示:
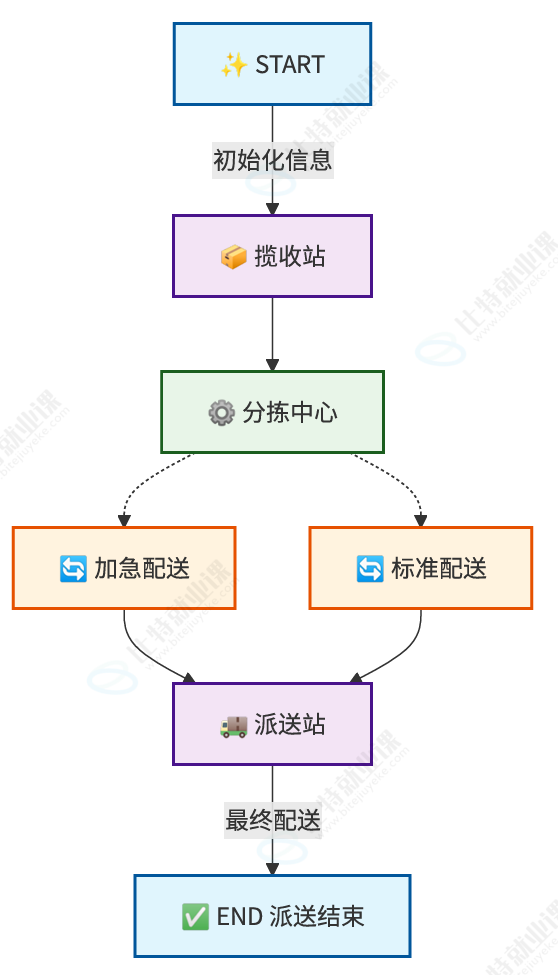
此时分拣中心需要判断来的包裹信息是否为加急件,并工具判断结果将包裹给两个节点:加急配送与标准配送节点完成不同的操作。所以如果我们想要完成上图中的处理流程首先需要创建两个节点分别为加急配送与标准配送。然后将两个节点添加到图中再完成统一的边规划:
python
#加急配送
def ExpressDelivery(state:PackageState):
    """加急配送"""
    return{
        "status": "运输中",
        "history": ["加急配送"],
        "total_distance": 500
    }
#标准配送
def StandardDelivery(state:PackageState):
    """标准配送"""
    return {
        "status": "运输中",
        "history": ["标准配送"],
        "total_distance": 1000
    }

Package_delivery.add_node("加急配送",ExpressDelivery)
Package_delivery.add_node("标准配送",StandardDelivery)
需要说明的是,在 LangGraph 中:
- START 节点:是一个特殊节点,表示将用户输入发送到图形的节点。引用此节点的主要目的是确定应该首先调用哪些节点。
- END 节点:是一个表示终端节点的特殊节点。当想要指示哪些边在完成后没有后续动作时,将引用此节点。
- 条件入口点(Conditional Entry Point):调用一个函数来确定在用户输入到达时首先调用哪个节点。
我们可以使用 add_edge() 向图中添加从开始节点(或起始节点列表)到结束节点的固定边。 add_edge() 方法常用参数说明:
| 参数名 | 类型 | 描述 |
|---|---|---|
| start_key | 字符串 或 字符串列表 | 边的起始节点的键。 |
| end_key | 字符串 | 边的结束节点的键。 |
使用 add_conditional_edges() 向图中添加 从起始节点到任意数量的目标节点的条件边。 add_conditional_edges() 方法常用参数说明:
| 参数名 | 类型 | 描述 |
|---|---|---|
| source | 字符串 | 起始节点。退出此节点时,将运行此条件边。 |
| path | Callable 或 Runnable | 决定下一个节点或多个节点的方法。如果没有指定 path_map 应返回一个或多个节点。如果返回 "END",图将停止执行。 |
| path_map | 字典 或 字符串列表 或 None | 【可选】将路径映射到节点名。如省略,path 返回的路径应为节点名。 |
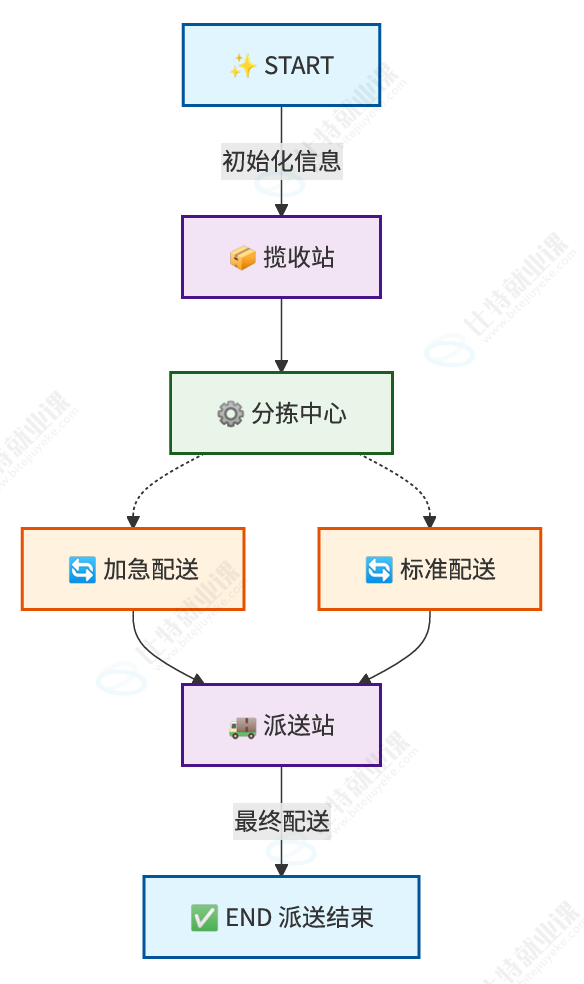
接下来实现下图对应的代码:
python
def SmartSorting(state:PackageState):
    if "加急" in state["priority"]:
        return "加急配送"
    else:
        return "标准配送"

#添加边
Package_delivery.add_edge(START,"揽收站")
Package_delivery.add_edge("揽收站","分拣中心")

Package_delivery.add_conditional_edges(
    "分拣中心",
    SmartSorting,
    ["加急配送","标准配送"]
)

Package_delivery.add_edge("加急配送","配送站")
Package_delivery.add_edge("标准配送","配送站")
Package_delivery.add_edge("配送站",END)
这里代码中需要留意的是添加条件边的接口add_conditional_edges的使用,第二个参数返回的字符串要求要与path_map中的字符串列表中的字符串对应。如果不对应则需要手动指定:
python
def SmartSorting(state: PackageState):
    """智能路由决策 - 根据包裹特性选择路线"""
    if state["priority"] == "加急":
        return "备注加急"
    else:
        return "无备注"

Package_delivery.add_conditional_edges(
    "分拣中心",        # source: 起始节点。退出此节点时,将运行此条件边。
    SmartSorting,     # path: 确定下一个或多个节点的可调用对象。
    {
        "备注加急": "加急配送",
        "无备注": "标准配送"
    }
)
步骤 6:StateGraph 图编译
在步骤 2 中,我们仅是构建出 StateGraph,还无法直接用于执行。LangGraph 要求:必须先编译图,然后才能使用它。编译提供了对图结构的一些基本检查,这会验证:
- 从 START 到所有节点的可达性
- 从所有节点到 END 的可达性
- 没有孤立节点或死循环
使用 compile() 方法即可编译图。该方法将 StateGraph 编译为 CompiledStateGraph 对象。编译后的图实现了 Runnable 接口,可以异步调用、流式传输、批处理和运行。
python
#编译图
delivery_system = Package_delivery.compile()
到这里,核心代码已编写完成。接下来进行测试。
python
# 8. 测试配送
test_packages = [
    {
        "package_id": "P001",
        "origin": "北京",
        "destination": "上海",
        "priority": "普通",
        "history": [],
        "total_distance": 0
    },
    {
        "package_id": "P002",
        "origin": "广州",
        "destination": "乌鲁木齐",
        "priority": "加急",
        "history": [],
        "total_distance": 0
    }
]

for package in test_packages:
    print(f"\n配送包裹: {package['package_id']}")
    result = delivery_system.invoke(package)
    print("最终状态:", result["status"])
    print("配送历史:", result["history"])
    print("总里程:", result["total_distance"])
注意,默认情况下,图将具有相同的输入和输出结构。对于 invoke() 方法,支持单个输入,它的输入可以是字典或任何其他类型,默认返回最新的 State。
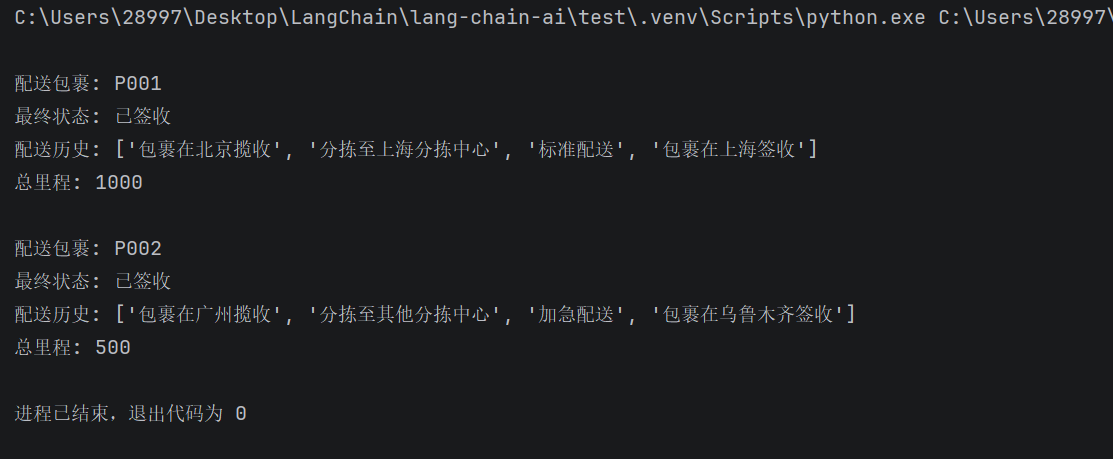
到此,我们已经构建出了一个图式的智能快递配送系统,来理解 LangGraph 图的基本能力与用法!核心概念回顾:
- State = 包裹信息卡(记录所有状态)
- Nodes = 配送站点(执行具体操作)
- Edges = 运输路线(控制流转顺序)
- Reducers = 信息更新规则(如何记录变更)
- 编译 = 从路线图到运营系统的转换
3.2.3 完整代码
python
from typing import TypedDict,Annotated
from operator import add

from langgraph.constants import START,END
from langgraph.graph import StateGraph

#Package表示的是包裹状态
class PackageState(TypedDict):
    package_id:str                      #包裹id
    origin:str                          #发货地
    destination:str                     #目的地

    status:str                          #包裹配送状态
    # history: list[str]  # 包裹的流转历史
    # total_distance: int  # 总里程
    history:Annotated[list[str], add]   #包裹的流转历史
    total_distance:Annotated[int,add]   #总里程

    # 配送详情
    priority: str  # "普通", "加急"

#定义图
Package_delivery=StateGraph(PackageState)

#揽收站:
def PickupStation(state:PackageState):
    """揽收站"""
    return{
        "status":"已揽收",
        "history":[f"包裹在{state["origin"]}揽收"]
    }

#分拣中心
def Sortingcenter(state:PackageState):
    """分拣中心"""
    destination=state["destination"]
    if "北京" in destination:
        nextdestination="北京分拣中心"
    elif "上海" in destination:
        nextdestination = "上海分拣中心"
    elif "广东" in destination:
        nextdestination="广东分拣中心"
    else:
        nextdestination = "其他分拣中心"
    return{
        "status":"已分拣",
        "history": [f"分拣至{nextdestination}"],
    }

#配送站
def Deliverystation(state:PackageState):
    """配送站"""
    return {
        "status": "已签收",
        "history": [f"包裹在{state['destination']}签收"]
    }

#加急配送
def ExpressDelivery(state:PackageState):
    """加急配送"""
    return{
        "status": "运输中",
        "history": ["加急配送"],
        "total_distance": 500
    }
def StandardDelivery(state:PackageState):
    """标准配送"""
    return {
        "status": "运输中",
        "history": ["标准配送"],
        "total_distance": 1000
    }

def SmartSorting(state:PackageState):
    if "加急" in state["priority"]:
        return "加急配送"
    else:
        return "标准配送"


#将三个节点添加到图中
Package_delivery.add_node("揽收站",PickupStation)
Package_delivery.add_node("分拣中心",Sortingcenter)
Package_delivery.add_node("配送站",Deliverystation)
Package_delivery.add_node("加急配送",ExpressDelivery)
Package_delivery.add_node("标准配送",StandardDelivery)

#添加边
Package_delivery.add_edge(START,"揽收站")
Package_delivery.add_edge("揽收站","分拣中心")

Package_delivery.add_conditional_edges(
    "分拣中心",
    SmartSorting,
    ["加急配送","标准配送"]
)

Package_delivery.add_edge("加急配送","配送站")
Package_delivery.add_edge("标准配送","配送站")
Package_delivery.add_edge("配送站",END)

#编译图
delivery_system = Package_delivery.compile()


# 8. 测试配送
test_packages = [
    {
        "package_id": "P001",
        "origin": "北京",
        "destination": "上海",
        "priority": "普通",
        "history": [],
        "total_distance": 0
    },
    {
        "package_id": "P002",
        "origin": "广州",
        "destination": "乌鲁木齐",
        "priority": "加急",
        "history": [],
        "total_distance": 0
    }
]

for package in test_packages:
    print(f"\n配送包裹: {package['package_id']}")
    result = delivery_system.invoke(package)
    print("最终状态:", result["status"])
    print("配送历史:", result["history"])
    print("总里程:", result["total_distance"])