《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)
目录
本文要点
(1)Show-Harness是新加坡国立大学Show Lab在2026年9月发布的具身运行时,让视觉语言模型用离散语义动作单元直接操作机械臂。
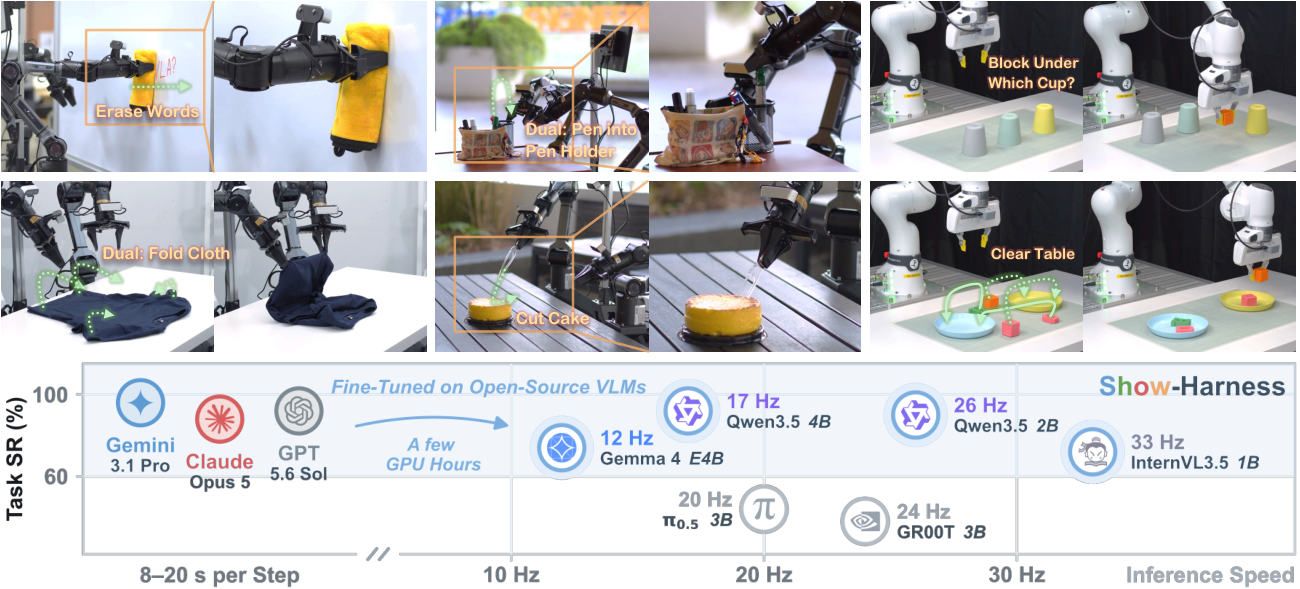
(2)十个抓放任务上,Gemini-3.1 Pro零样本平均89.0 ,微调后的Qwen3.5-2B平均86.0 ,对照里最好的RATS是57.0。
(3)模型只输出MV_FWD、GRASP这类符号,本体解释器负责落到关节,换机器人只换解释器。
(4)短板很清楚。评测主要在平行夹爪的单臂和双臂上,仿真数据训完再上真机只有13/20,香蕉放进碗的零样本是6/10。
(5)文末是官方README的仿真采集示例,我在本机跑通了一步MV_DOWN。
新加坡国立大学Show Lab在2026年9月把Show-Harness挂上arXiv,编号2609.10522。Hugging Face论文页写的日期是9月8日。我把HTML版从头对了一遍,又按仓库README把仿真采集器拉了起来。
他们想接住的事情很具体。模型在电脑上已经能点鼠标、敲键盘,这一套叫computer-use。换到机械臂上,同一份世界知识常常接不进去。
报告里的默认零样本用Gemini-3.1 Pro,五个物体配盘子和碗,十个抓放任务平均89.0。同一套动作上对Qwen3.5-2B做LoRA,平均86.0。对照里最好的代码策略智能体RATS是57.0。
从点鼠标到拧手腕
视觉语言动作模型(VLA)把预训练好的VLM往低层控制拉,直接回归和本体绑在一起的连续动作。报告说这条路会把本来很宽的语义知识压成不透明的像素到电机映射,换任务、换环境、换本体往往要重新适配。
另一条路让VLM出子任务、关键点或技能名,具体怎么动交给下游控制器。语义保住了,物理过程模型看不见。
Show-Harness把控制改写成一套离散的语义动作单元。每一步是一个方向上的一小段移动,或一次张合夹爪。模型认这些符号,本体解释器再确定性地落到局部动作。模型仍然对细粒度的物理决策负责。
这就是他们说的robot-use。computer-use里鼠标位移是人能理解的原子操作,这里的原子操作换成了MV_FWD这种单位步。
动作单元和解释器
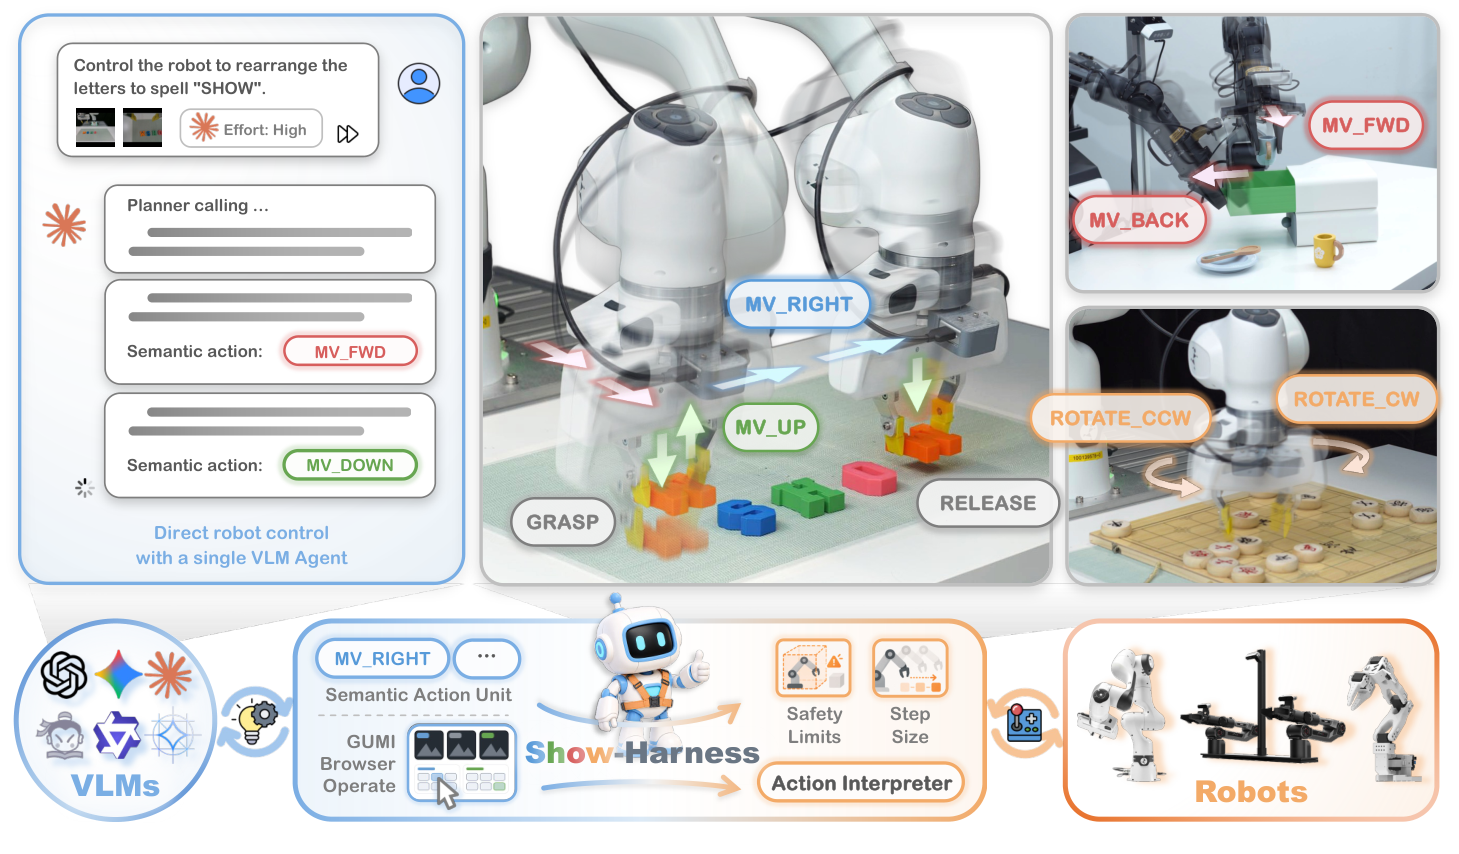
相对当前选定的参考视角,平移有六个方向,前、后、左、右、上、下。需要转手腕时,顺时针和逆时针绕指定轴转一小步。GRASP和RELEASE管夹爪,DONE表示任务结束。双臂时闲置臂还可以输出STILL。
解释器更新六自由度的笛卡尔位姿设定点。Franka用阻抗控制跟踪,AgileX用逆解再往关节流目标,仿真器执行对应的操作空间命令。工作空间和桌面高度这类安全限制写在解释器里,越界动作执行前会被挡住。
换本体只换解释器。模型面对的词表不变。
他们拿Gemini-3.1 Pro做过动作表示的消融,只改六个平移符号的写法。带名称和效果说明的默认设定20次全中,平均25步。任意符号加上书面约定仍有19/20。只给语义名称是18/20,步数升到34。
名称和约定都拿掉,让模型自己试、自己猜映射,20次里只成了1 次,猜对的方向比例23.3%,随机瞎猜是16.7%。
没有约定,模型几乎猜不出自己发出的符号会把胳膊带去哪。
插件和两种用法
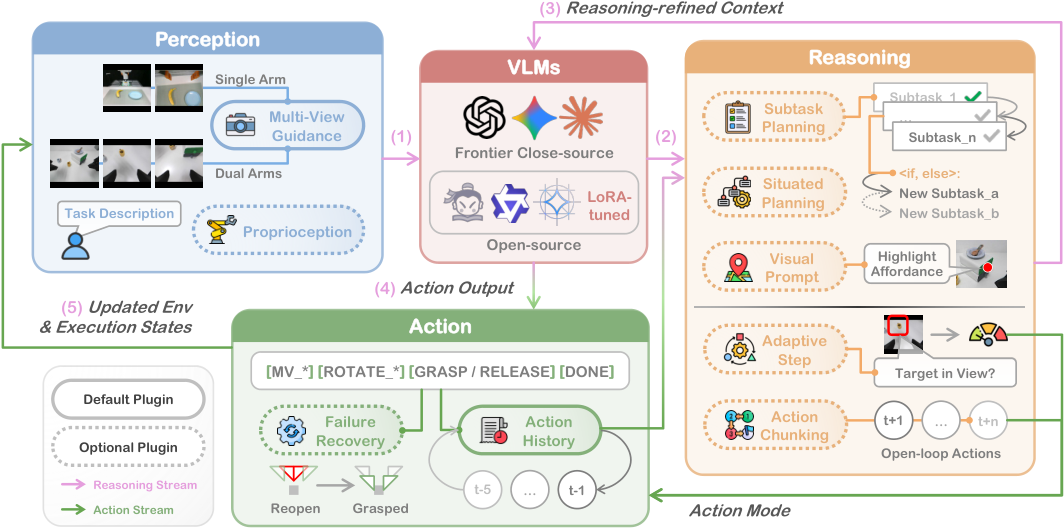
外面是感知、推理、动作三阶段插件。默认几乎全开,情境规划和视觉提示只在需要时打开。
零样本模式把闭源前沿模型直接塞进这套循环,不微调。微调模式用同一套符号,Qwen3.5-2B做默认,LoRA秩64,视觉编码器和多模态投影冻结,大约更新3%的参数。动作走模型自己的词表,不加专门的动作头。附录写,这份2B的微调在单张H200上不到2小时。
子任务规划关掉以后,五个盘子任务成功率掉到60% ,模型经常拖着物体往盘子蹭,不先抬起来。杯子把手那种要咬准交互点的抓取,打开视觉提示后从40%到85%。
藏在三只杯子下面的物块,情境规划从35%拉到85%。失败恢复关掉掉到72%,空抓之后还继续走是主要失败模式。
自适应步长默认腕部看见目标用2厘米细步,否则4厘米粗步,零样本在盘子任务上96%,平均30步。动作历史只保留最近5步,用来减少左右来回晃。
GUMI怎么采演示
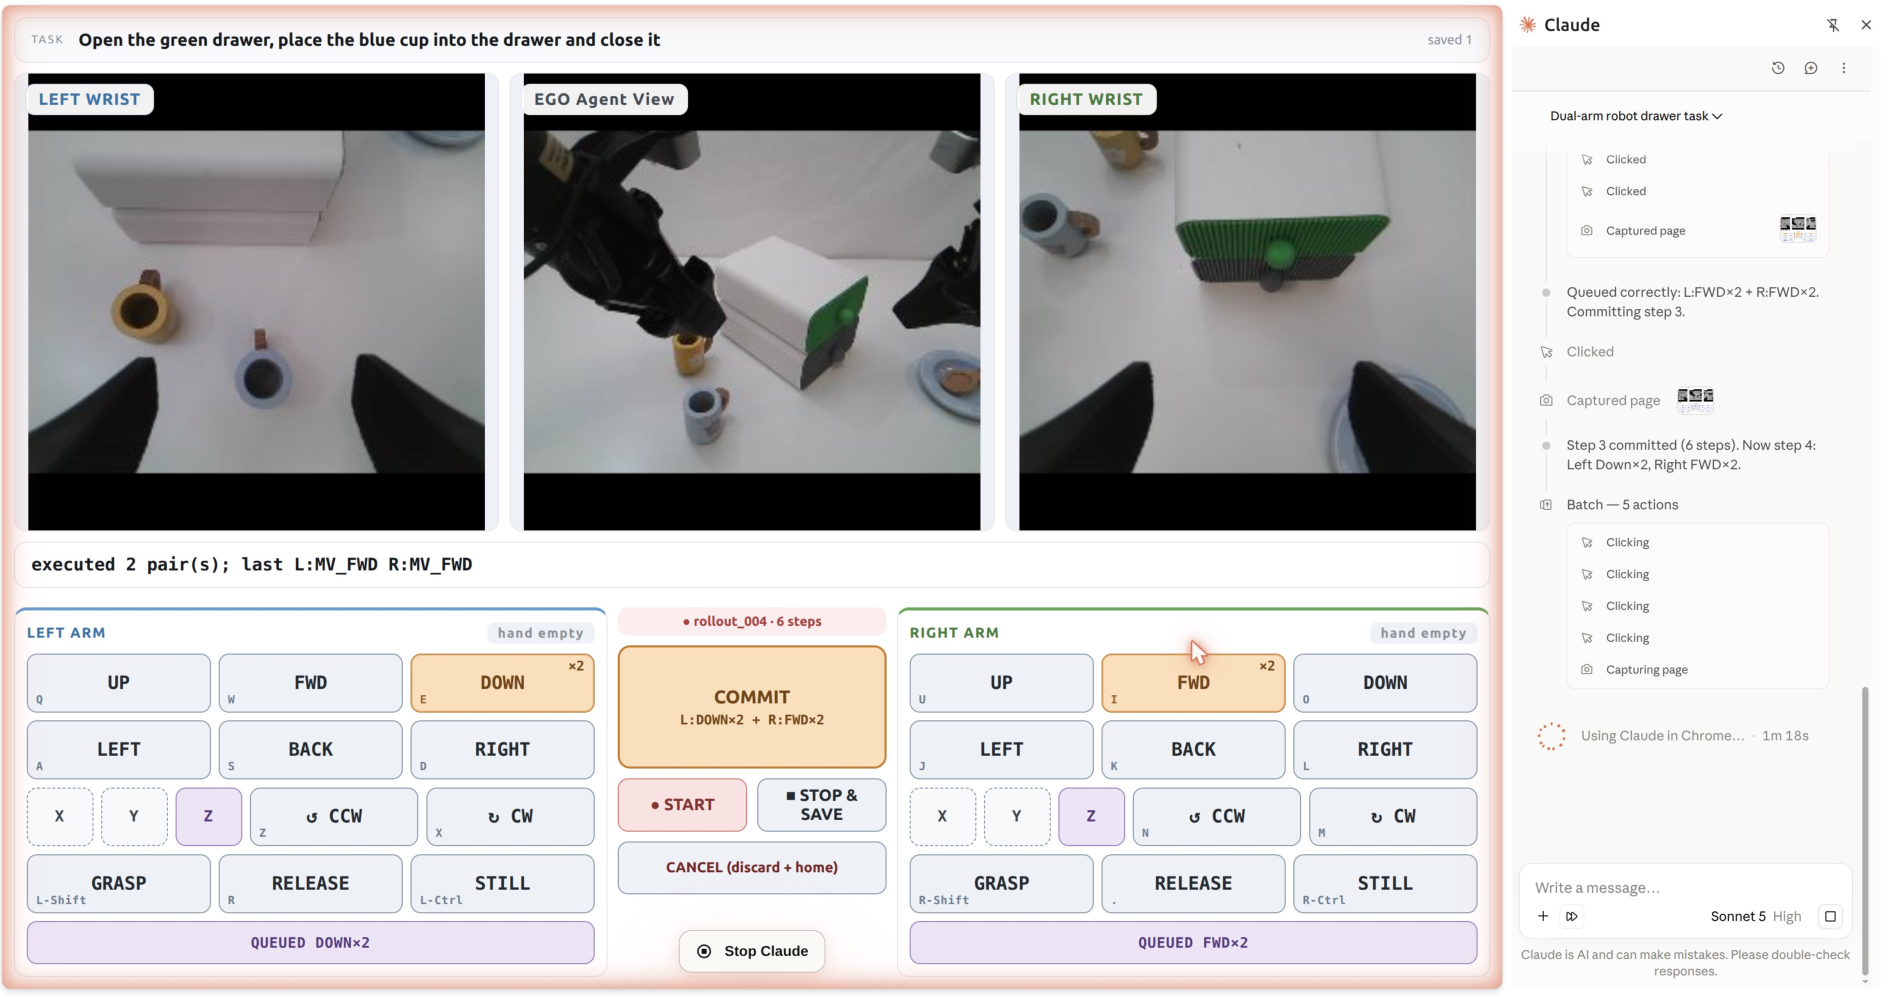
动作空间是离散的,也能画成网页按钮和快捷键。GUMI是这套图形界面。人用键盘玩机器人,电脑用智能体也可以点同一块屏幕,每一步记下执行前的观察和选中的语义动作。
解释器确定性地落地,所以同一条演示也能留低层命令,语义策略和连续控制策略都能训。
真机共164 条回合、约7.8K个决策步,统一2厘米平移。Franka 101条、约5.0K步,AgileX单臂63条、约2.8K步。
仿真230条、约13.5K步,ManiSkill 100条,RoboLab 12个抓放任务130条。人和前沿模型的浏览器回放都算进这批数据。
评测用五个物体配盘子和碗,共十个任务,每任务10次,上限50步,超时算失败。微调演示里出现过积木、香蕉、网球,泰迪熊和国际象棋棋子留作分布外。
成绩单,挑几个要紧的数
表2把三类对照和Show-Harness的两种模式放在一起。ZS是Gemini-3.1 Pro、中等思考预算。FT是Qwen3.5-2B。跨环境四项是背景、光照、视角、干扰物,仿真到真机单独一列。
| 模型 | 路线 | 跨任务平均 | 跨环境平均 | 跨本体平均 | 仿真到真机 |
|---|---|---|---|---|---|
| π0.5 | VLA | 39.0 | 40.0 | 41.0 | 0/20 |
| GR00T | VLA | 35.0 | 34.0 | 36.0 | 0/20 |
| H-VLA | 外包一层Agent的VLA | 50.0 | 63.8 | 49.0 | 未报告 |
| G-VLA | 外包一层Agent的VLA | 13.0 | 15.0 | 11.0 | 未报告 |
| CaP-X | 代码策略 | 44.0 | 52.5 | 43.0 | 未报告 |
| RATS | 代码策略 | 57.0 | 65.0 | 52.0 | 未报告 |
| Show-Harness ZS | 前沿模型零样本 | 89.0 | 100.0 | 93.0 | 未报告 |
| Show-Harness FT | 开源小模型微调 | 86.0 | 88.0 | 87.0 | 13/20 |
ZS的跨环境100.0来自那四项各20/20,仿真到真机这一格是横杠,没有测零样本。FT的88.0把13/20算进去了。两个平均口径不同,看表时分开读。
跨任务里零样本最难看的一项是香蕉进碗,6/10。国际象棋棋子没进微调数据,零样本盘子和碗都是10/10,微调各9/10,π0.5是1/10和1/10。
仿真里训完再上真机Franka,FT做成13/20。π0.5和GR00T在同一批仿真轨迹上训连续动作,都是0/20。13/20谈不上稳,对照是零。
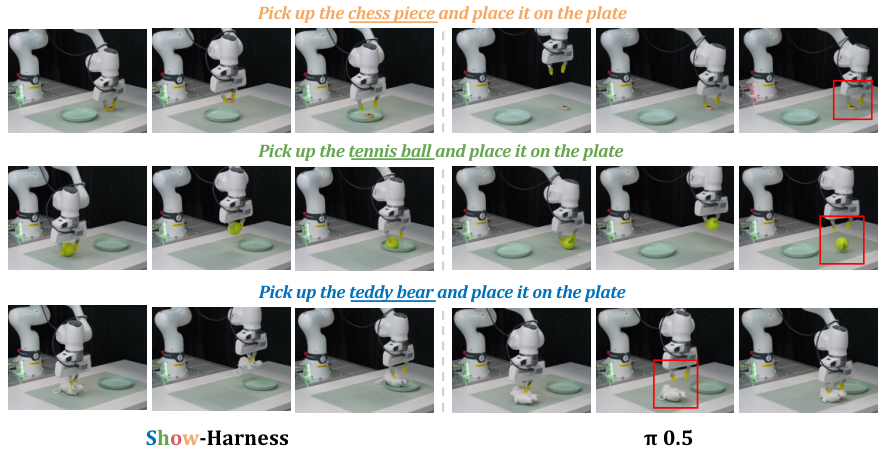
附录定性对比里,同一套演示转成连续轨迹去微调π0.5,棋子、网球、泰迪熊三例都出现夹爪碰撞或不稳抓取。Show-Harness这边走完了。
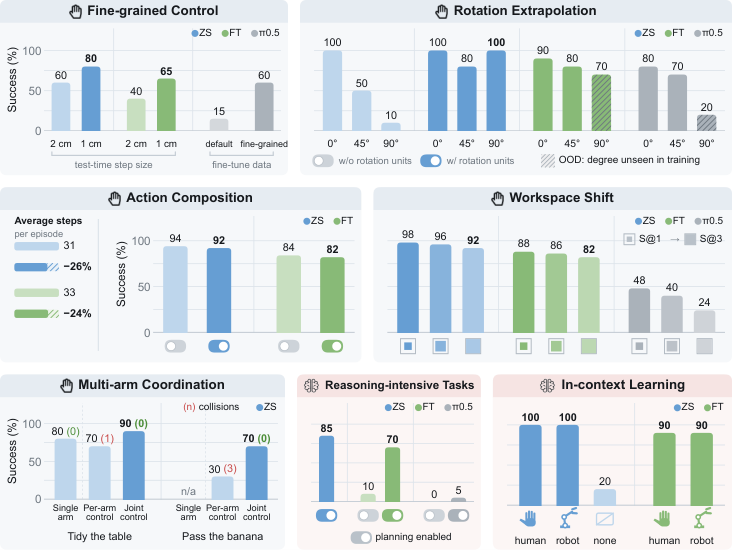
步长从2厘米改到1厘米,模型不用重训。零样本从60%到82%,微调从40%到65%。π0.5用同一批演示只有18%,补了细粒度训练才到62%。
胡萝卜朝向90度没在微调数据里出现过,微调策略仍有70%,π0.5是20%。
找杯子下面的物块、把字母摆成SHOW,这类要先想再动手的任务,带情境规划的零样本到85%。微调单独做只有10%,π0.5是0。
把Gemini写好的子任务指令喂给微调模型,它能到70%,π0.5仍是5%。
无演示只说收拾桌子,零样本20%。看一段人或机器人的视频再做,20次全中。
本地跑一遍
我没有真机。下面命令来自官方README的Quick Start第2节,仿真桌面,不接CAN、不接相机。
bash
git clone https://github.com/showlab/Show-Harness.git
cd Show-Harness
bash scripts/setup.sh base
.venv/bin/python gumi/collect_rollouts_web.py data/rollouts_demo --simREADME写打开http://localhost:8600,用WASD或方向键开车。我这台机器8600已经被别的服务占用,改成--port 8610才绑得上。
另外,--sim仍会加载configs/robot_piper.yaml。不把configs/site/piper_arms.yaml.example拷成piper_arms.yaml,启动会直接报找不到站点配置。这一步README写在真机流程里,仿真命令本身没写。
页面标题是Show-Harness Web Teleop。状态接口里任务句是Pick up the orange cube and place it on the blue plate,step_m为0.02 。我发出一条MV_DOWN,末端高度从0.25米变成0.23米,和两厘米步长对得上。
日志提示没装pyrealsense2。仿真走MockPiperRobot。关节流因为正运动学和位姿反馈差了214.4毫米被关掉,退回MOVE P。我只验证了单步,没有把方块放到盘子上。
模型卡还写了一条部署时会静默出错的约定。方向按Franka俯视外参视角定义,AgileX是第一人称,上真机要把MV_FWD和MV_BACK对调,否则手臂会走反,程序不报错。Franka和仿真不用换。这条来自Hugging Face模型卡,论文正文没写。
几点看法
报告把力气花在模型能直接操作的符号上。闭源模型零样本能用,2B开源模型微调也能用,换本体换解释器。这个选择我认同。
图1把前沿模型标在每步8到20秒,微调开源模型标在12 Hz到33 Hz。要在真机上盯着滚动的网球,延迟会反过来咬人。报告里更大的骨干在网球上不一定更好,图8里Qwen3.5从0.8B到9B,决策耗时从27毫秒、39毫秒涨到79毫秒。
短板报告自己写了。目前主要评测平行夹爪的单臂和双臂,人形和灵巧手还没走。触觉和力也没接进感知。香蕉进碗6/10,仿真到真机13/20,细粒度抓放仍然是瓶颈。第5.4.1节说各家前沿模型跟指令都还稳,有效动作单元超过98%,规划也不是主因,错在厘米级的抓和放。
参考链接
- 技术报告原文 arXiv 2609.10522 v1,2026年9月
- 项目页 Show-Harness
- 代码仓库 showlab/Show-Harness
- 微调权重 showlab/Show-Harness-VLMs
- 演示数据 showlab/Show-Harness-Data
- 对照方案 π0.5、GR00T N1