前面我们介绍了 Xenium 与 H&E 图像的配准,包括 Xenium Explorer 中的手动操作,以及使用 InSituPy 进行自动配准。完成这一步后,就可以继续实现最开始的需求:以 H&E 为背景,在上面叠加细胞轮廓和基因表达,观察这些信号在组织中的具体位置。
这里使用 10x 官方人肺癌 FFPE 的 Xenium Prime 5K 数据,基于 Python 的 SpatialData 框架,演示配准结果读取、局部区域选择,以及细胞表达和单分子转录本的原位展示。先看最终效果,再逐步说明代码。
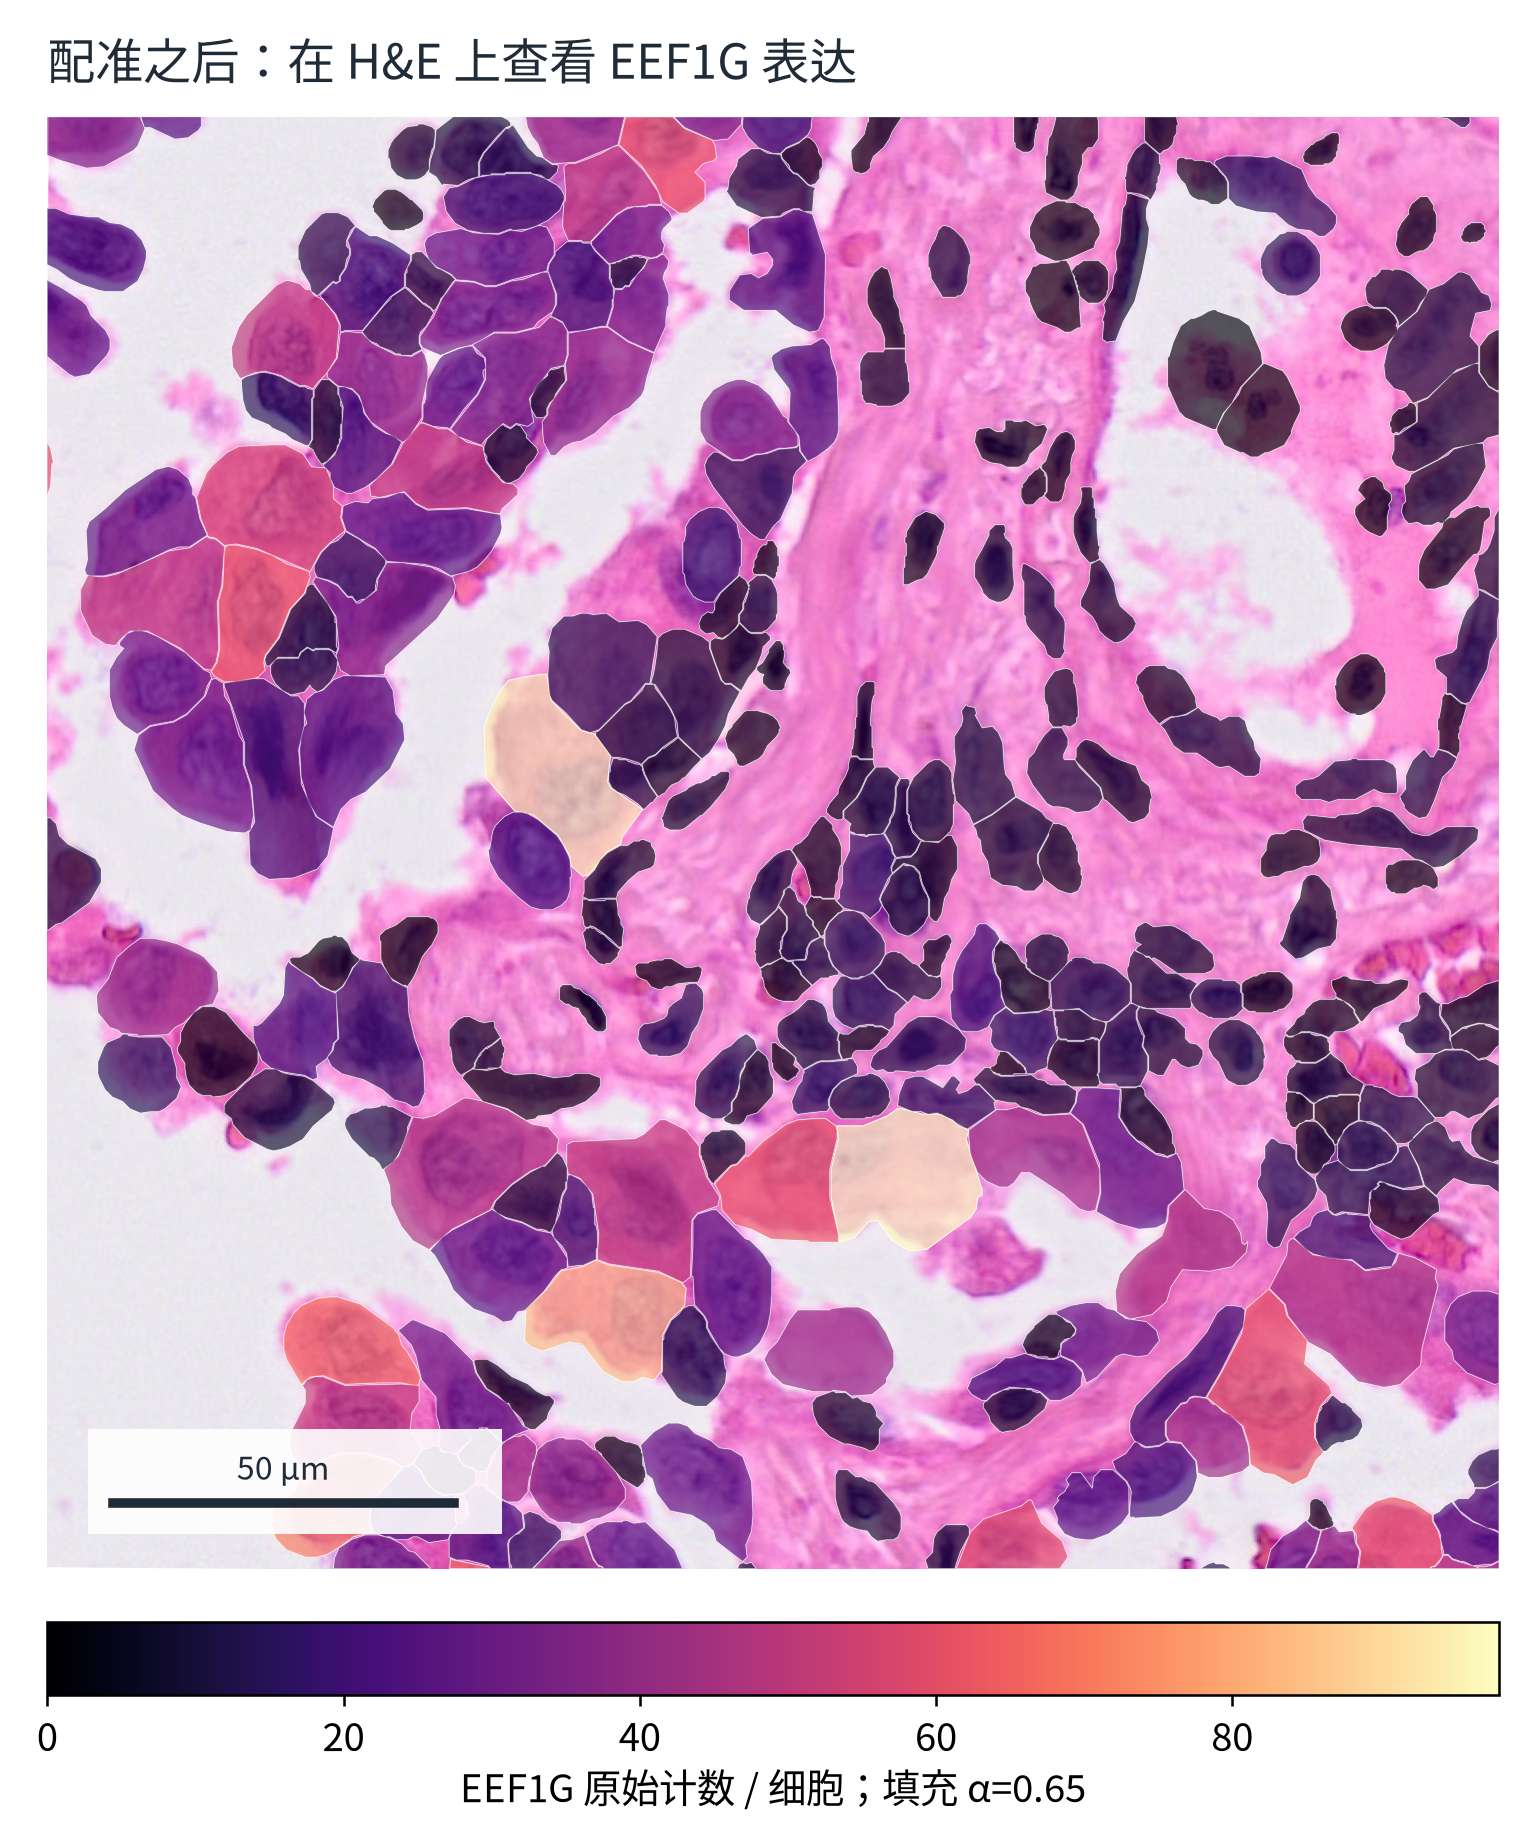
效果预览:H&E上的EEF1G细胞表达
效果预览|H&E 提供组织形态背景,白线标出细胞分割轮廓,填充颜色对应每个细胞的 EEF1G 原始计数。半透明颜色会与底图混合,精确读值应结合后面的独立表达图。
一、配准完成后,需要准备哪些文件?
本例采用官方数据页面中的 Experiment 2,包含 278,328 个检测到的细胞,读取后的基因表达表为 278,328 × 5,001。这里的"5K"指目标基因panel大小,并不表示每个细胞都检测到了五千个基因。数据页面报告的每细胞转录本中位数为 242。数据来源与说明
绘图需要把几类信息对应起来:H&E 图像提供背景,配准矩阵记录空间映射,细胞边界决定轮廓的位置,表达矩阵提供细胞的基因计数,转录本文件则保留单分子的坐标。
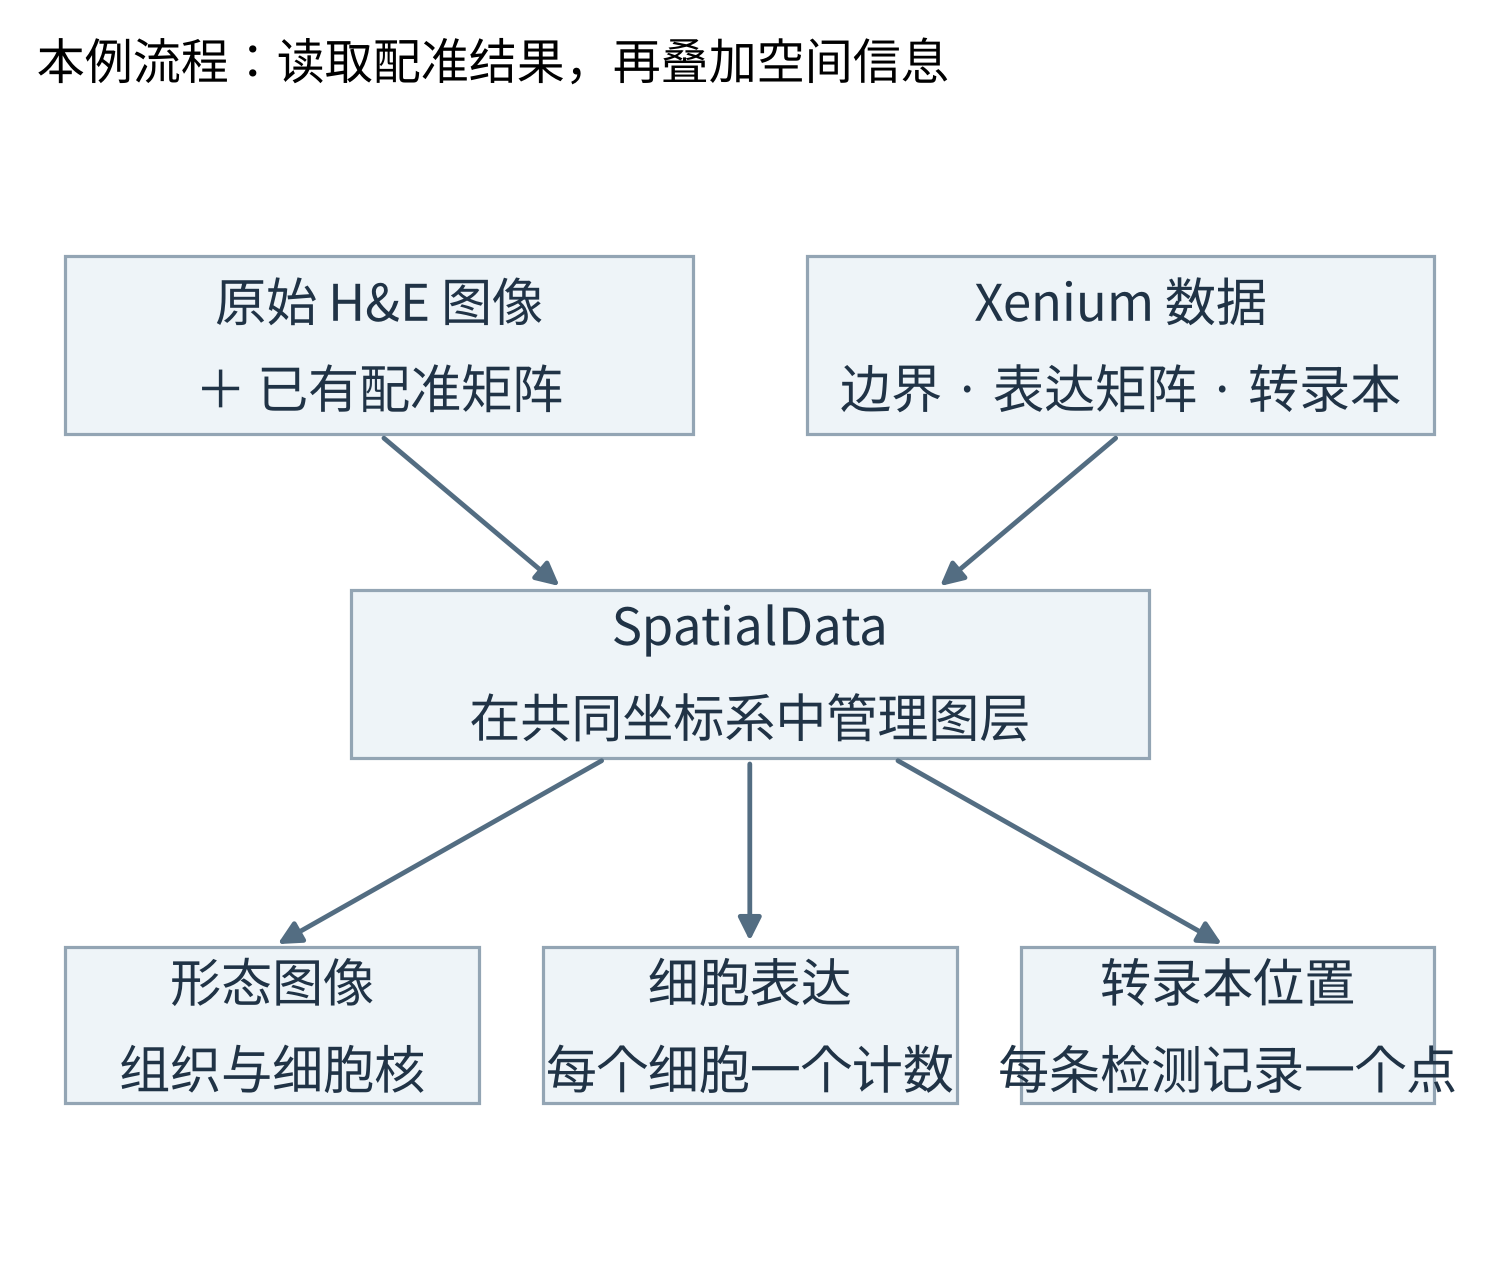
从输入文件到空间绘图的流程
图1|本例使用原始 H&E 和已有配准矩阵,将不同信息放到同一空间参考下展示。流程图中的"细胞表达"和"转录本位置"分别对应细胞级与分子级信息。
接着前文,这里要区分两种情况。若手里是原始 H&E+配准矩阵 ,读取时需要应用该变换;若使用 InSituPy 已经变换并保存的 H&E,则应先核对图像所在坐标系、像素尺寸和方向,避免重复应用原来的变换。本例走第一条路径,使用数据包自带的 *_he_image.ome.tif 和 *_he_imagealignment.csv。配准操作可回看前文。
二、使用 SpatialData 读取配准结果
SpatialData 可以把图像、几何边界、点坐标和表达表放进同一个对象。这里先读取图像、细胞及细胞核边界,暂不加载全部转录本;后面只提取绘图所需的局部记录,减少内存开销。10x 官方也提供了基于这一框架的Python 下游分析教程。
from pathlib import Path
import json
import pandas as pd
import matplotlib.pyplot as plt
import spatialdata_plot
from spatialdata_io import xenium

data_dir = Path("./Xenium_Prime_Human_Lung_Cancer_FFPE")
pixel_size = json.loads(
    (data_dir / "experiment.xenium").read_text()
)["pixel_size"]

sdata = xenium(
    data_dir,
    cells_boundaries=True,
    nucleus_boundaries=True,
    cells_labels=False,
    nucleus_labels=False,
    transcripts=False,
    aligned_images=True,
)注意,aligned_images=True 的作用是读取可用的 H&E/IF 配准信息,不会替我们重新计算图像配准 。文件发现规则与命名有关;使用自己命名的图像时,可通过 xenium_aligned_image() 显式传入路径和矩阵。读取函数说明
接下来,把表达表关联到本次绘图使用的细胞多边形。关键是通过 cell_id 对应,不能假设两个文件中的行顺序相同。
table = sdata.tables["table"]
table.obs["region"] = pd.Categorical(
    ["cell_boundaries"] * table.n_obs
)
sdata.set_table_annotates_spatialelement(
    "table", region="cell_boundaries",
    region_key="region", instance_key="cell_id",
)
这样,后面给 cell_boundaries 指定某个基因时,程序才能找到对应细胞的表达值。这里没有重新做细胞分割,使用的仍是 Xenium 输出的分割结果。
三、选取局部区域,先确认图层对应
直接在全片上展示所有细胞,容易看不清细节。我们先在全景中确定一个 ROI,再对同一区域逐层查看。
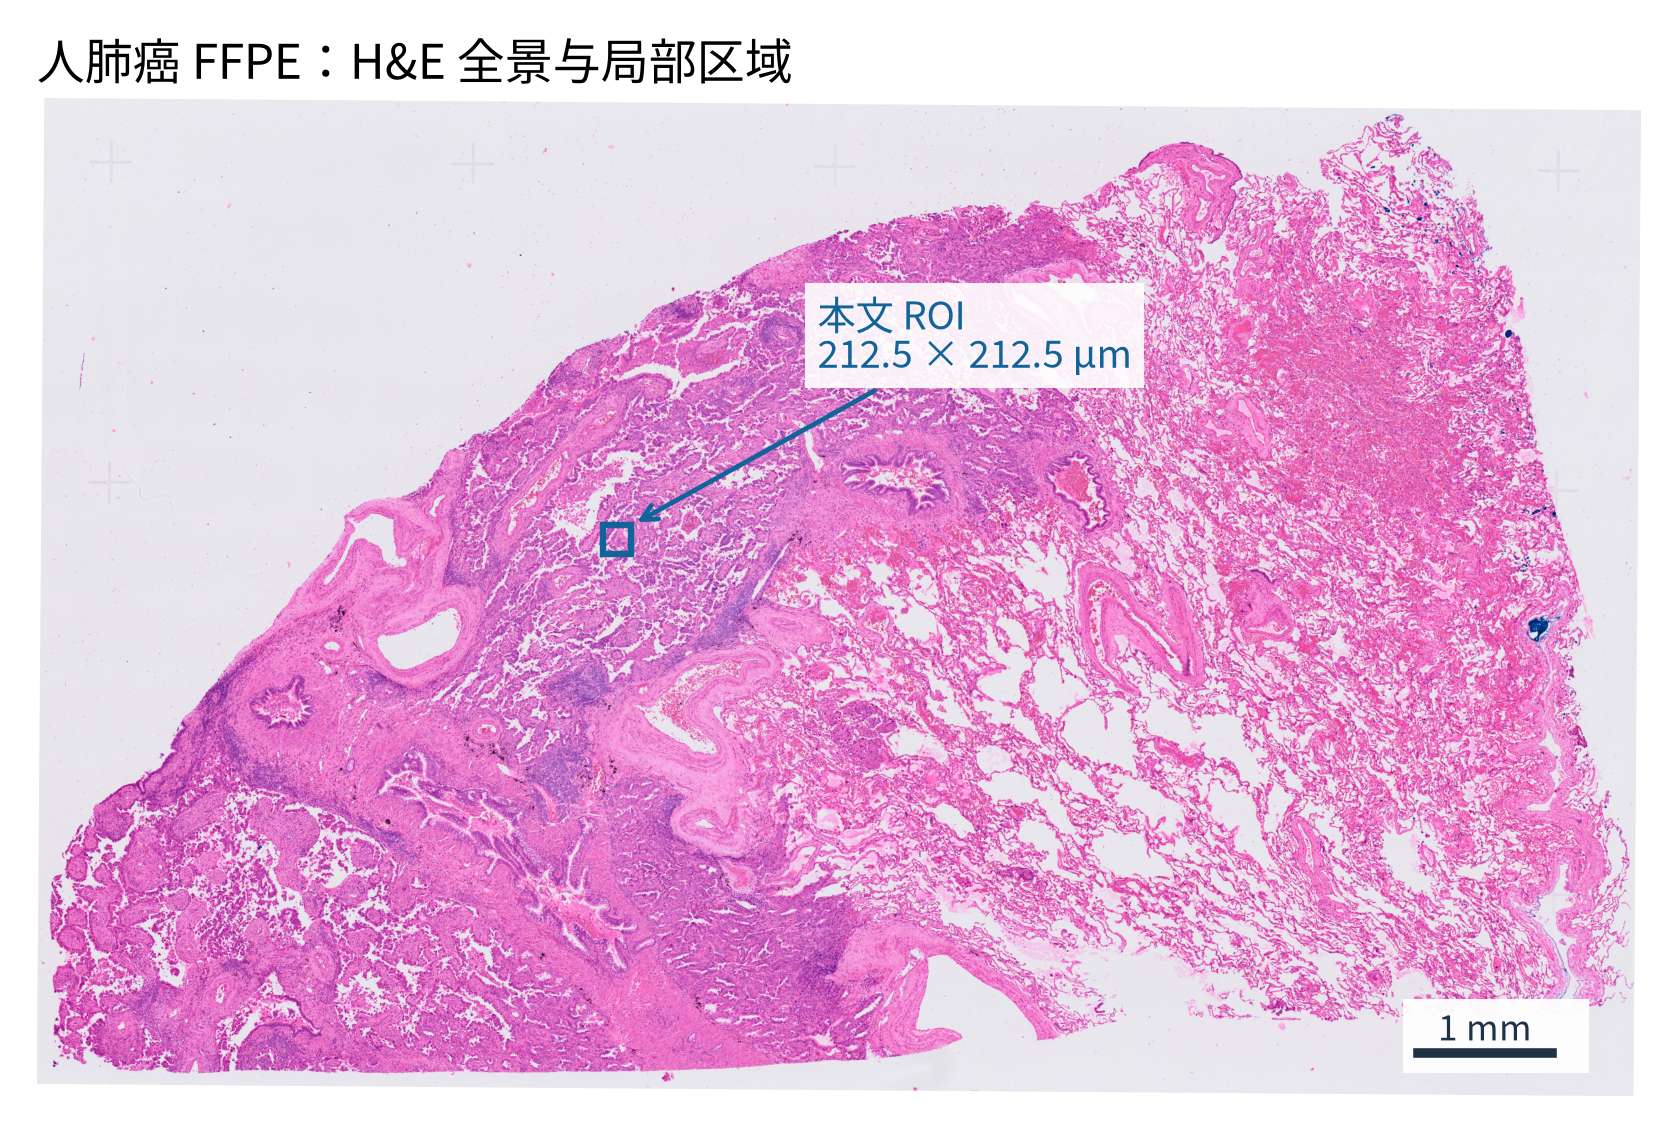
H&E全景与ROI位置
图2|蓝框为本文使用的局部区域。全景用于定位,后续图像均保持相同的 ROI 范围与方向。
from shapely.geometry import box
from spatialdata import polygon_query

xmin, ymin = 19000, 15000
xmax, ymax = 20000, 16000
roi = box(xmin, ymin, xmax, ymax)
sdata_crop = polygon_query(
    sdata, polygon=roi,
    target_coordinate_system="global",
    filter_table=True, clip=True,
)这里有个容易忽略的细节:本例读取器下的 global 使用 Xenium 图像像素坐标,不能把它直接理解为微米。实验文件给出的像素尺寸为 0.2125 µm/px,所以这个 1000 × 1000 像素的区域实际为 212.5 × 212.5 µm。换数据或换读取流程时,应检查变换和单位,而不是照搬这个换算值。
filter_table=True 同步筛选表达表,clip=True 裁切跨越 ROI 边缘的轮廓。本区域保留了 269 个与 ROI 相交的细胞多边形,其中部分细胞只显示一部分,不能把它们都算作完整落在区域内的细胞。
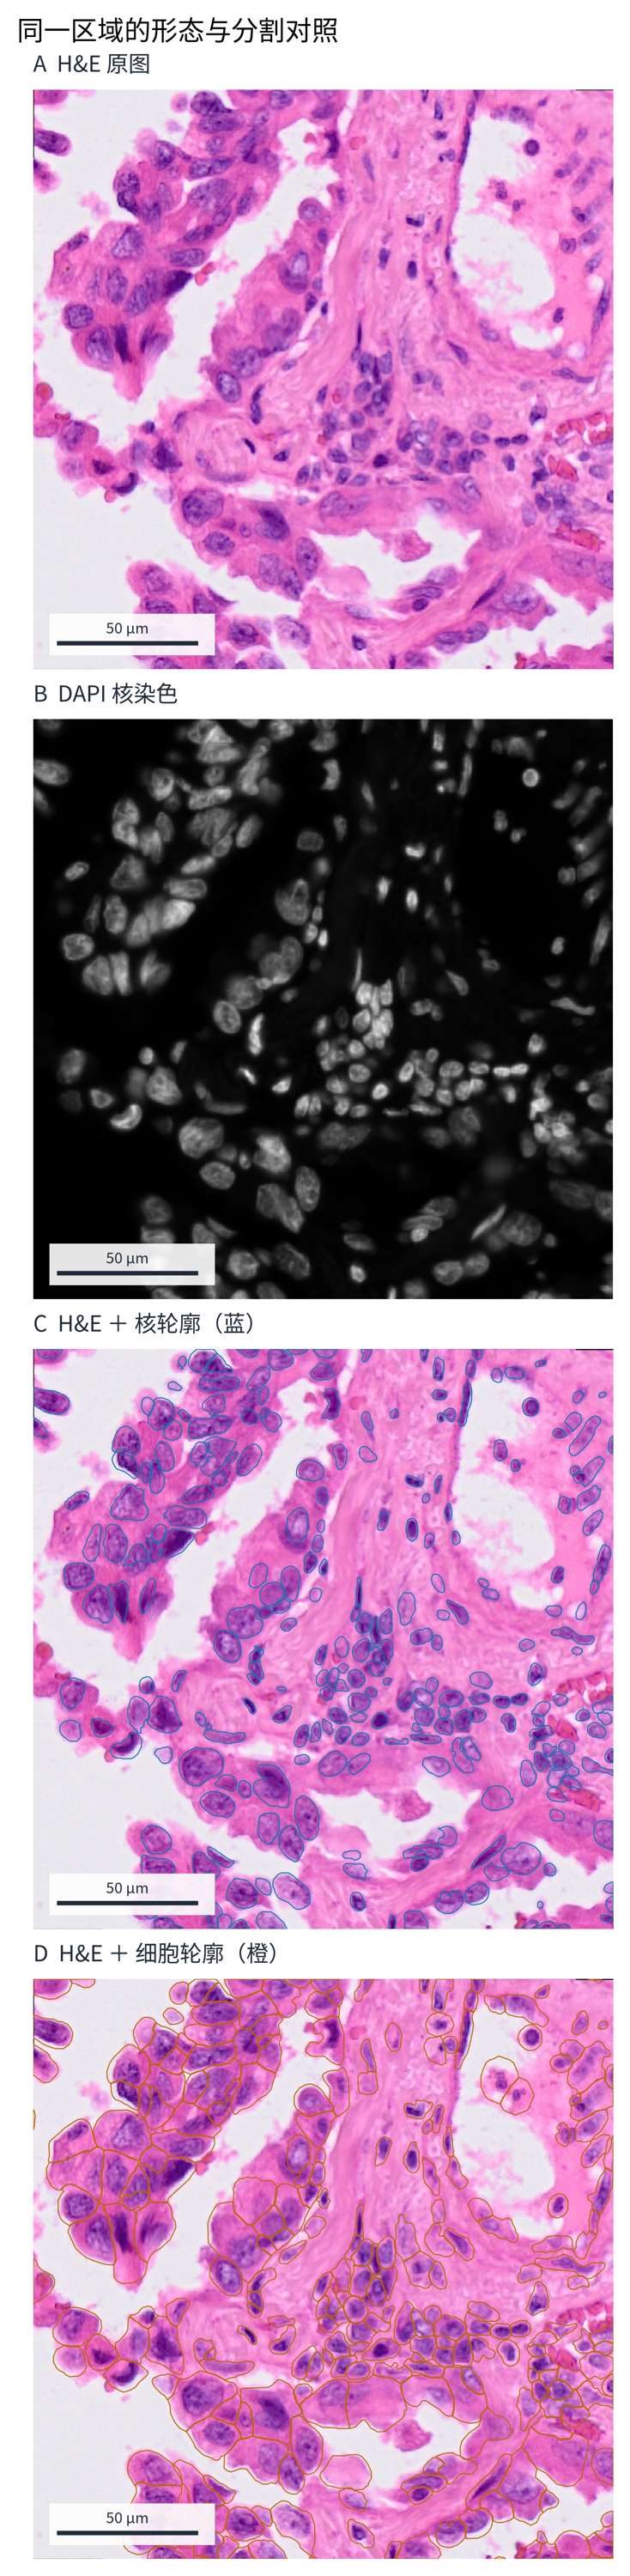
同一区域的H&E、DAPI、核轮廓与细胞轮廓
图3|A:H&E;B:DAPI;C:H&E 叠加蓝色核轮廓;D:H&E 叠加橙色细胞轮廓。核轮廓用于检查核结构对应,细胞轮廓用于后续表达展示。比例尺均为50 µm。
这一步仍需放大检查。核轮廓应与 H&E 中相应的核结构对照;细胞轮廓则包含胞质范围,不能要求它贴住核边缘。图中能看到两种图像的主要结构对应,但局部边缘并非处处重合,也不能用这一块 ROI 代替全片配准误差评估。
四、把基因表达画到细胞所在的位置
下面以 EEF1G 基因表达为例,这里使用表达矩阵中的原始计数,未做总量归一化或对数变换;每个多边形用一种颜色表示对应细胞的计数。
from matplotlib.colors import Normalize

plot_gene = "EEF1G"
values = sdata_crop.tables["table"][:, plot_gene].X
norm = Normalize(vmin=0, vmax=float(values.max()))

sdata_crop.pl.render_images(
    "he_image", alpha=1.0
).pl.render_shapes(
    "cell_boundaries",
    color=plot_gene, table_name="table",
    cmap="magma", norm=norm,
    fill_alpha=0.7,
    outline=True, outline_width=0.35,
    outline_color="white",
).pl.show(
    title="EEF1G expression over H&E",
    coordinate_systems="global",
    figsize=(7, 7), frameon=False,
    scalebar_dx=pixel_size, scalebar_units="um",
)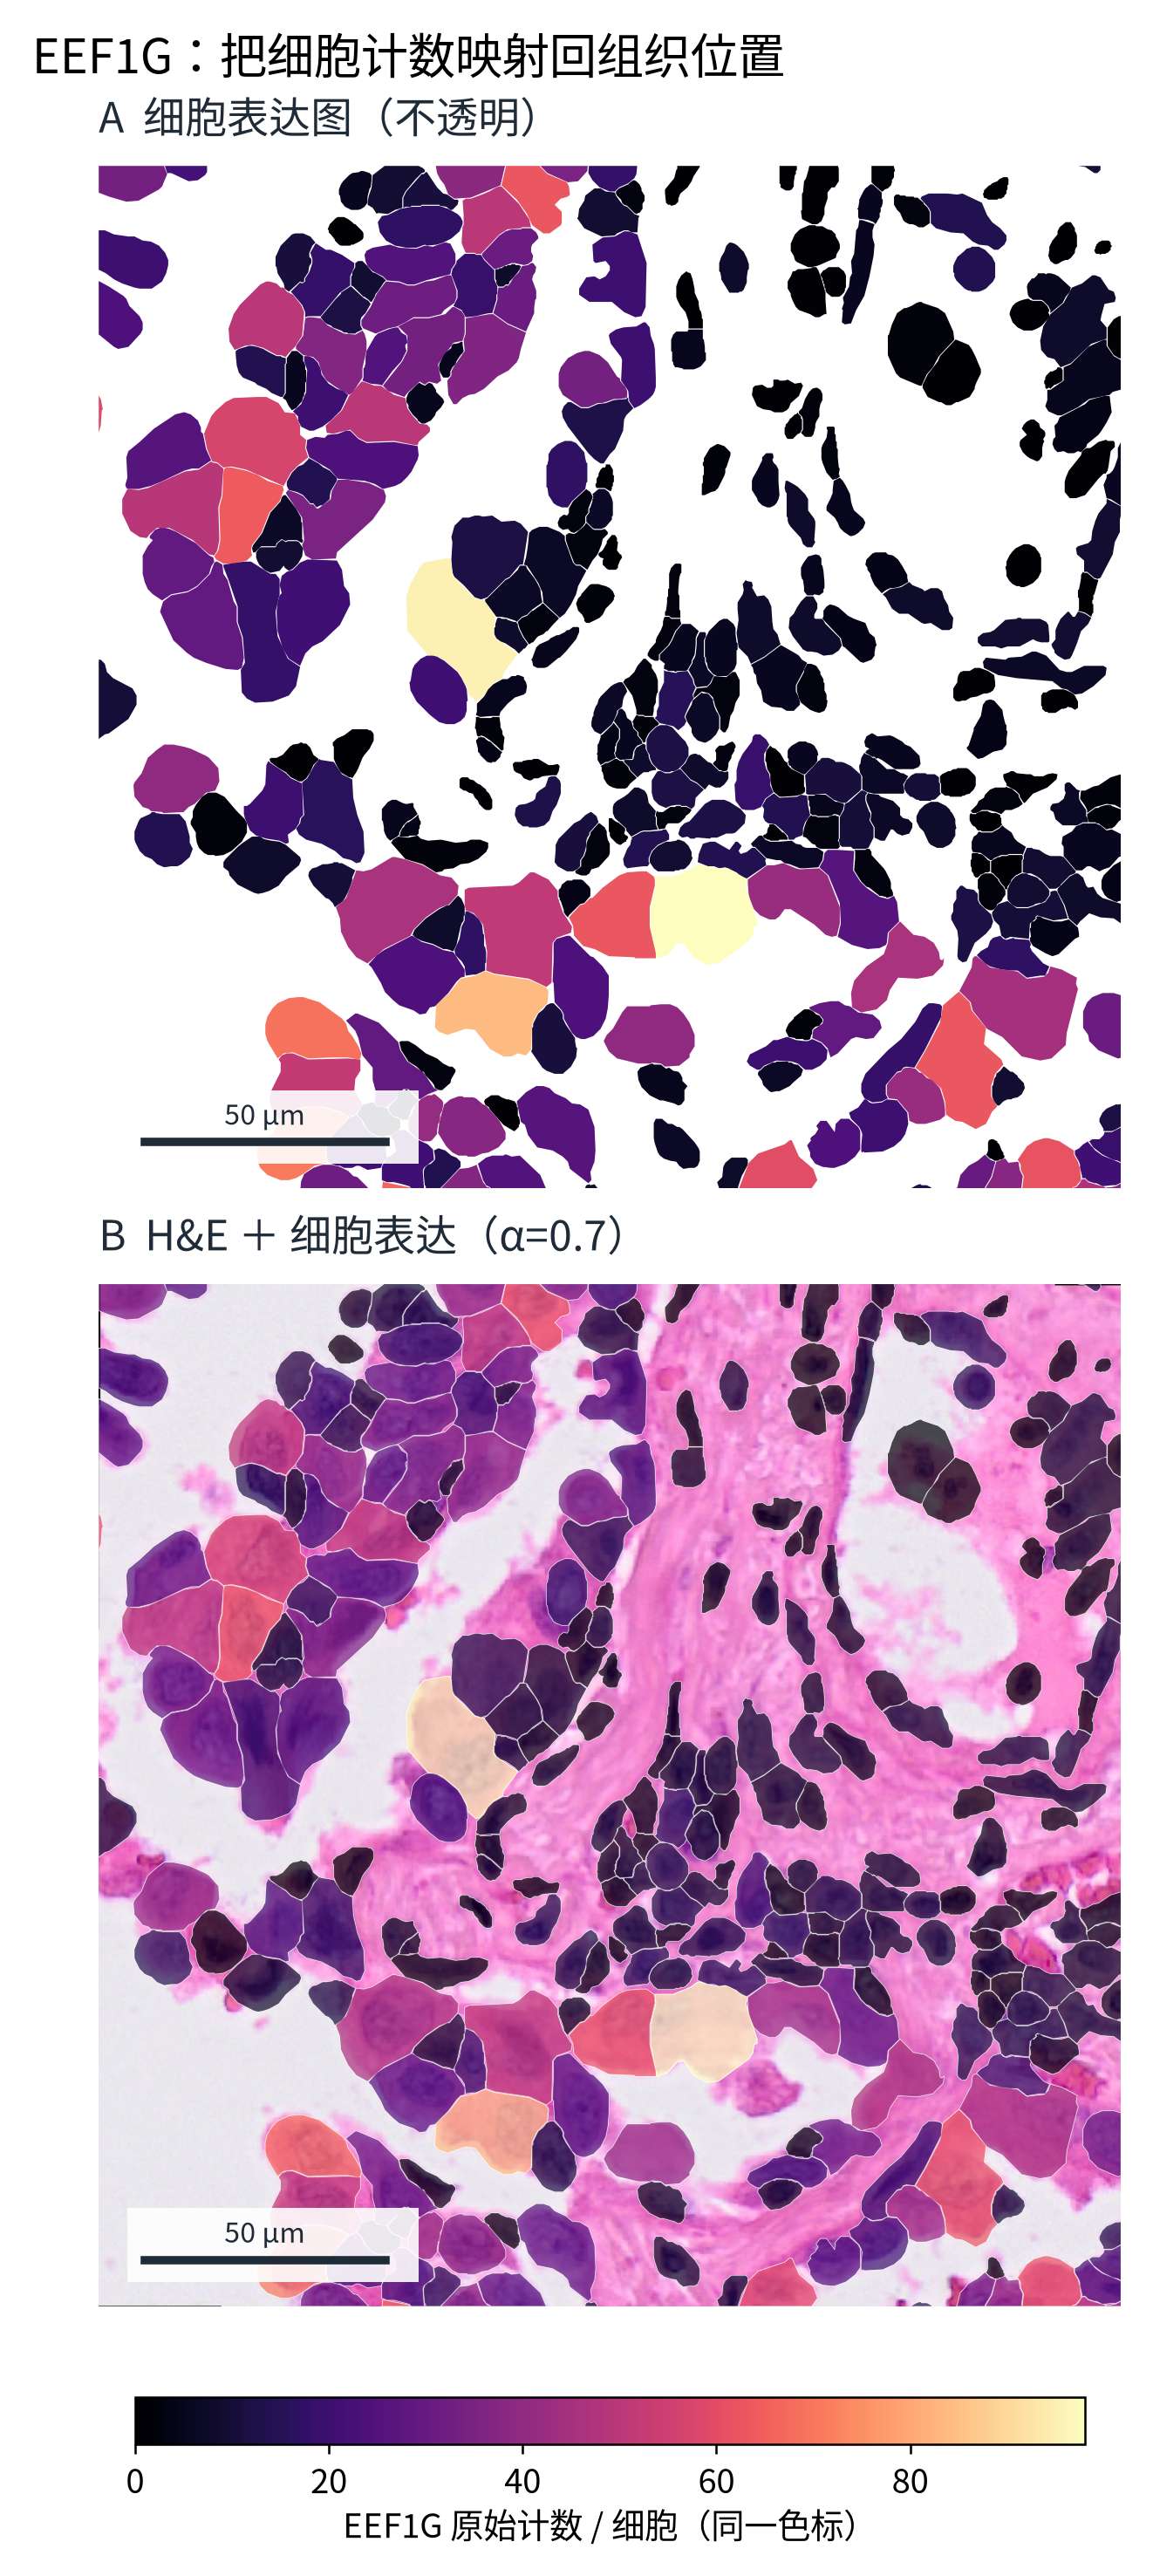
EEF1G独立表达图与H&E叠加图
图4|上图为不透明的细胞表达图,下图叠加 H&E,细胞填充透明度为0.7。两图均使用0---98的计数映射范围。浅色对应较高计数;未覆盖多边形的空白位置不代表存在一个零表达细胞。
两种展示可以配合使用。独立表达图方便比较颜色,叠加图帮助定位这些细胞处于什么组织背景。选用 EEF1G 是为了说明绘图方法,这张图本身不足以定义肿瘤细胞、判定细胞状态或证明某种机制。
另一个细节是,裁切细胞轮廓不会重新计算表达量。图中位于 ROI 边缘的细胞即使只剩半个轮廓,填充的仍是该细胞在原表达矩阵中的计数;若要统计"只落在 ROI 内的分子",应回到转录本坐标计算。
五、透明度可以调整
H&E 自身已有丰富的颜色。细胞填充过实容易遮住组织细节,过淡又不容易看出表达差异。可以固定同一个色标,仅改变 fill_alpha,比较哪种展示更适合当前图片。
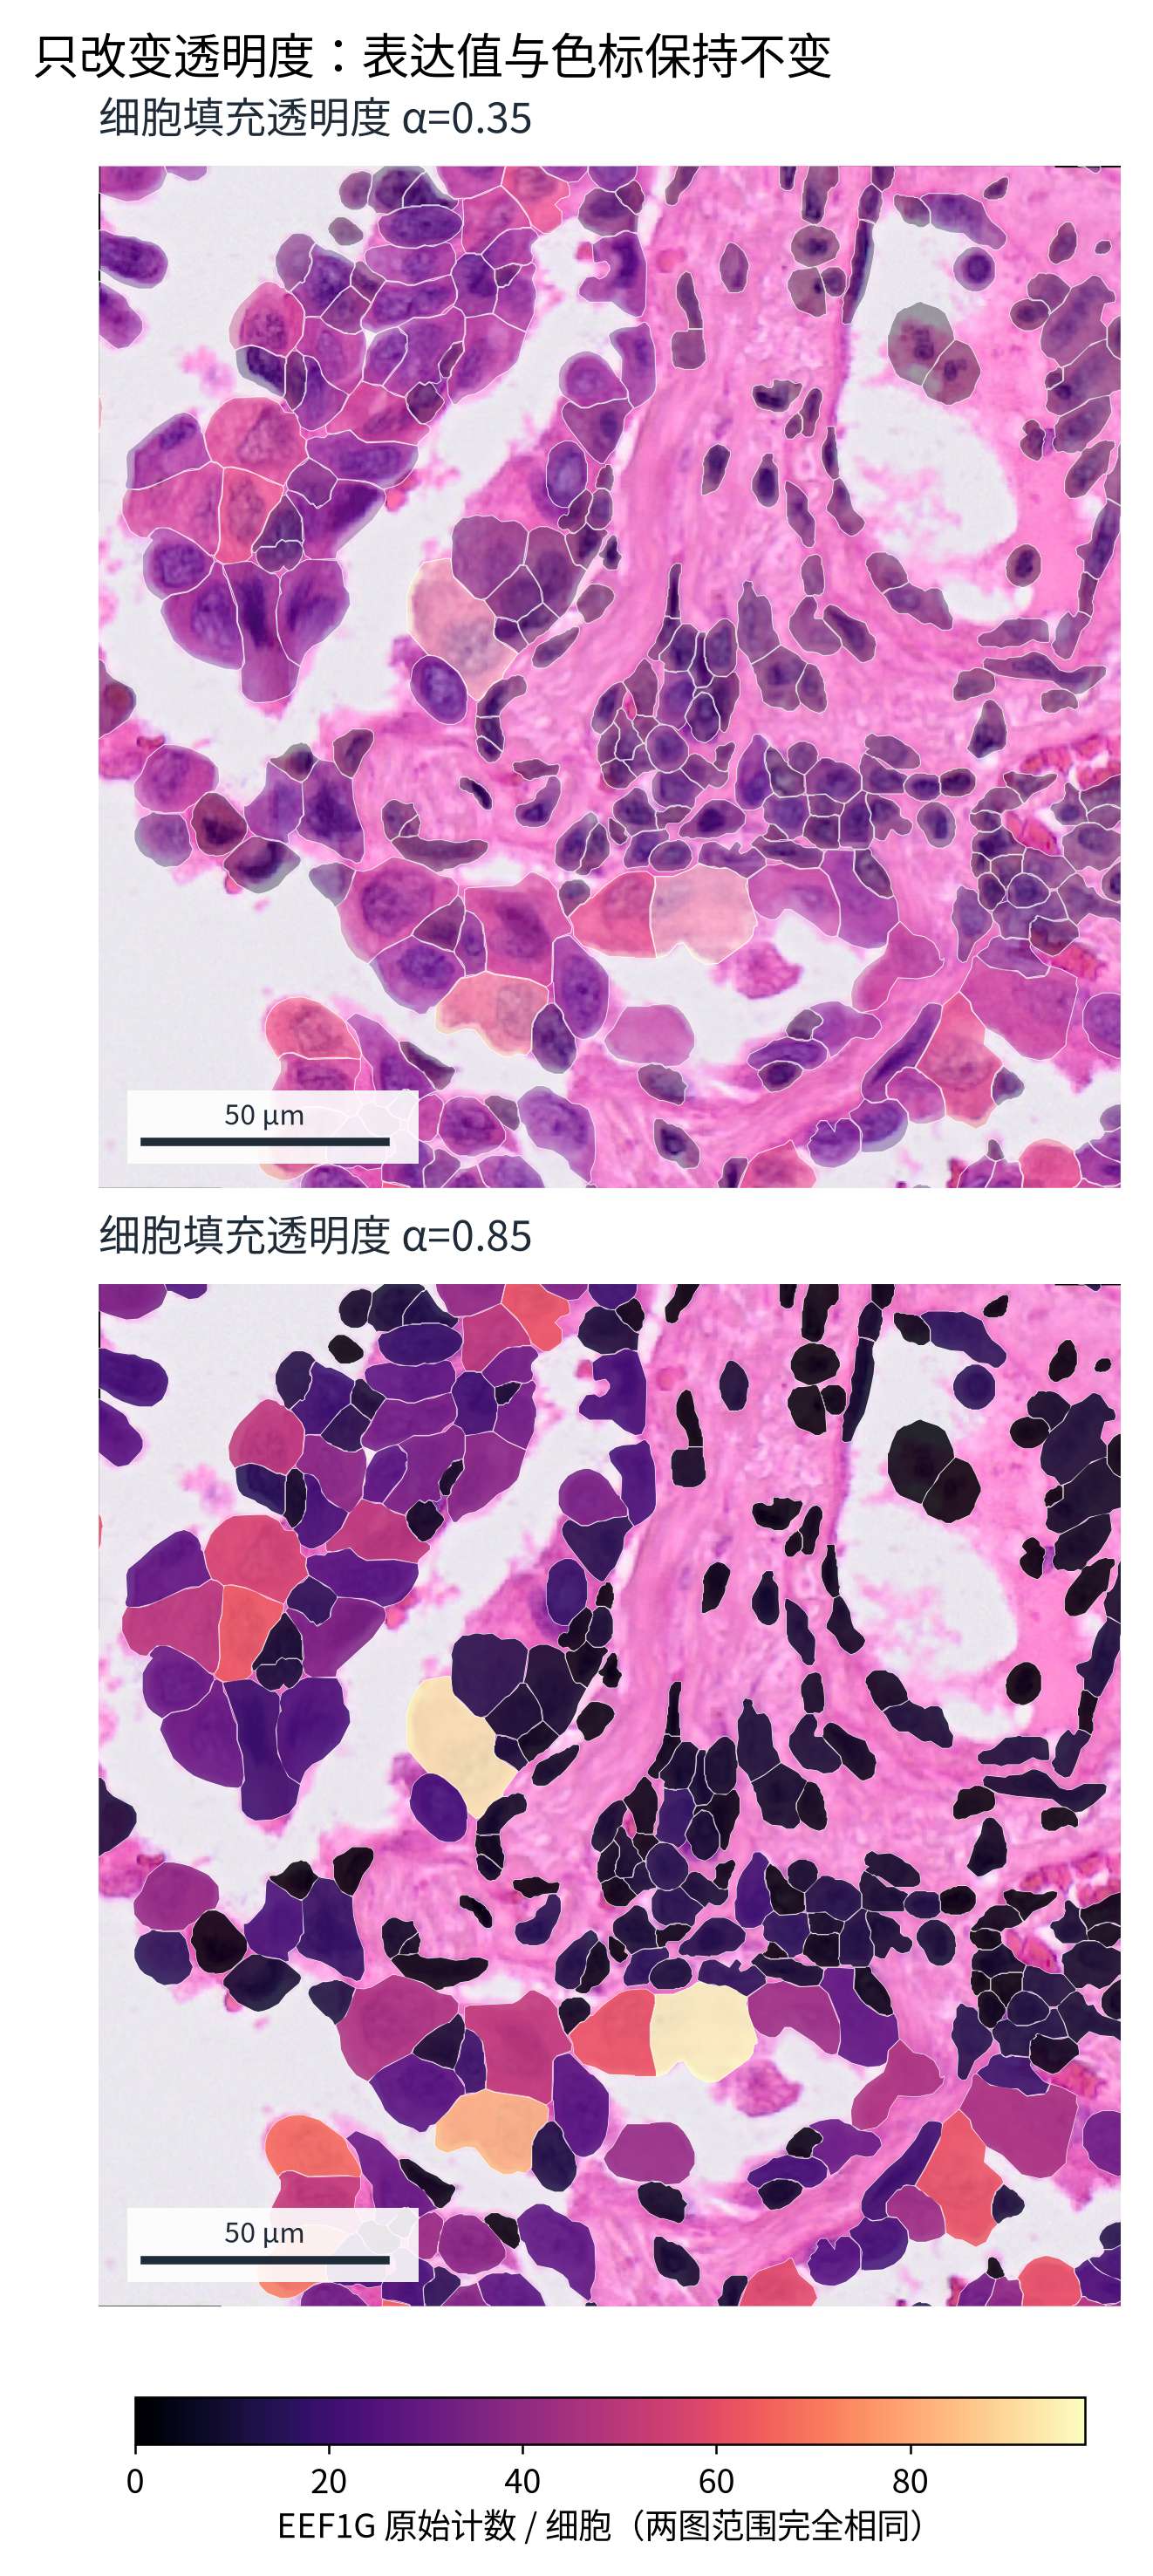
相同数据在不同透明度下的显示
图5|两图使用同一批细胞、同一表达值和同一色标,仅将填充透明度分别设为0.35与0.85。叠加后的颜色受背景影响,不能把透明度差异理解为表达变化。
还可以 PercentileNormalize(1, 99)。它调整的是颜色显示范围,使少量极端值不至于压缩大多数细胞的视觉差异,并没有完成细胞表达矩阵的归一化。用于展示时应说明百分位设置;同一基因跨 ROI 或跨样本比较时,应使用明确且可比较的处理流程与色标,避免各图自动缩放后产生误导。
六、进一步叠加单分子转录本
细胞表达图把分子数汇总到细胞,而转录本点图保留每条检测记录的位置。下面从 transcripts.parquet 提取同一 ROI 内的 EEF1G 和 EPCAM,并筛选 Q-score ≥ 20 的基因转录本。
import pyarrow.parquet as pq

tx = pq.read_table(
    data_dir / "transcripts.parquet",
    columns=["feature_name", "x_location", "y_location", "qv"],
    filters=[
        ("feature_name", "in", ["EEF1G", "EPCAM"]),
        ("is_gene", "==", True), ("qv", ">=", 20),
        ("x_location", ">=", xmin * pixel_size),
        ("x_location", "<", xmax * pixel_size),
        ("y_location", ">=", ymin * pixel_size),
        ("y_location", "<", ymax * pixel_size),
    ],
).to_pandas()
转录本文件中的 X、Y 以微米表达,叠加到本例 global 图层时,需要除以像素尺寸,转回 Xenium 像素坐标。例如展示 EPCAM:
fig, ax = plt.subplots(figsize=(7, 7))
sdata_crop.pl.render_images("he_image", alpha=0.55).pl.show(
    ax=ax, coordinate_systems="global", show=False,
    title="EPCAM transcripts over H&E", colorbar=False,
    scalebar_dx=pixel_size, scalebar_units="um",
)
gene_tx = tx[tx["feature_name"] == "EPCAM"]
ax.scatter(
    gene_tx["x_location"] / pixel_size,
    gene_tx["y_location"] / pixel_size,
    s=4, color="#a65c00", linewidths=0,
)
ax.set_xlim(xmin, xmax)
ax.set_ylim(ymax, ymin)
ax.set_aspect("equal")
ax.axis("off")
plt.show()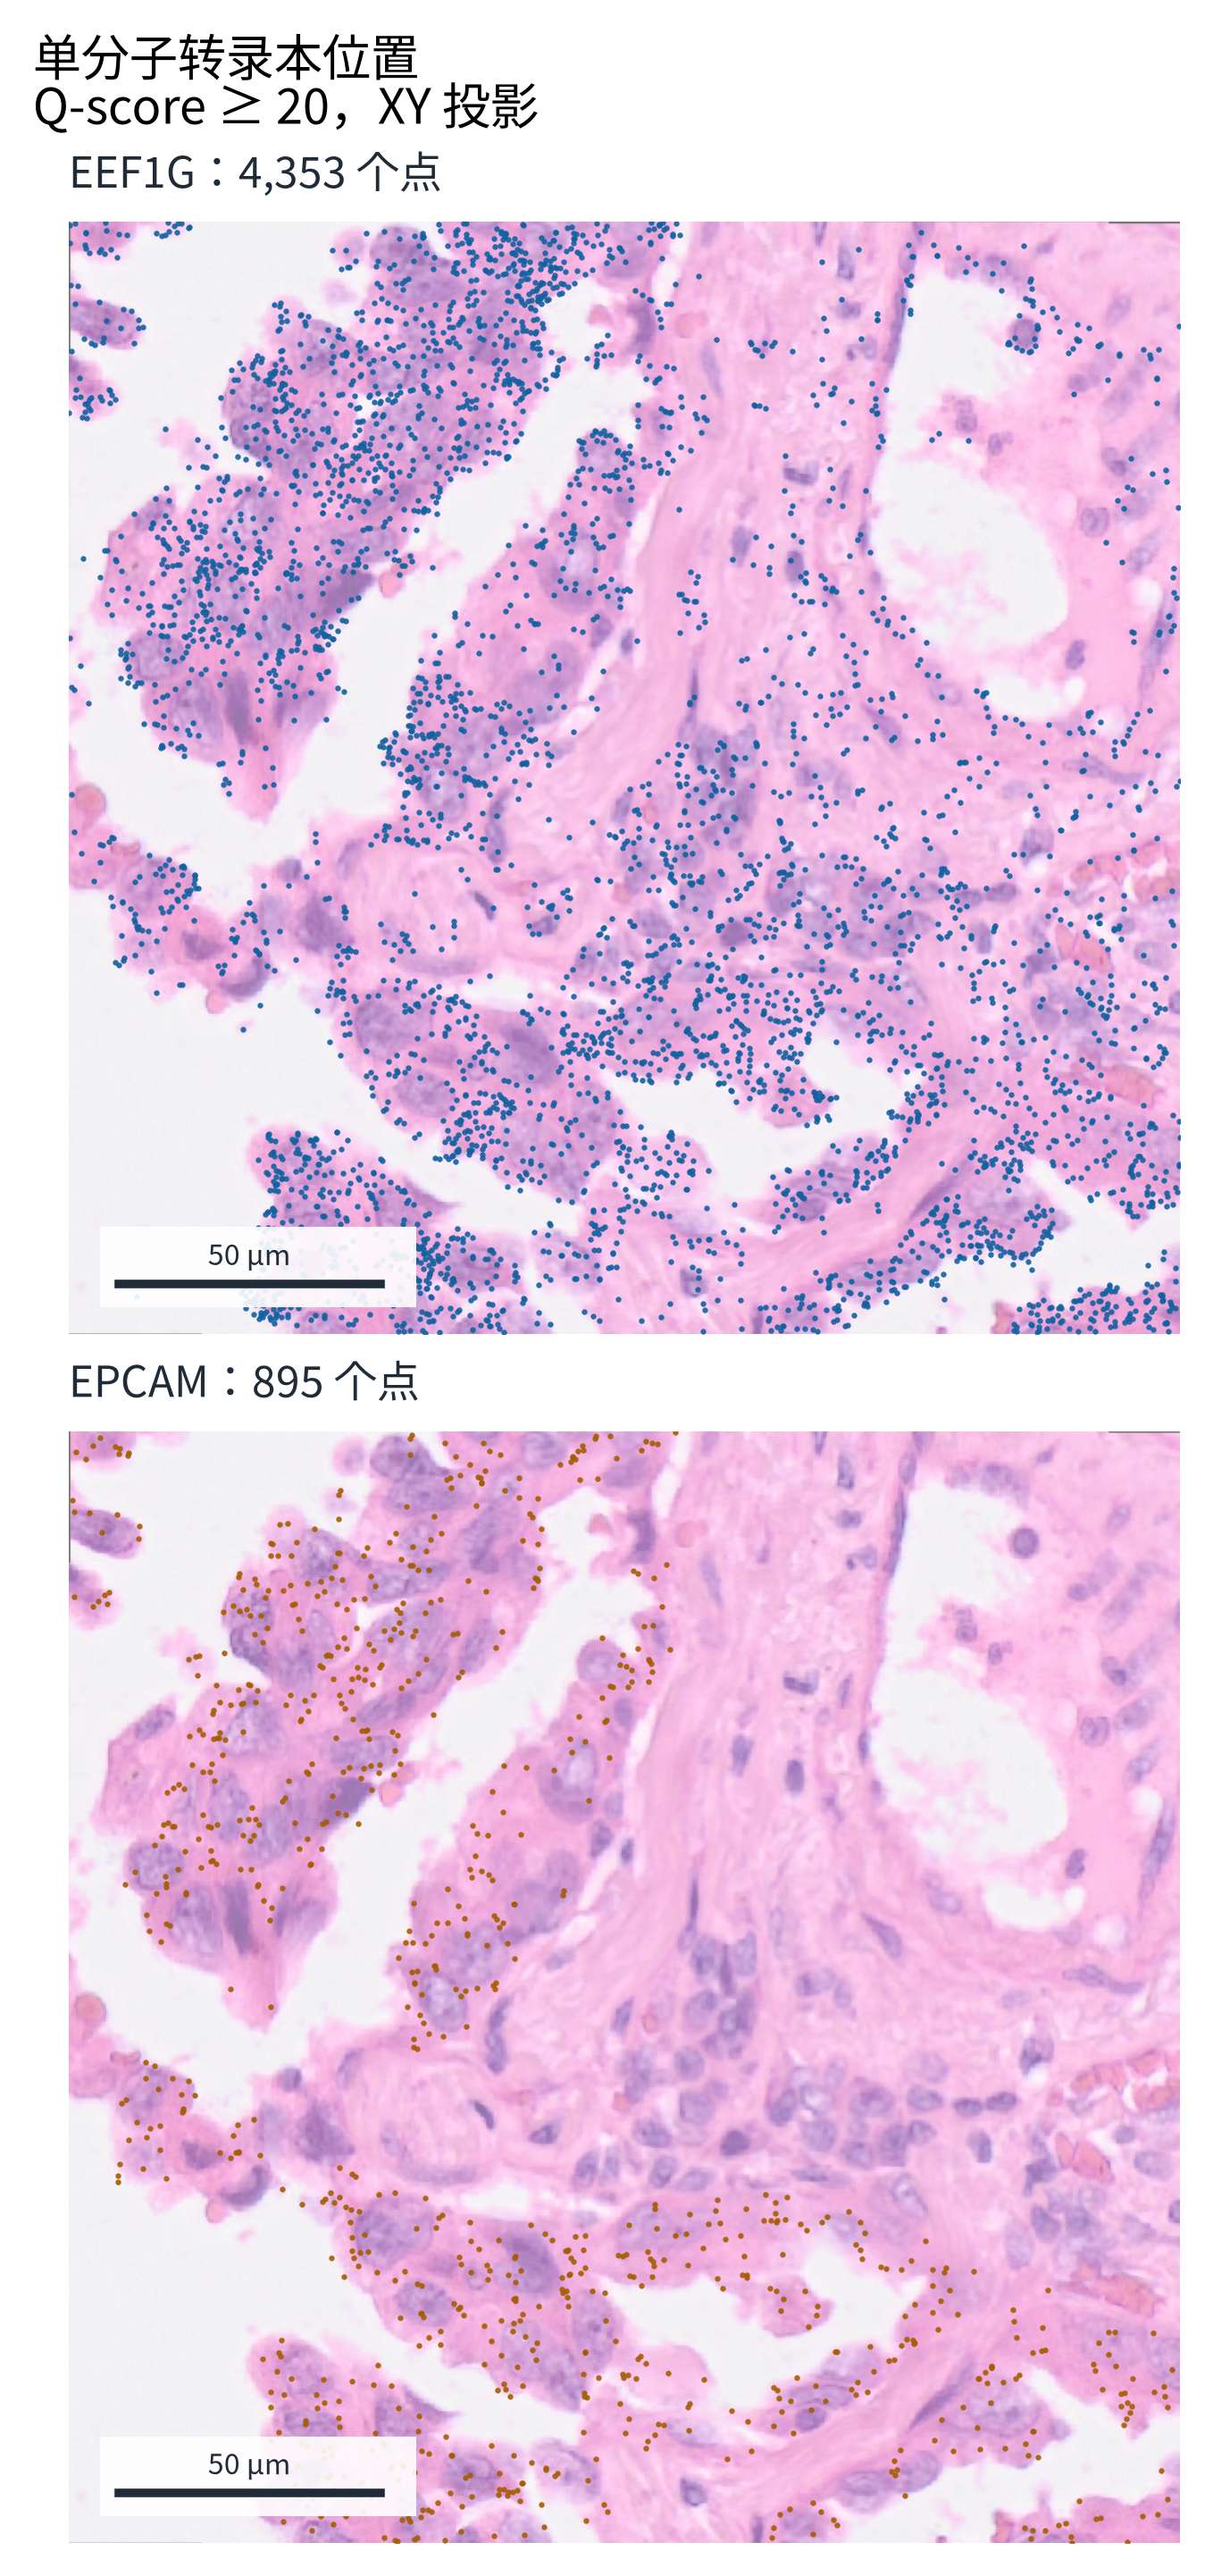
EEF1G与EPCAM的转录本位置
图6|同一区域内,EEF1G为4,353条、EPCAM为895条符合筛选条件的转录本记录。所有Z位置投影到XY平面,未随机抽样;每点代表一条记录,点的显示尺寸不表示分子的真实大小。
点图可以帮助观察分子信号与组织结构的对应关系,也能辅助检查细胞分割与转录本归属。这里保留了 ROI 内符合条件的记录,未额外要求它们必须归属于某个细胞。因此,点数既不能直接等同于细胞数,也不应与相交细胞的完整表达计数求和强行对应。
至此,我们把前文的配准结果接到了具体绘图流程:先用轮廓检查位置关系,再展示细胞级表达,最后查看分子级坐标。以后有经过核实的细胞类型注释,也可以按 cell_id 写回表达表,用类别颜色展示细胞分布;本例尚未完成这一步,图中的表达颜色不代表细胞类型。
完整代码和独立图片随文整理。实际使用时,替换数据路径、ROI范围和目标基因即可开始检查;涉及定量比较时,还要单独考虑分割质量、细胞大小、检测总量与样本重复。
数据与参考
-
数据与组织图像:10x Genomics,Post-Xenium Technical Note,Experiment 2,CC BY 4.0。本文根据该数据重新裁切、叠加和绘图。
-
Python流程:10x Xenium downstream analysis in Python。