7> 🔥作者:it毕设实战小研🔥
💖简介:java、微信小程序、安卓;定制开发,远程调试 代码讲解,文档指导,ppt制作💖
精彩专栏推荐订阅:在下方专栏👇🏻👇🏻👇🏻👇🏻
💕💕文末获取源码
文章目录
- 1、基于大数据的人工智能社交媒体情绪分析与可视化分析设计与实现-前言介绍
-
- 1.1背景
- 1.2课题功能、技术
- [1.3 意义](#1.3 意义)
- 2、基于大数据的人工智能社交媒体情绪分析与可视化分析设计与实现-研究内容
- 3、基于大数据的人工智能社交媒体情绪分析与可视化分析设计与实现-开发技术与环境
- 4、基于大数据的人工智能社交媒体情绪分析与可视化分析设计与实现-功能介绍
- 5、基于大数据的人工智能社交媒体情绪分析与可视化分析设计与实现-论文参考
- 6、基于大数据的人工智能社交媒体情绪分析与可视化分析设计与实现-成果展示
- 7、代码展示
- 8、结语(文末获取源码)
本次文章主要是介绍基于大数据的人工智能社交媒体情绪分析与可视化的设计与实现
1、基于大数据的人工智能社交媒体情绪分析与可视化分析设计与实现-前言介绍
1.1背景
随着互联网平台和移动社交应用的快速发展,社交媒体中每天产生大量包含文字、话题、评论、转发和用户属性的信息。这些文本数据不仅规模庞大,而且具有内容复杂、表达随意、情绪隐含性强等特点,其中包含正负面情绪、讽刺表达、垃圾信息、毒理内容以及不同话题下的情感倾向。传统依靠人工阅读和统计分析的方式效率较低,难以同时完成海量数据处理、情绪特征提取和多维度结果展示;现有部分分析系统又存在数据维度单一、平台对比能力不足、分析结果不直观等问题。因此,本课题设计并开发一个基于大数据的社交媒体文本情绪识别与可视化分析系统,对社交媒体文本进行统一处理和分析,挖掘文本情绪、内容质量、用户属性和互动行为之间的潜在关系,并通过图表和可视化大屏直观呈现分析结果,为社交媒体舆情监测和内容治理提供数据支持。
1.2课题功能、技术
本系统采用Python作为主要开发语言,利用Hadoop完成海量数据的分布式存储,使用Spark实现社交媒体文本数据的清洗、去重、分词、特征提取和聚类分析,并通过Hive构建数据仓库,实现数据的分层存储与快速查询。在文本分析方面,利用K-means聚类算法对文本向量及相关情感特征进行聚类,辅助发现不同情绪和内容类型的数据群体。在系统实现方面,后端采用Django框架,为前端提供数据查询和统计分析接口;前端采用Vue框架,结合Echarts实现交互式图表和大屏展示;MySQL用于保存用户信息、分析结果及系统业务数据。系统主要实现讽刺占比、垃圾占比、情感占比、极性占比、毒理分布、话题情感分布、平台情感对比、平台极性对比、平台热门话题率、用户地区极性、粉丝规模与互动、语言与情感分析以及认证与极性关系等功能,同时实现月度极性演进、讽刺内容互动象形、毒理等级分布、极性评论分享画像、话题极性层级、标签共现关系、周内互动趋势和垃圾内容互动率等大屏可视化功能。
1.3 意义
本课题的研究与实现具有一定的理论价值和实际应用意义。从理论层面看,系统将大数据处理技术、文本情绪分析方法、聚类算法和数据可视化技术结合起来,构建了一个较为完整的社交媒体文本分析流程,为相关领域的数据处理和情感分析系统设计提供参考。从应用层面看,系统可以将分散、复杂且难以理解的社交媒体文本转化为直观的统计指标、趋势图表和关联关系,帮助管理人员快速了解不同平台、不同地区、不同话题和不同用户群体的情绪特征,及时发现负面情绪集中、毒理内容增加或垃圾信息传播等异常情况。同时,系统还能够辅助平台开展舆情监测、内容审核、用户运营和公共管理,提高社交媒体数据的利用效率和分析决策能力。
2、基于大数据的人工智能社交媒体情绪分析与可视化分析设计与实现-研究内容
(1)数据采集与清洗:通过网络公开数据、平台数据接口或已有数据集采集社交媒体文本、发布时间、平台、用户地区、粉丝数量、互动数据及标签信息,并利用Python、Hadoop和Spark完成去重、去空值、异常值处理、文本规范化和分词,为后续分析提供可靠数据。
(2)数据分析与可视化:基于Hive和Spark对清洗后的数据进行统计分析,重点研究讽刺、垃圾、毒理、情感极性、热门话题及用户属性等指标,并通过Django接口向Vue前端提供数据,结合Echarts实现图表和可视化大屏展示。
(3)模型设计与训练:采用K-means聚类算法对社交媒体文本进行特征提取和聚类分析,利用分词、词频统计及TF-IDF方法构建文本向量,通过设置合理的聚类数量完成模型训练,并结合聚类结果分析不同文本群体的情感特征。
(4)系统功能设计:系统采用前后端分离模式,后端使用Django实现数据查询、统计分析和接口服务,前端使用Vue和Echarts实现交互式页面及大屏展示,MySQL负责保存用户、文本、分析结果和系统运行相关数据。
(5)系统测试与优化:通过功能测试、接口测试、数据准确性测试、页面兼容性测试和系统性能测试,验证数据分析、模型聚类及可视化功能是否正常运行,并针对查询速度、页面响应、数据展示和异常操作进行优化,提高系统的稳定性和实用性。
3、基于大数据的人工智能社交媒体情绪分析与可视化分析设计与实现-开发技术与环境
- 开发语言:Python
- 大数据技术:hadoop、spark、hive
- 框架:Django后端框架、Vue前端框架、Echarts可视化
- 机器学习算法:K-means聚类分析
- 软件工具:Pycharm
- 数据库:MySQL
4、基于大数据的人工智能社交媒体情绪分析与可视化分析设计与实现-功能介绍
1个角色:管理员
可视化分析:
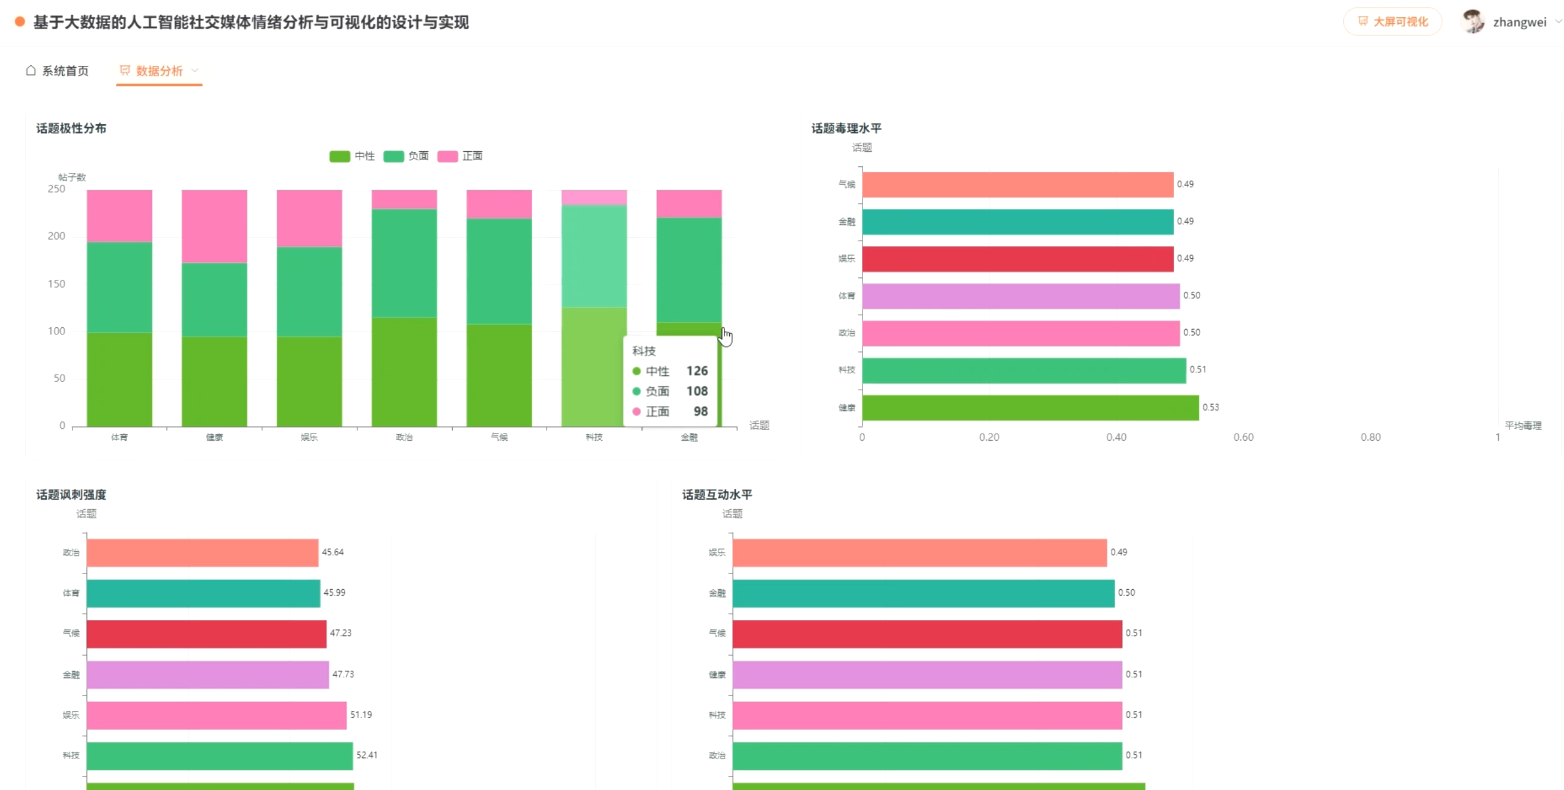
数据分析:讽刺占比分析、垃圾占比分析、情感占比分析、极性占比分析、毒理分布分析、话题情感分布、平台情感对比、平台极性对比、平台热门话题率、用户地区极性、粉丝规模与互动、语言与情感分析、认证与极性关系
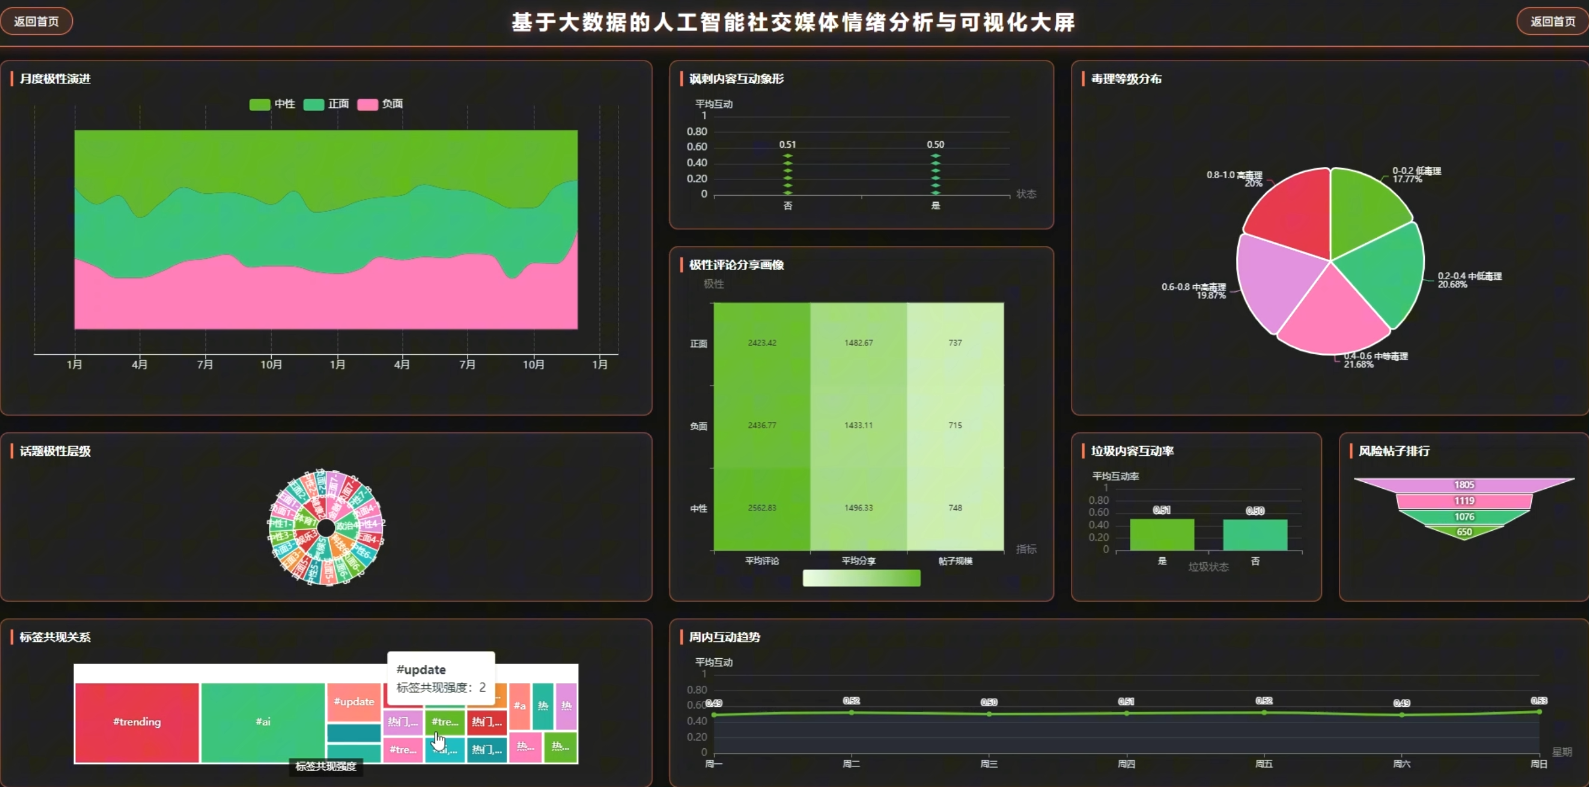
大屏可视化分析:月度极性演进、讽刺内容互动象形、毒理等级分布、极性评论分享画像、话题极性层级、标签共现关系、周内互动趋势、垃圾内容互动率
5、基于大数据的人工智能社交媒体情绪分析与可视化分析设计与实现-论文参考
6、基于大数据的人工智能社交媒体情绪分析与可视化分析设计与实现-成果展示
6.1演示视频
6.2演示图片
☀️数据分析☀️
☀️大屏可视化☀️
7、代码展示
1.基于K-means的文本情感聚类分析功能【代码如下(示例):】
bash
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, udf, length
from pyspark.sql.types import StringType
from pyspark.ml.feature import RegexTokenizer, HashingTF, IDF
from pyspark.ml.clustering import KMeans
import jieba

spark = SparkSession.builder \
    .appName("SocialEmotionKMeans") \
    .enableHiveSupport() \
    .getOrCreate()

raw_data = spark.sql("""
    SELECT id, platform, text
    FROM social_text
    WHERE text IS NOT NULL
      AND length(trim(text)) > 0
""")

def segment_text(sentence):
    return " ".join(jieba.cut(sentence))

segment_udf = udf(segment_text, StringType())

clean_data = raw_data.withColumn(
    "text_cut", segment_udf(col("text"))
).where(length(col("text_cut")) > 0)

tokenizer = RegexTokenizer(
    inputCol="text_cut",
    outputCol="words",
    pattern="\\s+"
)

word_data = tokenizer.transform(clean_data)

hashing_tf = HashingTF(
    inputCol="words",
    outputCol="raw_features",
    numFeatures=262144
)

tf_data = hashing_tf.transform(word_data)

idf = IDF(
    inputCol="raw_features",
    outputCol="features",
    minDocFreq=2
)

idf_model = idf.fit(tf_data)
vector_data = idf_model.transform(tf_data)

kmeans = KMeans(
    k=4,
    seed=42,
    featuresCol="features",
    predictionCol="cluster_id",
    maxIter=30
)
2.平台情感对比可视化功能【代码如下(示例):】
bash
from django.http import JsonResponse
from django.db import connection
from django.views.decorators.http import require_GET

@require_GET
def platform_emotion_compare(request):
    sql = """
        SELECT
            platform,
            SUM(CASE WHEN polarity = 'positive' THEN 1 ELSE 0 END) AS positive_count,
            SUM(CASE WHEN polarity = 'neutral' THEN 1 ELSE 0 END) AS neutral_count,
            SUM(CASE WHEN polarity = 'negative' THEN 1 ELSE 0 END) AS negative_count,
            COUNT(*) AS total_count
        FROM social_text
        WHERE platform IS NOT NULL
          AND polarity IS NOT NULL
        GROUP BY platform
        ORDER BY platform
    """

    with connection.cursor() as cursor:
        cursor.execute(sql)
        rows = cursor.fetchall()

    categories = []
    positive_data = []
    neutral_data = []
    negative_data = []

    for row in rows:
        platform = row[0]
        positive = int(row[1] or 0)
        neutral = int(row[2] or 0)
        negative = int(row[3] or 0)
        total = int(row[4] or 0)

        categories.append(platform)
        positive_data.append(positive)
        neutral_data.append(neutral)
        negative_data.append(negative)

    result = {
        "categories": categories,
        "series": [
            {
                "name": "正面情感",
                "type": "bar",
                "data": positive_data
            }
8、结语(文末获取源码)
💕💕
💟💟如果大家有任何疑虑,或者对这个系统感兴趣,欢迎点赞收藏、留言交流啦!
💟💟欢迎在下方位置详细交流。
🔥作者:it毕设实战小研🔥
💖简介:java、微信小程序、安卓;定制开发,远程调试 代码讲解,文档指导,ppt制作💖
精彩专栏推荐订阅:在下方专栏👇🏻👇🏻👇🏻👇🏻