论文题目:Cylindrical and Asymmetrical 3D Convolution Networks for LiDAR Segmentation (用于 LiDAR 分割的柱面划分与非对称 3D 卷积网络)
会议:CVPR 2021
摘要:大规模驾驶场景中的 LiDAR 语义分割方法通常先把点云投影到二维空间,再使用 2D 卷积处理。虽然这类方法具有较强竞争力,但二维投影不可避免地会改变甚至丢失原始三维拓扑与几何关系。一个自然的替代方案是采用 3D 体素化和 3D 卷积网络,但作者发现,直接这样做在室外点云上的性能提升仍然有限,一个重要原因是室外点云具有明显的稀疏性和密度变化。为此,论文提出新的室外 LiDAR 分割框架,通过柱面划分和非对称 3D 卷积网络,在保留三维几何结构的同时适应这些固有特性;同时加入逐点细化模块,以缓解体素标签编码造成的信息损失。该方法在 SemanticKITTI 和 nuScenes 上进行评估,在 SemanticKITTI 排行榜取得第 1 名,并在 nuScenes 上相较已有方法获得约 4% 的明显提升。进一步实验表明,该框架还可以推广到 LiDAR 全景分割和 3D 目标检测。
源码:https://github.com/xinge008/Cylinder3D
一、研究背景与核心问题
LiDAR 语义分割的目标是给每个激光点预测语义类别。室外场景真正棘手的地方在于:点云不仅稀疏,而且密度会随距离显著变化,近处点密、远处点稀。
论文讨论了两条常见路线。二维投影方法把点云变成 Range Image 或鸟瞰图,再使用 2D CNN,效率较高,但会改变三维几何关系;规则体素方法则保留 3D 结构,却默认空间划分相对均匀,远距离区域因此容易产生大量空体素。
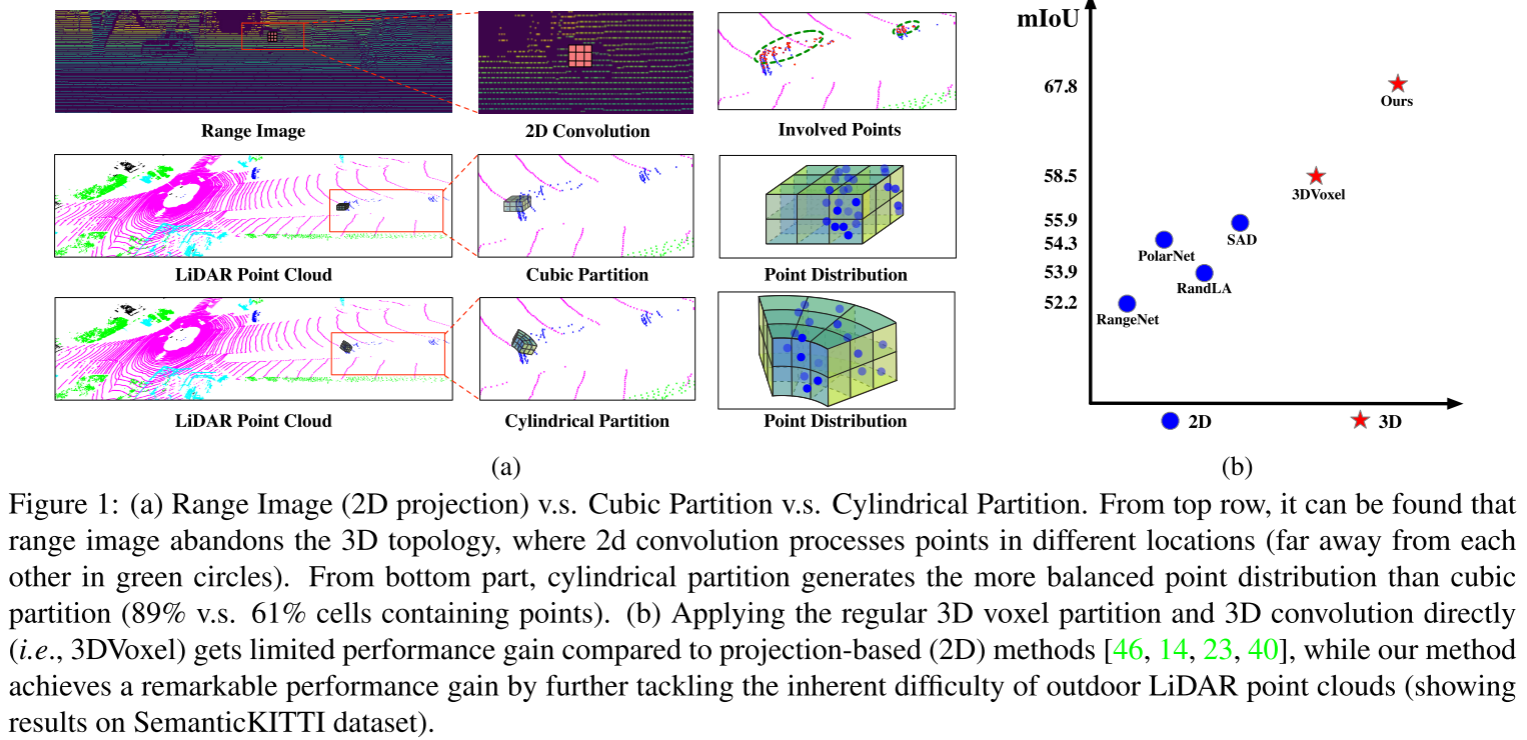
论文 Figure 1:Range Image、规则立方体划分与柱面划分的对比,以及不同方法在 SemanticKITTI 上的性能位置
Figure 1 给出了论文最核心的动机:二维投影可能把空间上相距很远的点变成二维邻居,而柱面划分能得到更均衡的点分布。论文统计中,柱面划分有点的 cell 比例约为 89%,规则立方体约为 61%。因此,Cylinder3D 的核心问题是:既然室外 LiDAR 的稀疏性和变密度是数据本身的结构特征,那么空间划分和卷积结构也应该主动适配它。
二、方法整体框架
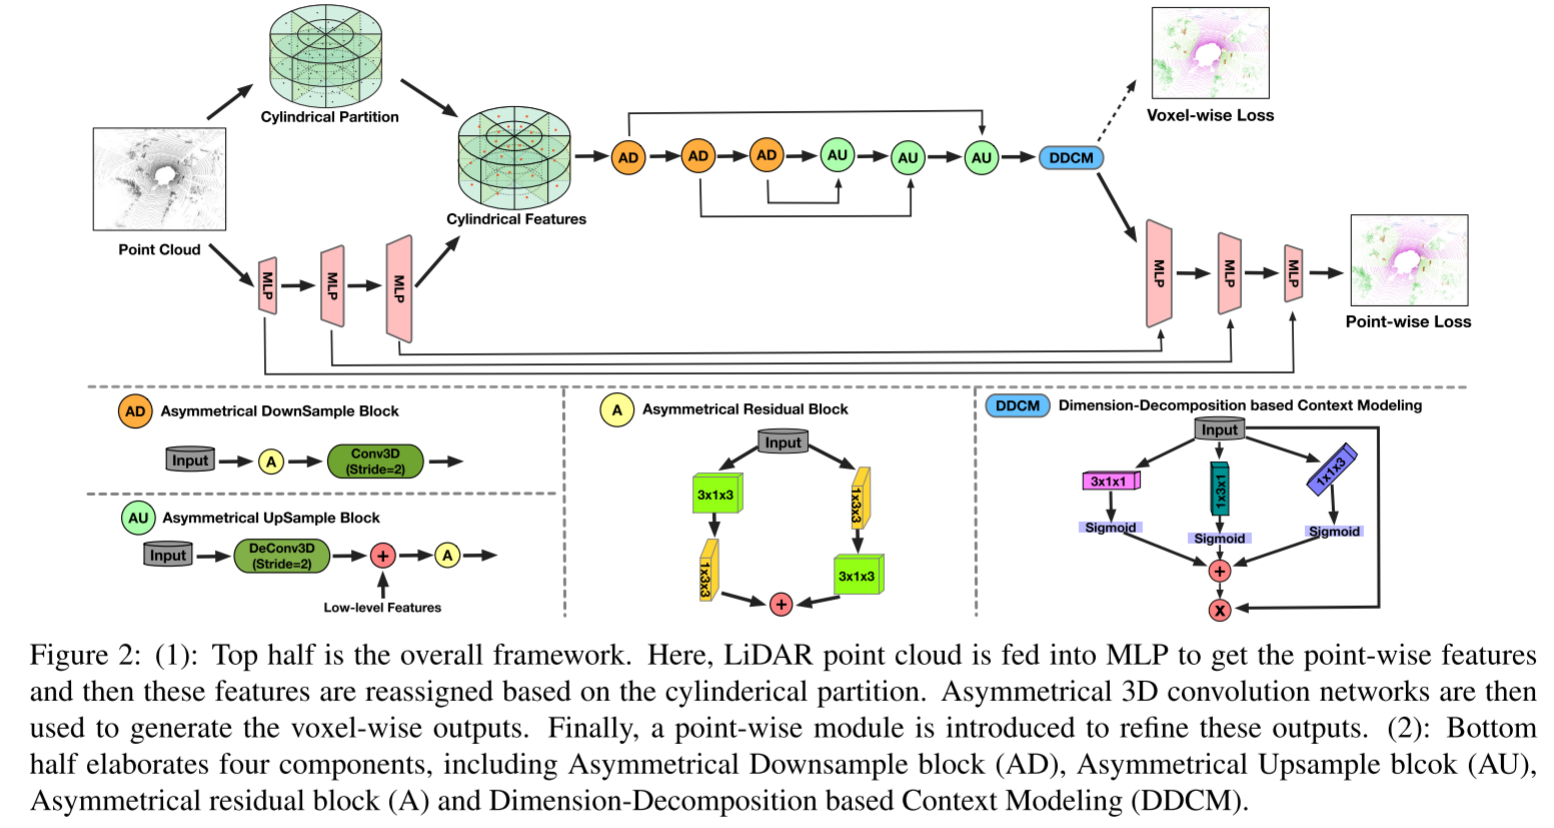
论文 Figure 2:Cylinder3D 整体框架,以及 AD、AU、非对称残差块和 DDCM 的结构
整体流程可以概括为:
Point Cloud → Point-wise MLP → Cylindrical Partition → Asymmetrical 3D CNN → DDCM → Voxel-wise Prediction → Point-wise Refinement
输入点云先经 MLP 得到逐点特征,再根据柱面坐标重排为结构化 3D 表示;随后使用非对称 3D 卷积网络完成编码与解码,并通过 DDCM 建模较大范围上下文;最后把 voxel-wise feature 映射回点,并与体素化之前的逐点特征融合,得到最终预测。
在 SemanticKITTI 和 nuScenes 上,论文均使用 480 × 360 × 32 的柱面表示,三个维度分别对应半径、方位角和高度。Cylinder3D 的关键不是"是否体素化",而是什么样的体素坐标系与卷积核更适合室外 LiDAR。
三、Cylindrical Partition:先解决"怎么划分空间"
普通 voxelization 在 (x, y, z) 笛卡尔坐标中使用规则立方体。固定大小的体素会造成近处拥挤、远处空洞。Cylinder3D 则把点转换到柱面坐标 (ρ, θ, z),其中 ρ 是 XY 平面内到原点的距离,θ 是方位角,再沿半径、角度和高度进行划分。由于相同角度间隔对应的物理宽度会随半径增加,远处 cell 会自然覆盖更大的空间范围,因此能部分抵消远距离点云变稀的问题。
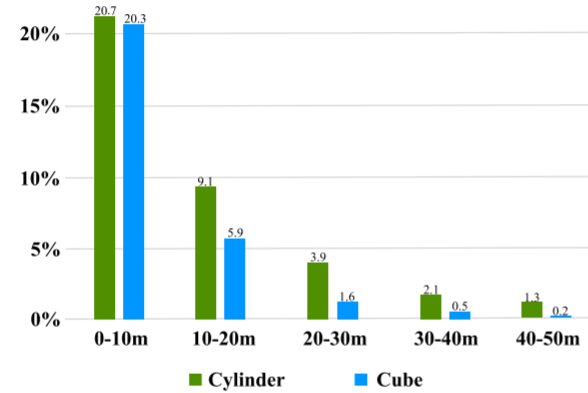
论文 Figure 3:柱面划分和立方体划分在不同距离区间的非空 cell 比例
Figure 3 显示,0--10 m 时两种划分差异较小,但距离增加后,规则立方体的非空比例下降更快;远距离区域中,其非空比例约为柱面划分的六分之一。这说明 cylindrical partition 并非简单"换坐标系",而是在表示层面适配 LiDAR 的距离相关密度变化。
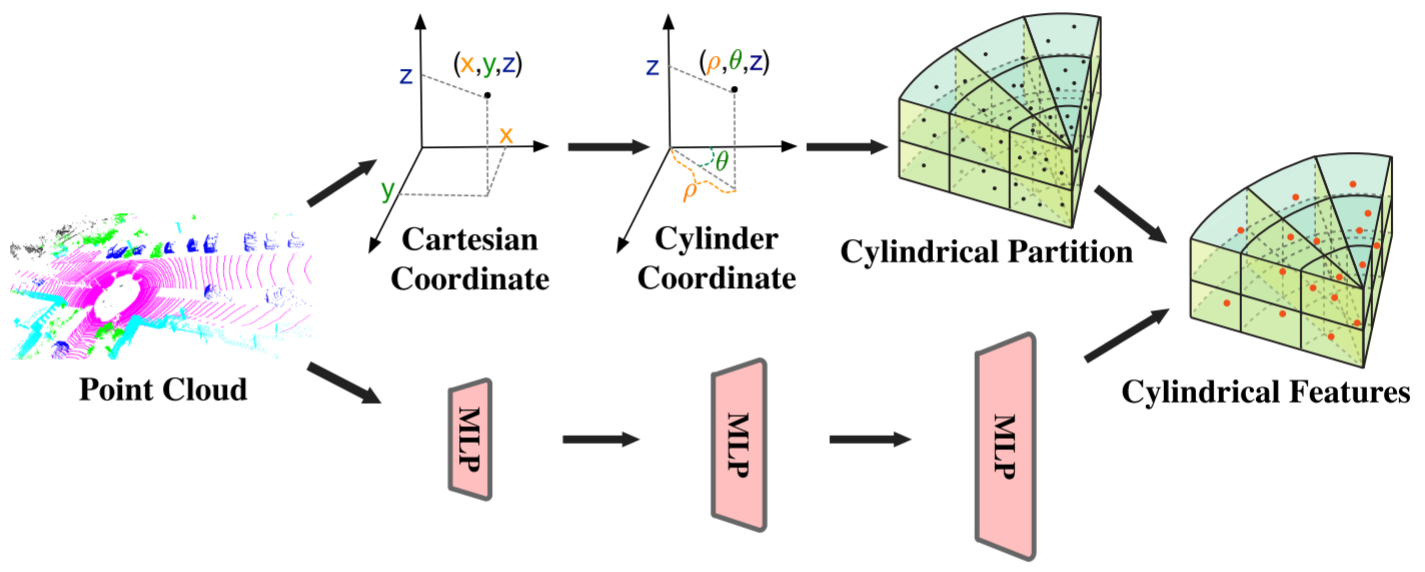
论文 Figure 4:Cylindrical Partition 的具体流程
Figure 4 展示了 (x, y, z) → (ρ, θ, z) 的坐标变换以及逐点特征向柱面网格的重新分配。最终网络依然使用 3D 卷积,只是输入网格更符合室外 LiDAR 的空间分布。
四、Asymmetrical 3D CNN 与细粒度恢复
道路场景中的汽车、卡车、摩托车等目标具有明显的水平和垂直结构。作者因此设计 Asymmetrical Residual Block,用非对称卷积强化卷积核"骨架",同时降低部分计算与显存开销。
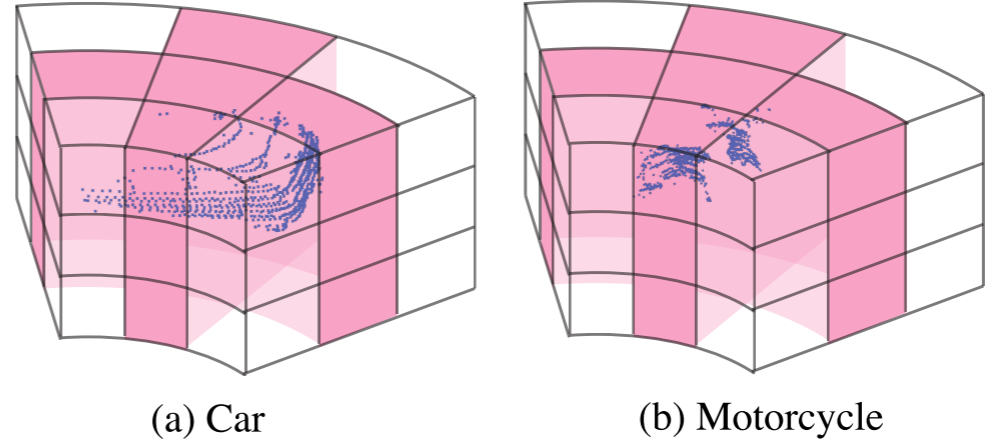
论文 Figure 5:汽车与摩托车示例,以及非对称卷积对水平、垂直方向结构的强调
网络使用类似 3 × 1 × 3 与 1 × 3 × 3 的卷积组合,并在此基础上构建 Asymmetrical DownSample Block 和 UpSample Block,形成完整的 encoder-decoder。
4.1 DDCM:用维度分解建模全局上下文
论文进一步加入 Dimension-Decomposition based Context Modeling(DDCM)。其思路是把难以直接构建的高秩上下文分解为多个低秩分量,再聚合成最终特征。具体做法是沿不同维度使用 rank-1 kernel 提取信息,通过分解---聚合方式扩大上下文范围,而不是直接堆叠更大的 3D kernel。
4.2 Point-wise Refinement:补回体素化损失
多个点可能落入同一个 cell,但它们未必属于同一类别,因此 voxel label encoding 天然会丢失信息。
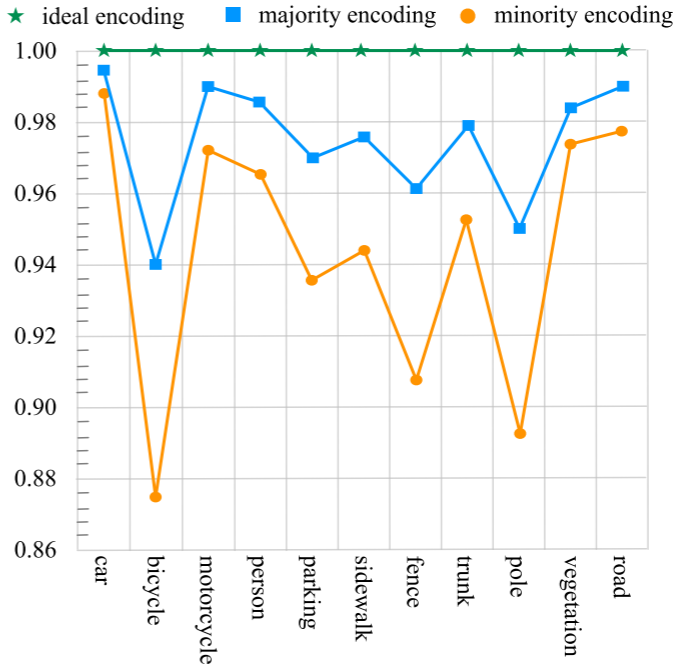
论文 Figure 6:不同 cell-label encoding 的 mIoU 上界
Figure 6 表明,无论采用 majority encoding 还是 minority encoding,都达不到理想编码的 100% 上界。作者因此把 3D CNN 输出的 voxel feature 通过 point-voxel mapping 映射回点,并与网络前的原始逐点特征融合进行细化。训练目标为 L = L_voxel + L_point:voxel 端使用 weighted cross-entropy 与 Lovász-Softmax,point 端使用 weighted cross-entropy;推理时采用逐点细化结果。
五、实验结果与消融分析
论文主要在 SemanticKITTI 和 nuScenes 上验证语义分割性能,指标为 mIoU;此外还扩展到 LiDAR panoptic segmentation 和 3D detection,以验证泛化能力。
5.1 SemanticKITTI 与 nuScenes 主实验
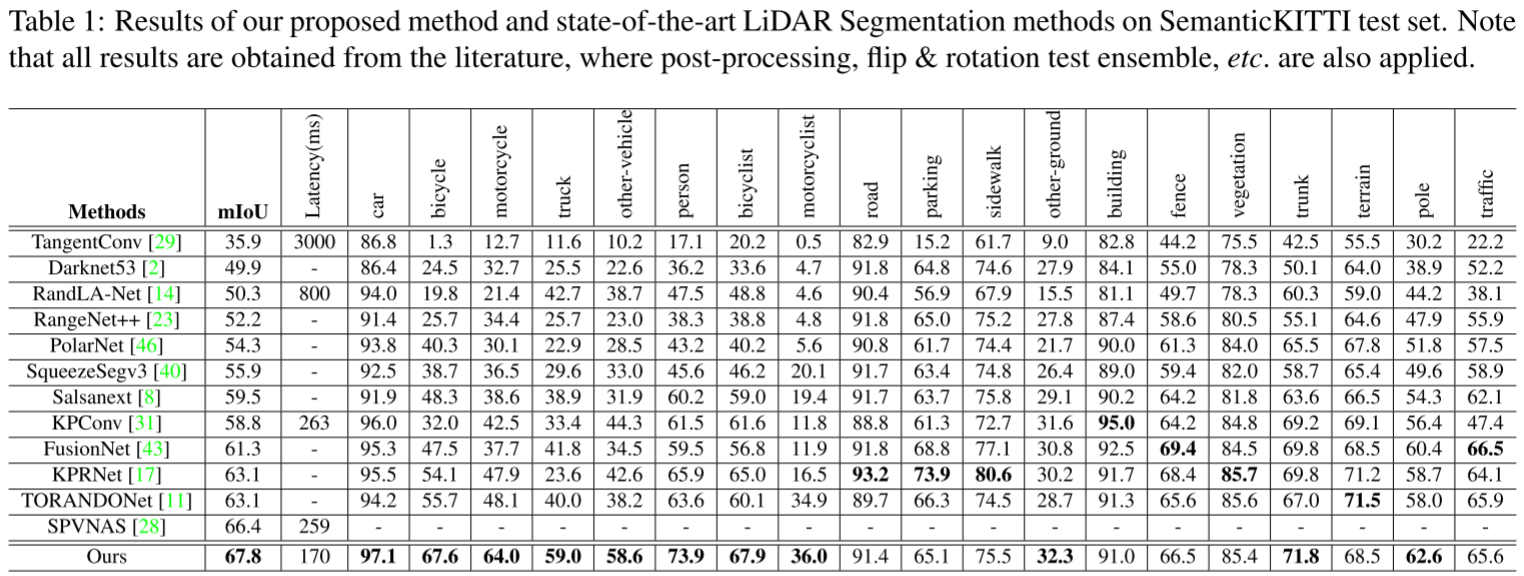
论文 Table 1:SemanticKITTI test set 上与主流 LiDAR 语义分割方法的比较
Cylinder3D 在 SemanticKITTI test set 上达到 67.8 mIoU ,高于表中的 SPVNAS 66.4、KPRNet 63.1 和 TORANDONet 63.1;相较 RangeNet++ 的 52.2、PolarNet 的 54.3 和 SalsaNext 的 59.5,优势更明显。论文同时报告 170 ms 延迟,低于表中 RandLA-Net 的 800 ms 和 KPConv 的 263 ms。
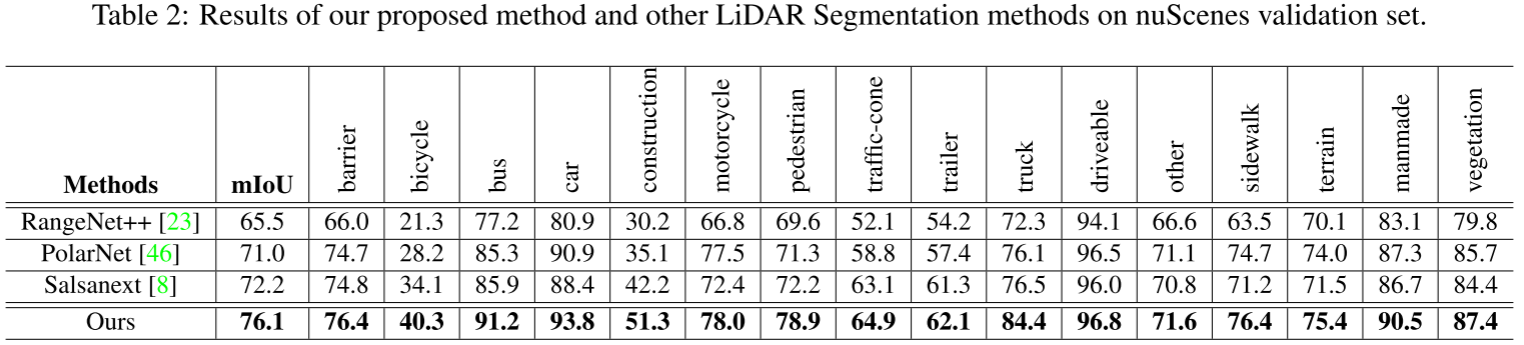
论文 Table 2:nuScenes validation set 上的语义分割结果
在 nuScenes 上,Cylinder3D 达到 76.1 mIoU,高于 SalsaNext 的 72.2、PolarNet 的 71.0 和 RangeNet++ 的 65.5。对于 bicycle、pedestrian 等较稀疏类别,Cylinder3D 分别达到 40.3 和 78.9,也高于表中对比方法,与论文针对稀疏性和密度变化进行设计的动机相吻合。
5.2 核心模块消融
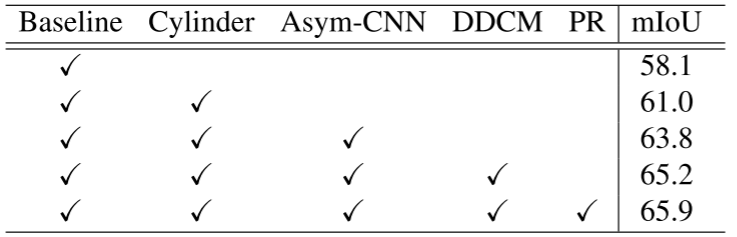
论文 Table 3:Cylinder、Asym-CNN、DDCM 与 Point-wise Refinement 的逐步消融
基础 3D voxel + 3D CNN baseline 为 58.1 mIoU ;加入 cylindrical partition 后提升到 61.0 ;再加入 asymmetrical 3D CNN 达到 63.8 ;加入 DDCM 后为 65.2 ;最后加入 point-wise refinement 得到 65.9。
这组消融给出了清晰的模块分工:Cylinder 主要解决 varying density,Asym-CNN 主要适配驾驶场景的几何结构与稀疏性,DDCM 补充上下文,PR 修复 voxel-to-point 过程中的细节损失。 前两个模块各带来约 3 个点的提升,是框架最核心的设计。
5.3 为什么要使用非对称卷积
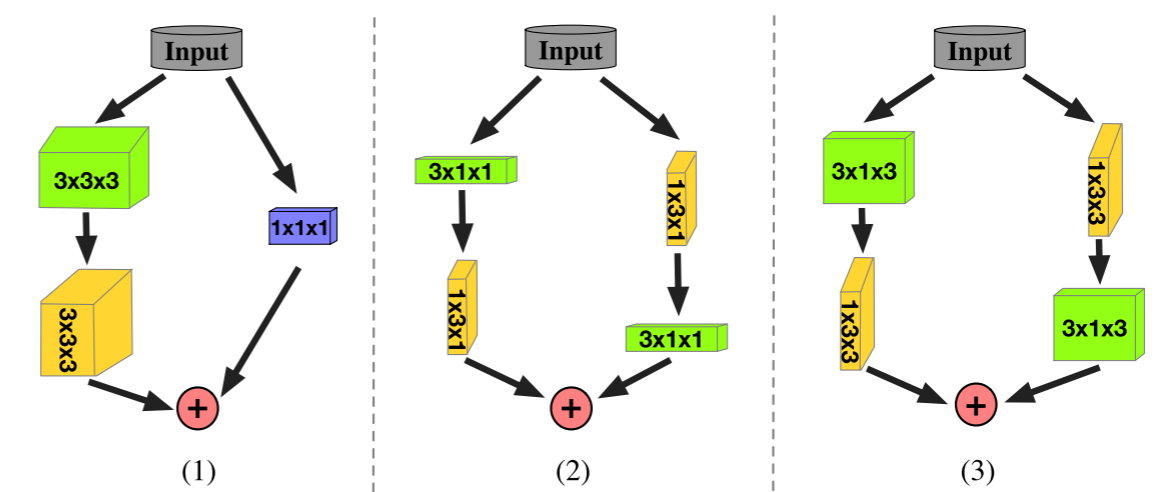
论文 Figure 7:Regular、1D-Asymmetrical 与完整 Asymmetrical Residual Block 的结构对比
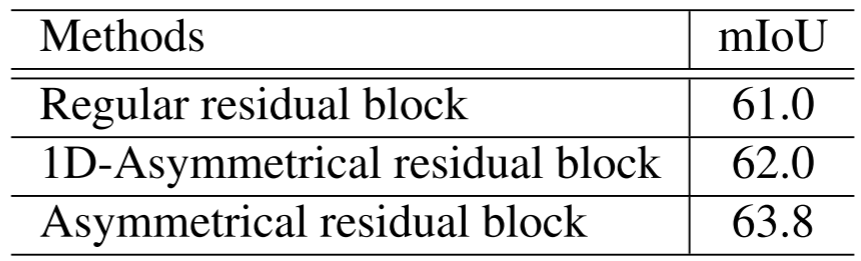
论文 Table 4:三种残差块的消融结果
普通 residual block 为 61.0 mIoU ,1D-Asymmetrical block 为 62.0 ,完整 Asymmetrical Residual Block 达到 63.8。这说明强化水平/垂直 kernel 本身就有效,把高度维也纳入设计后还能进一步提升,直接支撑了作者关于"卷积核结构应匹配驾驶场景目标分布"的判断。
5.4 跨任务泛化
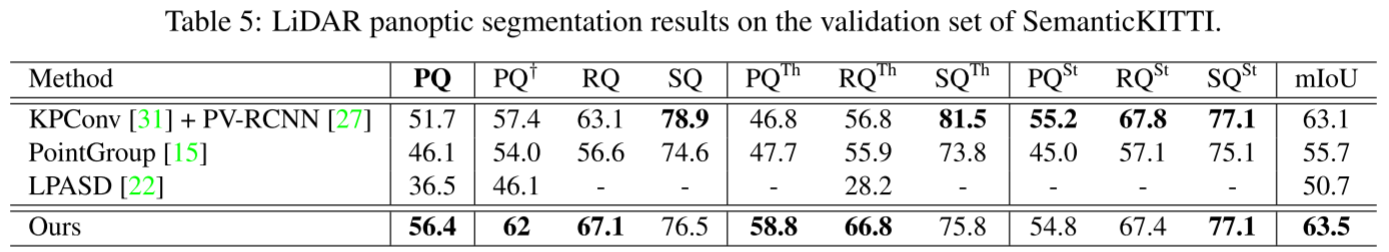
论文 Table 5:SemanticKITTI validation set 上的 LiDAR panoptic segmentation 结果
扩展到 panoptic segmentation 后,方法获得 56.4 PQ ,高于 KPConv + PV-RCNN 的 51.7。按 Table 5 本身,things 类 PQTh = 58.8 明显领先,而 PQSt = 54.8 并非表中最高,因此更稳妥的结论是:整体 PQ 与前景实例类表现证明了该表示具有不错的跨任务泛化能力。
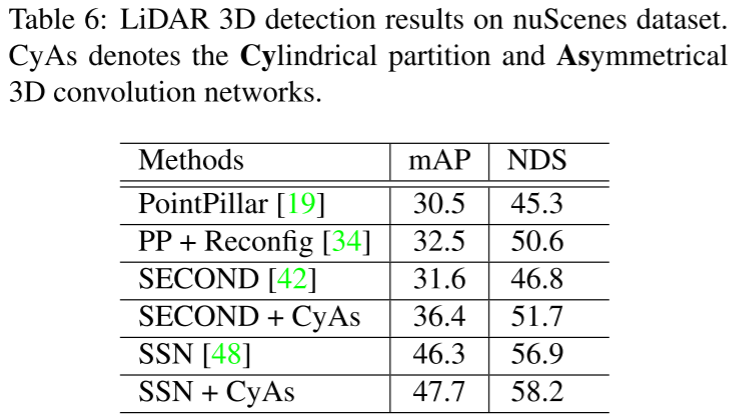
论文 Table 6:在 nuScenes 上将 CyAs 接入 SECOND 与 SSN 的 3D detection 结果
将 cylindrical partition + asymmetrical CNN 接入 SECOND 后,mAP 从 31.6 提升到 36.4 ,NDS 从 46.8 提升到 51.7 ;接入更强的 SSN 后,mAP 仍从 46.3 提升到 47.7 ,NDS 从 56.9 提升到 58.2。这说明 CyAs 并不只是为语义分割定制的模块,而可以作为更适合室外 LiDAR 的 3D 表示与 backbone 设计。
六、总结与思考
如果把 Cylinder3D 压缩成一句话,它真正做的不是"把点云换成柱坐标再做 3D CNN",而是:
从室外 LiDAR 的物理采样特性出发,同时重设计空间划分方式与 3D 卷积结构。
论文的逻辑链条很完整:先指出二维投影会损失 3D 几何、普通立方体 voxel 又不适合 varying density;再用 cylindrical partition 改善远近区域分布不均,用 asymmetrical 3D convolution 强化与驾驶场景目标形状相匹配的方向响应;最后利用 DDCM 增强上下文,并用 point-wise refinement 修补体素编码造成的细节损失。
从方法设计上看,这篇论文最值得学习的是它的问题定义方式 :先观察并统计数据真实存在的结构偏差,再让 representation 和 network architecture 主动适配这种偏差。对于后续 LiDAR 语义分割工作,这个思路仍然很有价值------与其单纯堆叠更复杂的 attention 或更深的 backbone,不如先问一句:当前的坐标系、邻域与特征聚合方式,真的符合 LiDAR 的几何分布吗?