当 AI 开始成为新的数据查询入口时,很多团队都会遇到同一种困惑:为什么它已经能写出一条语法正确的 SQL,却还是给不出业务上正确的答案?
问题往往不在 SQL 语法,也不只是模型能力。真正缺失的是那些写在资深分析师脑中、散落在报表和脚本里、却没有被数据库结构表达出来的信息。
例如,"销售额"到底是商品标价、优惠后金额、实际支付金额,还是确认收入?一张订单表应当如何连接客户表?哪些测试账号必须从每一份内部报表中排除?仅凭表名和字段名,很难让人或模型稳定地推断出这些答案。
上一篇我们讨论了:AI 生成查询时,缺的到底是什么信息。本文继续回答下一步的问题:这些业务信息应当在哪里定义?查询如何引用?数据库又如何将它们展开为可执行 SQL,并让团队检查实际采用的计算逻辑?
镜舟的做法是,将经过确认、能够形式化为查询规则的业务语义,声明为数据库可引用的定义。本文将这组定义称为信息契约(Information Contract),而 Semantic View 则是它在数据库中的承载形式。
一份可执行的语义定义需要包含什么?
给字段补几句注释,不足以支撑 AI 生成业务正确的查询。一份可用的语义定义,需要把正确查询依赖的事实逐项写清楚:
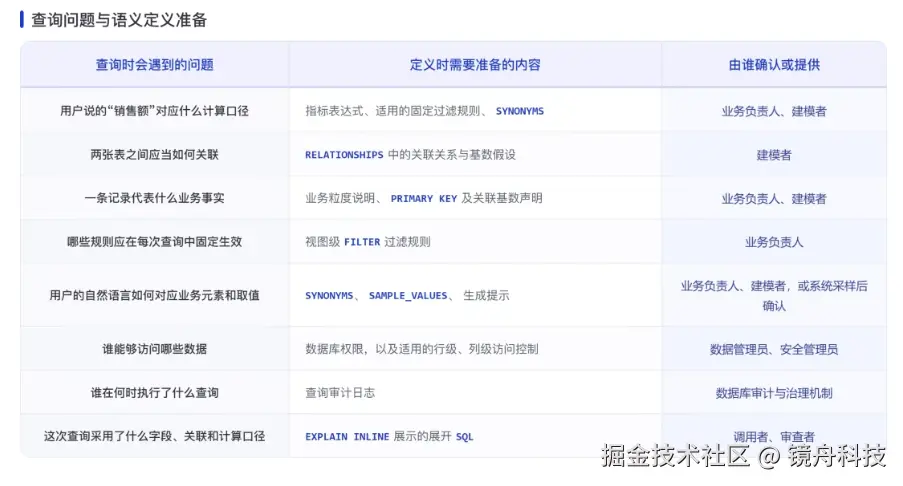
这里需要区分"业务粒度"和"主键"。主键回答的是"如何唯一标识一条记录";业务粒度回答的是"这条记录代表什么业务事实"。
例如,在本文的示例中,只有当 t_item 的一行确实代表一次购买时,COUNT(items.id) 才能被解释为"购买次数"。如果一行代表的是一次购买中的一项商品,则这一指标需要按订单或购买标识重新定义。
主键和关系声明需要与实际数据一致。声明本身是否校验唯一性,以及系统如何处理不符合声明的数据,应以具体产品实现为准。它们不会因为被声明后,就自动消除源数据中的重复、缺失或错误关联问题。
语义定义、访问控制、查询审计和查询逻辑核验属于不同机制。这种方式把一部分业务判断,从查询时的临场推断前移到定义时的确认。
- 语义定义回答"这个指标如何计算、这些表如何关联"。
- 数据库权限以及适用的行级、列级访问控制回答"谁能够访问哪些数据"。
- 查询审计日志回答"谁在什么时候执行了什么查询"。
EXPLAIN INLINE展示的展开 SQL 则回答"本次语义查询实际引用了哪些字段、关系、过滤和聚合表达式"。
视图与底层表之间的权限继承关系、可复用的权限范围,以及审计覆盖范围,需要以具体版本和部署配置为准。
当然,AI 仍然要理解问题:判断用户在问趋势、品牌还是某个具体指标,选择合适的维度和过滤条件。但它不需要再从物理字段里猜 amount 和 real_amount 哪个是业务要的金额,也不需要临时决定两张表该怎么连。
人的判断被前移到语义定义阶段,并成为后续查询可以复用的依据:确认"实际支付金额"该如何计算,声明一行记录的粒度,确定哪些数据要被固定排除。一旦做出这些判断,就不再只存在于某一次对话、某段 Prompt 或某份手工 SQL 里,而是成为可以被反复调用的定义。
Semantic View:一次定义,处处复用
Semantic View 本身是数据库中的一等对象,可以在其中声明逻辑表、主键、关系、维度和指标,也可以附加同义词、示例值和面向 AI 的生成提示。
用上一篇(AI 能写 SQL,但它真的理解数据吗?镜舟 Semantic View 如何补齐语义缺口随着 Text-to-SQL、 - 掘金)里的钓鱼装备消费场景继续说明。
以下示例假设:t_item 的每一行代表一次完成的购买记录,id 唯一标识这次购买;t_item_type 是分类维表,t_item_brand 是品牌维表。在这个前提下,COUNT(items.id) 表示购买次数。
java
CREATE OR REPLACE SEMANTIC VIEW sv_fishing_item_spend
  TABLES (
    items AS t_item PRIMARY KEY (id)
      WITH SYNONYMS = (
        'fishing gear spend',
        'purchase record',
        '钓鱼装备消费',
        '购买记录'
      )
      COMMENT = 'one row = one completed purchase',
    item_types AS t_item_type PRIMARY KEY (id),
    brands AS t_item_brand PRIMARY KEY (id)
  )
  RELATIONSHIPS (
    item_to_type AS items (item_type) REFERENCES item_types (id),
    item_to_brand AS items (brand) REFERENCES brands (id)
  )
  DIMENSIONS (
    items.buy_year AS YEAR(items.buy_date)
      WITH SYNONYMS = ('purchase year', 'year', '购买年份', '年份'),
    items.buy_month AS DATE_TRUNC('month', items.buy_date)
      WITH SYNONYMS = ('purchase month', 'month', '购买月份', '月份'),
    brands.item_brand_name AS brands.item_brand
      WITH SYNONYMS = ('brand', 'make', '品牌')
      SAMPLE_VALUES = ['Woding', 'Handing', 'Liuzhiqiang']
  )
  METRICS (
    items.total_real_spend AS SUM(items.real_amount)
      WITH SYNONYMS = (
        'total amount paid',
        'actual spend',
        '实际支付金额',
        '实际消费金额'
      ),
    items.purchase_count AS COUNT(items.id)
      WITH SYNONYMS = ('purchase count', 'number of purchases', '购买次数')
  )
  AI_SQL_GENERATION
    'For spend questions, prefer total_real_spend.
     For purchase-count questions, prefer purchase_count.';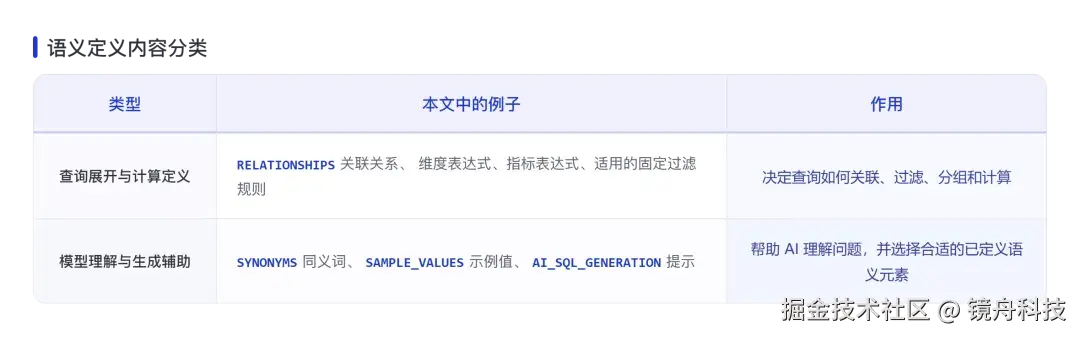
两类信息的约束力并不相同。同义词、示例值和生成提示,帮助 AI 将自然语言问题映射到合适的语义元素;当指标、维度和关系被选定后,查询的关联和计算依据已经声明的定义展开。提示本身不等于数据库强制执行的规则。
在这份定义中,RELATIONSHIPS 声明表之间的关联方式;DIMENSIONS 定义可被引用和分组的业务维度;METRICS 固定指标所使用的计算表达式。例如,items.total_real_spend 已被定义为 SUM(items.real_amount),调用该指标时,不需要由调用者再次决定应使用 amount 还是 real_amount。
SYNONYMS 和 SAMPLE_VALUES 用于帮助模型理解"品牌""购买月份""实际消费金额"等自然语言表达,并映射到相应的语义元素。AI_SQL_GENERATION 则用于提示 AI:面对不同类型的问题时,应优先选择哪个已经定义的指标。例如,消费金额问题优先使用 total_real_spend,购买次数问题优先使用 purchase_count。
AI 与 BI 复用同一份指标定义
有了这份定义,"2024 年每个品牌实际花了多少钱,买了多少次"这个问题,可以直接用语义查询表达:
vbnet
SELECT * FROM SEMANTIC_VIEW(
  sv_fishing_item_spend
  DIMENSIONS brands.item_brand_name
  METRICS    items.total_real_spend, items.purchase_count
  WHERE      items.buy_year = 2024
  ORDER BY   items.total_real_spend DESC
) AS sv;
调用者只需要表达要分析的维度、指标、过滤条件和排序方式,不需要在每次查询中重新编写表关联、金额聚合和购买次数计算。
对于不使用语义查询语法的 BI 工具,Semantic View 也可以作为可连接的数据对象供其读取。此时需要明确:返回记录按照哪些维度组织、一行代表什么,以及 BI 工具再次添加 SUM、AVG 等聚合时,系统如何处理已定义指标。
以下示例表达的是与上文相同的业务问题:按品牌查看 2024 年的实际消费金额和购买次数。
sql
SELECT
  brands__item_brand_name,
  items__total_real_spend,
  items__purchase_count
FROM sv_fishing_item_spend
WHERE items__buy_year = 2024
ORDER BY items__total_real_spend DESC;
在该示例中,以 brands__item_brand_name 为分组维度;返回结果的每一行代表一个品牌在 2024 年的汇总结果,包含该品牌的实际消费金额和购买次数。
同一个业务问题,可以通过语义查询或 BI 连接两种方式引用同一份指标定义。这样,AI Agent 与 BI 工具在调用已定义指标时,可以减少重复实现业务口径的工作。
这不意味着所有下游计算都会自动一致:如果调用者绕开已定义指标自行编写表达式,或在下游额外叠加计算,仍然需要相应的治理与审核。
计算逻辑可核验:查看语义查询展开后的 SQL
语义查询不是一个黑盒承诺。需要核实时,可以用 EXPLAIN INLINE 查看展开后的真实 SQL:
vbnet
EXPLAIN INLINE
SELECT * FROM SEMANTIC_VIEW(
  sv_fishing_item_spend
  DIMENSIONS brands.item_brand_name
  METRICS    items.total_real_spend, items.purchase_count
  WHERE      items.buy_year = 2024
  ORDER BY   items.total_real_spend DESC
) AS sv;
展开 SQL 示意:
go
SELECT
  `brands`.`item_brand` AS `item_brand_name`,
  SUM(`items`.`real_amount`) AS `total_real_spend`,
  COUNT(`items`.`id`) AS `purchase_count`
FROM `test`.`t_item` AS `items`
LEFT JOIN `test`.`t_item_brand` AS `brands`
  ON `items`.`brand` = `brands`.`id`
WHERE YEAR(`items`.`buy_date`) = 2024
GROUP BY 1
ORDER BY 2 DESC;
通过展开 SQL,审查者可以检查这次查询实际引用了哪个字段、采用了哪些关联、如何过滤、如何分组,以及指标使用了什么聚合表达式。
这让语义查询的计算逻辑不止停留在"模型说它会这样算",而能够落到可阅读、可审查的 SQL 上。
需要区分的是:展开 SQL 用于检查查询逻辑;物理执行计划用于理解优化器如何执行;实际运行过程、资源消耗和结果行级追溯则属于不同层面的能力。
Semantic View 在 MIP 中的位置:连接业务语义与查询执行
回答一个完整的业务问题,通常需要经历四个环节:理解问题、匹配业务语义、将语义定义展开为可执行 SQL、解释结果并决定下一步行动。
在镜舟 MIP(MirrorShip Intelligence Platform)中,这些环节由 MirrorPilot、MirrorMind 和 MirrorData 协同完成。Semantic View 位于业务语义与查询执行之间:它承载已经确认、能够形式化为查询定义的部分,并将其交给数据库稳定执行。
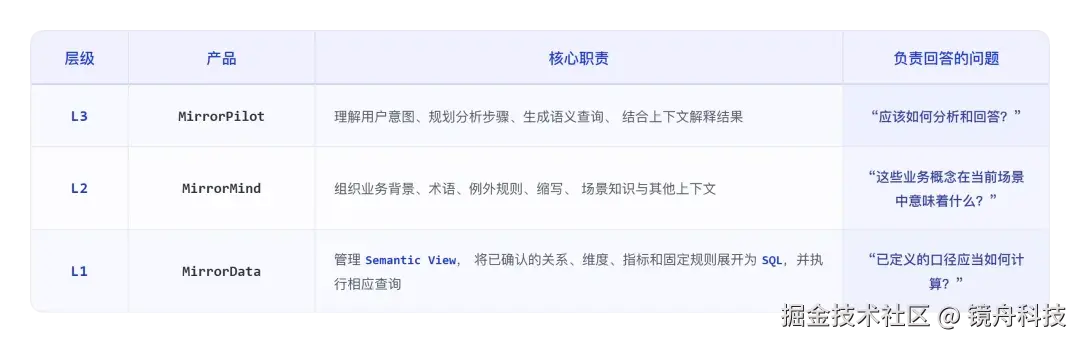
MirrorMind 组织业务语义与上下文,其中经过确认、能够形式化为查询定义的部分,通过 MirrorData 中的 Semantic View 承载和执行。对于指标表达式、维度表达式、表关系和固定过滤规则,Semantic View 应作为查询执行层的权威定义来源。
业务负责人和建模者负责确认这些定义,并在业务规则、数据模型或指标口径变化时维护它们。MirrorPilot 可以结合 MirrorMind 中的上下文理解问题和解释结果,但不应在每次查询时重新发明已经在 Semantic View 中固定的计算口径。
结语
Semantic View 对已经定义的语义范围负责。遇到新的业务域、尚未确认的口径、需要跨领域关联的信息,或依赖多步推理的问题,仍然需要 AI 的生成能力、业务上下文以及人的审核。
它解决的是把已经确认的业务口径,从分析师个人经验、临时 Prompt 和重复 SQL 中抽离出来,成为可复用、可维护、可检查的查询定义。
当业务口径发生变化时,团队可以围绕同一份定义进行维护,并检查这份定义如何进入实际的查询逻辑。这也是 AI 与 BI 复用语义定义的实际价值:减少重复实现口径的工作,而不是放弃对下游计算和业务变化的治理。
下一篇将进一步讨论:查询准确性从何而来,以及 Semantic View 如何界定自己的职责边界。