1. 把 DDD 开源脚手架化为自己的:先读懂它------Spring Boot 4.1 的四层架构、多数据源与领域事件
学了这么多年 Java,Controller 调 Service、Service 调 DAO、一套 JPA 从头敲到底,业务和框架糊在一起,代码长了是真难维护。最近在折腾"面向 AI 编程",我盯上了一套 DDD 开源脚手架,本想直接拿来用,但越看越觉得该先把它"化为自己的"------不是抄结构,而是把它装进脑子里。
这篇是系列第 1 篇,先把骨架读懂:DDD 四层架构每一层放什么、多数据源到底怎么切、领域事件是怎么"全部异步化"的。官方脚手架用的是 JDK 25,我实际落地用 JDK 17,所以系列里我不打算无脑跟着版本走,而是讲清楚原理再按自己的规范落地。
一、为什么是"内化",而不是"照抄"
官方脚手架的开篇写得特别直白:
这份代码不只是给你看的,更是给 AI 读的。
这句话其实点破了一件事:所谓的 DDD 脚手架,本质上是一份给 AI 看的架构契约 。你把规矩固定下来,AI 照着规矩生成的代码才不会跑偏。这跟我之前一直在调的"框架+细节 SKILL"是同一个思路------规则要先于生成,绑定在结构上。
所以我的目标也不是"扒一份工程下来跑起来",而是:把它核心的建模思想和落地套路内化成我自己的规范,后面再用它去指导我自己的 service-api 改造方向。先保证能运行、能用起来,其他的都是后面的事。
二、DDD 四层架构:每一层到底该放什么
这是整个脚手架的地基。官方版本是四层,从上到下:
| 层 | 英文 | 放什么 | 依赖方向 |
|---|---|---|---|
| 接口层 | interfaces | Controller、VO、自定义注解 | 依赖应用层 |
| 应用层 | application | Application Service、Command、DTO、Port | 依赖领域层 |
| 领域层 | domain | 领域模型、聚合根、领域服务、仓储接口、领域事件 | 不依赖任何框架 |
| 基础设施层 | infrastructure | 仓储实现、配置、外部客户端、消息处理 | 实现 domain 的接口 |
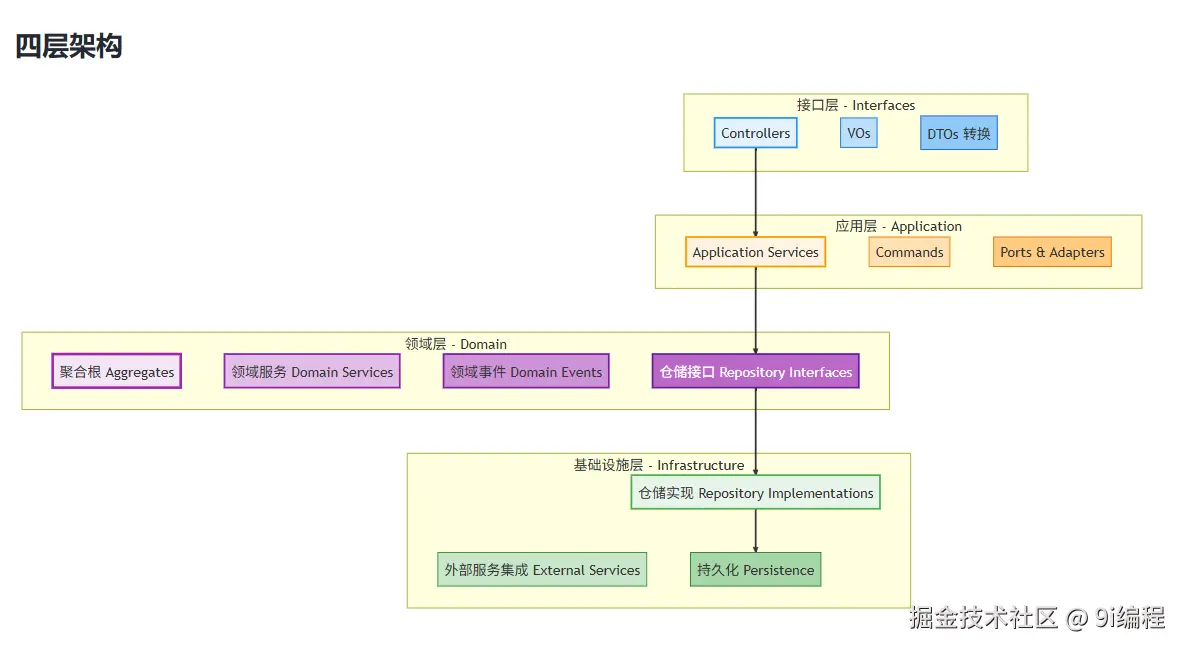
最关键的一条纪律:领域层必须纯净,不依赖 Spring。
java
// ✅ 正确 ------ 领域层就是干净的 Java
package ...domain.model.user;

public class User {
    private Long id;
    private String name;

    public static User register(String name, String email) {
        // 纯业务逻辑,没有任何 Spring 注解
        return new User(null, name, email);
    }
}

// ❌ 错误 ------ 把框架依赖塞进领域层
@Entity
public class User {
    @Id
    @GeneratedValue
    private Long id;
    @Autowired
    private UserRepository repository;   // 领域层不该有这些
}我的理解是:四层其实在做一件事------把"业务规则"和"技术实现"彻底剥开。领域层只谈业务该怎么算、状态该怎么变;至于数据存 MySQL 还是 Postgres、缓存用不用 Redis,那都是基础设施层的事。这样业务逻辑才可以脱离 Spring 单独测试、单独演进,也更方便 AI 理解"规则在哪里"。
三、多数据源:最容易绕晕,其实思路很简单
官方脚手架搞的是 MySQL(user 库)+ PostgreSQL(order 库)双数据源,独立事务管理。
但我内化时做了一个很务实的取舍:order 不再用 PostgreSQL,而是也用 MySQL,只是和 user 用的是不同的库。
用不同库而不是不同数据库,是降低落地成本------我整套基础设施都是 MySQL 系的,没必要为一个 order 单独再拉一个 PG。源文档提问那里,官方只是"举例切换不同的数据源,实际上可能不会这么明确"。
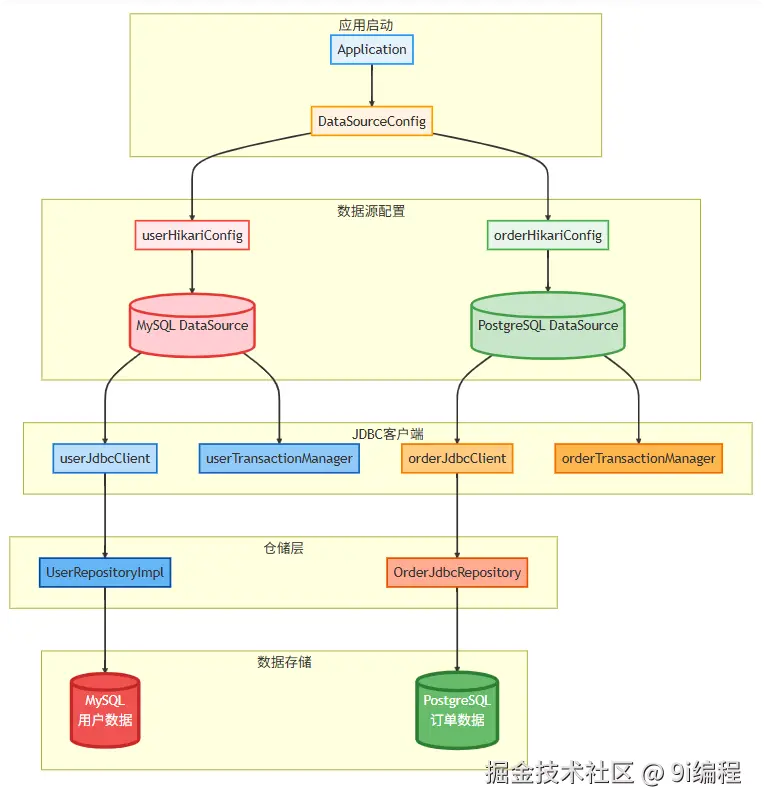
多数据源的配置长这样:
yaml
spring:
  user:
    datasource:
      jdbc-url: jdbc:mysql://localhost:3306/user_db
      username: root
      password: password
  order:
    datasource:
      jdbc-url: jdbc:mysql://localhost:3306/order_db
      username: root
      password: password
核心是有各自的 JDBC 客户端、各自的事务管理器 。用的时候通过 @Qualifier 指定数据源,@Transactional 指定用哪个事务管理器:
java
@Service
@Transactional(transactionManager = "userTransactionManager")    // 走 MySQL(user_db)
public class UserService {
    // 用户事务
}

@Service
@Transactional(transactionManager = "orderTransactionManager")   // 走 MySQL(order_db)
public class OrderService {
    // 订单事务
}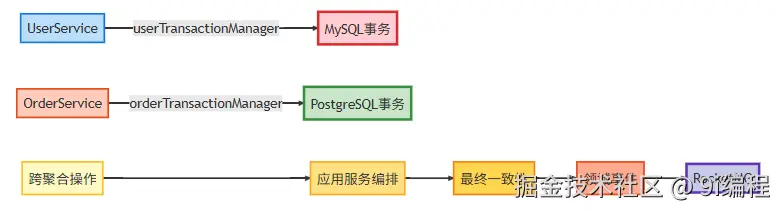
这里有个很关键的点要记住:Java 的 @Transactional 默认只对一个数据源生效。跨库、跨聚合的事务没法靠一个事务管理器保证,官方走的是"应用层编排 + 领域事件 + 最终一致性",这正好接上了下一节的领域事件。
四、事件驱动:把该异步的都异步化
官方用 RocketMQ 做领域事件发布。核心链路是:
聚合根(比如 Order 的
pay())记录领域事件 → 领域事件发布器 DomainEventPublisher 打成消息 → 推到 RocketMQ 消息队列 → 各消费者(订单服务、通知服务、统计服务)各取所需。
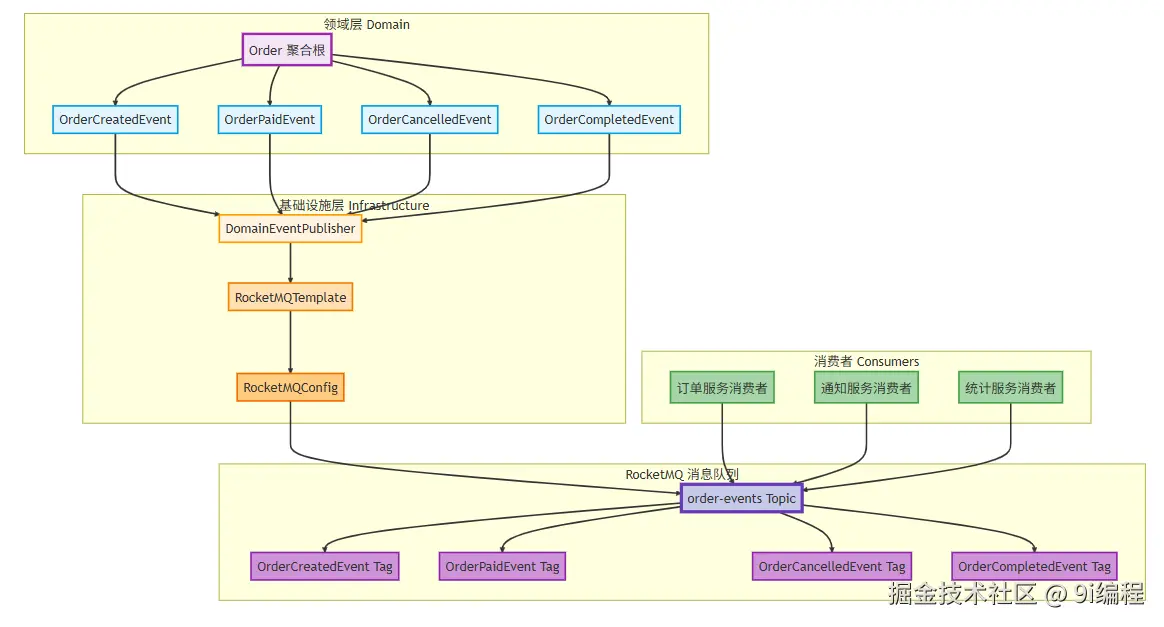
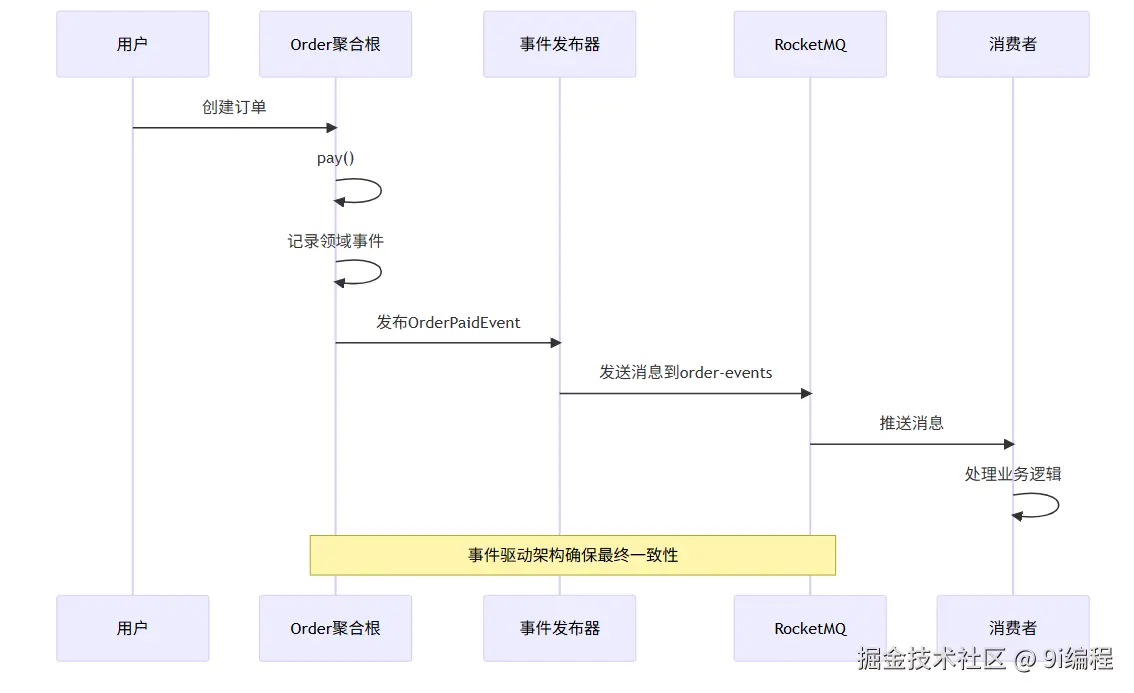
我理解这件事的实质就一句话:把所有"不一定要同步做完"的事,都异步化。订单支付成功后,扣库存、发通知、记统计,这些后续动作不需要和"支付成功"这个结果绑定在一起等它完成,交给消息通知下游自己处理就行,系统整体响应就不卡了。
消息类型用**主题(Topic)+ 标签(Tag)**来区分:
| 事件类型 | 标签 | 触发时机 |
|---|---|---|
| OrderCreatedEvent | 订单创建 | 订单首次保存后 |
| OrderPaidEvent | 订单支付 | 支付成功 |
| OrderCancelledEvent | 订单取消 | 取消操作 |
| OrderCompletedEvent | 订单完成 | 完成操作 |
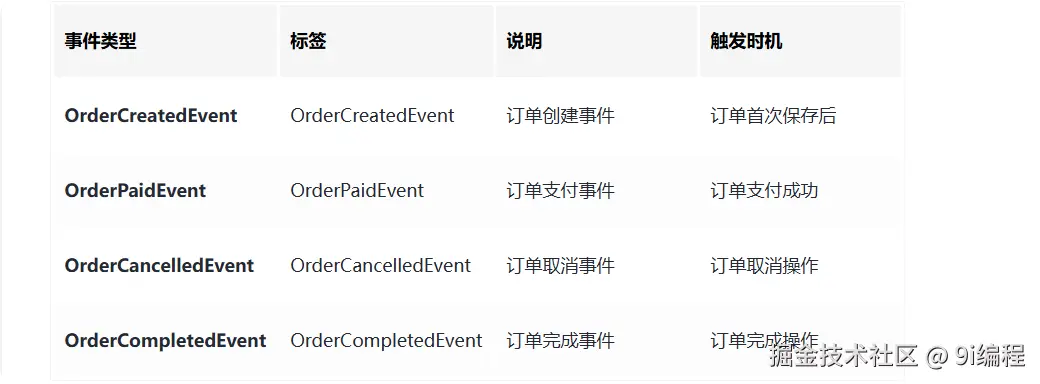
我在这儿加了一个自己的优化想法:给事件增加一个 type 字段,用不同的 type 对应不同事件,而不只是靠 Topic/Tag 字符串去约定。这样消费端按 type 分发逻辑更清晰,不会到处散落字符串判空。
另外值得点赞的是优雅降级:RocketMQ 不可用时系统照样能启动,只是记录警告,不把主链路拖死。这对生产很实用------消息中间件挂了,不能让整个应用跟着崩。
yaml
rocketmq:
  name-server: localhost:9876
  producer:
    group: order-producer-group
  consumer:
    group: order-consumer-group
  fallback:
    enabled: true   # 启用优雅降级
五、领域建模:聚合根是怎么"管住"业务规则的
有了分层、有了多数据源、有了事件,最后落到根上的是怎么建模。官方用 User / Order 两个聚合根做示范。
聚合根把业务规则收在自己手里。看 Order 的状态流转:
java
public class Order {
    private OrderStatus status;

    public void pay() {
        this.status = OrderStatus.PAID;
        recordEvent(new OrderPaidEvent(this.id, this.orderNo));   // 记录领域事件
    }
    // cancel() / complete() 同理,状态只走合法的流转
}
User 聚合根则用私有构造 + 静态工厂方法,强制你走它的校验逻辑:
java
public class User {
    private User(Long id, String name, String email) {
        this.id = id;
        this.name = name;
        this.email = email;
    }

    public static User register(UserUniquenessChecker checker,
                                String name, String email) {
        if (checker.existsByName(name)) {
            throw new UniquenessViolationException("用户名已存在");
        }
        return new User(null, name, email);
    }
}还有一个落地纪律很值得记:仓储接口(Repository)定义在领域层,实现在基础设施层。
java
// domain/repository/ ------ 接口在这
public interface UserRepository {
    User save(User user);
    Optional<User> findById(Long id);
}

// infrastructure/repository/ ------ 实现在这
@Repository
public class UserRepositoryImpl implements UserRepository {
    private final JdbcClient jdbcClient;
    // JdbcClient 实现
}
这么做的意义是:领域层只声明"我需要一个地方存 User",至于存哪里、怎么存,交给基础设施层去实现。这样换数据库时,领域层一行都不用动。
最后,应用服务(Application Service)负责编排------它不写业务规则,只协调仓储和领域对象把一次用例跑完:
java
@Service
@RequiredArgsConstructor
public class OrderService {
    private final OrderRepository orderRepository;
    private final UserRepository userRepository;
    private final DomainEventPublisher eventPublisher;

    @Transactional
    public OrderDTO createOrder(CreateOrderCommand command) {
        User user = userRepository.findById(command.getUserId())
                .orElseThrow(() -> new EntityNotFoundException("用户不存在"));
        Order order = Order.create(user.getId(), command.getTotalAmount());
        Order savedOrder = orderRepository.save(order);
        eventPublisher.publishOrderCreated(savedOrder);   // 发领域事件
        return OrderDTO.from(savedOrder);
    }
}到这里四条线就串起来了:分层管职责,聚合根管规则,仓储管存取,应用层管编排,事件管异步。DDD 不是炫技,是把"复杂系统的变化点"一个个钉死在明确的位置上。
六、怎么让 AI 按这套规范帮你写代码
脚手架官方给了很实用的"Agent CLI 编程指南",本质是把脚手架当参考项目喂给 Agent,让它按固定架构、技术、编码规范生成代码。核心要点有三条,我都很认同:
- 上下文预加载------开始任务前,先让 Agent 读关键配置文件(pom.xml、DataSourceConfig、UserRepositoryImpl、User)和已有实现;
- 架构约束明确------每个任务开头重申必须遵守的四层约束(领域层纯净、仓储接口在领域层、Builder 建对象、遵循 DDD/SOLID);
- 分步执行 + 代码审查 + 持续反馈------复杂任务拆小步做,做完让 Agent 自检是否偏离架构,再根据结果迭代提示词。
这跟我前面在铁律/SKILL 里总结的经验完全一致:"规则要先绑定,AI 才不会跑偏。" 而这个脚手架,正好提供了一个"给 AI 读的"落地范本。
落到我自己,几个关键取舍先记下来(也埋个后续系列的钩子):
- JDK 版本:官方 JDK 25,我实际用 JDK 17 落地,兼容更稳;
- benchmark/orm:官方主打 Spring Data JDBC + MyBatis Plus + JdbcClient,我需要确认和我要接的 knife4j、tk.mybatis 是否兼容(knife4j 目前主要支持 Spring Boot 3.x,这块要单独验证);
- 方向:后面我会把 service-api 升级成 service-api-4x,把脚手架的 DDD 能力迁过去------但这是后面系列的事,这篇先把概念消化透。
七、小结
这套 DDD 脚手架真正打动我的,不是"最新技术栈"四个字,而是它把复杂拆成了能被 AI 理解和遵守的四件事:
- 四层架构:业务规则和技术实现彻底分开,领域层纯净;
- 多数据源:各自数据源 + 各自事务管理器,跨库靠最终一致性;
- 领域事件:把该异步的全部异步化,用 Topic/Tag 或 type 区分、优雅降级兜底;
- 聚合根建模:私有构造 + 静态工厂 + 仓储接口在领域层,把规则钉在聚合根里。
我的核心收获:DDD 不是让你把代码写得"更高级",而是让系统的变化点都有明确的归属。规则集中在领域层,AI 照着规则写,就不容易跑偏------这正是"面向 AI 编程"的真意。
系列后续我会一篇一个功能往下实现:先用 JDK 17 把脚手架跑起来,再解决 knife4j / tk.mybatis 的兼容,然后按 service-api-4x 的方向把它迁移成我自己的规范。感兴趣可以关注我,下一篇见。
参考:Spring Boot 4.1 + JDK 25 DDD 开源脚手架,面向 AI 编程(掘金)------ juejin.cn/post/766143...