文章目录
一、前言
本文提到的 DeepSeek-V4.1 的 Day 0 适配和 kernel 优化由 SGLang 团队共同完成。最终在 4×B300、TP4 / EP4 配置下,配合 DSpark 达到
1)BS=1 764 tokens/s
2)BS=64 13,473 tokens/s。
优化从普通 decode 的 BS=1 35 tokens/s 开始,先提升到 203 tokens/s,再接入 DSpark 继续优化。这里介绍模型结构变化,以及这些 kernel 性能提升是怎么做的。基于DS V4.1的技术报告和DeepGEMM, FlashMLA等给Deepseek V4.1开源的新kernel,SGLang的性能还会在开发分支继续提升。
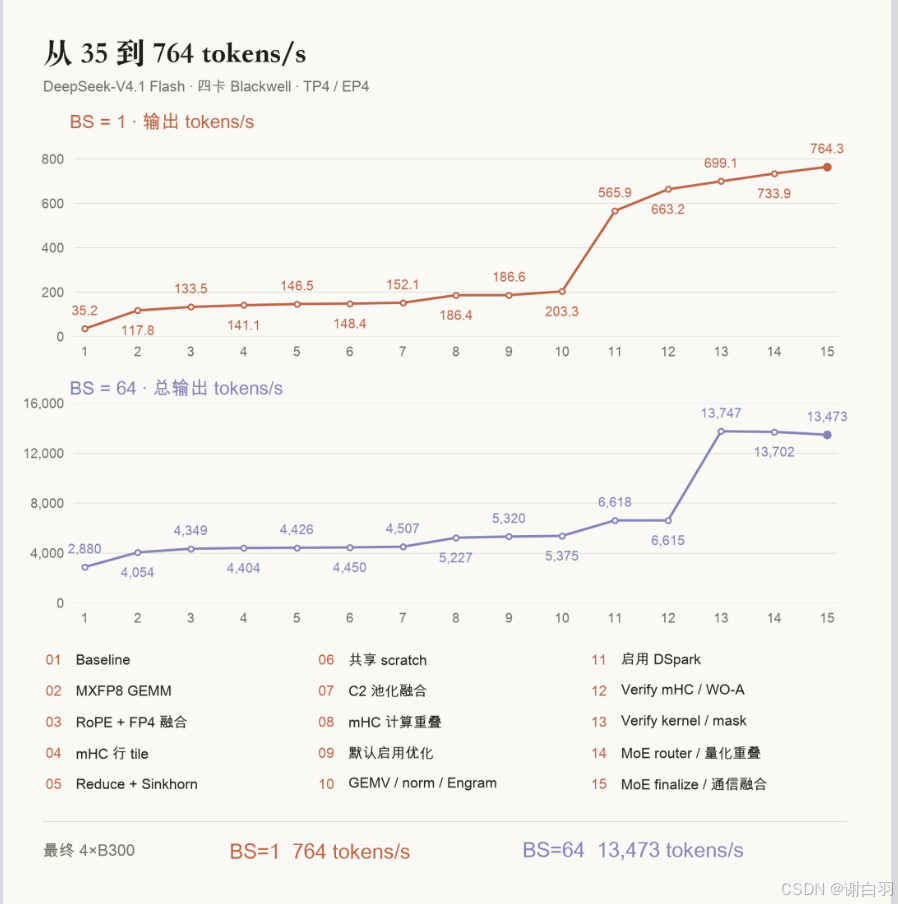
横轴是优化选项
四卡 Blackwell 下各项优化后的代表吞吐,最终结果在 4×B300 上测得。BS=1 是单请求输出速度,BS=64 是并发总输出吞吐;复现负载见文末。
二、架构变化与 KV cache 压缩
V4.1 Flash 的 backbone 比 V4 Flash 更大,但处理输入时激活的参数反而更少。
| 项目 | V4 Flash | V4.1 Flash |
|---|---|---|
| Backbone 参数 | 284B | 552B,另有 196B Engram 记忆参数 |
| 每 token 激活参数 | 约 13B | 输入约 8B,输出约 16B |
| 主干结构 | 43 层 decoder | 20 层 causal encoder + 20 层 decoder |
| 全局注意力 | CSA / HCA | CSA2,跨层共享 KV 和索引 |
| 全局 KV / token | 3514 bytes | 890 bytes |
数据来自官方模型配置与技术报告
CED 减少了 prefill 计算量。 后 20 层需要的全局 KV 从 encoder 最终输出生成,所以长 prompt 主要经过前 20 层。Decoder 的局部窗口通过最近 128 个 token 的 bounded replay 补齐,主干的 prefill 工作量接近减半。生成新 token 时,仍然经过完整的 40 层。
CED = Causal Encoder-Decoder(因果编码器-解码器),是 V4.1 的核心架构改动。
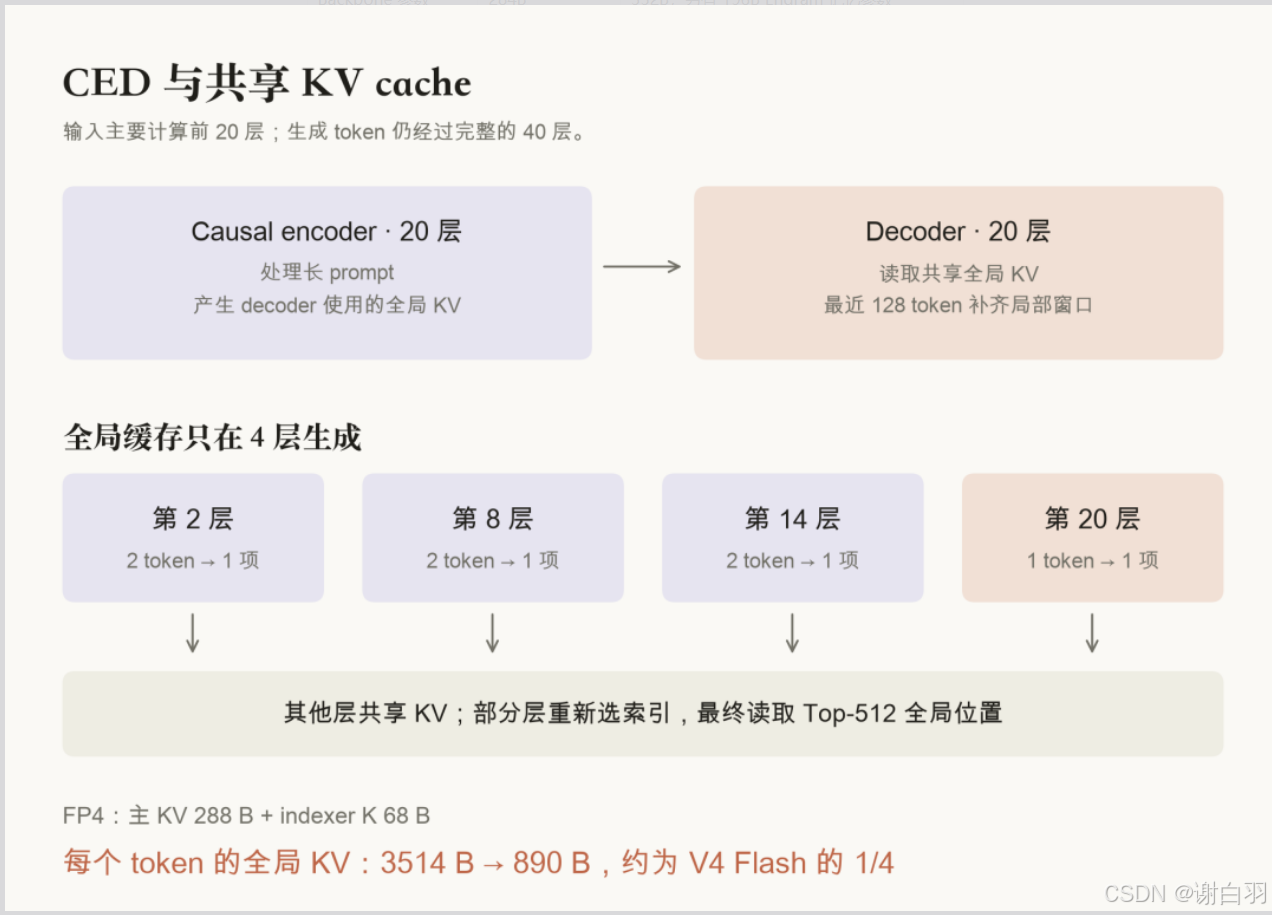
KV cache 压缩来自共享、池化和 FP4 存储。 40 层中只有第 2、8、14、20 层产生全局 KV,其余层复用缓存,部分层重新计算索引。前三份缓存每两个 token 池化成一项,最后一份按 token 保存。主 KV 每项 288 bytes,indexer K 每项 68 bytes,折合每个原始 token:
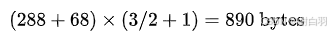
主 KV      288 bytes   ← 正文内容
indexer K   68 bytes   ← 目录/索引(告诉模型去哪些位置找)
────────────────────
一条项     356 bytes   ← (288 + 68)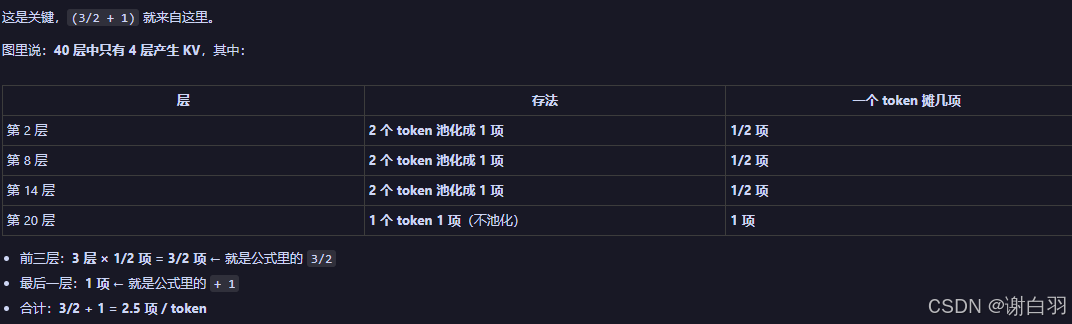
这约为 V4 Flash 的 1/4。局部窗口还能用 bounded replay 重建,减少需要持久保存的状态,官方给出的 SSD 缓存需求约为原来的 1/8。890 bytes 是全局 KV 的逻辑大小;SGLang 部分路径仍使用兼容 FlashMLA 的缓存布局,实际显存占用与此不同。
CSA2 还通过分层候选筛选缩小后续 indexer 的搜索范围,最终只取 Top-512 全局位置参与 attention。Engram 则通过 n-gram 查表补充条件记忆。它们在模型里承担不同工作,也带来了新的索引、归一化和融合需求。
三、优化
3.1 普通 decode 的 kernel 优化
FP8 GEMM:35 → 118 tokens/s
模型的一些 dense 权重已经是 FP8,但量化块和 scale 布局没有适配对应后端,计算进入了较慢的 fallback。我们在加载阶段整理 scale 布局,让它直接进入 Blackwell 的 MXFP8 GEMM 实现。
这一项就把 BS=1 从 35.2 提升到 117.8 ,BS=64 从 2880 提升到 4054 tokens/s。新模型适配时,确认 GEMM 实际调用了哪个 kernel,往往比先调 tile 更有用。
小算子融合与 GEMV
逐 token decode 会反复执行大量短 kernel。RoPE、FP4 量化、压缩器池化、RMSNorm 和缓存写入之间有直接的数据依赖,把相邻操作合在一起,可以减少启动次数和中间结果读写。
| 优化 | 实现方法 | BS=1 的变化(tokens/s) |
|---|---|---|
| RoPE + FP4 | 融合旋转、量化与反量化 | 117.8 → 133.5 |
| C2 压缩器 | 融合相邻 token 的归一化、池化和状态写入 | 148.4 → 152.1 |
| WO-A、norm、Engram gate | 单行投影使用 GEMV,小尺寸归一化和门控使用融合 kernel | 186.6 → 203.3 |
这些数值对应上图中的各个位置。每步的 request 索引和 scratch 也改为跨层共享,减少重复的转换和初始化。
mHC
保留四条残差流,需要计算混合系数,并通过 Sinkhorn 归一化。每层 attention 和 MoE 都会执行一次,小 batch 下开销很明显。按输入行数调整 tile,再融合统计量归约和 Sinkhorn,BS=1 从 133.5 → 141.1 → 146.5 tokens/s。
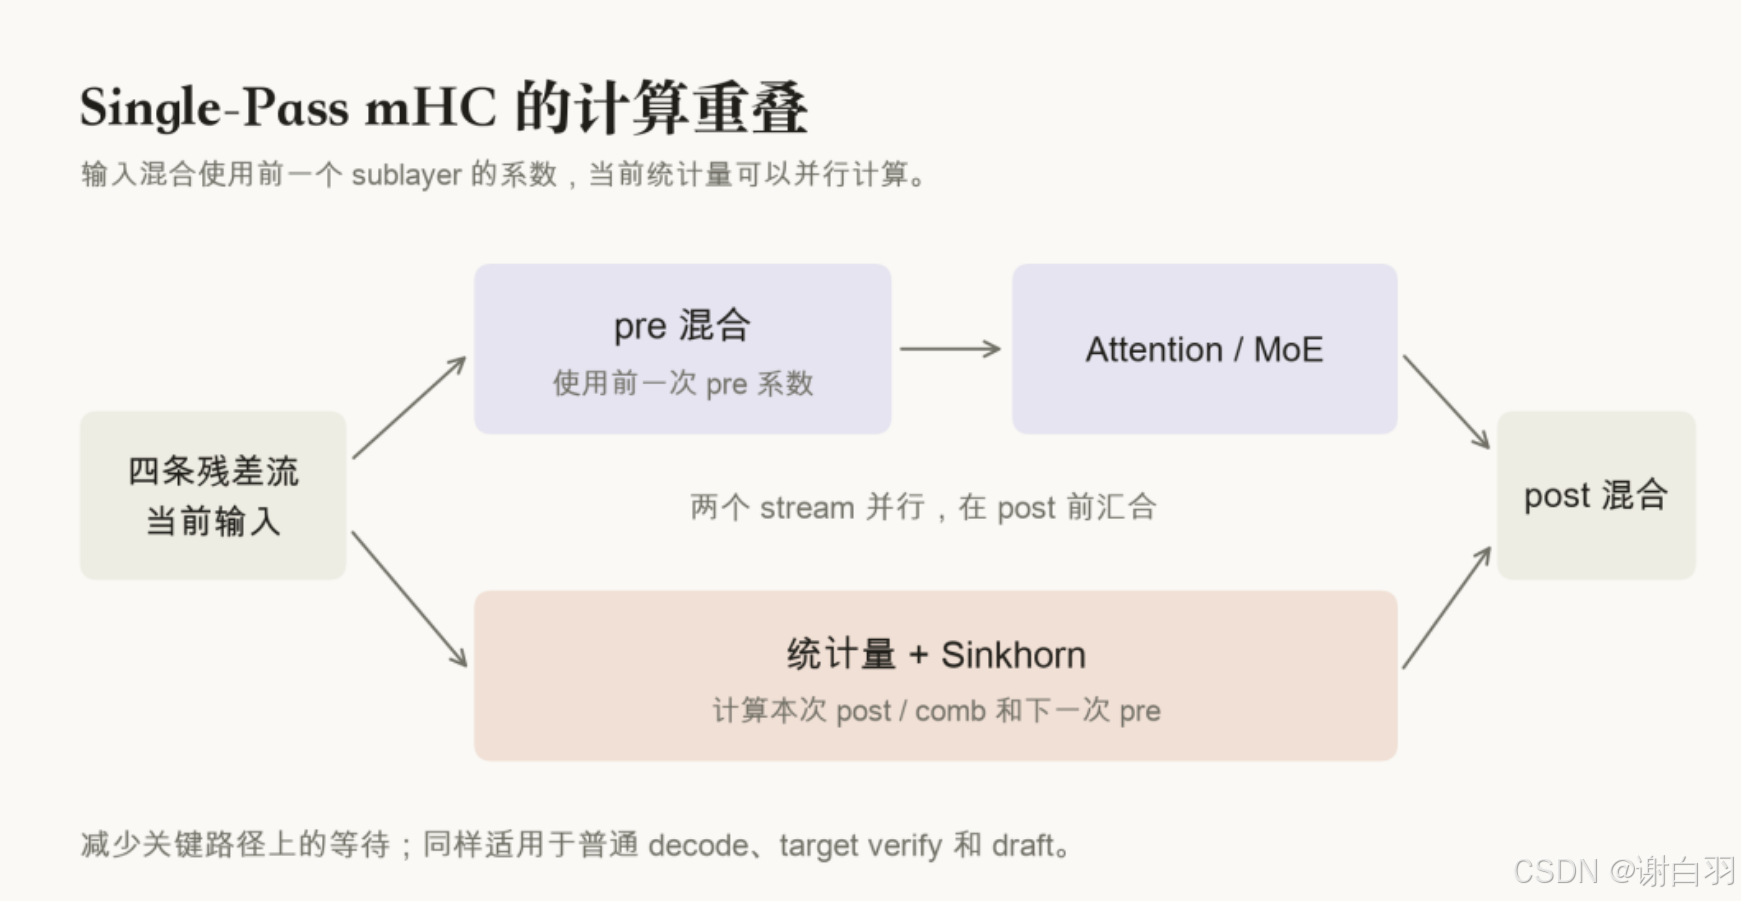
V4.1 的 Single-Pass mHC 使用前一个 sublayer 产生的输入混合系数。当前 attention / MoE 因此可以和当前残差的统计量计算并行,等 post 混合时再汇合。我们用多 stream 实现这一重叠,并结合 compressor / indexer 的融合与重叠,把 BS=1 从约 152 提升到 186 tokens/s ,BS=64 提升到 5227 tokens/s。
3.2 DSpark 适配与优化
DSpark 的权重就在官方 checkpoint 中,包括三个轻量 draft block。它利用主模型后几层的 hidden state,一次为多个位置计算 logits,再用 Markov head 处理 draft token 之间的依赖,最后交给目标模型批量验证。
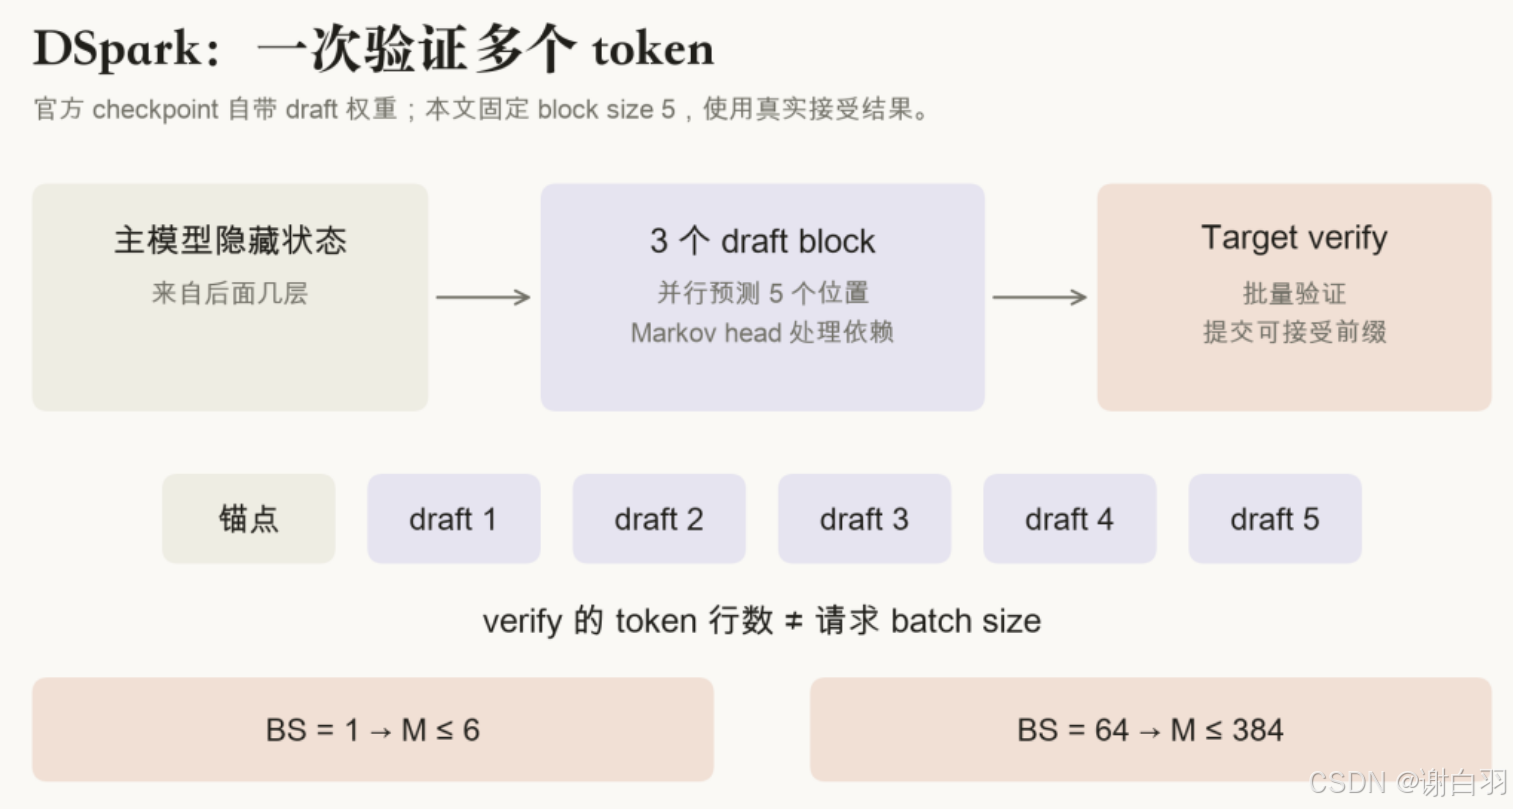
本次使用固定 block size 5,统计真实接受结果。加上锚点,一个请求的 target verify 最多处理 6 行;BS=64 时就是 384 行。普通 decode 中针对 M=1 或 M≤64 写的优化,不能直接覆盖这些形状。这也是开启 DSpark 后还需要继续适配 kernel 的原因。
| 优化 | 主要改动 | 吞吐变化(tokens/s) |
|---|---|---|
| mHC 与 WO-A | 重叠接入 verify / draft;投影直接写入后续需要的布局 | BS=1:566 → 663 |
| Verify kernel 与 candidate mask | 扩大适用形状;融合有效长度判断与候选处理,减少大 buffer 的重复扫描 | BS=1:663 → 699;BS=64:6615 → 13747 |
| MoE 前处理 | Router 直接输出所需布局,输入量化与 routing 重叠 | BS=1:699 → 734 |
| MoE finalize / all-reduce | 专家带权归约、shared expert 加法与通信融合,减少中间结果写回 | BS=1:734 → 764 |
BS=64 的主要收益来自 verify 和候选处理。一些 logits buffer 按最大容量分配,通用 mask 操作会重复扫描大量无效区域;融合后省掉了这些读写。BS=1 则更受益于 mHC 重叠和 MoE 融合。
我们还把接受判断、结果整理和部分 KV 更新放进 CUDA Graph,减少图外的小算子和 CPU 发射间隔。最终 target verify 的 GPU 耗时从 9.049 ms 降到 6.927 ms,每次 graph 的 kernel 数从 2209 减少到 1965。
四、复现
使用 SGLang 的 dsv4.1 分支(https://github.com/sgl-project/sglang/tree/dsv4.1)和官方 checkpoint,测试环境为 4×B300、TP4 / EP4。依赖版本:PyTorch 2.13.0+cu130、FlashInfer 0.6.18、Triton 3.7.1、sglang-kernel 0.4.6.post1、sgl-deep-gemm 0.1.7、CUTLASS DSL 4.6.2。
shell
MODEL_PATH=/path/to/DeepSeek-V4.1
CUDA_VISIBLE_DEVICES=0,1,2,3 PYTHONPATH="$PWD/python" MAX_JOBS=16 \
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --tp 4 --ep-size 4 --trust-remote-code \
  --mem-fraction-static 0.80 --max-total-tokens 33554432 \
  --chunked-prefill-size 4096 \
  --cuda-graph-bs-decode 1 2 4 8 16 32 64 \
  --max-running-requests 128 \
  --speculative-algorithm DSPARK --speculative-dspark-block-size 5 \
  --skip-server-warmup --reasoning-parser deepseek-v41 \
  --random-seed 42 --decode-log-interval 10 \
  --host 127.0.0.1 --port 30021
GPU 编号和模型路径按实际环境修改。启动后调用 POST /freeze_gc,benchmark 前清空请求缓存。
吞吐测试使用脚本构造的英文摘要任务:重复一段气象观测记录,填充到 4096 tokens,再要求模型总结。BS=64 为每个请求加上不同的 Notebook 编号。优化前后使用相同的输入 token,设置 temperature=0、ignore_eos=True,分别生成 1024 / 2048 tokens。DSpark 使用真实接受结果,下面取六次测量的中位数。
| 负载与指标 | DSpark kernel 优化前 | 优化后 |
|---|---|---|
| BS=1,输入 4096 / 输出 1024,首个流式事件之后的输出速度 | 569.88 | 764.29 |
| BS=64,输入 4096 / 输出 2048,稳定 decode 总输出吞吐 | 6555.95 | 13472.51 |
| BS=1,平均 accept length | 5.658 | 5.818 |
| BS=64,平均 accept length | 5.407 | 5.479 |
accept length(接受长度)= 投机解码时,平均"一次验证能接受几个 token"。
吞吐单位为 tokens/s,均不包含完整 prefill 耗时。Accept length 表示每轮 verify 平均提交的 token 数,包含目标模型补出的 token,因此 block size 5 时上限为 6。重复文本较易预测,这里的接受长度和吞吐对应这组输入,不能直接代表真实聊天或推理负载。
五、资料补充
-
LMSYS:SGLang and Miles Add Day-0 Support for DeepSeek-V4.1(https://www.lmsys.org/blog/2026-09-10-deepseek-v41):团队的完整 Day 0 支持介绍,涵盖推理和 RL 训练。
-
SGLang DeepSeek-V4.1 部署指南(https://docs.sglang.io/cookbook/autoregressive/DeepSeek/DeepSeek-V4_1):启动配置、硬件支持和调优说明。
-
SGLang DeepSeek-V4.1 代码(https://github.com/sgl-project/sglang/tree/dsv4.1)。Miles DeepSeek-V4.1 Flash 训练指南(https://miles.radixark.com/docs/models/deepseek/deepseek-v4-1-flash):训练环境、checkpoint 准备和 RL 启动配置。
-
Miles GitHub 仓库(https://github.com/radixark/miles)。
-
DeepSeek-V4.1 技术报告(https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf)。
Kernel 实现细节可以直接看 mHC、candidate mask 和 MoE / all-reduce