上周,我看到了海外知名 AI 研究者 AK 的一个帖子。
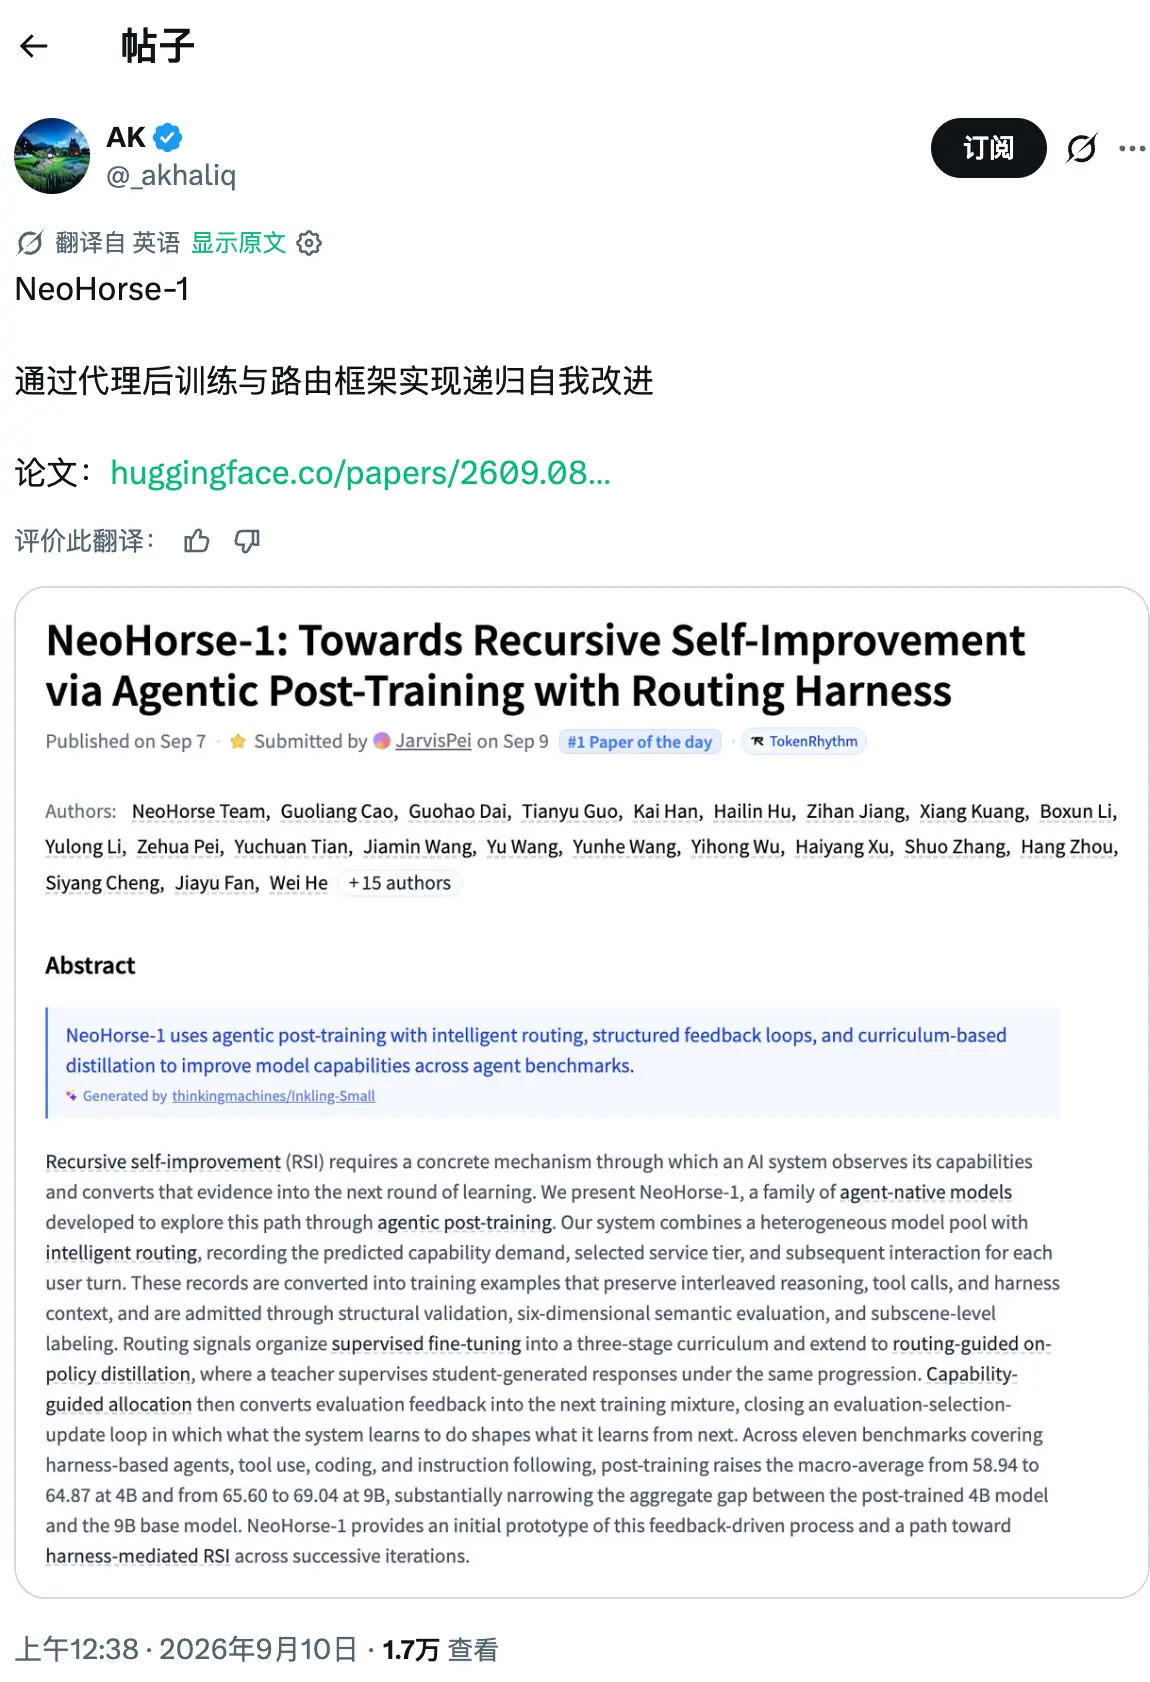
图源:AK 原帖
这个帖子介绍的是一个名为 NeoHorse-1 的开源模型,主打通过后训练与路由框架,探索通往递归自我改进(Recursive Self-Improvement,简称 RSI)的工程路径。
看到后训练和 RSI 这两个在大模型前沿极其抢眼的热词,我下意识以为这又是哪家顶尖基础模型大厂(如 OpenAI、Anthropic、阿里、智谱等)或高校实验室在展示前沿成果。但点开 ArXiv 上的技术报告看到作者团队时,说实话我是有点困惑的。
这个模型背后的主导者,居然是基元律动(TokenRhythm)。
基元律动?这不是一个搞开源、搞多模型聚合路由 API 的厂商么。
他们有一个很出名的 Agent 运行框架,就是 OpenSquilla ,也叫做皮皮虾,就是这个
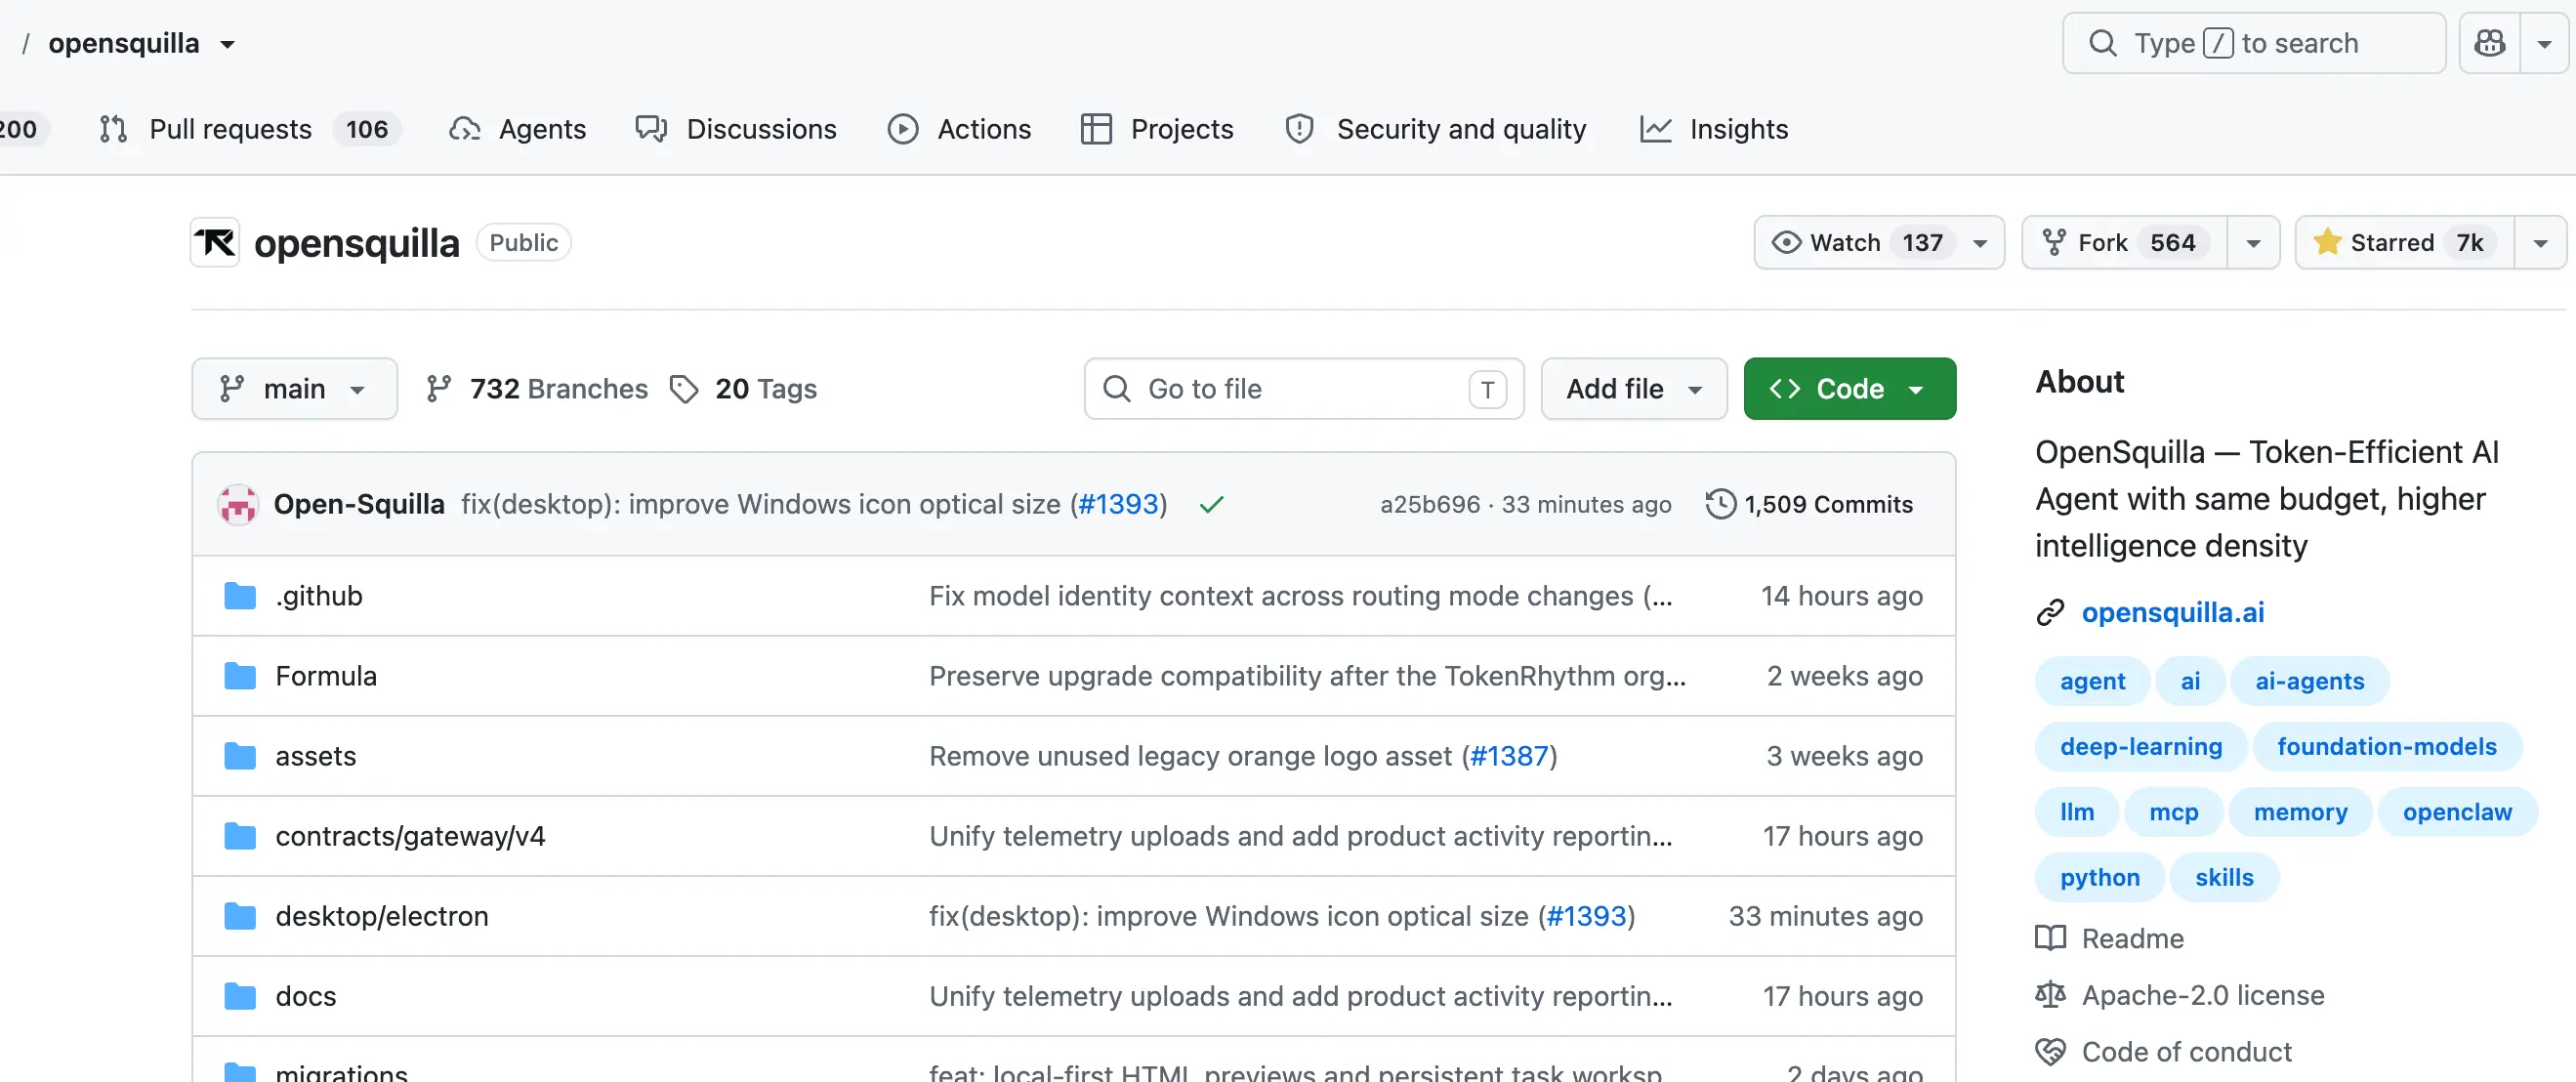
这个 GitHub 项目已经有 7k star 了,确实很火,而且 Issue 和 PR 也非常多,社区很活跃。
除此之外,这个厂商还搞了一个多模型聚合路由 API ,TokenRhythm API 。
这立刻引发了我的好奇:一家做中间层路由调度、帮开发者省 Token 账单的中间件公司,不好好做工具,怎么自己挽起袖子下场训模型了?
而且上来一发不可收拾的直接搞 RSI 去了?这可是一个 Agent-Native 的模型啊。
带着这种类似反直觉的疑问,我通读了他们的技术报告,发现背后隐藏着一套极具启发性的技术与商业逻辑闭环。
下面就跟大家聊聊这事儿。
后训练与 RSI
我觉得要理解这件事情的起因经过结果升华 :) ,得先从后训练和 RSI 来说起。
在行业早期内,大家都认为一个超级大模型能够上下通吃,多场景吞并。但现实是全球模型持续赛马,各自在代码、数学推理、中文语境、超长上下文或推理成本上各有所长,我觉得百花齐放这个词用到这里还挺搭的。
在真实的 Agent 任务中,一个复合型任务有可能会串联调度多个模型,模型之间的账单成本根本不一样,比如刚上线的 GPT-6 Astra,你会拿他来做测试吗?之前 A 社还单独发了一篇文章就在说,Opus 负责规划,Sonnet 负责执行,Haiku 负责做测试验证。
根据基元律动提供的平台账单统计,最贵、最顶级的模型往往只承担了大约 10% 的核心复杂决策,却消耗了 75% 以上的 Token 账单预算。
Token 账单在成为显性刺客。
而且大模型的进化也在迅速加快,从最初的 Chat (一问一答式) -> Reasoning(思维推理)-> Coding(执行验证反馈)-> Agent(多步规划、多工具交互、反馈)。
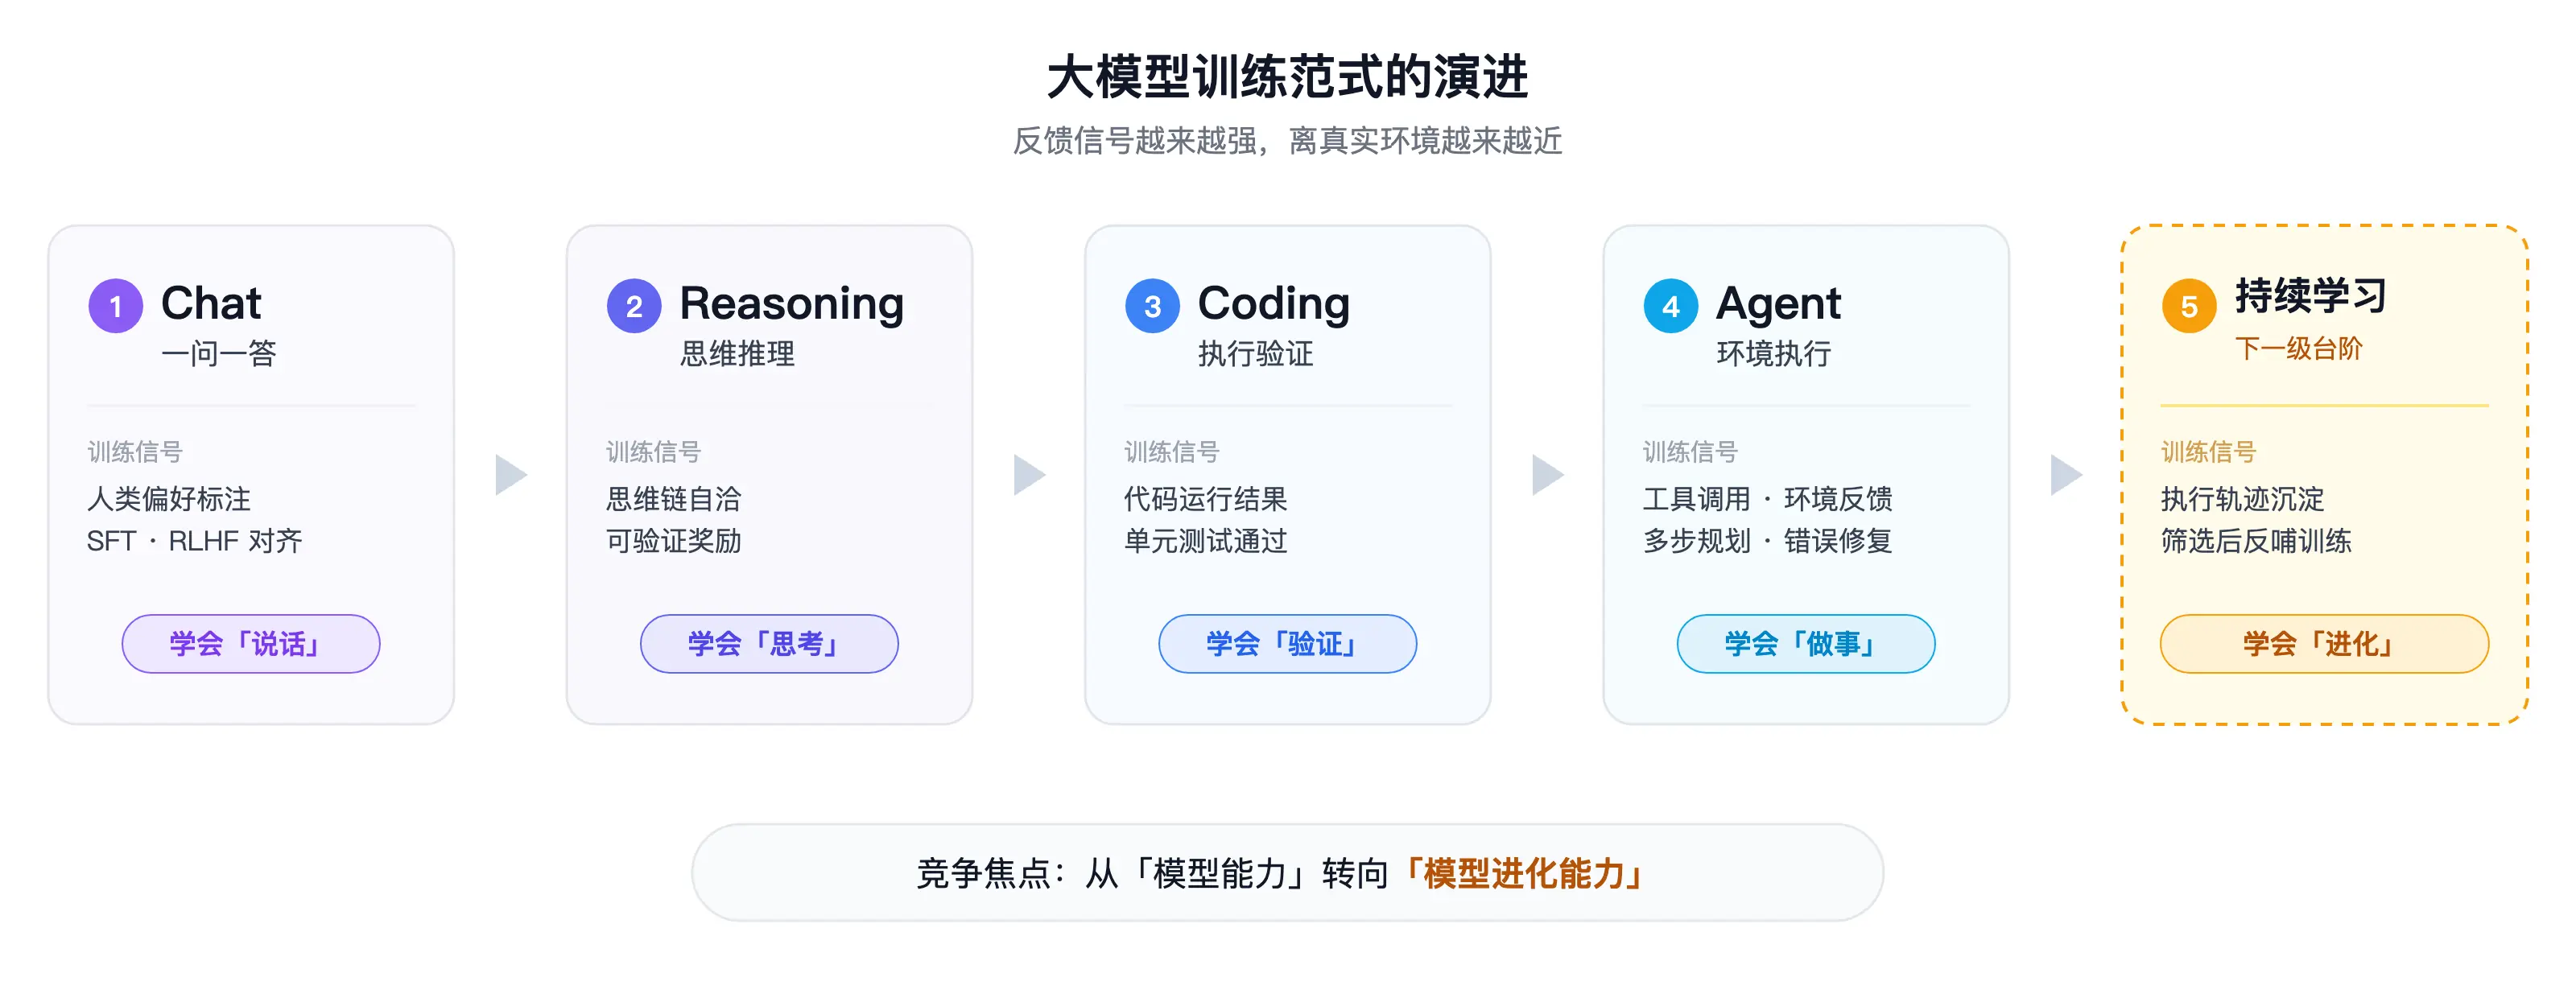
当公开网络上的高质量人类语料基本被预训练吃干抹净后,行业的胜负手已经转移到了后训练(Post-Training) ,以及更长远的目标递归自我改进(RSI)。
RSI 描绘的是一个极其诱人的图景:AI 系统能够观测自身执行任务的表现,并将这些经验反馈转化为下一轮自我升级的依据,让每一代模型助力下一代模型的生成,把原本孤立的训练转变为复利增长。
写到这里我停下来想了一个问题:这种迭代式增长,和斐波那契数列是一样的吗?
想了想,还是不一样。斐波那契是一场纯粹的数学游戏:每一项由前两项机械相加,规则一旦给定,数列就无条件地滚下去,中间没有任何质量把关。而 RSI 式的增长更像复利:每一轮的「本金」是上一轮沉淀下来的执行轨迹,但这些本金必须先经过评测与筛选这道「风控」,确认哪些经验真的值得学,才允许进入下一轮。所以这种增长能不能滚起来,关键在于每一轮的评测和筛选是否可靠。
RSI 最大的工程难点在于:模型无法在真空里自我进化,它必须在一个具备真实交互和严密反馈的环境中历练。
当 Agent 在编写代码、排查系统故障或处理数据时,它在环境中所做出的每一次决策、工具调用、报错以及最后的修复,都会留下一串结构化的记录,也就是所谓的交互轨迹(Trajectory)。
这些 Trajectory 并不是静态的问答语料,它记录了模型完整的纠偏和进化能力的过程,包括如何尝试、碰壁、调整并解决最终问题的。
而掌握这些 Trajectory 的,就是大家所熟知的驭马工程(Harness)。
Harness 是如何把执行反馈变成训练数据的?
所谓的驭马工程(Harness),你可以理解成 Agent Runtime 外面的执行层:它管理着模型的上下文、可用工具集、外部环境反馈以及多轮会话状态。
当 Harness 引入了 **Agentic Routing(智能路由)**机制后,它不仅能根据任务复杂度将请求分发给最合适、最经济的模型,还能完整记录下任务在不同阶段的模型调用轨迹与执行成败。
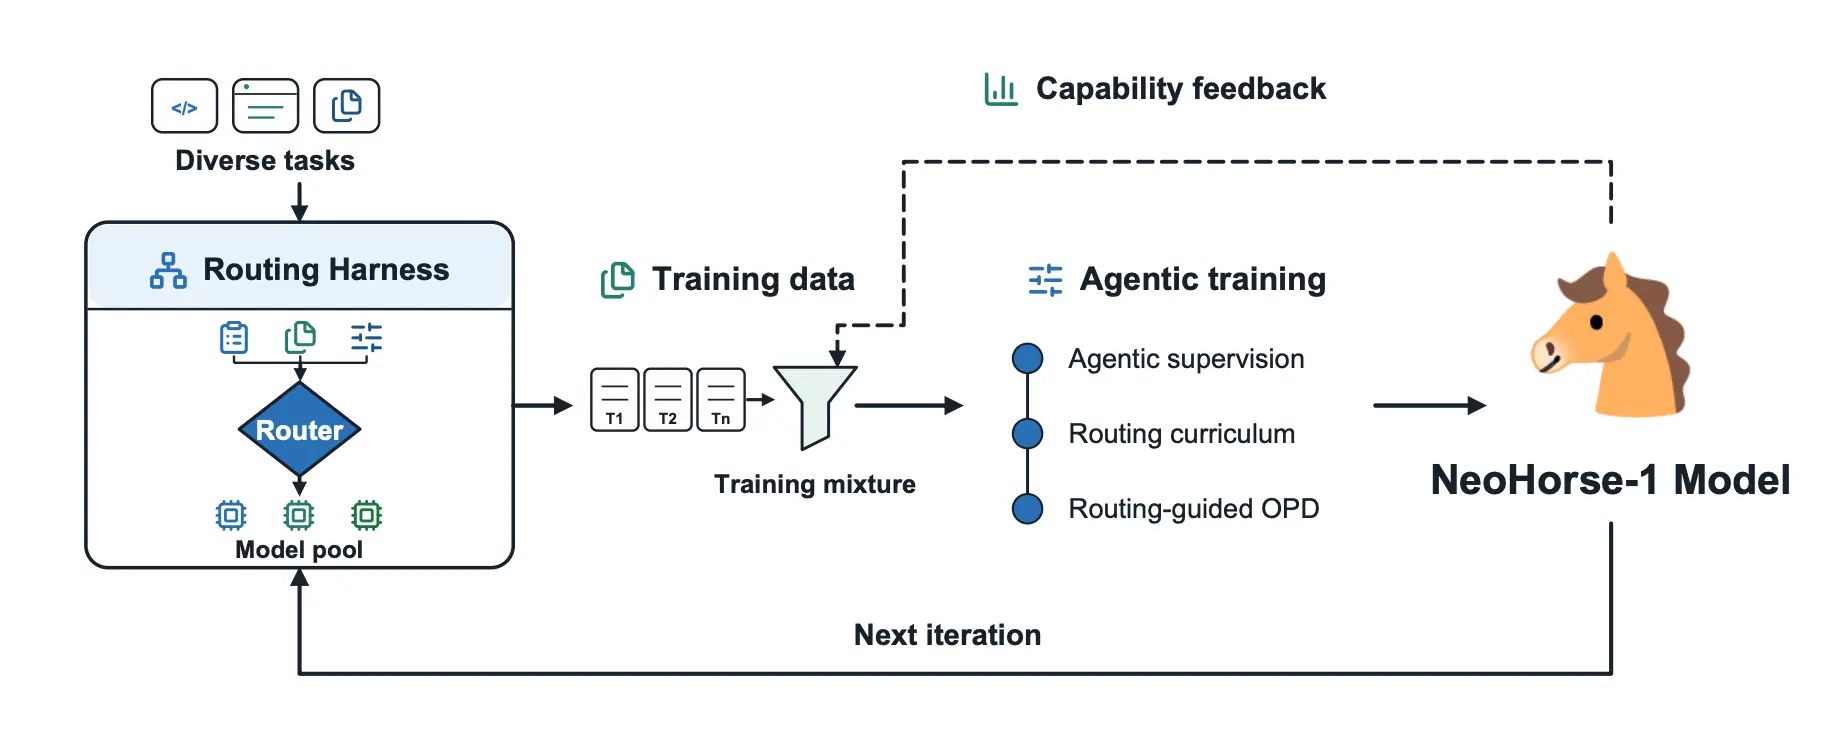
在基元律动的技术报告中给出的系统架构,也极其生动地展示了这一闭环:
图源:NeoHorse-1 技术报告
仔细拆解上图,整个系统实际上构成了 Data-RSI(数据飞轮) 与 Model-RSI(模型飞轮) 的协同双环:
- 环境与轨迹收集(Routing Harness): 面对外部多样化的任务(Diverse tasks),Routing Harness 通过智能路由器(Router)在异构模型池(Model pool)中分派任务并执行,完整沉淀出包含工具调用与环境交互的原始轨迹数据。
- 能力反馈与数据筛选(Capability Feedback -> Training Mixture): 执行记录并不等于训练样本。系统通过自动化评测模块,时刻监控模型当前能力的短板。评测反馈会动态调整下一轮训练的数据配比(Training mixture),确保模型缺什么补什么。
- 针对性智能体训练(Agentic Training): 有了高质量轨迹和筛选后的数据配比,系统采用三阶段训练机制:
- Agent 执行监督(Agentic Supervision):学习严谨的推理步骤、工具调用格式与错误恢复;
- 路由课程学习(Routing Curriculum):将路由系统的复杂度分级(如 C0--C3)作为课程表,由易到难逐步增加学习难度;
- 路由引导的在策略蒸馏(Routing-guided On-Policy Distillation, OPD):让小模型实际生成行动路径,再由更强的模型针对其生成过程提供即时纠偏与指导。
- 模型回流与下一轮迭代(Next Iteration) : 按照这套设计,完成训练后的 NeoHorse-1 可以重新部署回模型池(Model pool),在 Harness 的调度下承接实际任务,为下一轮观测和改进提供新数据。
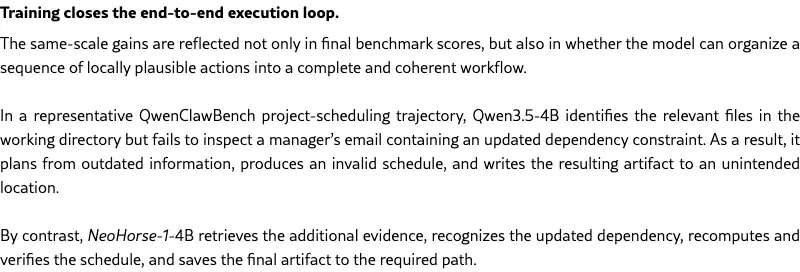
技术报告里有个项目排期案例,特别适合解释这事。
Qwen3.5-4B 找到了工作目录里的相关文件,却漏读了一封包含最新依赖关系的经理邮件。结果它拿着过期信息做排期,生成了一份无效计划,连文件都放错了位置。
NeoHorse-1-4B 却继续找到这封邮件,识别更新后的依赖关系,重新计算并验证排期,最后把文件存到要求的路径。两个模型最后都会回复,差别在于有没有把事情真的做完。
图源:NeoHorse-1 技术报告 5.1 节
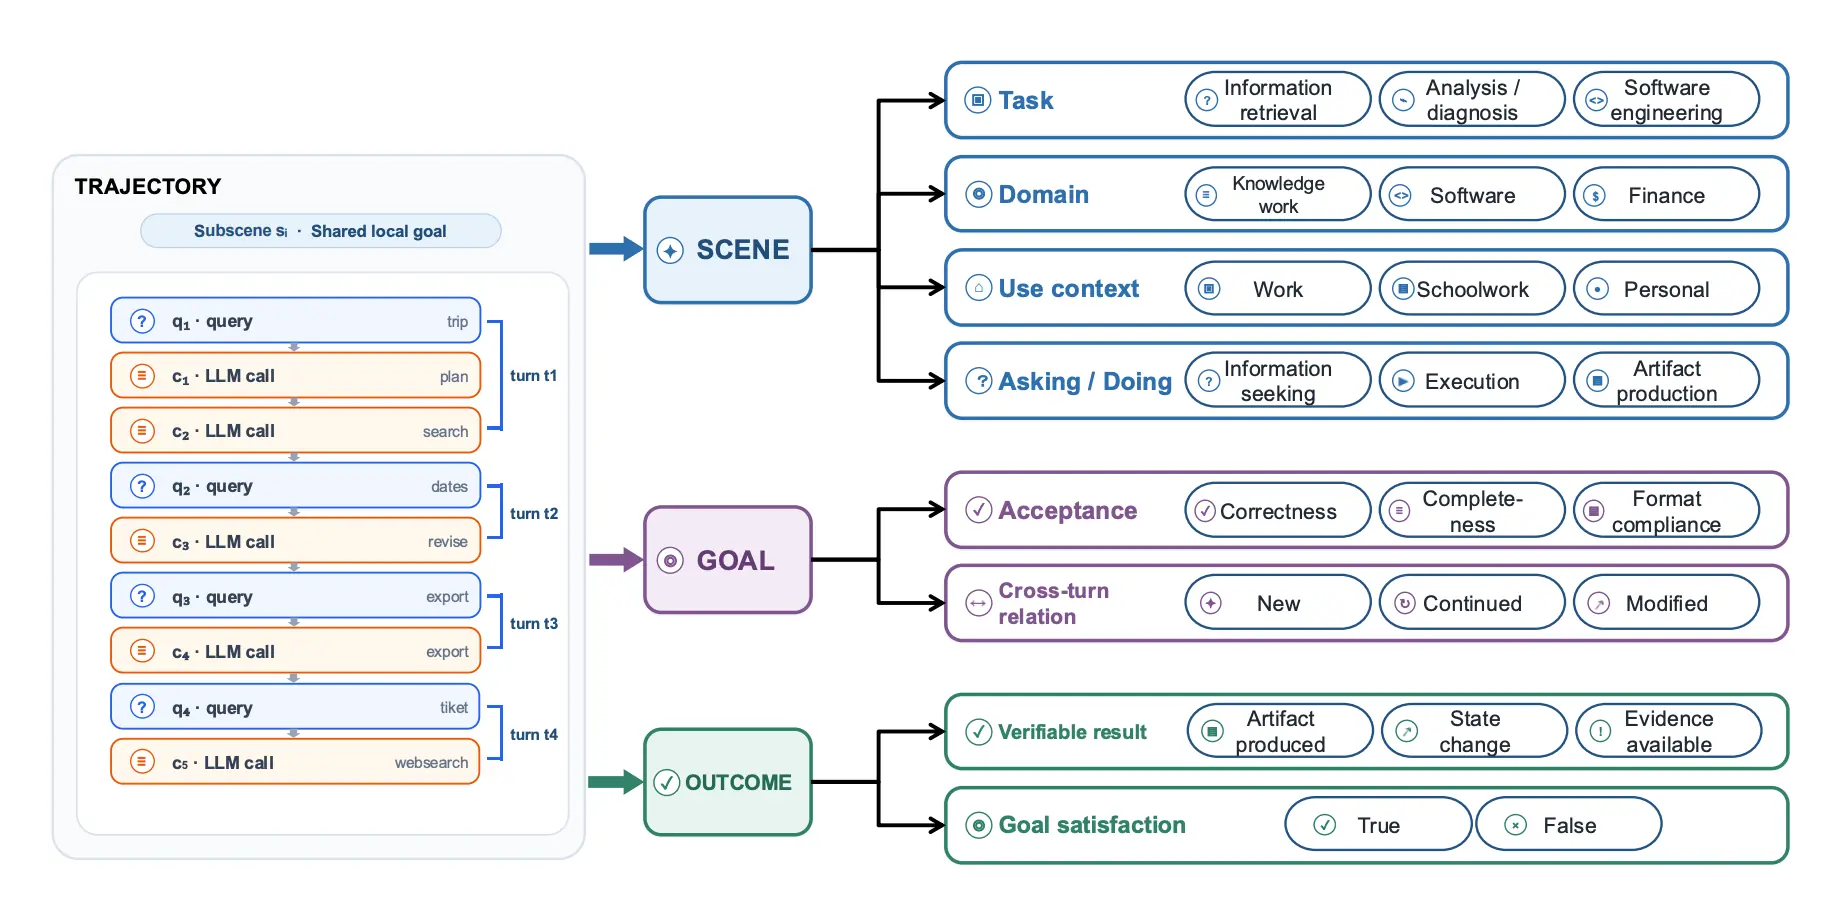
NeoHorse-1 的技术报告里最硬核的地方,我觉得是它对 Trajectory 的处理规范:
图源:NeoHorse-1 技术报告
如上图所示,每一条复杂的长程 Trajectory,首先会被切分为拥有局部目标的子场景(Subscene Si),再从 场景(SCENE) 、目标(GOAL) 和 结果(OUTCOME) 三个角度描述任务本身:
1. 场景维度(SCENE)
- Task(任务类型):区分是信息检索(Information retrieval)、分析诊断(Analysis / diagnosis)还是软件工程(Software engineering);
- Domain(业务领域):标注知识工作(Knowledge work)、软件代码(Software)还是金融计算(Finance);
- Use context(使用场景):工作生产(Work)、学术研究(Schoolwork)还是个人生活(Personal);
- Asking / Doing(交互性质):严格区分是普通的咨询问答(Information seeking)、实际执行系统操作(Execution),还是最终产出具体交付制品(Artifact production)。
2. 目标维度(GOAL)
- Acceptance(验收标准):从正确性(Correctness)、完整性(Completeness)到格式规范(Format compliance)多重验证;
- Cross-turn relation(跨轮次关系):判断当前轮次是开启了全新任务(New)、延续此前进度(Continued),还是用户根据中间结果调整了需求(Modified)。
3. 结果维度(OUTCOME)
- Verifiable result(可验证产物):是否有确切的产物生成(Artifact produced)、系统状态是否发生改变(State change)、是否有充分的事实证据(Evidence available);
- Goal satisfaction(目标达成判定):严格给出最终布尔值(True / False)。
这三个角度描述「用户要做什么、想做到什么、最后拿到了什么」。轨迹质量则另外看六个维度:目标达成、指令遵循、工具使用、证据一致性、错误恢复和正常终止。
这一设计的精髓在于把任务完成(Completed)与质量达标(Satisfied)严格区分开来。 很多时候 Agent 以为自己回复了就是完成了,但只有质量评估达标、结果也能验证的轨迹,才有资格进入训练集。
4B/9B 小模型的跑分越级表现
基元律动这次开源的 NeoHorse-1 采用了 Qwen3.5 作为初始化底座,发布了 4B 与 9B 两个主流小模型规格。
目前 4B、9B、GGUF 量化版和 Apple Silicon 可用的 MLX 版本都已经放出来了,采用 Apache 2.0 协议,原生上下文长度为 262,144。模型可以在 Hugging Face 和魔搭社区下载,部署方式与完整评测也放在了 GitHub 上,相关链接见文末。
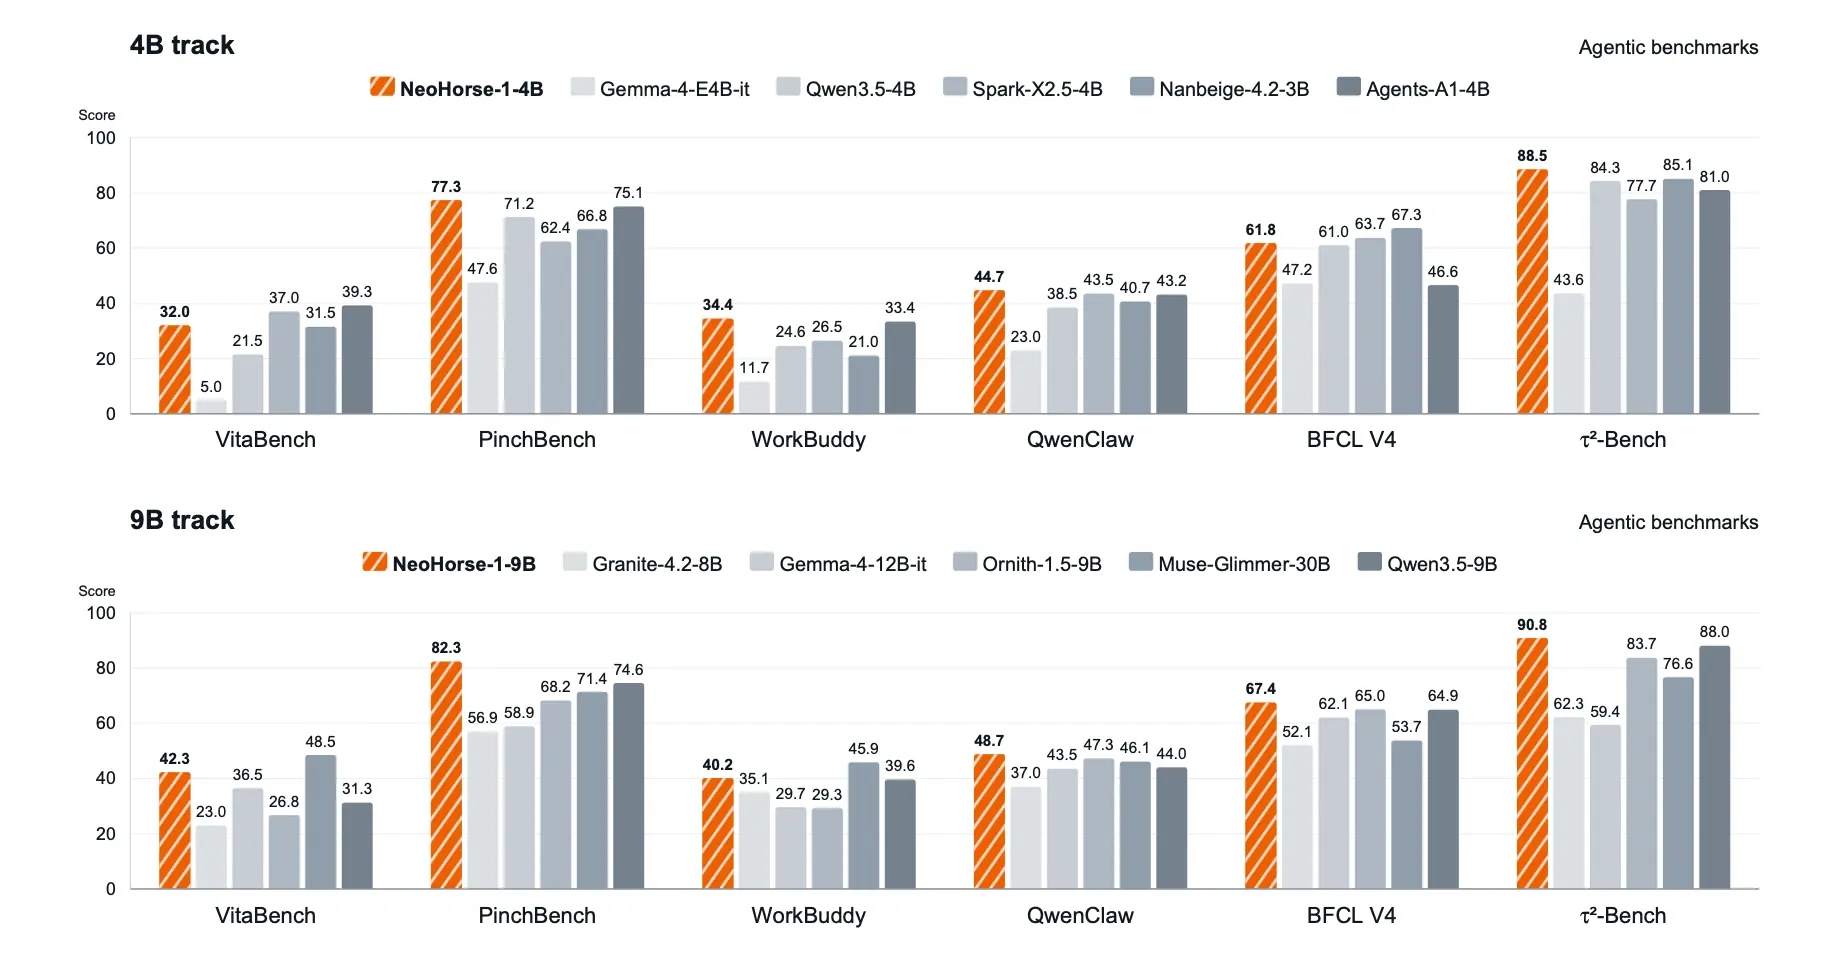
在涵盖智能体框架交互、指令遵循、代码编写、复杂工具调用等 10 项基准测试中,其官方自测表现如下:
图源:NeoHorse-1 技术报告
从具体的各项智能体基准对比中,可以看到几个非常显著的特征:
- 4B 赛道(4B Track) : 在后训练加持下,NeoHorse-1-4B 的综合平均分从底座的 58.94 跃升至 64.87(+5.93)。10 项评测全部高于原始的 Qwen3.5-4B,在 τ²-Bench 复杂工具交互上拿到了 88.46,在 PinchBench 上也达到了 77.33。按这组官方评测的平均分,它在 4B 同尺寸对比中最高,也已经逼近未经后训练的 9B 基座水平。
- 9B 赛道(9B Track) : NeoHorse-1-9B 的综合平均分从 65.60 提升到 69.04(+3.44),多数项目都有提升。不过 LiveCodeBench 和 IFBench 与底座持平,IFEval 还低了 0.37 分。它的提升更集中在长程工具调度、执行与容错这些 Agent 任务上。
- 真实轨迹 vs 合成数据 : 技术报告中还有一个关键对比:在相同底座、课程表、优化器、随机种子和评测协议下,使用 Harness 沉淀轨迹训练的模型,在 5 项可比评测上比使用公开合成工具数据集 Toucan 平均高出了 6.26 分。至少在这组配置和这 5 项测试里,经过筛选的真实执行轨迹更有效。
当然,技术团队在报告中写得挺克制:对于极端复杂的跨文件架构重构、长程状态保持任务,4B 小模型仍有自身上限,仍然需要路由调度到更强大的前沿大模型,但这恰恰是 Harness 存在和协同调度的意义所在。
我在想这是哪个团队做的事情?直到我翻到技术报告的最后我才懂了。
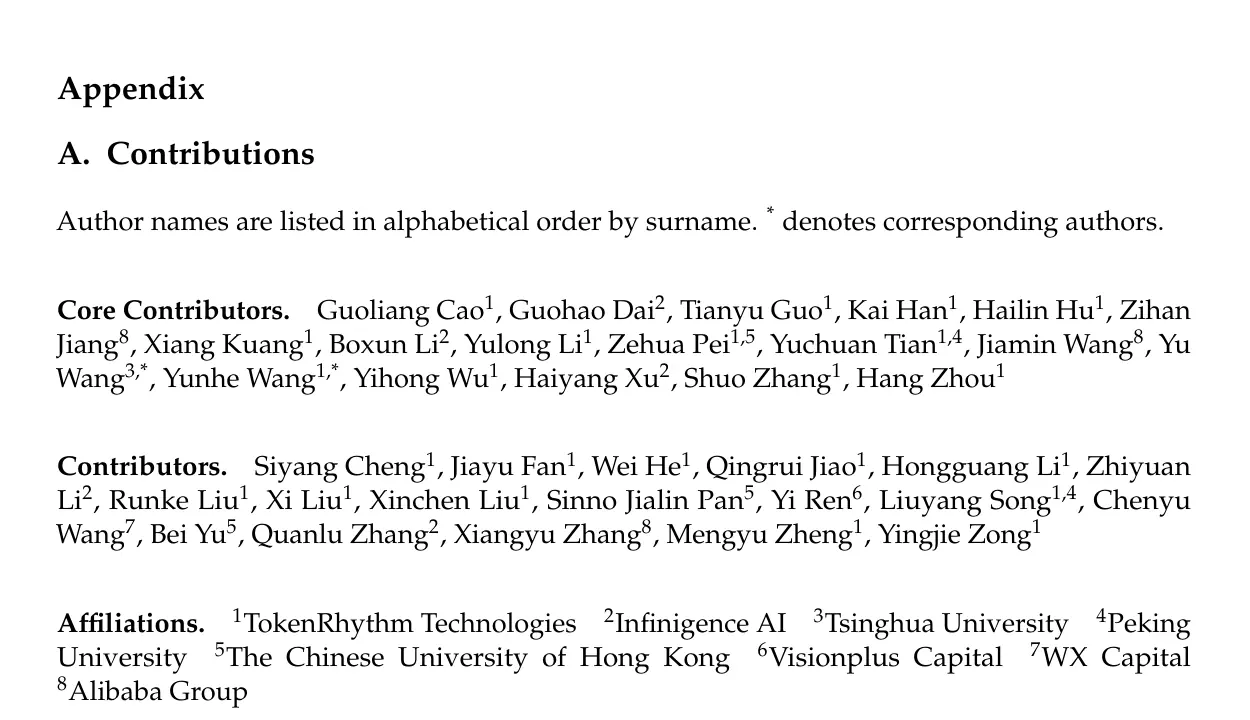
图源:NeoHorse-1 技术报告附录 A
无问芯穹官方披露的说法是:NeoHorse-1 由基元律动与无问芯穹联合发布,无问芯穹提供大模型基础设施支持,清华大学、北京大学团队参与算法和训练方法研究。技术报告附录列出的作者机构还包括香港中文大学、阿里巴巴集团等。
怪不得。
最后的思考
回到我们最初的疑问:一家做 API 和 Harness 调度工具的公司,为什么下场训模型?
看完 NeoHorse-1,答案已经非常清晰了。基元律动其实是在用一个模型,串联起了一套极为严密的商业与技术飞轮:
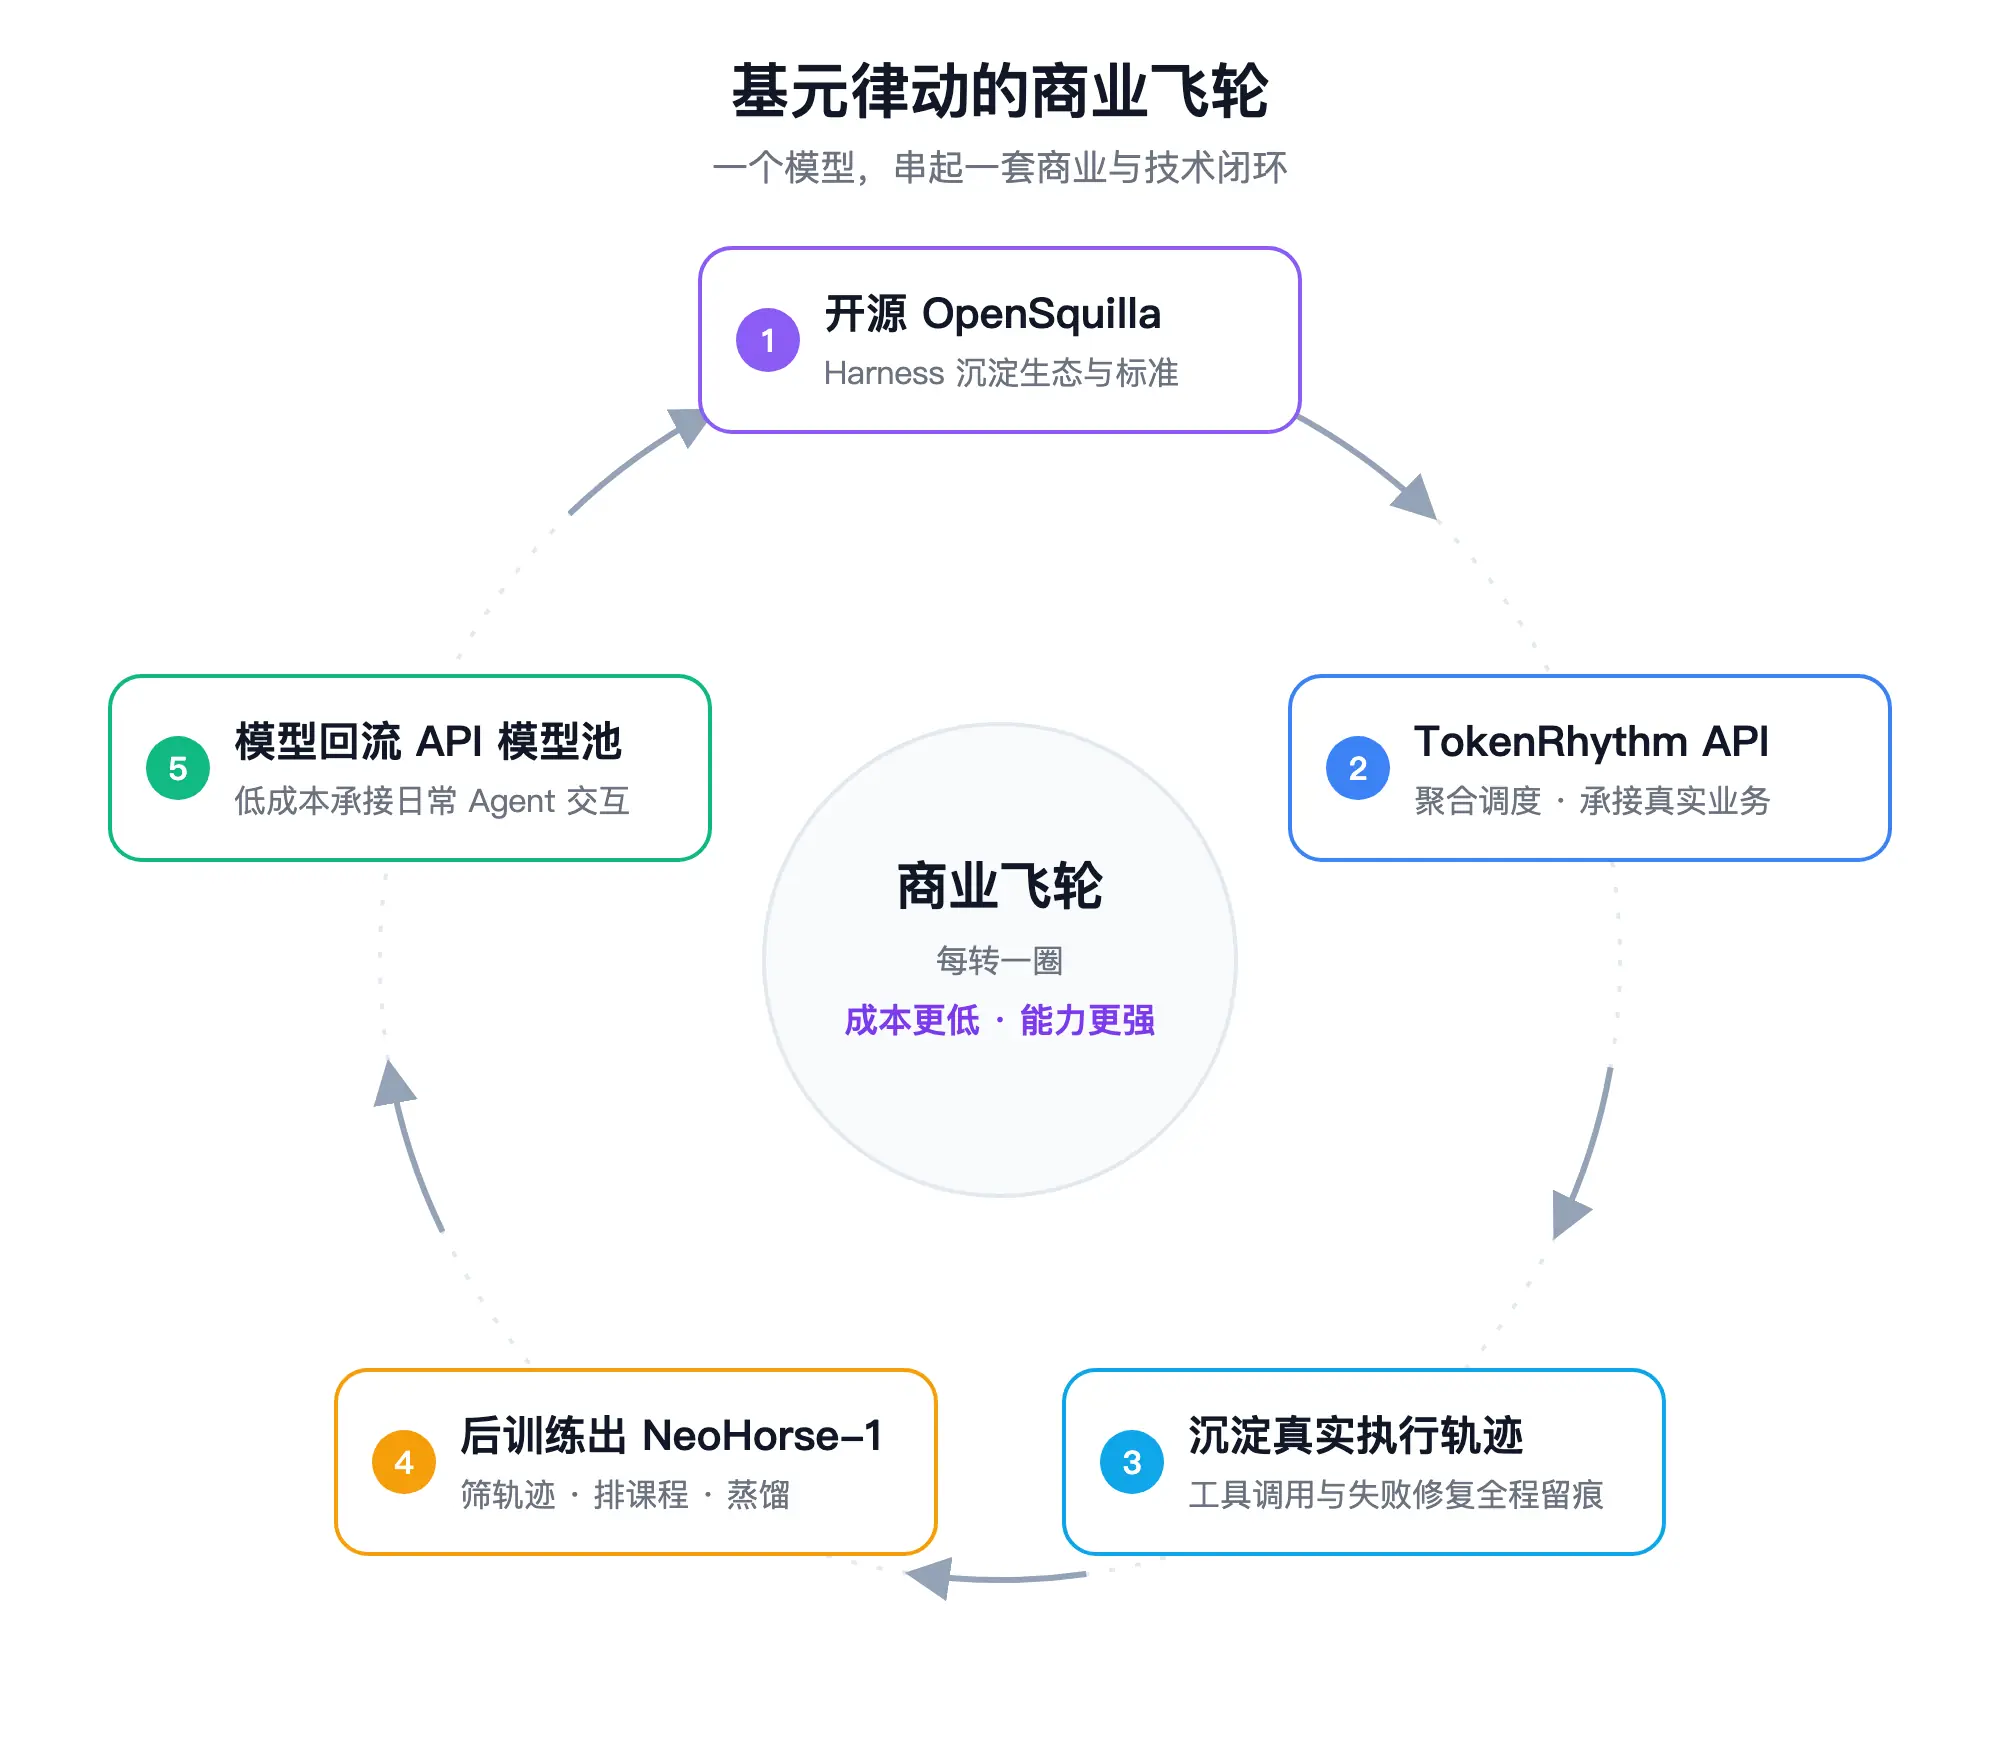
OpenSquilla 负责把 Agent 任务跑起来,TokenRhythm API 负责在不同模型之间做调度。而 Harness 每跑完一个任务,其实都是一层反馈信号:这一步路由给了谁、工具调用、失败之后如何回复、结果有没有验证。这些信号经过结构校验、质量评估和筛选之后,才成为 NeoHorse-1 后训练的教材;训练好的模型再回到模型池里,去承接下一批任务。
技术路线上,NeoHorse-1 跑通了面向 RSI 的一次单轮工程验证。尽管从严格意义上讲,目前的奖励信号设计、数据配比与训练流程仍需工程师人工干预,尚未达到全自动、无人干预的终极自进化形态,但这无疑迈出了极具实践价值的一步。
相关链接
- AK 原帖:x.com/\_akhaliq/s...
- NeoHorse-1 技术报告:arxiv.org/abs/2609.08...
- NeoHorse-1 GitHub:github.com/TokenRhythm...
- NeoHorse-1 Hugging Face:huggingface.co/collections...
- NeoHorse-1 魔搭社区:www.modelscope.cn/collections...
- OpenSquilla GitHub:github.com/TokenRhythm...
- 无问芯穹官方说明:www.infinigence-ai.com/news-update...