这两年,几乎每个制造企业都在谈AI。但真正动手的企业很快会发现一个尴尬的现实:
大模型很热,落地却很冷。
工艺工程师想用一个"问答助手"查排障手册,发现文档散落在十几个系统里;品质团队想做缺陷自动归因,发现MES、QMS、设备日志的数据口径根本对不上;IT团队好不容易接入了大模型,却发现生产数据一出厂,安全部门第一个不同意......
问题的根源不在模型,而在底座。
我们结合国内外灯塔工厂与智能中台标杆的实践经验,梳理出一套面向制造企业的AI基建底座建设方法论。全文约2600字,建议收藏后对照自查。
一、为什么"底座"成了必答题?
很多企业做AI的路径是"烟囱式"的:某个部门有痛点,就立一个项目,买一套工具,建一个小模型。一年下来,场景做了十几个,能力却无法复用------每个场景都在重复造轮子。
AI竞争的本质,正在从"模型竞争"转向"基建竞争"。
要让AI在企业里规模化生根,必须先回答三个问题:
-
数据从哪来? 设备数据、业务数据、工程文档是否打通?
-
能力怎么复用? 每个场景的Agent、模型、知识库能否沉淀为公共资产?
-
风险如何可控? AI的每一次决策能否追溯、解释、问责?
因此,AI基建的建设必须坚守三条原则:
-
以数据为基、以场景为锚、以价值为尺------紧扣QCDS(质量、成本、交付、安全/服务),坚持"一痛点一算账":纵轴看一年损失多少钱,横轴看数据成熟度。
-
能力推导链路闭环 ------严格遵循 数据 → 知识 → 模型 → Agent → 业务价值 的端到端链路,不建脱离业务的空中楼阁。
-
分层解耦、能力复用------统一入口、统一语义、统一调度、可管可控。
二、总体架构:五层底座 + 两大立柱
我们把工业AI基础设施规划为**"五层横向能力底座 + 两大纵向治理立柱"**:
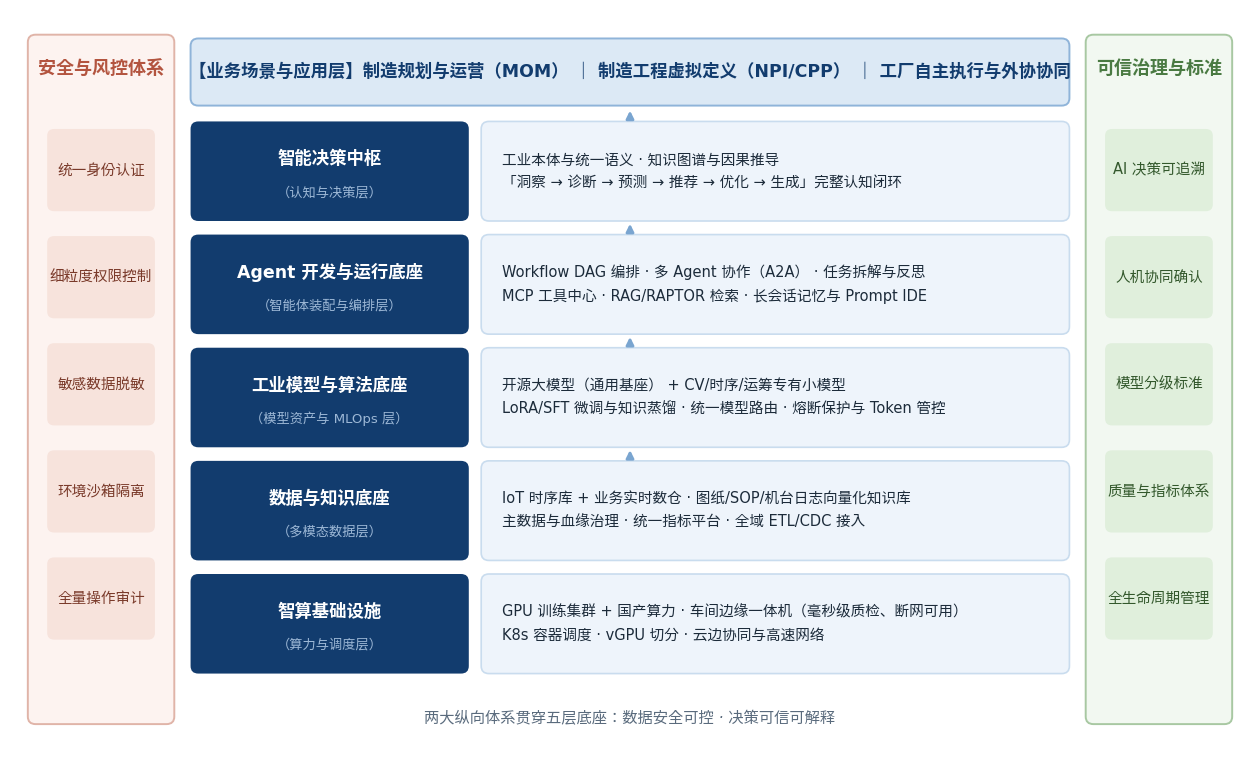
从下往上看,五层底座各司其职:
表格
| 层级 | 定位 | 解决的核心问题 |
|---|---|---|
| 智算基础设施 | 算力与调度层 | 算力从哪来、怎么高效用 |
| 数据与知识底座 | 数据燃料层 | 数据怎么采、怎么治、怎么变成知识 |
| 工业模型与算法底座 | 模型资产层 | 用什么模型、怎么管模型 |
| Agent开发与运行底座 | 编排层 | 智能体怎么搭、怎么协作 |
| 智能决策中枢 | 认知与决策层 | 如何形成洞察、诊断、预测的闭环 |
左右两侧,是贯穿始终的两大立柱:
-
安全与风控体系:统一身份认证、细粒度权限、数据脱敏、沙箱隔离、全量审计------让AI"不敢乱来"。
-
可信治理与标准体系:决策可追溯、人机协同确认、模型分级标准------让AI"出了问题查得到"。
三、六大底座,各自解决什么问题?
底座一:智算基础设施------算力与调度层
采用云---边---端三级协同架构:
-
中心算力:承载工业大模型微调、向量计算与知识图谱构建;
-
车间边缘节点 :部署边缘一体机,支撑AOI视觉质检等毫秒级场景,断网也能用,数据不出厂;
-
端侧轻量智能:巡检终端、手持设备上运行量化精简模型。
配合K8s容器调度与vGPU切分技术,算力利用率可从传统独占式的15%~20%提升至60%以上。
底座二:数据与知识底座------数据燃料层
三层数据汇聚管道并行:
-
设备层(OT):通过OPC-UA、Modbus、MQTT等工业协议,毫秒级接入PLC、传感器数据;
-
业务层(IT):通过CDC变更捕获,实时同步ERP、MES、QMS、WMS核心数据;
-
文档层:支持PDF、CAD图纸、工艺指导书、质检图片等15+种格式的批量解析与向量化。
两个关键抓手:
-
统一指标平台:沉淀节拍、OEE、直通率、制造成本等核心指标,彻底杜绝"同名不同义、同义不同名";
-
知识工程 :动态切片 + 混合检索(向量语义 + BM25关键词 + 重排模型),让技术文档与排障手册的召回准确率达到92%以上。
底座三:工业模型与算法底座------模型资产层
坚持**"通专结合、大小协同"**的模型矩阵:
-
通用大模型负责语义理解与任务拆解;
-
通过LoRA/SFT微调与知识蒸馏,打造7B~32B的工业垂域模型,推理成本降低70%以上;
-
CV质检、时序预测、运筹排产等点状场景,保留高精度专用小模型。
配套MLOps/LLMOps流水线:统一模型网关负责路由与限流,版本注册、灰度发布、漂移监测实现模型全生命周期闭环。
底座四:Agent开发与运行底座------智能体编排层
-
可视化编排:Workflow DAG画布,业务人员低代码搭建"工单延误根因分析"这类多步流程;
-
工具中心:基于MCP等标准协议,把ERP下单、MES暂停、WMS调拨等系统操作封装为Agent可调用的"技能"(Skill);
-
人机回环(HITL) :报表生成、数据查询等低风险任务全自动执行;参数修改、自动停线、采购下单等高风险操作,必须人工确认后执行,全程留痕。
底座五:智能决策中枢------认知与决策层
-
构建覆盖产品、工艺、设备、质量、人员、物料六大对象的工业本体,打通系统间的语义壁垒;
-
沉淀DFM规则库、工艺机理库、FMEA故障案例库、质检标准库四大知识库;
-
形成 「洞察 → 诊断 → 预测 → 推荐 → 优化 → 生成」 的完整认知链条------例如从"AOI虚焊异常"自动反推"回流焊温区曲线偏移"的根因。
底座六:安全可信与合规治理------两大立柱
对标行业标杆的三大信任原则:
每一个行动可追踪(Traceable) 每一个决策可解释(Explainable) 每一次交接可问责(Accountable)
四、成熟度模型:从M1到M5,你的企业在哪一级?
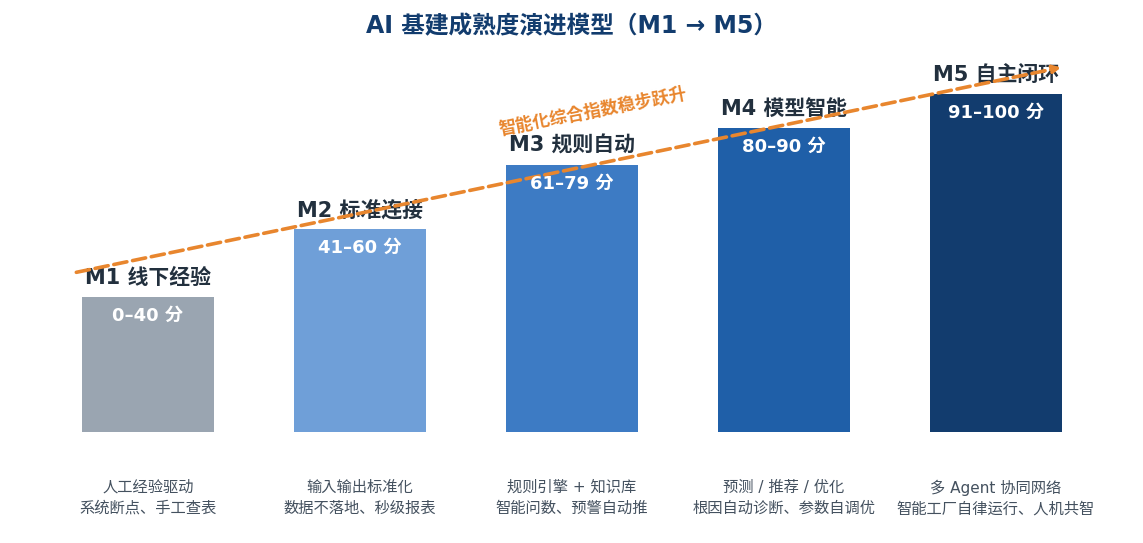
表格
| 阶段 | 综合指数 | 核心特征 | 底座建设重点 |
|---|---|---|---|
| M1 线下经验 | 0--40 | 人工经验驱动 | 盘点数据盲区,打通基础采集 |
| M2 标准连接 | 41--60 | 流程在线化、口径统一 | 统一数据底座、指标平台 |
| M3 规则自动 | 61--79 | 规则驱动自动检查 | 知识库(RAG)、基础Agent平台 |
| M4 模型智能 | 80--90 | 预测、推荐、优化 | 本体中枢、模型微调产线 |
| M5 自主闭环 | 91--100 | 边界内自主优化 | 多Agent协同网络、数字孪生 |
诚实自评很重要:大部分制造企业目前处于M1~M2之间。这不可怕,可怕的是用M5的蓝图,建M1的地基。
五、三年路线图:筑基破局 → 体系成型 → 数智协同
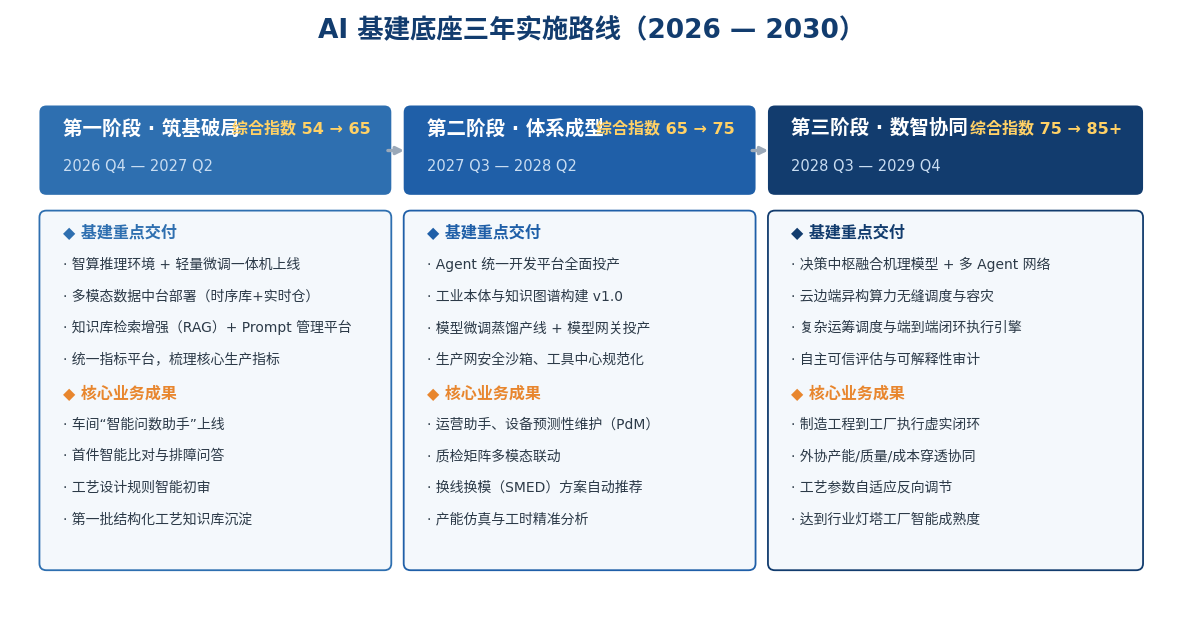
第一阶段·筑基破局(2026 Q4--2027 Q2,指数54→65) 部署多模态数据中台与知识库检索增强,上线"车间智能问数助手"、首件智能比对与工艺规则初审,跑通首批标杆场景。
第二阶段·体系成型(2027 Q3--2028 Q2,指数65→75) Agent统一开发平台投产,工业本体与知识图谱v1.0建成,模型微调蒸馏产线运行,规模化培育业务智能体。
第三阶段·数智协同(2028 Q3--2029 Q4,指数75→85+) 决策中枢融合机理模型与多Agent网络,实现自营与外协工厂穿透式协同、工艺参数自适应调节,对标行业灯塔工厂成熟度。
六、落地加速的四个保障机制
① 平台---场景双飞轮。 平台团队按双周迭代沉淀通用能力;场景突击队采用"算法架构师+工程IT+车间专家"三位一体小组,4~6周完成一个POC,实现"上线一个场景、沉淀一批资产、赋能一个业务域"。
② 技术选型建议(供参考):
表格
| 模块 | 推荐方案 | 备选方案 |
|---|---|---|
| 算力底座 | GPU服务器+车间边缘一体机 | 弹性云算力专线接入 |
| 向量检索 | Milvus / Qdrant + 对象存储 | Elasticsearch向量插件 |
| 实时计算 | Doris/StarRocks + Flink | ClickHouse + Trino |
| Agent编排 | 可视化编排平台 / LangGraph | Dify私有化引擎 |
| 模型网关 | LiteLLM Proxy + vLLM | Triton推理服务 |
| 知识图谱 | Neo4j / TuGraph | Nebula Graph |
③ 以资产看进展。 考核不仅看业务指标,更看三类资产沉淀率:知识资产(文档切片入库覆盖率)、能力资产(API转化为标准Skill的数量与复用频次)、模型资产(版本化管理与自动化部署率)。
④ ROI测算 + 季度关卡复盘。 每个场景立项即测算"节省工时 + 减少报废 + 降低停机"的年化收益,每季度由业务与IT联合复盘纠偏。
写在最后
AI基建不是一次性工程,而是一场**"打牢底座、小步快跑、场景闭环、平台成型"**的长跑。
大模型会不断迭代,但数据底座、知识资产、工具接口和治理体系,是企业穿越技术周期的真正护城河。与其追逐每一个新模型,不如先把自己的"地基"打深一寸。
智能化的竞争,最终是基建的竞争。
觉得这篇文章对你有启发,欢迎点个「在看」,转发给正在规划AI落地的同行。你的企业目前处于M几?欢迎在评论区聊聊。