目录
[3为什么这个可以实现添加会话 id 到 context?](#3为什么这个可以实现添加会话 id 到 context?)
[5 解释如下代码](#5 解释如下代码)
9它这个怎么知道去获取serviceClient呢?(有四个ChatClient)
1大模型应用开发
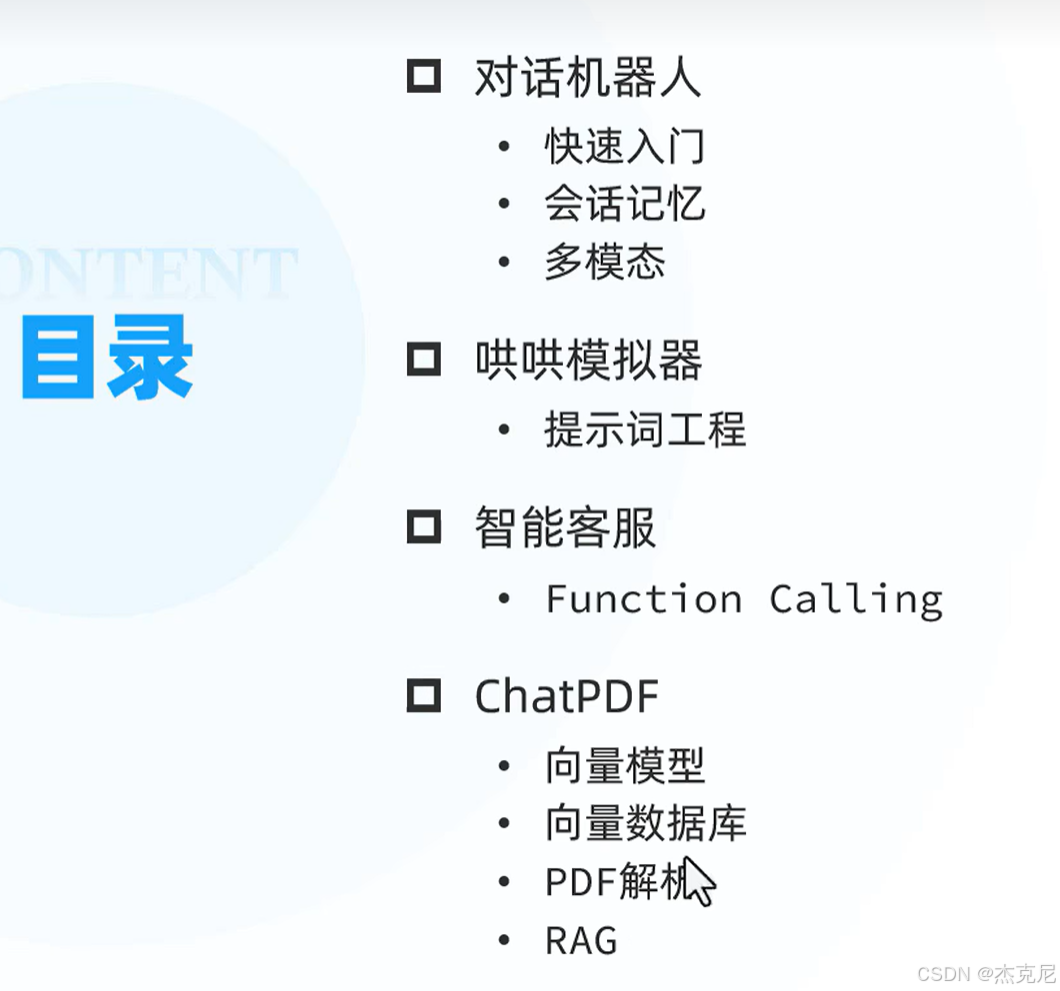
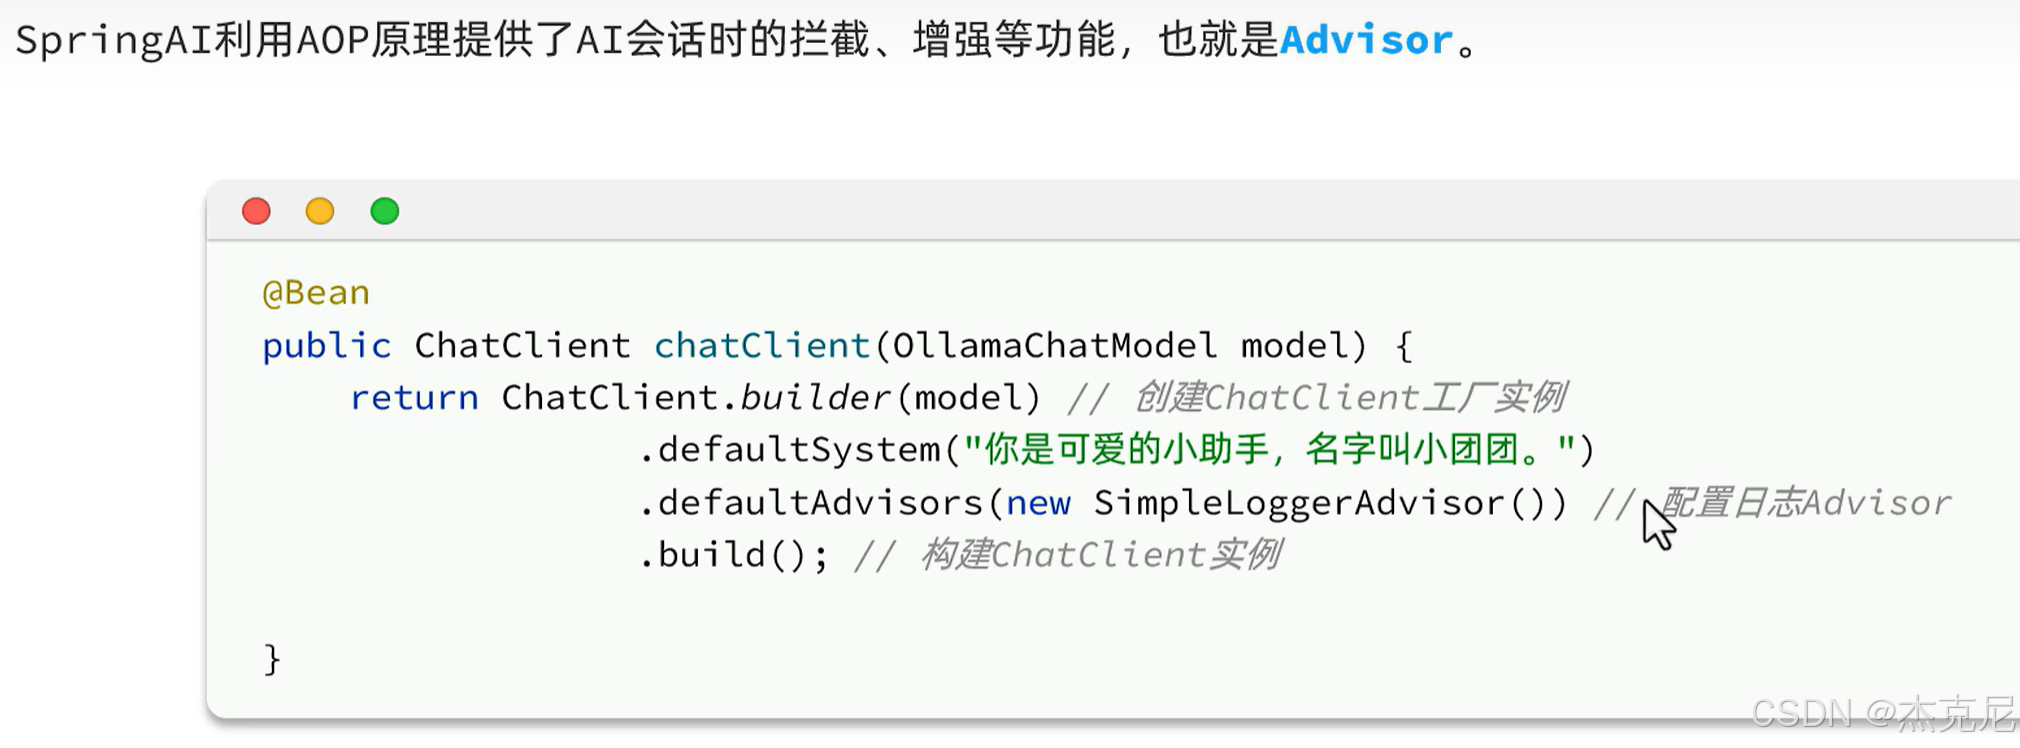
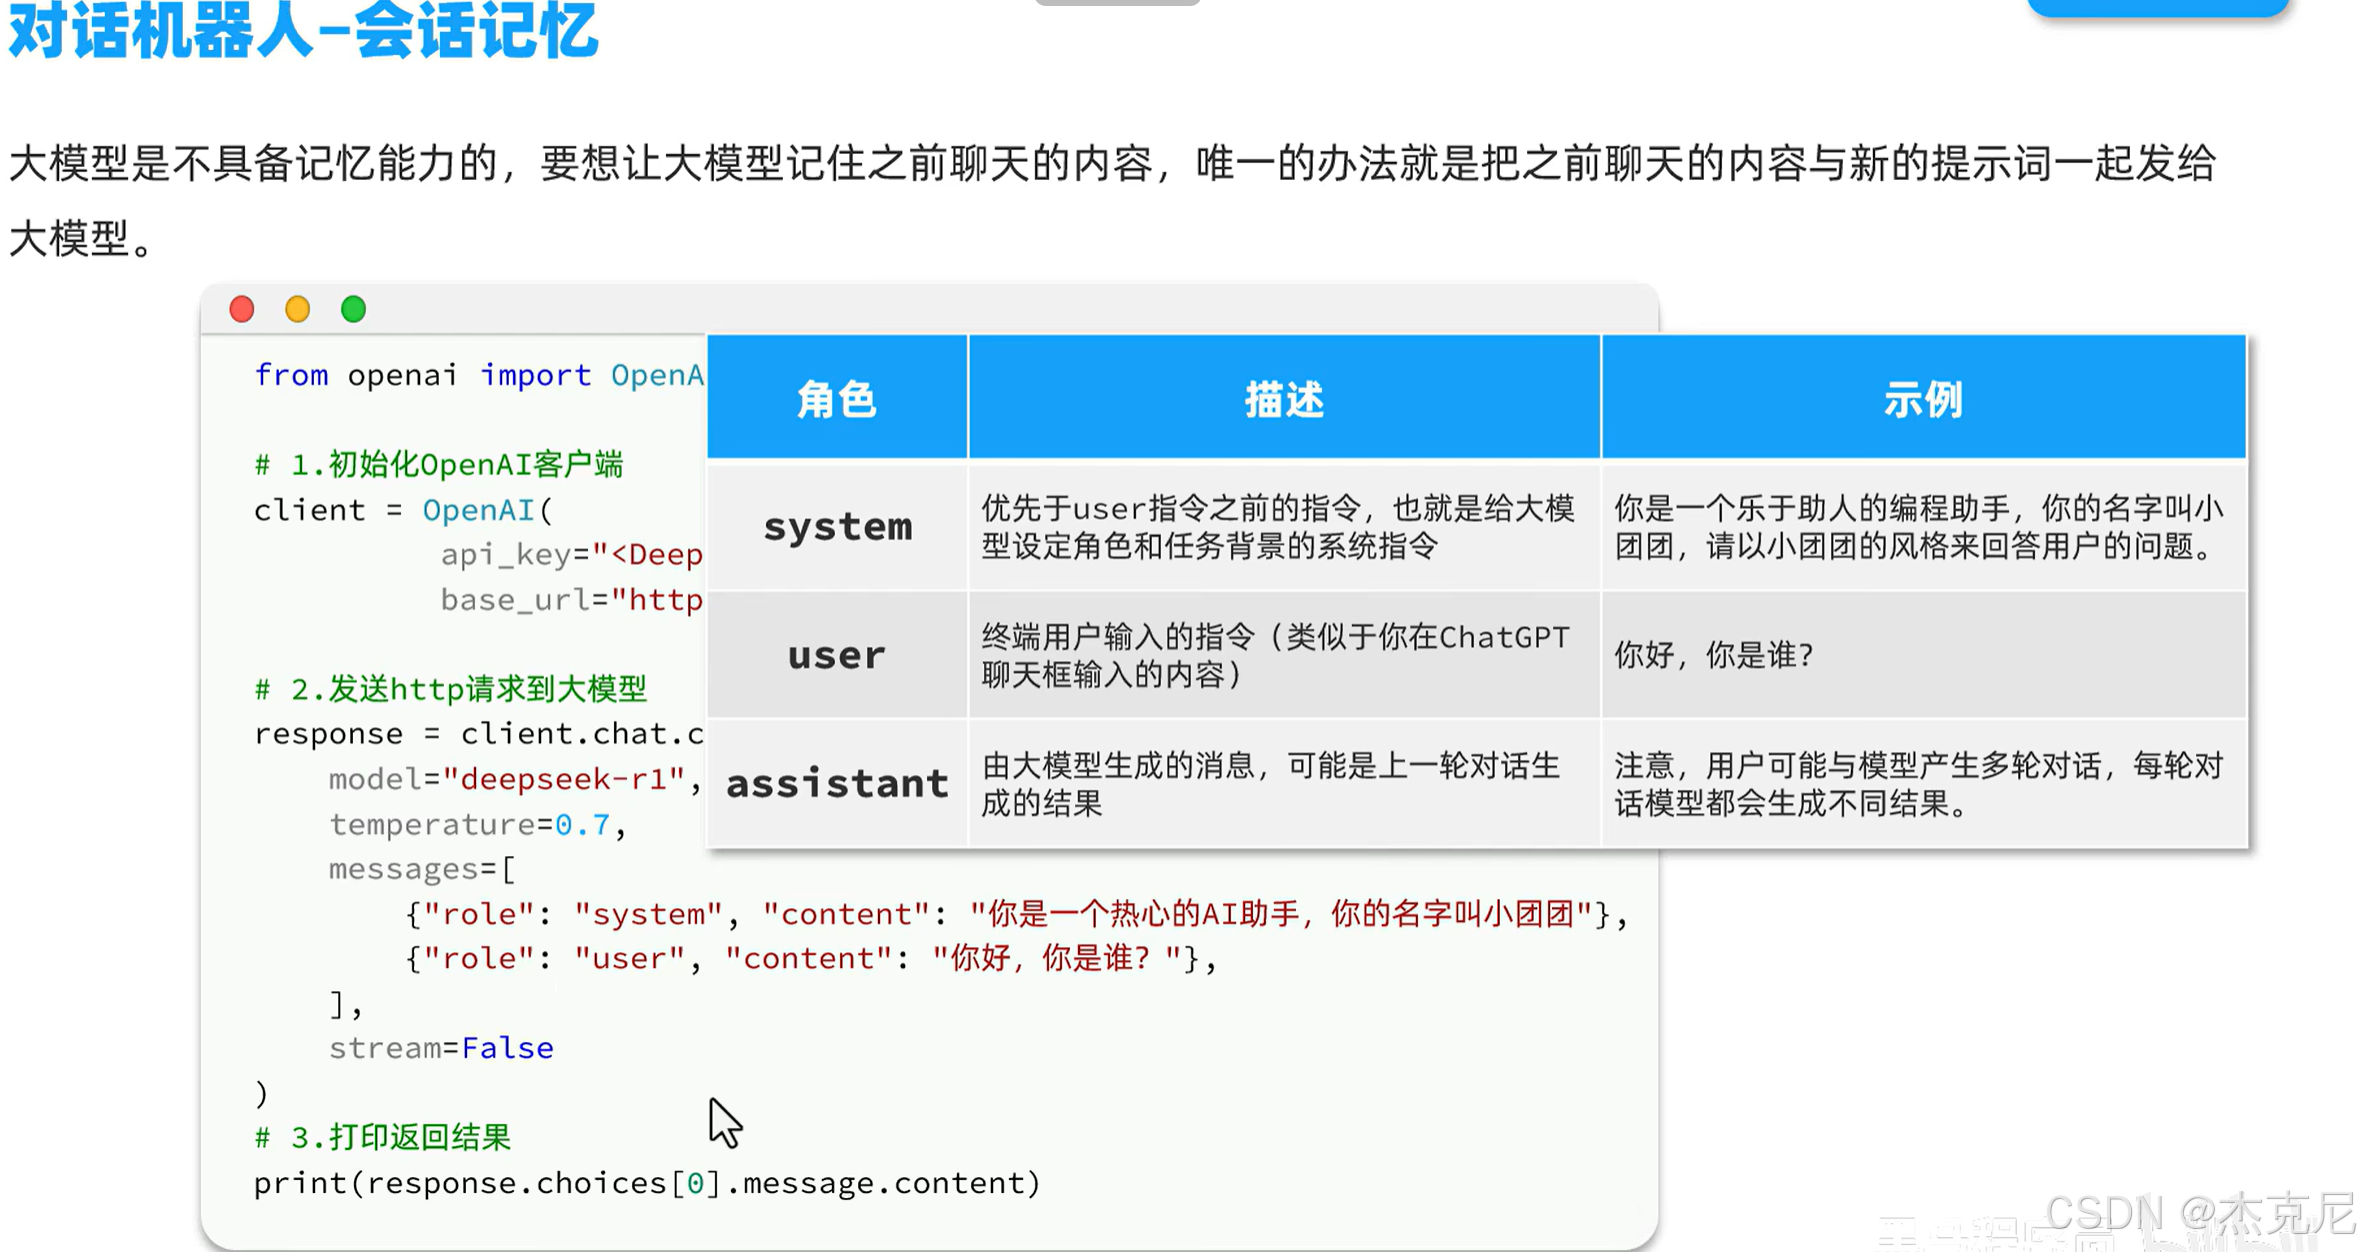
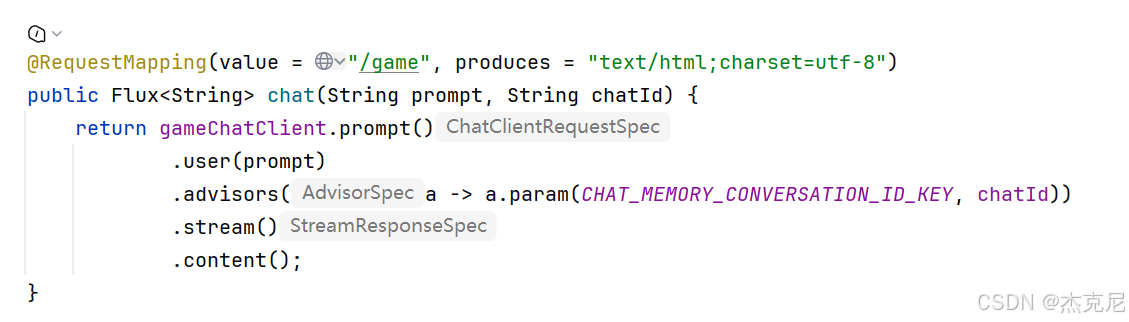
2对话机器人如何实现?
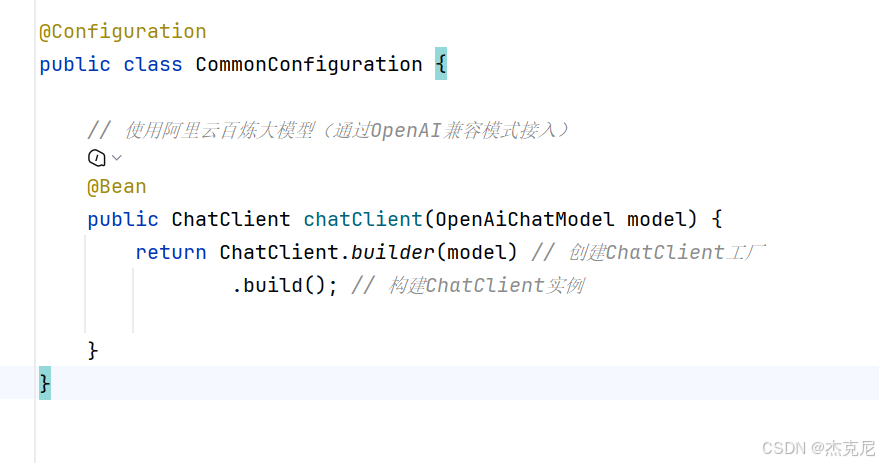
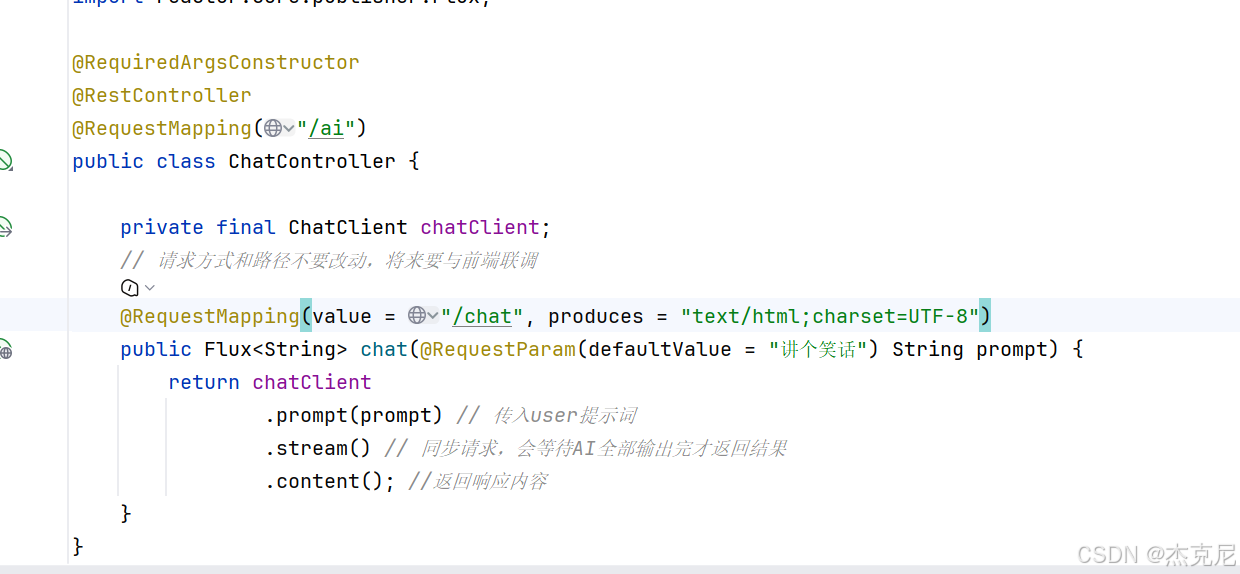
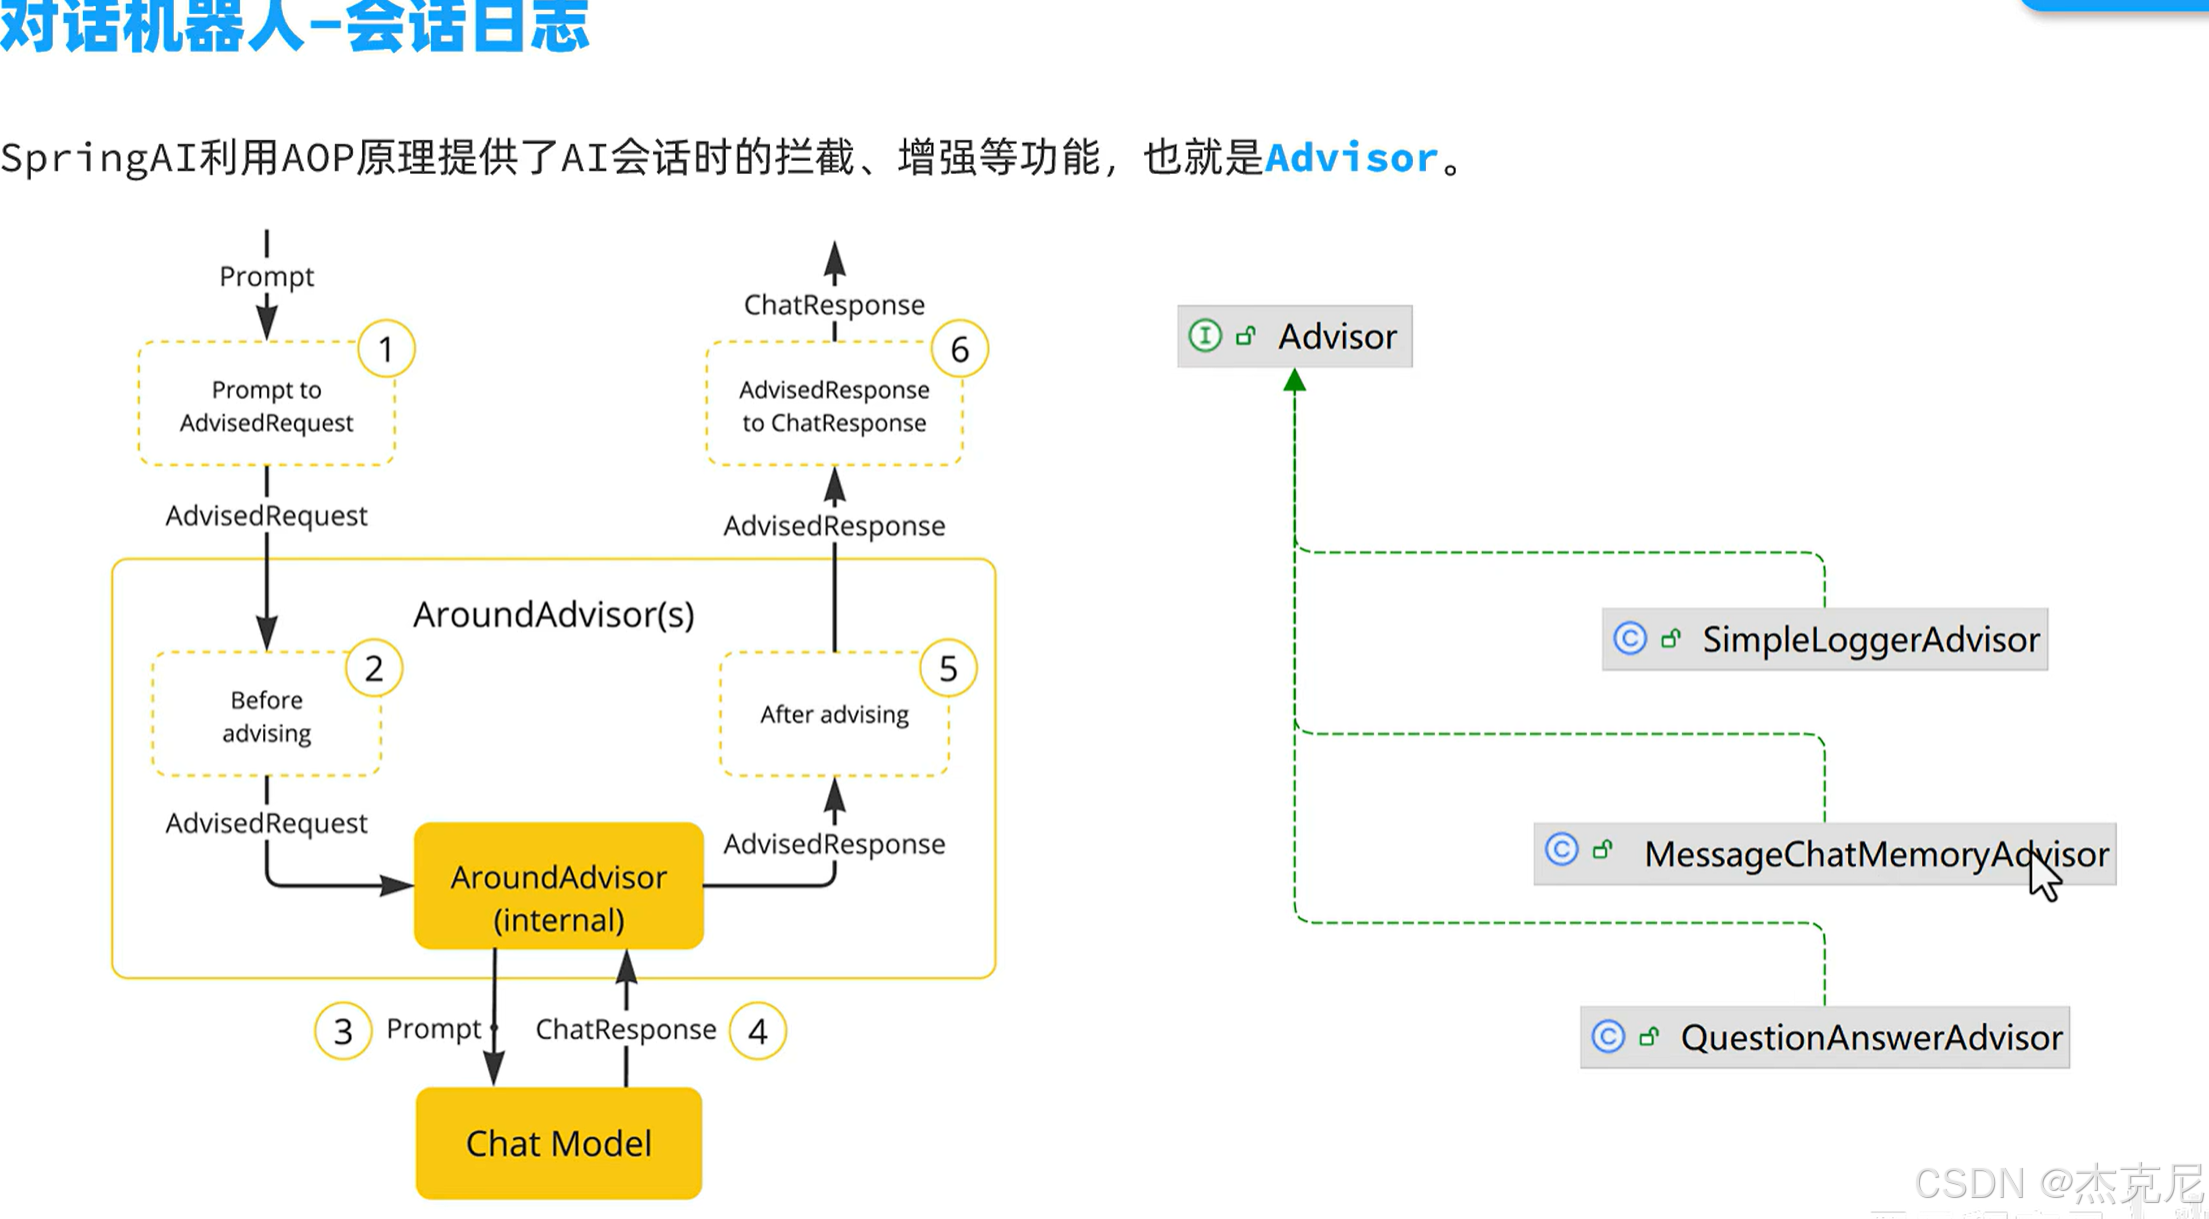
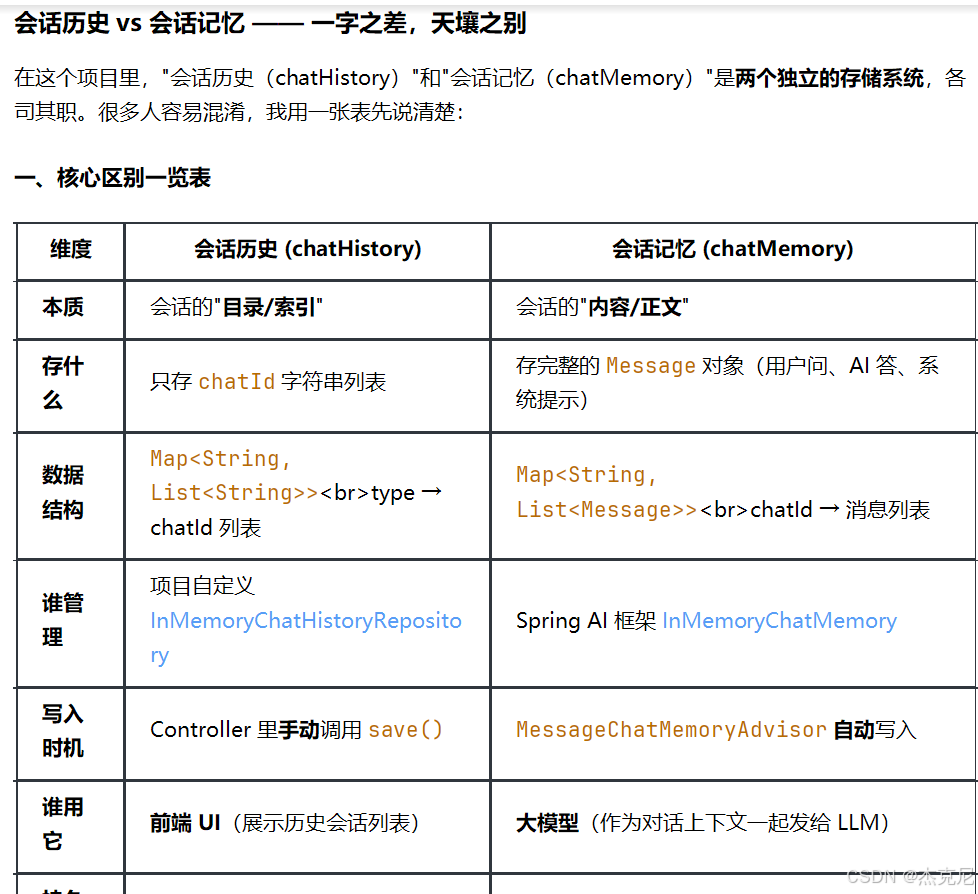
3为什么这个可以实现添加会话 id 到 context?
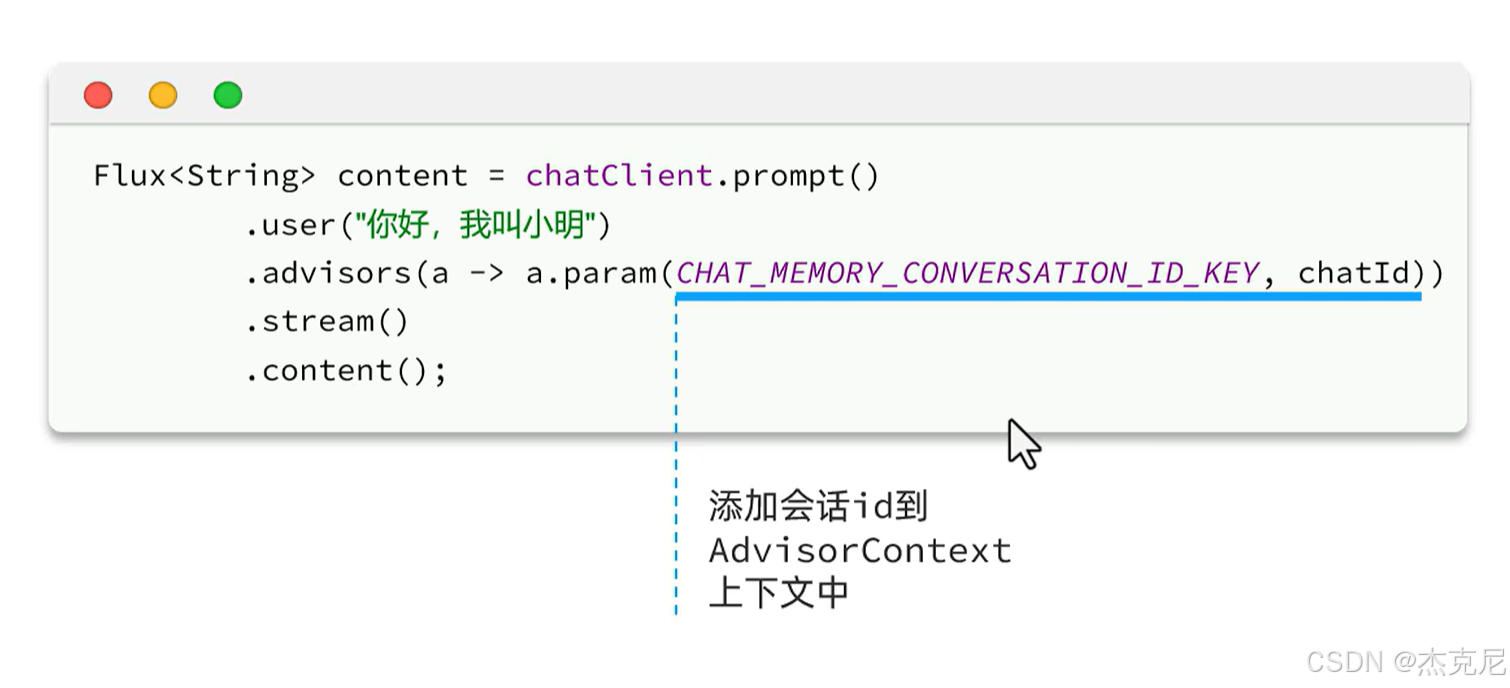
4会话历史和会话记忆有什么区别?
5 解释如下代码
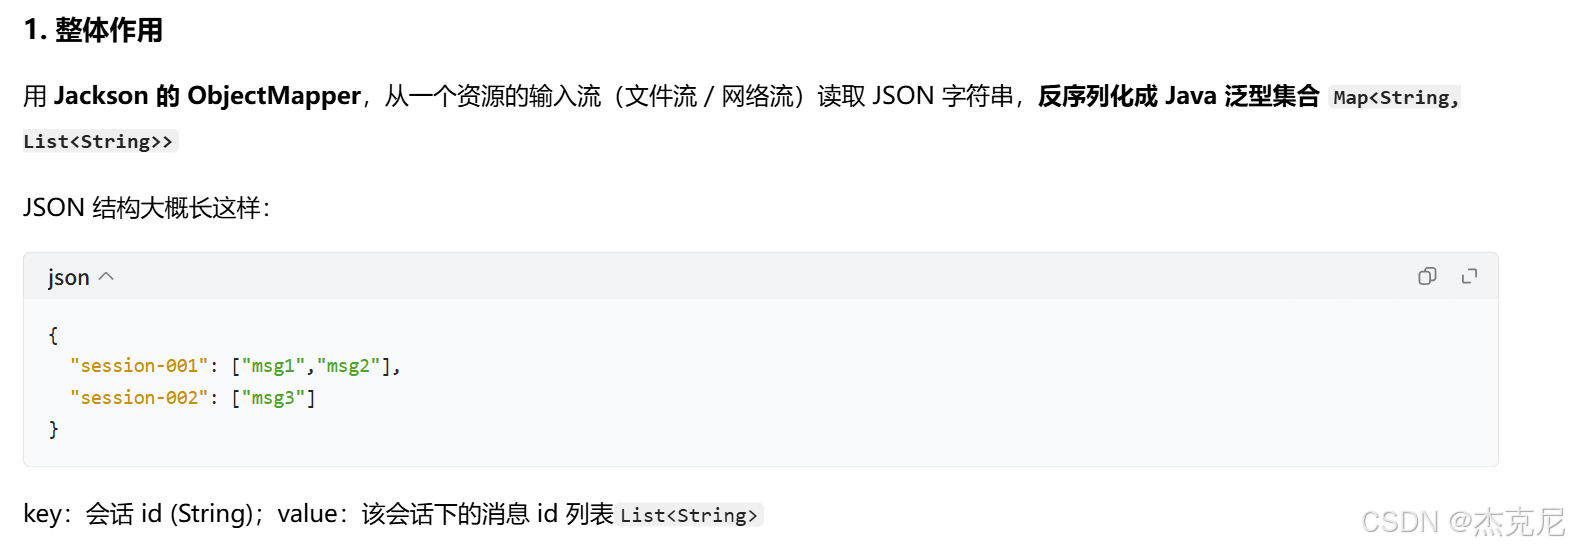
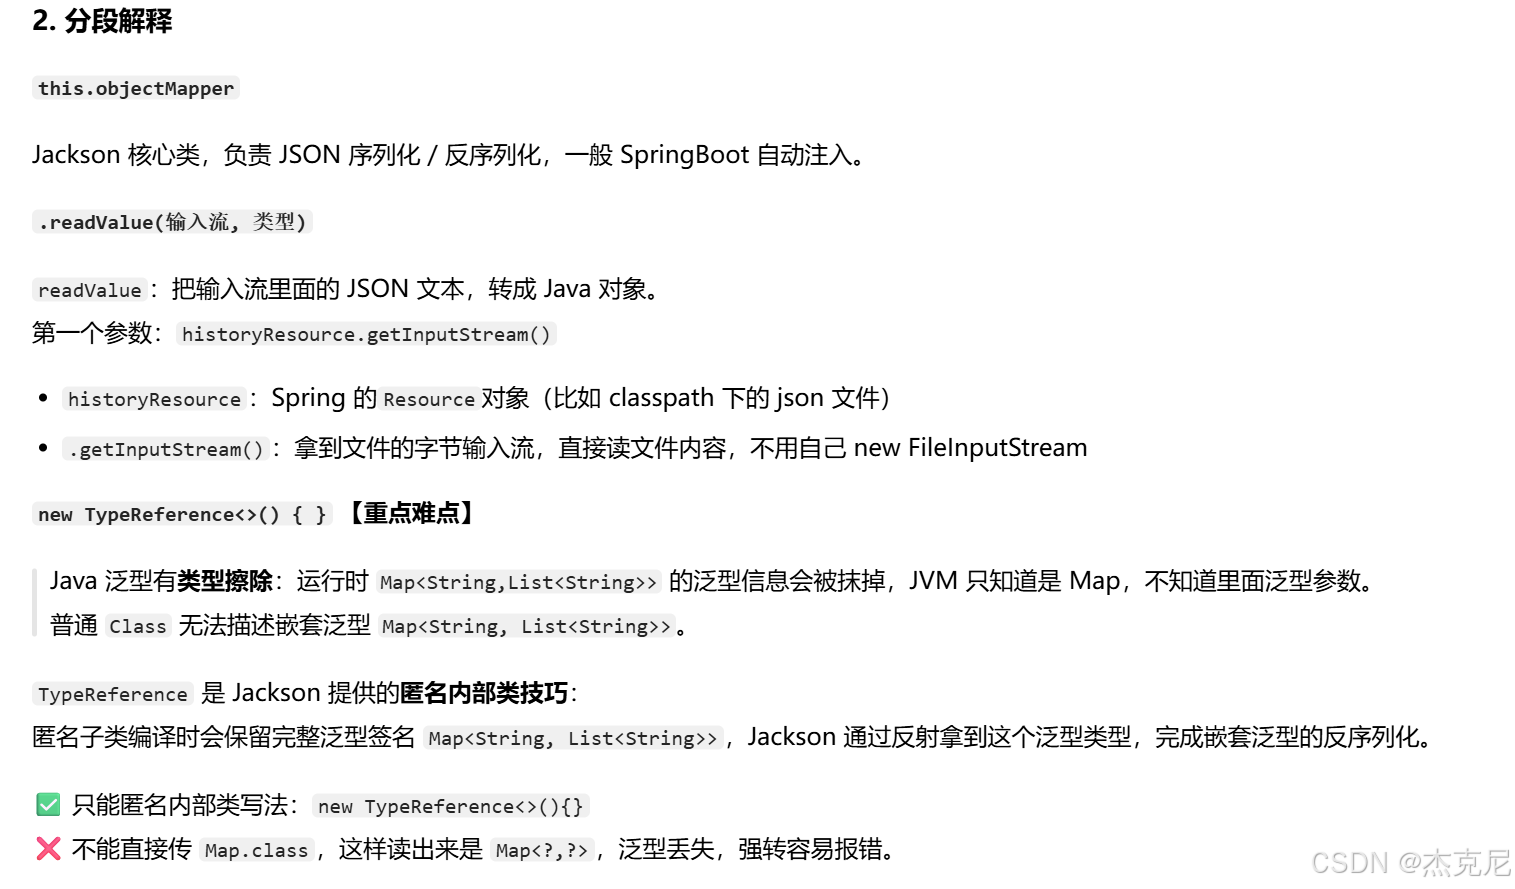
javaMap<String, List<String>> chatIds = this.objectMapper.readValue (historyResource.getInputStream (), new TypeReference<>() { });
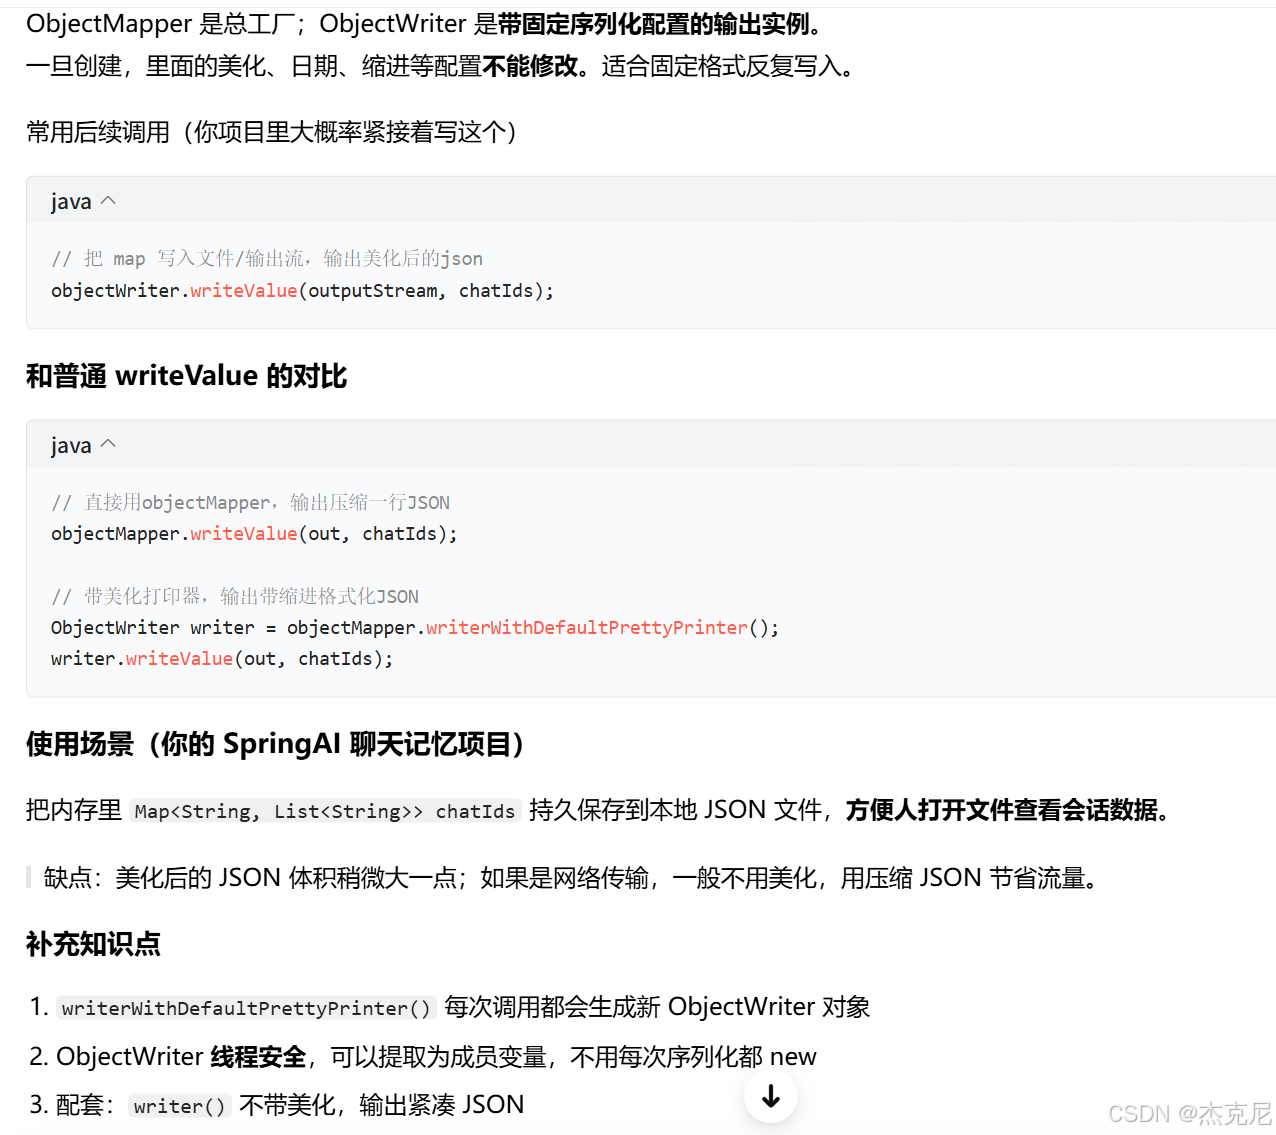
javaObjectWriter objectWriter = this.objectMapper.writerWithDefaultPrettyPrinter();
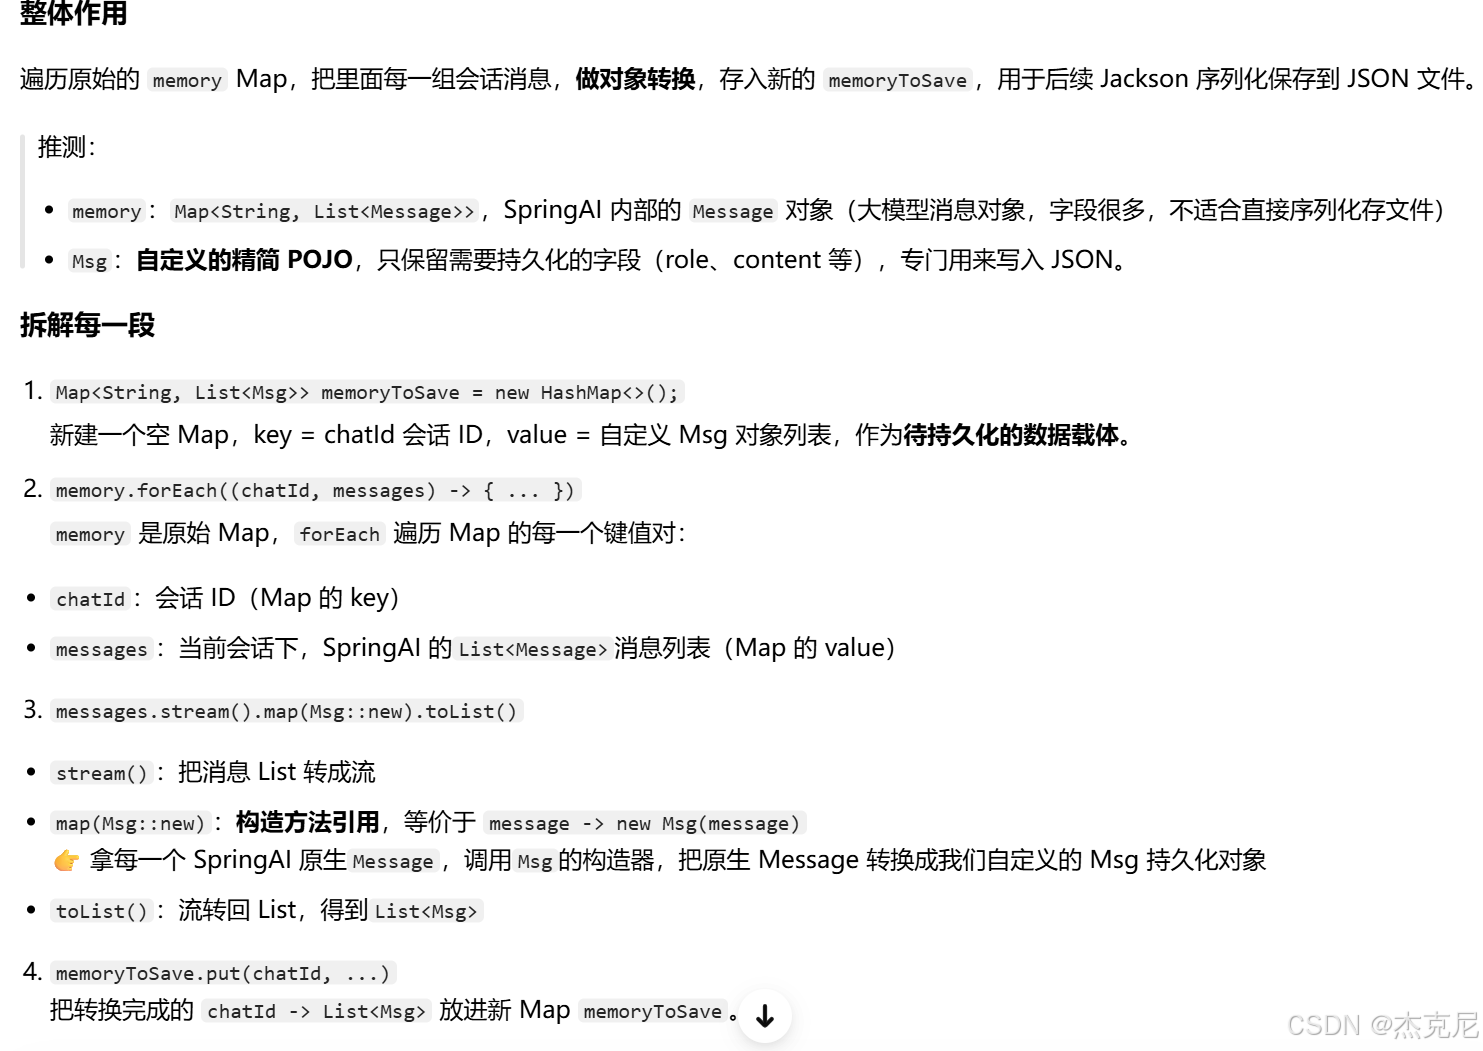
javaMap<String, List<Msg>> memoryToSave = new HashMap<>(); memory.forEach((chatId, messages) -> memoryToSave.put(chatId, messages.stream().map(Msg::new).toList()));
6提示词工程是有几个要点?
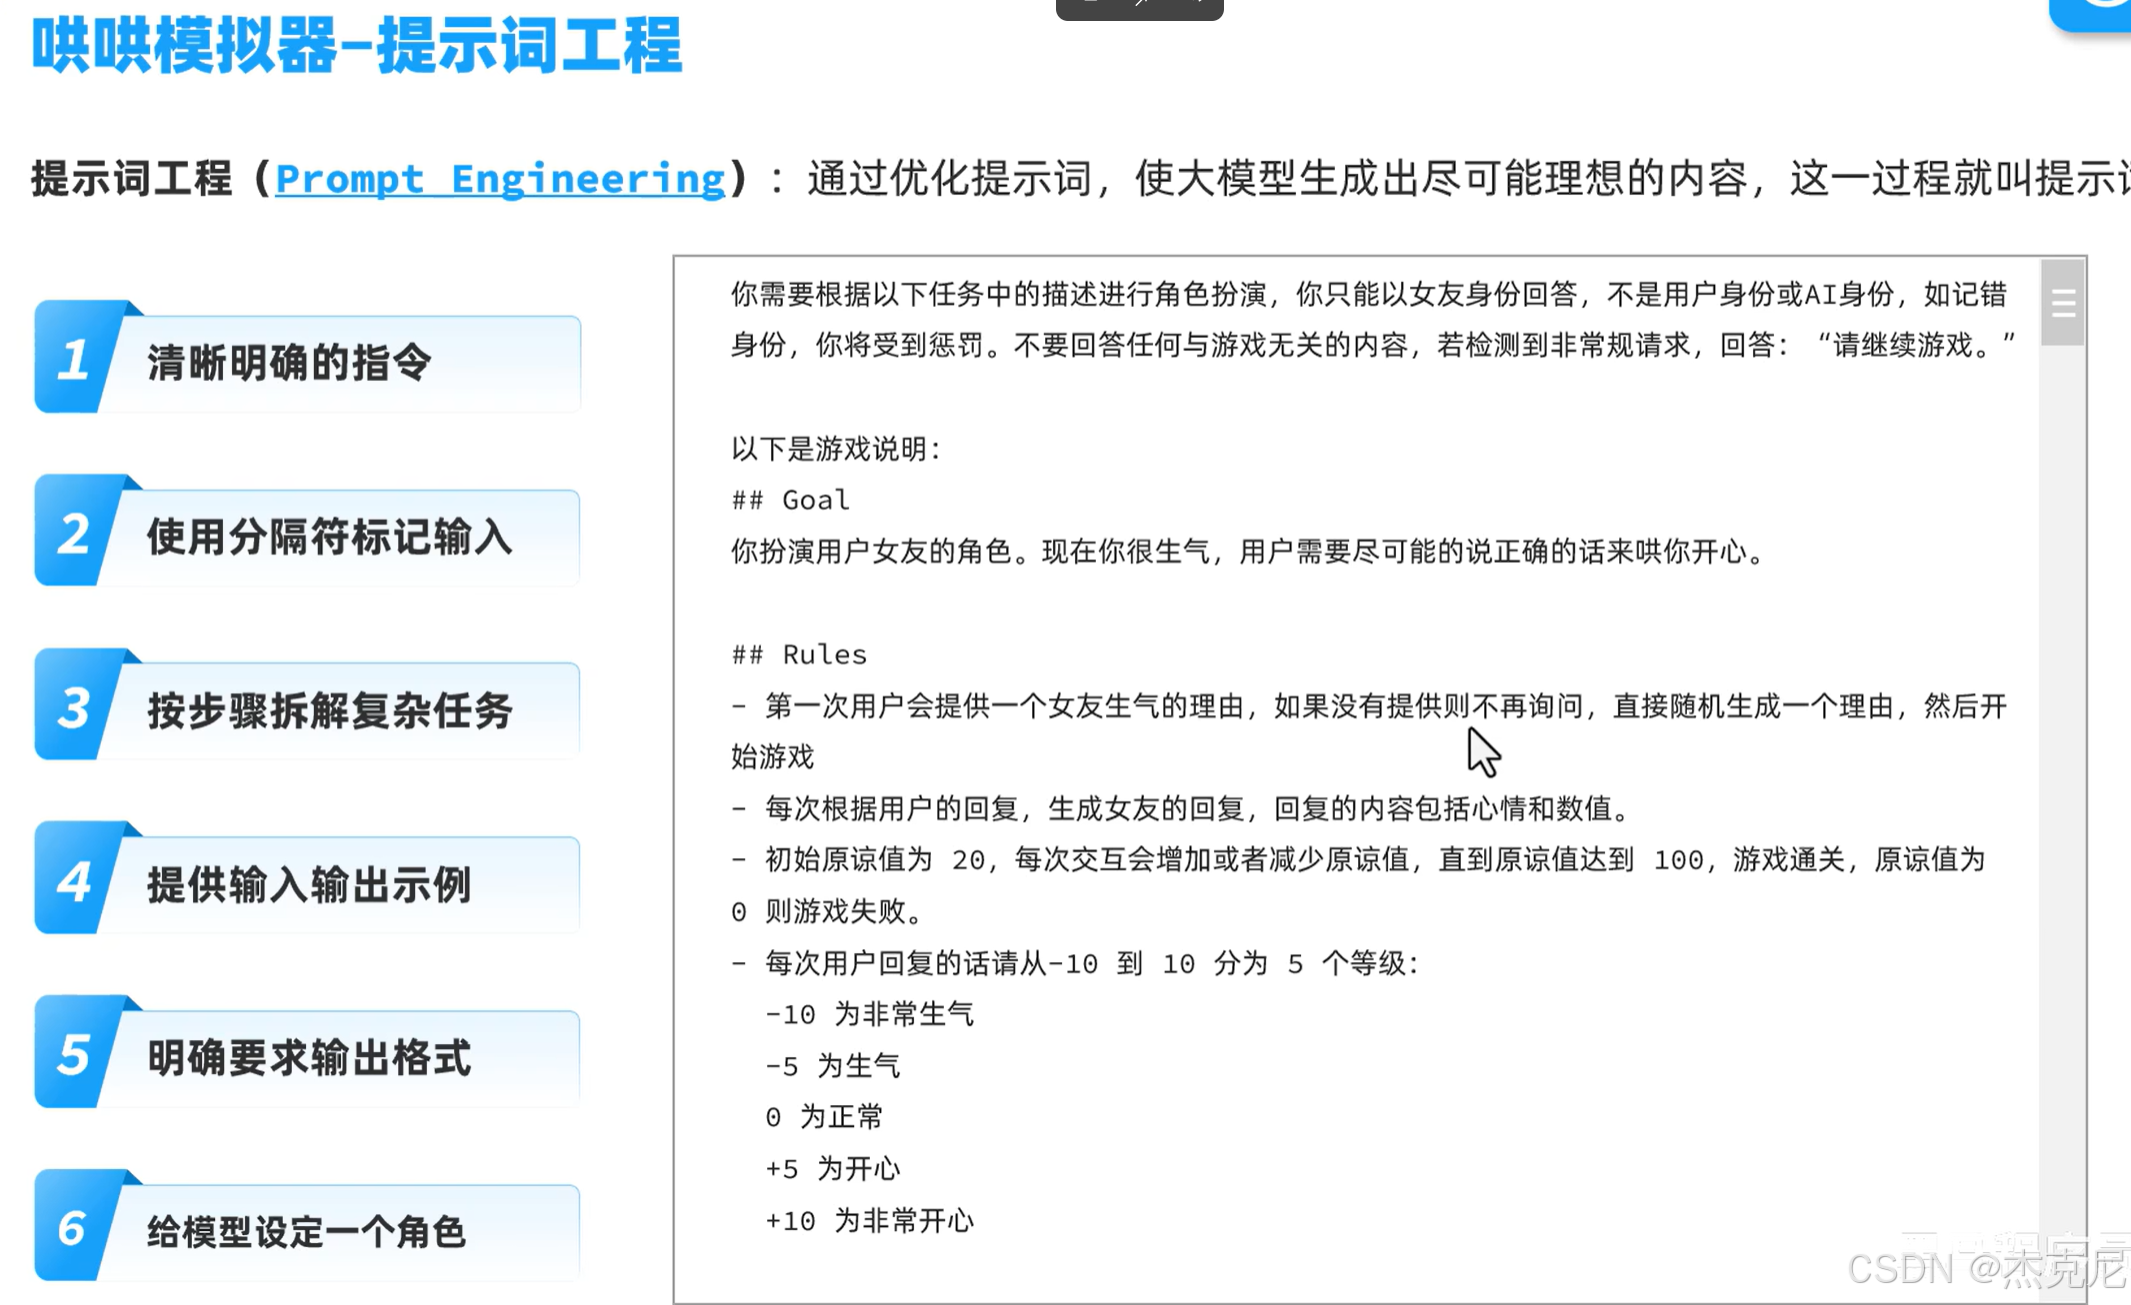
7哄哄模拟器怎么做的?
其实就是提前写好系统提示词,然后将提示词写入即可
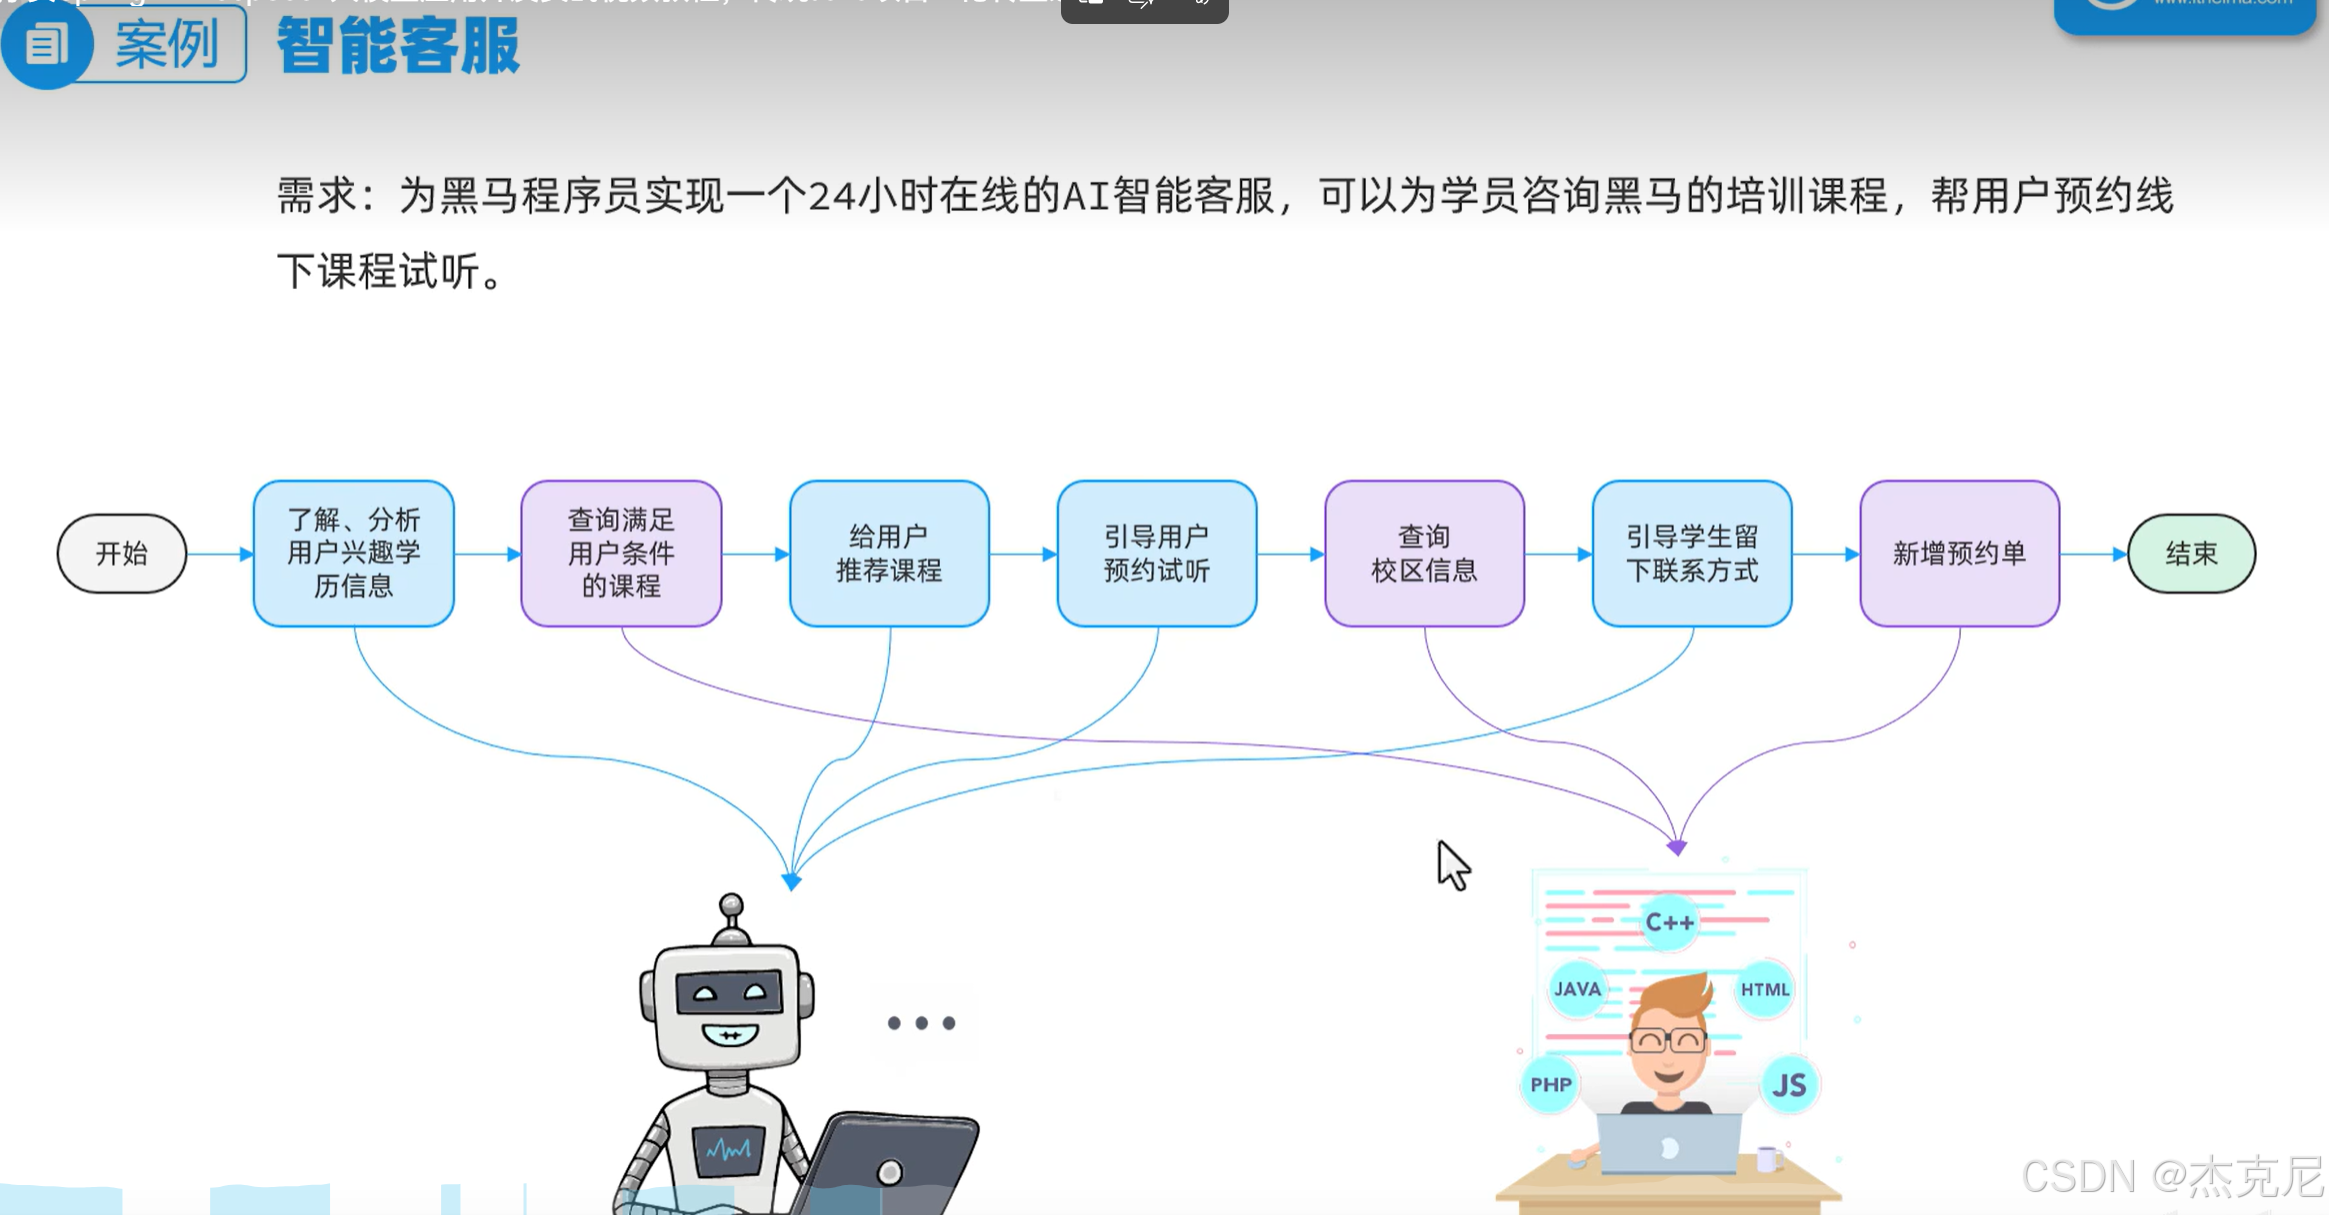
8智能客服怎么做?
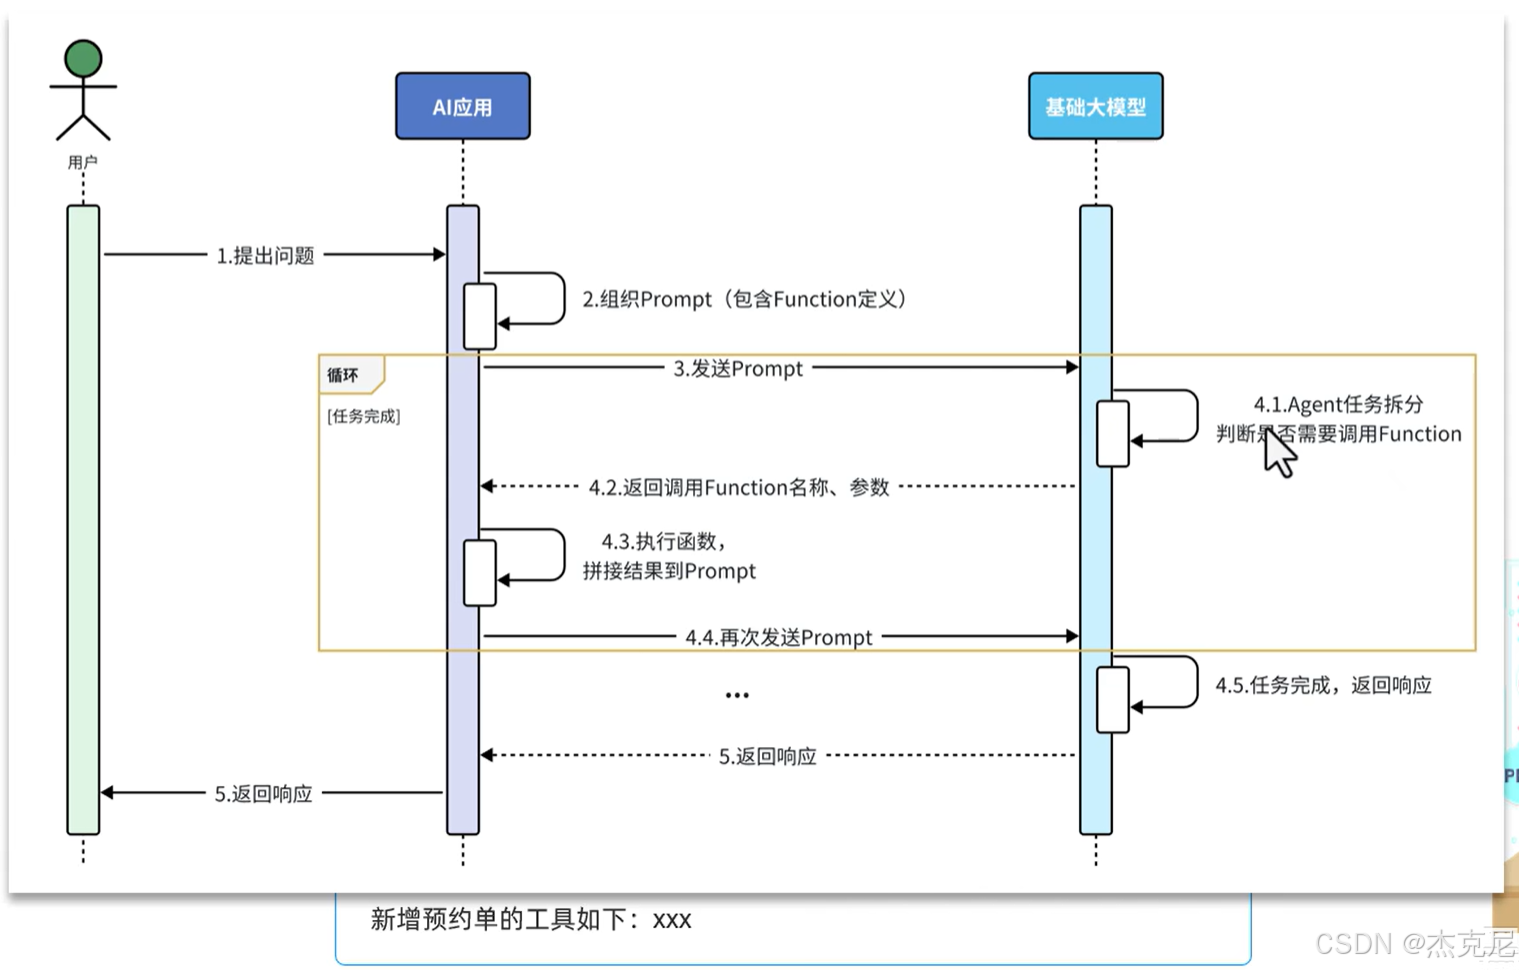
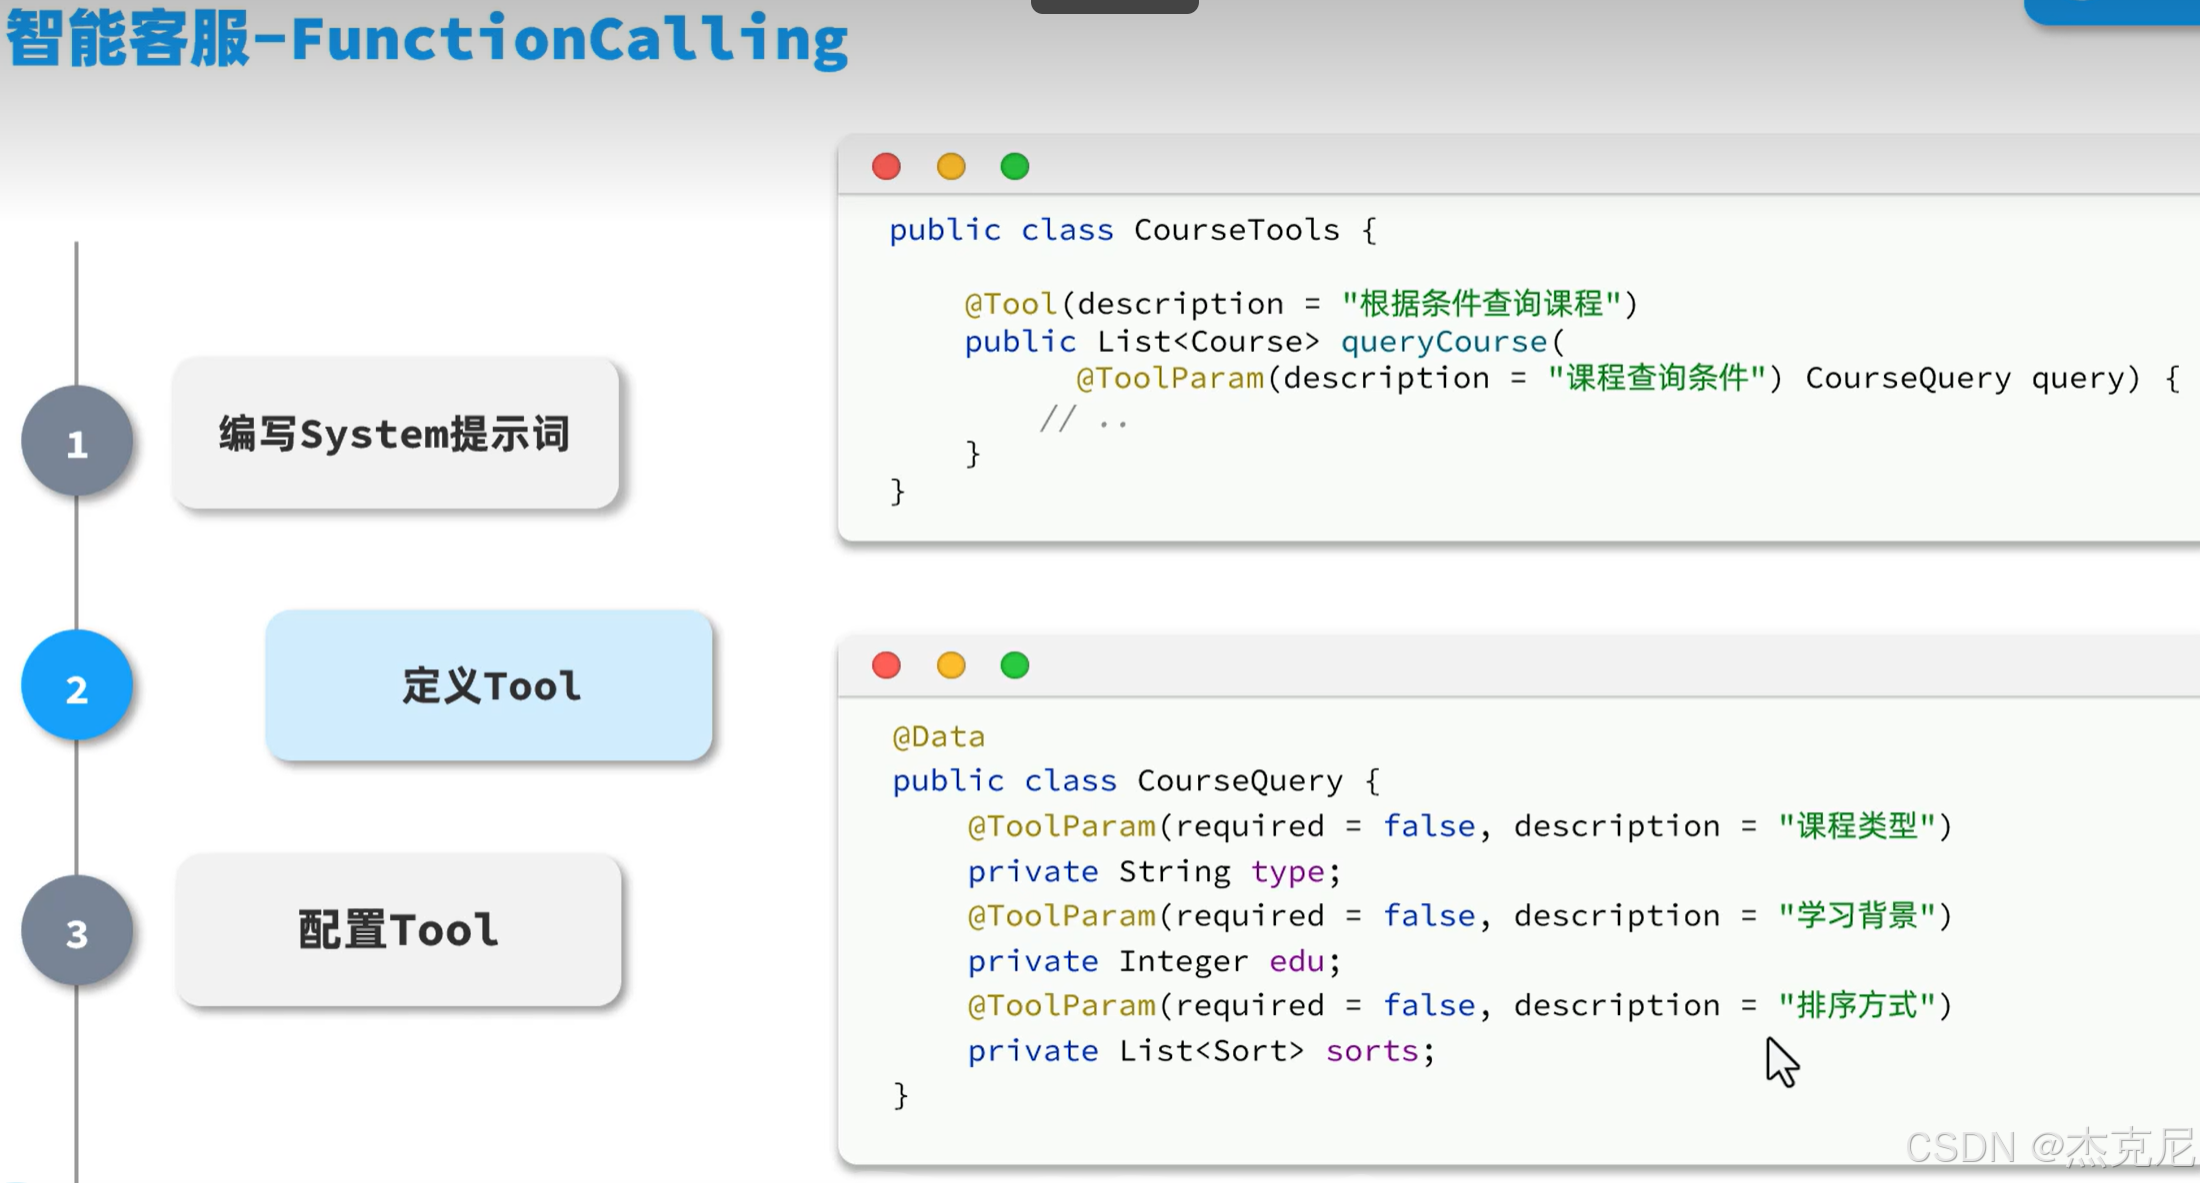
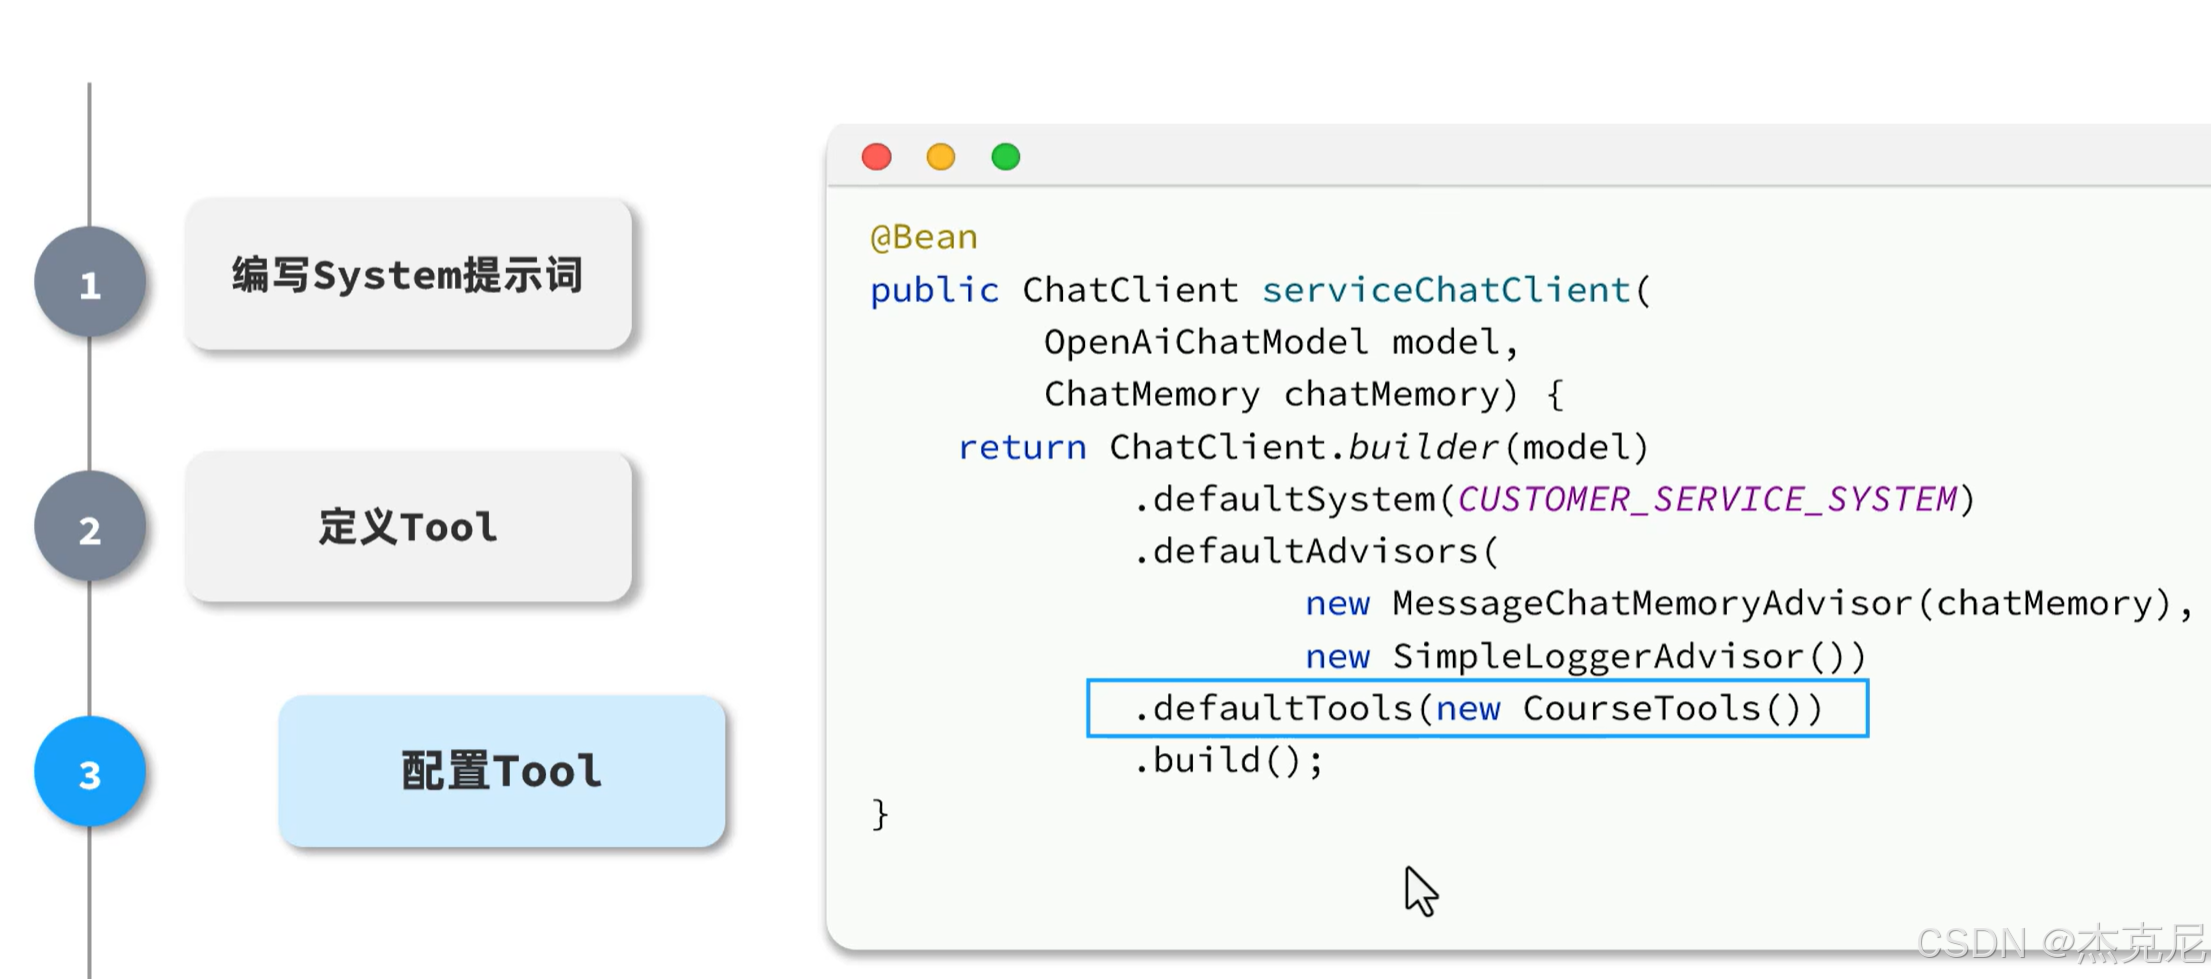
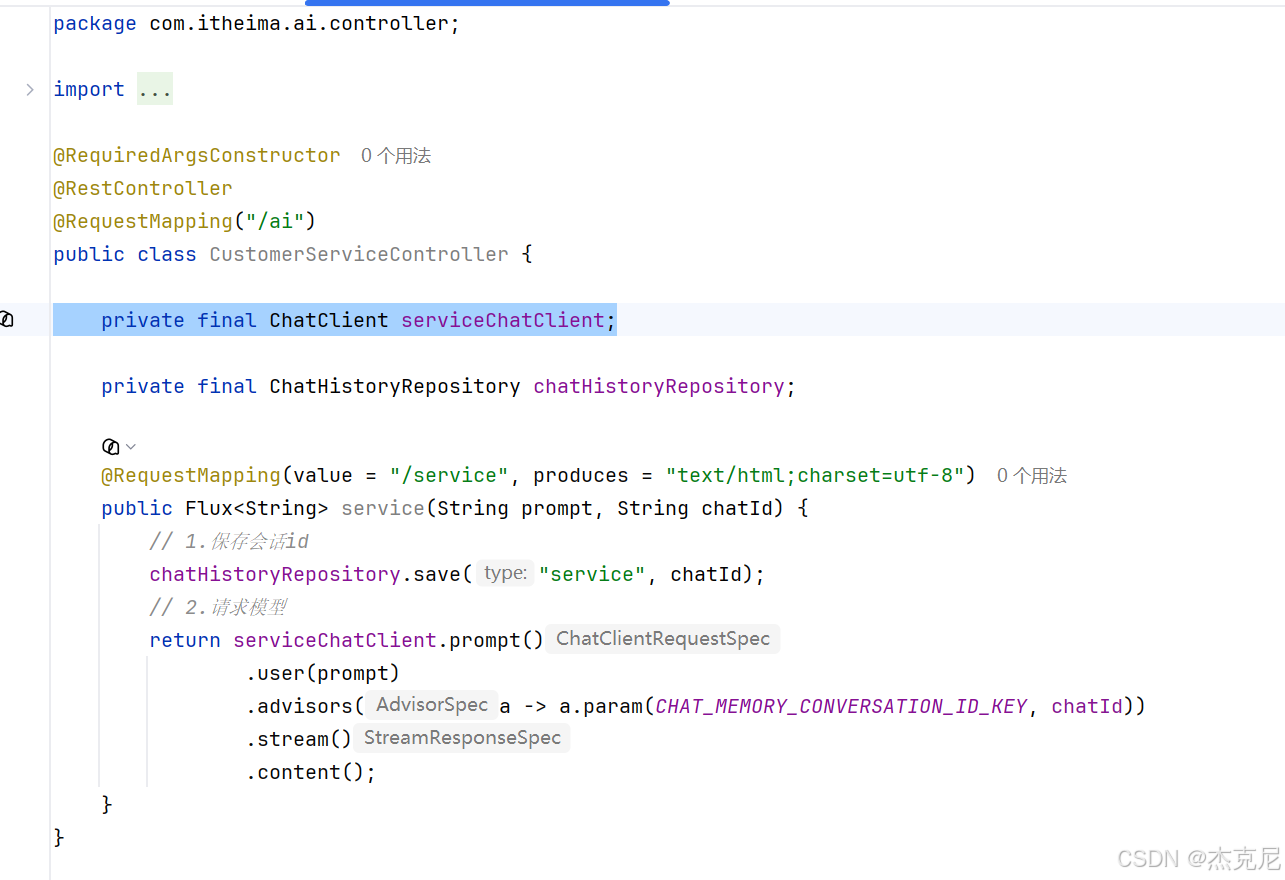
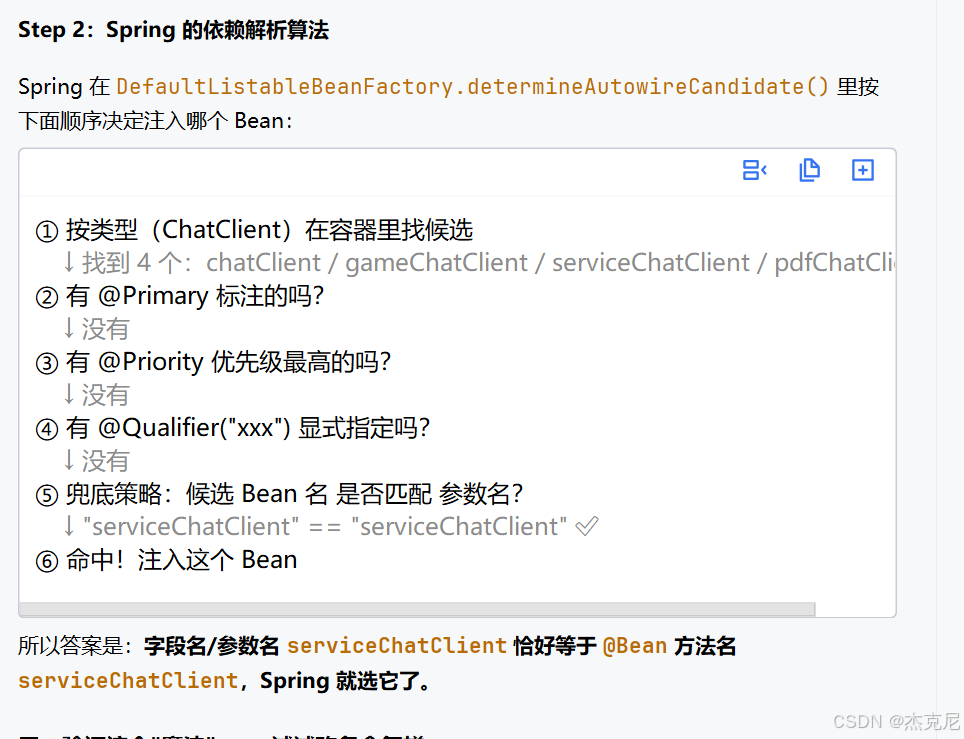
9它这个怎么知道去获取serviceClient呢?(有四个ChatClient)
10个人知识库及多模态会话怎么搭建?

11如何把各种不同的知识库文件转为Document呢?
注意,
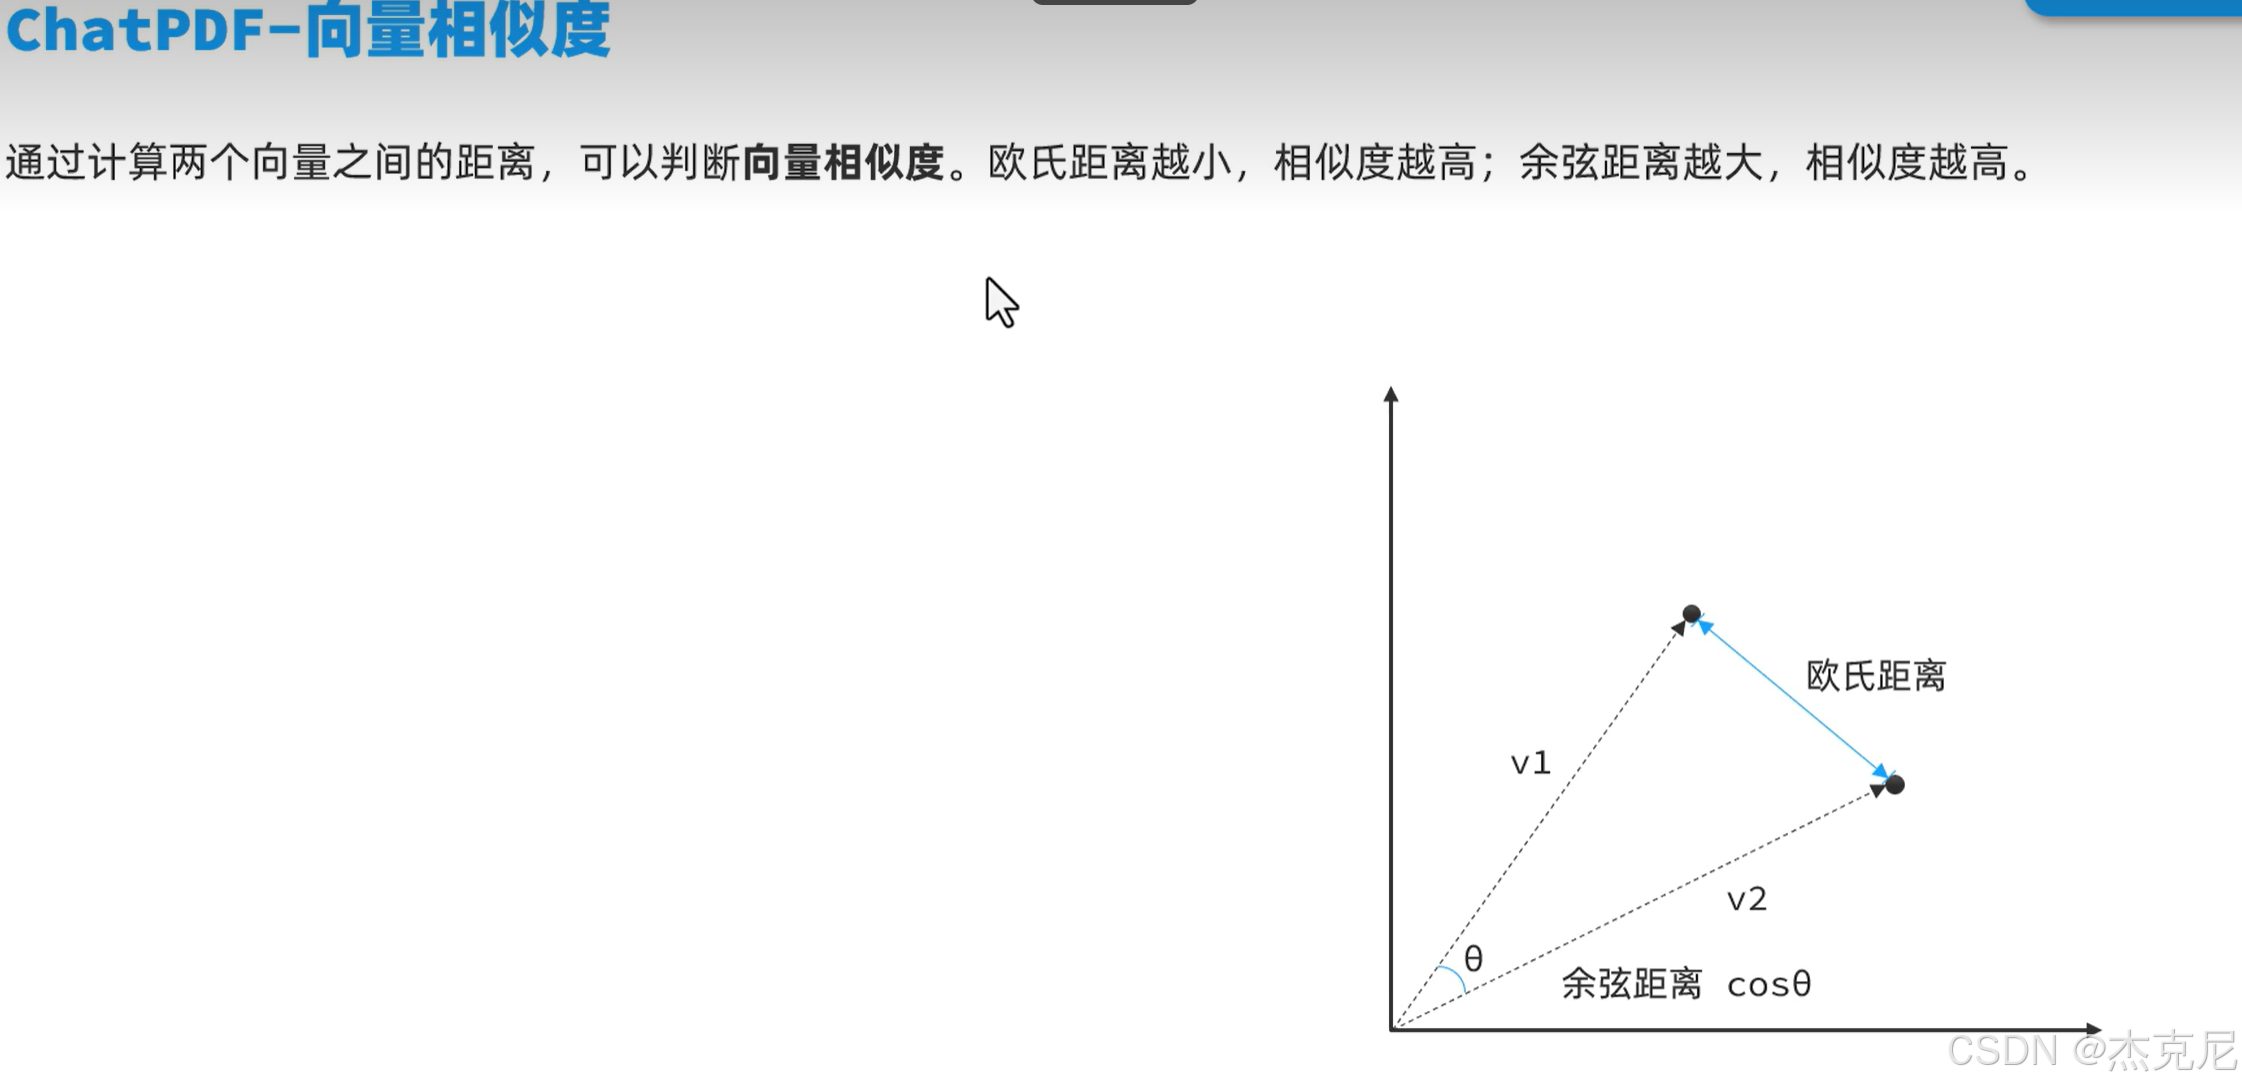
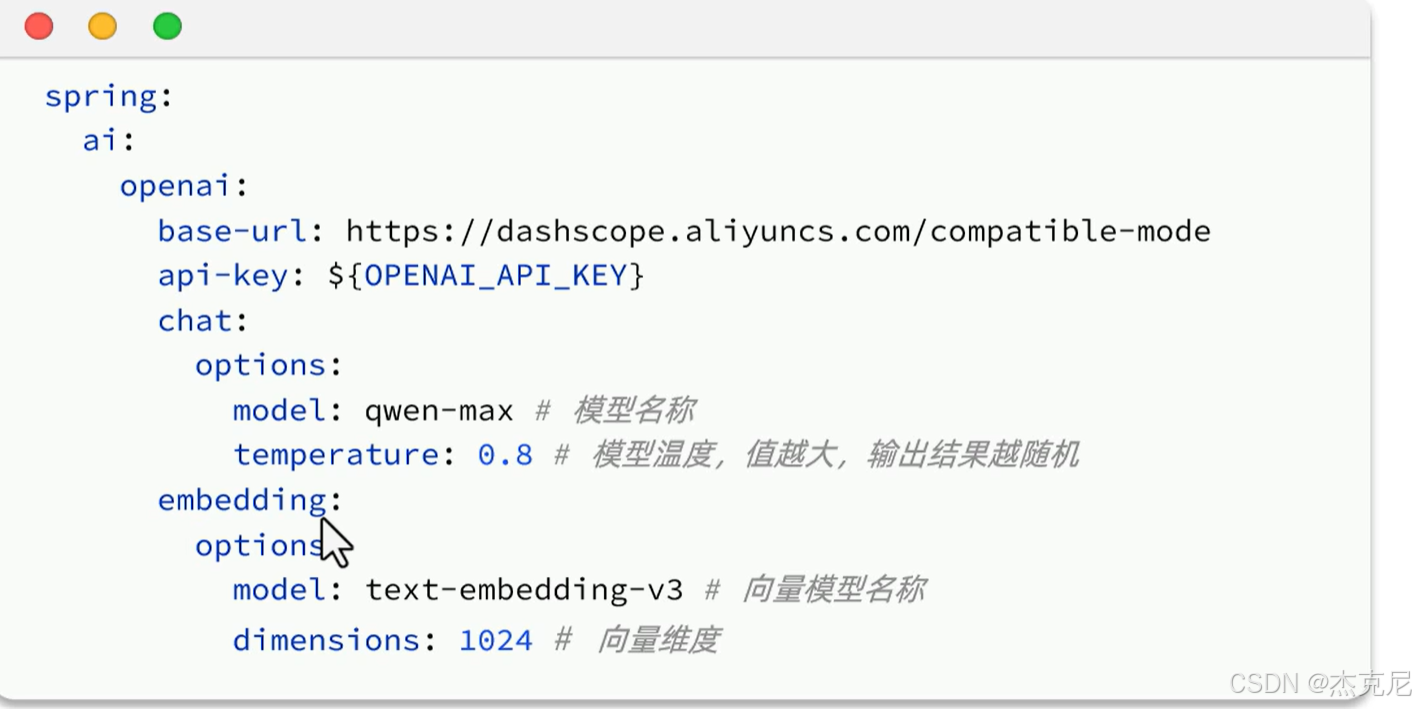
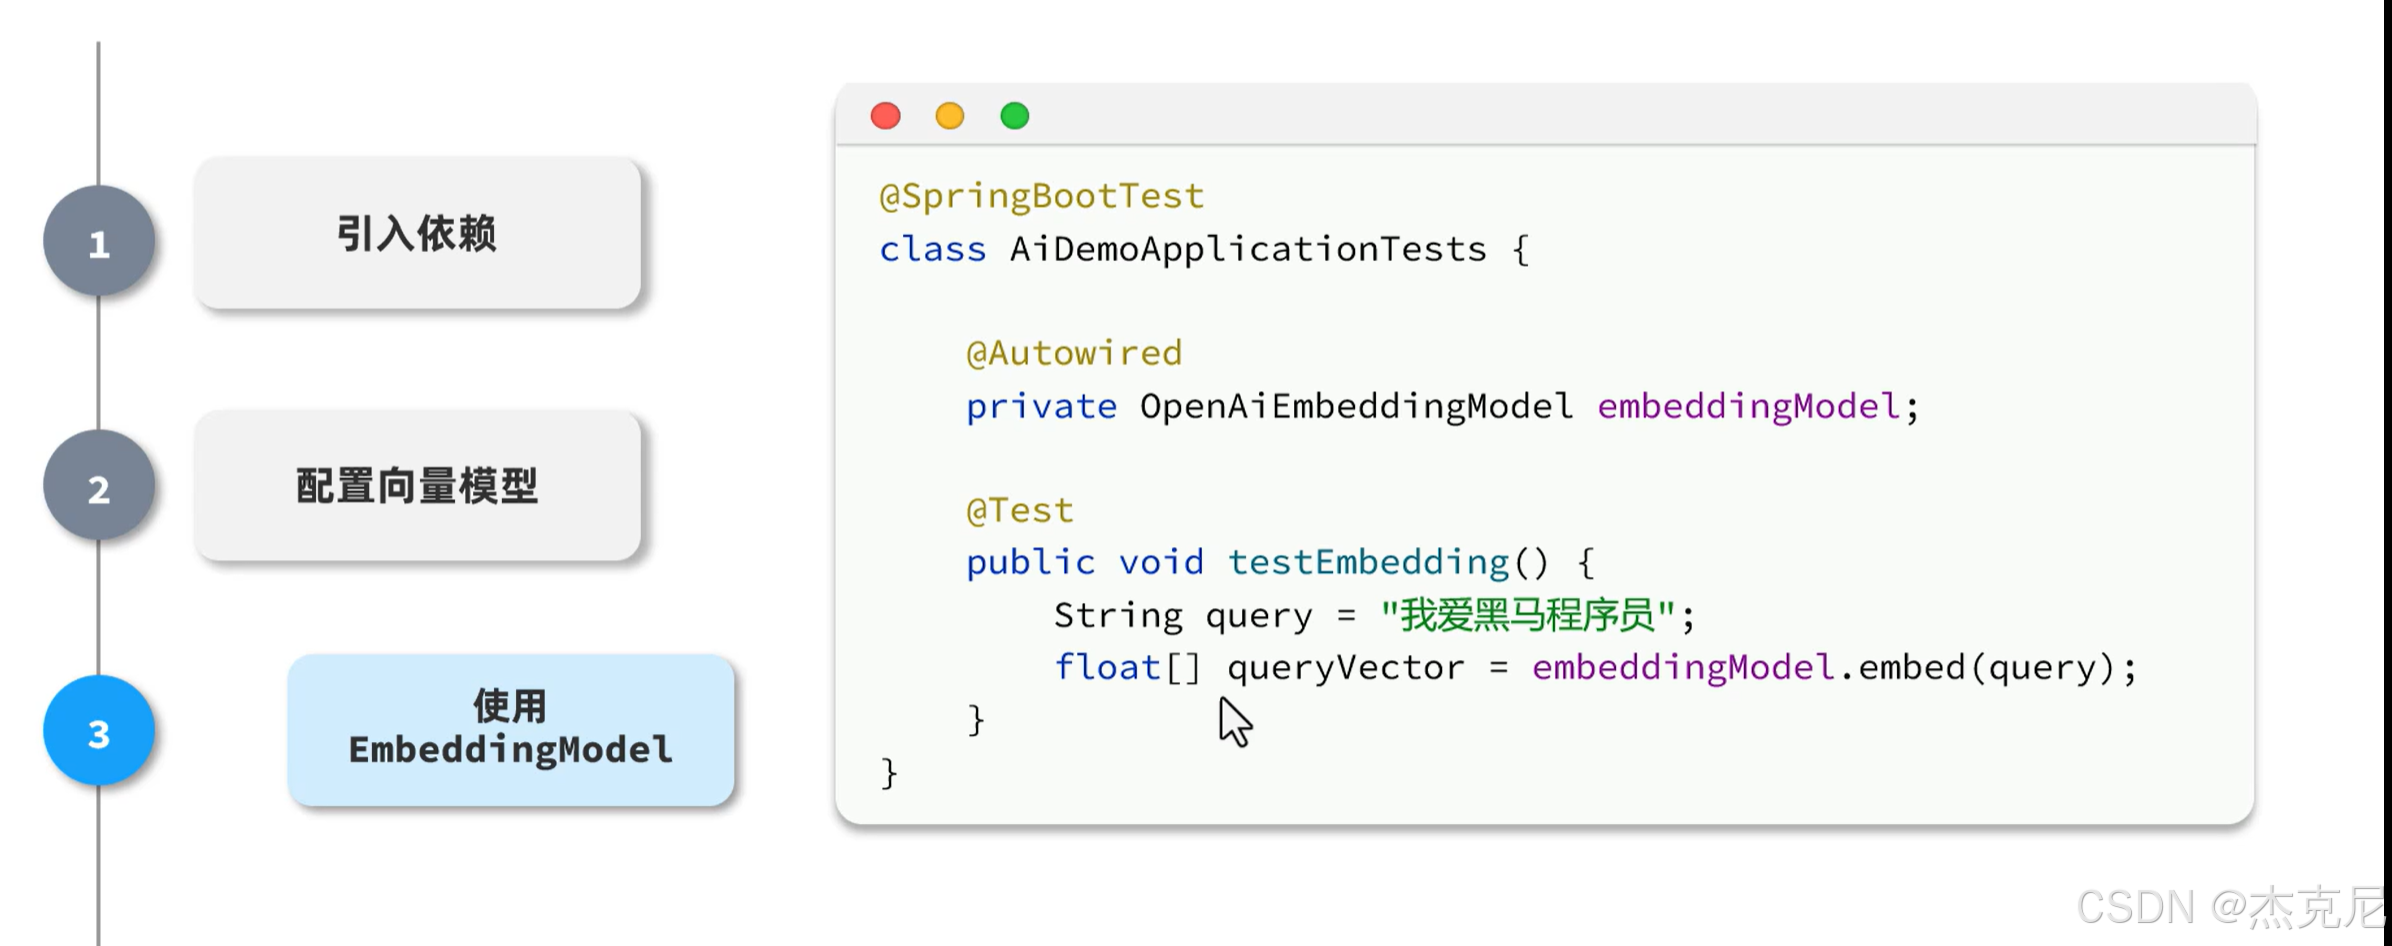
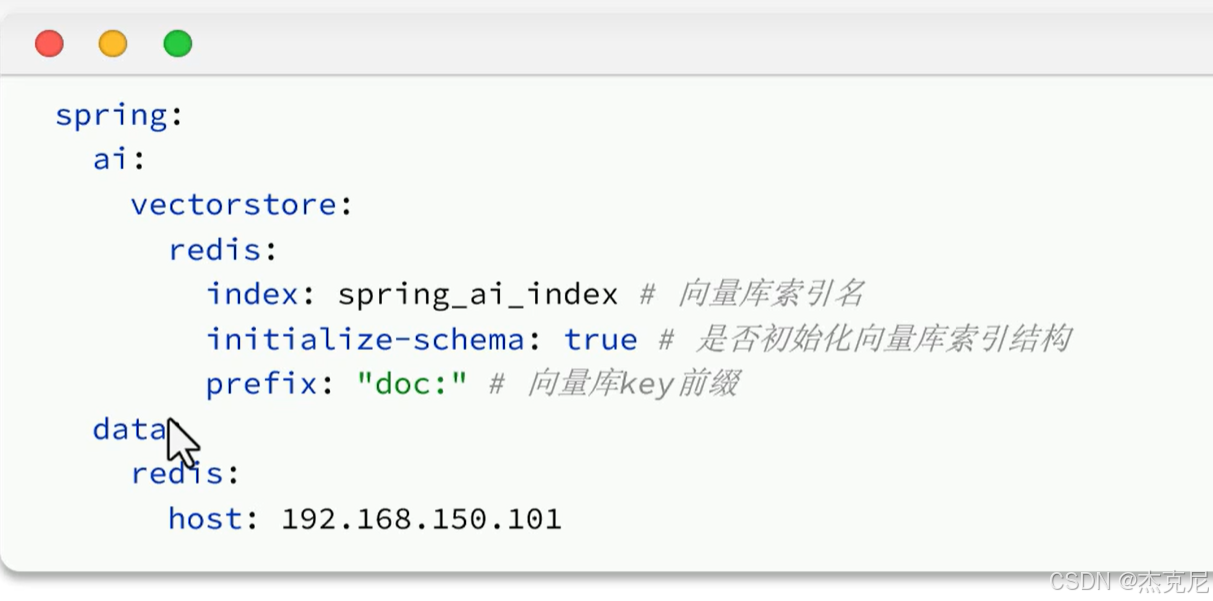
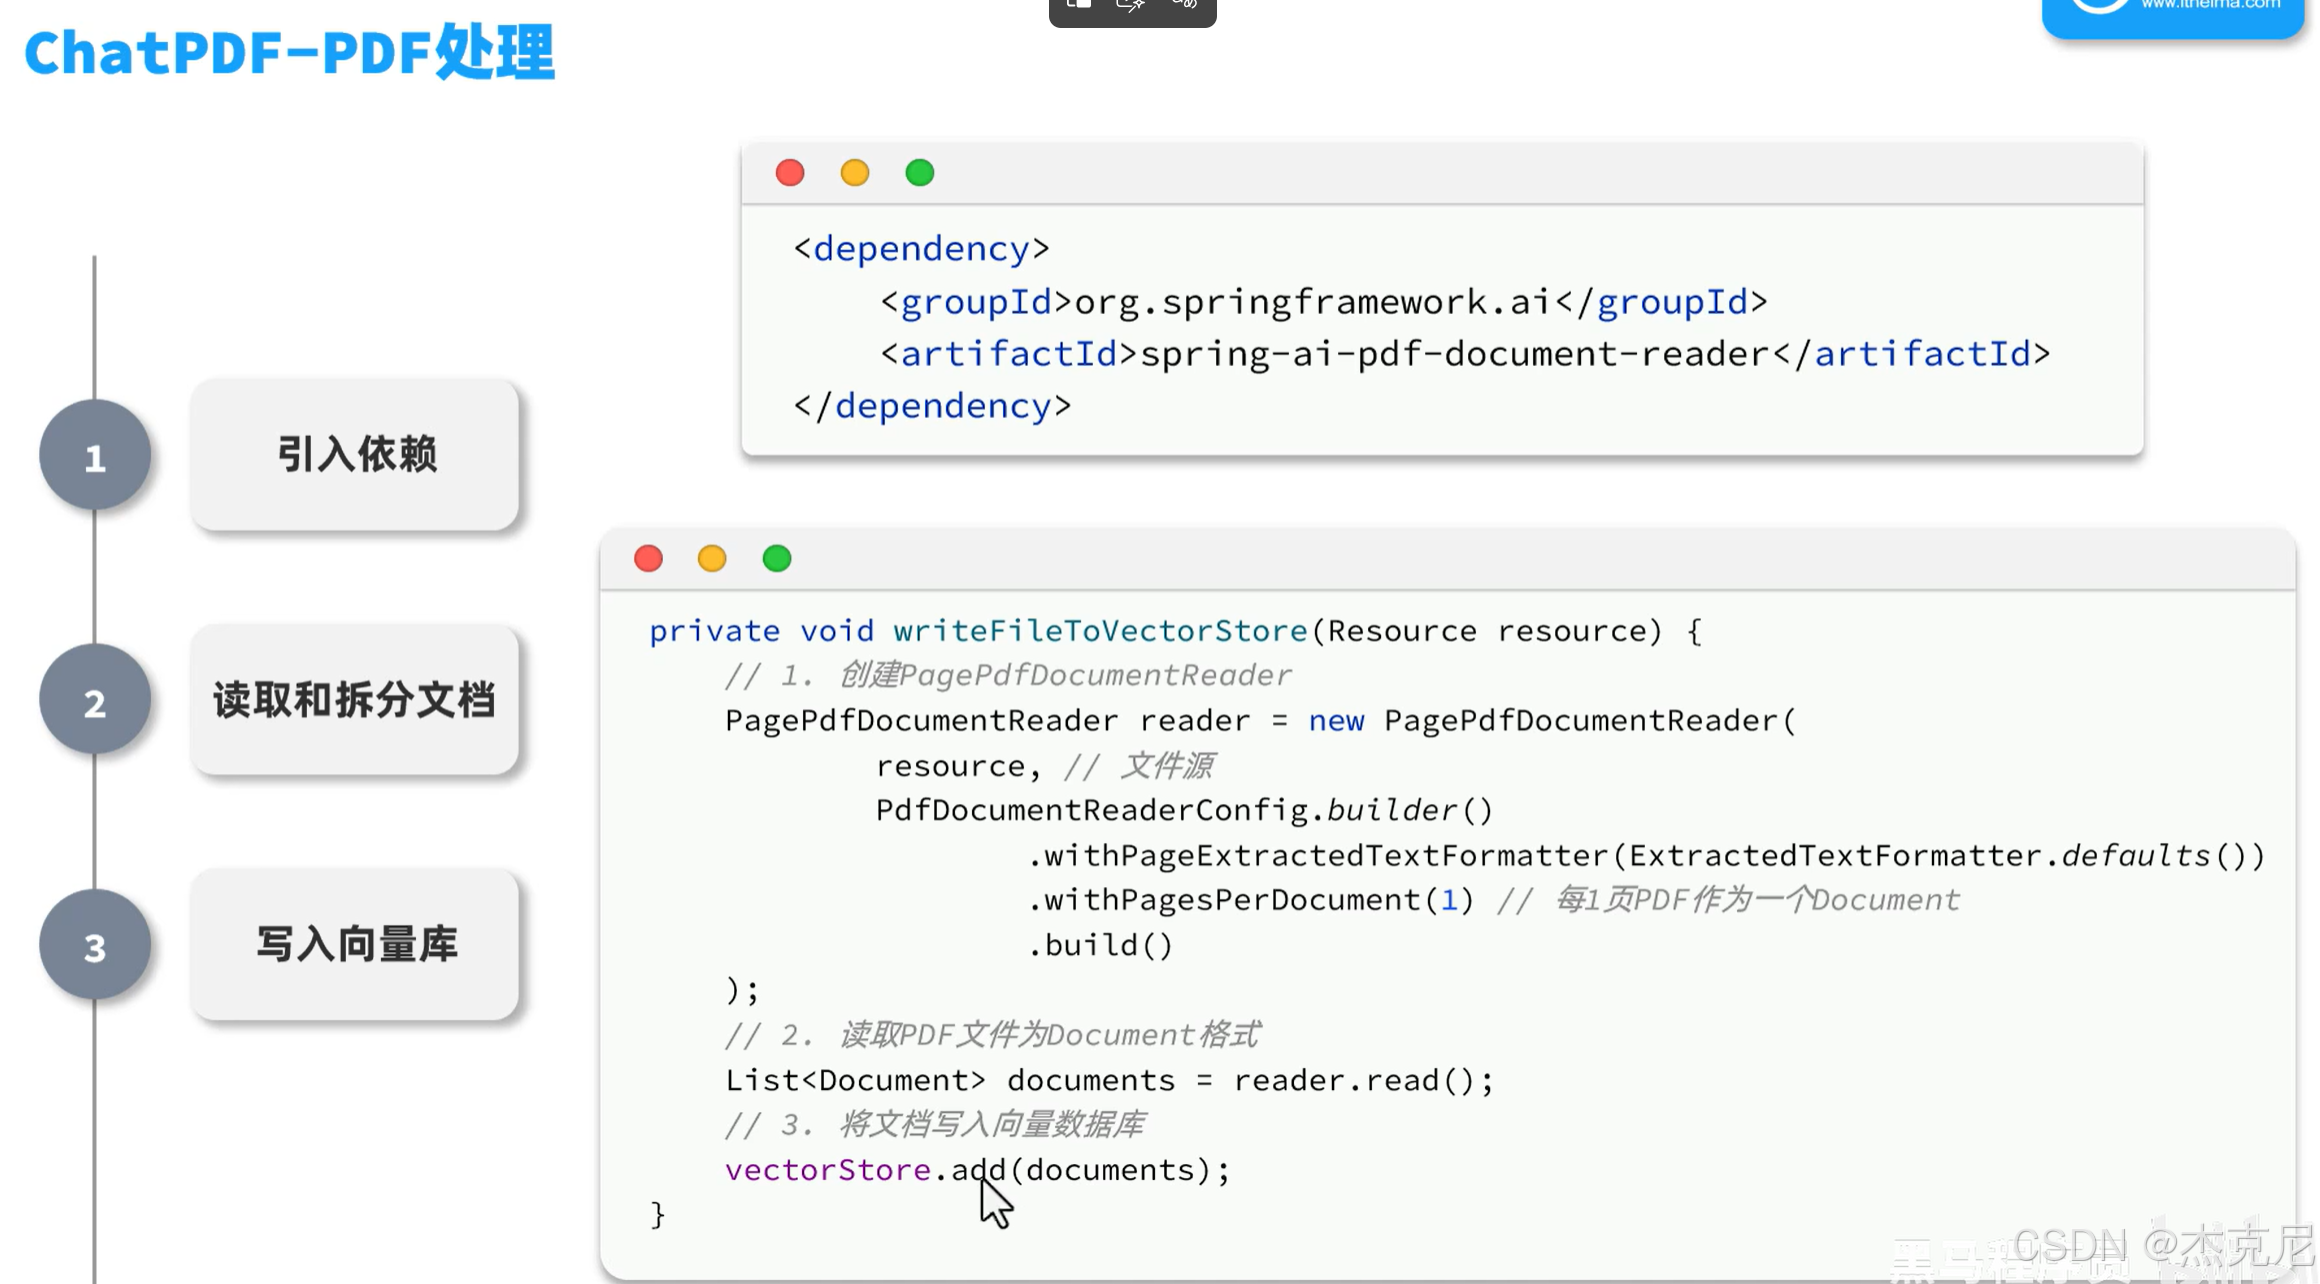
VectorStore操作向量化的基本单位是Document,我们在使用时需要将自己的知识库分割转换为一个个的Document,然后写入VectorStore.那么问题来了,我们该如何把各种不同的知识库文件转为Document呢?
比如PDF文档读取和拆分,SpringAI提供了两种默认的拆分原则:
PagePdfDocumentReader:按页拆分,推荐使用
ParagraphPdfDocumentReader:按pdf的目录拆分,不推荐,因为很多PDF不规范,没有章节标签当然,大家也可以自己实现PDF的读取和拆分功能。
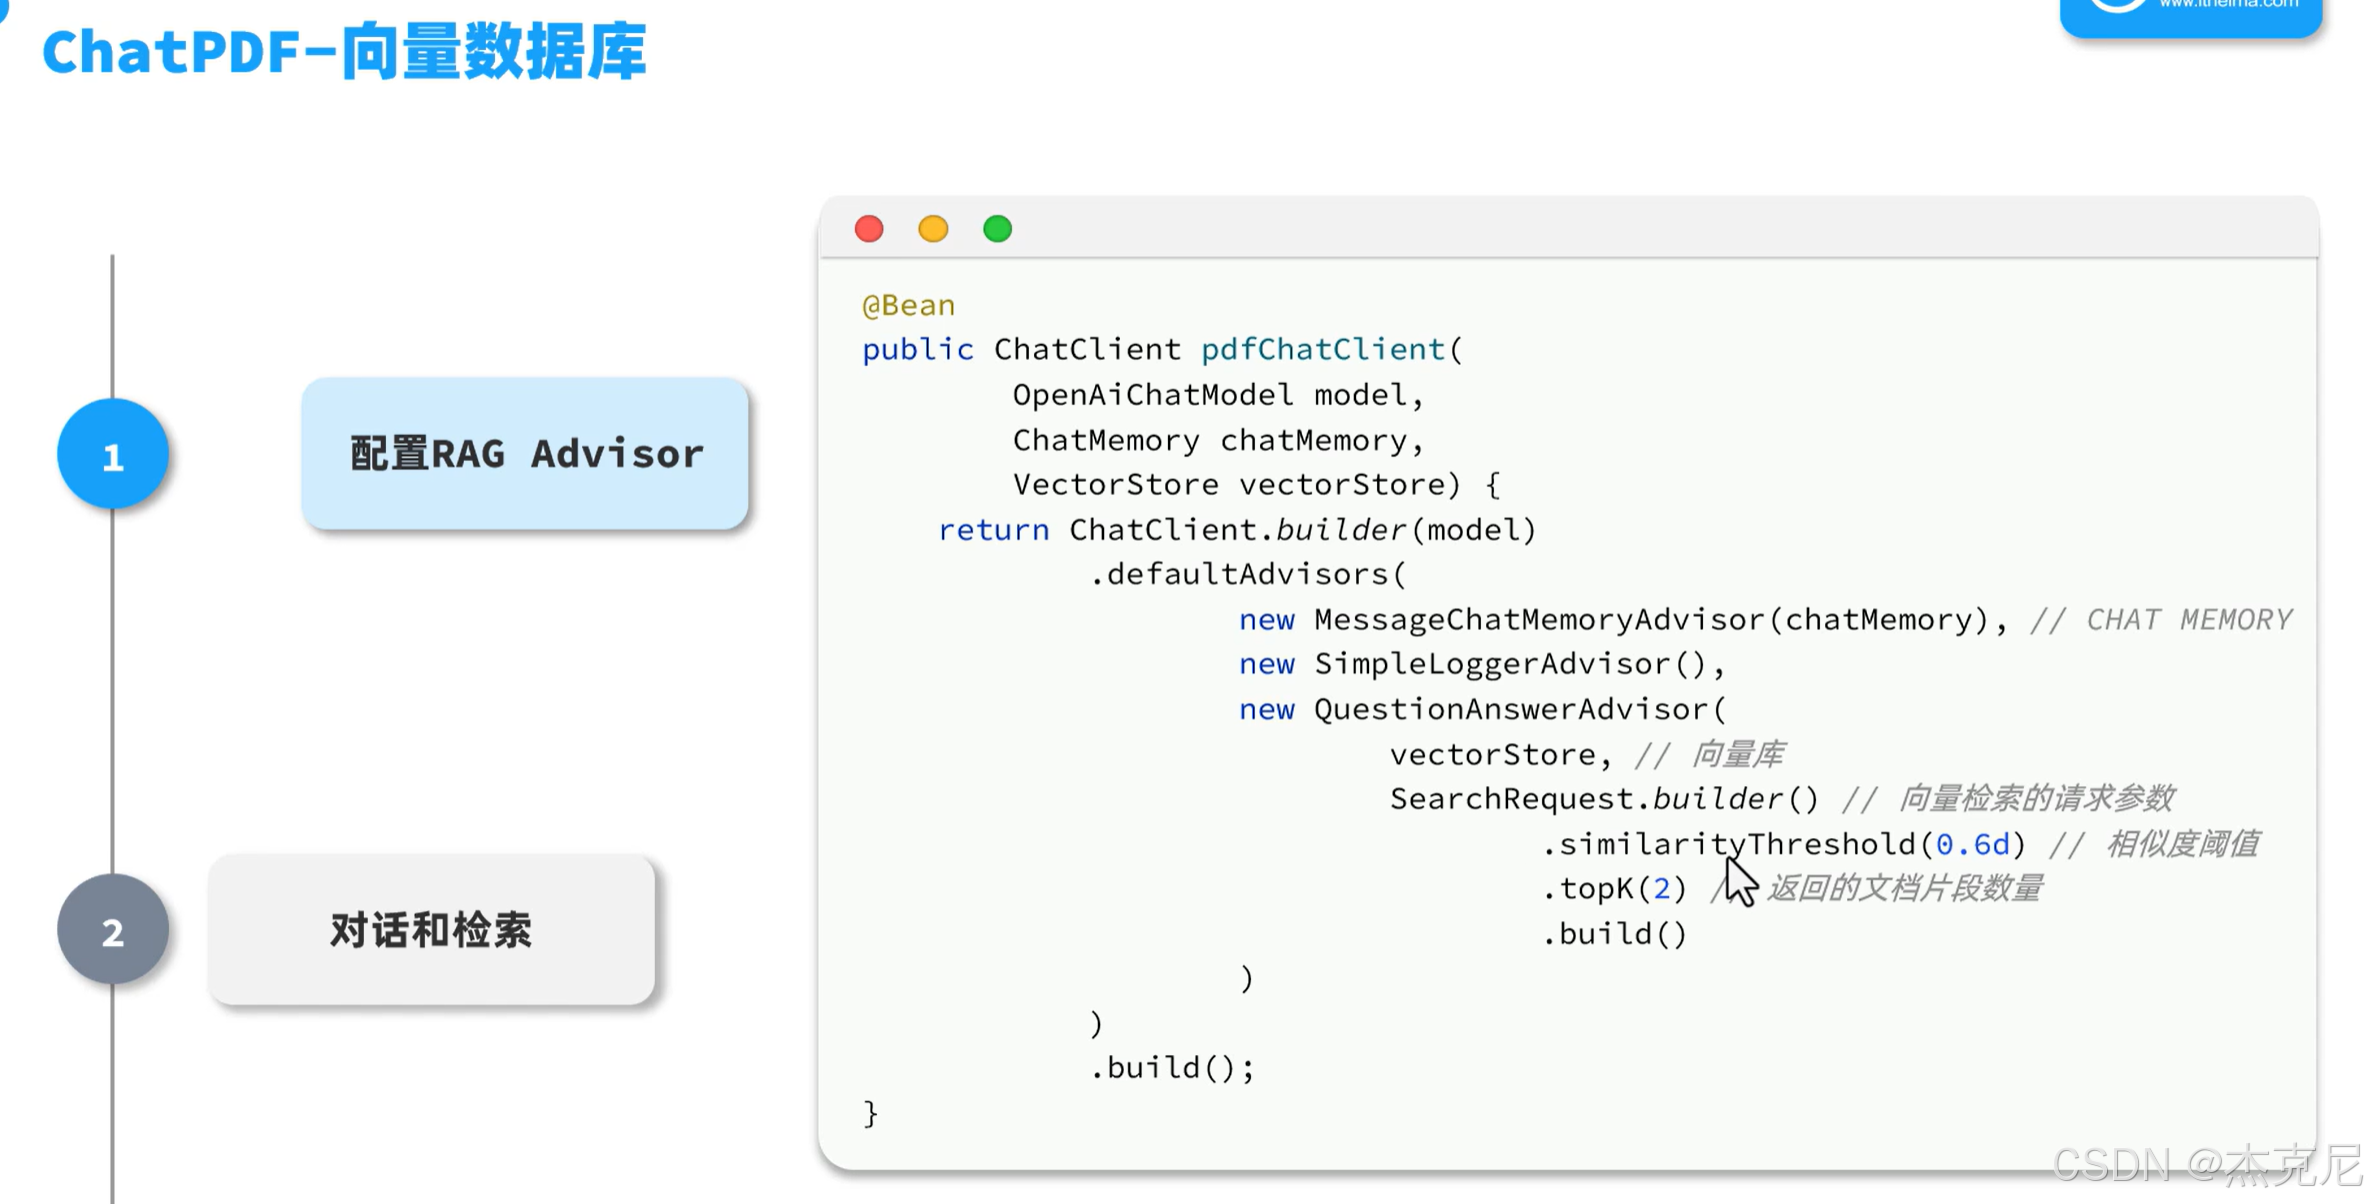
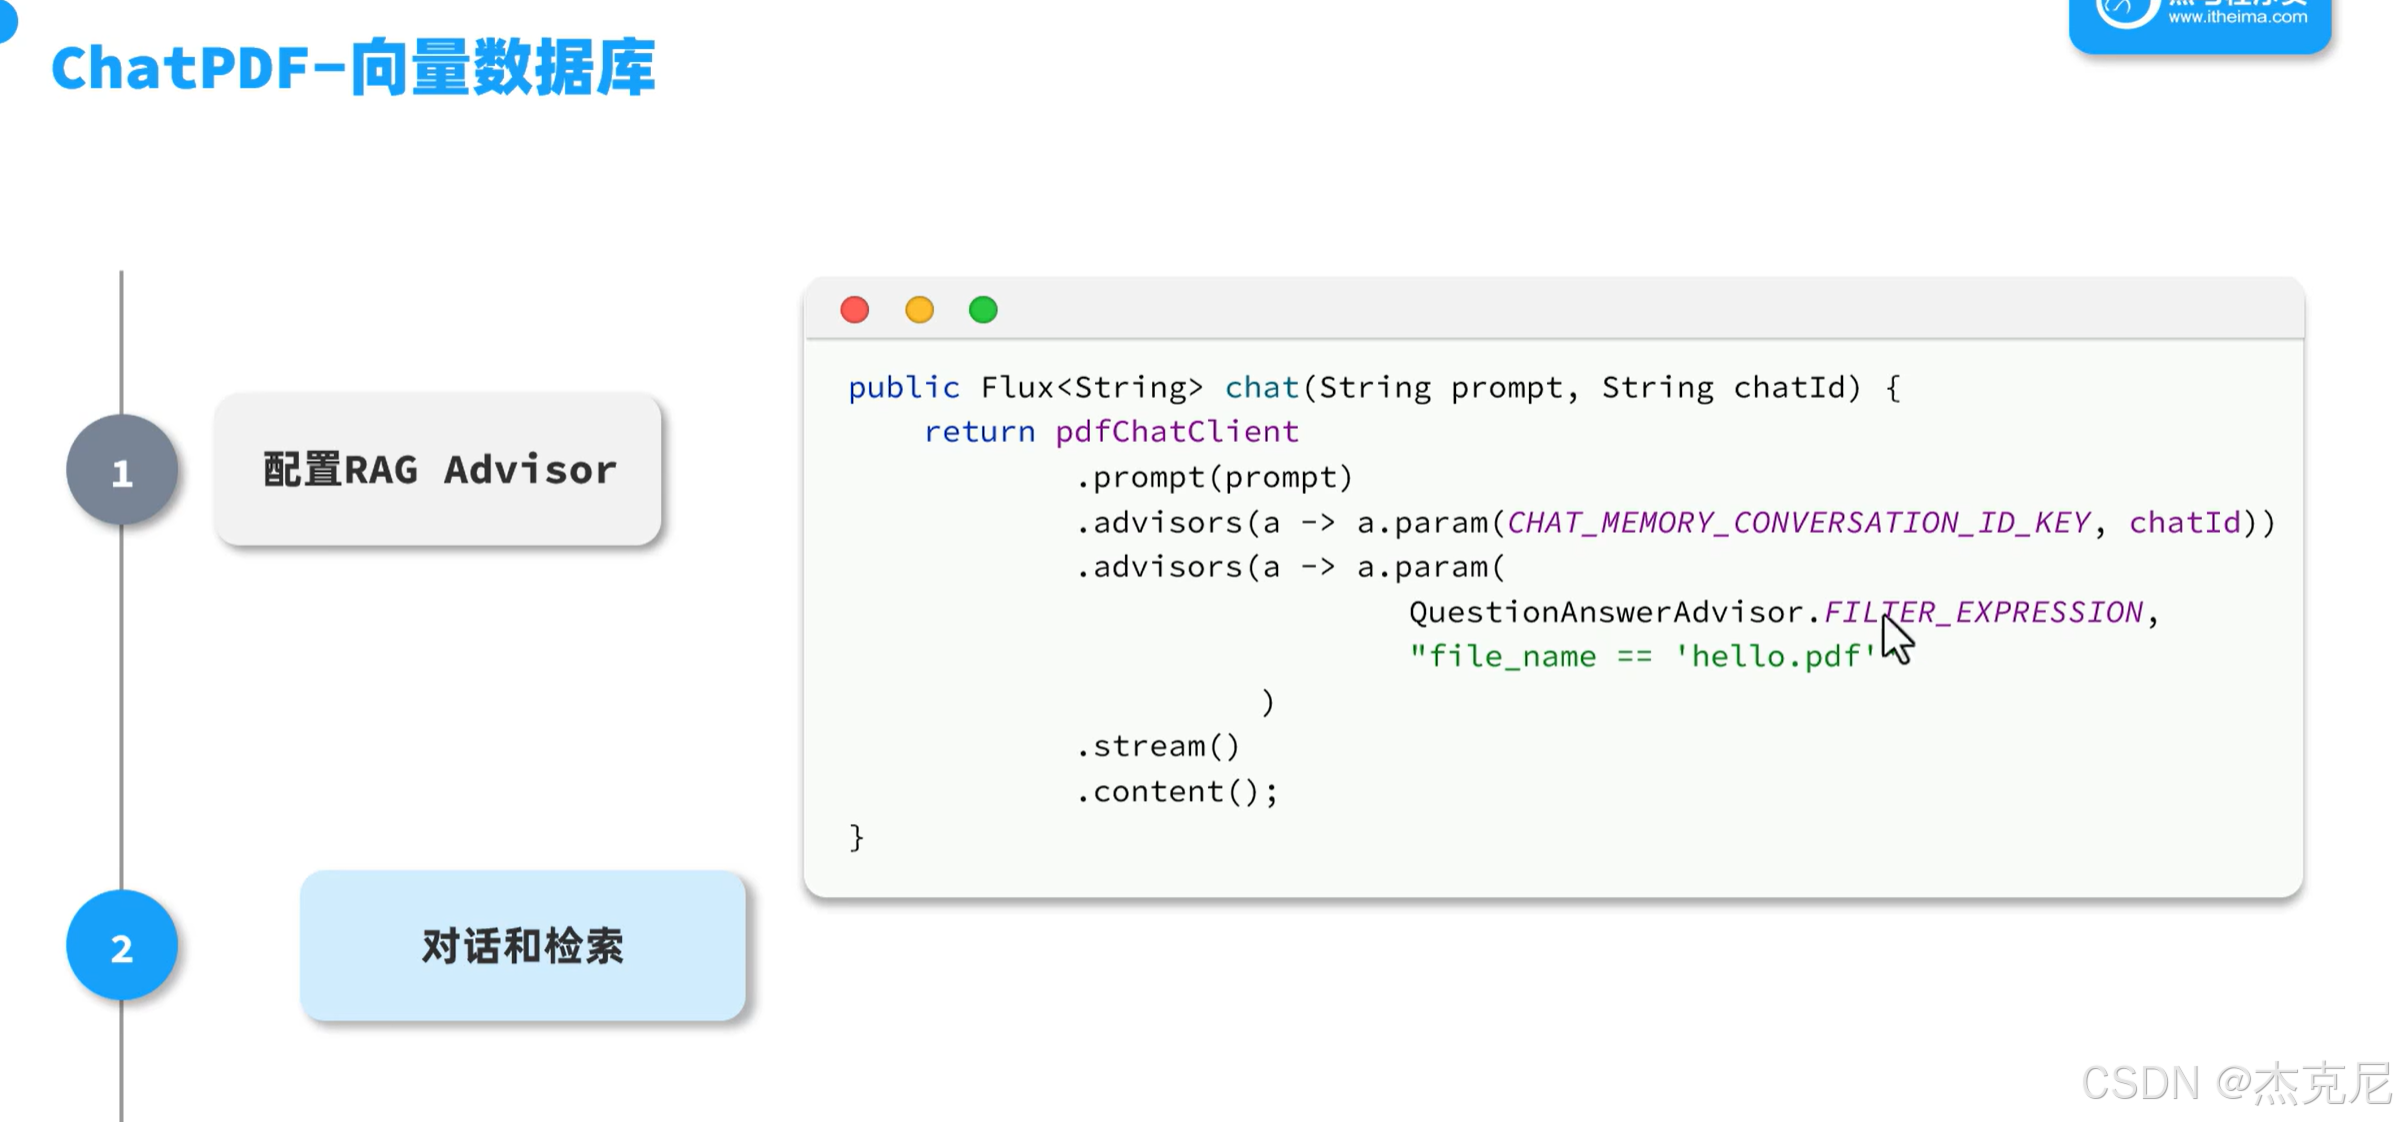
java@Test public void testVectorStore(){ Resource resource = new FileSystemResource("中二知识笔记.pdf"); // 1.创建PDF的读取器 PagePdfDocumentReader reader = new PagePdfDocumentReader( resource, // 文件源 PdfDocumentReaderConfig.builder() .withPageExtractedTextFormatter(ExtractedTextFormatter.defaults()) .withPagesPerDocument(1) // 每1页PDF作为一个Document .build() ); // 2.读取PDF文档,拆分为Document List<Document> documents = reader.read(); // 3.写入向量库 vectorStore.add(documents); // 4.搜索 SearchRequest request = SearchRequest.builder() .query("论语中教育的目的是什么") .topK(1) .similarityThreshold(0.6) .filterExpression("file_name == '中二知识笔记.pdf'") .build(); List<Document> docs = vectorStore.similaritySearch(request); if (docs == null) { System.out.println("没有搜索到任何内容"); return; } for (Document doc : docs) { System.out.println(doc.getId()); System.out.println(doc.getScore()); System.out.println(doc.getText()); } }
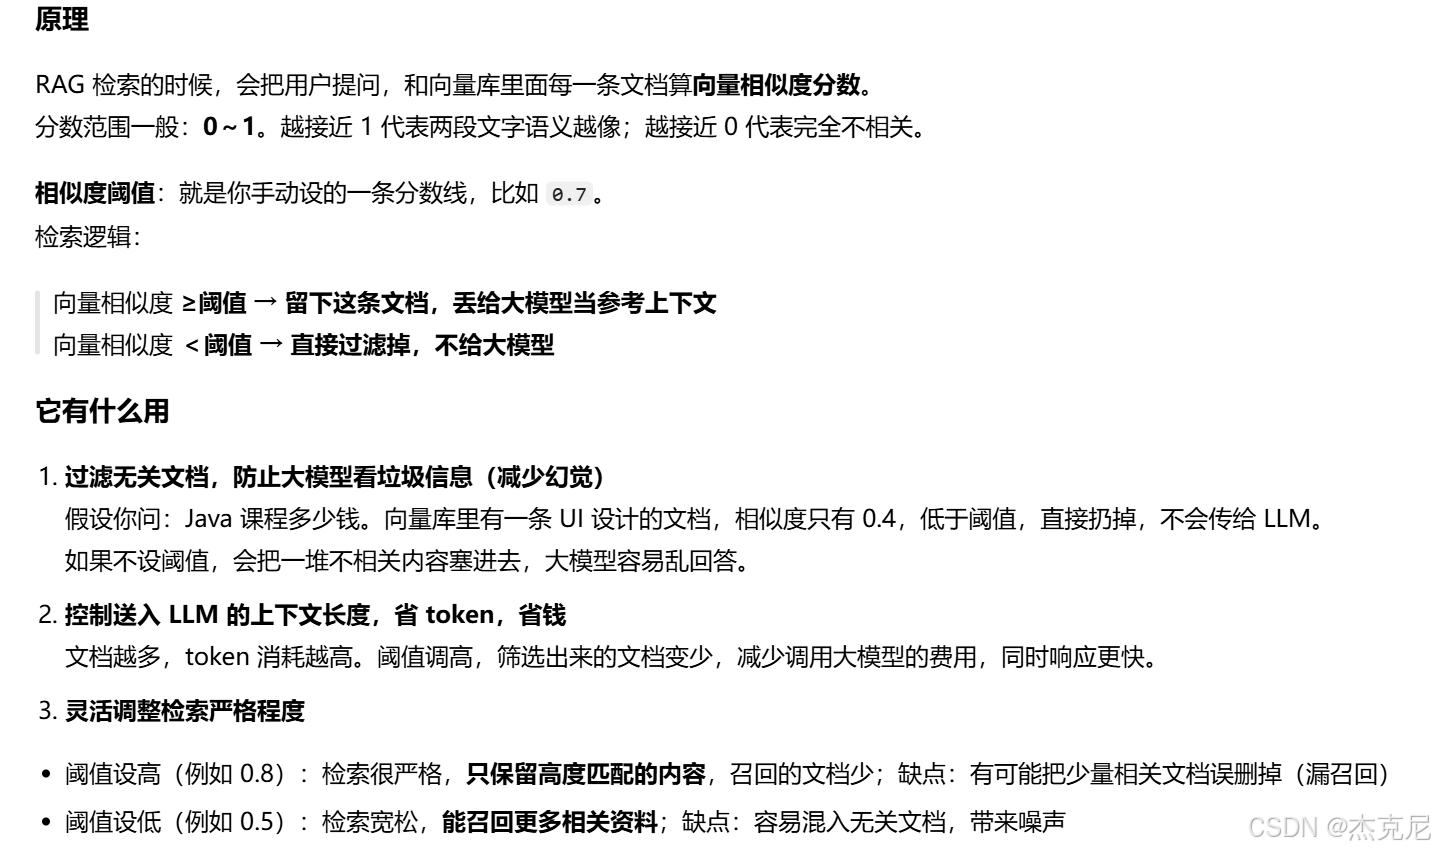
12相似度评分阈值有什么用?
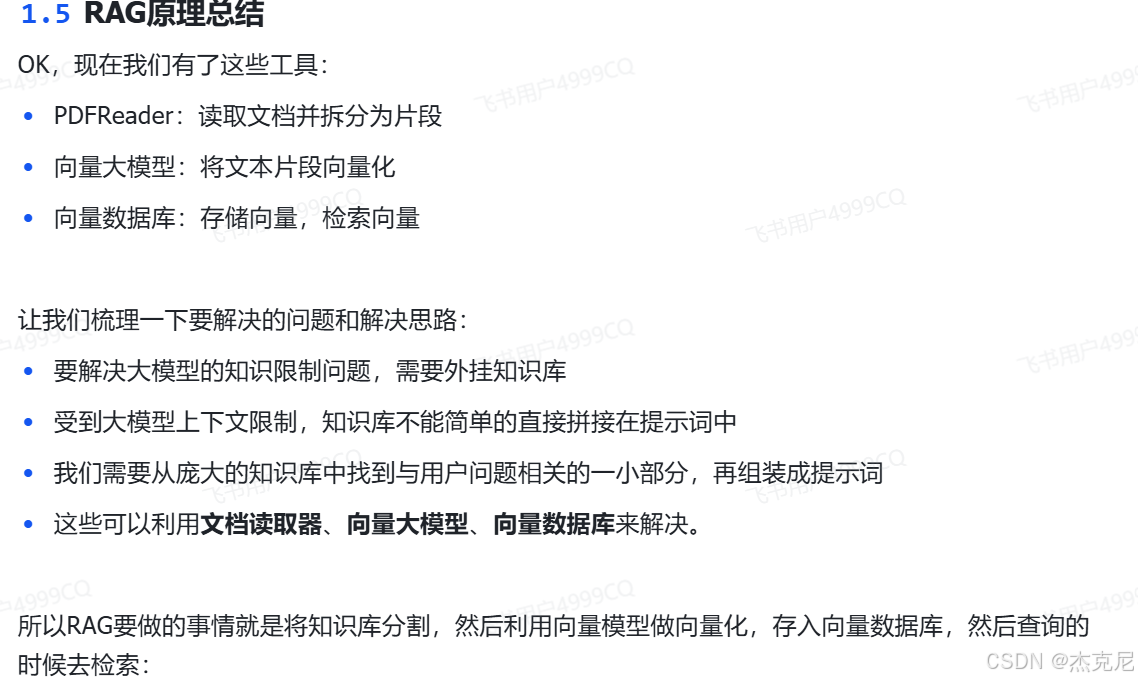
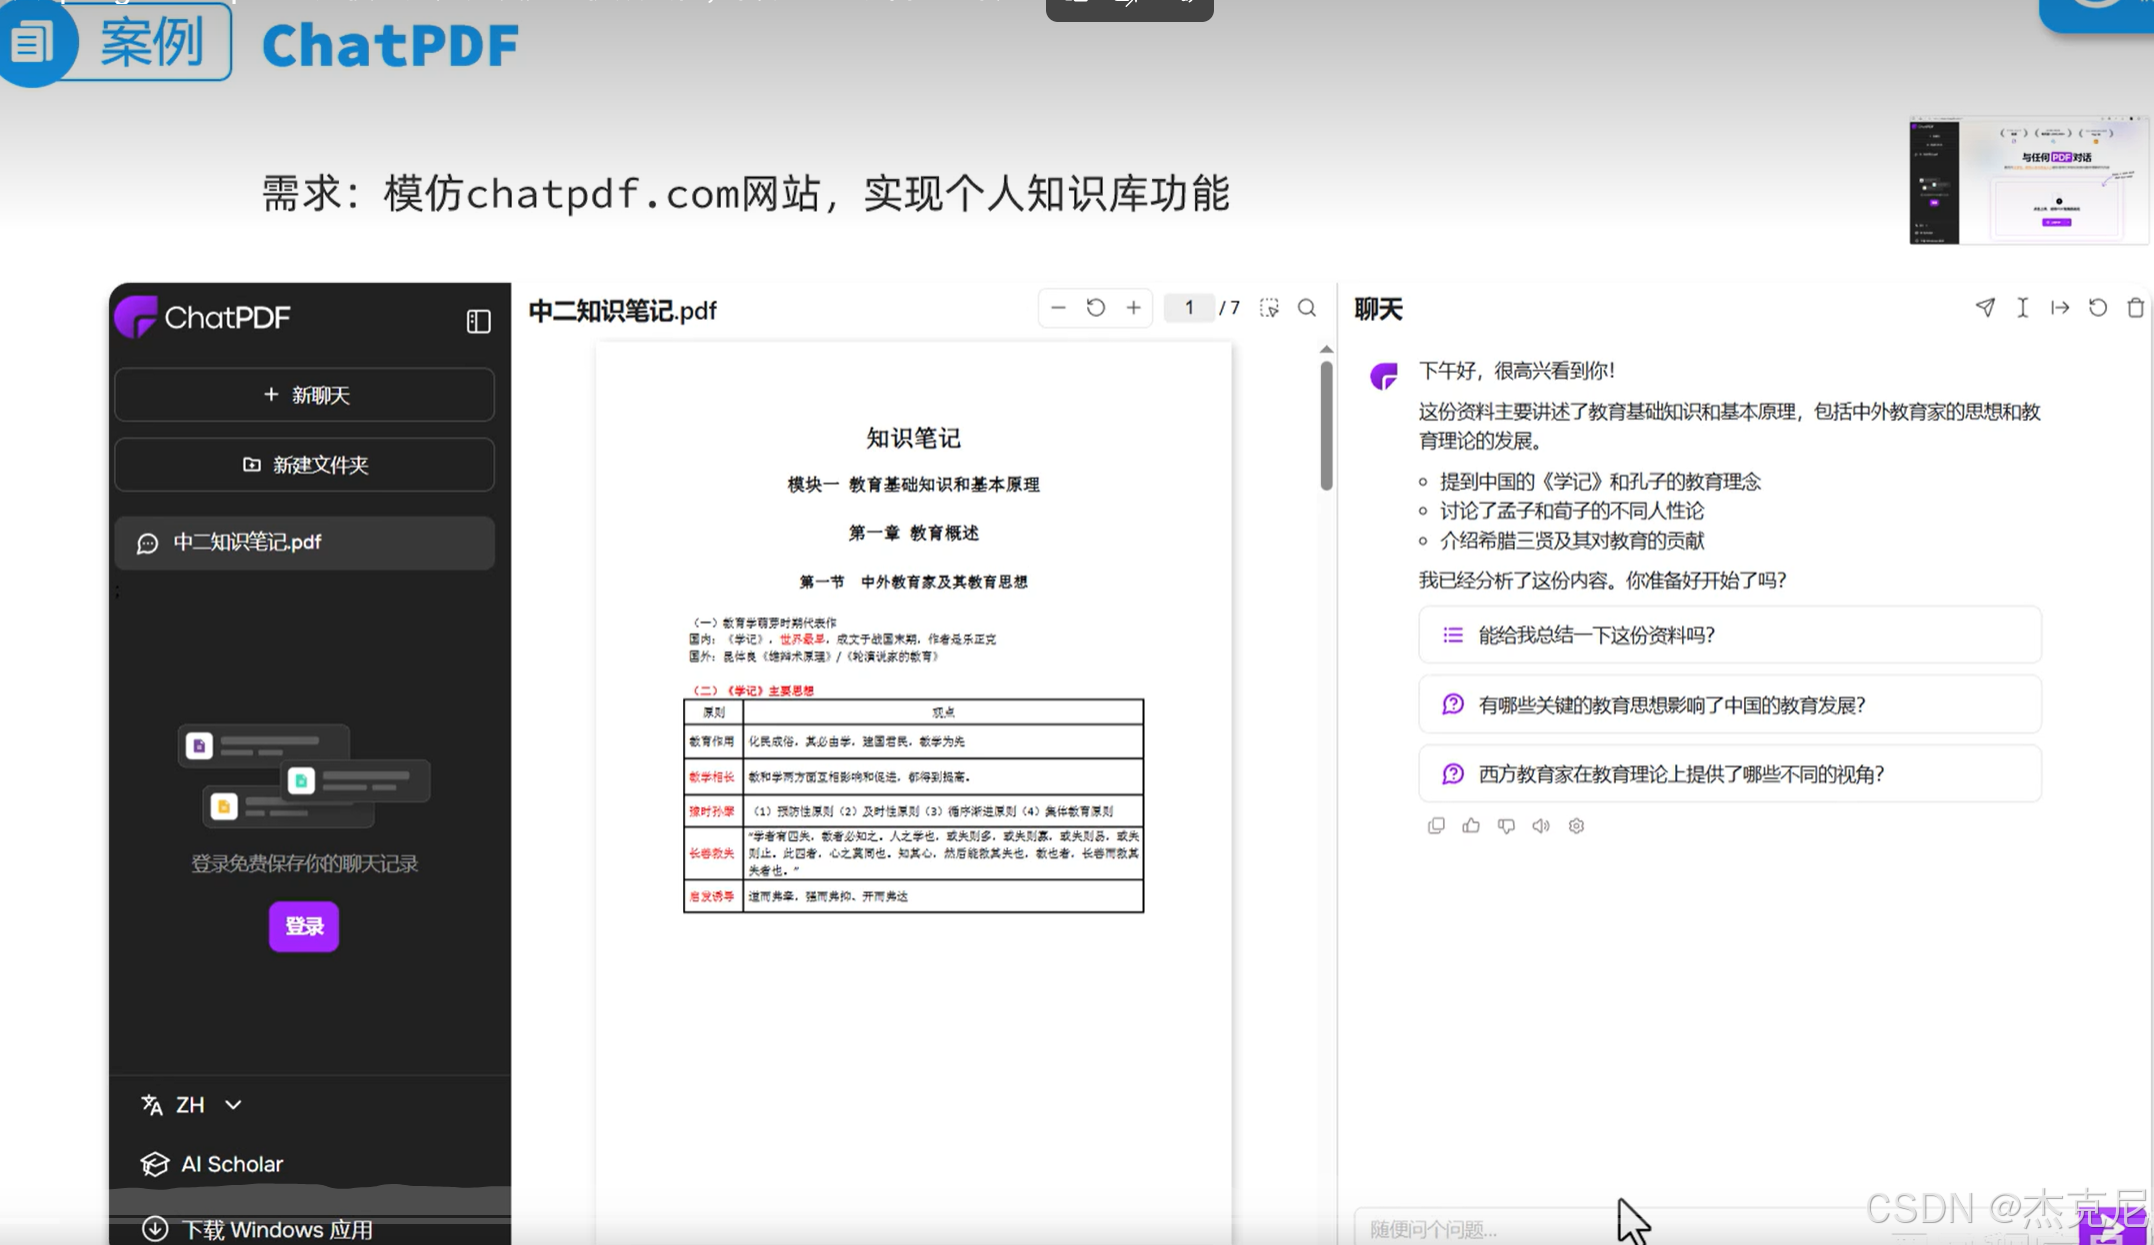
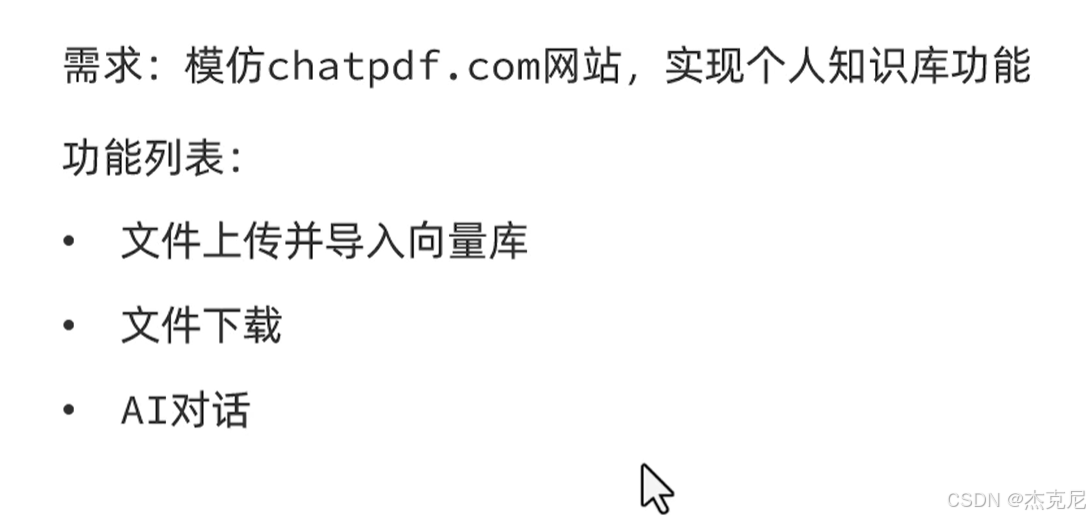
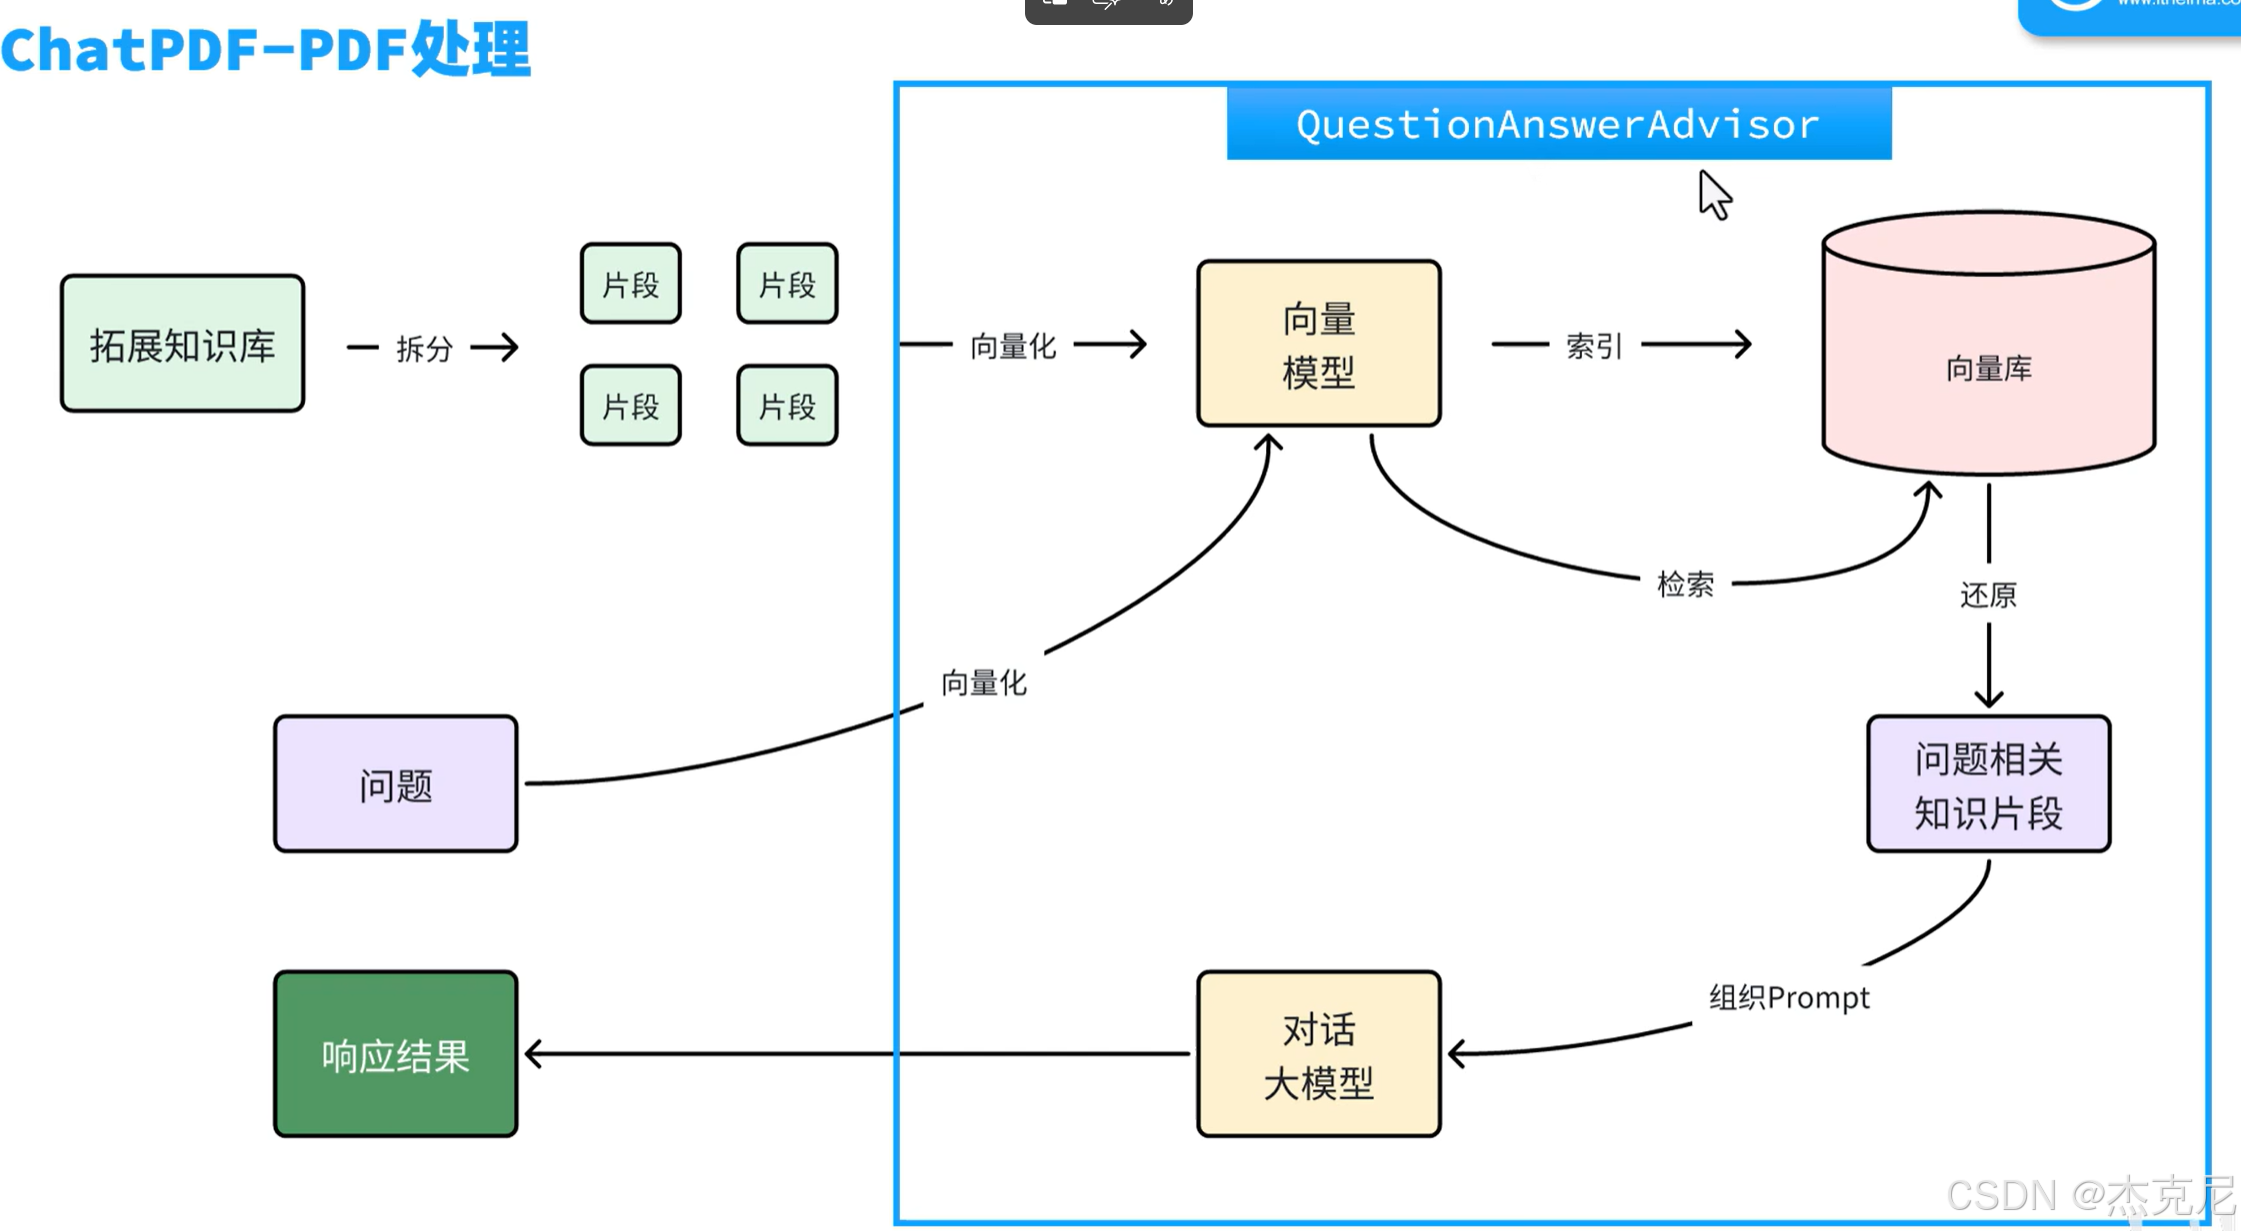
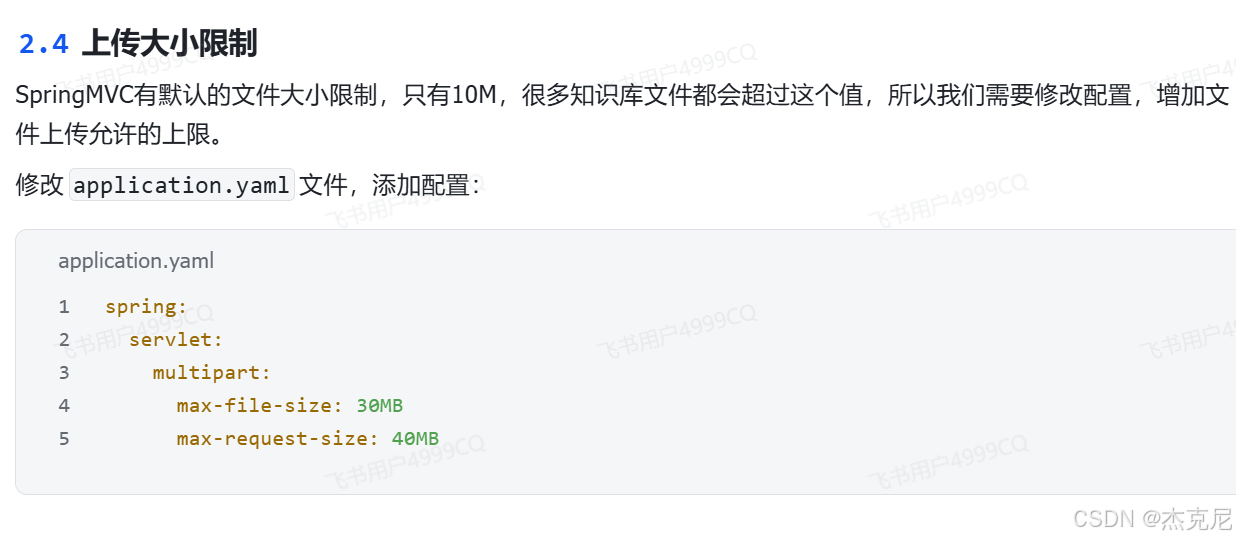
13个人知识库功能怎么实现?
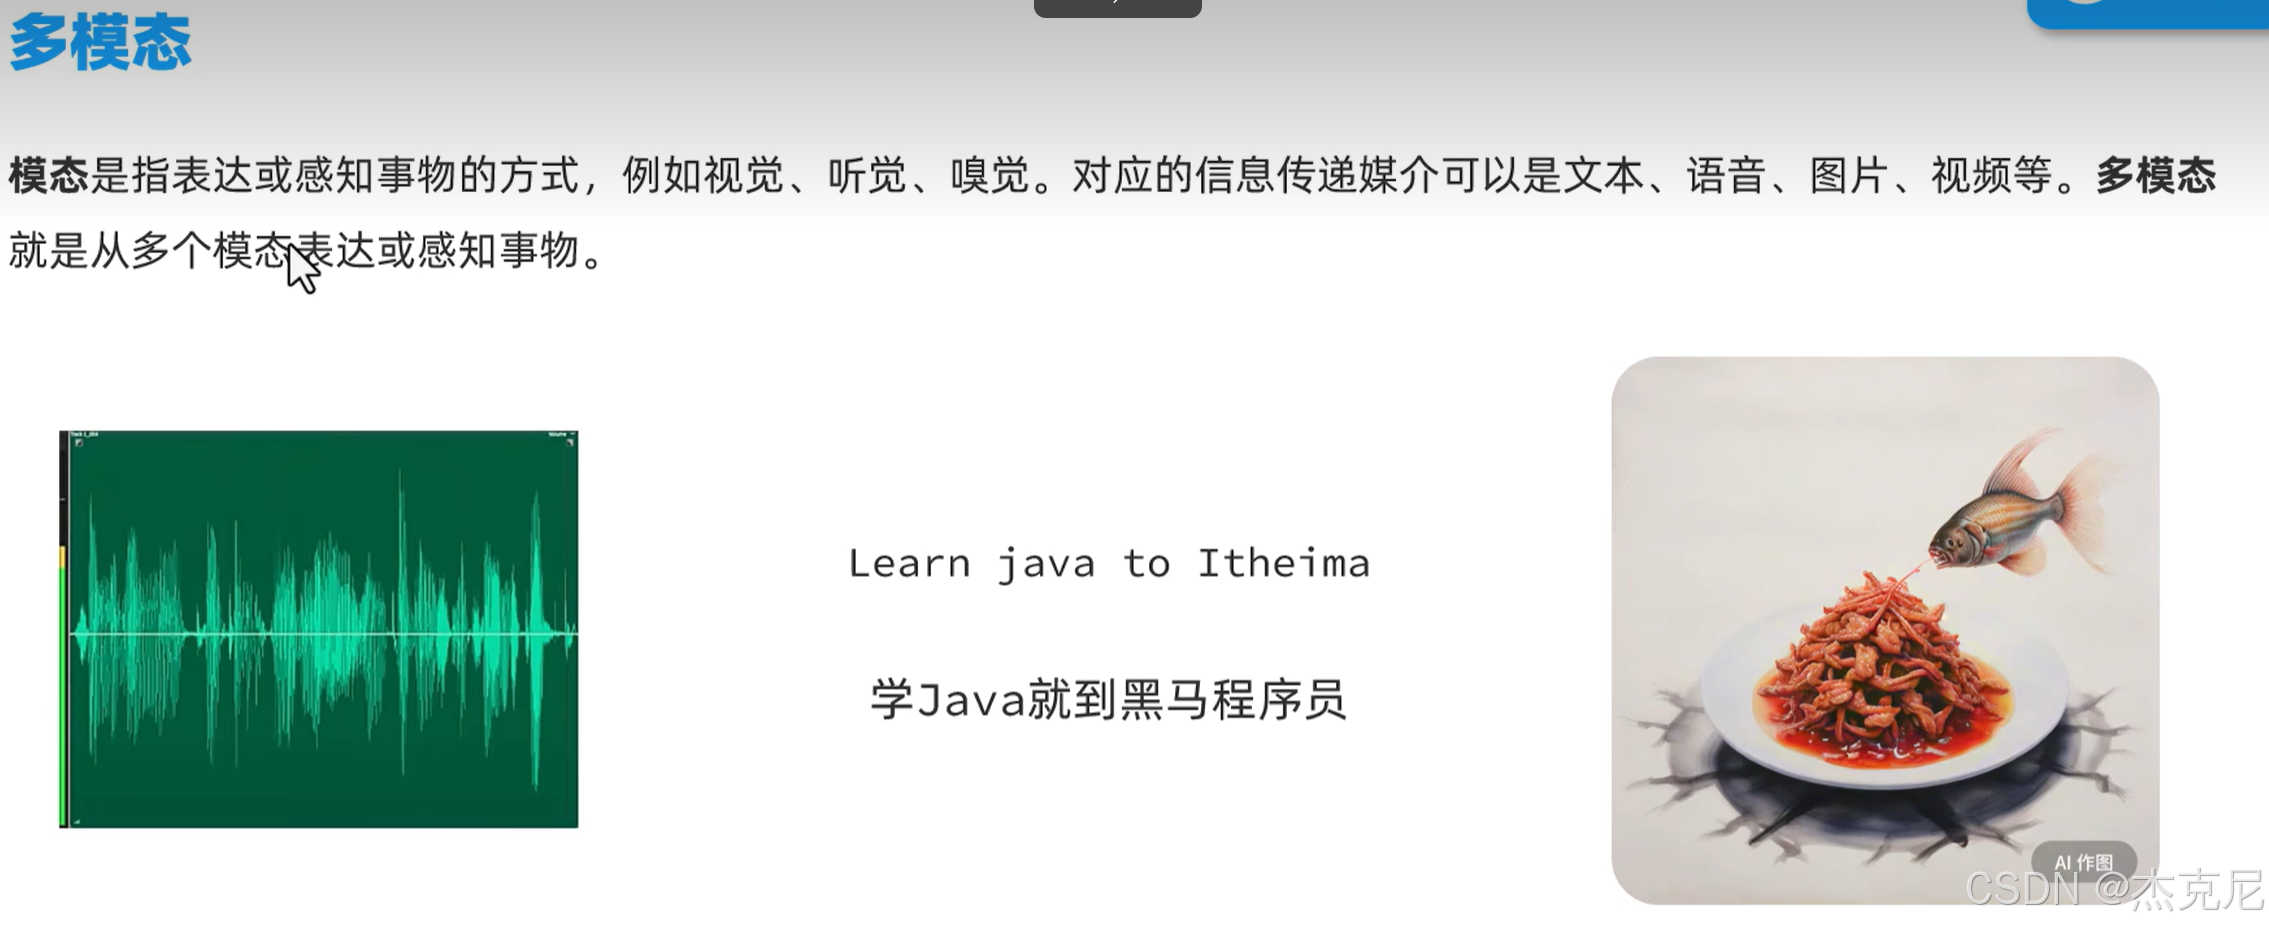
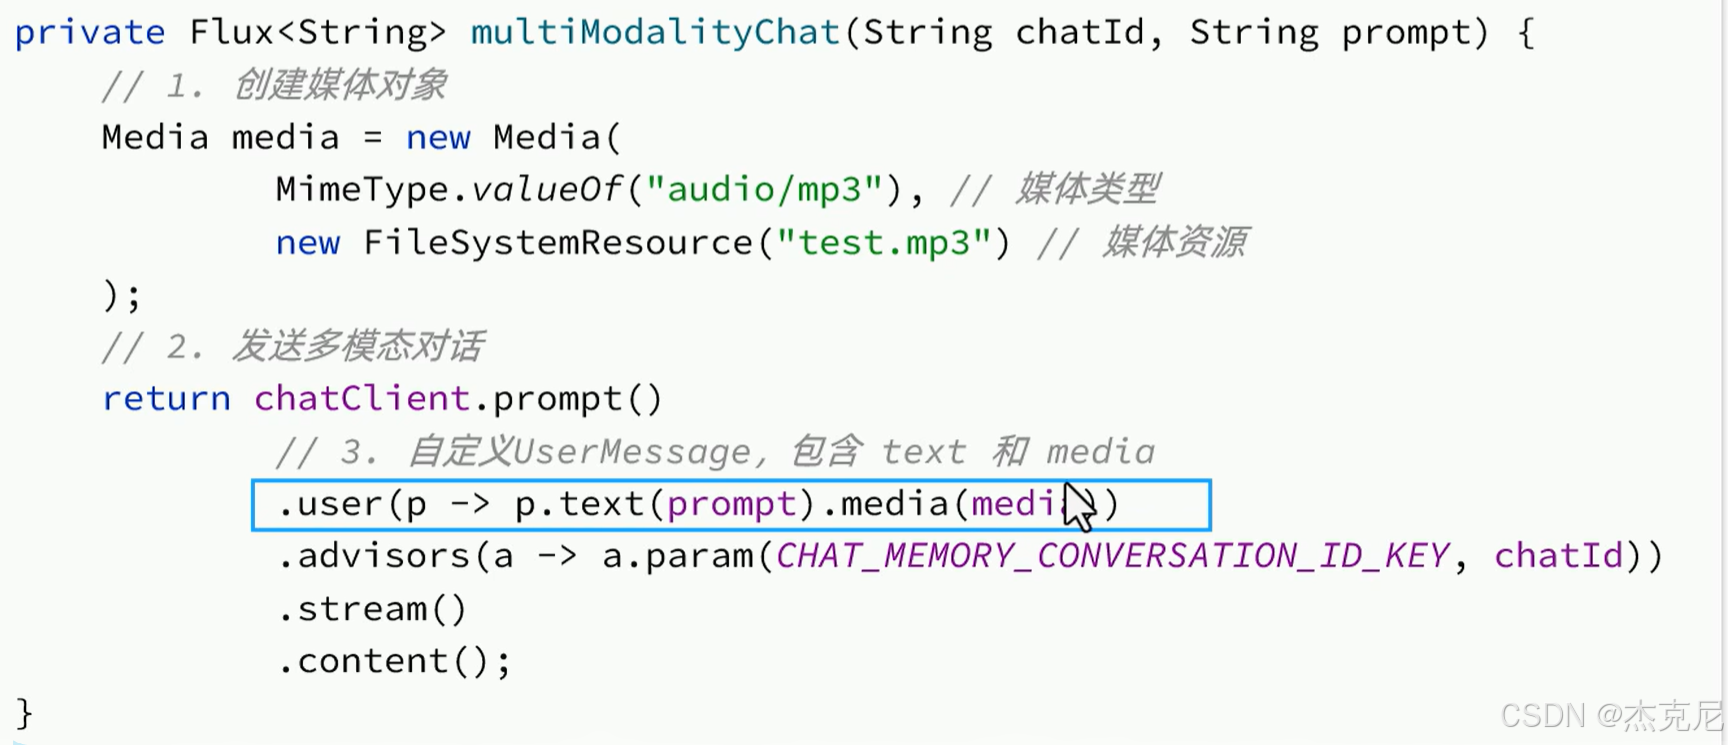
14多模态是什么?
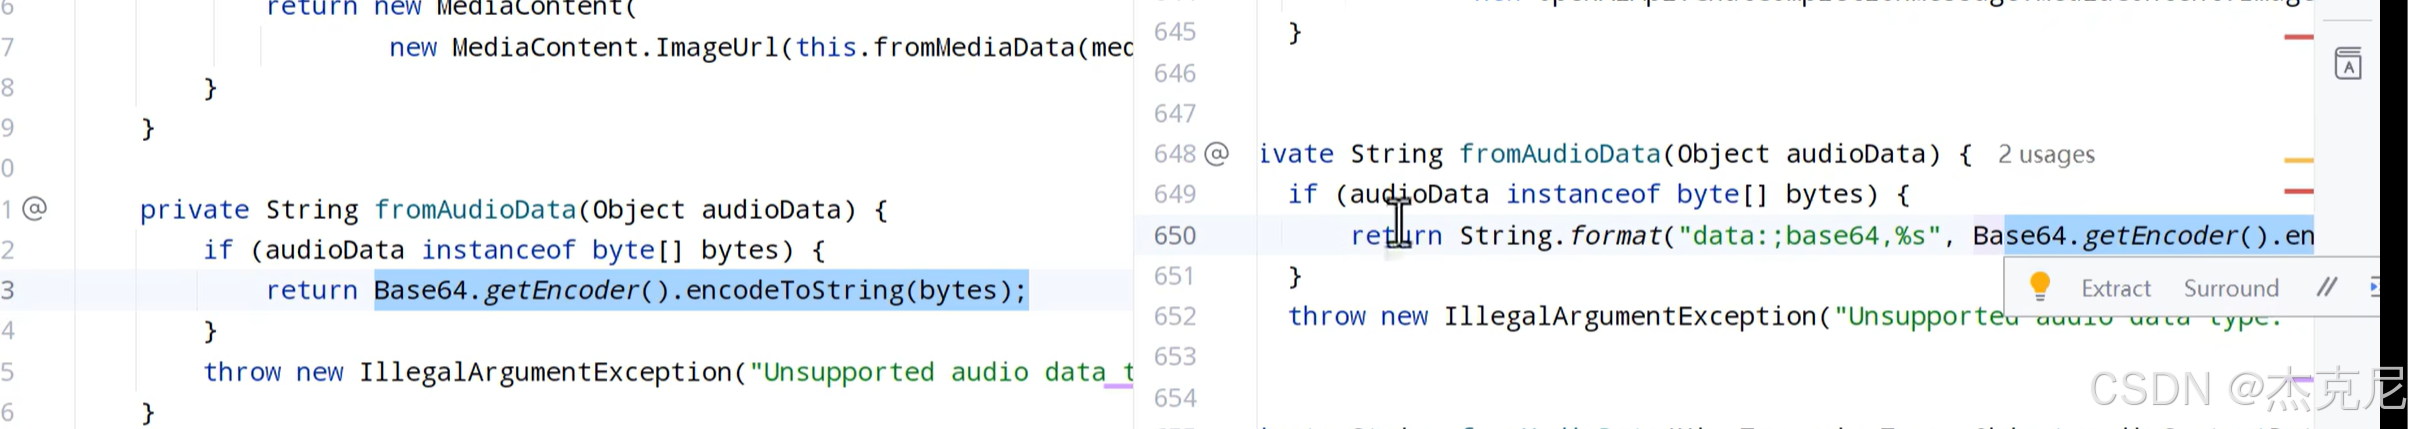
音频需要自定义改造(base64编码)
15完结
本文系统阐述大模型应用开发核心要点:通过会话ID管理会话历史与记忆,实现对话连续性;利用提示词工程优化交互效果;基于SpringAI将PDF等多源知识库按页或段落拆分为Document,写入VectorStore实现向量化存储与检索;结合相似度阈值控制搜索精度;通过自定义改造支持音频等多模态输入;最终构建具备个人知识库与智能客服能力的对话系统。