把库仑定律写进损失函数:DCNN-PINN 做锂电池 SOC 估计
第 69 讲 · 电池预测系列 | 内含 9 张实测图表、完整公式推导与参数清单
油车看油表,电车看 SOC。
油表能直接量液位,SOC 不能。它是电池内部"还剩多少锂"的抽象状态,没有哪个传感器能直接读出这个数。你在车机上看到的那个百分数,全都是算出来的。
所以 SOC 估计本质上是在做一个映射:从可观测量 (电流、电压、温度)到不可观测量(荷电状态)。这个映射里有两个绕不开的老问题。
安时积分法,把电流对时间积分再除以容量,公式干净,但初值错了就一直错,传感器零点漂移会一秒一秒累积,跑两小时能偏出 10 个百分点。开路电压法,静置到电压稳定后查 OCV-SOC 曲线,准,可车一开起来就失效了。
这几年大家往数据驱动上挤,LSTM、CNN、Transformer 全上,精度确实能打。但纯黑箱模型有个通病------它不知道自己在估的是"电荷"。于是会输出一条 SOC 跳变、越界、甚至和电流方向相反的轨迹。拟合得再漂亮,也只是在训练分布里像样。
这讲要做的就是治这个病。办法说穿了不复杂:把物理方程当成软约束,写进损失函数里去。
01 它到底做了什么
先把这个程序的功能说清楚,别一上来就堆网络结构。
输入是一段长度为 32 秒的电流、电压时间窗口,输出是窗口内每一个时刻的 SOC 轨迹,而不只是最后一个点。这个设计是有讲究的:让网络逐点预测整段曲线,物理约束才能作用在"相邻两点之间的差分"上,而不是只有一个孤立的数值。
更关键的是,程序里没有一个物理参数是人为拍脑袋填进去的。容量、库仑效率、欧姆内阻、OCV-SOC 曲线,全部从数据里辨识出来:
- 容量 Cn 由放电电量积分除以 SOC 变化量得到,估出来是 77.72 Ah
- 库仑效率 η 由全段 SOC 变化与电流积分自洽求得,落到 1.00
- 等效欧姆内阻 R0 和 OCV 多项式系数,用一次最小二乘同时解出,R0 ≈ 0.00390 Ω
这一步很实在。参数从数据里来,模型就不是在拟合一个你预先设定的世界,而是在边拟合边校准自己的物理模型。
02 技术路线
整条链路一句话就能串起来:
数据重采样 → 物理参数辨识 → 特征归一化 → 滑窗构造 → 因果空洞卷积 → 三项复合损失训练 → 多维度评估
拆开看,每一步都在解决一个具体问题:
| 阶段 | 做什么 | 解决什么 |
|---|---|---|
| 数据预处理 | 每 10 行取 1 行,等效 dt = 1 s | 降低序列冗余,统一时间步 |
| 参数辨识 | 积分法求 Cn、自洽法求 η、最小二乘求 R0 与 OCV | 让物理方程有真实数值可用 |
| 归一化 | 电流、电压 Min-Max 拉到 0,1 | 让三项损失量级可比 |
| 滑窗构造 | 32 点滑窗,输出 [2, N, 32] 张量 |
给网络一段"上下文"而非单点 |
| 网络前向 | 四层因果空洞卷积 + 逐层归一化 | 只看过去,感受野刚好覆盖整窗 |
| 损失回传 | 数据损失 + 库仑损失 + 电压损失加权求和 | 精度与物理一致性同时约束 |
| 评估 | RMSE / MAE / R² / MAPE + 误差分布 + 物理一致性 | 不只看准不准,还看合不合理 |
采集来的电池数据是 BBDST 工况下的电流电压序列,属于典型的动态放电工况,电流波动剧烈、SOC 全程从满放到空,正好是检验动态估计能力的好素材。先看看数据本身长什么样。
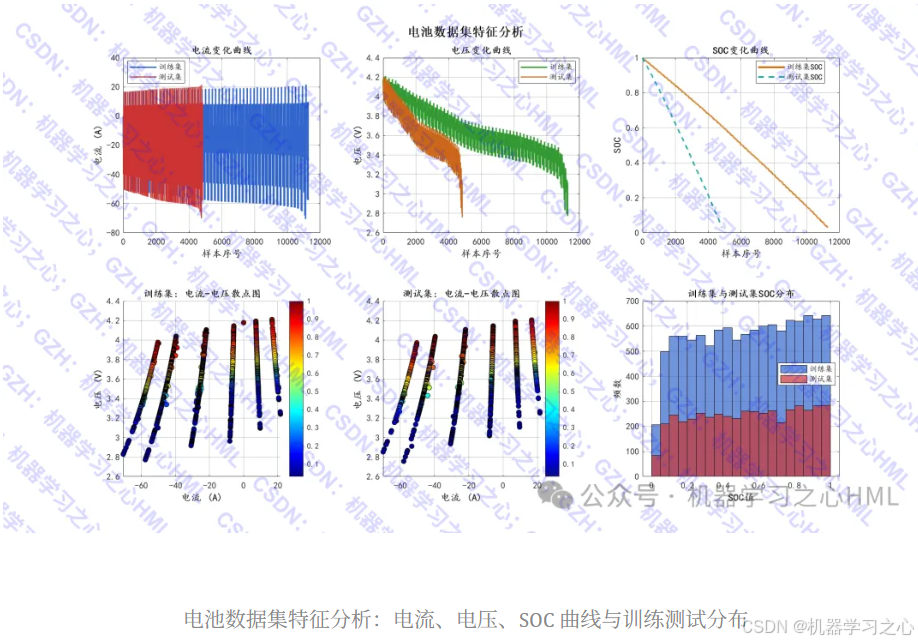
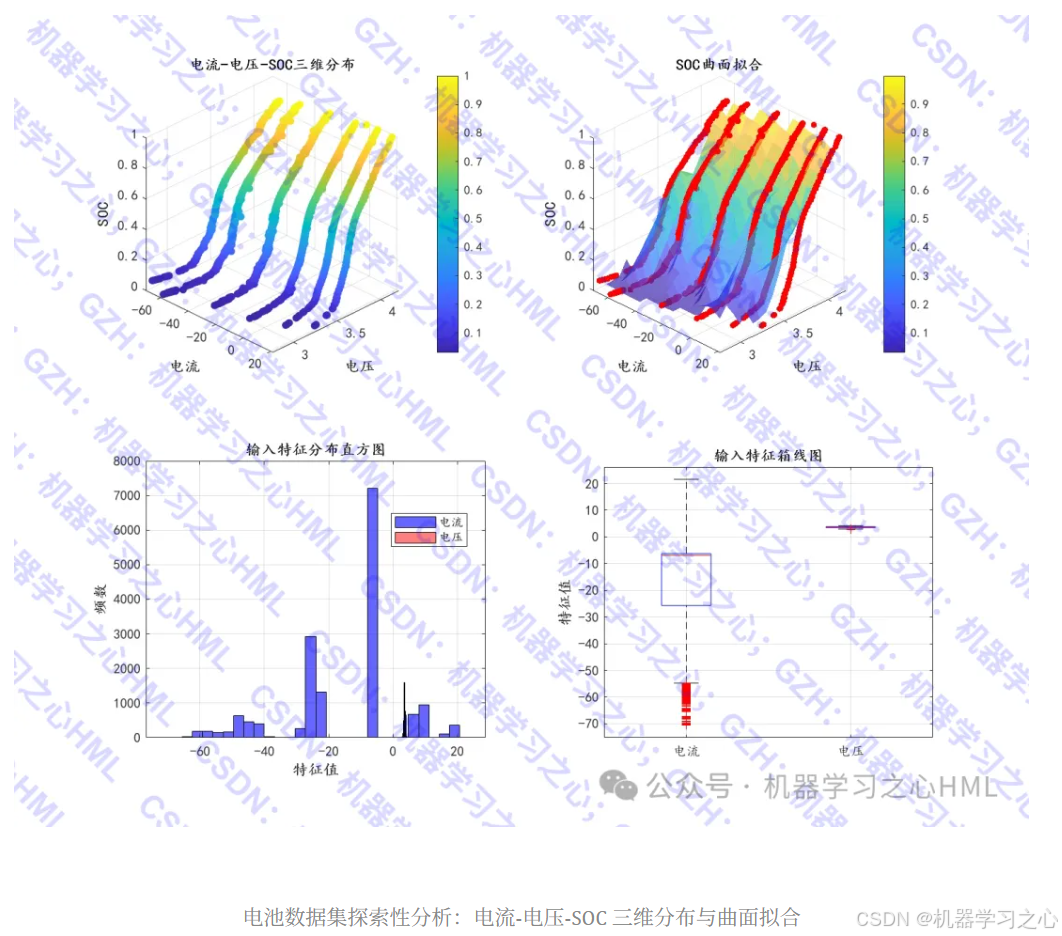
电流在 -60 A 到 +20 A 之间来回跳,电压从 4.2 V 单调下探到 2.7 V,SOC 线性滑落。右下角那张散点图值得多看两眼------同样的电压、同样的电流,SOC 可以落在完全不同的位置。这说明单点映射是行不通的,必须把时间上下文一起喂进去。窗口长度选 32 秒,正是从这张图上得到的直觉。
03 公式原理:三条方程撑起整个模型
这一节是全文的核心。整个模型只有三条方程,但它们的配合方式才是 PINN 的精髓。
方程一:库仑计数(电荷守恒)
电池的 SOC 变化,来自于流过它的电荷。写成微分形式:
dSOCdt=η⋅ICn\frac{dSOC}{dt} = \frac{\eta \cdot I}{C_n}dtdSOC=Cnη⋅I
离散到 1 秒的时间步上,就变成了相邻两点的差分关系:
ΔSOCk=SOCk+1−SOCk=η⋅Ik⋅dtCn\Delta SOC_k = SOC_{k+1} - SOC_k = \frac{\eta \cdot I_k \cdot dt}{C_n}ΔSOCk=SOCk+1−SOCk=Cnη⋅Ik⋅dt
这条方程的意义是:它规定了 SOC 相邻两点的变化量必须由这一段电流唯一决定。 网络可以自由预测绝对方程的常数项,但"两点之间走了多远"这件事被方程锁死了。
实现上,损失函数直接对这个差分做均方误差,而不是对积分做------这一点区别很大:
matlab
dSOC_pred = SOC_pred(:,:,2:end) - SOC_pred(:,:,1:end-1);  % 网络预测的逐步变化
dSOC_phys = eta .* I_raw(:,:,2:end) .* dt ./ Cn;          % 物理定律给出的逐步变化
lossCoul = mse(dSOC_pred, dSOC_phys);用逐步残差而不是整体积分残差,是因为差分约束是逐点的、密集的,梯度信号能落到每一个时间步上;而积分残差会在一段窗口内相互抵消,约束反而变松。这是一个很容易被忽略、但非常影响收敛效果的工程细节。
方程二:等效电路端电压
电池的端电压,可以拆成"开路电压"加上"内阻压降"两部分:
V=OCV(SOC)+R0⋅IV = OCV(SOC) + R_0 \cdot IV=OCV(SOC)+R0⋅I
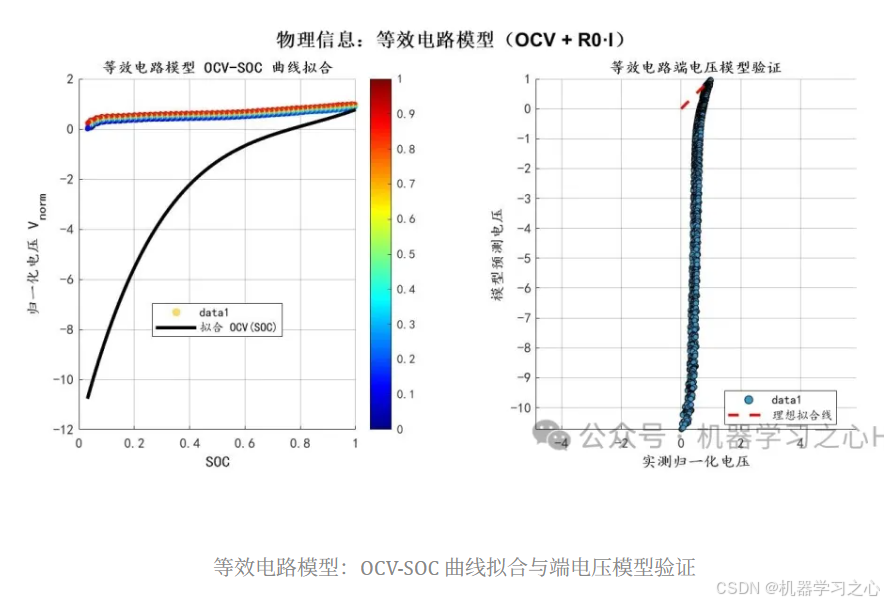
开路电压本身是 SOC 的函数,代码里用 6 阶多项式去逼它:
OCV(SOC)=∑k=0pck⋅SOCk,p=6OCV(SOC) = \sum_{k=0}^{p} c_k \cdot SOC^k, \quad p = 6OCV(SOC)=k=0∑pck⋅SOCk,p=6
这条方程的作用是把电压、电流、SOC 三者钉在一起。前一条库仑方程只关心 SOC 与电流的关系,它管不住电压;加上端电压方程后,网络如果乱报一个 SOC,反推出来的电压就会和实测电压对不上,损失立刻升上去。两条方程一横一纵,把解空间夹紧了。
一次最小二乘就把七个多项式系数和一个内阻同时解了出来,构造矩阵的写法也很简洁:
matlab
A_fit = zeros(num_samples, p_ocv + 2);
for k = 0:p_ocv
    A_fit(:, k+1) = soc_true.^k;      % OCV 多项式基
end
A_fit(:, p_ocv+2) = I_norm;           % 内阻项
coeff_fit = A_fit \ V_norm;           % 一次性解出 [c0..c6, R0n]
辨识出来的 OCV 曲线和端电压验证结果如下。端电压散点几乎严丝合缝地贴在理想拟合线上,说明这个二阶结构的等效电路模型对当前数据集是够用的。
方程三:三项复合损失
把数据损失和两条物理约束加权加在一起,就是最终的优化目标:
L=1N∑(SOCpred−SOCtrue)2⏟数据损失+λcoul1N∑(ΔSOCpred−ηIΔtCn)2⏟库仑损失+λocv1N∑(OCV(SOCpred)+R0nInorm−Vnorm)2⏟电压损失\mathcal{L} = \underbrace{\frac{1}{N}\sum \left(SOC_{pred} - SOC_{true}\right)^2}{\text{数据损失}} + \lambda{coul}\underbrace{\frac{1}{N}\sum \left(\Delta SOC_{pred} - \frac{\eta I \Delta t}{C_n}\right)^2}{\text{库仑损失}} + \lambda{ocv}\underbrace{\frac{1}{N}\sum \left(OCV(SOC_{pred}) + R_{0n}I_{norm} - V_{norm}\right)^2}_{\text{电压损失}}L=数据损失 N1∑(SOCpred−SOCtrue)2+λcoul库仑损失 N1∑(ΔSOCpred−CnηIΔt)2+λocv电压损失 N1∑(OCV(SOCpred)+R0nInorm−Vnorm)2
这里有个设计上的巧思,值得单独说一句。三项损失的权重是 5.0 和 1.0,量级都是 O(1),没有做任何精细调参------因为 SOC 本身就在 0,1,电压也被归一化到 0,1,三项损失天然落在同一个量级上。很多 PINN 实现里物理项和数据项差好几个数量级,得反复配权重,甚至上自适应权重;这里通过量纲对齐直接绕开了这个坑。
还有两处把物理先验写进结构的地方:
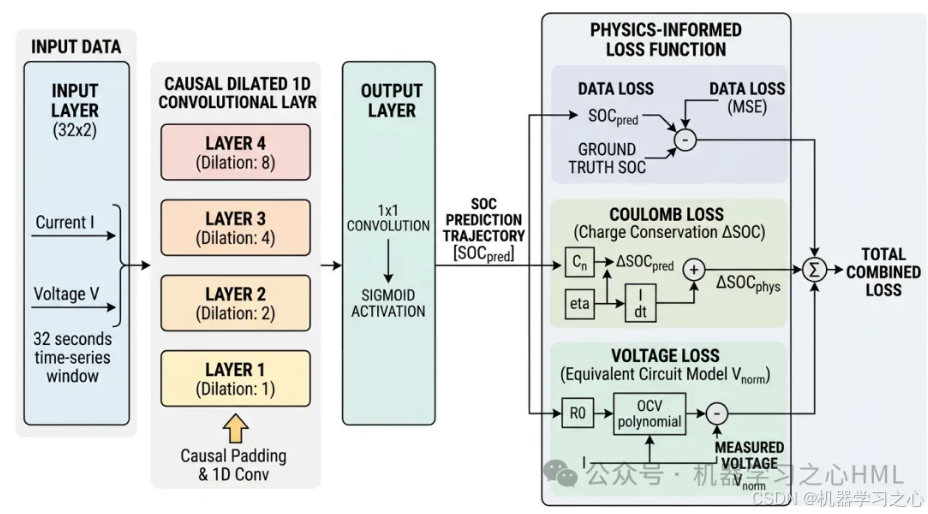
- 输出层用 sigmoid,SOC 被硬性夹在 (0,1) 之内。这是结构层面的物理约束,网络再疯也报不出 1.3 的 SOC。
- 卷积用 causal 填充 ,左侧补零、右侧不补,配合逐层递增的空洞率,保证任何时候都只看过去、不看未来。
第二点对工程落地非常重要。如果是普通 same 填充,第 t 个输出会看到第 t+1、t+2 时刻的输入,训练指标会非常好看,但那是信息泄漏,一旦上车实时推算就崩了。用因果卷积,训练时和部署时的信息边界完全一致。
网络结构与感受野
四层卷积的空洞率依次是 1、2、4、8,核长都是 3。感受野的算法是:
R=1+2×(1+2+4+8)=31R = 1 + 2 \times (1 + 2 + 4 + 8) = 31R=1+2×(1+2+4+8)=31
这个数字刚好和窗口长度 32 咬合。也就是说,网络上最后一层的每个输出点,恰好能看到整个输入窗口的全部历史。 设计上不需要再加深,也不用加池化或注意力,四层就精确够用了。
空洞卷积的好处也在这里:要在不增加参数和计算量的前提下把感受野从 8 撑到 31,靠的就是"卷积核之间插零"。参数还是 3×3,看到的历史却翻了近四倍。
04 算法步骤
按执行顺序过一遍,每一步都能对上代码。
第一步,数据加载与重采样。 读入 BBDST25.xlsx,每 10 行抽 1 行,得到 16107 个样本、时间步长 1 秒。这一步把原始数据的高频冗余压掉了,同时把 dt 规整成整数。
第二步,物理参数辨识。 这是最有"做题感"的一步。先用放电段电量积分除以 SOC 跌幅算出容量;再从全段 SOC 变化与电流积分的关系反解库仑效率,并把它夹在 0.90, 1.00 这个物理合理区间内防止数值异常;最后用最小二乘一次解出 OCV 多项式和内阻。三个参数的辨识逻辑各不相同的物理含义,不是同一个套路套三遍。
第三步,特征归一化。 电流和电压各做 Min-Max 归一化。这一小步是后面损失权重能保持 O(1) 的前提。
第四步,滑窗构造。 用向量化索引一次性铺出所有窗口,避免循环。窗口总数 = 16107 − 32 + 1 = 16076,训练集 11253 个(70%),测试集 4823 个(30%)。
第五步,网络构建。 输入层 → 四组「因果空洞卷积 + 层归一化 + ReLU」→ 1×1 卷积降维 → sigmoid 输出。共 15 层。
第六步,自定义训练循环。 这是全篇代码结构上最关键的一点------没有用 trainNetwork,而是手写 dlfeval + adamupdate 循环 。因为损失函数里含有对网络输出的差分运算、以及外部的物理参数,这些没法塞进标准的 trainingOptions 流程里。自定义循环把每一步的梯度都显式算出来:
顺带把三项损失分开记录,训练时就能看出是哪一项在主导收敛、哪一项在拖后腿。
第七步,评估与可视化。 训练集和测试集分别算 RMSE、MAE、R²、MAPE,再画拟合散点、误差分布、误差 ECDF,最后单独验证物理一致性。
05 训练过程:三项损失各自在干什么
训练损失曲线是理解 PINN 行为最直观的窗口。
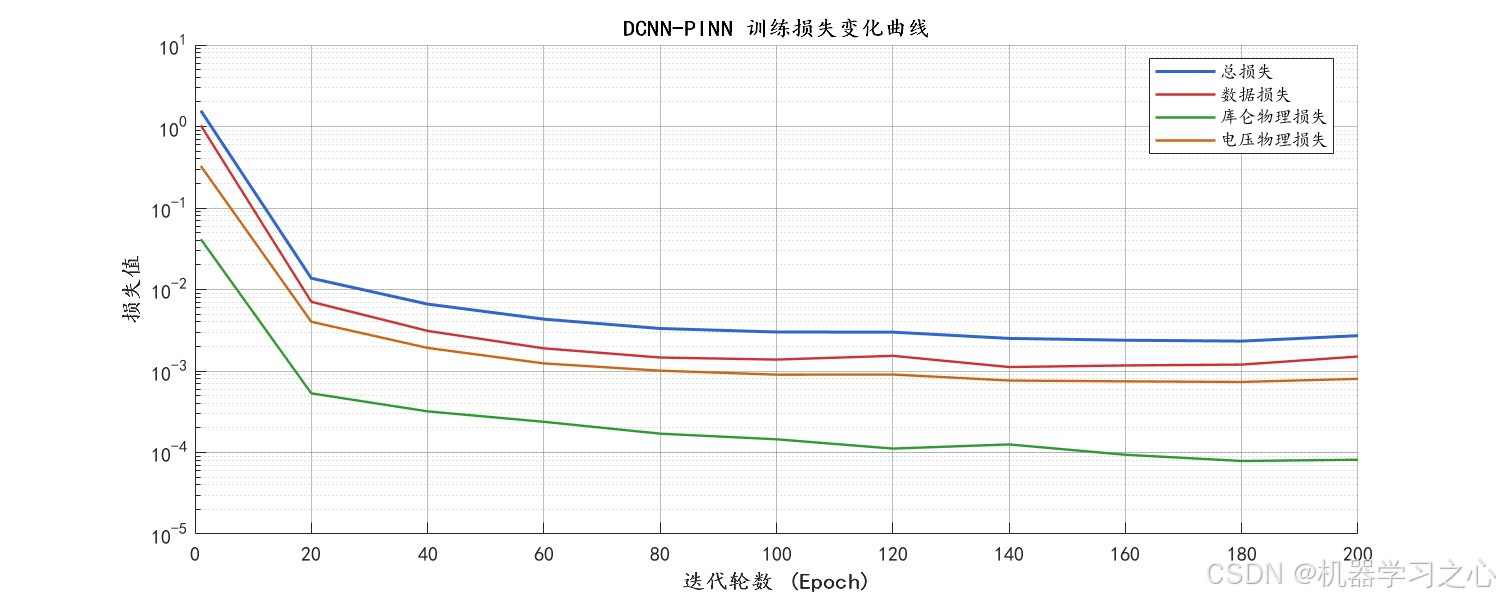
第一轮总损失 1.5647,到第 200 轮降到 0.0027,两个数量级半。
值得看的是三条分量曲线的相对位置和下降节奏 。库仑损失(绿色)从一开始就是最低的,起步就比数据损失低两个数量级,最后落到 8e-5 附近。这说明什么?库仑约束几乎是"免费"的------因为电流序列本身就是 SOC 变化的最好证据,网络只要稍微配合一下就能满足它。
真正决定精度的是数据损失(红色),从 1.0301 一路磨到 0.0015,它是整个过程的主角。电压损失(棕色)从 0.3275 降到 0.0008,走势和数据损失基本同步,说明端电压方程和数据标签之间是自洽的,没有互相打架。
第 120 到 140 轮之间总损失出现过小幅抖动(0.0030 附近震荡了几轮),第 200 轮甚至比第 160 轮略高。这是 mini-batch 训练的正常波动,也提示200 轮这个量级基本已经收敛到位,再加轮数收益有限。从时间成本看,200 轮跑了 5 分 46 秒,整段程序含全部可视化合计 369 秒,一台普通笔记本就够。
06 结果:误差不到 0.8 个 SOC 百分点
先上数字。
| 指标 | 训练集 | 测试集 |
|---|---|---|
| 均方根误差 RMSE | 0.0078 | 0.0078 |
| 平均绝对误差 MAE | 0.0062 | 0.0063 |
| 决定系数 R² | 0.9992 | 0.9992 |
| 平均绝对百分比误差 MAPE | 2.69% | 2.75% |
RMSE 0.0078,换算过来就是 SOC 平均偏差不到 0.8 个百分点 。而且训练集和测试集几乎一模一样------RMSE 完全相同、R² 完全相同、MAE 只差 0.0001。这个"太一致"本身就是信息:说明模型没有过拟合,泛化能力和拟合能力被打平了。
预测曲线拉出来看更直观。
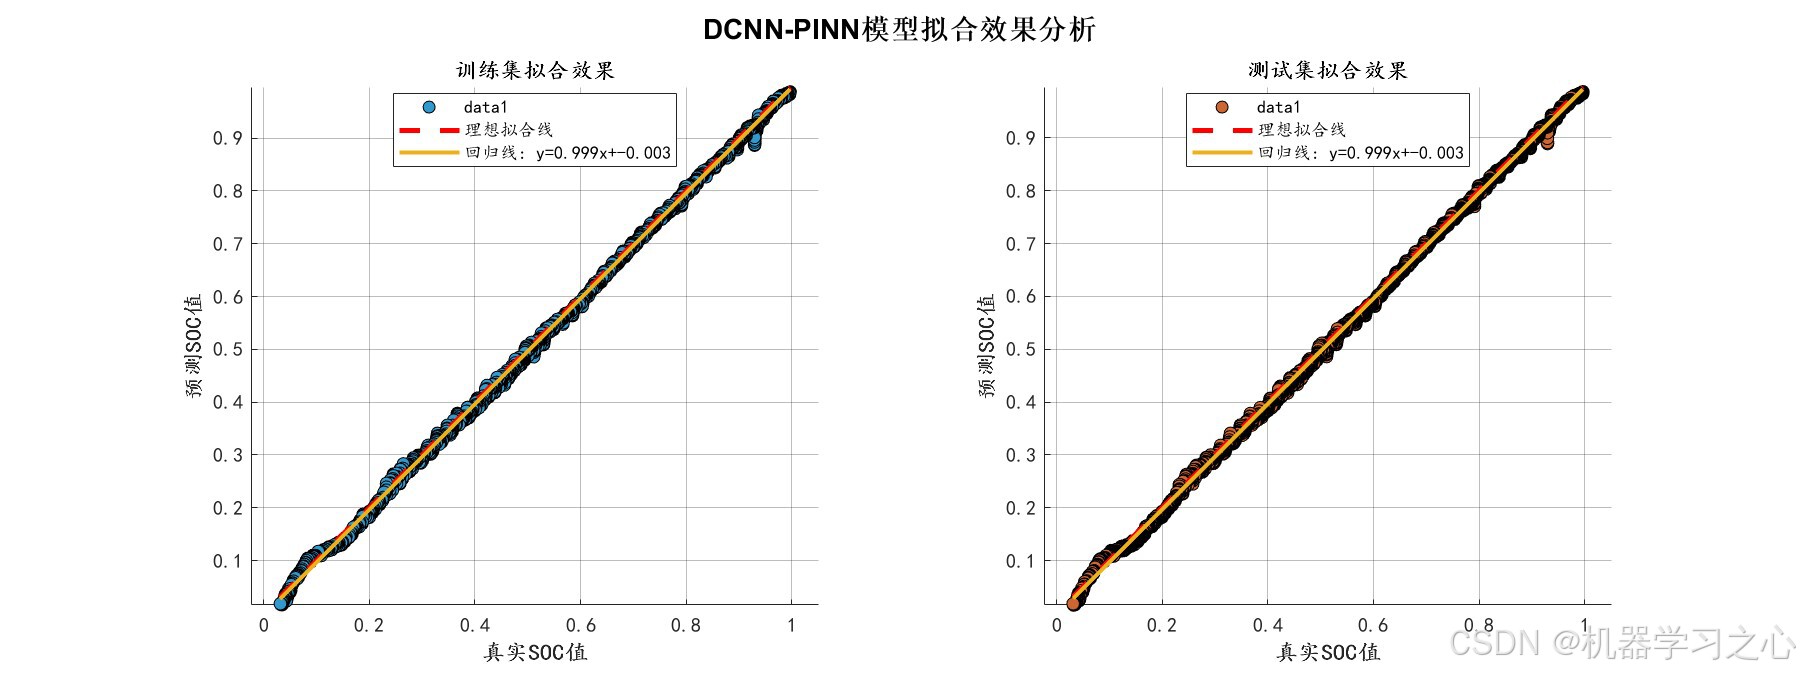
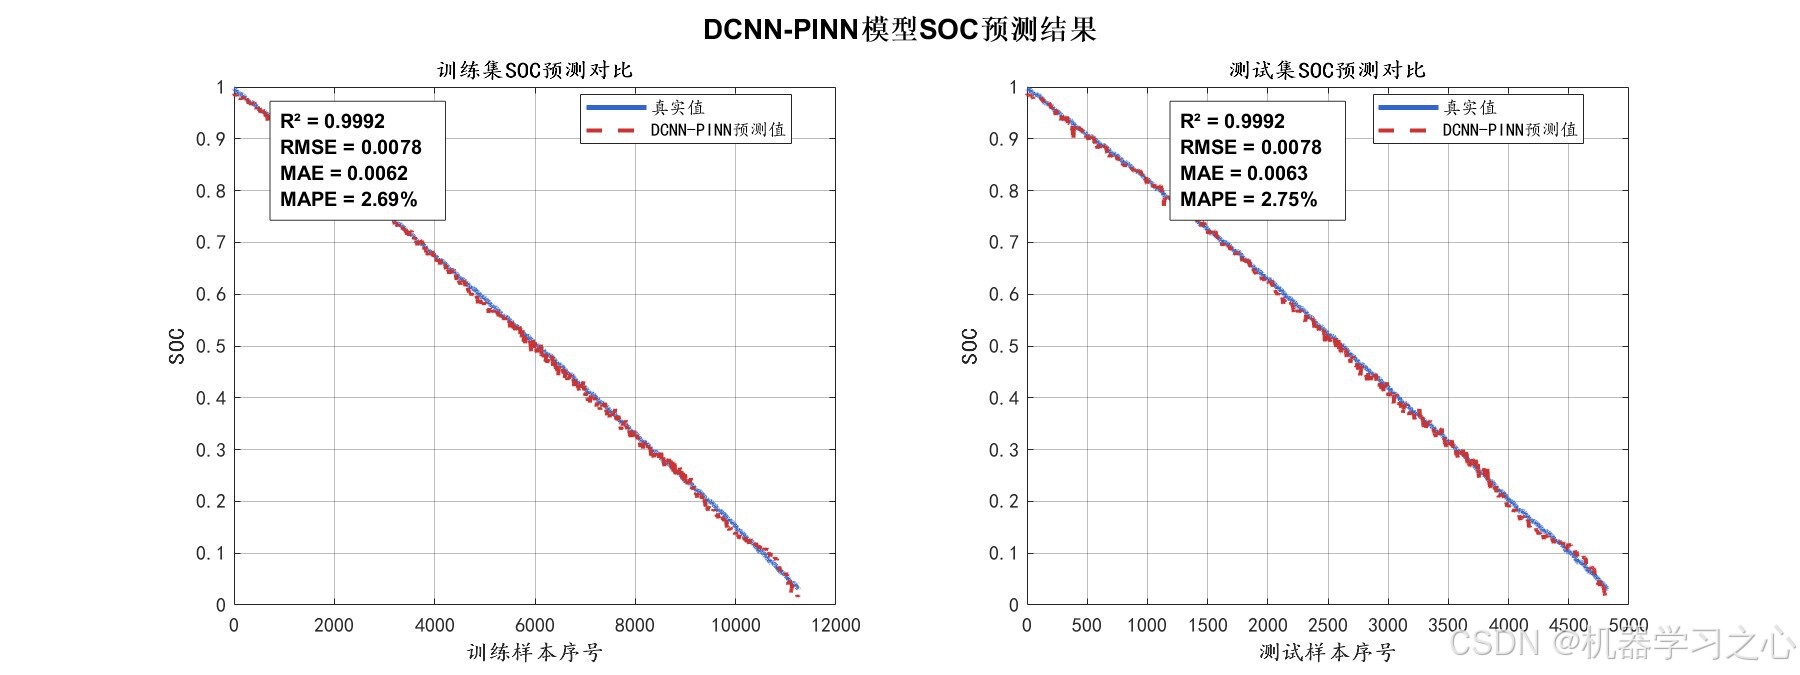
训练集和测试集的回归线都是 y = 0.999x + 0.003,斜率几乎就是 1,截距几乎就是 0。也就是说,预测值和真实值之间是一个近乎完美的恒等映射,没有系统性的放大、缩小或偏移。散点紧紧贴在 45° 理想线上,全程 SOC 从 1 到 0.03 都没有出现明显的块状偏离。
误差分布也支持这个判断。
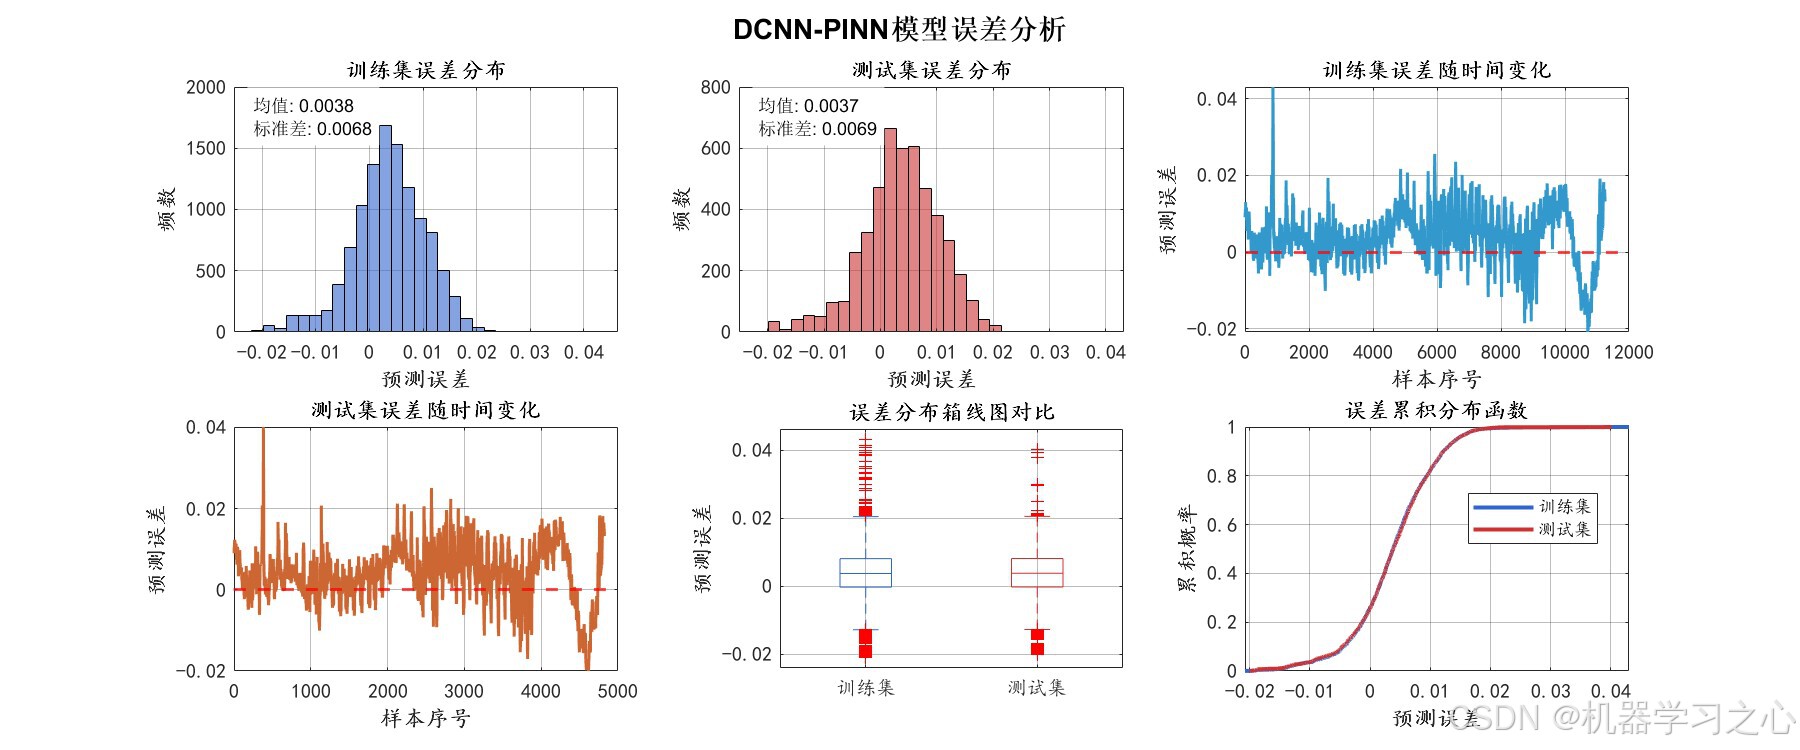
训练集误差均值 0.0038、标准差 0.0068;测试集均值 0.0037、标准差 0.0069。均值贴近零,说明没有系统性偏置------模型不是在"一直高估"或"一直低估",而是围绕真值小幅抖动。ECDF 曲线(右下)训练集和测试集几乎重合,也印证了分布的一致性。
误差随时间变化的图(上排两侧)里有细节:两侧端点附近的误差包络明显张开。这对应的是滑窗的边界效应------窗口初始阶段上下文不足,以及 SOC 两端(OCV 平台区、陡降区)本身的可辨识性较差。这是窗口类方法的一个共性弱点,不是这个模型独有的。
07 一个必须诚实说的现象
前面都是好看的数字,但我想把一张图单独拎出来讲,因为它是这个方案真正的软肋。
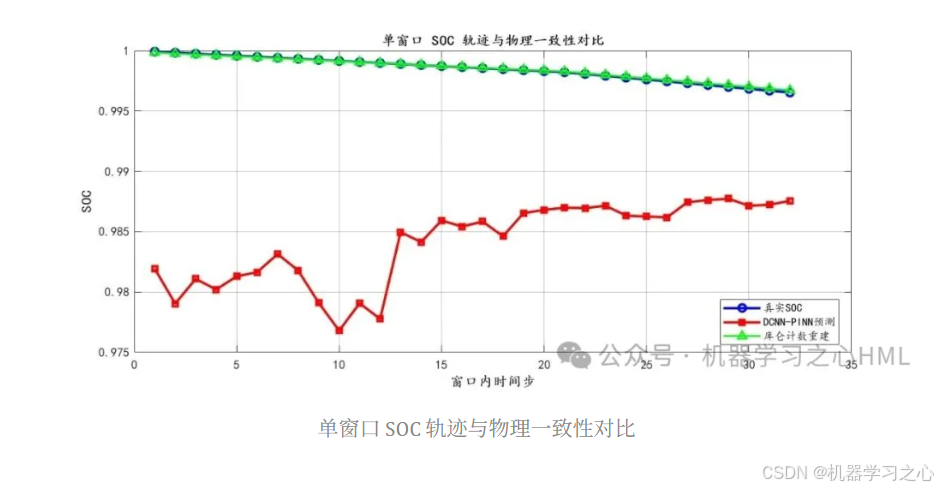
这张图取了测试集里的一个窗口,把三条线画在一起:蓝色是真实 SOC,绿色是库仑计数重建,红色是 DCNN-PINN 的预测。
看蓝色和绿色------几乎完全重合,库仑重建在 32 秒内跟着真值从 1.0000 平滑滑到 0.9970,物理一致性非常好。再看红色:整条曲线整体下沉了大约 0.01 左右,明显偏低,但走势方向和蓝绿两条是同步的。
为什么会出现这种偏差?原因在于模型看到的输入只有窗口内的电流和电压,它拿不到这个窗口起始时刻的绝对 SOC。它只能从 I/V 片段去推断"我现在大概在什么水平"。窗口内的"变化量"被库仑损失牢牢钉住了,但"绝对锚点"只能靠端电压反推------而在 SOC 接近满电的区间,OCV 曲线非常平坦,电压差几个毫伏就能对应 SOC 一大片,绝对定位精度自然就下去了。
这个现象其实点出了一条很实用的改进方向:工程上应该给网络加一个绝对锚点,比如把上一时刻的 SOC 估计值作为额外输入通道回灌,或者直接改成残差学习------让网络只学"相对于库仑积分的修正量"。这样绝对水平交给积分、趋势细节交给网络,两者的优势才能叠加。
我把这一点写出来,是因为技术文章最容易犯的毛病是把结果往好里说。R² 0.9992 是真的,单窗口的绝对偏差也是真的,两件事同时成立。
08 参数设定一览
全部可调参数集中列在这里,方便复现时对照。
| 类别 | 参数 | 取值 |
|---|---|---|
| 数据 | 重采样方式 | 每 10 行取 1 行,等效 dt = 1 s |
| 数据 | 总样本数 | 16107 |
| 数据 | 训练 / 测试划分 | 70% / 30%(窗口级随机) |
| 物理 | 电池容量 Cn | 77.72 Ah |
| 物理 | 库仑效率 η | 1.00(限幅在 0.90, 1.00) |
| 物理 | 等效欧姆内阻 R0 | 0.00390 Ω |
| 物理 | OCV 多项式阶数 | 6 |
| 网络 | 输入特征 | 电流 I、电压 V(2 通道) |
| 网络 | 滑动窗口长度 | 32(= 32 s) |
| 网络 | 卷积核数 / 核长 | 32 / 3 |
| 网络 | 空洞率序列 | 1 → 2 → 4 → 8 |
| 网络 | 等效感受野 | 31 |
| 网络 | 输出层 | 1×1 卷积 + sigmoid |
| 损失 | 库仑权重 λ_coul | 5.0 |
| 损失 | 电压权重 λ_ocv | 1.0 |
| 训练 | 优化器 / 初始学习率 | Adam / 1e-3 |
| 训练 | mini-batch 大小 | 512 |
| 训练 | 训练轮数 | 200 |
有一处参数选择值得多说一句:λ_coul 给到 5.0,明显高于 λ_ocv 的 1.0。这不是随手填的------库仑约束是"逐点密集"的,一个窗口内它一次约束 31 个差分关系;而电压约束虽然也逐点,但它受 OCV 平台区不敏感性的影响,单独依赖它定不了绝对水平。给库仑项更高权重,本质上是让网络优先把"轨迹形状"学对,再让电压项去校准绝对位置。
09 运行环境
| 项目 | 说明 |
|---|---|
| 平台 | MATLAB2024b |
| 核心工具箱 | Deep Learning Toolbox |
| 关键 API | dlnetwork、dlarray(CBT 格式)、dlfeval、dlgradient、adamupdate |
| 序列层特性 | convolution1dLayer 的 Padding="causal" 与 DilationFactor |
| 数据文件 | BBDST25.xlsx |
| 硬件 | 普通 CPU 即可,无需 GPU |
| 耗时 | 200 轮训练约 5 分 46 秒,全流程(含出图)约 369 秒 |
需要注意一点:代码用的是自定义训练循环加因果空洞卷积这套组合,涉及 dlnetwork、dlgradient 以及序列卷积层的 causal 填充参数,建议在较新的 MATLAB2024b 版本上运行 (causal 填充与空洞卷积是相对较新的序列层特性)。如果版本偏旧,可以把 Padding 手动改成向量形式的左填充,效果等价,只是写法会啰嗦一些。
另外,代码里没有任何深度学习之外的第三方依赖,数据读取走 xlsread,绘图全部用 MATLAB 原生函数(图注字体设为楷体,这是为了让中文标签正常显示)。整体是一个自包含的单机脚本,文件结构就两个:main.m 和 modelLoss.m。
10 这套方案用在哪
最后聊聊应用场景,也是很多人关心的"这玩意儿到底能干嘛"。
车载 BMS 的 SOC 在线估计。 这是最直接的目标场景。因果卷积保证了只依赖历史数据,实时性好;自定义训练循环的推理成本也很低,一次前向就能吐出整段窗口的 SOC 轨迹。
储能电站的电池簇状态监控。 储能堆里电池数量多、工况相对规整,正好适合这种"物理参数从数据辨识 + 神经网络做估计"的路线。尤其是容量和内阻这两个参数,程序里是自动辨识的,天然适合做健康状态(SOH)的旁路监测。
实验台架的数据校正。 测试设备记录的 SOC 往往来自安时积分,初值不准,长时间测试后漂移明显。用这套模型对历史数据做一遍回溯校正,成本很低。
物理信息学习的教学范例。 说白了,这份代码也是一个很干净的 PINN 入门模板:三条方程、三项损失、一个自定义训练循环,结构足够简单,但机制完整。想从纯数据驱动跨到物理约束建模,从这类案例切入比啃综述论文要快得多。
再往远看一层。SOC 估计这件事的演进很能说明问题:从"只用物理公式"到"只用数据",再到现在"让数据拟合、让物理兜底"。纯物理模型的瓶颈是参数不准、工况太复杂;纯数据模型的瓶颈是不讲理、外推就崩。把物理写成损失函数里的软约束,本质上是让两者各管一半。 这个思路不止能用在电池上,凡是"有明确守恒律或动力学方程、但参数难以精确标定"的估计问题,都能套。
写在最后
这篇是对代码和实测结果的整理,所有图表均由文中的 MATLAB 代码直接生成,指标数值取自程序的实际运行输出,没有做任何修饰。
R² 0.9992 是个漂亮的结果,但更值得记住的是那条"只差 0.8 个百分点"背后的事:误差之所以能被压住,不是因为网络多深、参数多密,而是因为网络从被训练的那一刻起,就知道自己估的是一个必须守电荷守恒的物理量。
模型可以很复杂,但只要它讲道理,就比一个纯粹聪明的黑箱更值得信任。
下一篇会在这个基础上,把绝对锚点的问题解决掉------用库仑积分做主干、神经网络做修正量的残差结构,看看能不能把单窗口那个系统性偏移也吃掉。
本文图表由 MATLAB 代码生成,数据源为 BBDST 动态工况电池测试数据。