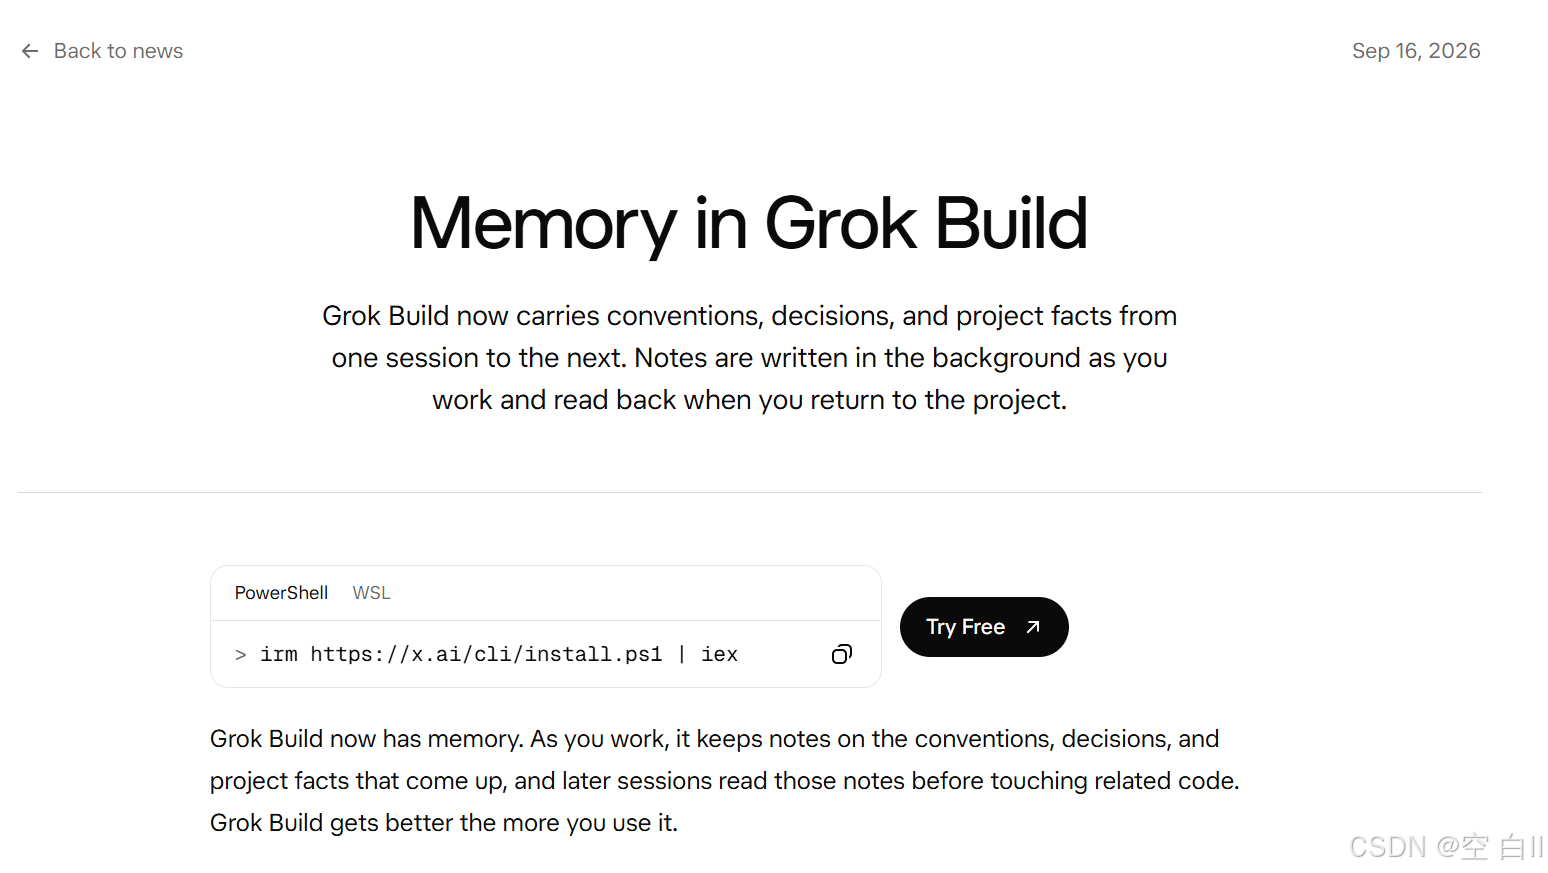
Grok Build 在北京时间2026 年 9 月 17 日 03:00发布了正式的跨对话记忆 Agent ,原文链接为
根据官方描述:
Grok 可以在用户工作时,记录遇到的约定、决策和项目相关信息,并在后续会话中读取这些记录后再修改相关代码。Grok Build 使用得越多,性能就越好。
那么它记住了什么呢?根据官方的文档:
内存中保存着后续会议中最可能重要的细节:团队如何编写和审查代码、决策及其背后的原因,以及关于项目的持久性事实,例如子系统的位置以及运行套件的命令。任务状态、初步结论、机密信息以及代码库或其文档中已涵盖的内容均不包含在内存中。
每个项目都会保存备注,此外还有一个全局设置,用于保存适用于所有项目的偏好设置。
此外,根据文档内容:
捕获功能会在回合结束后运行,并且不会阻塞会话。Grok 会回顾已完成的回合,将任何值得保留的内容记录为 Markdown 笔记,然后继续执行。随着时间的推移,/dream 会将这些笔记整理成主题文件,每个主题一个文件,因此每个项目最终都会得到一套整理好的参考资料。
当用户返回某个项目时,Grok 会读取与即将处理领域相关的主题。当前对话中的指令优先于笔记中的任何内容。
在日常的 AI 使用中,openAI 以及 deepseek 其实也有记忆功能,那么它们和 grok 的有什么不同呢?
首先,这三家的Memory策略其实并不处于同一个系统层级。
如果用认知系统来类比,可以简单理解为:
- DeepSeek:Working Memory(工作记忆)
重点是如何让模型高效保留和处理超长上下文。 - xAI Grok Build:Project Memory(项目长期记忆)
重点是从工作过程中提取值得长期保存的项目知识。 - OpenAI:Long-term Memory / User Model(长期记忆 / 用户状态模型)
重点是跨会话整合用户偏好、长期项目和历史状态。
因此,它们并不是三种实现同一目标的方法,而是在解决三个不同的问题。
| 维度 | xAI Grok Build Memory | OpenAI Memory / Context Compaction | DeepSeek |
|---|---|---|---|
| 核心目标 | 记住项目知识和工程约定 | 维持跨上下文或跨会话的长期状态 | 高效保存超长上下文 |
| 典型记忆内容 | 测试命令、代码规范、架构决策、项目事实 | 用户偏好、历史信息、任务摘要、长期状态 | Token 对应的 KV / Attention 状态 |
| 跨 Session | 支持 | 支持 | 主要不是语义型跨 Session Memory |
| 记忆生成方式 | Agent 主动判断"什么值得记住" | 后台总结、压缩或整合历史信息 | 自动缓存和压缩上下文状态 |
| 存储形式 | Markdown Topic Files | Summary / Memory State | KV Cache、Latent KV、Context Cache |
| 主要优势 | 可读、可编辑、可审计 | 能整合长期历史信息 | 高保真、低推理成本 |
| 主要问题 | Memory Poisoning、错误长期固化 | 错误摘要、过期信息、来源不透明 | "保存上下文"不等于"真正长期记忆" |
xAI Grok Build:Memory as Documents
Grok Build 的设计非常接近一个由 Agent 自动维护的长期知识库。
基本流程可以表示为:
text
Raw Interaction
      ↓
Memory Extraction
      ↓
Observations
      ↓
Consolidation (/dream)
      ↓
Topic Files
      ↓
Selective Retrieval
      ↓
Future Session
例如,在一个软件项目中,Grok 可能逐渐形成:
text
memory/
├── testing.md
├── code-style.md
├── architecture.md
└── deployment.md
其核心思想是:
不保存完整历史,而是把历史交互压缩成以后仍然有价值的项目知识。
优点
1. 可解释性高
Memory 本身是显式文件,用户可以直接查看 Agent 到底记住了什么。
2. 可审计
如果 Agent 以后产生异常行为,可以检查对应 Memory 文件。
3. Scope 清晰
可以区分:
text
Project Memory
Global Memory
因此不同项目之间不必共享全部长期状态。
4. 非常适合 Coding Agent
软件工程中的很多长期知识本身就是结构化的,例如:
text
Build commands
Testing conventions
Architecture decisions
Coding style
Deployment procedures
Known pitfalls
这些信息很适合保存成显式文档。
缺点
最大问题在于:
Agent 自己决定什么值得记住。
因此可能出现:
text
一次错误判断
      ↓
写入 Memory
      ↓
被 Consolidation 成长期事实
      ↓
未来 Session 持续读取
      ↓
错误长期固化
其他模型中的幻觉通常会随着上下文消失,而这种 持续记忆下下的错误可能持续数周甚至数月。
OpenAI:Memory as an Evolving State
OpenAI 的思路更偏向:
把过去大量交互压缩成一个持续变化的用户或任务状态模型。
一个简化结构是:
text
Conversation 1 ─┐
Conversation 2 ─┤
Conversation 3 ─┤
Conversation 4 ─┼──→ Memory Consolidation
...              │
Conversation N ─┘
                         ↓
                Long-term Memory
                         ↓
                Relevant Retrieval
                         ↓
                    New Session
相比 Grok 的"Memory as Documents",OpenAI 更像:
text
Memory as an Evolving User / Task Model例如用户曾经说:
text
I will travel to Singapore in July.几个月以后,合理的长期状态不应该仍然是:
text
User will travel to Singapore.而应该更新为类似:
text
User traveled to Singapore in July 2026.因此 OpenAI 的长期 Memory 更强调:
text
Update
Contradiction Resolution
Temporal Validity
Relevance
Forgetting
优点
1. 能整合大量历史信息
不是简单保存聊天记录,而是从多次对话中抽取长期稳定的信息。
2. 更适合 General Assistant
用户长期状态通常不像代码项目那样结构化,例如:
text
Research interests
Writing preferences
Long-term projects
Travel history
Work habits
Interaction preferences
这类信息更适合动态整合。
3. 可以处理信息随时间变化的问题
真正的长期 Memory 必须处理:
text
旧事实
    ↓
新证据
    ↓
更新 / 覆盖 / 修正
缺点
主要问题是 Provenance(来源可追溯性)较弱。
当系统说:
text
I remember that you prefer X.这个结论可能来自过去很多次对话的综合,而不是某一条明确记录。
此外还存在:
text
错误用户画像
过期 Memory
错误 Consolidation
Memory Poisoning
等风险。
OpenAI Context Compaction:另一种 Memory
OpenAI 在 Agent 场景中还有另一类非常重要的 Memory:
Context Compaction / Summary Memory
它解决的问题不是:
text
"几个月以后还能不能记住?"而是:
text
"一个任务已经超过上下文窗口了怎么办?"基本流程是:
text
Long Context
     ↓
Compaction
     ↓
Summary
     ↓
New Context Window
     ↓
Continue Task
这实际上是一种:
Compressed Episodic Memory
但它也暴露出非常典型的安全问题。
例如:
text
Model(t)
   ↓
生成错误 Summary
   ↓
Summary 被带入下一阶段
   ↓
Model(t+1) 将其视为事实或指令
因此错误可能跨上下文窗口持续传播。
这也是 OpenAI 最近披露的模型失配案例中值得关注的问题之一。
DeepSeek:Memory as Efficient Context
DeepSeek 当前公开技术路线中,"Memory"的重点明显不同。
它主要解决的是:
如何让模型能够处理非常长的 Context,同时降低 KV Cache 的存储和推理成本。
例如 MLA(Multi-head Latent Attention)的核心思想之一,就是压缩传统 Attention 中需要缓存的 K/V 状态。
传统模型大致是:
text
Token
  ↓
Key
Value
  ↓
KV Cache
而 MLA 更接近:
text
Token
  ↓
Compressed Latent Representation
  ↓
Recover K / V when needed
因此 DeepSeek 的 Memory 更接近:
Efficient Working Memory
而不是:
Persistent Semantic Memory
DeepSeek 的 Context Cache
DeepSeek 还有 Context Caching。
例如连续两个请求:
text
SYSTEM
+ 100K Token Document
+ Question A
以及:
text
SYSTEM
+ 100K Token Document
+ Question B
其中前面的大段 Prefix 完全相同。
那么第二次请求可以直接使用之前缓存的状态:
text
Repeated Prefix
      ↓
Context Cache
      ↓
Cache Hit
      ↓
Only Compute New Tokens
这种方式能够显著降低:
text
Prefill Cost
Latency
KV Computation
Serving Cost
但它并没有真正回答:
"这个事实是否值得半年以后仍然记住?"
因此:
text
Context Cache ≠ Semantic Memory用一个例子理解三者区别
假设用户告诉模型:
在这个机器人项目中,所有旋转矩阵都统一采用 Body-to-World 的惯例
Grok Build
可能直接写进:
markdown
## Coordinate Conventions

All rotation matrices use the body-to-world convention.
以后进入这个项目的新 Session,可以重新读取。
OpenAI
更可能把它整合为长期项目状态:
text
User's robotics project uses the body-to-world
rotation convention.
以后相关对话时再召回。
DeepSeek
只要这句话仍然存在于:
text
Current Context或者对应 Prefix 仍然能够 Cache Hit,那么模型就能够继续使用这个信息。
但是 Context 生命周期结束以后,DeepSeek 的 KV / Context Cache 本身并不会自动产生:
text
"This is an important project convention
that should be remembered permanently."
7. 三种路线的核心优缺点
DeepSeek
优点:
- 保留原始上下文,信息 Fidelity 高
- 不需要额外 Memory Extraction
- KV Cache 成本低
- 适合超长 Context
- 工程实现确定性较强
缺点:
- Long Context 不等于 Long-term Memory
- 不能天然解决跨 Session 记忆
- 不解决 Memory Consolidation
- 不解决信息冲突与遗忘
- 1M Context 中的信息也不一定能够可靠 Retrieval
xAI Grok Build
优点:
- 记忆可读
- 记忆可编辑
- 记忆可审计
- 项目视野清晰
- 很适合 Coding Agent
缺点:
- 依赖 Agent 的写入策略
- 错误可能被长期固化
- 可能发生记忆中毒
- 合并本身也可能出现幻觉
OpenAI
优点:
- 能整合大量历史对话
- 适合长期目的维护
- 能维护长期用户或项目状态
- 更适合处理随时间变化的信息
- 可以进行持续合并
缺点:
- 来源不如显式文件容易追踪
- 可能形成错误用户画像
- 记忆更新策略复杂
- 冲突消解很困难
- 同样存在持续幻觉的风险
因此真正的问题不是找回,而是记忆的生命周期
未来 Agent 周期真正困难的问题可能不是:
text
如何召回记忆?而是整个生命周期:
text
  记忆写入
     ↓
  记忆合并
     ↓
  记忆召回
     ↓
  记忆修改
     ↓
末端记忆遗忘
对于一段 Agent 轨迹:
T = { o 1 , a 1 , o 2 , a 2 , ... , o n } T = \{o_1,a_1,o_2,a_2,\dots,o_n\} T={o1,a1,o2,a2,...,on}
记忆系统首先需要学习:
M = f θ ( T ) M=f_\theta(T) M=fθ(T)
其中真正困难的问题是:
轨迹中哪些信息应该成为长期记忆?
之后还需要召回:
M q = g ϕ ( q , M ) M_q=g_\phi(q,M) Mq=gϕ(q,M)
而随着新的信息不断出现,还需要更新:
M t + 1 = h ( M t , E t , t ) M_{t+1}=h(M_t,E_t,t) Mt+1=h(Mt,Et,t)
其中至少涉及:
text
记忆关联
记忆自信
记忆来源
记忆时域验证
记忆矛盾消解
末端记忆遗忘
安全记忆机制
统一的记忆范式
可以把当前大模型记忆技术大致划分为:
text
L0 --- 模型参数中的知识

          ↓

L1 --- 工作记忆
     上下文记忆 / KV Cache
     → DeepSeek 重点优化

          ↓

L2 --- 压缩后的章节记忆
     上下文总结 / 压缩
     → OpenAI Agent 压缩

          ↓

L3 --- 持续的语义记忆
     跨节保存项目或用户事实
     → Grok Build
     → ChatGPT 记忆

          ↓

L4 --- 持续用户 / 世界模型
     动态处理时间、冲突、更新与遗忘
     → OpenAI 长期记忆路线
结论
三家的核心区别可以浓缩成三句话:
DeepSeek:让工作记忆的持续时间更长、更便宜。
xAI Grok Build:把重要项目知识显式写成长期文档。
OpenAI:把大量历史交互持续压缩成动态长期状态。
未来更成熟的 Agent Memory 很可能不是三选一,而是三者融合:
text
DeepSeek-style
高效工作记忆
          +
Grok-style
可检查的项目内存
          +
OpenAI-style
长时记忆巩固
最终形成:
text
    短期上下文
        ↓
    章节式记忆
        ↓
     语义记忆
        ↓
持续记忆 / 世界模型
也就是说,未来真正强大的长期 Agent,不只是需要更大的上下文窗口,而需要一套完整的:
记忆写入 + 记忆合并 + 记忆召回 + 记忆修改 + 末端记忆遗忘 + 安全记忆机制
记忆生命周期机制。