关键词:Python、多线程、HTTP Range、断点续传、wxPython、PyInstaller
本文基于一个真实开源小工具的源码,讲清楚"多线程下载器"到底该怎么写------不只是开几个线程那么简单,真正的难点在于:如何保证暂停后能续传、远程文件变了能察觉、传输中断时半成品永远不会伪装成成品。
一、背景:为什么需要它
本地部署 ComfyUI 玩 Z-Image 文生图,先要下载约 9.7 GB 的文件:
| 文件 | 大小 | 来源 |
|---|---|---|
| ComfyUI Windows 便携版 | 约 1.99 GB | GitHub Releases |
| Z-Image Turbo 主模型(Q4_K_M GGUF) | 约 4.98 GB | Hugging Face |
| Qwen3-4B 文本编码器 | 约 2.38 GB | Hugging Face |
| VAE 解码器 | 约 335 MB | Hugging Face |
浏览器下载这些大文件时,痛点很明显:
- 单连接吃不满带宽,尤其是跨洋访问 GitHub / Hugging Face;
- 网络一抖前功尽弃,断点续传时常失效;
- 多个文件要逐个手动点,保存路径还各不相同(主程序放
D:\,模型要按models/unet、models/vae等目录分门别类)。
于是就有了这个工具:一个带图形界面、支持多任务并行 + 每文件多线程分段 + 可靠暂停续传的下载器,最终打包成双击即用的 exe。
整体代码结构非常克制,核心只有两个文件:
download_core.py   # 下载引擎:纯标准库,不依赖任何 GUI
app.py             # wxPython 桌面界面
把"引擎"和"界面"彻底分开,是这个项目第一个值得称道的决定------核心逻辑可以脱离界面被单测直接调用。
"C:\Users\86182\Desktop\下载文生图zimage模型的工具\app.py"
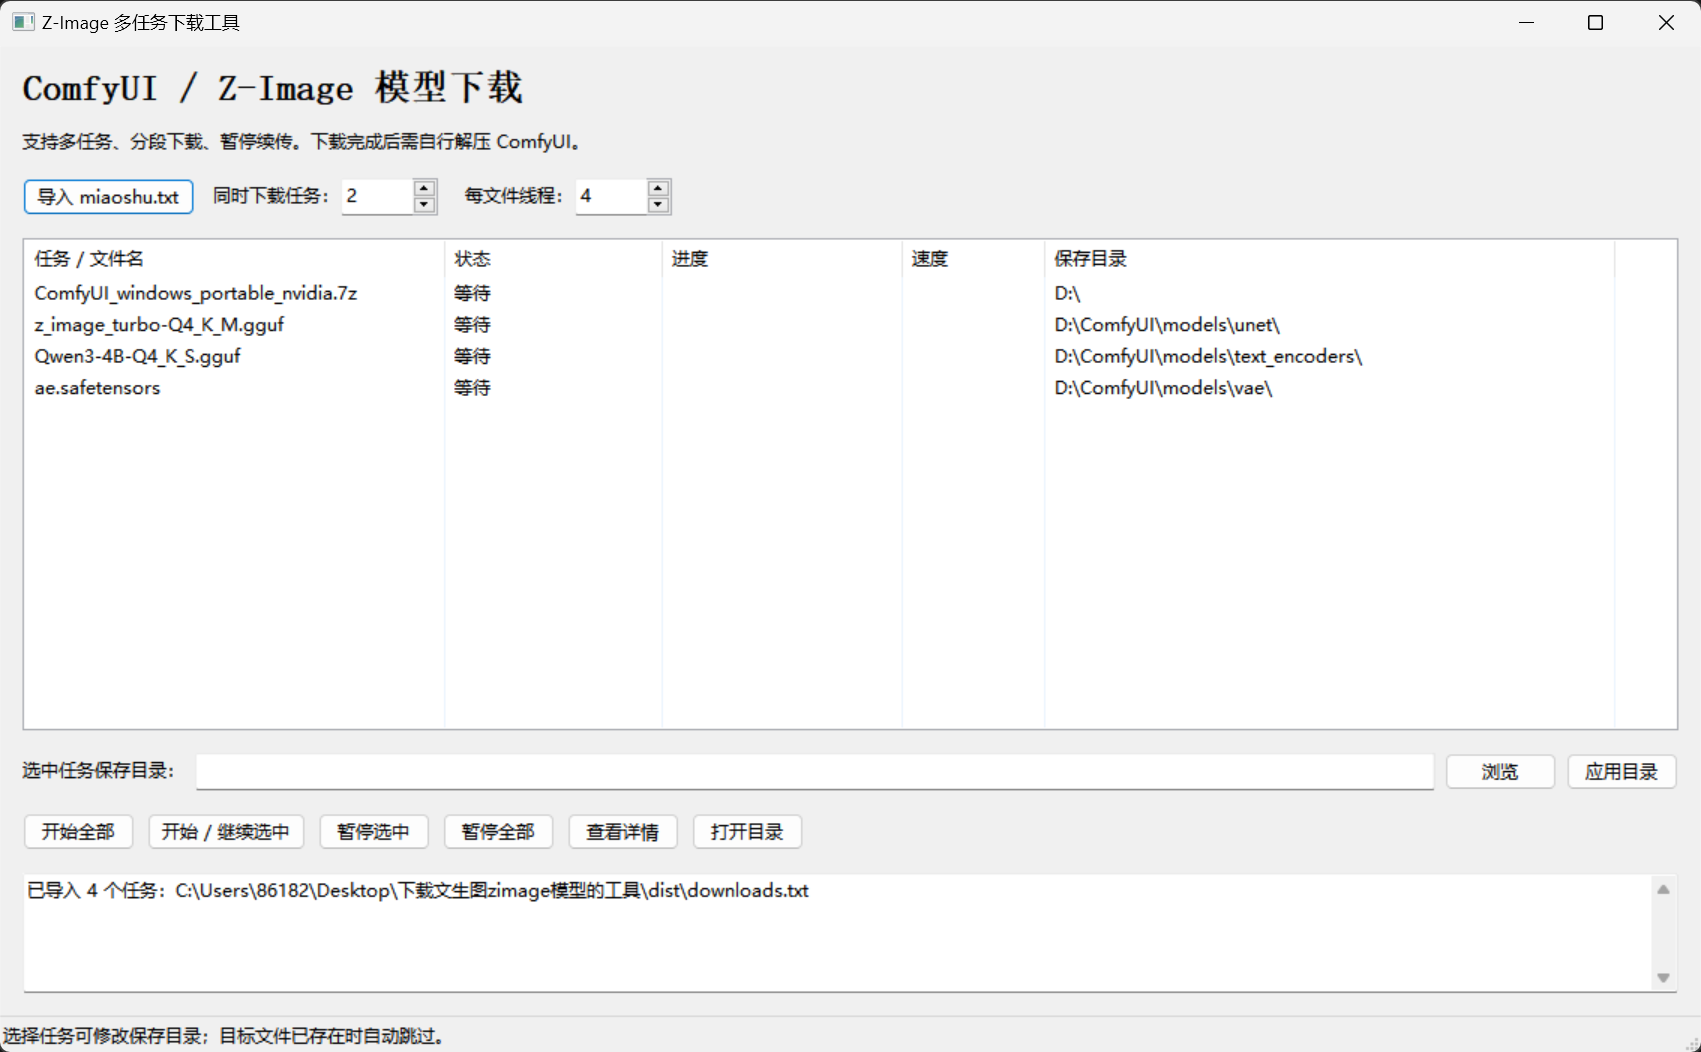
二、整体架构:两级线程池
工具的并发模型是两级线程池,这是理解全部代码的骨架:
text
GUI 主线程 (wxPython)
  │
  └─ 第一级:任务级线程池(默认 max_workers=2,即同时下载 2 个任务)
        ├─ 任务 A: DownloadTask.run()
        │     └─ 第二级:分段线程池(默认 4 线程)
        │           ├─ 线程1 → 0.part(字节段 [0, total/4-1])
        │           ├─ 线程2 → 1.part
        │           ├─ 线程3 → 2.part
        │           └─ 线程4 → 3.part
        └─ 任务 B: DownloadTask.run()
              └─ 第二级:分段线程池(默认 4 线程)
第一级池在 GUI 侧,控制"同时下载几个任务"(1~8 可调);第二级池在每个任务内部,控制"一个文件开几个连接分段下载"(1~16 可调)。
很多人看到 Python 多线程会立刻想到 GIL。但下载是典型的 IO 密集型任务 :线程绝大多数时间阻塞在 socket.recv() 上等待网络数据,此时 GIL 已被释放,其他线程可以照常运行。所以这里多线程提速是真实有效的,不需要上 asyncio 或多进程。
任务级线程池的创建有个细节------只在没有任务在跑时才按新的并发数重建:
python
def ensure_pool(self):
    if self.pool is None or not self.active():
        if self.pool:
            self.pool.shutdown(wait=False)
        self.pool = ThreadPoolExecutor(
            max_workers=self.concurrent.GetValue(),
            thread_name_prefix='download')
三、核心之一:先探测,再决定怎么下
不是所有服务器都支持分段下载。HTTP 的规则是:客户端发 Range: bytes=起始-结束 请求头,支持的服务器返回 206 Partial Content 和 Content-Range 头;不支持的服务器无视 Range,直接返回 200 和完整文件。
探测代码(download_core.py):
python
def _probe(self):
    # GET 而不是 HEAD:部分 CDN / 发行站会拒绝 HEAD 请求
    for attempt in range(3):
        try:
            with self._request({'Range': 'bytes=0-0'}) as response:
                self.validator = response.headers.get('ETag', '')
                self.validator_header = 'ETag'
                if self.validator.startswith('W/'):   # 弱 ETag 不可靠,丢弃
                    self.validator = ''
                if not self.validator:
                    self.validator = response.headers.get('Last-Modified', '')
                    self.validator_header = 'Last-Modified'
                value = response.headers.get('Content-Range', '')
                match = re.fullmatch(r'bytes 0-0/(\d+)', value)
                if response.status == 206 and match:
                    self.total = int(match.group(1))  # 真实总大小在分母里
                    return True
                if response.status != 200:
                    raise ValueError('服务器返回了无效的 Range 响应。')
                self.total = int(response.headers.get('Content-Length', '0'))
                return False
        except Paused:
            raise
        except Exception:
            if attempt == 2:
                raise
            if self.stop.wait(attempt + 1):
                raise Paused()
这里有三个实战经验点:
- 用 GET 而非 HEAD 探测 。很多对象存储和 CDN 对 HEAD 的处理与 GET 不一致,HEAD 说不支持,GET 却支持。只请求第一个字节(
bytes=0-0),拿到响应头后立即关闭连接,成本极低。 - 文件总大小优先从
Content-Range的分母取 (bytes 0-0/4981532736),这是服务器对"整个资源有多大"的明确回答。 - 探测本身也带 3 次重试,重试间隔 1s、2s 递增,且暂停信号能立刻打断等待。
四、核心之二:没有"身份证",就绝不分段
这是整个项目里最有工程思维的一行:
python
ranged = self._probe() and bool(self.validator)仅仅支持 Range 还不够,服务器必须同时提供可靠的文件标识------强 ETag 或 Last-Modified------才启用多线程分段。
为什么这么保守?设想一个场景:
你用 4 个线程下载一个 5 GB 的模型,下到 50% 时,服务端把这个文件替换成了新版本(URL 完全没变)。此时第 1、2 段是旧文件的字节,第 3、4 段是新文件的字节。最后拼接出来的是一个结构完好、长度正确、内容却是"缝合怪"的 GGUF 文件------权重加载不报错,但生成的图全是噪声。这类损坏最难排查。
防御手段是 HTTP 的 If-Range 机制:分段请求时带上文件标识,告诉服务器"只有当文件还是这一版时,才给我发分片;否则请重新发完整文件"。
python
headers = {}
if ranged:
    headers['Range'] = f'bytes={start + offset}-{end}'
    if self.validator:
        headers['If-Range'] = self.validator
响应回来后还要做二次核对(不信任是安全的底色):
python
if ranged:
    correct = f'bytes {start + offset}-{end}/{self.total}'
    if response.status != 206 or response.headers.get('Content-Range') != correct:
        raise ValueError('服务器未按分段请求返回数据,或远程文件已变化。')
elif response.status != 200:
    raise ValueError('服务器未返回完整文件。')
if self.validator and response.headers.get(self.validator_header) != self.validator:
raise ValueError('远程文件标识已变化,请重试以重新探测文件。')- 状态码必须是 206;
Content-Range必须与请求的区间逐字节吻合(防止服务器"答非所问");- ETag / Last-Modified 必须与探测时一致。
任何一条不满足,直接报错重来,绝不带着可疑数据继续拼接。
而对那些不支持 Range、或给不出可靠标识的服务器,工具会自动降级为单线程整文件下载(界面状态明确显示"下载中(单线程)"),暂停后只能从头重下。宁可慢,不可错。
五、核心之三:分段、续传与身份失效
5.1 字节区间切分
python
bounds = [
    (i,
     self.total * i // count,
     self.total * (i + 1) // count - 1)
    for i in range(count)
]
用整除而不是简单的 total // count * i,是为了让余数均匀分布,并且最后一段的结束位置精确落在 total - 1:区间首尾相接、不重叠、不遗漏。
5.2 每个分段就是一个独立的可续传文件
所有临时数据放在目标文件旁边的 <文件名>.download/ 目录里:
text
D:\ComfyUI\models\unet\
├─ z_image_turbo-Q4_K_M.gguf.download\
│    ├─ metadata.json     # 这次下载的"身份档案"
│    ├─ 0.part
│    ├─ 1.part
│    ├─ 2.part
│    └─ 3.part
└─ (完成后出现)z_image_turbo-Q4_K_M.gguf
分段下载函数启动时,先看本地 .part 已经有多少字节,从断点处接着下:
python
part = self.work / f'{index}.part'
expected = end - start + 1 if self.total else None
...
offset = part.stat().st_size if part.exists() and ranged else 0
...
if ranged:
    headers['Range'] = f'bytes={start + offset}-{end}'
...
with part.open('ab' if ranged else 'wb') as stream:   # 分段追加 / 整文件重写
    received = offset
    while True:
        chunk = response.read(128 * 1024)
        if not chunk:
            break
        received += len(chunk)
        if expected is not None and received > expected:
            raise ValueError('服务器数据长度超出预期。')
        stream.write(chunk)
        self._progress(index, received)
    if expected is not None and received != expected:
        raise IOError('连接提前结束,数据未下载完整。')
注意单线程模式打开文件用的是 'wb' 而不是 'ab':没有可靠身份标识时,旧字节可能属于一个已被替换的文件,追加就是在延续错误,所以从头写入。
5.3 metadata.json:跨重启续传的"身份档案"
暂停后关程序、第二天再开,凭什么相信磁盘上那堆 .part 还能用?靠的是 metadata.json:
python
identity = dict(url=self.url, size=self.total,
                validator=self.validator, header=self.validator_header,
                parts=count, ranged=ranged)
...
try:
    previous = json.loads(metadata.read_text(encoding='utf-8'))
except (OSError, ValueError):
    previous = None

if previous != identity or not self.validator or not ranged:
    for file in self.work.glob('*.part'):
        file.unlink()
metadata.write_text(json.dumps(identity), encoding='utf-8')
身份五元组里任何一个对不上------URL 变了、远程文件大小变了、ETag 变了、分段数量变了------旧分段全部作废,干净利落地重新开始。
这也解释了使用说明里那条看似奇怪的规定:"重启后续传需使用相同目标路径和线程数"。不是技术做不到兼容,而是分段边界一旦改变,旧 part 的字节区间与新边界对不上,与其做复杂的迁移,不如明确地重下------把规则写在明面上,反而更不容易出错。
六、核心之四:协作式暂停,而不是强杀线程
下载这类任务最忌讳 thread.kill() 式的粗暴终止:线程可能死在写文件的中途,留下长度未知的半成品。
工具用一个 threading.Event 实现协作式暂停,并在所有可能阻塞的节点插入检查点:
python
class Paused(Exception):
    pass

def _check(self):
    if self.stop.is_set():
        raise Paused()
检查点遍布:发请求前、每读 128 KB 数据块前、重试退避等待中、合并文件每读 1 MB 时。其中重试等待的写法值得一看:
python
if self.stop.wait(attempt + 1):   # 最多等 1/2 秒,但暂停信号一到立刻醒来
    raise Paused()
Event.wait(timeout) 同时承担了"退避计时"和"暂停唤醒"两件事,暂停操作的响应延迟被压到最低。
收到暂停后,控制流跳到 run() 中的统一出口:
python
except Paused:
    with self.lock:
        self.status = '已暂停'
线程自己走到安全位置、抛出内部信号、留下状态完整的 .part 文件后平静退出。下次点"继续",就是重新跑一遍 run():探测 → 读 metadata → 读各 part 的 offset → 从断点接着下。
七、核心之五:原子收尾,半成品永不"转正"
多线程下载最危险的时刻其实是最后一步:合并。工具的收尾流程是:
text
4 个 part 全部下完且各自长度校验通过
        │
        ▼
按编号顺序合并 → merged.tmp
        │
        ▼
merged.tmp 总长度 == 服务器声明的总长度?
        │ 否 → 抛错,状态"失败",临时目录保留
        ▼ 是
目标文件此刻是否已存在?(下载期间可能被用户手动放入)
        │ 是 → 抛错,绝不覆盖
        ▼ 否
rename: merged.tmp → 目标文件(同盘原子操作)
        │
        ▼
状态置"已完成",删除 .download 目录
对应代码:
python
merged = self.work / 'merged.tmp'
with merged.open('wb') as output:
    for i in range(count):
        with (self.work / f'{i}.part').open('rb') as source:
            while chunk := source.read(1024 * 1024):
                self._check()
                output.write(chunk)
if self.total and merged.stat().st_size != self.total:
    raise IOError('合并后的文件长度不正确。')
self._check()
if self.target.exists():
    raise FileExistsError('目标文件在下载期间被创建,未覆盖。')
merged.rename(self.target)
同分区上的 rename 由操作系统保证原子性------目标文件要么不存在,要么是完整的,不存在任何中间状态。配合下载开头的"目标已存在即跳过"逻辑,工具对用户数据的承诺是:已有的文件一个字节都不会动。
代价也要诚实告知:合并阶段需要额外一个完整文件大小的临时空间,所以下载大文件前建议预留约两倍文件大小的磁盘空间。README 里明确写了这一点。
另外,文档没有提供 SHA256,工具就不伪称做过哈希校验,只校验文件长度;也不提供自动解压、自动安装到 ComfyUI 的功能。能力边界写得清清楚楚,这本身就是可靠软件的一部分。
八、GUI 与工作线程如何安全协作
wxPython(以及几乎所有 GUI 框架)要求控件只能在主线程访问。工具的处理方式是经典的"共享状态 + 定时轮询":
- 任务侧用一把
RLock保护所有可变字段; - 对外只暴露
snapshot()一个读接口,返回普通 dict 快照:
python
def snapshot(self):
    with self.lock:
        return dict(status=self.status, error=self.error,
                    total=self.total, downloaded=self.downloaded,
speed=self.speed)- GUI 用
wx.Timer每 350 ms 拉取快照、刷新表格:
python
self.timer = wx.Timer(self)
self.Bind(wx.EVT_TIMER, self.refresh, self.timer)
self.timer.Start(350)
工作线程全程不碰任何 wx 对象,因此不存在跨线程操作控件的隐患。
排队任务的暂停 也有专门处理:任务在线程池队列里还没开始执行时,暂停它必须做到"一个网络请求都不发"。做法是在入队前于 UI 线程清掉 Event 并置状态,暂停时对未开始的 Future 调用 cancel():
python
task.stop.clear()                 # UI 线程中先清信号再入队
with task.lock:
    task.status = '排队中'
self.futures[index] = self.pool.submit(task.run)
...
def pause_task(self, index):
    task = self.tasks[index]
    future = self.futures.get(index)
    if future and not future.done():
        task.pause()
        if future.cancel():       # 还在队列里 → 直接取消,状态立刻变"已暂停"
            with task.lock:
                task.status = '已暂停'
关闭窗口时也不是一杀了之:先暂停全部任务,把关闭事件 veto 掉,界面提示"等待当前网络读取结束",靠 350 ms 的刷新轮询发现所有 Future 结束后才真正销毁窗口------保证退出时磁盘上的续传数据一定是自洽的。
九、不连外网也能测:内置 Mock HTTP 服务器
下载器这种软件,如果测试依赖真实网站,那既慢又不稳定。项目用标准库 ThreadingHTTPServer 在本地搭了一个"故障注入服务器",用不同 URL 路径模拟真实世界的各种幺蛾子:
python
class Handler(BaseHTTPRequestHandler):
    def do_GET(self):
        if self.path == '/missing':
            self.send_error(404)                    # 404
        ...
        use_range = value and self.path != '/plain' # /plain 不支持 Range
        if self.path != '/noidentity':
            self.send_header('ETag', '"test-v1"')  # /noidentity 不给标识
        ...
        if self.path == '/truncated' and value != 'bytes=0-0':
            self.wfile.write(DATA[start:start + 1024])  # /truncated 传一半断连
        if self.path == '/slow':
            time.sleep(0.01)                        # /slow 慢速,给暂停测试留窗口
12 个测试用例覆盖了全部关键路径,其中几个特别能体现设计意图:
test_pause_and_resume:慢速下载中暂停 → 工作线程必须真的退出、状态"已暂停"、目标文件不存在 → 继续后文件内容与源数据逐字节一致;test_truncated_data_never_becomes_final_file:传输截断时状态必须是"失败",目标文件必须不存在,临时目录保留;test_restart_resumes_existing_segments:模拟重启程序,断言新请求的起始字节正好等于旧.part的长度------续传是真的,不是从头重下;test_existing_target_not_overwritten:目标里先写入b'keep me',下载后内容必须原封不动;test_cleanup_failure_does_not_hide_success:即使临时目录删除失败(模拟文件被占用),文件照样算成功,错误只作为附注提示。
测试与设计形成了闭环:每一条安全承诺,都有一个用例在盯着。
十、打包:让用户完全不碰 Python
最终用户可能不知道 Python 是什么。用 PyInstaller 打成单文件、无控制台窗口的 exe:
powershell
python -m PyInstaller --noconfirm --clean --onefile --windowed `
    --name ZImageDownloader --add-data 'downloads.txt:.' app.py
几个细节:
--windowed去掉黑色控制台窗口;--onefile产出单个 exe;--add-data 'downloads.txt:.'把修正过的下载清单打进包内,程序启动时按downloads.txt → miaoshu.txt → 内置清单的顺序寻找配置;- 通过
sys.frozen判断自己是否运行在打包环境中,从而正确定位 exe 旁边的清单文件------配置文件放包外,用户不用重新下载 exe 也能更新任务清单。
十一、写在最后:一个"小"下载器里的工程原则
回头看,这个工具没有用任何高深技术,urllib、threading、ThreadPoolExecutor 都是 Python 自带的东西。它的价值在于把朴素的原则坚持到底:
- 先探测能力,再选择策略,对不支持的场景优雅降级;
- 身份先于数据------没有 ETag / Last-Modified,再快的分段也不开;
- 半成品永远不能伪装成成品:长度校验 + 原子 rename + 绝不覆盖;
- 协作式取消,让线程在安全点自己停下,而不是被杀死在半路;
- GUI 与工作线程严格隔离,只通过锁保护的快照通信;
- 诚实地声明能力边界:不做哈希校验就明说,不支持解压就明说;
- 用可注入故障的 mock 服务器测试,让每一条承诺都有自动化用例兜底。
这些原则并不局限于下载器。任何需要与不可靠网络、并发和用户数据打交道的程序,本质上都在回答同一组问题:如何识别变化?如何隔离失败?如何保证系统在任意时刻被打断后,状态依然自洽?
想清楚这三个问题,比"用什么框架"重要得多。
源码运行:python app.py(需 wxPython);测试:python -m unittest -v;完整使用说明见项目 README。