实验 10-2 豆包版复现分析:书籍翻译 Agent 的管理者模式
一、实验概述
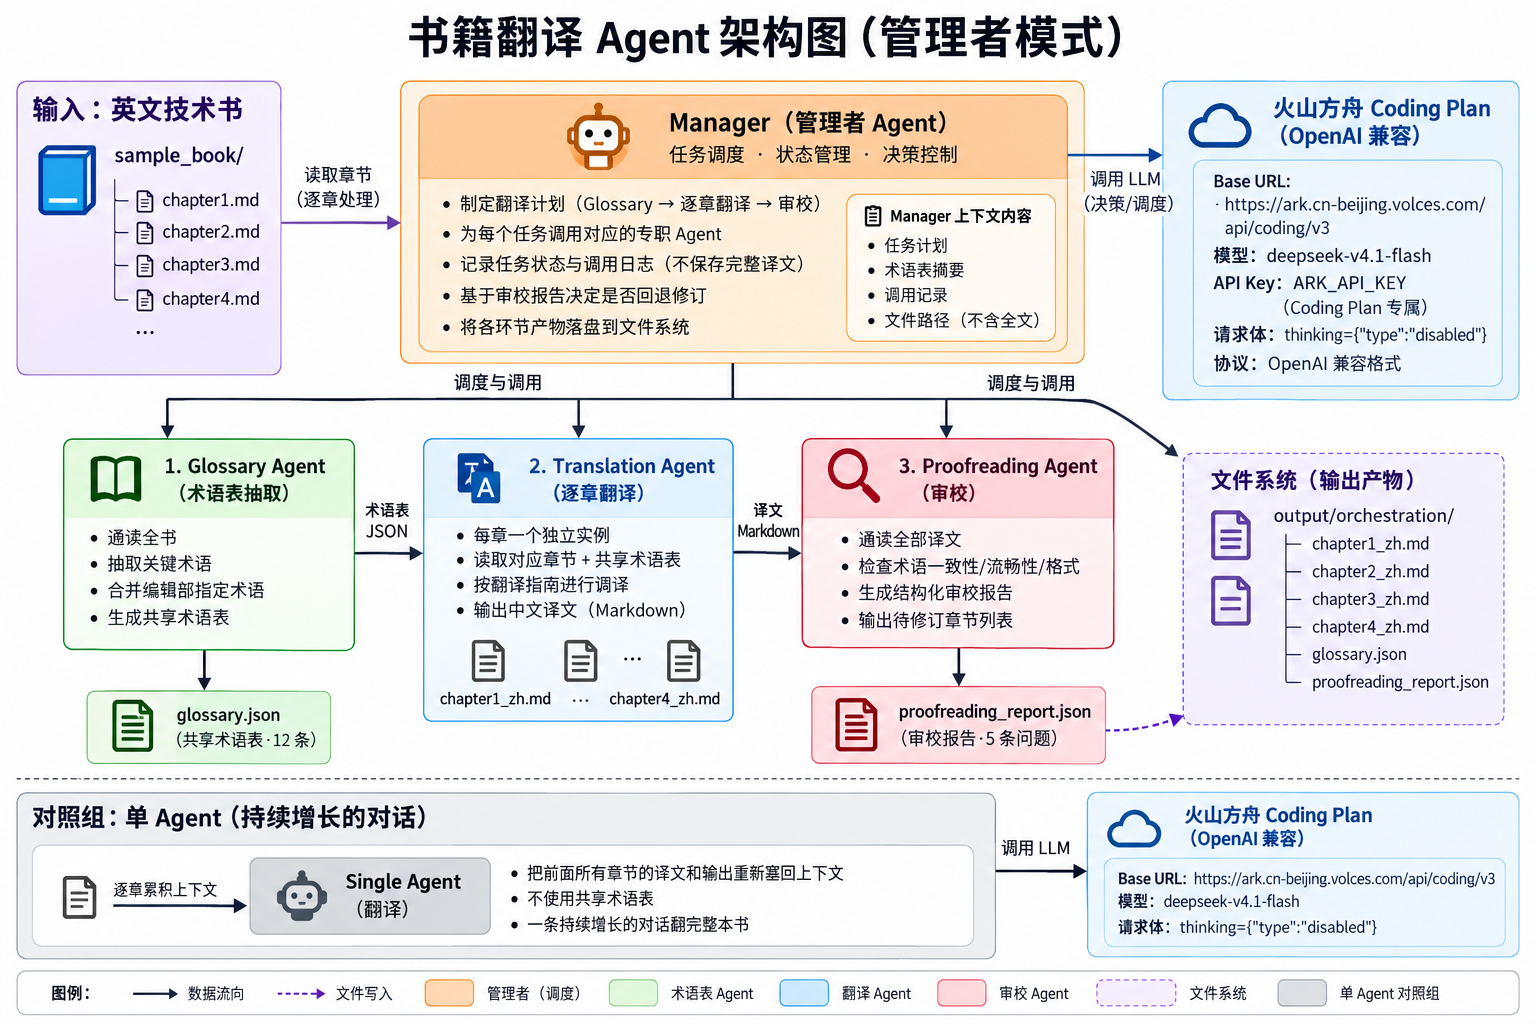
实验 10-2 用管理者模式(Orchestration)把一本英文技术小书的翻译拆给四个专职 Agent:
Glossary(抽术语表)→ Translation(逐章翻译,每章一个独立实例)→ Proofreading(审校)→
Manager(调度与决策)。核心主张是上下文隔离 与控制 Manager 上下文膨胀 :完整译文全部落盘,
Manager 上下文里只留任务、计划、调用记录与文件路径,因此书越长、Manager 上下文基本不涨。
对照组是「单 Agent 一条持续增长的对话翻完整本书」,用来量化两者在上下文峰值 、术语一致性
和成本上的差别。
本实验的原版默认走 OpenAI / OpenRouter。本次复现改用火山方舟 Coding Plan (OpenAI 兼容端点
/api/coding/v3),以验证该书实验在国产订阅套餐上的可复现性。
二、运行配置
| 配置项 | 值 |
|---|---|
| Provider | ark-coding(本次新增,见第三节) |
| 端点 | https://ark.cn-beijing.volces.com/api/coding/v3(OpenAI 兼容) |
| 模型 | deepseek-v4.1-flash |
| 凭据 | Coding Plan 专属 ARK_API_KEY,来自 .env(值不落盘、本文不回显) |
| 思考开关 | 请求体显式 thinking={"type":"disabled"} |
| 翻译方向 | 英文 → 中文 |
| 语料 | sample_book/,4 个短章节 |
| 运行方式 | 管理者模式 + 单 Agent 对照(未加 --skip-single) |
| 运行时间 | 2026-10-01 |
deepseek-v4.1-flash 属方舟 Coding Plan 套餐内模型,本次翻译链路与审校/调度调用均走该端点。
三、复现改造点(相对原版)
原代码只有 OpenAI / OpenRouter / Mistral / 方舟标准 API 几条路径。本次为跑通 Coding Plan 做了如下改动:
agents.py新增ark-codingprovider :Base URL 指向.../api/coding/v3;Key 取
ARK_CODING_API_KEY,缺省回退ARK_API_KEY;模型缺省deepseek-v4.1-flash(可用
ARK_CODING_MODEL/OPENAI_MODEL/--model覆盖)。- 抽出
THINKING_DISABLED_PROVIDERS常量 :把原先硬编码的「方舟需要关思考」逻辑收敛为一处,
避免推理占满 completion 导致译文正文为空;ark-coding一并纳入。 demo.py新增--provider参数 ,并修正原有的 Key 校验------原实现只认
OPENAI_API_KEY/OPENROUTER_API_KEY,会把ark/ark-coding误拦在门外。demo.py显式加载脚本同目录.env(load_dotenv(os.path.join(HERE, ".env"))),
保证从任意工作目录运行都能读到配置。run_official_experiment.py的--provider增加ark-coding,并同步其 thinking 口径。
改造后的链路与协议语义未变:四角色、文件系统传参、共享术语表、确定性字符串匹配统计,全部沿用原设计。
四、实测结果
| 指标 | 管理者模式 | 单 Agent | 来源 |
|---|---|---|---|
| 主/Manager 上下文峰值 (tokens) | 1022 | 2050 | 控制台 |
| Manager LLM 决策调用上下文 (tokens) | 751 | --- | 控制台 |
| 全流程总 token | 7492 | 5948 | 管理者=控制台;单 Agent=可复算 |
| 术语内部一致率 | 100% (9/9) | 88.9% (8/9) | 可复算 |
| 指定术语遵从率 | 100% (15/15) | 26.7% (4/15) | 可复算 |
| 参与 Agent 种类数 | 4 | 1 | 代码结构 |
单 Agent 的 token 明细可从 output/single_agent/progress.json 逐调用复算(真实 API usage):
| 调用 | 输入 (prompt) | 输出 (completion) |
|---|---|---|
| Chapter 1 | 368 | 299 |
| Chapter 2 | 944 | 252 |
| Chapter 3 | 1482 | 263 |
| Chapter 4 | 2050 | 290 |
| 合计 | 4844 | 1104 |
注:单 Agent 第 4 章的输入 2050 即「主上下文峰值」------它随章节线性累积 (368 → 944 → 1482 → 2050),
每翻一章就把前面所有章节的译文和输出重新塞回上下文。管理者模式没有这个累积过程,Manager 的
峰值 1022 主要由术语表与调用记录构成,与每章正文长度无关。
五、术语一致性实测明细
管理者模式:把「编辑部指定术语」强制写进共享术语表,下发给每个 Translation 实例。
| 指定术语 | 规定 / 默认 | 出现 | 命中 |
|---|---|---|---|
| token | 词元 / 标记 | 4 | 4 |
| prompt | 提示词 / 提示 | 4 | 4 |
| latency | 时延 / 延迟 | 4 | 4 |
| embedding | 嵌入向量 / 嵌入 | 3 | 3 |
内部一致率 9/9:9 个被追踪术语(词元、提示词、时延、嵌入向量、推理、注意力、Transformer、
吞吐量、微调)在各自出现的章节里均只用单一译法,无跨章漂移。
单 Agent:同样的译文,但看不到术语表。
| 指定术语 | 规定 / 默认 | 出现 | 命中 | 单 Agent 实际用的写法 |
|---|---|---|---|---|
| token | 词元 / 标记 | 4 | 4 | 词元(自发命中) |
| prompt | 提示词 / 提示 | 4 | 0 | 提示(4 章) |
| latency | 时延 / 延迟 | 4 | 0 | 延迟(4 章) |
| embedding | 嵌入向量 / 嵌入 | 3 | 0 | 嵌入(3 章) |
内部一致率 8/9:唯一不一致的是 token ------全书同时出现「词元」(4 章)与英文 token(2 章正文,
非代码块)两种写法,属典型的跨章漂移。
共享术语表收录 12 条 (4 条强制指定 + Glossary Agent 自动抽取 8 条):token→词元、
embedding→嵌入向量、prompt→提示词、inference→推理、latency→时延、transformer→Transformer、
attention→注意力、throughput→吞吐量、KV cache→KV缓存、batching→批处理、fine-tuning→微调、
deployment→部署。
六、审校报告
proofreading_report.json 共报 5 条 问题,chapters_need_revision 列出全部 4 章:
- 术语类 4 条 :Ch1 token、Ch2 attention、Ch3 KV cache、Ch4 fine-tuning------均指向
代码注释 / 变量名里仍保留英文原文; - 流畅性 1 条:Chapter 4 标题的数字与冒号之间有多余空格。
报告总结:整体术语基本一致,但代码内仍保留英文术语,建议统一并修正标题空格。
这不与「管理者模式遵从率 100%」矛盾:
consistency.py统计前会_strip_code去掉围栏代码与行内代码,遵从率衡量的是正文表述 ;代码注释保留英文正是翻译指南的预期行为。审校 Agent 额外把这一层
作为「可选优化」报了出来------说明四角色分工里审校确实在做独立于术语表的检查。
七、分析与结论
-
上下文隔离成立,但幅度比 README 样本小。 本次 Manager 峰值 1022 vs 单 Agent 2050,约
2.0 倍 ;README 记录的 gpt-5.6-luna 运行是 697 vs 2320(3.3 倍)。差距缩小的直接原因是
单 Agent 的累积起点更低(368 tokens)且每章输出更短(~270 completion)。关键不在这一个倍数,
而在增长曲线的形状 :单 Agent 是 368→944→1482→2050 的线性累积,管理者模式的 Manager 状态只随「章节数」增加一行记录,与每章正文长度无关------书越长,差距越大。
-
共享术语表把「指定译法」从可选变成强制。 管理者模式 15/15 全中;单 Agent 只有 4/15。
值得注意的是:单 Agent 在 token 上自发 采用了与规定一致的「词元」(4/4),但对没有唯一
标准的术语各行其是------prompt 一律译「提示」、latency 一律译「延迟」、embedding 一律译「嵌入」,
三者在全书内各自一致却不合规定。这正好说明单 Agent 的问题不是"乱翻",而是"无人裁决"。
-
单 Agent 的真实缺陷是跨章漂移,而非译法不同。 它的 88.9% 内部一致率唯一失分项就是
token:4 章写「词元」、2 章正文写
token。同一个术语在同一本书里换写法 ,是长文档翻译最典型的质量事故;管理者模式靠「一份术语表下发所有 Translation 实例」从机制上消除了它。
-
代价方向与 README 一致:管理者模式更贵。 总 token 7492 vs 5948(+26%),多出来的部分花在
术语表抽取、审校和调度决策上。换来的是可控的主上下文 与可强制的术语统一 ------对长文档
翻译而言,这两个性质比省 token 重要。
-
一次诚实的负结果 :四角色跑完后,审校 Agent 仍然报了 5 条问题、4 章全部进了待修订列表。
即「共享术语表 + 一轮审校」并不能让所有检查项归零------术语表管的是正文表述,代码注释、
标题格式这类问题需要另外的规则。管理者的价值是把这些问题显式暴露成结构化报告 并决定
是否回退修订,而不是假装没有。
八、局限与注意事项
- 语料只有 4 个短章节 ,用于暴露机制,不代表大规模真实书籍的绝对 token 数值。
- 管理者模式的 token/上下文数值(1022 / 751 / 7492)只在控制台打印、未落盘 ,无法离线复核;
单 Agent 的数值已从progress.json逐调用复算。建议后续给管理者模式也加一份 metrics 落盘。 - 术语指标为确定性字符串匹配 (
consistency.py),不是模型自评,可能漏判更灵活的措辞变体。 - 单次运行的数字会随模型输出随机性小幅波动,量级与结论稳定。
- 合规提示 :火山方舟官方文档明确说明 Coding Plan 套餐额度仅在 AI 编程工具中生效、不可用于
API 调用 ,在非编程工具中使用其专属 Base URL + Key 有可能被识别为滥用/违规。本次运行是把
Coding Plan 当作可选 provider 做的技术验证,生产用途请改用方舟标准 API 或其它正规计费通道,
且切勿混用平台ARK_API_KEY与 Coding Plan 专属 Key。
附录:本次运行产物清单
| 文件 | 字节 |
|---|---|
output/orchestration/chapter1_zh.md |
1340 |
output/orchestration/chapter2_zh.md |
1234 |
output/orchestration/chapter3_zh.md |
1138 |
output/orchestration/chapter4_zh.md |
1273 |
output/orchestration/glossary.json |
2026 |
output/orchestration/proofreading_report.json |
1670 |
output/single_agent/chapter1_zh.md |
1371 |
output/single_agent/chapter2_zh.md |
1269 |
output/single_agent/chapter3_zh.md |
1234 |
output/single_agent/chapter4_zh.md |
1333 |
output/single_agent/progress.json |
7096 |
两组均产出 4 篇译文,每篇 1 个 H1 标题 + 1 个代码块;管理者模式各篇体积略小。
复现命令
powershell
# 仓库根目录,构建第 10 章环境(含 dev 依赖,便于跑离线测试)
uv sync --locked --python 3.12 --extra ch10 --extra dev

cd chapter10/book-translation

# 离线自检(不联网、不消耗额度)
.\.venv\Scripts\python.exe demo.py --dry-run
.\.venv\Scripts\python.exe -m pytest tests -q          # 14 passed

# 管理者模式 + 单 Agent 对照(真实调用,需 ARK_API_KEY,消耗套餐额度)
.\.venv\Scripts\python.exe demo.py

# 只跑管理者模式,调用更少
.\.venv\Scripts\python.exe demo.py --skip-single
.env 关键项:LLM_PROVIDER=ark-coding、ARK_API_KEY=<Coding Plan 专属 Key>、
ARK_CODING_MODEL=deepseek-v4.1-flash(.env 已被 gitignore)。