判断存在用 LIMIT 1:PostgreSQL 五种 count 计数方式与 NULL 语义
标签:#PostgreSQL #SQL #性能优化 #计数
一、前言
在函数中、或程序中,不要使用 count(*) 判断是否有数据------很慢。 官方 9.21 原话(性能 Note):"习惯于其他数据库系统的用户可能会对 count 聚合在整表上的性能失望。像 SELECT count(*) FROM sometable; 这样的查询,工作量与表的大小成正比:PostgreSQL 需要扫描整张表、或包含所有行的整个索引。"
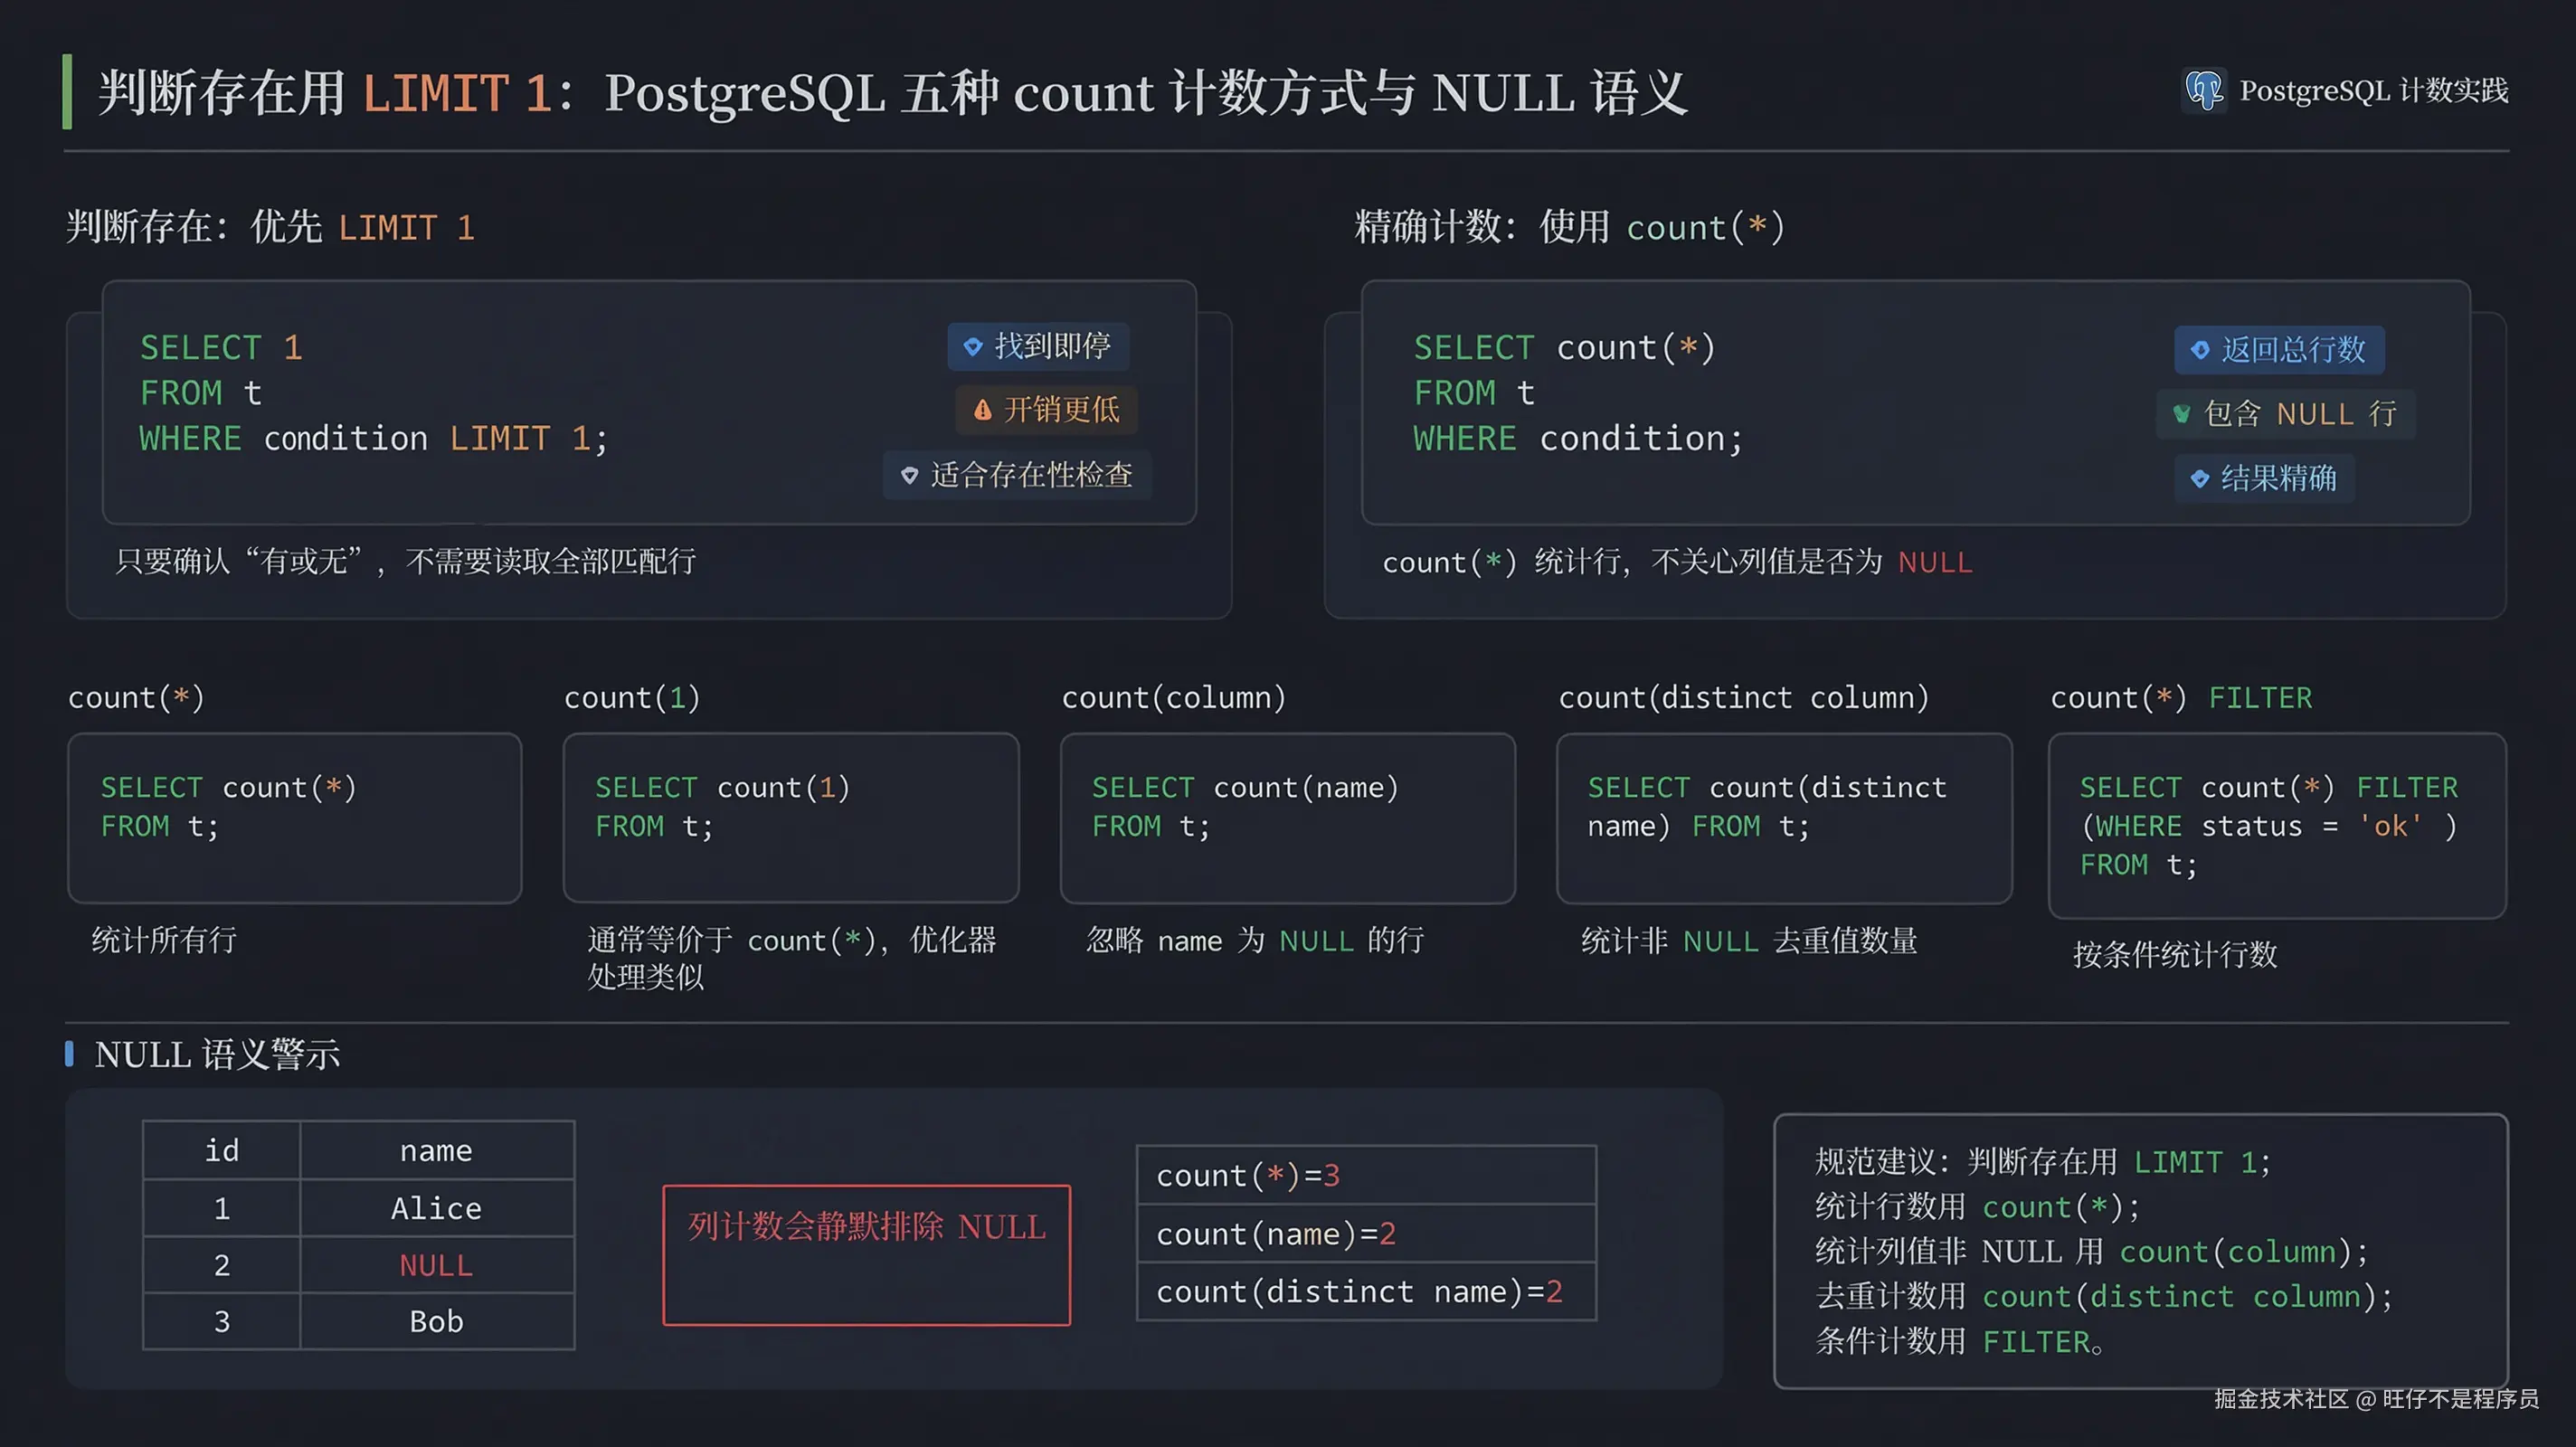 判断"有没有数据"的正确姿势是 LIMIT 1(人工检查):
sql
SELECT 1 FROM tbl WHERE xxx LIMIT 1;
-- IF FOUND → 存在
-- ELSE → 不存在同时要会选取合适的计数方式------五种 count 的 NULL 语义各不相同(官方 9.21 / 4.2.7):
| 写法 | 语义 | NULL 处理 |
|---|---|---|
count(*) |
统计输入行数(标准语法) | 空值会纳入统计 |
count(col) |
统计 col 列非空记录数 | col 为 NULL 不计入 |
count(distinct col) |
col 列去重计数 | 同样忽略 NULL,只统计非空不同值 |
count((col1, col2)) |
多列计数(行构造器) | 即使列全为空也会被计数,(null, null) 有效 |
count(distinct (col1, col2)) |
多列去重计数 | 即使列全为空也会被计数,(null, null) 有效 |
二、核心开发规范
- 存在性判断用 LIMIT 1,不用
count(*):SELECT 1 FROM tbl WHERE xxx LIMIT 1;+IF FOUND------找到第一行立即停,工作量只到第一行命中;count(*)要数完所有匹配行(官方 9.21:工作量与表大小成正比); - 五种计数方式按需选取 :数全部行用
count(*)(含全 NULL 行);数某列非空用count(col);数不同非空值用count(distinct col);数"组合列"用count((col1, col2))(全 NULL 也计入); - COUNT DISTINCT 有去重成本:需要排序 / 哈希聚合,比 count 更贵------能不用就不用,高频路径尤其注意。
三、底层原理通俗讲解
- 官方 9.21 count 定义 :
count(*)→ "计算输入行的数量";count(expression)→ "计算输入值不为 NULL 的输入行数量"------这就是count(*)纳入空值、count(col)忽略 NULL 的官方依据; - 官方 9.21 性能原话 :
SELECT count(*) FROM sometable;需要扫描整张表或包含所有行的整个索引------全量计数没有捷径,工作量随表长大; - LIMIT 1 为什么快 :Limit 节点找到一行就提前终止执行(第 17 篇讲过)------存在性检查只关心"有没有",第一行命中即停,不用数完全部;
- 官方 4.2.7 原文 :"count(*) 产生输入行的总数;count(f1) 产生 f1 非空的输入行数,因为 count 忽略 null ;count(distinct f1) 产生 f1 不同的非空值的个数";
- DISTINCT 的多表达式 :官方 4.2.7------DISTINCT 形式"对表达式的每个不同值(或多个表达式的不同值集合)调用一次聚合"------这就是
count(distinct (col1, col2))按组合去重的依据; - 为什么 (null, null) 也被计入 :
(col1, col2)是行构造器 (官方 4.2.13),生成的是复合值------即使所有字段都是 NULL,复合值本身仍是非 NULL 值(不同于 IS NULL 谓词的"全字段为 NULL"判定)→ 按官方 count 定义"输入值不为 NULL 的行"被计数;验证:SELECT count((NULL, NULL)); -- 返回 1; - count(distinct col) 的代价:去重需要排序或哈希聚合(官方 4.2.7 的 DISTINCT 语义),比普通 count 多一整层处理,数据量越大越明显。
四、实战错误案例&优化方案
场景1:函数/程序中判断"是否存在"(核心场景)
表设计:orders 表 500 万行,函数要判断某用户是否有订单
❌ 错误写法(用 count(*) 数完所有匹配行)
sql
DO $$
DECLARE cnt bigint;
BEGIN
  SELECT count(*) INTO cnt FROM orders WHERE user_id = 10086;
  IF cnt > 0 THEN
    RAISE NOTICE '存在';
  ELSE
    RAISE NOTICE '不存在';
  END IF;
END $$;
-- count(*) 要扫完 user_id=10086 的所有订单行才能返回
-- 官方 9.21:工作量与表大小(匹配行数)成正比,很慢
✅ 正确写法(LIMIT 1 + FOUND,人工检查)
sql
DO $$
DECLARE v_id int;
BEGIN
  SELECT 1 INTO v_id FROM orders WHERE user_id = 10086 LIMIT 1;
  IF FOUND THEN        -- plpgsql FOUND:最近一条 SQL 是否产生了行
    RAISE NOTICE '存在';
  ELSE
    RAISE NOTICE '不存在';
  END IF;
END $$;
-- Limit 节点找到第一行立即终止(第 17 篇)
-- 工作量 = 扫到第一行命中为止,而非数完全部
关键结论 :判断"有没有"用 LIMIT 1 + IF FOUND,别用 count(*)------一个"找到就停",一个"数完全部",大表上差一个量级(官方 9.21:count 全量计数与表大小成正比)。
场景2:count 星号与 count 列:NULL 语义差异
表设计:orders 表,remark 列 30% 为 NULL,含少量整行全 NULL 的脏数据
✅ 正确认知(官方 4.2.7 / 9.21 语义)
sql
SELECT count(*) FROM orders;          -- 所有输入行,全 NULL 行也计入(空值纳入统计)
SELECT count(remark) FROM orders;     -- 只统计 remark 非空的行,NULL 不计入
-- count(f1) = f1 非空的输入行数(count 忽略 null)
SELECT count(*) - count(remark) FROM orders;   -- 差 = remark 为 NULL 的行数
关键结论 :count(*) 数所有行(含全 NULL 行);count(col) 只数该列非空的行------差一列 NULL 语义就不同,统计口径错位是常见坑。
场景3:去重计数的取舍
表设计:orders 表,user_id 可重复,业务要"有多少个不同用户下过单"
✅ 正确认知(distinct 语义与成本)
sql
SELECT count(distinct user_id) FROM orders;   -- 不同的非空 user_id 个数(官方 4.2.7)
SELECT count(user_id) FROM orders;            -- 非空 user_id 的行数(不去重)
-- count(distinct f1) = f1 不同的非空值的个数

-- 高频路径上的去重要谨慎:distinct 需要排序/哈希聚合
-- 可以先 GROUP BY 预聚合到小表,再 count
SELECT count(*) FROM (SELECT user_id FROM orders GROUP BY user_id) t;
关键结论 :count(distinct col) 忽略 NULL、只统计不同非空值,且带去重成本------数"多少个不同值"才用它;高频查询可先 GROUP BY 预聚合(第 22 篇:聚合一次再复用)。
场景4:多列计数:null 也要被计入(用户核心点)
表设计:orders 表,业务要按 (user_id, status) 组合统计"记录数"与"不同组合数"
✅ 正确写法(行构造器多列计数)
sql
-- 多列计数:即使两列全为 NULL 也会被计数,(null, null) 有效
SELECT count((user_id, status)) FROM orders;

-- 多列去重计数:同样 (null, null) 有效
SELECT count(distinct (user_id, status)) FROM orders;

-- 官方依据:count(expression) 统计输入值不为 NULL 的行(9.21)
-- (col1, col2) 是行构造器(4.2.13),生成复合值:字段全 NULL 时复合值本身仍非 NULL → 计入
-- 验证:
SELECT count((NULL, NULL));   -- 返回 1,(null, null) 被计数
SELECT count(distinct (NULL, NULL));  -- 返回 1
关键结论 :count((col1, col2)) / count(distinct (col1, col2)) 按"行"计数,即使列全为空也会被计数((null, null) 有效) ------与单列 count(col) 忽略 NULL 正好相反,选型时别想当然。
五、绝对禁止的写法汇总
- 函数 / 程序里用
count(*)判断是否存在 (cnt > 0/cnt = 0)------改用LIMIT 1+FOUND(官方 9.21:全量计数与表大小成正比); - 把
count(*)与count(col)混用口径(一个含全 NULL 行、一个不含,差值是 NULL 行数); - 高频路径直接用
count(distinct col)不做预聚合(去重有排序/哈希成本); - 对
count((col1, col2))想当然认为 (null, null) 不计入(行构造器复合值:全 NULL 也计); - 报表 / 低频场景外,对大表反复执行全表 count 星号(高频全量计数是大表性能杀手)。
六、最终评审口诀(记住不踩坑)
存在检查LIMIT 1,星号数行慢又全;
单列忽略NULL值,多列null也计全。
七、总结
- 存在性判断 :函数 / 程序中不要用
count(*)判断是否有数据,很慢 (官方 9.21:count(*)全表计数工作量与表大小成正比)------用SELECT 1 FROM tbl WHERE xxx LIMIT 1;+IF FOUND,找到一行立即停(第 17 篇 Limit 提前终止); - 五种计数方式 (官方 9.21 / 4.2.7):
count(*)数所有行(空值纳入统计 );count(col)数该列非空 行;count(distinct col)数不同非空值 ;count((col1, col2))多列计数、全 NULL 也计入((null, null) 有效) ;count(distinct (col1, col2))多列去重、同样 (null, null) 有效; - 原理 :(col1, col2) 是行构造器(官方 4.2.13)生成复合值,字段全 NULL 时复合值本身非 NULL → 按 count 定义被计入(验证:
count((NULL, NULL))返回 1); - 代价提醒:distinct 带排序/哈希成本,高频路径先预聚合。
标签:PostgreSQL 数据库 性能优化
参考来源
- PostgreSQL 官方文档 9.21 Aggregate Functions(count() 计算输入行数、count(expression) 统计输入值不为 NULL 的行数;性能 Note:count( ) 全表计数工作量与表大小成正比)------ www.postgresql.org/docs/curren...
- PostgreSQL 官方文档 4.2.7 Aggregate Expressions(count 忽略 null、count(f1) 非空行数、count(distinct f1) 不同的非空值个数、DISTINCT 多表达式按不同值集合调用)------ www.postgresql.org/docs/curren...
- PostgreSQL 官方文档 4.2.13 Row Constructors(行构造器生成复合值、IS NULL / IS NOT NULL 判定)------ www.postgresql.org/docs/curren...