目录
前言
学习赵老师讲授的强化学习的数学原理视频,本篇文章记录第八讲 Part 7:值函数近似(DQN-Experience replay),记录个人学习笔记,和大家一起分享交流😄
1. Deep Q-learning - Experience replay
除了刚刚的 "双网络" technique 之外,还有一个很重要的 technique --- experience replay(经验回放),下面我们要回答两个问题:第一个:经验回放是什么,第二个:为什么要使用经验回放,我们先来看一下经验回放是什么。
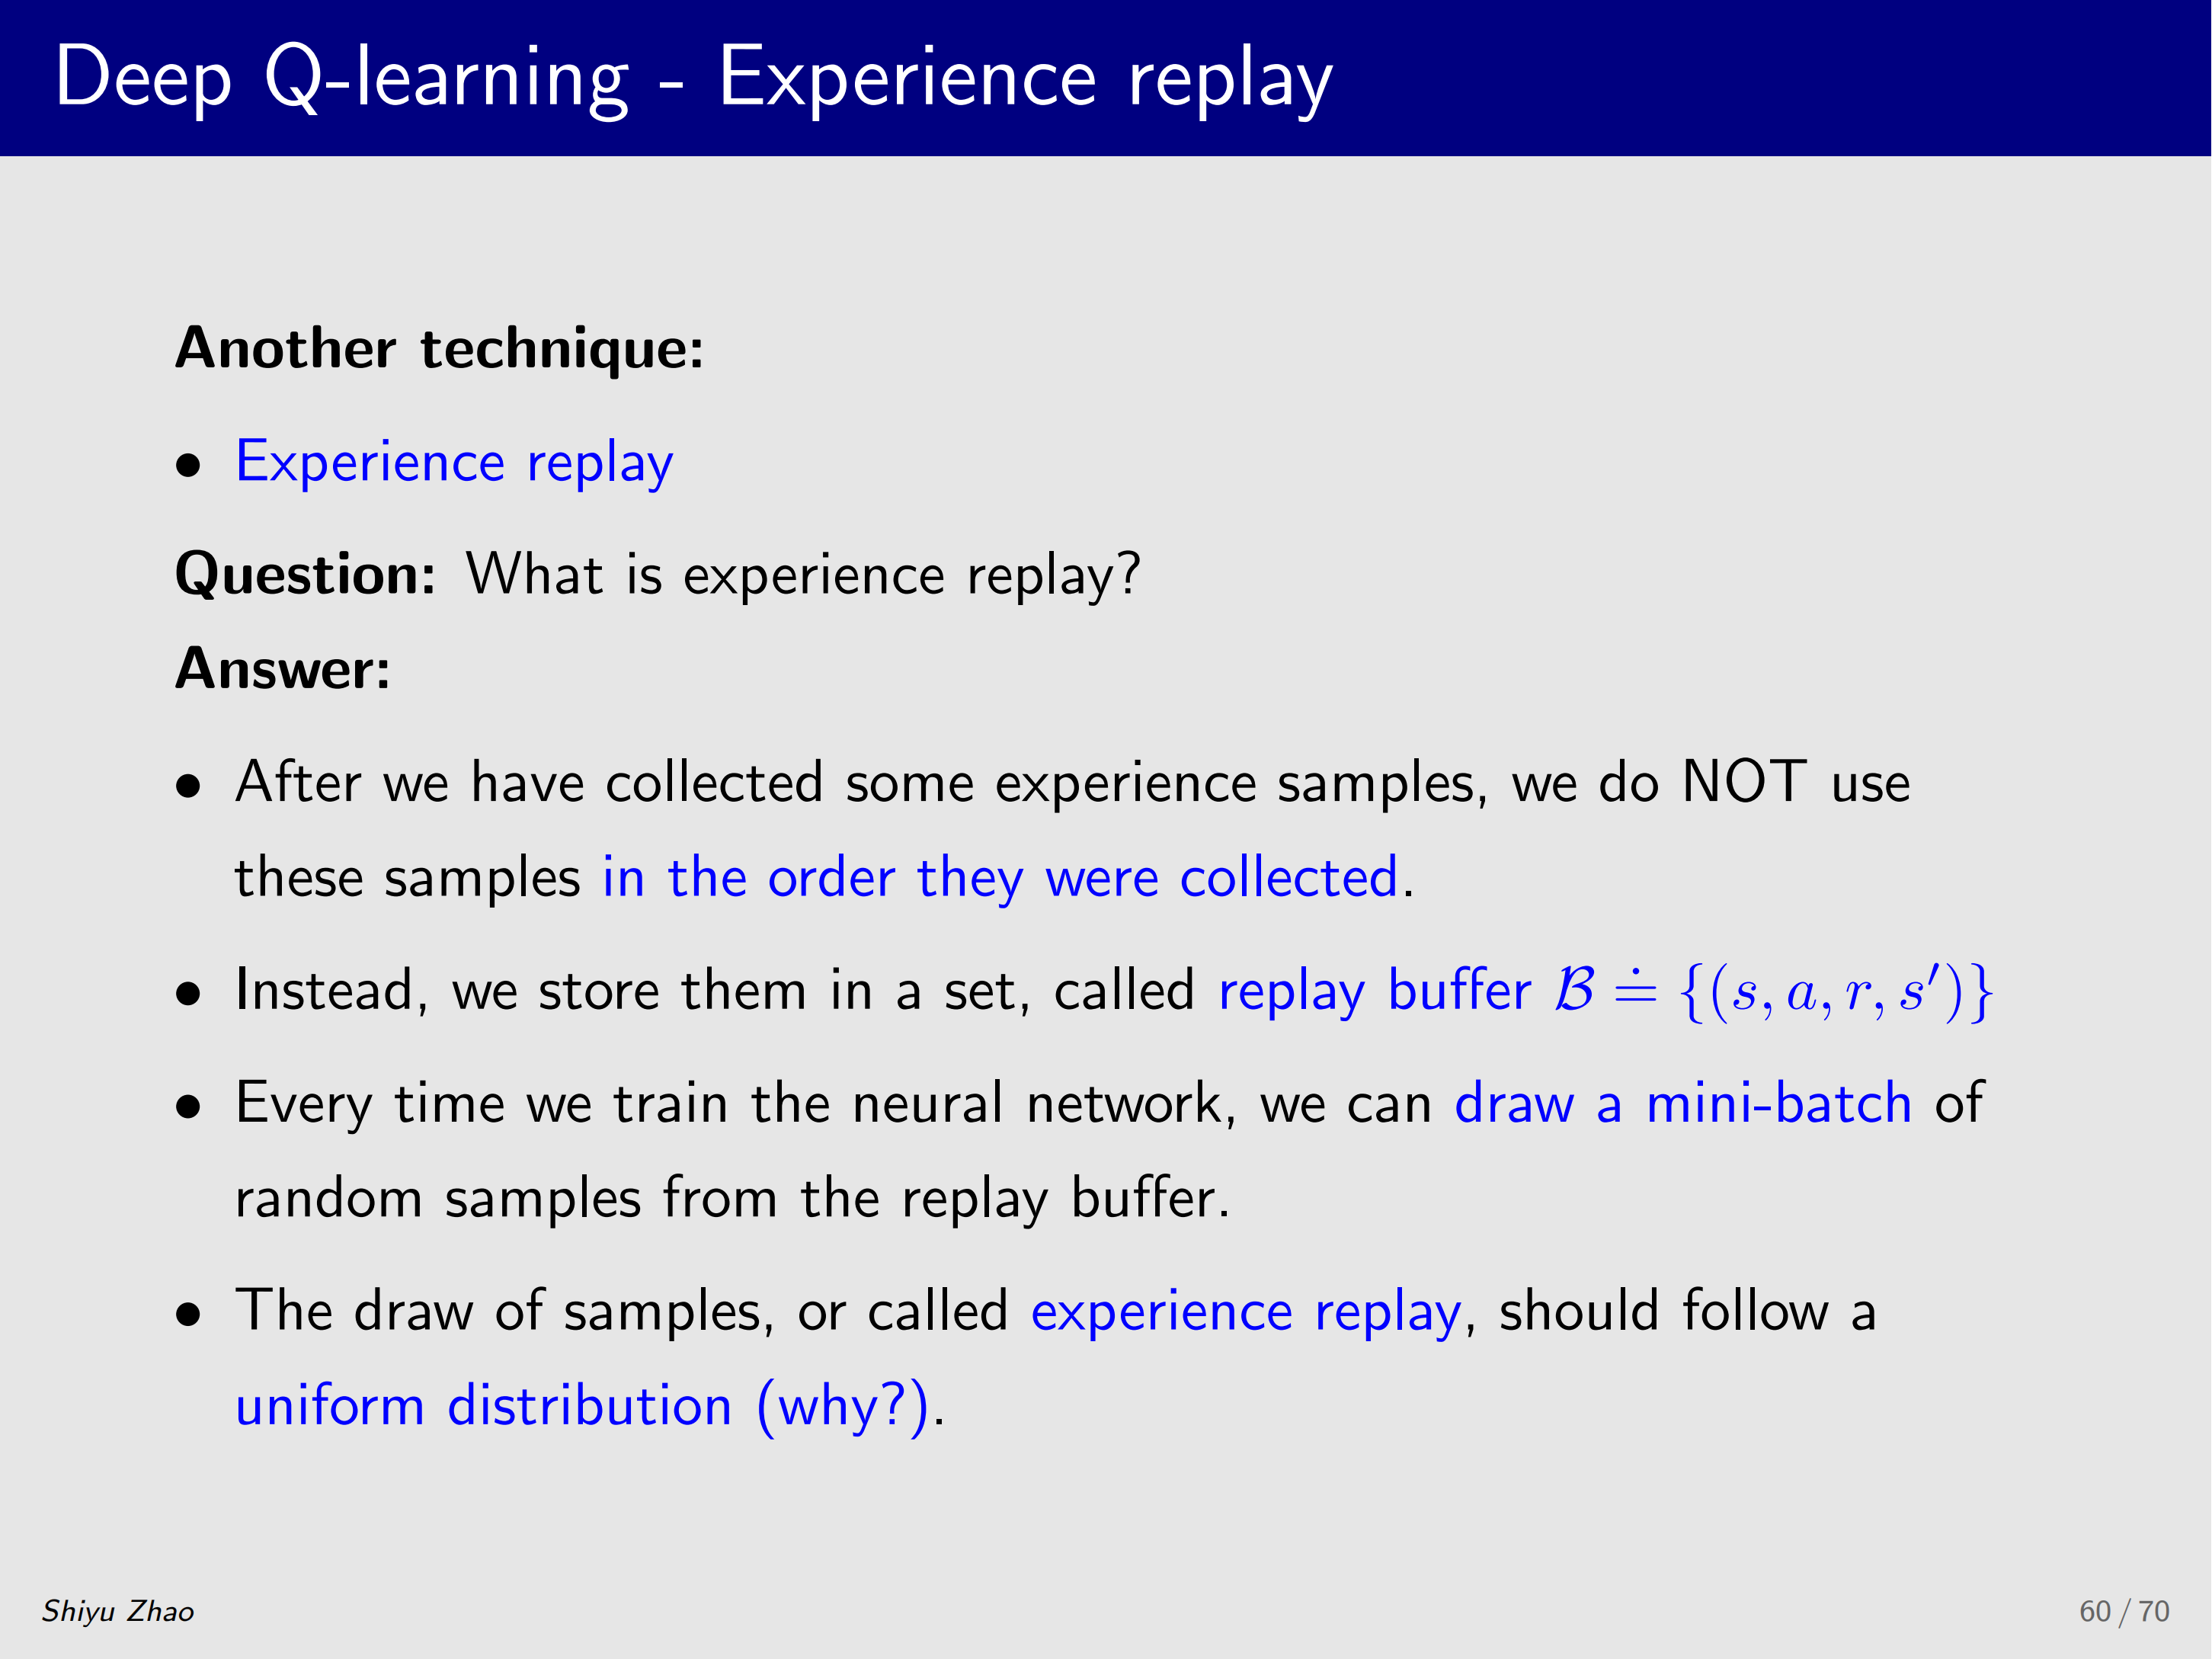
我们在收集数据(experience sample)时一定有先后顺序,但是我们在使用这些 sample 的时候, 不一定要按照它们的先后顺序 ,不是谁先来就先使用谁,我们怎么使用呢?我们把所有的数据全放到一个集合 B ≐ { ( s , a , r , s ′ ) } \mathcal{B} \doteq \{ (s,a,r,s') \} B≐{(s,a,r,s′)} 当中,花括号代表集合,里边的每一个元素就是一个 experience sample,它对应从 s s s 出发执行 action a a a ,得到的 reward 是 r r r ,跳到的下一个状态是 s ′ s' s′ ,这个集合有一个名字叫做 replay buffer。
样本数据放进这个集合后,每次训练神经网络时,不是说谁先来就先用谁,而是把所有样本混在一起,从这个集合中取一些样本来训练网络。这个 "取出来再用" 的过程就叫做 experience replay,因为经验(样本)已经在那儿了,我再把它用一次,不就是 "回放" 吗?
注意,取的时候一定要服从 uniform distribution(均匀分布),也就是每个数据点被拿到的概率应该相同,为什么呢?为什么必须要均匀分布?为什么要用 experience replay?下面我们来回答。
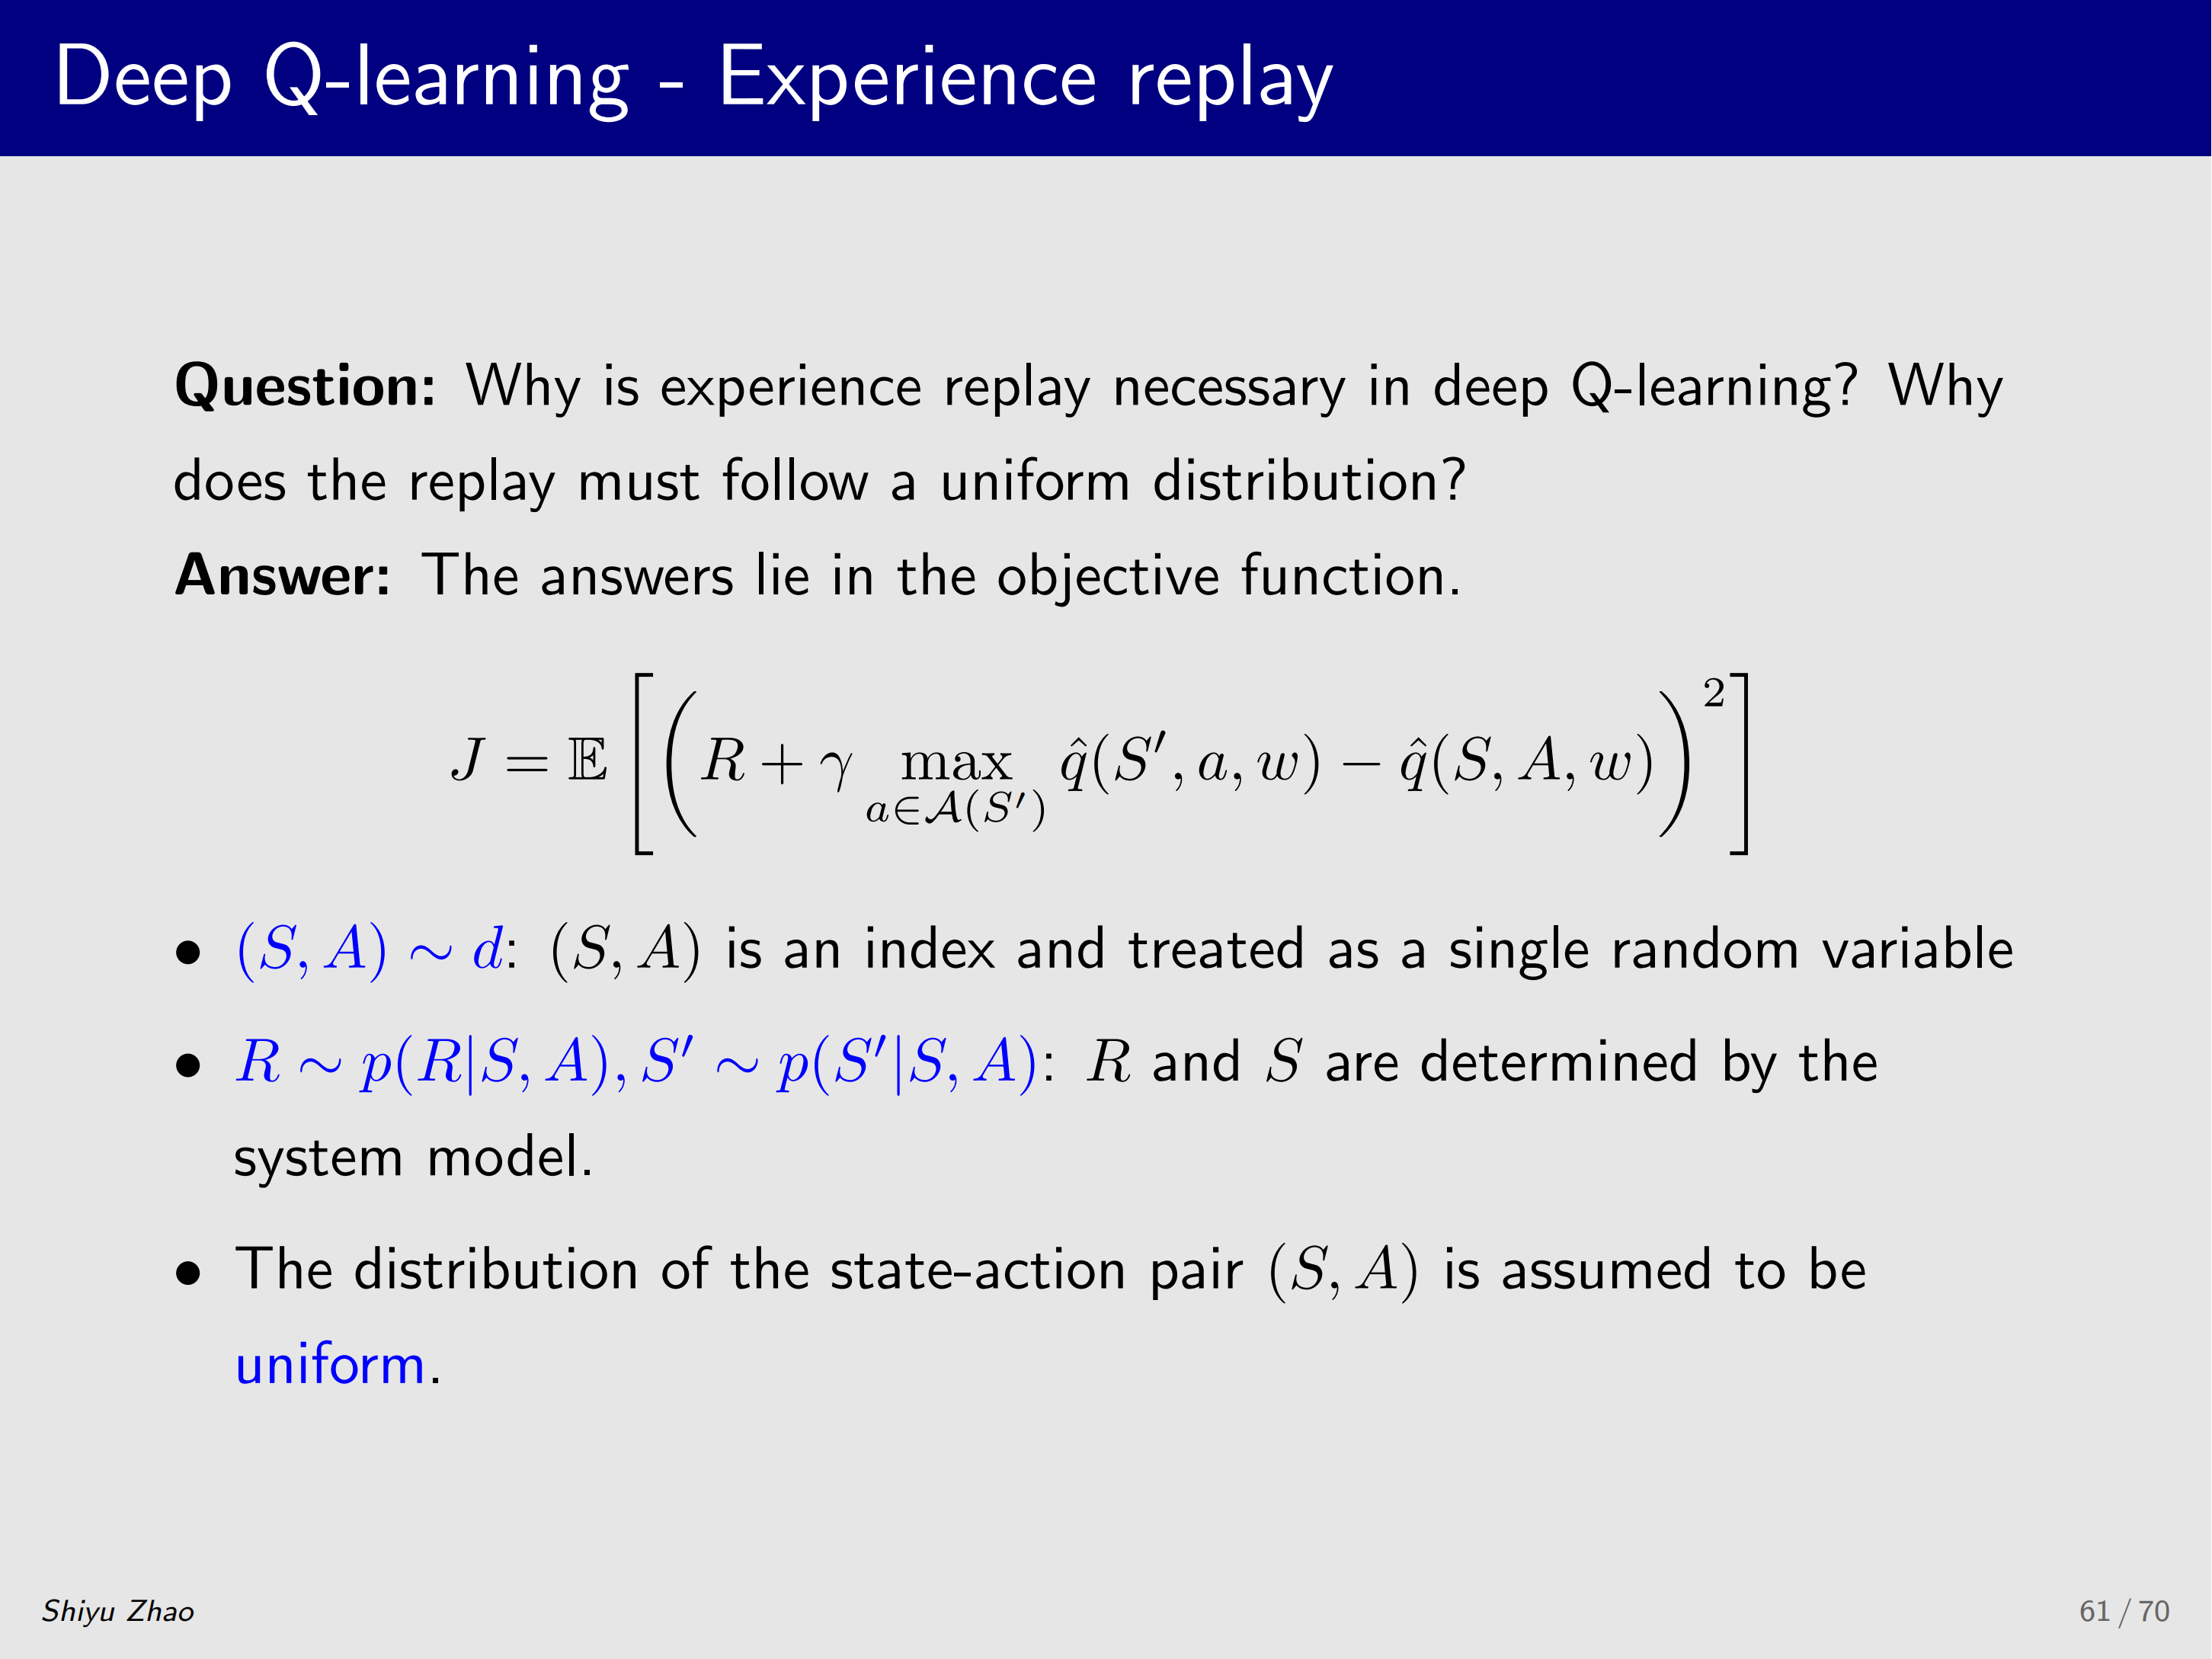
J = E ( R + γ max a ∈ A ( S ′ ) q \^ ( S ′ , a , w ) − q \^ ( S , A , w ) ) 2 J = \mathbb{E}\left \\left( R + \\gamma \\max_{a \\in \\mathcal{A}(S')} \\hat{q}(S', a, w) - \\hat{q}(S, A, w) \\right)\^2 \\right J=E(R+γa∈A(S′)maxq\^(S′,a,w)−q\^(S,A,w))2
回答这些问题要依据上面的目标函数,这个 objective function 中有几个随机变量: R R R、 S ′ S' S′、 S S S 和 A A A,我们要对这些随机变量求 expectation,就需要知道它们的分布。
首先, S S S 和 A A A 的分布是什么?注意,我们这里 把 ( S , A ) (S,A) (S,A) 整体当成一个随机变量(同时也是一个索引) ,什么意思呢?比如现在有 n n n 个状态,每个状态有 5 个 action,那么我们一共有 5 n 5n 5n 个 state-action pair,怎么索引某个具体的 "状态-动作" 对?
可以用 ( S , A ) (S,A) (S,A) 来索引,它对应 "哪个状态下的哪个动作",就像二维平面上的一个点,虽然它是一个点,但它却对应两个坐标(如 x、y),所以 ( S , A ) (S,A) (S,A) 组成了一个随机变量,服从某个分布 d d d ,即 ( S , A ) ∼ d (S,A) \sim d (S,A)∼d ,这个分布是什么呢?待会讨论。
先看另外两个随机变量: R R R 和 S ′ S' S′,当 S S S 和 A A A 给定后, R ∼ p ( R ∣ S , A ) , S ′ ∼ p ( S ′ ∣ S , A ) R \sim p(R \mid S, A), \, S' \sim p(S' \mid S, A) R∼p(R∣S,A),S′∼p(S′∣S,A)---由系统模型决定,这不需要过多讨论,回到 ( S , A ) (S,A) (S,A) 的分布上来。
这里假设它的分布是均匀分布,有的同学可能会说:为什么是均匀分布呢?其它的分布行不行呢?比如说高斯分布,比如想给某些 ( S , A ) (S,A) (S,A) 更大的权重,那么采样时当然也要更多次地用到它们,当然可以,但这样做的代价是:我们需要某些先验知识,要知道哪些 ( S , A ) (S,A) (S,A) 重要,哪些不重要,如果没有先验知识,就要一视同仁,所有 ( S , A ) (S,A) (S,A) 对应的概率都应相同,这时就是均匀分布。
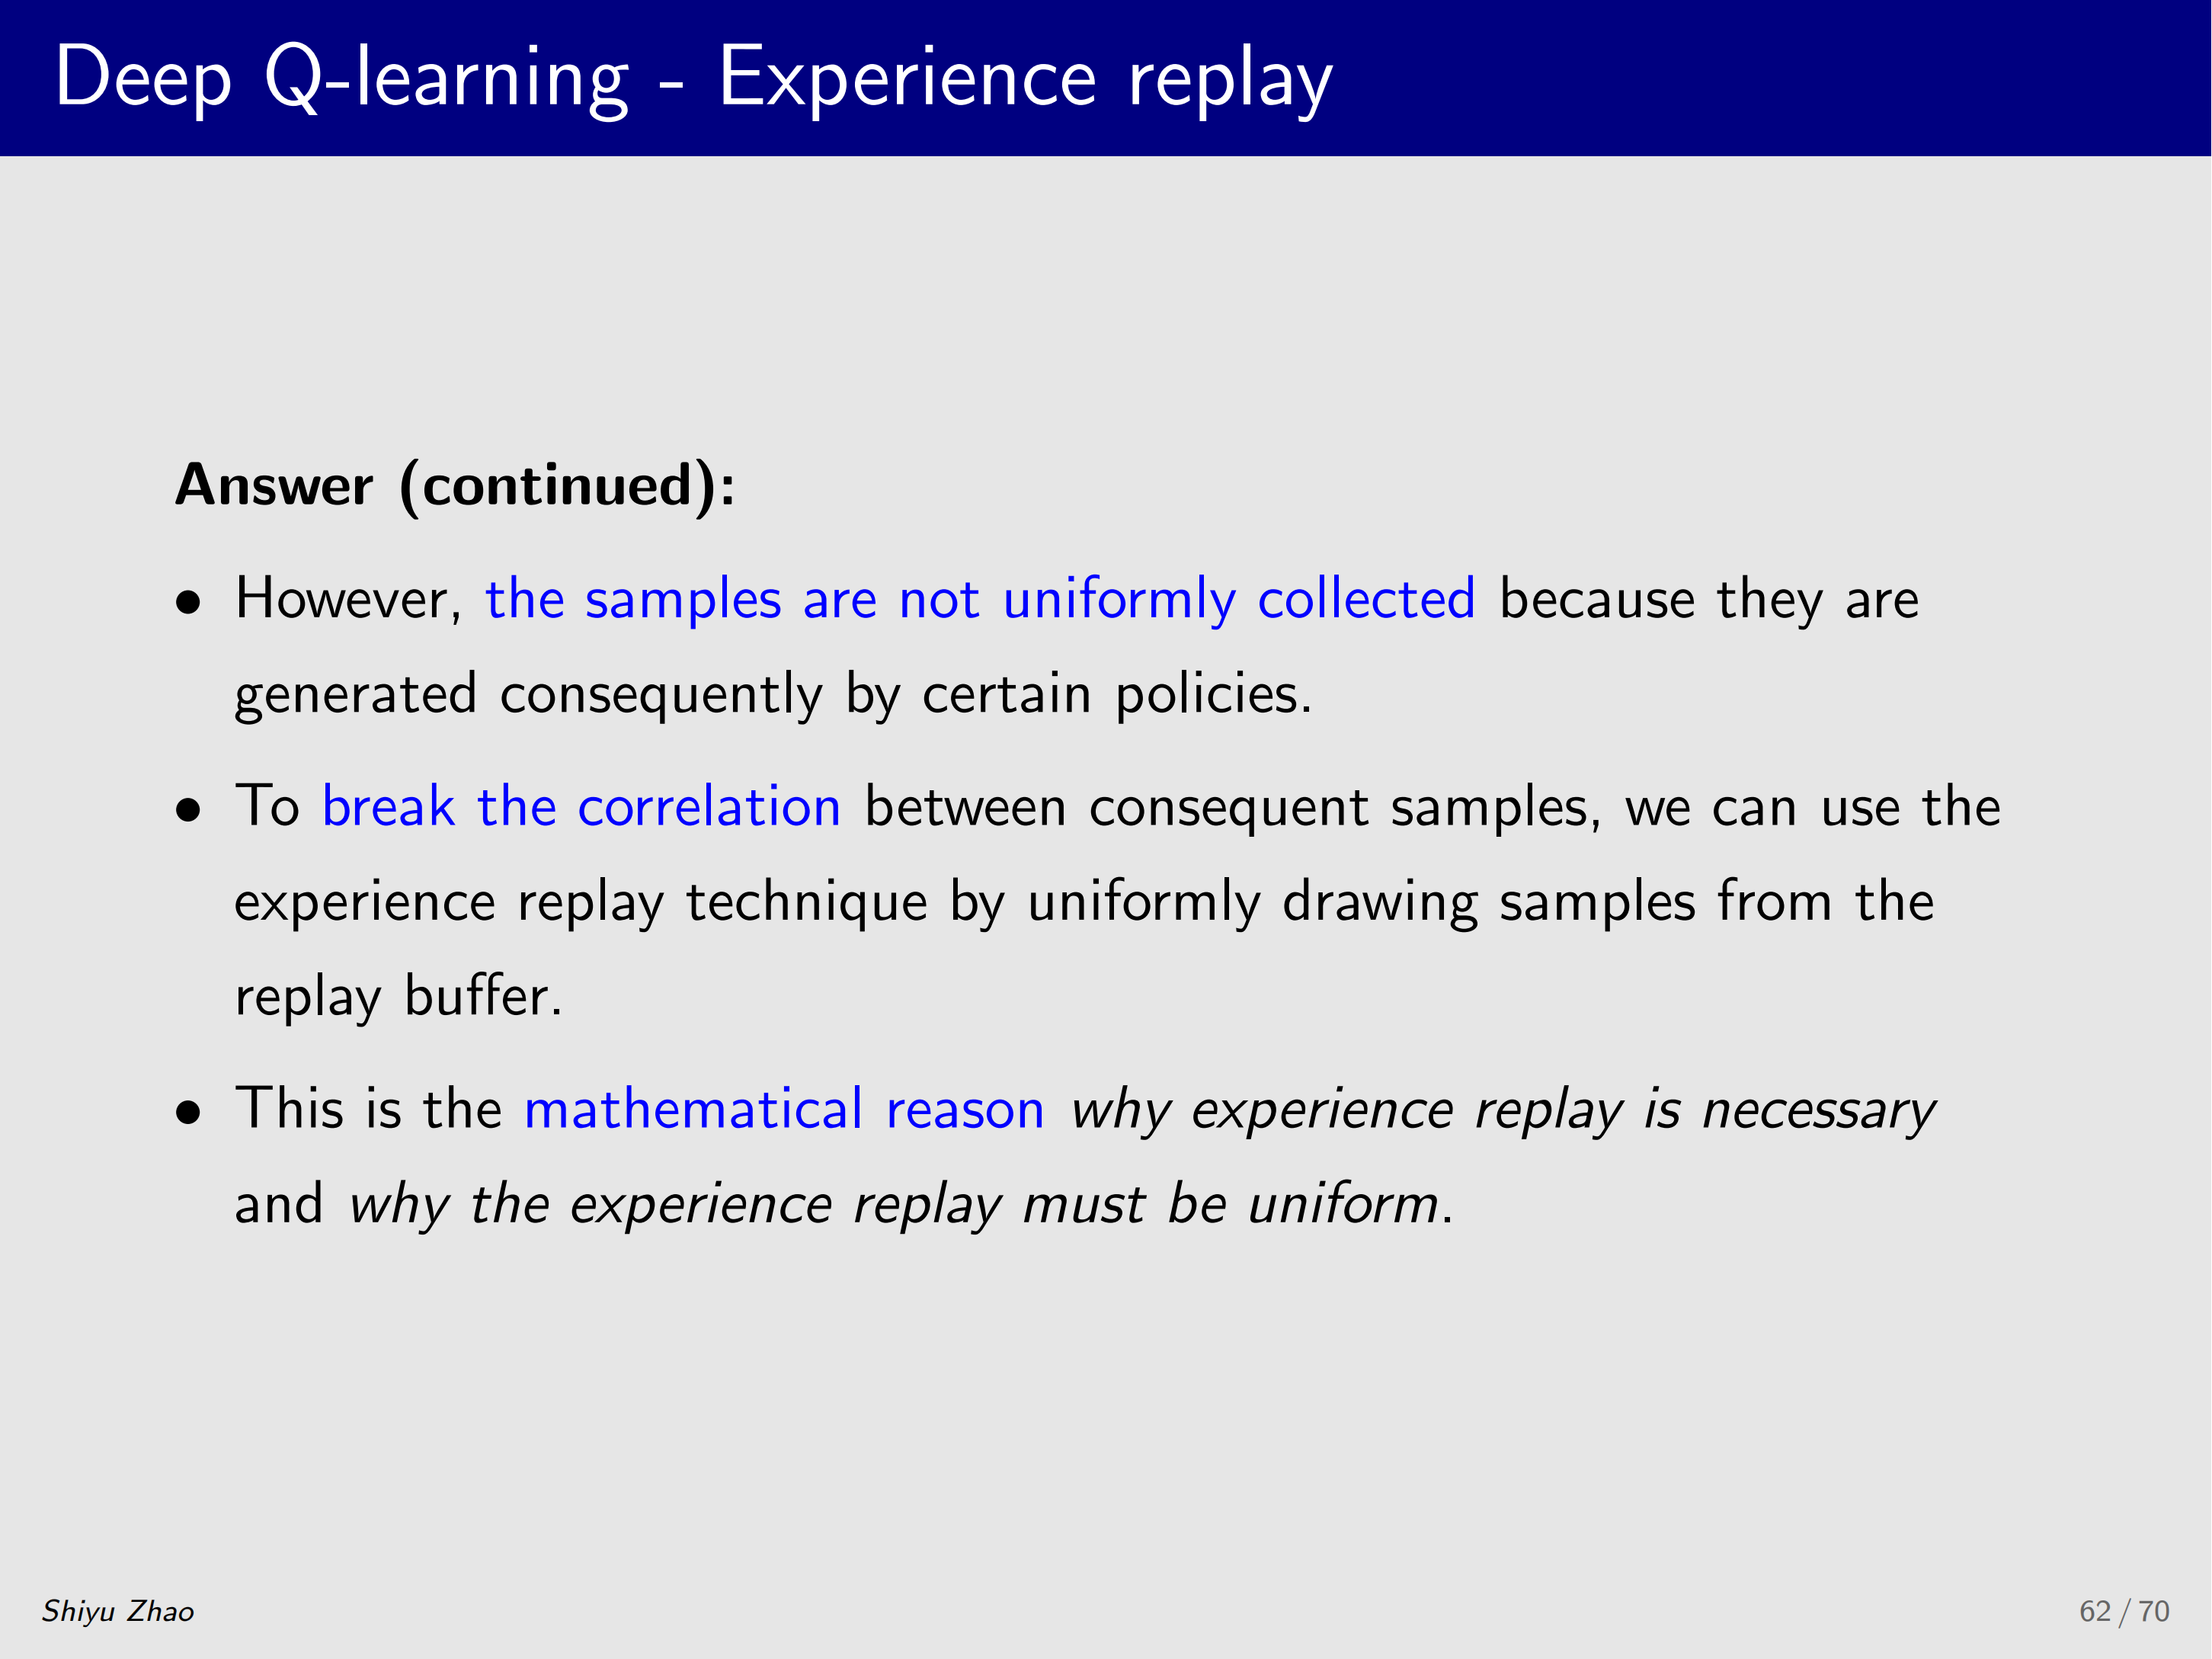
问题来了: 数学上要求 ( S , A ) (S,A) (S,A) 服从均匀分布,但采集数据时一定有先后顺序、且按其它概率分布采集 ,这时该怎么办呢?非常简单,就不按先后顺序使用它们就行,我们用 experience replay 的方法,把所有 sample 拿到一起然后打散,再从打散的集合里边均匀采样,这样的话 就可以打破不同 sample 之间的 correlation,这就是为什么 experience replay 是必须的,为什么采样要均匀的数学原因。
刚刚介绍了 experience replay 的技巧,下面不着急,先回顾一下我们之前学的基于表格的 Q-learning 中有没有 experience replay。下面问几个问题,如果这几个问题你都能比较好地回答,说明你对 Q-learning 无论是 tabular 的形式,还是基于 function 的形式都有比较好的理解。
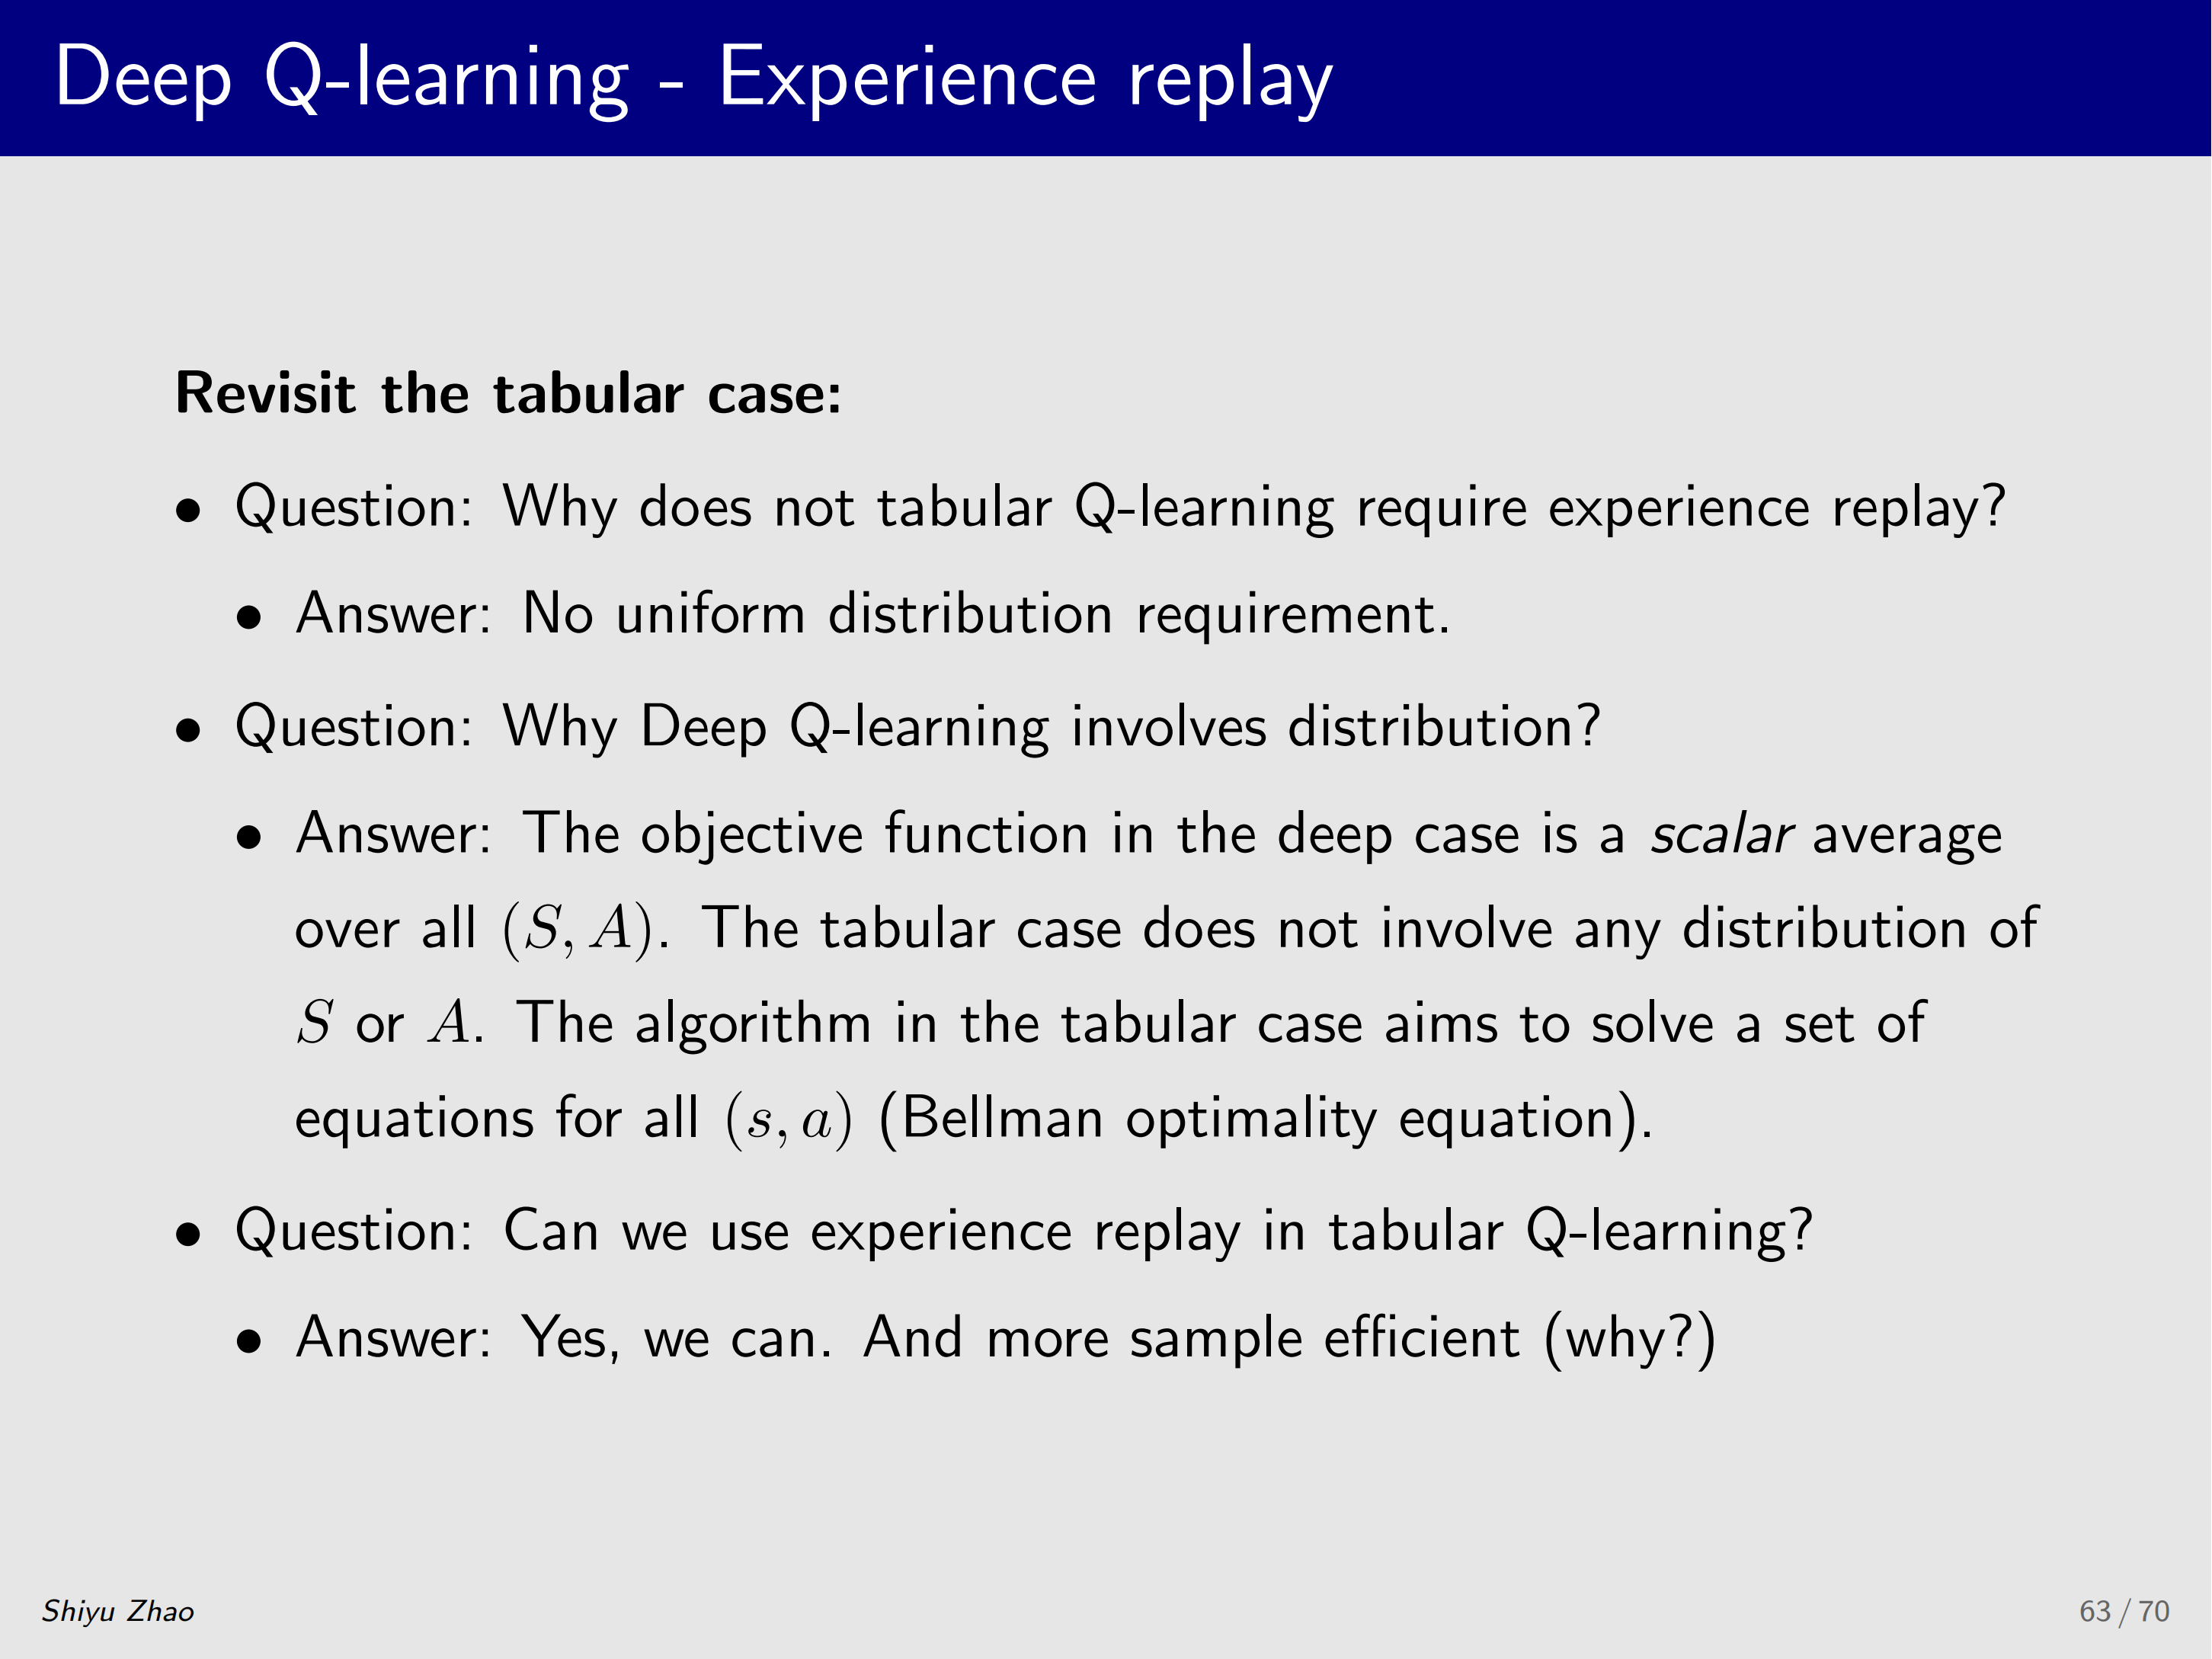
第一个问题:tabular Q-learning 中是没有 experience replay 的,这是很显然,我们之前从未提过,为什么之前没有 experience replay,而现在与 value function approximation 结合却需要呢?
答案很简单:因为之前根本没有涉及 ( S , A ) (S,A) (S,A) 的分布,只有当要求它服从某个分布(比如均匀分布)时,才需要把它打散、再均匀采样;没有这个分布要求,自然不需要这么做。
另一个问题紧接着就来了,为什么 Deep Q-learning 涉及 ( S , A ) (S,A) (S,A) 的 distribution,而 tabular Q-learning 就没有呢?
答案在于它们在干什么。Deep Q-learning 当然是 value function approximation 方法,这一大类方法都是在做 optimization ,也就是有一个标量的 objective function 要去优化,而这个标量目标函数是一个期望,里面涉及很多随机变量,其中就包括 ( S , A ) (S,A) (S,A) ,所以要定义(求解)目标函数,就必然涉及 ( S , A ) (S,A) (S,A) 的分布---分布就这样出来了。
相反,基于表格的 Q-learning(或 TD 算法)就没有这个,为什么?它们在干什么呢?基于表格的 Q-learning 在求解贝尔曼最优公式---一组等式 :每个 ( s , a ) (s,a) (s,a) 对应一个式子,把它们求出来就得到最优 action value。正是因为它们在做不同的事情,Deep Q-learning 才会涉及 distribution,而 tabular 不会涉及。
再问一个问题:experience replay 对 tabular Q-learning 虽非必须,但能不能用呢?也就是:能不能把 experience replay 应用到 tabular Q-learning 当中呢?
答案是可以的,即使基于表格也能这么用,为什么呢?因为 tabular Q-learning 也是 off-policy 算法,off-policy 不在乎数据由什么策略产生 ,可以是按时间顺序沿 episode 得到的,也可以是跳来跳去的,都无所谓,反正给什么 ( s , a ) (s,a) (s,a) ,就更新那个 ( s , a ) (s,a) (s,a) 对应的 q 即可。
而且这么做也有好处,刚才还没提到 experience replay 的好处是什么:它 可以让你的 sample 更加 efficient ,为什么呢?因为我们是在 replay buffer 中均匀采样,同一个 sample 完全可能被采到很多次,这样就可以充分重复利用每一个 sample,而之前基于表格的 Q-learning 实际上有些浪费数据。
还记得之前的仿真的例子吗?待会也会提到,之前的 tabular Q-learning 仿真一个 episode 需要 10 万步,实际上根本不需要这么多步,只需要每个 state-action pair 被访问到即可。因为是确定性的环境,所以访问很多次和访问一次区别不大,当然如果是 stochastic 环境那另当别论,所以只要访问过一次,就可以反复使用这一次的经验,而之前按时间顺序更新时,一次访问之后经验就被丢掉了,一定程度上是浪费。
这几个问题就介绍到这里,它们还是有些 tricky 的,希望大家能明白,明白之后,你对 TD 算法和 value function approximation 算法的理解会更加深刻。
结语
本讲第七部分深入剖析了 experience replay 的来龙去脉。经验回放的核心做法很简单:把按时间顺序采集的经验样本存入 replay buffer,训练时打散顺序、均匀采样。但 "为什么必须如此" 的答案藏在目标函数之中---DQN 优化的是关于 ( S , A ) (S,A) (S,A) 的期望,数学上要求 ( S , A ) (S,A) (S,A) 服从均匀分布(无先验知识时一视同仁),而实际采集的数据带有时间相关性,唯有打散重采样才能打破 correlation,使采样分布与数学假设一致。
三个追问进一步深化了理解:tabular Q-learning 之所以不需要经验回放,是因为它在求解贝尔曼最优方程---一组等式,不涉及对 ( S , A ) (S,A) (S,A) 的分布假设;而 VFA 方法在解优化问题,标量目标函数的期望中天然引入了分布要求。有趣的是,经验回放完全可以移植到 tabular Q-learning 上(因其 off-policy 性质),还能带来样本高效性的收益---同一个样本可以被反复使用,避免了时序学习中对经验的一次性浪费🤗。