AlphaZero 五子棋实战(番外二):白棋才是瓶颈 ------ 黑棋早就到顶了,白棋却永远原地踏步
前五篇讲"怎么训对 ",番外一讲"怎么训快 "。这一篇番外二,讲一个让人睡不着的现象:
同一条 v36 线上,黑棋早就封顶了,白棋却纹丝不动。
黑棋打 Rapfi 从早期 66.7% 涨到晚期 70.2%,忙活一整条线只 +3.5 个百分点 ;而同一批网执白,早期 4.1% → 晚期 2.0%,零提升 。
一查才发现,问题不在"算力不够""网络太小",而在白棋长期拿不到正反馈,policy 一代一代往外漂 。
解法也不是加算力,而是颜色专精 + 同源教练(代差 0)------内部白棋从 10% 拉到 40%,4 倍。
但我不打算吹。对外打 Rapfi,白线仍然全体 0~6%,还是地板。 这篇把"内部涨了 4 倍、对外仍是 0"这个尴尬也一起写了。
全文约 5100 字,数字全部来自训练报表和本地曲线文件(
*.npy),没有估算。
适合人群
- 在跑自对弈 RL,发现"怎么练都只有一边在进步"的人
- 用"冻结教练"带学生、却总觉得学生学不动的人
- 五子棋 / 围棋这类先手有天然红利的棋:想知道后手(白)到底卡在哪
- 想知道"内部指标涨了"和"对外真变强了"是两回事的人
你将收获
① 一组反转数字 :黑棋整条线只 +3.5pp,白棋零提升(it11 4.1% → it483 2.0%)
② 白棋烂的机制------拿不到正反馈 ⇒ policy 逐代外扩 (距天元 1.98 格 → 5.09 格),以及 R11 的反证 (corr = −0.735)
③ 一个可落地的解法:颜色专精 + 同源教练(代差 0) ,内部白 4 倍
④ 一条诚实边界:对外打 Rapfi,白线一律 0~6%,外部标尺分辨不出各代(附一个污染哨兵小技巧)
目录
- [1. 先看一个反直觉的现象](#1. 先看一个反直觉的现象)
- [2. 黑棋:早就到顶了](#2. 黑棋:早就到顶了)
- [3. 白棋:为什么永远烂](#3. 白棋:为什么永远烂)
- [4. 实锤:白 policy 逐代往外跑](#4. 实锤:白 policy 逐代往外跑)
- [5. 反证:R11 不外扩,反而涨了](#5. 反证:R11 不外扩,反而涨了)
- [6. 早期能涨、后期涨不动,差在哪](#6. 早期能涨、后期涨不动,差在哪)
- [7. 插叙:我们的"教练法"长什么样,又是怎么演化的](#7. 插叙:我们的"教练法"长什么样,又是怎么演化的)
- [8. 解法:颜色专精 + 同源教练](#8. 解法:颜色专精 + 同源教练)
- [9. 交叉验证:胜率分辨不出白线各代,"均手"能](#9. 交叉验证:胜率分辨不出白线各代,"均手"能)
- [10. 但对外......白线还是 0~6%](#10. 但对外……白线还是 0~6%)
- [11. 给读者的三条建议](#11. 给读者的三条建议)
- [12. 附:一个顺手就能加的污染哨兵](#12. 附:一个顺手就能加的污染哨兵)
1. 先看一个反直觉的现象
我们这条 v36 线跑得挺久了。一直有个感觉:黑棋好像越练越强,白棋好像一直......就那样。
直到把两边的对外数据摆到一起,才看清有多离谱:
| 权重 | 执黑打 Rapfi d5 | 执白打 Rapfi d5 |
|---|---|---|
| v36_it11(早期) | 66.7% | 4.1% |
| v36_it483(晚期最强) | 70.2% | 2.0% |
| 差值 | +3.5pp | −2.1pp |
注意这是同一批网 。黑棋从 66.7% 磨到 70.2%,一整条线下来只涨了 3.5 个百分点 ------基本可以说早就到头了 。而白棋不但没涨,还倒退了。
一个网络、两条颜色,差距天壤之别。问题显然不在"网太弱",因为网执黑能打 70%。瓶颈就在白棋。
2. 黑棋:早就到顶了
先说说黑棋的"到顶"有多硬。
晚期最强网 it483,我们把它拿去和 Rapfi 逐级加深度对打:
| Rapfi 深度 | it483 执黑胜率 |
|---|---|
| d5 | 70.2% |
| d6 | 61.7% |
| d7 | 52.0% |
再加一档就跌破 55% 了------这就是天花板, d7 附近。也就是说黑棋面对"世界级引擎"能打到五五开偏上一点,已经很极限了。
再回头看那个 +3.5pp (66.7% → 70.2%):花了一整条线的算力,换来 3 个多点。黑棋这条路,边际收益已经趋近于零了。
所以想继续变强,答案不可能在黑棋身上。
3. 白棋:为什么永远烂
白棋烂,听起来像"白棋本来就难下"。确实,五子棋先手有天然红利 (黑先落一子)再加上"无禁手自由开局",黑方占优是理论常态。但"难下"解释不了"几百万局练下来一点没涨"。
真正的原因是:白棋长期拿不到正反馈。
我们的训练用的是"冻结教练"模式------黑方用一个练好的强网(教练),白方是学生。问题是,这个教练太强了 :黑方对学生常年碾压到 80% 以上胜率。
这意味着什么?白棋每局只有约 20% 的概率赢。
而强化学习是靠"赢了 ⇒ 这步强化一下"来进步的。白棋十局输八局,绝大部分动作都被标成"错",偶尔蒙对一两次还分不清是实力还是对手失误 ⇒ 有效梯度几乎没有 ⇒ policy 在探索里越飘越远。
反过来看黑棋:黑方对教练胜率高 ⇒ 走哪儿都赢 ⇒ 走的棋被稳定强化 ⇒ 越练越稳。同一套机制,黑棋吃到红利,白棋一直在挨饿。
一句话:不是白棋不想学,是它根本收不到"你这样做对了"的信号。
4. 实锤:白 policy 逐代往外跑
"拿不到正反馈 ⇒ 乱飘"不只是推测,我们有曲线。
取 R9 这一轮(白学生,代 234~359),用一批固定的局面(让白方来选点),看它的 policy 一代代往哪儿偏。距离单位是"离天元(中心)几格":
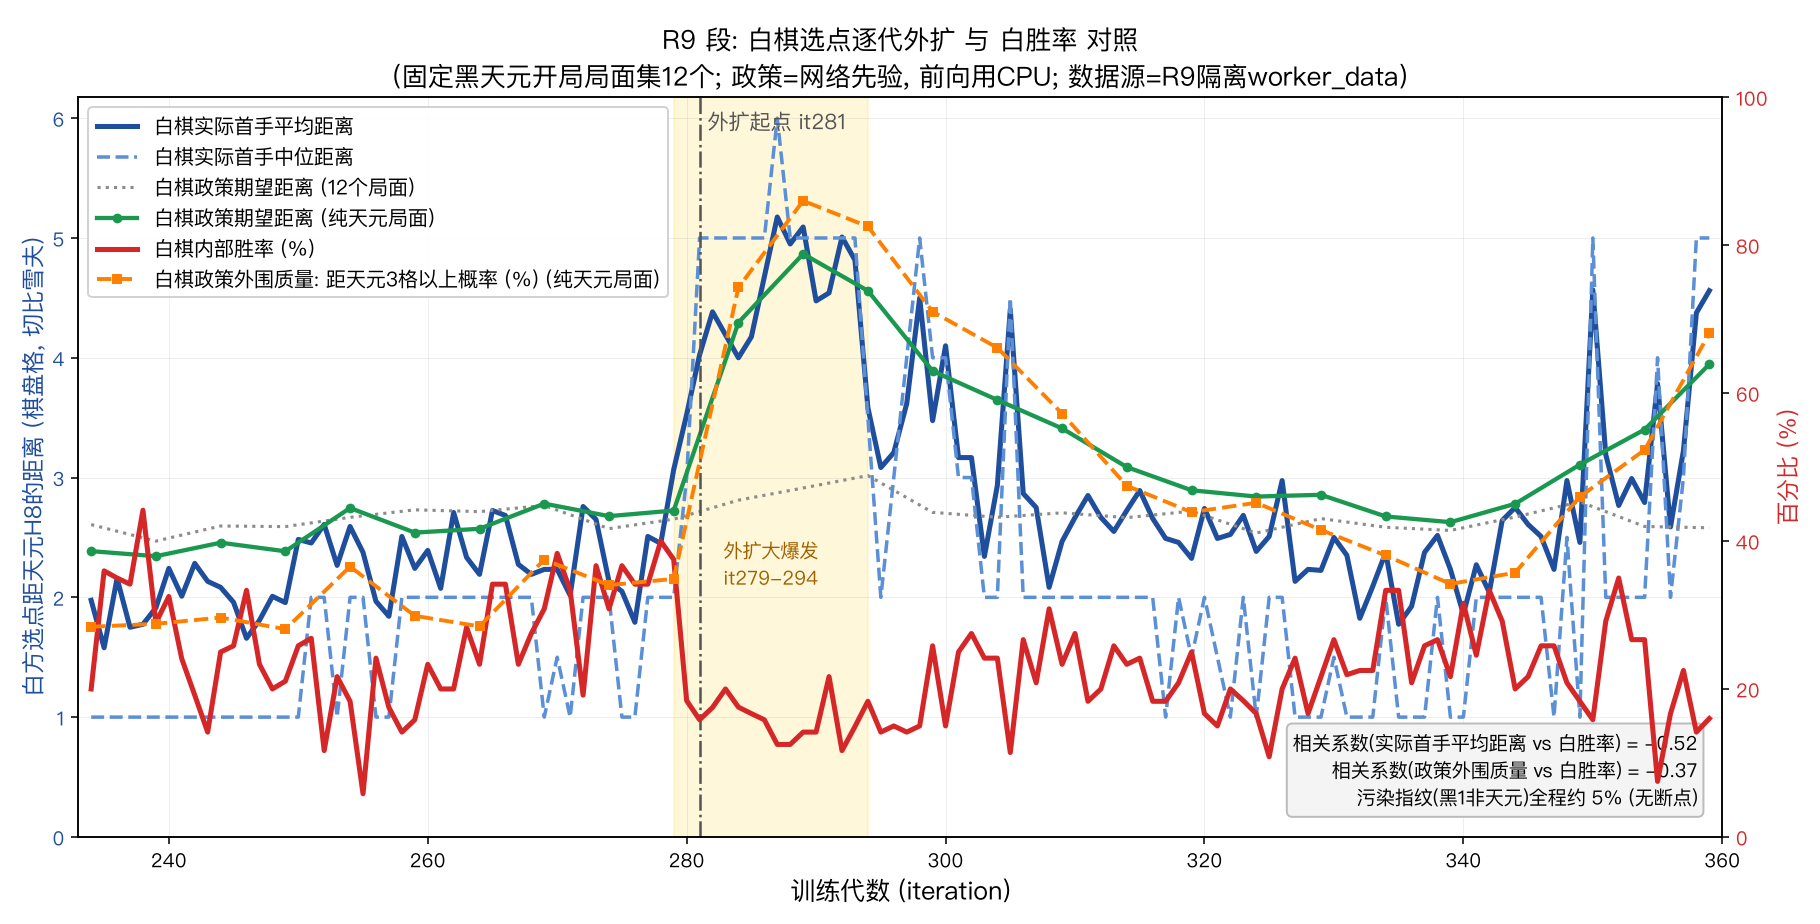
| 代 | 政策期望距离(格) | 外围(≥3格)占比 | 白胜率 |
|---|---|---|---|
| it234 | 2.39 | 28.4% | 20.0% |
| it279 | 2.72 | 34.9% | 37.5% |
| it284 | 4.29 | 74.3% | 17.5% |
| it289 | 4.87 | 86.0% | 14.2% |
| it294 | 4.56 | 82.5% | 18.3% |
| it319 | 2.89 | 43.9% | 25.0% |
| it359 | 3.95 | 68.1% | 16.0% |
配合"实际首手平均距天元"这条更细的线看:it234 起是 1.98 格,到 it289 冲到 5.09 格 。也就是白棋越来越爱往边边角角跑。
而这批"外扩"的代,白胜率恰恰是最低的 :it289 外围占比 86%,胜率只有 14.2%。
边跑边输。 这不是"发现新打法",这是"找不到出路时的乱窜"。
R9 白胜率整轮的走势也很清楚:开局冲到 41.6%(it238,第 5 代) ,之后 126 代一路退化到 16%,再没回到过峰值。
这里插一句归因的自我更正:我们一度以为是"数据污染"(显存泄漏导致教练加载失败、退化成自对弈)搞坏的。查了时间线,不成立 ------漂移起点在 10-02,最早的 OOM 在 10-03,晚了 1.5 天。污染只碰到 R9 尾巴和 R11 早期,解释不了 R9 中段的外扩 。真相还是那句:白棋没正反馈。
5. 反证:R11 不外扩,反而涨了
如果"外扩 = 烂"成立,那反过来应该也成立:不外扩的,应该越练越强。 我们找到了这个对照组:R11。
R11 换了设计------学生就是当前最强网自己的分身,教练是同一份网冻结版(代差 0)。同样的固定局面集,再看曲线:
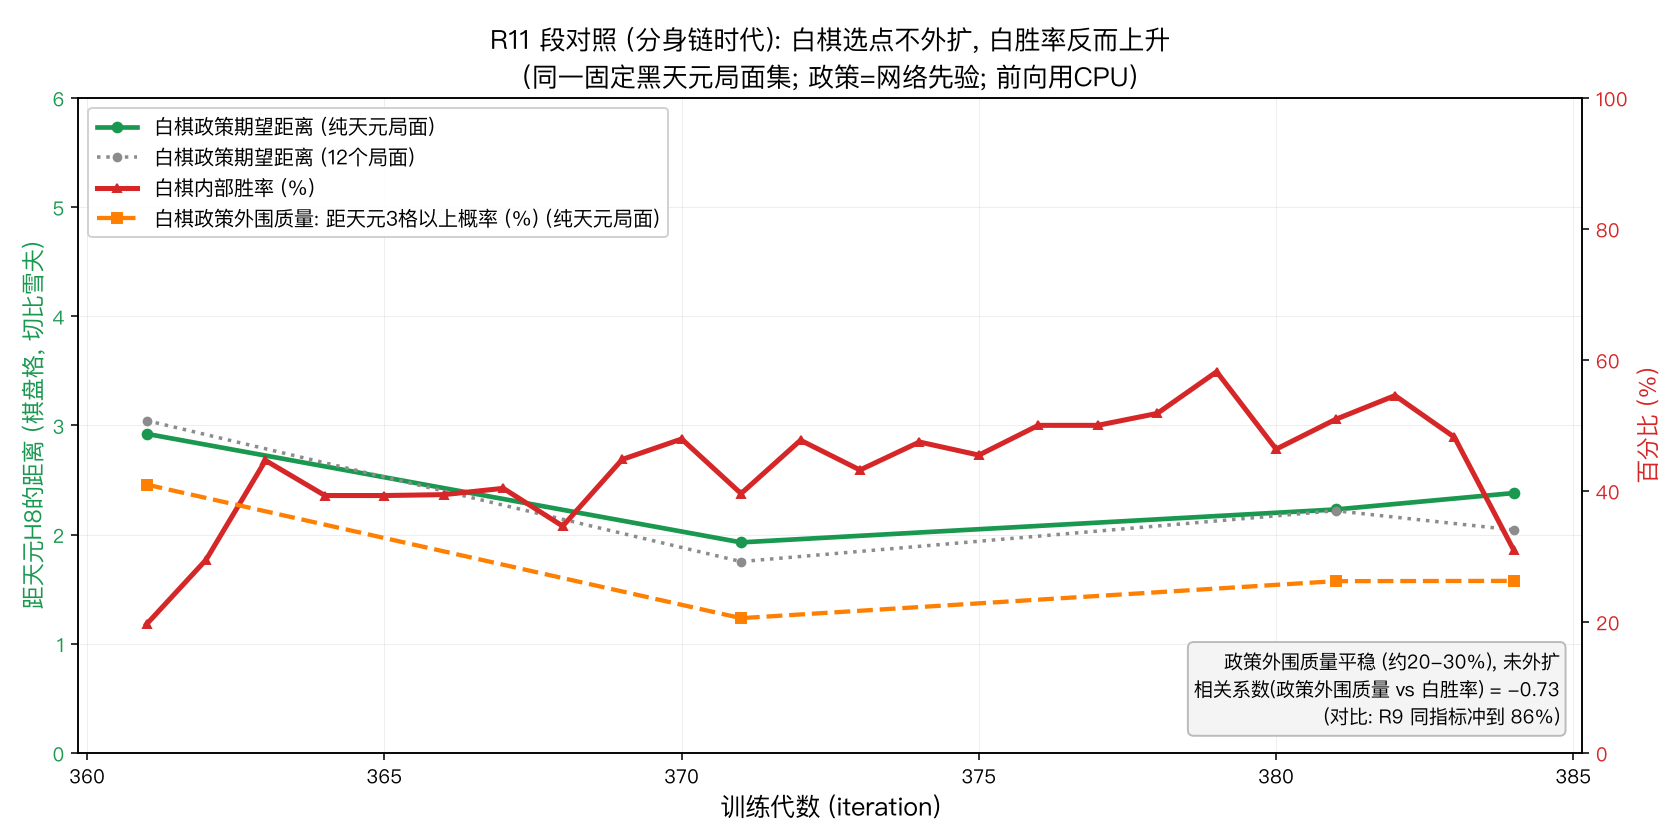
| 代 | 政策期望距离(格) | 外围(≥3格)占比 | 白胜率 |
|---|---|---|---|
| 361 | 2.92 | 41.0% | 19.6% |
| 371 | 1.93 | 20.6% | 47.9% |
| 381 | 2.23 | 26.2% | 50.9% |
| 384 | 2.38 | 26.3% | 30.9% |
两条曲线方向完全相反 :R11 的 policy 往里收 (外围 41.0% → 20.6/26.2%),而白胜率往上走(19.6% → 峰值 58.2% @ it379 → 50.9%)。
算一下相关性:corr(政策外围程度, 白胜率) = −0.735。
越不外扩,白棋越强。 R9 和 R11 一对,方向锁死了。
6. 早期能涨、后期涨不动,差在哪
那为什么早期 白棋明明能涨?R1 那轮,白棋胜率一轮从 13% 干到 58%,达标得飞快。
原因是:早期黑网漏洞多。
黑棋那时候还没磨好,白棋只要"找到黑棋的洞",就能赢------这种"钻洞"是能被正反馈强化的,所以涨得飞快。事后复盘,R1 那次涨其实定性就是"定式钻洞",不全是真本事。
后期不一样了:黑网被磨平,没洞可钻了。
白棋要赢,只能靠真的把后手棋下好 ------这难得多。R9 卡了 126 代都达不到目标,就是证据。
所以时间是白棋的敌人:越往后,黑棋越没漏洞,白棋拿正反馈越难,就越往边上飘。
7. 插叙:我们的"教练法"长什么样,又是怎么演化的
前六节把"白棋为什么烂"讲透了,但你八成一直有个疑问:这个"冻结教练带学生"的训法具体怎么摆? v38/v39 又是啥? 这一节补上------后面的 §8(4 倍提升)和 §9(均手)才好懂。
一、基本设计:双槽轮流,一轮只练一个颜色
两张网塞进同一个项目、共用一张卡,轮流练:
-
两个槽 :
v39槽 = 黑棋专精 ,v38槽 = 白棋专精 。同一时间只有一个槽在跑(号段交错:黑练到 it231 时,白那边是 it179)。 -
每轮只练一个颜色 。这一轮的"学生"练某个色,对面那个色交给上一轮练好的网 当"教练",而且教练全程冻结(不更新)。
-
★ 铁律:【本轮学生 = 上一轮的教练】。
⇒ 这句话决定了学生跟教练是同色还是异色:上一轮教练执黑,这轮学生就练黑(同色延续);上一轮教练执白,学生就练白。
(出处:
scripts/round_switch/ROUND_SWITCH_README.md「两条铁律」①;round_config.json里 R6~R9 各轮都是student_weight = 上一轮 coach_weight。)
教练冻结 ⇒ 学生一路分化、教练纹丝不动,这就是"冻结教练"模式的标准形态。
二、演化三阶段(在改什么、为什么改)
① R1~R9:连续继承(白线一根链,网络从不重置)
白槽轮里,每个学生的起点 = 上一轮的白 ------白棋这根线一直往下接 ,网络永不重置 。实测血统链(出处:_pk_v8_pull/round_boundary_audit.md「逐轮表 / 回答用户两问」):
it57(R1) → it77(R3) → it117(R5) → it179(R7) → it359(R9)
这一阶段的成绩:白线对外 2~4%,黑线对外 66~70%,而 R9 直接卡死------126 代没达标 (出处:版本演进史_v32_起.md「R9 收官」节)。
※ 口径注:文档里白线毕业生有两套编号 ------"报表代"记 it57/it79/it118/it183/it359,"权重代 / 血统节点"记 it57/it77/it117/it179/it359;同一根链,只差"对局代 itN 用 it(N−1) 权重"这一口径。本节按权重代 写,两套都在本地
版本演进史_v32_起.md与round_boundary_audit.md可查。
② R10:对照重跑(唯一变量 = 打开 COLOR_SYM)
R9 卡死后,先排一个嫌疑:是不是训练样本"视角不对称"害的? 于是 R10 = R9 同配置重跑,唯一改动 = 打开 GOMOKU_COLOR_SYM=2(视角对调增强) ,白学生复位回 it179 (出处:round_config.json R10 note,明写"唯一变量对照"、白学生复位 it179)。
COLOR_SYM=2 是什么?它对每条样本额外造一份"黑白对调 "版本:棋盘取负、qa 取负,而 prob(策略目标)不变 ------★ 关键是:这份对调样本只进 value 损失,不碰 policy 。单测把这事钉死了(scripts/test_color_sym_v39.py;数字出处:版本演进史_v32_起.md 2026-10-04 节):
| 模式 | policy 变化 | value 变化 |
|---|---|---|
| mode2(选的这个) | Δ = 3e-8(完全一致 ✓) | Δ = 9.7e-2 |
| mode1(旧严格规格) | ✗ 会【污染 policy】 | --- |
⇒ 选 mode2 是必要的:它只动 value、不污染 policy。
(※ 附带一句:后续对照发现,光"练成白棋"这件事本身就会慢慢修视角对称性,对调增强更像加速器 (4 代 vs R9 的 126 代,约 30 倍)而非救命药------出处:版本演进史_v32_起.md「视角对称性四点对照」节。)
③ R11 起:改"分身链·空降版"(学生 == 教练,代差 0)
R10 也没救活白线。R11 换了个更狠的招------★ 整段设计里最重要的一改:
- 学生 = 当前最强网的"分身";教练 = 同一份权重冻结 ⇒ ★ 学生 == 教练 (第 0 代完全相同,代差 0)。
- R11 :学生 = 教练 = v39_it231(黑网"转白",空降到 v38 槽)
- R12 :学生 = 教练 = it383(白网"转黑",空降到 v39 槽------与 R11 镜像)
- R13 :学生 = 教练 = v39_it398(黑网再"转白"------R12 的镜子)
(出处:round_config.json R11/R12/R13 段,三轮都 student_weight == coach_weight、同源代差 0;tensor 指纹 217ec806 / 34196db6。)
当时的理由 (要诚实写):R9 卡死 126 代 ⇒ 我们判断【继承链自带代差 ⇒ 学生永远追不上教练 ⇒ 这就是 R9 的死因】。R11 的"同源"就是冲这个假设去的。
三、★★ 今天的修正:动机是误判的,但效果是对的
事后又挖了一遍(就是本文 §4/§5 的那批数据),R9 的真正死因不是"代差",而是:
白棋长期拿不到正反馈 ⇒ policy 一代一代往外漂。
两条硬证据:
- 外扩曲线 (R9 段):白 policy 选点距天元 1.98 → 5.09 格 (出处:
版本演进史_v32_起.mdR9 外扩表 + 本地R9白棋选点外扩_数据.npy),而最外扩的那几代胜率恰恰最低 (it289:外围 86%,胜率仅 14.2%)。 - R11 对照 :同源之后 policy 不外扩 (外围 41.0%→26%),白胜率反而往上走 (19.6%→50.9%),corr(外围程度, 白胜率) = −0.735 (出处:
版本演进史_v32_起.mdR11 对照节 + 本地R11对照_数据.npy)。
⇒ ★★ 所以最诚实的一句话是:"改分身链"这个决策,【当时的动机是误判的,但效果上是对的】。
- 误判在于:R9 不是"被代差碾死",是"没正反馈饿死"。
- 但对了 在于:因为"学生 == 教练 "恰好让白棋**面对"自己"**⇒ 两边同水平 ⇒ 白棋赢得下来 ⇒ 正反馈回来了 ⇒ policy 自然往里收。歪打正着,可机制上恰好命中病根。
四、换轮次怎么切(工程细节,简写)
一轮跑完换下一轮,不是改个配置就完事,要走一遍固定流程:
- 清场 ------ 先停三进程(主 1 / 工兵 / 推理服务);⚠️
pkill与启动必须分两条 ssh(曾 pkill 匹配到自身)。 - 复位权重 ------ 学生/教练写成同一份(R11 起),或按铁律写成"上轮教练"。
- 重建池 ------ 换
start_pool(取最近几代);不同血缘的池空池启动(如 R12/R13)。 - 核验 ------ 跑固定体检清单,三份指纹必须一致 :①进程(主1/兵N/服1)②environ(路径 +
COACH_COLOR)③权重 tensor 指纹 (注意:不比文件 md5,容器差异会误报)。
★ 一整套是配置化 的:单一真相源 = scripts/round_switch/round_config.json,配 switch_round.sh(切换,先 --dry-run)+ check_round.sh(11 项体检)。换轮 = 改 config → dry-run → 真切 → 体检。
阶段对照小表:
| 阶段 | 学生来源 | 教练(冻结) | 结果 |
|---|---|---|---|
| R1~R9 连续继承 | 上一轮的白(同色延续,不重置) | 上一轮的教练 | 白对外 2~4%;R9 卡 126 代不达标 |
| R10 对照重跑 | 复位 it179(同 R9) | v39-it231 黑 | 唯一变量=开 COLOR_SYM=2(对照,未救活) |
| R11 分身链·空降 | = 教练(v39-it231 黑分身"转白") | 同一份 it231 | 23 代,白 22%→55%+ 达标 ✓ |
| R12(镜子) | = 教练(it383 白分身"转黑") | 同一份 it383 | 起点 73.3%(主要是黑先手红利 ✗) |
| R13 | = 教练(v39-it398 黑分身"转白") | 同一份 it398 | 对外最强白 6.1%------仍 <10% 门槛 ✗ |
(出处:R11 收官(白 22%→55%+、it378=59% / it381=57%)与 R12 建轮(起点 73.3%)见 版本演进史_v32_起.md 2026-10-04/05 节;R13 白 6.1% 见同文档 2026-10-07 白线表;血统链与分界点见 _pk_v8_pull/round_boundary_audit.md。)
8. 解法:颜色专精 + 同源教练
既然病根是"没正反馈",那药就是让白棋重新赢起来。
我们的做法两条:
① 颜色专精:白棋就专门练白棋,不去当"两头都要会"的通才。
② 同源教练(代差 0) :学生 = 当前最强网的分身 ,教练 = 同一份网冻结 。也就是让白棋对着"自己"练 ------两边水平接近,白棋能赢,正反馈就来了。
效果,用同一把尺子量(都是"执白 vs 黑锚 it231,同口径"):
| 白棋来源 | 执白胜率 |
|---|---|
| v36 网执白(从不专门练白) | 10% |
| 颜色专精 + 同源教练 | 40% |
10% → 40%,4 倍。
而且机制是自洽的:对着"自己的分身"下,白棋不再被 80% 碾压,赢下来的棋能被强化,policy 自然往里收(就像 R11 那条曲线),而不是往外飘。
9. 交叉验证:胜率分辨不出白线各代,"均手"能
下一节(§10)会说,白线对外全部贴在 0~6% 的地板上,连"谁强谁弱"都分不出 ------d5 说 it179 最强(6.4%),换 d3 又说 it238 最强,两把 Rapfi 尺子自己打架 。这不奇怪:胜率这把尺子在地板区已经失灵了,剩下的差别基本都是噪声。
但"胜率分不出"只说明这一个指标 不好使,不代表白棋各代真的没差别 。换一把尺子,档次立刻分出来------这把尺子叫均手(平均手数),说人话就是**"输棋时能扛多久"**。
为什么均手能当交叉验证? 胜率只看结果 (赢没赢),在地板区被压成一团;均手看的是过程 (这盘棋活了多少手)。一个真乱下 的网,几手就被抓死,均手极短;一个真会防守 的网,能把局面拖进中盘缠斗,均手明显变长。⇒ 均手是一条正交于胜率的信号:胜率说"大家都一样烂",均手能看出"其实有档次"。
白线各代执白打 Rapfi d5 的均手:
| 权重 | 执白均手 | 白胜率 | 出处 | 核验 |
|---|---|---|---|---|
| v36_it483(自对弈极限网) | ★ 13.3 | 2.0% | 版本演进史 C 表 · 服务器 rapfi_white_ctr | 待核 |
| v36_it11(自对弈早期网) | 21.8 | 4.1% | 同上 | 待核 |
| it79(R3 真毕业白) | 23.5 | 2.0% | 版本演进史 A 表 · 服务器 rapfi_white_grad | 待核 |
| it117(教练法白) | 25.0 | 2.0% | 版本演进史 B 表 · 服务器 rapfi_coach | 待核 |
| it238(R9 内部峰值代) | 24.9 | 4.0% | 版本演进史 D 段 · 服务器 rapfi_white_peak | 定稿 |
13.3 → 21.8 → 23.5 → 25.0 手,一条肉眼可见的台阶。 最速败的 v36_it483(13.3 手)基本是"不会下白、几手就崩 ";后段白能扛到 23~25 手 。⇒ 白棋的能力真实存在,而且分层------不是噪声。
三个补充角度
① 白赢的方式是"磨",不是"捡"。
已知规律:白胜局 96.7% 都是 >30 手的长局 (出处 R11云月雨月_Rapfi裁判_前12手.md;其原始统计未在本地逐局复核 ⇒ 待核 )。也就是白棋赢的局,几乎全是长缠斗里磨回来的 。⇒ 一个乱下的网,不可能在三十几手的长缠斗里磨赢 Rapfi。能靠磨赢,本身就是"会下白"的证据。
② 内部、对外两把独立尺子,指向同一个结论。
- 内部 (vs 黑锚 it231,同口径 10 局):教练法白 40% vs v36 网执白 10% ⇒ 4 倍 (出处
待测PK队列.md/版本演进史_v32_起.md,与 §8 同源;原始对局在服务器 ⇒ 与 §8 同档)。 - 对外 (vs Rapfi,同 depth):教练法白均手 2531 手 ≥ v36 网 13~22 手 (见上表)⇒ 也更高。
⇒ 一把尺子量"胜率"、一把尺子量"抗压时长",两把都指向"教练法白更强" ⇒ 不是单一指标的偏差。
③ 结论拧成一句:白棋"会了",但"有限"。
- 会 :能扛到中盘(均手 20+)、能靠磨赢棋(96.7% 靠长局)------相对 v36 网执白 (10% / 13 手)是实打实的进步。
- 有限 :对外打 Rapfi,胜率仍卡在 0~6% 地板 ------相对 Rapfi 还差得远。
⇒ 两句不矛盾 :"会"是相对自己 (v36 网)说的,"有限"是相对世界级引擎(Rapfi)说的。
这一节正好补全 §10 那句"内部涨 4 倍 ≠ 对外强" :内部 4 倍 + 白胜局靠磨 ⇒ 确实学会了 ;可对外均手再长、胜率还在地板 ⇒ 水平仍然有限 。"会了但有限",这才是最完整的那句话。
10. 但对外......白线还是 0~6%
这一段必须写清楚,不然就是吹。
内部白棋涨了 4 倍,不代表对外真的能打了。我们把白线历代拿去打 Rapfi d5:
| 权重 | 轮次 | 执白打 Rapfi d5 |
|---|---|---|
| it57 | R1 | 2.0% |
| it118 | R5 | 2.0% |
| it183 | R7 | 4.0% |
| it179 | --- | 6.4% |
| it446 / 最新白 | R13 | 6.1% |
| v36_it483 | 自对弈 | 2.0% |
全体落在 0~6%。 事先定的"对外 ≥10% 才算练出来"的线,一个都没过。
更扎心的是:外部标尺根本分辨不出白线各代的差别。
- Rapfi d5 说 it179 最强(6.4%)
- 换 Rapfi d3(更浅)测,又说 it238 最强
两把尺子打架、结论互斥 ⇒ 说明这点差异就是噪声。 白线对外,现状就是"全部贴在 0~6% 的地板上,谁强谁弱测不出来"。
所以这篇的结论要拧成两句:内部机制上,我们找对了白棋的门(4 倍);但对外战力上,白棋还没走出地板。 内部涨 ≠ 对外强,这两件事得分开记。
📎 而上一节(§9)换了一把尺子------均手(抗压时长) ------又量了一遍:白棋确实"会了" (能扛到中盘、靠磨赢棋),只是水平还"有限" (对外仍在地板)。"会了但有限",这才是完整的那句话。
11. 给读者的三条建议
如果你也在用"冻结教练带学生"这套,这几条可以直接抄:
-
教练强度控制在 55~60%,别拉到 80%+。
教练太强 ⇒ 学生长期挨打 ⇒ 拿不到正反馈 ⇒ policy 漂移。学生"赢不了"是所有学习停滞的总根源。
-
早期可以偏强,后期必须调弱。
早期对手漏洞多,学生靠"钻洞"还能涨;后期洞被磨平,必须主动放水,让白棋还有正反馈可拿。
-
落地做法:上"对手池 + 按胜率分配算力"。
别死磕单一教练,准备一池不同强度的对手,按胜率动态挑(胜率高了换强的,低了换弱的),让学生的胜率始终维持在"能赢但要努力"的区间。
12. 附:一个顺手就能加的污染哨兵
最后送一个小技巧,纯工程,但救过我们一次。
我们给工兵加了一个探针:记录每局"黑 1 是不是走天元" 。正常教练局,黑 1 几乎恒定落在天元;一旦某代退化成普通自对弈(比如教练加载失败),这个比例会掉下来。
实测:R9 期间,教练局的黑 1 有 95.9% 落在天元;而某代悄悄退化成自对弈时,只 26%。
差别巨大,一眼看出问题。
为什么重要? 我们那次是显存泄漏 ⇒ 工兵加载教练 OOM ⇒ 静默退化成自对弈 ⇒ 训练数据被污染,而且不报错、不崩、偷偷坏。事后靠这个"黑 1 天元占比"指纹,才把污染段揪出来(R9 全段该指纹都在 4~12% 的正常区,没有断点,也反过来证明了 R9 中段不是污染------见第 4 节)。
这个哨兵的价值在于:它监控的是"数据是不是教练产的",而不是"训练有没有在跑"。 后者监控不到污染,前者能。
※ 口径说明:文中黑线/白线对外数字来自服务器/root/pk_v8/报表;R9/R11 曲线来自本地blog_articles/*.npy;"黑1天元 95.9% vs 26%"来自 R9 工兵日志统计(本次离线未复核原始日志,数字待核)。
写在最后
这条番外二的主线就一句话:v36 那条线的瓶颈在白棋,不在黑棋。
黑棋早已到顶(+3.5pp),白棋却因为"拿不到正反馈"而逐代外扩、原地打转。解法是颜色专精 + 同源教练 ,内部白棋一口气 4 倍------但对外打 Rapfi,白线还在 0~6% 的地板上,这件事我不藏。
如果你也遇到"一边在涨一边死活不动",先别加算力,先去看弱的那一边是不是根本没在赢。 大概率,问题不在算力,在"它收不到对的信号"。
👍 觉得有用就点个赞,⭐ 收藏这份曲线和三条建议,💬 评论区聊聊:你的项目里,"弱的那一边"是怎么卡住的?
番外二 · 完