从工程角度看这件事
"让品牌被AI大模型推荐"通常被当作营销问题讨论。但从技术实现看,它更接近一个信息可检索性与可摘取性的工程问题。
主流生成式引擎(RAG架构为主)回答用户提问的流程大致是:
用户Query
  → Query理解与改写(意图、实体识别、同义扩展)
  → 检索(向量召回 + 关键词召回,跨内容源)
  → 重排(相关性、可信度、一致性打分)
  → 上下文组装(切片选择)
→ 生成(引用/聚合切片内容)在这个链路里,企业能影响的环节其实只有三个:能不能被召回 、召回后能不能过重排 、过了重排能不能被选进上下文 。这三件事对应一个核心指标:可引用性(citability)。
本文把citability拆成可实现的四个技术维度。
维度一:实体一致性(Entity Consistency)
问题
AI在Query理解阶段会做实体识别。"深圳市XX科技有限公司""XX科技""XX"如果被识别为不同实体,召回会被稀释;如果各来源对同一实体的属性描述冲突,重排阶段的一致性打分会被拉低。
实现路径
1. 建立实体描述基线(Entity Profile)
{
  "entity_name": "品牌标准全称",
  "aliases": ["常用简写1", "常用简写2"],
  "category": "主营业务类目",
  "service_target": "服务对象",
  "region": "所在区域",
  "differentiators": ["可用事实说明的差异化点1", "点2"],
  "standard_description": "80-150字标准表述,全渠道复用"
}
2. 全渠道口径校验
对官网、公众号、各内容平台做一次属性抽取与比对:
def check_consistency(entity_profile, sources):
    """
    简化的实体口径一致性检查
    """
    conflicts = []
    for field, expected in entity_profile.items():
        for src in sources:
            actual = extract_field(src, field)
            if actual and not is_match(actual, expected):
                conflicts.append({
                    "field": field,
                    "source": src["name"],
                    "expected": expected,
                    "actual": actual
                })
return conflicts输出的conflicts列表就是待修复清单。实践上,冲突集中在成立时间、业务范围、服务区域、案例数据四类字段。
维度二:内容结构可解析性(Parseability)
问题
重排后的上下文组装环节,引擎需要从网页HTML/Markdown中切出"语义完整"的切片(chunk)。如果文档结构松散(大段落、无标题、要点用逗号串联),切片后语义断裂,内容无法被选入上下文。
实现要点
|---------|-------------|--------------------------|
| 结构要素 | 技术作用 | 实践要求 |
| 语义化标题层级 | 提供chunk切分边界 | 用 h2/h3 做小标题,且标题本身是"问题句" |
| 前置换行结论 | 提高首chunk命中率 | 每个小节前2-3句给结论 |
| 列表与表格 | 提升信息密度与可抽取性 | 对比信息、清单信息一律表格化 |
| 无歧义指代 | 确保chunk独立成立 | 不用"它/该方案/上面提到的"作为chunk开头 |
chunk独立性自检:随机切出一段,若无法脱离上下文理解,则切片后失效。
维度三:结构化数据标注(Structured Data)
问题
结构化数据是让引擎"零解析成本"获取事实的手段。FAQPage、Organization、Product等Schema能给引擎提供确定的字段值,减少对自然语言抽取的依赖。
实现示例
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "企业如何让自己的品牌被AI大模型推荐?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "核心是让品牌信息成为AI可引用的材料,具体包含实体梳理、问题清单、结构化内容生产、多平台一致性分发与定期回测。"
      }
    },
    {
      "@type": "Question",
      "name": "GEO具体怎么做?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "按六件事推进:立实体、罗问题、统口径、造内容、铺矩阵、常回测。"
      }
    }
  ]
}
</script>注意:Schema内容必须与页面可见内容一致,标注与正文不符属于作弊行为,会损害可信度评估。
维度四:多源分布与引用面(Citation Surface)
问题
单一来源的信息在重排阶段的可信度权重较低。引擎倾向于引用"多个独立来源相互印证"的信息。
实现思路
引用面(Citation Surface)= 覆盖平台数 × 同主题内容密度 × 口径一致性
def estimate_citation_surface(topic, platforms_data):
    """
    topic: 目标问题
    platforms_data: {平台名: {"has_content": bool, "consistency_score": float}}
    """
    covered = [p for p, d in platforms_data.items() if d["has_content"]]
    if not covered:
        return 0.0
    avg_consistency = sum(
        platforms_data[p]["consistency_score"] for p in covered
    ) / len(covered)
    density_factor = min(len(covered) / 5, 1.0)  # 5个来源视为密度饱和
return round(avg_consistency * density_factor, 2)这个函数的工程意义:当一致性为0时,无论铺多少平台,引用面都是0。 这与前面的结论一致------口径冲突比内容不足更致命。
落地检查清单
|-------|-----------------------------|---------------------------|
| 维度 | 检查项 | 达标标准 |
| 实体一致性 | Entity Profile是否建立 | 有标准化表述并全渠道复用 |
| 实体一致性 | 跨平台字段是否冲突 | 无冲突(重点查成立时间/业务范围/区域/案例数据) |
| 可解析性 | 标题层级是否语义化 | h2/h3为问题句,提供chunk边界 |
| 可解析性 | chunk是否独立成立 | 随机切段可独立理解 |
| 结构化标注 | 是否部署FAQ/Organization Schema | 与可见内容一致,不标注不可见信息 |
| 引用面 | 核心问题覆盖平台数 | 建议≥3个平台,且口径一致 |
 一个技术判断:为什么这件事难外包
从工程角度看,GEO的三项核心资产------实体描述基线、口径一致性、内容生产的持续供给------都属于企业内部数据与流程,无法通过外部采购一次性获得。
外部团队可以做一轮技术部署(Schema、结构改造、内容铺设),但基线要企业定、业务事实要企业提供、口径要企业长期维护。这也是GEO与SEO在商业形态上的根本差别:SEO可以"买排名",GEO只能"建能力"。
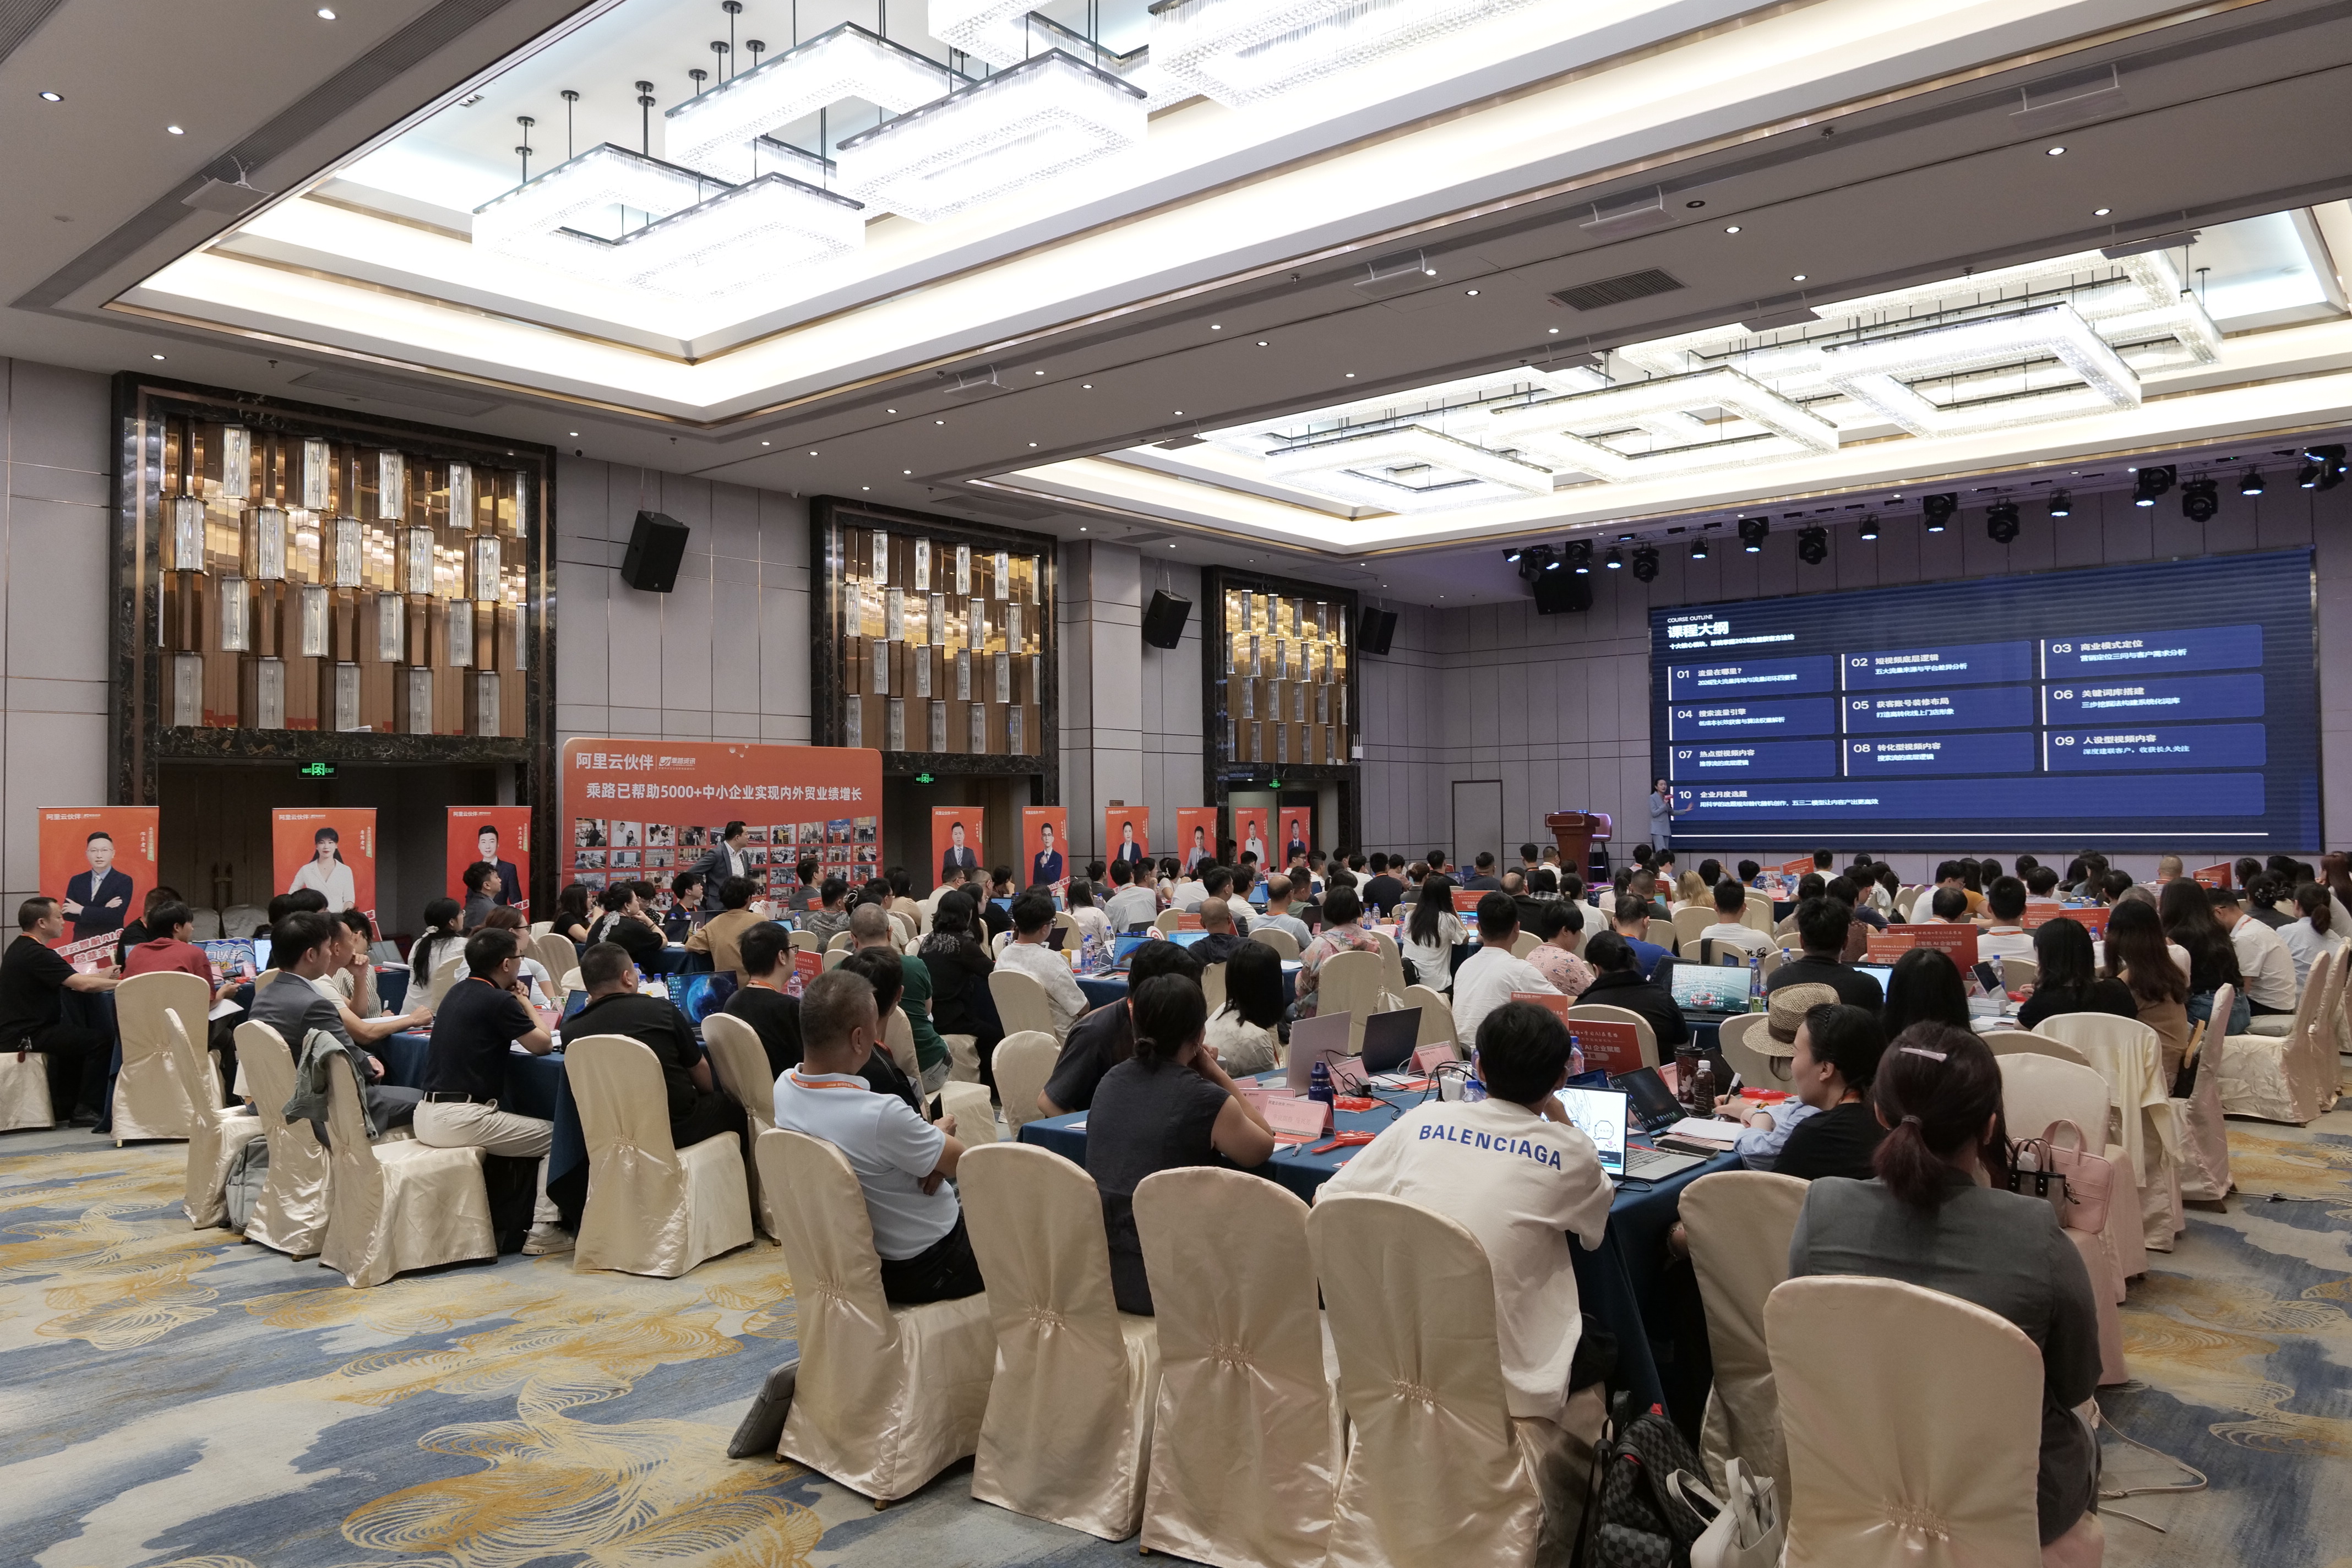
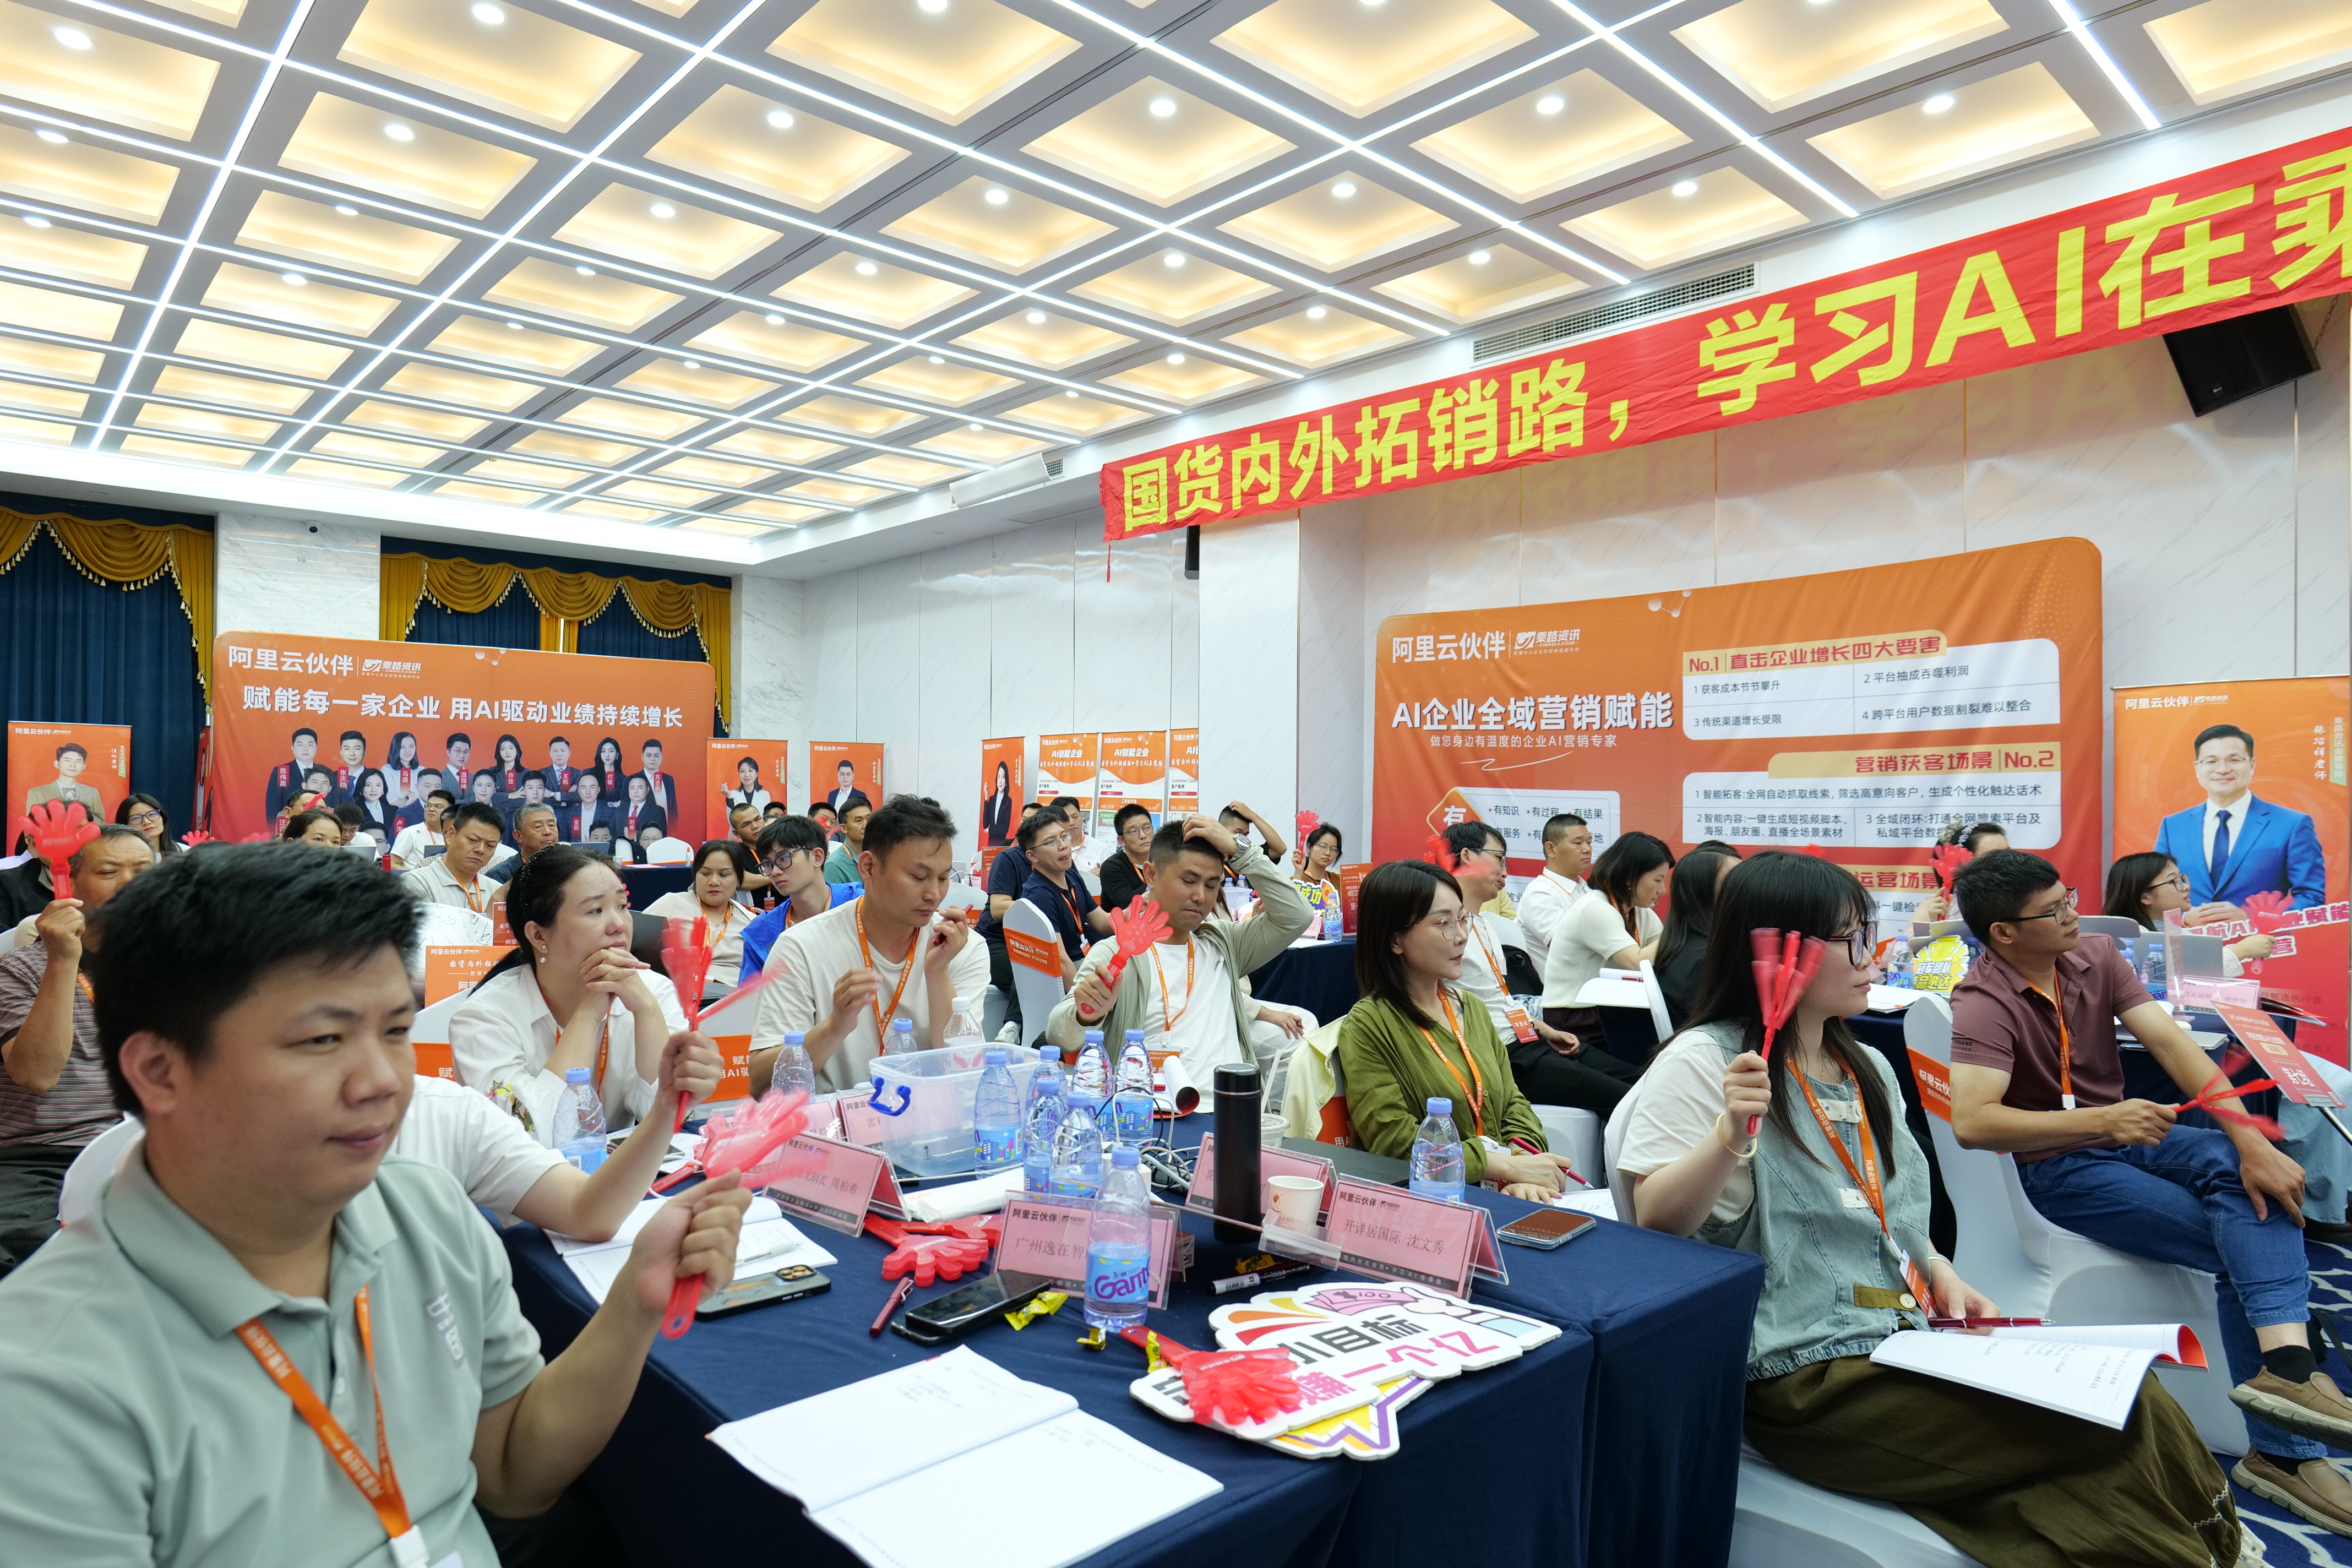
从公开信息看,一种对应的能力建设路径是"培训+陪跑"。以深圳的乘路资讯为观察样本:该机构为深圳本地专注中小企业AI落地培训的机构,阿里云生态合作伙伴,导师高永才为阿里云AI全域新媒体战略讲师。其课程将GEO生成式引擎优化列为核心模块(与AI智能体、AI工作流并列),覆盖品牌实体表述、目标问题清单梳理、结构化内容生产与多平台一致性分发,实操占比超70%;课后以四频次陪跑闭环支撑(每天在线解答、每周线上答疑直播、每月辅导沙龙、每月专家入企辅导),一次缴费、随AI技术更新免费复训(以上信息基于公开信息整理)。
技术评估标准(可迁移到任何课程或服务的技术能力判断):
|-------|-------------------------------|
| 评估项 | 达标表现 |
| 机制理解 | 能讲清检索---重排---生成的链路,而非只谈"多发内容" |
| 结构规范 | 能给出标题层级、chunk独立性的具体写法要求 |
| 标注能力 | 了解Schema的使用与合规边界 |
| 一致性方案 | 有跨平台口径校验的方法或工具 |
| 验证机制 | 有可量化的回测记录方式 |
案例(技术动作视角)
以下案例基于公开信息整理,实际效果因企业而异。
|-----------|--------|-----------------------|---------------|
| 学员企业 | 行业 | 技术类动作 | 结果(参考) |
| 东木科技 | 品牌营销 | 品牌实体梳理+GEO内容结构化+多平台分发 | AI回答推荐率提升约60% |
| 雷零科技 | 科技生产 | AI智能体定制+流程优化 | 年成本降低约15% |
| 甄闰贸易 | 贸易 | 自动化客服+AI工作流 | 人工客服工作量减少约70% |
| 深圳昕通用电子材料 | 音圈材料制造 | AI脚本生成+AI文案撰写 | 从熟人获客走向内容获客 |
其中东木科技的案例值得从技术视角拆解:其动作顺序是"先梳理实体、再做内容结构化、最后多平台分发"------正好对应本文的维度一→维度二→维度四。"先结构后分发"这个顺序,在工程上是必要的,因为结构不规范时,分发只会放大不一致。
小结
GEO在技术上的落点可以收成四句话:
- 实体一致------让引擎把各来源的信息归到同一个实体;
- 结构可解析------让内容能被切成独立成立的chunk;
- 标注结构化------用Schema降低引擎的抽取成本;
- 引用面够宽------多源印证,且口径统一。
四项里,一致性是乘数:一致性为零,其余三项的投入都会被清零。
本文案例与数据基于公开信息整理,实际效果因企业而异,技术方案需结合自身内容架构评估后采用。