Agent Memory 架构设计:短时记忆、长期记忆与 Memory 生命周期
作 者:吴佳浩(Alben)
公众号:全栈架构师笔记
系列专栏:《企业级 Agent Memory 实战指南》· 第 02 篇
导读
计算机科学的本质是状态管理,Agent 架构的本质是认知模拟。
人脑不是流水账硬盘,海马体不会把看到的每一个像素都存进皮层;一个不具备主动遗忘与反思能力的 Agent,运行两周就会被自己的历史噪音彻底淹没。
短期记忆决定 Agent 当前执行的敏捷度,长期记忆决定 Agent 跨越周期的专业度。没有分层与代谢,记忆就会沦为系统的认知负债。
在第 01 篇中,我们确立了核心认知:Memory 不是只读检索,而是一个有状态的 Memory Runtime。
但进入系统构建阶段后,很多团队会立刻掉进另一个极端陷阱:把用户说的每一句话、每一次工具执行的回包,全量向量化后丢进数据库,然后在每一轮对话前盲目召回 Top-20 塞进 Prompt。
这种粗暴的做法上线两周就会导致系统发生三大灾难性崩溃:
| 灾难现象 | 具体表现 | 架构根因 |
|---|---|---|
| 1. 记忆沼泽 (Memory Swamp) | 检索召回几乎全是"好的""收到""谢谢"等低价值口语,真正重要的配置、决策和经验被完全淹没。 | 缺乏信息密度评估(Information Density)、重要性分级(Importance Scoring)与指代消解(Coreference Resolution),原始噪音被无差别持久化。 |
| 2. 认知精神分裂 (Cognitive Split) | 前期临时假设与后期最终结论同时存在,Agent 推理过程前后自相矛盾。 | 缺乏状态覆写(State Overwrite)、版本管理(Versioning)与冲突检测(Conflict Detection),历史脏数据持续污染推理。 |
| 3. 上下文延迟失控 (Context Explosion) | Prompt 持续膨胀,TTFT(首 Token 延迟)从数百毫秒飙升至数秒,Token 成本持续增加。 | 缺乏 Token 预算管理(Token Budget)、生命周期管理(Lifecycle Management)与确定性淘汰(Deterministic Eviction)机制。 |
Memory 本质上是在模拟人类的认知系统。
如果一个系统只懂"记录"不懂"遗忘",只懂"存储"不懂"反思",它就无法演化出真正的智能。
一、核心映射:人脑认知机制与 Agent 记忆架构
人类大脑处理信息并非单层平铺,而是通过极其精密的分层机制实现高信噪比的认知管理:
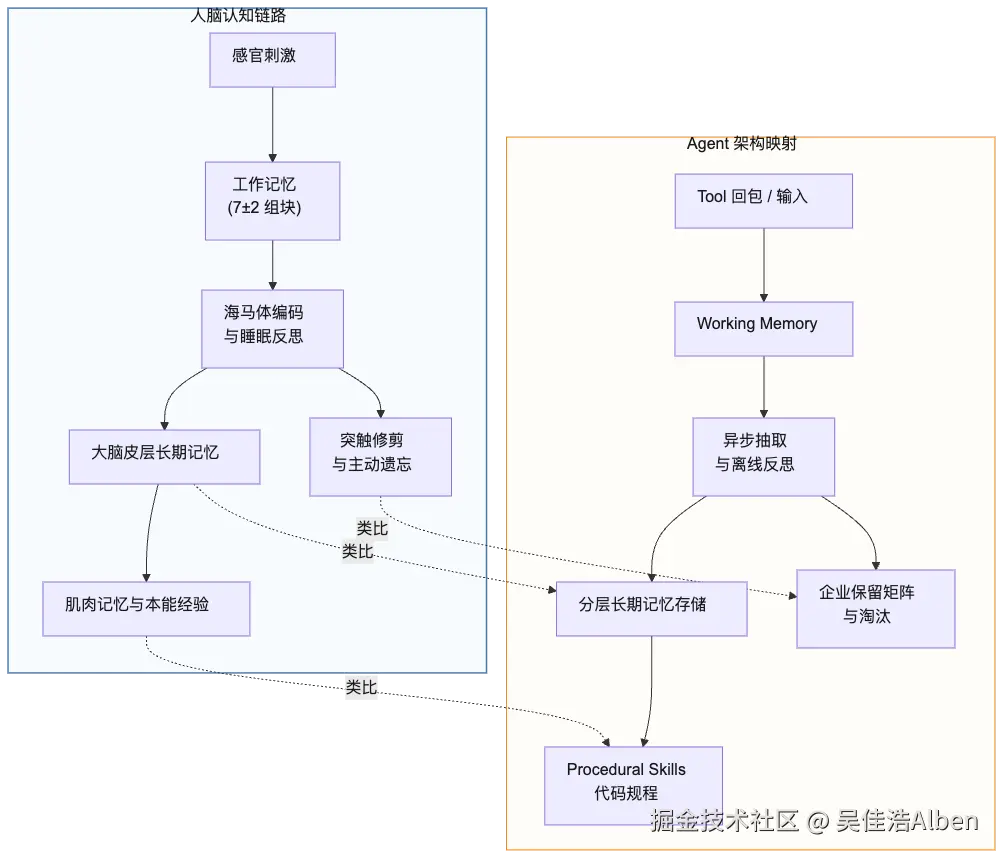
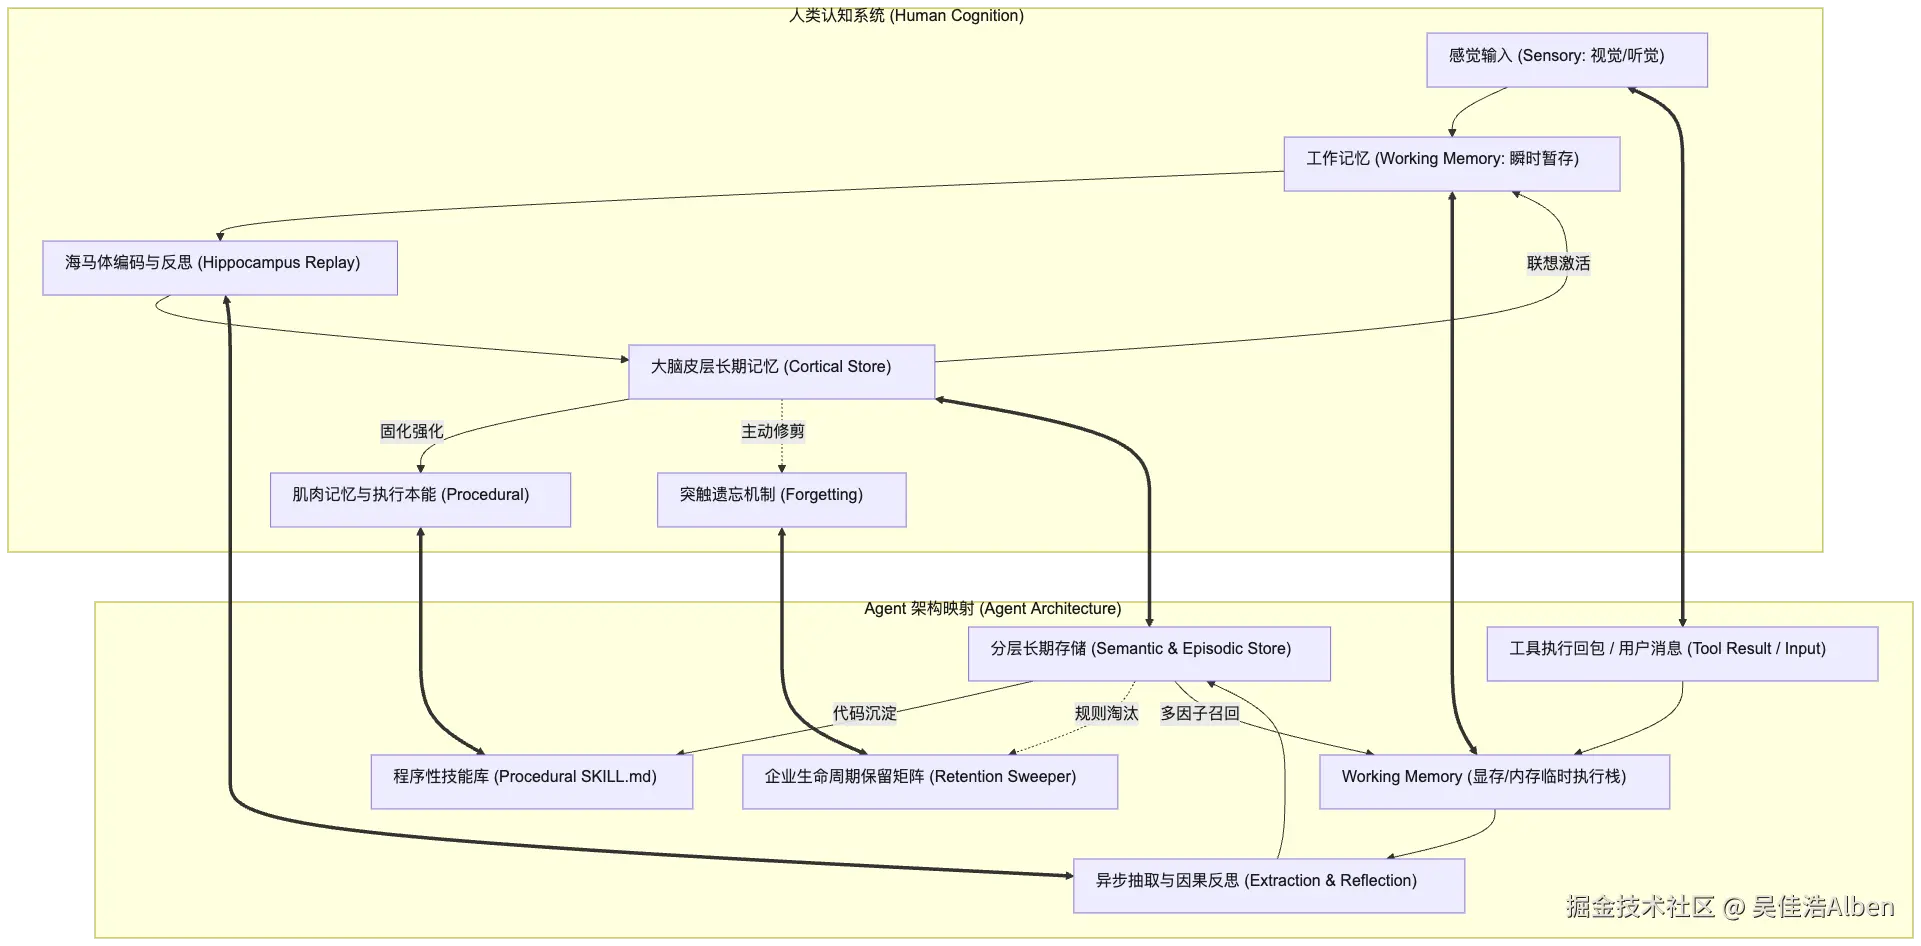
- 🔸 感官刺激与 Working Memory:对应 LLM 的 Prompt 运算栈与进程内存临时变量,随用随清;
- 🔸 海马体与长期记忆:对应离线抽取反思模块与分布式图/向量存储,负责经验提炼;
- 🔸 突触修剪与肌肉记忆 :对应企业级生命周期淘汰矩阵与经过验证的
SKILL.md程序性规程。
一句话总结这一章的核心观点:
Agent Memory 架构的最高境界,不是搭建更大的数据库,而是完美映射人脑工作记忆、长期记忆与遗忘代谢的认知闭环。
二、分层认知模型:七层记忆架构的设计取舍
工业级 Agent Memory 绝不能做成单一的大宽表,必须按照时间尺度、更新频率与确定性要求进行分层隔离:
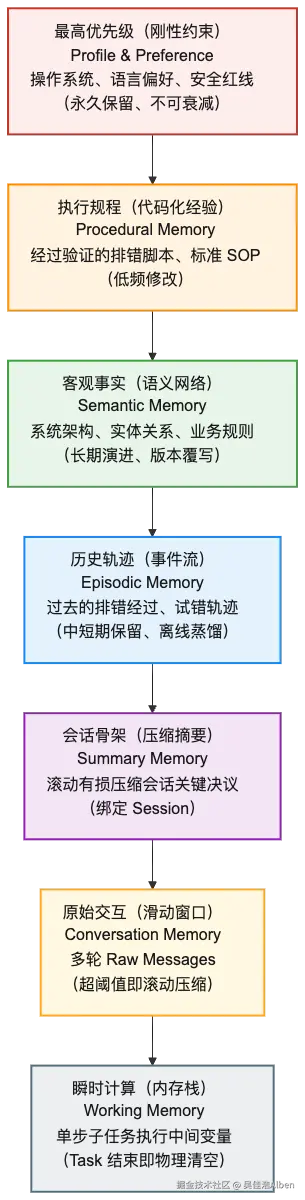
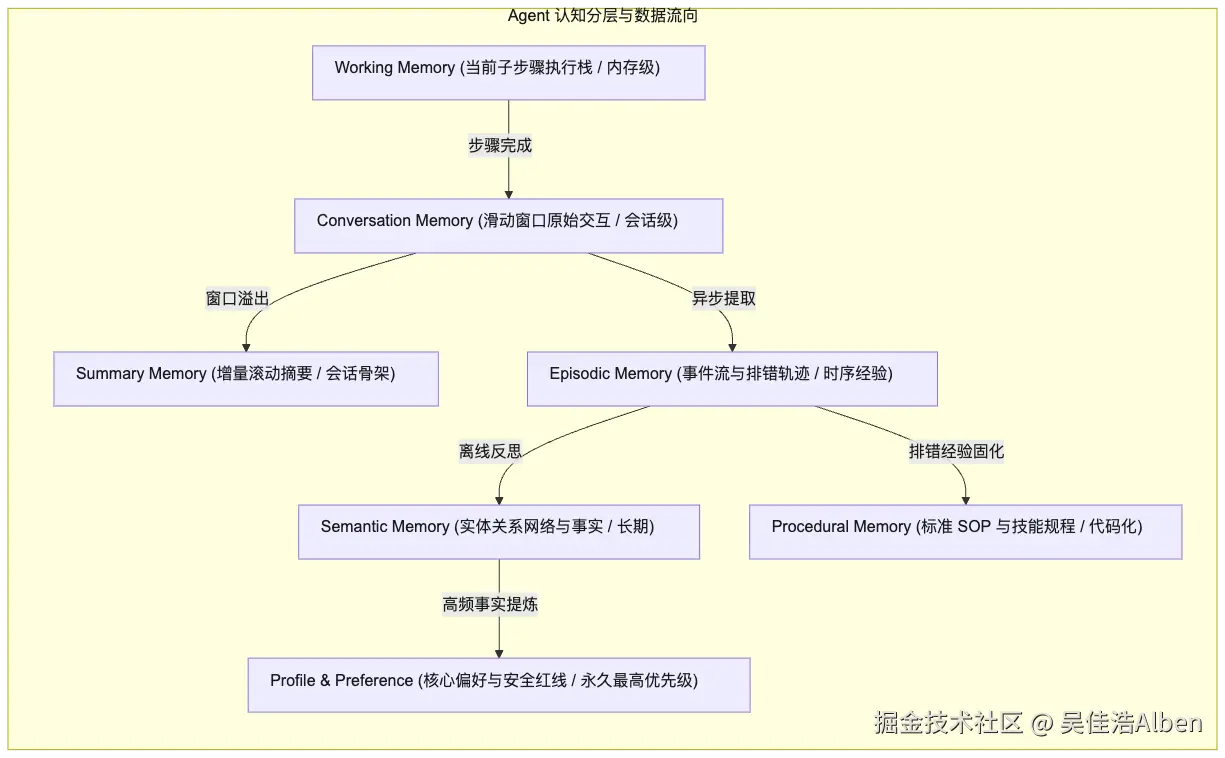
- 🔸 Profile / Preference(刚性约束):具有最高 Prompt 注入优先级,绝对免疫时间衰减;
- 🔸 Procedural Memory(程序性技能):代码化 SOP,通过工具或 Skill 显式挂载,确保确定性执行;
- 🔸 Semantic Memory(语义事实):结构化实体关系网络,支持版本覆写与置信度自演进;
- 🔸 Episodic Memory(情景事件):中短期时序轨迹,用于离线归因与反思提炼;
- 🔸 Working Memory(工作记忆):单次任务临时执行栈,毫秒级释放,不落磁盘。
一句话总结这一章的核心观点:
不同的信息有不同的半衰期和确定性要求。不做认知分层,系统就会在临时口语和刚性偏好之间产生致命混淆。
三、记忆全生命周期管道(The 5-Stage Pipeline)
一条记忆进入系统后,必须经历完整的 5 阶段代谢闭环:
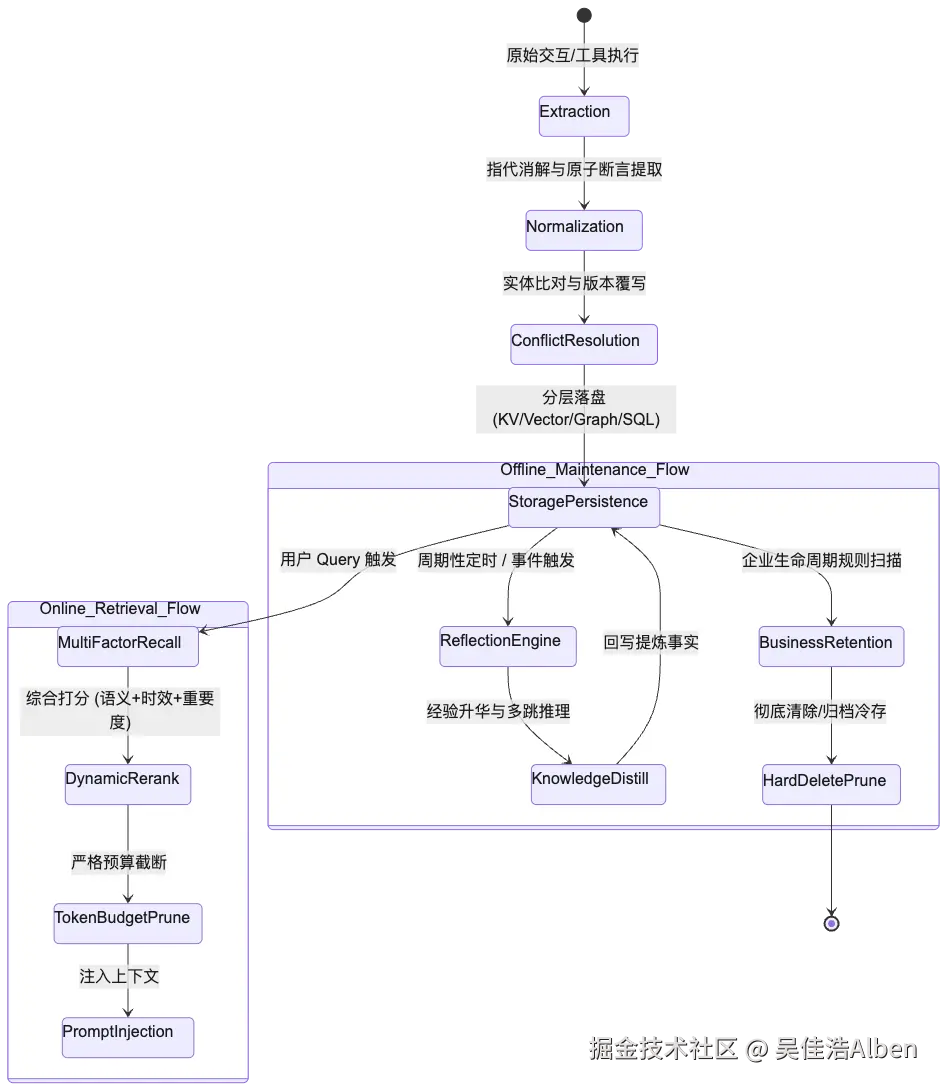
1. 抽取(Extraction):拒绝垃圾进、垃圾出
用户输入:"把它部署到上次那个测试节点,记得改一下端口"。 抽取管道必须完成指代消解(Coreference Resolution)与原子事实解构,将其转化为自包含断言:
- 🔸
Target: user-auth-service - 🔸
Node_IP: 10.200.4.15 - 🔸
Action: deploy_with_custom_port
2. 召回与重排(Recall & Rerank):超越单纯向量距离
传统向量余弦相似度在 Memory 场景下极易召回语义相近但毫无决策价值的废话。生产环境必须采用多因子综合评分机制:
综合得分 = 0.45 × 语义相关度 + 0.25 × 固有重要性 + 0.20 × 时效新鲜度 + 0.10 × 历史激活频次- 🔸 Profile 享有 1.2 倍加成保底:用户的硬性偏好天然具备最高召回优先级;
- 🔸 时效衰减因子:确保 3 个月前的临时排错日志不会抢占当前任务的关键上下文。
3. 反思(Reflection):离散事件升华为共识
当系统中存在多条相似的情景记忆时,离线反思任务自动启动:
- 事件 A:"用户在 Node 20 下构建失败,切至 Node 18 成功";
- 事件 B:"用户再次确认项目构建依赖 Node 18";
- 🔸 反思提炼 :生成一条确定性规则
Project.runtime.nodejs.version = "18",并级联清除原有的两条碎片事件。
4. 巩固(Consolidation):临时共识固化为技能
经过多次跨会话验证且从未被推翻的事实,置信度自动提升至 1.0,并转化为工程代码化 SOP(写入 SKILL.md)。
一句话总结这一章的核心观点:
记忆不是静态的数据存储,而是持续处于"抽取-重排-反思-巩固-修剪"动态代谢中的认知流。
四、企业级确定性保留与删除矩阵(Enterprise Retention Matrix)
很多学术论文喜欢讨论复杂的数学衰减公式,但在真实的严肃企业级工程实践中,必须通过确定性的业务规则决定数据的生死:
企业级 Agent Memory 确定性保留与删除矩阵:
| 记忆类型 | 保留周期策略 | 淘汰与删除触发条件 | GDPR / 合规要求 |
|---|---|---|---|
| Profile & 刚性偏好 | 永久保留 (绝对免疫衰减) | 仅允许用户显式修改或账户注销 | 账户注销时级联物理删除 |
| Semantic 业务事实 | 长期演进 | 出现新版本事实覆写,或 180 天未激活且低分 | 支持按租户/实体批量清除 |
| Episodic 排错事件 | 中短期 (30~90天) | 超过 TTL、被提炼为规则后、或低频未激活 | 归档至 S3 冷存后定期物理粉碎 |
| Session 摘要骨架 | 绑定会话生命周期 | 会话关闭后保留 30 天用于追溯审计,后转冷存 | 随会话注销同步物理销毁 |
| Working Memory | 瞬时计算级 | 子任务执行完成即刻清空 | 内存 GC 释放,不落磁盘 |
一句话总结这一章的核心观点:
企业的合规底线与成本红线,决定了数据淘汰必须走确定性的业务矩阵,而非随机概率。
五、记忆系统的量化评估体系(Memory Evaluation)
没有度量就没有优化。企业级 Agent Memory 必须建立以下五个维度的自动化评测基线:
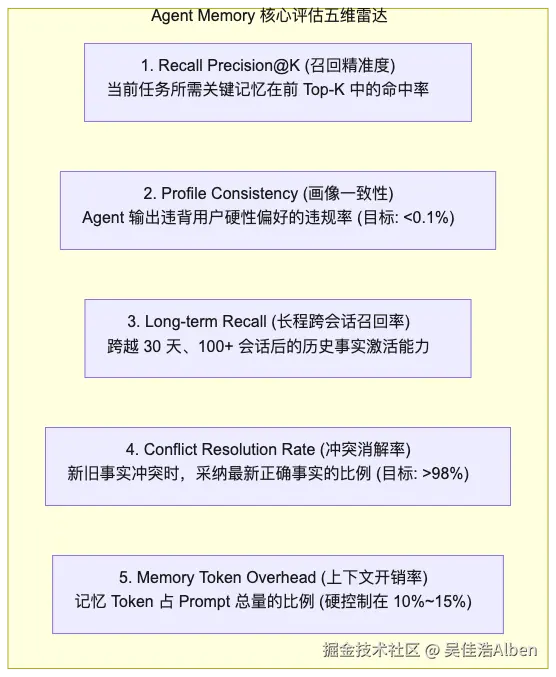
- 🔸 Recall Precision@K:衡量关键上下文在 Top-K 召回中的信噪比;
- 🔸 Profile Consistency:通过判别模型自动化巡检 Agent 是否违背了用户的核心偏好;
- 🔸 Conflict Resolution Rate:时序更替后,Agent 采纳最新结论的准确率;
- 🔸 Memory Token Overhead:严格将 Memory 上下文开销锁死在总 Prompt 的 10%~15% 以内,杜绝 Token 浪费。
一句话总结这一章的核心观点:
评估 Memory 的优劣,核心看它能否用最小的 Token 预算,换取最高的一致性与决策精准度。
六、生产级完整实现:分层架构与生命周期引擎
以下为基于 Python 3.11+ 与 Pydantic v2 的完整生产级实现代码:
python
"""
agent_memory_architecture_engine.py
生产级 Agent Memory 分层架构与生命周期引擎
包含:分层存储管理、多因子打分检索、企业级保留淘汰与 Token 预算裁剪
"""

from __future__ import annotations

import enum
import math
import uuid
from datetime import datetime
from typing import Any, Dict, List, Optional, Tuple
from pydantic import BaseModel, Field


class MemoryCategory(str, enum.Enum):
    """分层记忆类型"""
    PROFILE = "profile"            # 用户偏好/系统约束 (永久不衰减)
    SEMANTIC = "semantic"          # 业务事实/实体关系 (长期演进)
    EPISODIC = "episodic"          # 历史事件/排错经历 (中短期衰减)
    SUMMARY = "summary"            # 会话骨架摘要 (固定 TTL)
    WORKING = "working"            # 瞬时执行栈 (即时销毁)


class MemoryNode(BaseModel):
    """标准记忆节点实体"""
    id: str = Field(default_factory=lambda: str(uuid.uuid4()))
    tenant_id: str
    user_id: str
    session_id: Optional[str] = None
    category: MemoryCategory

    # 事实内容与标签
    content: str
    tags: List[str] = Field(default_factory=list)

    # 认知打分维度
    importance: float = Field(default=0.5, ge=0.0, le=1.0)
    confidence: float = Field(default=1.0, ge=0.0, le=1.0)
    access_count: int = Field(default=0, ge=0)
    stability_hours: float = Field(default=72.0, ge=1.0)

    # 时间追踪
    created_at: datetime = Field(default_factory=datetime.utcnow)
    updated_at: datetime = Field(default_factory=datetime.utcnow)
    last_accessed_at: datetime = Field(default_factory=datetime.utcnow)

    # 状态
    is_archived: bool = Field(default=False)
    version: int = Field(default=1)

    def calculate_recency_factor(self, now: Optional[datetime] = None) -> float:
        """
        计算时效衰减因子
        Profile 具备绝对免疫力,不参与衰减
        """
        if self.category == MemoryCategory.PROFILE:
            return 1.0

        current_time = now or datetime.utcnow()
        elapsed_hours = max(0.0, (current_time - self.last_accessed_at).total_seconds() / 3600.0)

        # 衰减模型
        recency = math.exp(-elapsed_hours / self.stability_hours)
        return float(max(0.01, min(1.0, recency)))

    def record_access(self, now: Optional[datetime] = None) -> None:
        """激活记忆并增强其稳定性"""
        current_time = now or datetime.utcnow()
        self.access_count += 1
        self.last_accessed_at = current_time
        if self.category != MemoryCategory.PROFILE:
            # 每次被成功激活,延长其生命周期稳定性
            self.stability_hours = min(720.0, self.stability_hours * (1.0 + 0.25 * self.importance) + 24.0)


class MultiFactorMemoryReranker:
    """多因子加权检索与重排器"""

    def __init__(
        self,
        weight_semantic: float = 0.45,
        weight_importance: float = 0.25,
        weight_recency: float = 0.20,
        weight_frequency: float = 0.10,
    ):
        self.w_sim = weight_semantic
        self.w_imp = weight_importance
        self.w_rec = weight_recency
        self.w_frq = weight_frequency

    def compute_composite_score(
        self,
        node: MemoryNode,
        semantic_sim: float,
        now: Optional[datetime] = None,
    ) -> float:
        """计算综合相关度评分,Profile 享有 1.2 倍加成保护"""
        current_time = now or datetime.utcnow()

        sim_score = max(0.0, min(1.0, semantic_sim))
        imp_score = node.importance
        rec_score = node.calculate_recency_factor(current_time)
        frq_score = min(1.0, math.log(node.access_count + 1) / math.log(100 + 1))

        base_score = (
            self.w_sim * sim_score
            + self.w_imp * imp_score
            + self.w_rec * rec_score
            + self.w_frq * frq_score
        )

        if node.category == MemoryCategory.PROFILE:
            base_score = min(1.0, base_score * 1.2)

        return float(base_score)


class EnterpriseMemoryManager:
    """企业级分层 Memory 管理总控"""

    def __init__(self, token_budget: int = 800):
        self.token_budget = token_budget
        self.reranker = MultiFactorMemoryReranker()

    def select_memories_for_prompt(
        self,
        query: str,
        candidates: List[Tuple[MemoryNode, float]],  # (Node, SemanticSimilarity)
        now: Optional[datetime] = None,
    ) -> List[MemoryNode]:
        """严格受控于 Token 预算的多因子召回与裁剪"""
        current_time = now or datetime.utcnow()
        scored_nodes: List[Tuple[float, MemoryNode]] = []

        for node, sim in candidates:
            if node.is_archived:
                continue
            score = self.reranker.compute_composite_score(node, sim, current_time)
            scored_nodes.append((score, node))

        # 按综合得分降序排列
        scored_nodes.sort(key=lambda x: x[0], reverse=True)

        selected: List[MemoryNode] = []
        accumulated_tokens = 0

        for score, node in scored_nodes:
            node_token_cost = len(node.content) // 2 + 8
            if accumulated_tokens + node_token_cost > self.token_budget:
                continue

            node.record_access(current_time)
            selected.append(node)
            accumulated_tokens += node_token_cost

        return selected

    def execute_retention_sweep(
        self,
        nodes: List[MemoryNode],
        episodic_ttl_days: int = 60,
        now: Optional[datetime] = None,
    ) -> Dict[str, List[MemoryNode]]:
        """企业级保留规则物理扫描任务"""
        current_time = now or datetime.utcnow()
        retained: List[MemoryNode] = []
        archived: List[MemoryNode] = []

        for node in nodes:
            # 1. Profile 永久存活
            if node.category == MemoryCategory.PROFILE:
                retained.append(node)
                continue

            # 2. Episodic 超出 TTL 且非极高重要性则归档
            if node.category == MemoryCategory.EPISODIC:
                age_days = (current_time - node.created_at).days
                if age_days > episodic_ttl_days and node.importance < 0.85:
                    node.is_archived = True
                    archived.append(node)
                    continue

            # 3. 低置信度且长期未激活的 Semantic 归档
            if node.category == MemoryCategory.SEMANTIC:
                recency = node.calculate_recency_factor(current_time)
                if recency < 0.05 and node.confidence < 0.7:
                    node.is_archived = True
                    archived.append(node)
                    continue

            retained.append(node)

        return {"retained": retained, "archived": archived}
本篇总结
- 🔸 Memory 本质上是在模拟人类认知系统:理解了人脑海马体与皮层的协作分工,才能建立高信噪比的 Agent 状态机;
- 🔸 分层认知架构是系统底线:Profile 永久免疫衰减,Semantic 长期演进,Episodic 遵循中短期生命周期;
- 🔸 企业必须依靠确定性的保留矩阵:而不是把数据清理完全寄托在概率性公式上;
- 🔸 建立量化评估体系(Evaluation):以召回精准度、画像一致性与 Token 开销率作为核心衡量指标。
在下一篇中,我们将深入解构:《Memory Provider 实战:Hermes、Mem0、Honcho、Hindsight 为什么都这样设计?》,全面拆解主流框架如何落地 Memory Runtime 架构与统一 SPI 抽象。
筒子们本篇为《企业级 Agent 实战指南》· 第一章的第 02 篇,后续续会更新完整的agent的开发的全部过程,如果你对Agent开发感兴趣不妨关注一下本合集。