第 16 章:RAG
在模型回答前检索可信外部知识,把相关证据加入 Prompt,让回答更贴近私有数据并具备可追溯来源。
前言
模型参数中没有企业最新制度、内部文档和实时知识。RAG(Retrieval-Augmented Generation)不要求重新训练模型,而是在每次回答前检索外部资料,再把资料作为上下文交给模型。
一、RAG 解决什么问题
- 私有知识没有进入通用模型;
- 知识更新频繁,不适合反复微调;
- 回答需要引用来源;
- 需要限制模型只参考当前用户可访问的数据。
RAG 能降低无依据回答,但不能保证绝对正确。检索错误、文档错误和模型误读仍然可能发生。
二、完整流程
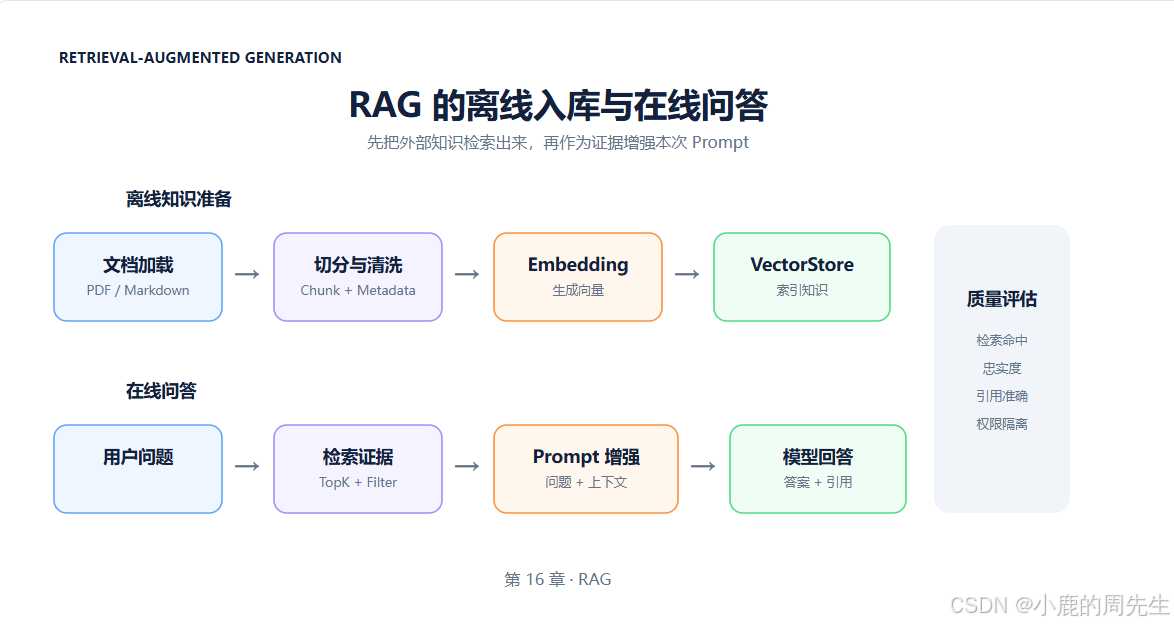
RAG 分为离线和在线两条链。
text
离线:加载 → 清洗 → 切分 → Embedding → VectorStore
在线:问题 → 检索 → 上下文增强 → 模型生成 → 引用
三、文档加载
Document Reader 把 PDF、Markdown、网页或数据库内容转换为统一 Document。加载阶段应保留来源、标题、页码、更新时间、租户等 Metadata。
扫描 PDF 需要 OCR;复杂表格和多栏排版可能丢失结构,不能默认"读取成功"等于内容正确。
四、文档切分
文档通常不能整体入库。Chunk 太大导致语义混杂和 Token 浪费,太小则丢失上下文。
切分应考虑标题层级、自然段、代码块、表格以及适当重叠。没有适用于所有资料的固定字符数。
五、Embedding 与 VectorStore
每个 Chunk 生成向量,并与原文及 Metadata 一起写入 VectorStore。查询时必须使用兼容的 Embedding 模型。
入库模型变更后通常需要重建向量;文档删除或更新时必须同步处理旧 Chunk。
六、Retrieval
java
List<Document> documents = vectorStore.similaritySearch(
        SearchRequest.builder()
                .query(question)
                .topK(5)
                .build()
);
检索不仅是 TopK,还应组合权限 Filter、相似度阈值、关键词检索和必要的重排。
七、Prompt Augmentation
把检索结果明确标记为参考资料:
text
请仅根据下面资料回答。
资料不足时明确说明无法判断。

【资料】
{context}

【问题】
{question}
外部资料本身也可能包含恶意指令。应用应把它视为不可信数据,而不是更高优先级的系统规则。
八、使用 Advisor 组织 RAG
Spring AI 可以通过检索 Advisor 在调用前查询 VectorStore 并增强 Prompt。业务 Service 保持简洁:
java
return chatClient.prompt()
        .user(question)
        .advisors(retrievalAdvisor)
        .call()
        .content();
具体 Advisor 名称和构造方式随版本变化,应以当前项目 API 为准。
九、引用来源
回答应返回来源文档、页码或链接。引用必须来自实际检索结果,不应让模型自由编造。
建议由程序保留检索 Document 的 Metadata,再把回答和来源组合为业务响应 DTO。
十、没有检索结果时怎么办
正确策略通常是明确说明资料不足、引导补充问题或转人工,而不是让模型脱离资料自由回答。是否允许回退到通用知识,应由业务策略决定。
十一、RAG 质量评估
分开评估:
- 检索:正确证据是否进入 TopK;
- 生成:回答是否忠实于证据;
- 引用:来源是否真实支持结论;
- 安全:是否跨租户或越权;
- 性能:检索与生成延迟、Token 和费用。
十二、常见优化
- 查询改写:把上下文相关的问题改成可独立检索的问题;
- 混合检索:向量与关键词结合;
- 重排:对候选文档再次排序;
- 元数据过滤:提前限制范围;
- 上下文压缩:只保留支撑回答的片段。
优化必须基于评估集,不能只凭单个演示问题。
十三、从 API 进入源码
text
Retrieval Advisor
    ↓
Question → SearchRequest
    ↓
VectorStore.similaritySearch
    ↓
Document Context
    ↓
Augmented Prompt → ChatModel
重点观察查询参数如何构造、文档怎样写入请求上下文、引用信息如何保留,以及流式调用下增强逻辑是否一致。
十四、常见误区
- 接入向量库就完成 RAG:还缺少切分、过滤、增强和评估。
- TopK 越大越好:噪声和 Token 成本同步增加。
- RAG 可以消除幻觉:只能降低风险。
- 引用让模型自己写即可:来源应由程序依据检索结果生成。
- 权限过滤放在生成后:越权文档不应进入 Prompt。
十五、本章总结
RAG 的核心是"先检索证据,再基于证据生成"。高质量实现需要同时管理入库、检索、Prompt 增强、引用、权限与评估。
完整源码
text
源码地址:待补充
对应章节:chapter-16-rag
参考资料
下一章:Tool Calling
下一章让模型不只生成文字,还能选择并调用应用内部的确定性能力。