思想:
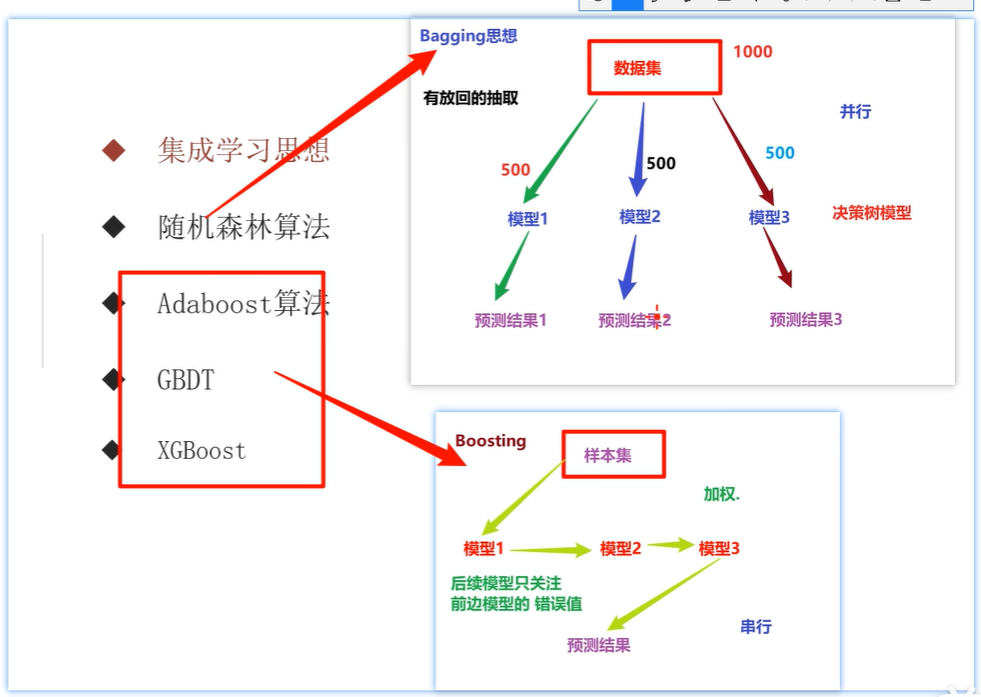
集成学习是机器学习中的一种思想,它通过多个模型的组合形成要给精度更高的模型,参与组合的模型成为弱学习器。使用训练集依次训练出这些弱学习器,对未知的样本进行预测时,使用这些弱学习器联合进行预测
** Bagging**
为啥要随机抽样训练集?(随机森林提问)
随机森林属于bagging集成学习思想,多个学习器并行执行,且多个弱学习器默认都是CART决策树,如果训练集都一样,则最终结果都是一样的,有放回的抽样就是让训练有交集也有差集(如果全量训练导致一个决策树训练多遍,无效训练),结果会更加精准。
Boosting
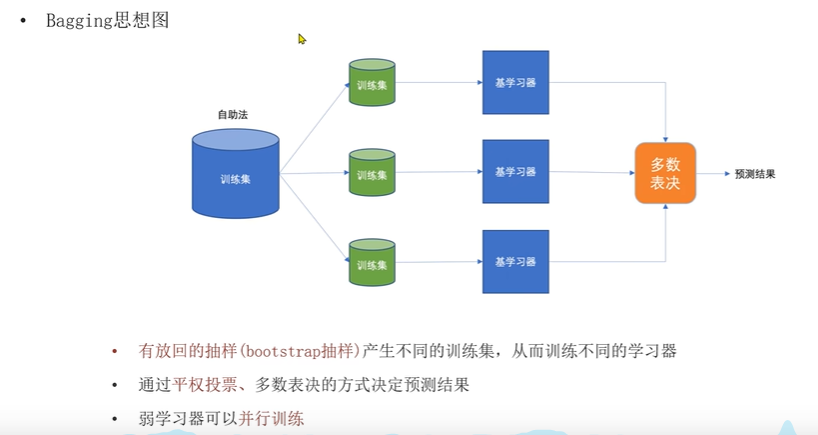
每次训练都会使用全部样本,加权投票,预测正确:权重减低,预测错误:权重增加,串行执行
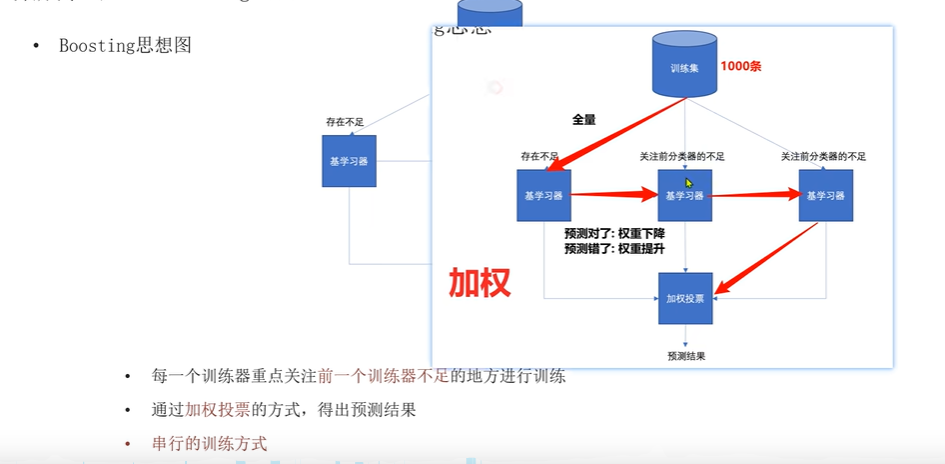
下面推导都是按照下面这个来的,这个图是总纲 这个adaboost推导很精彩
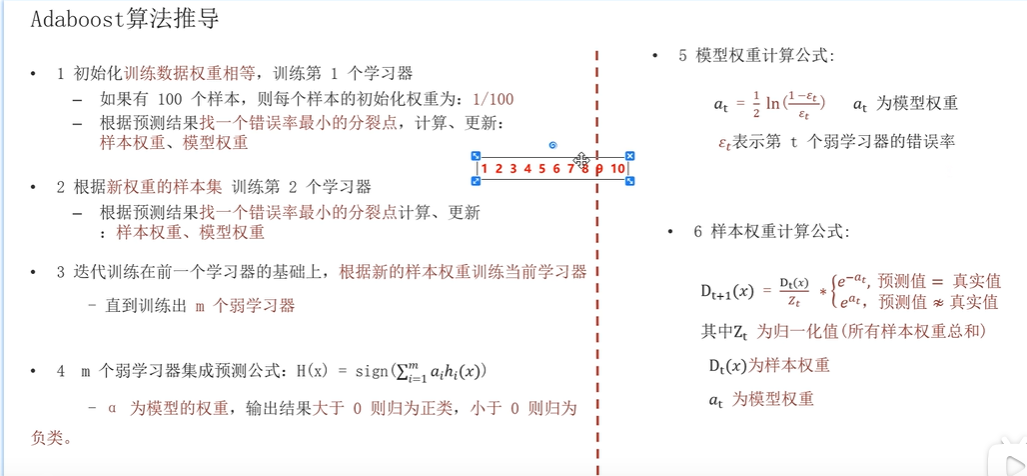
boosting 思想 集中学习: 把多个'弱学习器'组合起来,变成一个'强学习器'
adaboost adaptive :自适应
开始前推导前,解决下面举例数据几个疑问?
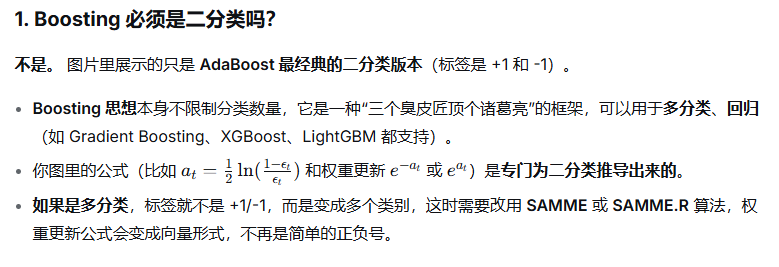
1.boosting 必须是二分类吗?
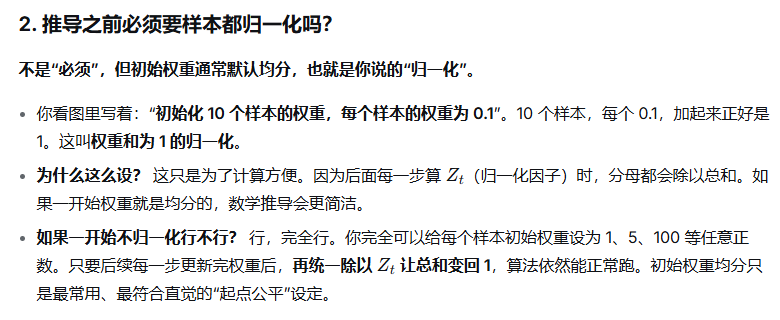
2.推导前必须所有样本权重必须归一化吗?
三个臭裨将顶个诸葛亮,
裨将:"裨将"是一个古代军事术语,指副将或偏将,即主将的副手
推导开始
主要分下面四步(下面截图标的四步)
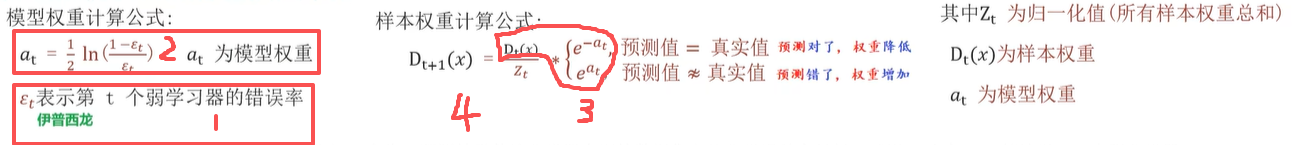
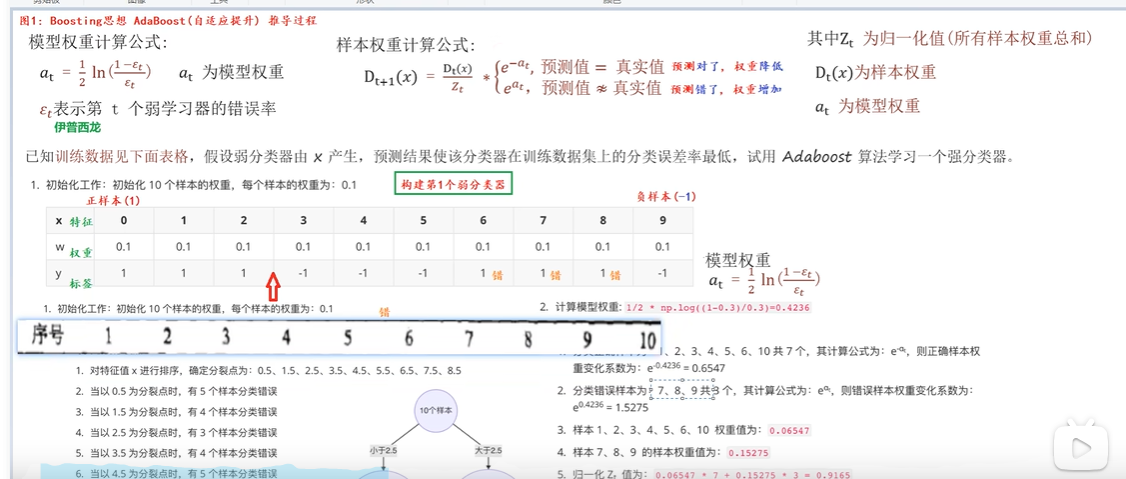
每个特征默认都是0.1权重,找最优分裂点。(一开始左边为1正样本,右边为-1为负样本)
第一步
移动找最优分裂点能看出来错误率,最终找到2.5作为分裂点,错误率(伊普西龙)最低0.3
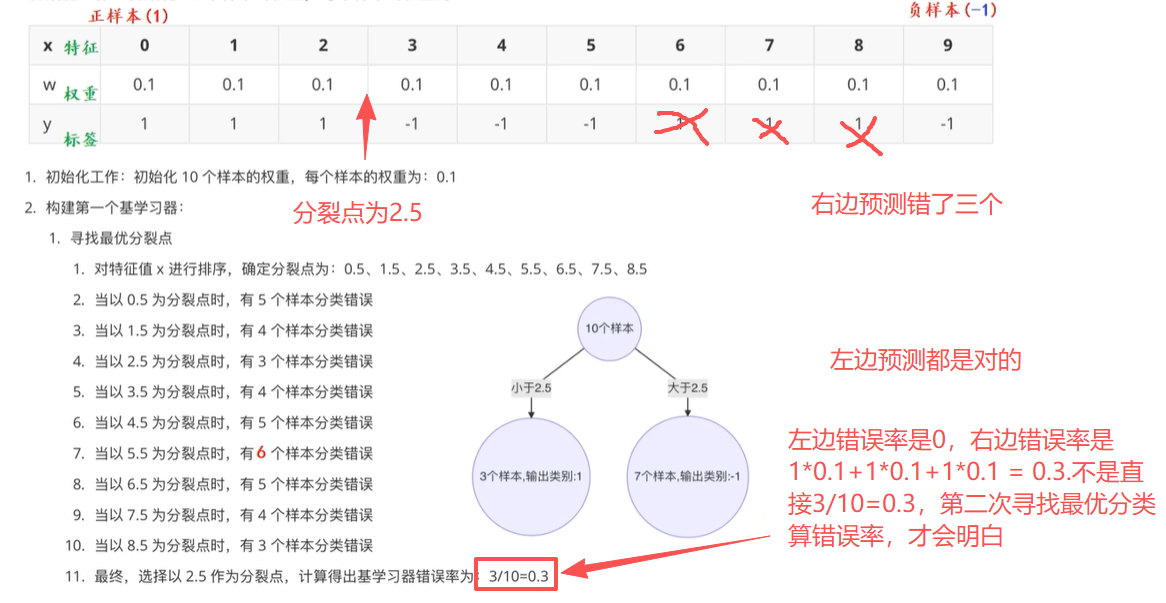
找到这个错误率(伊普西龙)很关键,就可以算出模型权重,从而知道 预测对的权重变化系数和预测错的权重变化系数
第二步
根据错误率算出模型权重。 at = 1/2 ln(1-0.3/0.3)
第三步
再根据模型权重,能知道e^-αt 预测对了,权重变化系数是0.6547.
e^αt 预测错了 ,权重变化系数是1.5275
Dt(x) 是旧的样本权重
Dt(x) 是旧的样本权重 * 权重变化系数 为新的权重
看出来正确的新样本权重变成了 0.06547 降低了(相对原来的旧权重0.1)(因为权重系数降低,所以 0.1 * 0.6547肯定比0.1原来这个旧的权重降低了)
看出来错误的新样本权重变成了 0.15275 升高了(相对原来的旧权重0.1)(因为权重系数升高,所以 0.1 * 1.5275肯定比0.1原来这个旧的权重升高了)
第四步:旧的样本权重 * 权重变化系数 后处理归一化值
乘完系数后,所有样本的权重加起来可能不再等于 1,所以必须除以归一化因子Zt,让总权重重新变回1
最后要统一再除以归一化才能得到最终的各自新的权重
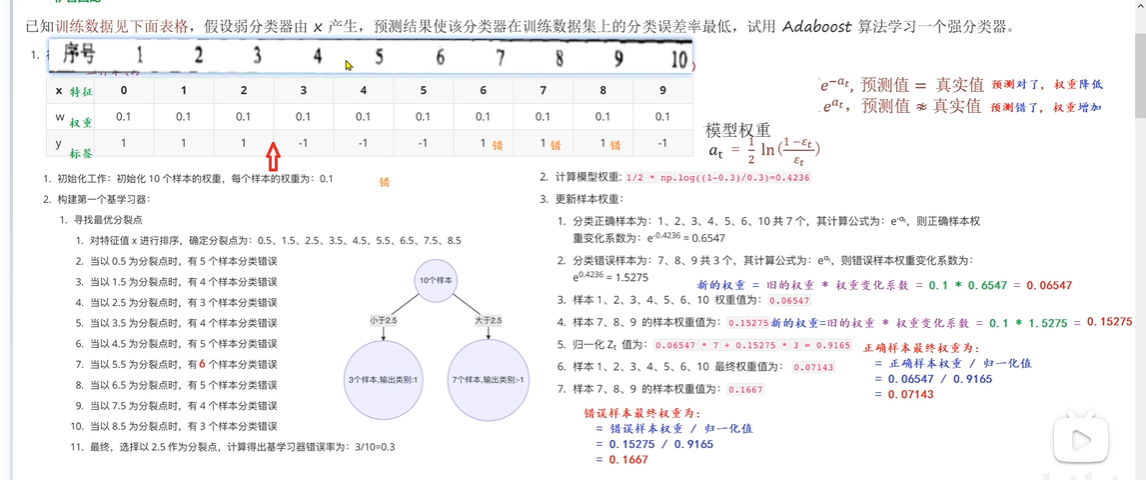
第一轮结束后最终正确处理后结果
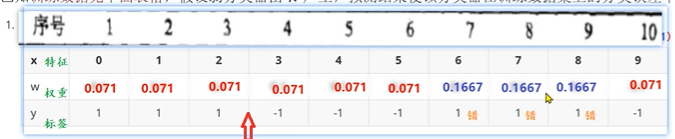
第二轮开始找最优分裂点 (一开始左边为1正样本,右边为-1为负样本)
但是这次不是每个特征默认都是0.1权重,要以第一轮结束的权重来算错误率
下面是0.5切分算的错误率
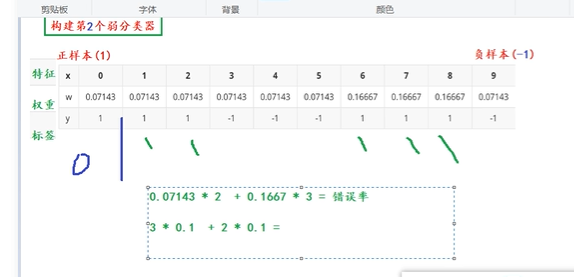
下面是3.5切分算的错误率
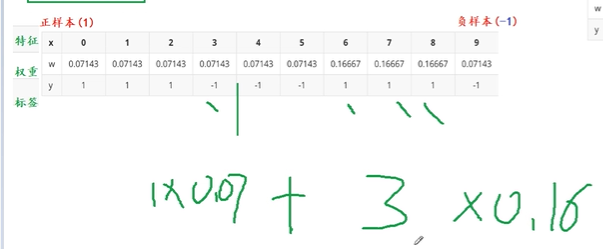
以此类推,算出第二个弱分类器的结果
截图第二个弱分类器演算过程
开始第二轮前各自权重
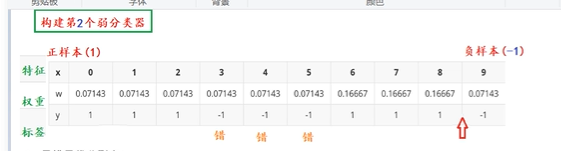
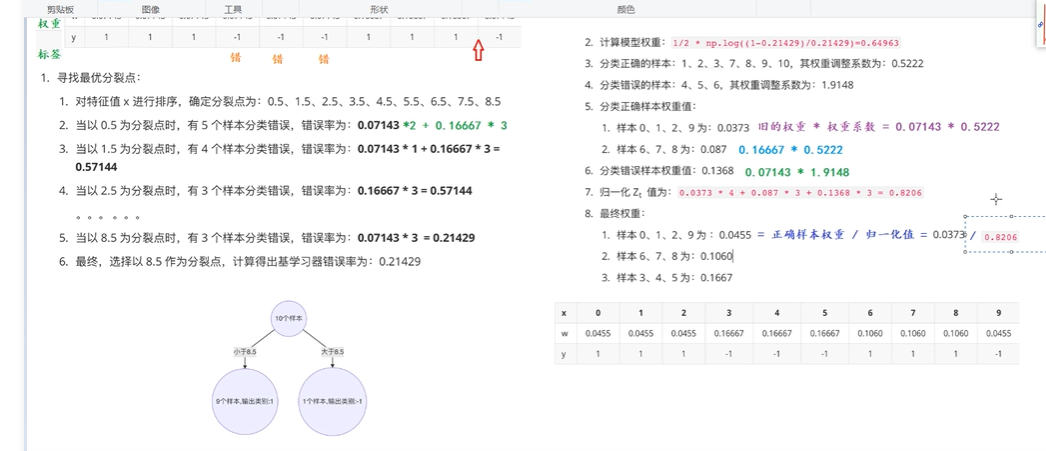
最终第二轮处理后结果
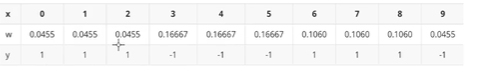
对比第二次处理后结果和第一次处理后结果,还是预测错误提升权重,预测正确减少权重
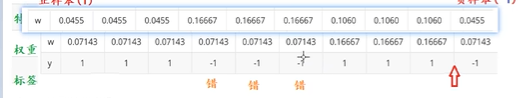
第三轮处理,最后算出来每个x对用正负类
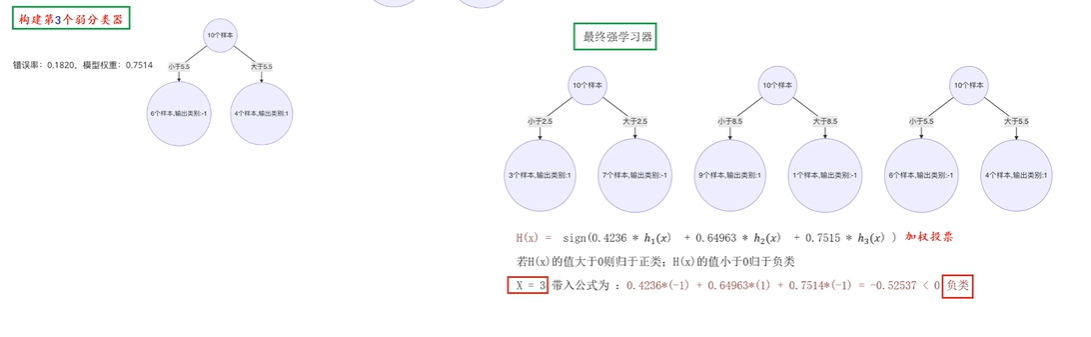
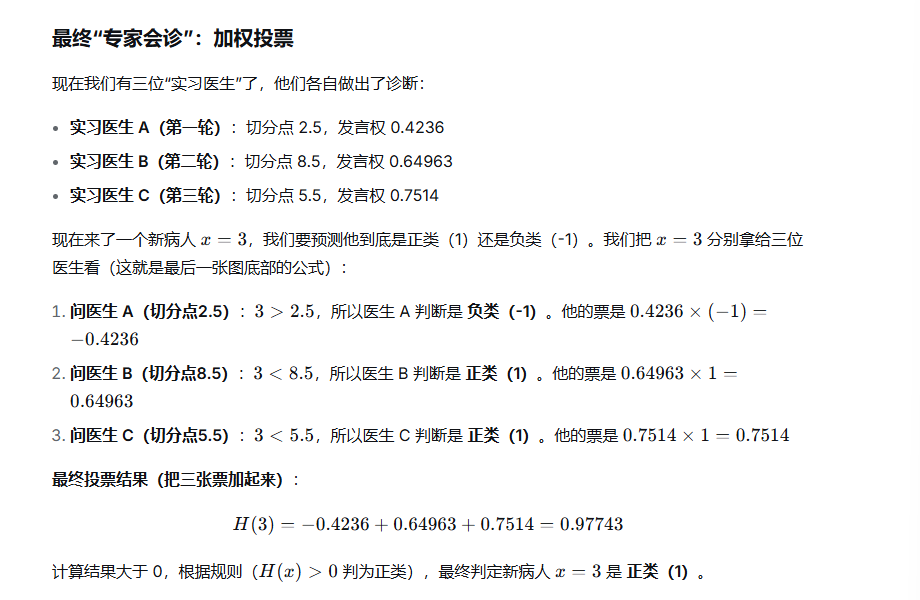
最后每个弱分类器都有自己得模型权重, 将x带入三个弱分类器。来判断特征x 输出类别
加权投票,将三个弱分类器输出得类别相加,算出最终类别(这里是二分类,所有用正负类,但是开头疑问讲了,可以是多分类)
终极疑问
1.为啥找到最优分割点,算出错误率。找到模型权重,根据模型权重算预测值等于真实值,来调整权重系数。最终正确的减少权重,错误增加权重,2.重新算出来的权重到下一轮有啥用
ai回答:
- 为什么找到最优分割点、算出错误率后,要用模型权重去调整样本权重?
因为 AdaBoost 的核心思想是"知错就改,重点关照难学的样本"。
- 找最优分割点:是为了让当前这个"弱分类器"在现有数据分布下,表现尽可能好(错误率最低)
- 算出错误率 ϵt :这个值很关键。它决定了这个弱分类器在最终投票中的"话语权"(模型权重 αt)。错误率越低,说明它越靠谱,αt越大。
- 用 αt 调整样本权重 :
- 对于预测对的样本:我们给它乘上e^-αt(一个小于 1 的数),让它的权重降低。因为模型已经学会它了,下一轮不用再重点关照。
- 对于预测错的样本:我们给它乘上e^αt(一个大于 1 的数),让它的权重升高。因为模型还没学会它,下一轮要重点攻克。
- 最后归一化:乘完系数后,所有样本的权重加起来可能不再等于 1,所以必须除以归一化因子 Zt,让总权重重新变回 1
- 重新算出来的权重到下一轮有啥用?
它的作用是:改变下一轮"找最优分割点"的评判标准。
第一轮开始时,所有样本权重都是 0.1,大家一视同仁。但第二轮开始时,权重变成了
- 第一轮预测对的样本:权重变成了 0.07143(降低了)
- 第一轮预测错的样本:权重变成了 0.1667(升高了)
这直接影响了第二轮"错误率"的计算方式。
怎么直接影响,结合上面推导数据举例,不然空话听不明白
AdaBoost 不是靠什么复杂的机制去"优先",而是直接把样本权重乘进了错误率里
情况A(就是分割点选2.5,右侧错三个,但是这三个都是加权后的权重)
- 这些样本权重是 0.1667,很大
- 只要分错一个,错误率就加 0.1667。
- 分错三个,错误率直接飙到 0.5 左右。
- 算法一看:这个分割点错误率太高,淘汰。
情况B(就是分割点选8.5,左侧错三个,同样错三个,这三个都是减权后的权重)
- 这些样本权重是 0.07143,很小
- 分错一个,错误率只加 0.07143。
- 分错三个,错误率才 0.214。
- 算法一看:这个分割点错误率低,优先选它。
所以"优先"的本质是什么?
算法并没有主动去"照顾"高权重样本,而是高权重样本一旦被分错,会让错误率急剧上升,从而让这个分割点被淘汰。(所以这次分割点就会尽量让这些高权重样本是正确的,从而来找最优分割点,进入下一轮时这些高权重会在这次被降低权重,这就是所谓的'照顾'高权重样本,为了让这些高权重正确,会影响一些原来低权重。如情况B就让特征3,4,5错了,会让他们下一轮加权。)
换句话说:
- 高权重样本 = 地雷。踩到一颗,错误率爆炸。
- 低权重样本 = 小石子。踩到几颗,影响不大。
找到最优分割点,重新调整权重,交给一下一个弱学习器
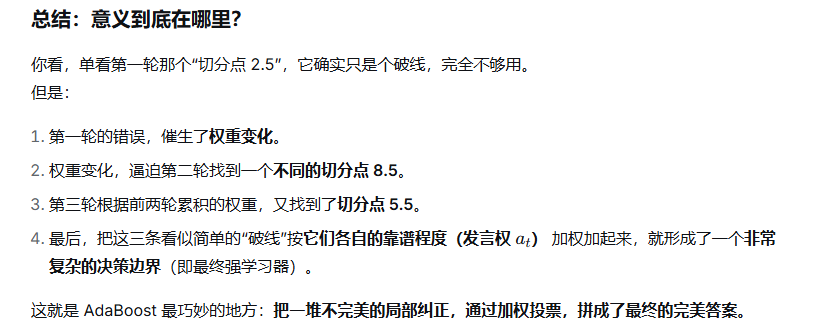
单看一轮,这个分割点确实没意义;但把它和"模型权重 αt "以及"最终加权投票"连起来看,意义就出来了(资质愚钝,还是没看出来意义,继续举例)。
先承认你的直觉:单看一轮,确实没意义
假设你只跑一轮 AdaBoost,找到一个分割点 2.5,错误率 0.3,模型权重 0.4236。
这一轮结束,你得到了一个弱分类器:x ≤ 2.5 判正,否则判负
然后呢?没了。
你拿这个弱分类器去预测新数据,它可能准确率只有 70%------这跟直接拍脑袋画一条线没本质区别,甚至还不如你直接训练一棵完整的决策树。 所以单看一轮,确实看不出意义。
意义:这个弱学习器水平一般(错误率0.3),所以他在最终会诊里的发言权(权重 α1)只有 0.4236。
第二轮,最优分割点会尽量处理上一轮的加权样本。
这个学习器的错误率更低(0.21429),比第一个弱学习器强,所以他的发言权 0.64963 大于第一个弱学习器的 0.4236。
第三轮
这个弱学习器错误率进一步降低,发言权 0.7514 最大。