本文摘要:结论先行:在集成了工具调用的 AI Agent 场景中,直接使用 React 的 useState 管理全部状态(包括 LLM 的流式响应、工具调用请求与结果、工作流步骤)是导致应用崩溃、逻辑纠缠和难以维护的核心反模式。它无法正确处理 AI 工作流中的异步性、并发性和长期性。失败现象验证:以下代码片段模拟了一个常见的错误起始点。
一、问题与结论:当 useState 遇见 Agent,状态在"撕裂"
结论先行:在集成了工具调用的 AI Agent 场景中,直接使用 React 的 useState 管理全部状态(包括 LLM 的流式响应、工具调用请求与结果、工作流步骤)是导致应用崩溃、逻辑纠缠和难以维护的核心反模式。它无法正确处理 AI 工作流中的异步性 、并发性 和长期性。
失败现象验证 :以下代码片段模拟了一个常见的错误起始点。开发者尝试用 useState 管理一个"全能状态",期望在单个组件内完成所有逻辑。
javascript
// 错误模式:单一 useState 承载所有 Agent 逻辑
const [agentState, setAgentState] = useState({
  messages: [], // 聊天历史
  toolCalls: [], // 待执行的工具调用
  toolResults: [], // 工具返回的结果
  status: 'idle' // 工作流状态
});

// 模拟一个耗时的工具调用(如查询数据库)
const executeTool = async (toolCall) => {
  // 问题1:状态更新不保证顺序,竞态条件
  setAgentState(prev => ({
    ...prev,
    status: 'executing_tool'
  }));
  const result = await callExternalAPI(toolCall);
  // 问题2:并发调用时,后续更新可能覆盖先前更新
  setAgentState(prev => ({
    ...prev,
    toolResults: [...prev.toolResults, result], // 追加,但时机不确定
    status: 'tool_done'
  }));
};

// 模拟LLM响应中包含两个工具调用(并行工具调用)
const handleLLMResponse = (response) => {
  if (response.tool_calls) {
    // 问题3:多个异步操作同时修改状态
    response.tool_calls.forEach(call => executeTool(call));
  }
};
预期输出 :理想中,toolResults 应有序积累,UI 应平滑展示每个工具的执行状态。
实际输出 :由于多个 executeTool 并发启动,它们读取的 prev 状态可能是相同的陈旧版本,导致只有最后一个工具的结果被保存,其他丢失;UI 状态 status 在 'executing_tool' 和 'tool_done' 之间快速闪动,造成渲染卡顿和信息错乱。这是典型的状态撕裂 与竞态条件。
二、排查与选择依据:为何 useState 的模型在此失效?
关键机制差异在于状态的生命周期 、更新模型 和数据结构。
- 生命周期 :
useState的状态生命周期绑定于 React 组件的挂载与卸载。页面刷新或路由切换,状态即丢失。而 Agent 的工作流(如一个需要多轮工具调用、人工确认的复杂任务)是长期存在的,需要能够暂停、恢复甚至从历史检查点回溯。这是前端状态管理器从未考虑过的维度。 - 更新模型 :React 的状态更新是批量、异步、倾向于合并 的,其核心目标是优化 UI 渲染性能,保证视图的最终一致性。而 Agent 工作流的状态更新是基于事件流、必须精确顺序、需要持久化历史快照 的。
setState的排队机制无法满足对工具执行中间状态和错误进行精确回放的需求。 - 数据结构 :
useState适合管理可序列化、与 UI 强相关的数据。Agent 状态包含复杂结构(如 LangChain 的消息实例、工具元数据),需要类型校验与智能合并。
结论 :这不是 useState 的缺陷,而是设计目标的错配。强行在组件内用 useState 编排 Agent 逻辑,等于试图用管理抽屉的方法来管理一条流水线。
三、关键原理:分层架构与 LangGraph 的 State
解决方案的核心是分层 :将视图状态 与Agent 执行状态彻底分离。
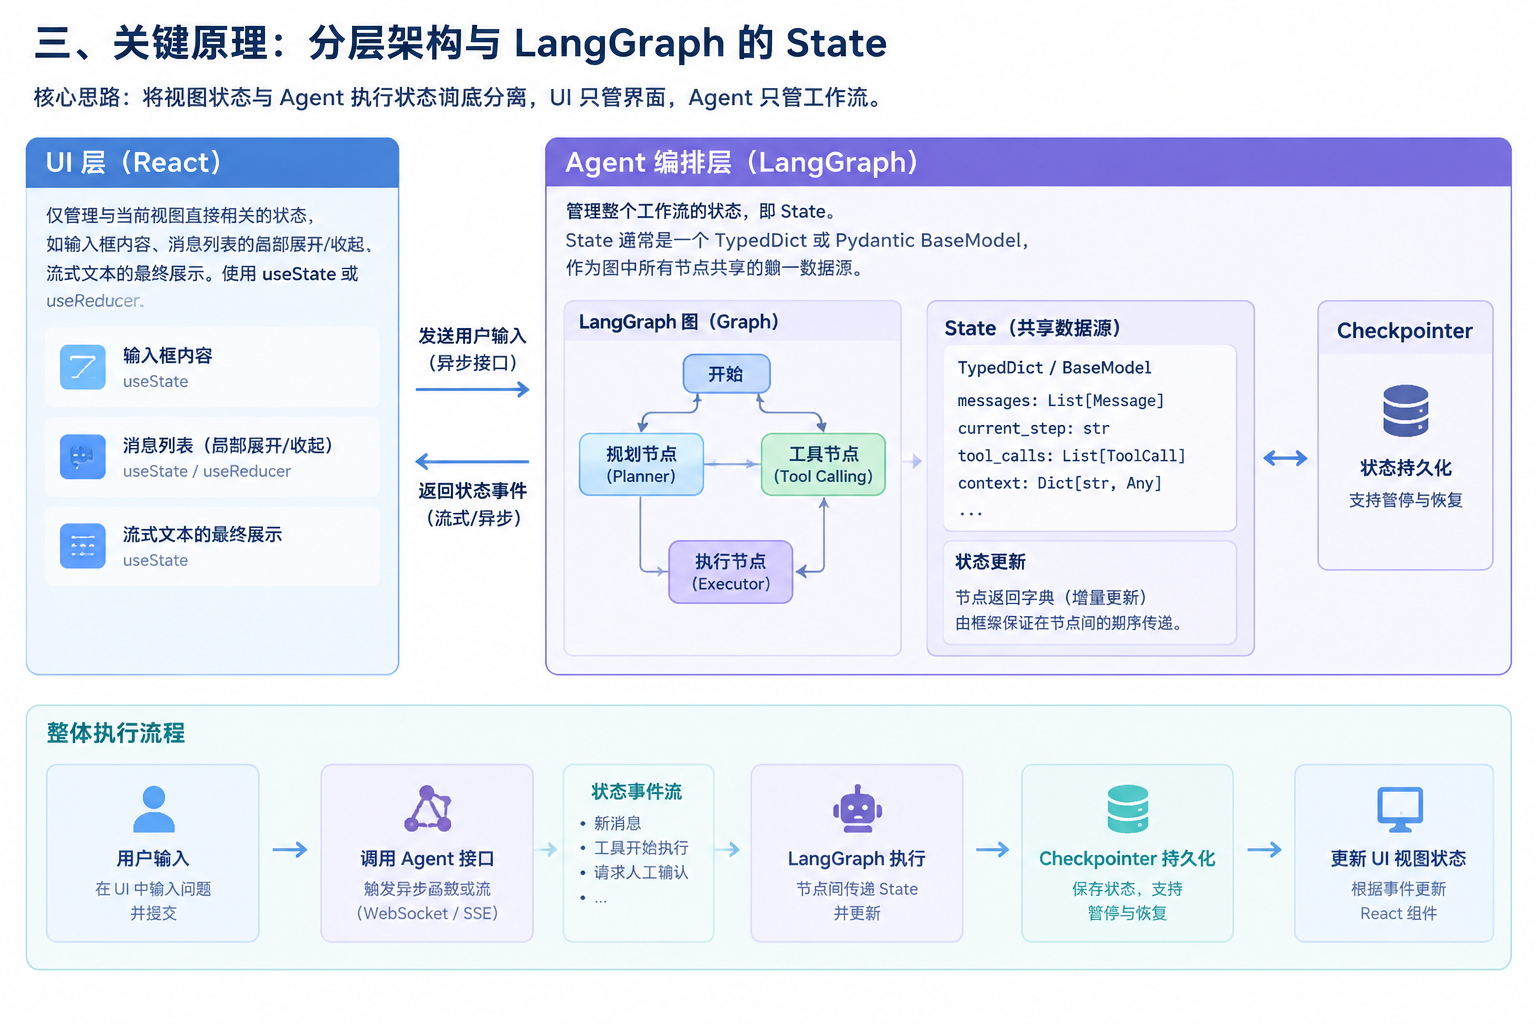
- UI 层 (React) :仅管理与当前视图直接相关的状态,如输入框内容、消息列表的局部展开/收起、流式文本的最终展示。使用
useState或useReducer足矣。 - Agent 编排层 (LangGraph) :管理整个工作流的状态,即
State。LangGraph 的State通常是一个TypedDict或 PydanticBaseModel,它作为图(Graph)中所有节点(Nodes)共享的单一数据源。状态更新通过返回字典(增量更新)来实现,并由框架保证在节点间的顺序传递。Checkpointer机制可将状态持久化,支持暂停与恢复。
接口定义 :Agent 编排层暴露给 UI 层的接口通常是一个异步函数或流(如 WebSocket、SSE)。UI 层调用此接口发送用户输入,并接收状态变化的事件(如"新消息"、"工具开始执行"、"请求人工确认")来更新视图状态。
四、可运行示例:从失败到成功的演进
环境准备:
- 安装依赖:
pip install langchain-openai langgraph fastapi uvicorn pydantic - 设置环境变量:
export OPENAI_API_KEY="你的密钥" - 创建
agent_server.py和agent_graph.py两个文件。
步骤一:定义结构化状态 (agent_graph.py)
python
from typing import TypedDict, Annotated, Sequence
from langchain_core.messages import BaseMessage
from langgraph.graph.message import add_messages
from pydantic import BaseModel, Field

# 定义工具调用和结果的最小结构
class ToolCall(BaseModel):
    name: str
    arguments: dict
    id: str = Field(description="唯一的调用ID,用于跟踪")

class AgentState(TypedDict):
    # 使用 add_messages 辅助函数,它会智能地合并消息列表
    messages: Annotated[Sequence[BaseMessage], add_messages]
    # 存储待执行和已完成的工具调用
    pending_tool_calls: list[ToolCall]
    tool_outputs: list[dict]  # 工具执行结果,可以是字典
    next_step: str | None  # 标识下一个要执行的节点
关键点 :Annotated[Sequence[BaseMessage], add_messages] 告诉 LangGraph,在合并来自不同节点的状态更新时,使用 add_messages 函数来智能处理 messages 字段的追加,避免覆盖。
步骤二:定义节点与图 (agent_graph.py 续)
python
from langchain_openai import ChatOpenAI
from langchain_core.tools import tool
from langgraph.graph import StateGraph, END

# 定义一个模拟工具
@tool
def get_current_weather(city: str) -> str:
    """获取指定城市的天气信息。"""
    # 实际应用中调用天气API
    return f"{city}:晴, 25°C"

llm = ChatOpenAI(model="gpt-4o")

# 定义'agent'节点:调用LLM决策
def agent_node(state: AgentState):
    response = llm.invoke(state["messages"])
    # 检查是否需要调用工具
    if response.tool_calls:
        parsed_calls = [
            ToolCall(**tc) for tc in response.tool_calls
        ]
        # 返回增量更新:追加消息,记录待处理的工具调用,指示下一步去'action'节点
        return {
            "messages": [response],
            "pending_tool_calls": parsed_calls,
            "next_step": "action"
        }
    else:
        # 不需要工具,直接返回最终消息,流程结束
        return {
            "messages": [response],
            "next_step": END
        }

# 定义'action'节点:执行工具
def action_node(state: AgentState):
    outputs = []
    for tc in state["pending_tool_calls"]:
        # 这里简化为直接调用,实际应根据tc.name路由到不同工具
        result = get_current_weather.invoke(tc.arguments)
        outputs.append({"tool_call_id": tc.id, "output": result})
    # 返回增量更新:清除待处理工具,记录工具输出,指示下一步回到'agent'
    return {
        "pending_tool_calls": [],  # 清空队列
        "tool_outputs": outputs,
        "next_step": "agent"
    }

# 构建图
workflow = StateGraph(AgentState)
workflow.add_node("agent", agent_node)
workflow.add_node("action", action_node)

# 定义条件边:根据 next_step 字段路由
workflow.add_conditional_edges(
    "agent",
    lambda s: s["next_step"],
    {"action": "action", END: END}
)
workflow.add_edge("action", "agent")

# 设置入口
workflow.set_entry_point("agent")

# 编译(不使用Checkpointer,简化演示)
app = workflow.compile
步骤三:创建 FastAPI 服务 (agent_server.py)
python
from fastapi import FastAPI
from fastapi.responses import StreamingResponse
from agent_graph import app, AgentState
from langchain_core.messages import HumanMessage
import json

api_app = FastAPI

@api_app.post("/chat")
async def chat_endpoint(message: str):
    # 初始化状态
    initial_state: AgentState = {
        "messages": [HumanMessage(content=message)],
        "pending_tool_calls": [],
        "tool_outputs": [],
        "next_step": "agent"
    }

    # 执行图,并收集状态更新流(这里简化为一次性返回)
    final_state = await app.ainvoke(initial_state)

    # 从最终状态中提取AI的回复(最后一条消息)
    ai_response = final_state["messages"][-1].content
return {"response": ai_response, "tool_outputs": final_state["tool_outputs"]}运行与测试:
bash
# 启动服务
uvicorn agent_server:api_app --reload

# 使用curl测试
curl -X POST " -d "message=北京今天天气怎么样?"
预期输出 :一个包含 AI 回复和工具执行结果的 JSON 响应,例如:{"response": "北京今天是晴天,气温25摄氏度。", "tool_outputs": [{"tool_call_id": "...", "output": "北京:晴, 25°C"}]}
实际输出 :应与预期输出一致。状态在整个流程中由 LangGraph 的 StateGraph 在 agent_node 和 action_node 之间准确传递和合并,没有丢失。
五、验证结果与边界:何时该用,何时不该用
验证结论:上述分层架构成功将 UI 状态与复杂的 Agent 工作流状态解耦。Agent 状态的演变(pending_tool_calls 的添加与清空、tool_outputs 的积累)清晰可追踪,且天然支持扩展(如添加人工确认节点)。
适用边界:
- 适用:需要调用外部工具、进行多步推理、可能涉及人工干预、需要错误恢复或任务持久化的中等及以上复杂度 Agent。
- 不适用 :仅进行单轮、无状态的 LLM 问答,且不涉及任何工具调用或复杂上下文管理。此时直接使用
useState或简单的 API 调用更轻量高效。
六、替代方案对比
| 方案 | 适用条件 | 代价 | 边界 |
|---|---|---|---|
1. 组件内单一useState |
极简原型,仅单轮无工具调用。 | 无法处理并发、异步、长期状态;状态逻辑与 UI 逻辑纠缠,难以测试和维护。 | 一旦需要引入第二个工具调用或执行步骤,缺陷立刻显现。 |
| 2. 分层架构 (React + LangGraph) | 生产级 Agent,需工具编排、状态持久化、人工介入。 | 引入新框架(LangGraph)学习成本;需要预先设计 State 结构;需维护独立的后端编排服务。 |
当 Agent 逻辑过于简单(如仅包装一次 API 调用)时,架构成本过高。 |
| 3. 客户端状态管理库 (如 Redux/Zustand) | 需要跨组件共享 Agent 状态,且状态以可序列化数据为主。 | 仍无法解决状态持久化和长期运行问题;复杂的异步逻辑仍需在 Reducer 中处理,容易出错;无法利用 LangGraph 的图编排和并发控制能力。 | 适用于状态复杂但生命周期仍在一次页面会话内,且不依赖后端状态恢复的场景。 |