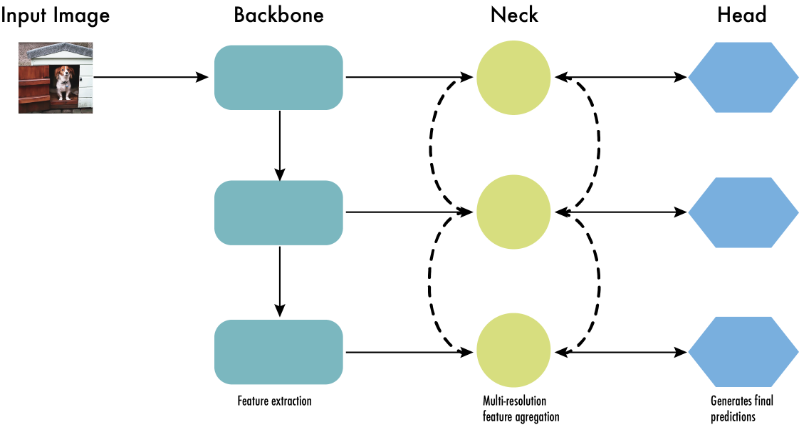
YOLO 系列目标检测器标准的三段式架构(Backbone-Neck-Head)。
-
Backbone(骨干):解决"看懂图像"的问题,将原始像素转化为不同层次的特征图。
-
Neck(颈部):解决"多尺度目标识别"的问题,避免小目标在深层特征图中丢失,或大目标缺乏语义信息。
-
Head(头部):解决"具体任务"的问题,输出物体的具体位置(Bounding Box)和类别概率,并通过 NMS 保留最优结果。
| 组件 | 中文名称 | 核心职责 | 提取特征/处理机制 |
|---|---|---|---|
| Backbone | 主干网络 | 特征提取 | 采用在 ImageNet 上预训练的 CNN。浅层提取低阶特征 (边缘、纹理等空间细节),深层提取高阶特征(语义信息、目标局部特征)。 |
| Neck | 颈部网络 | 特征融合与增强 | 连接 Backbone 与 Head。利用 FPN(特征金字塔网络)等机制,将不同尺度的浅层空间信息与深层语义信息进行聚合与精炼。 |
| Head | 检测头 | 预测与输出 | 基于 Neck 融合后的特征进行最终预测。包含分类、定位(边框回归)等子网络,最后通过 NMS(非极大值抑制)过滤重叠框。 |
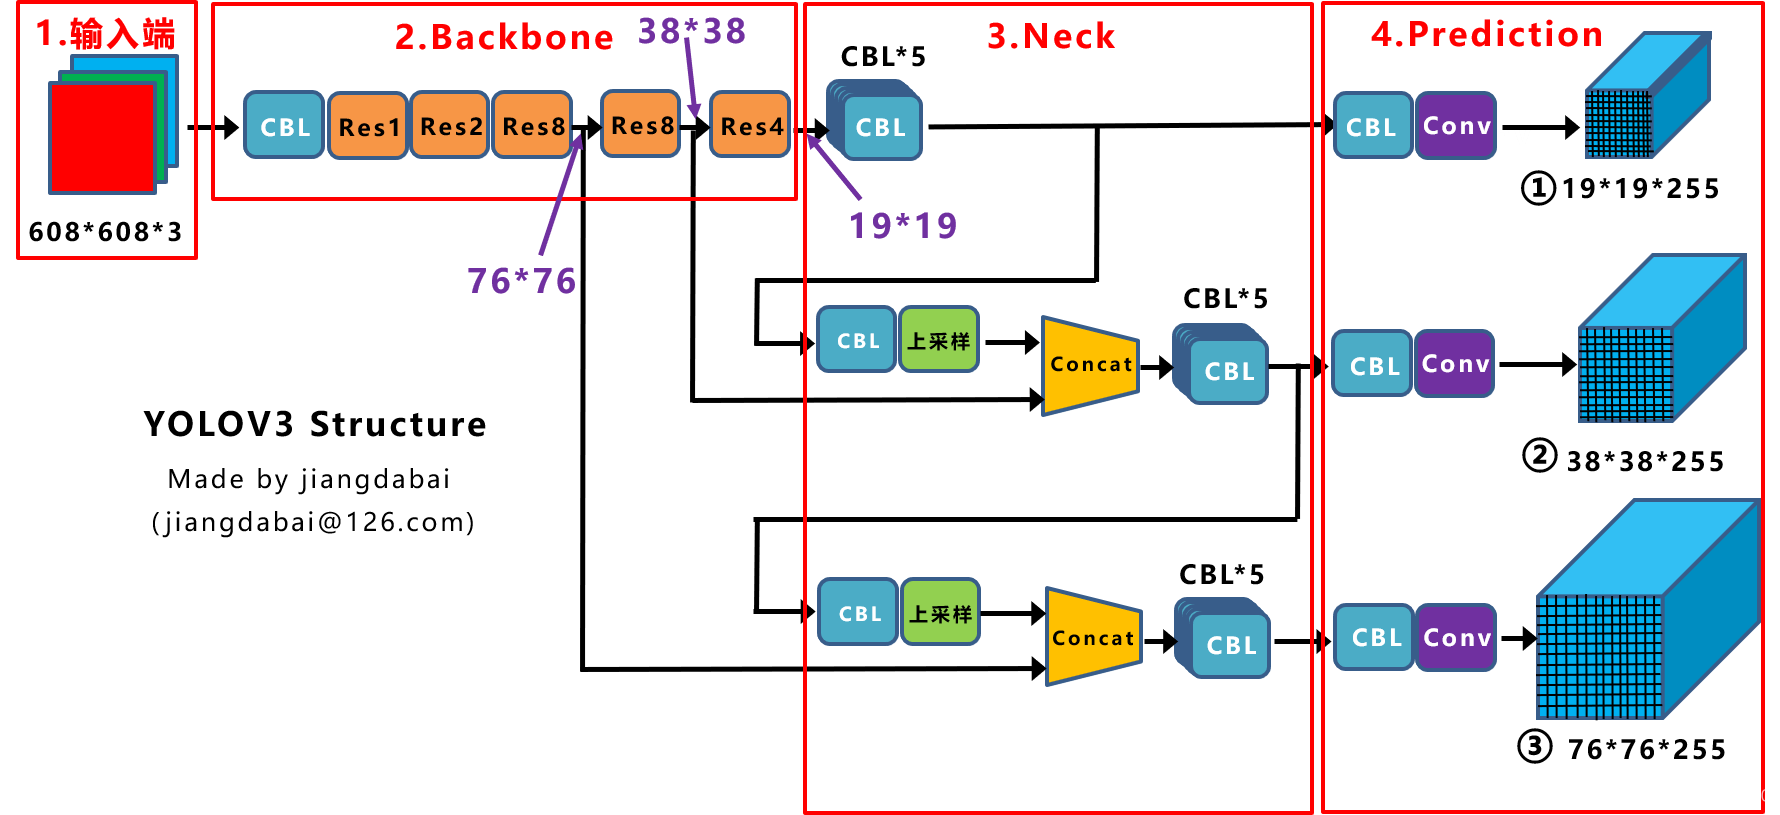
YoloV3网络结构图
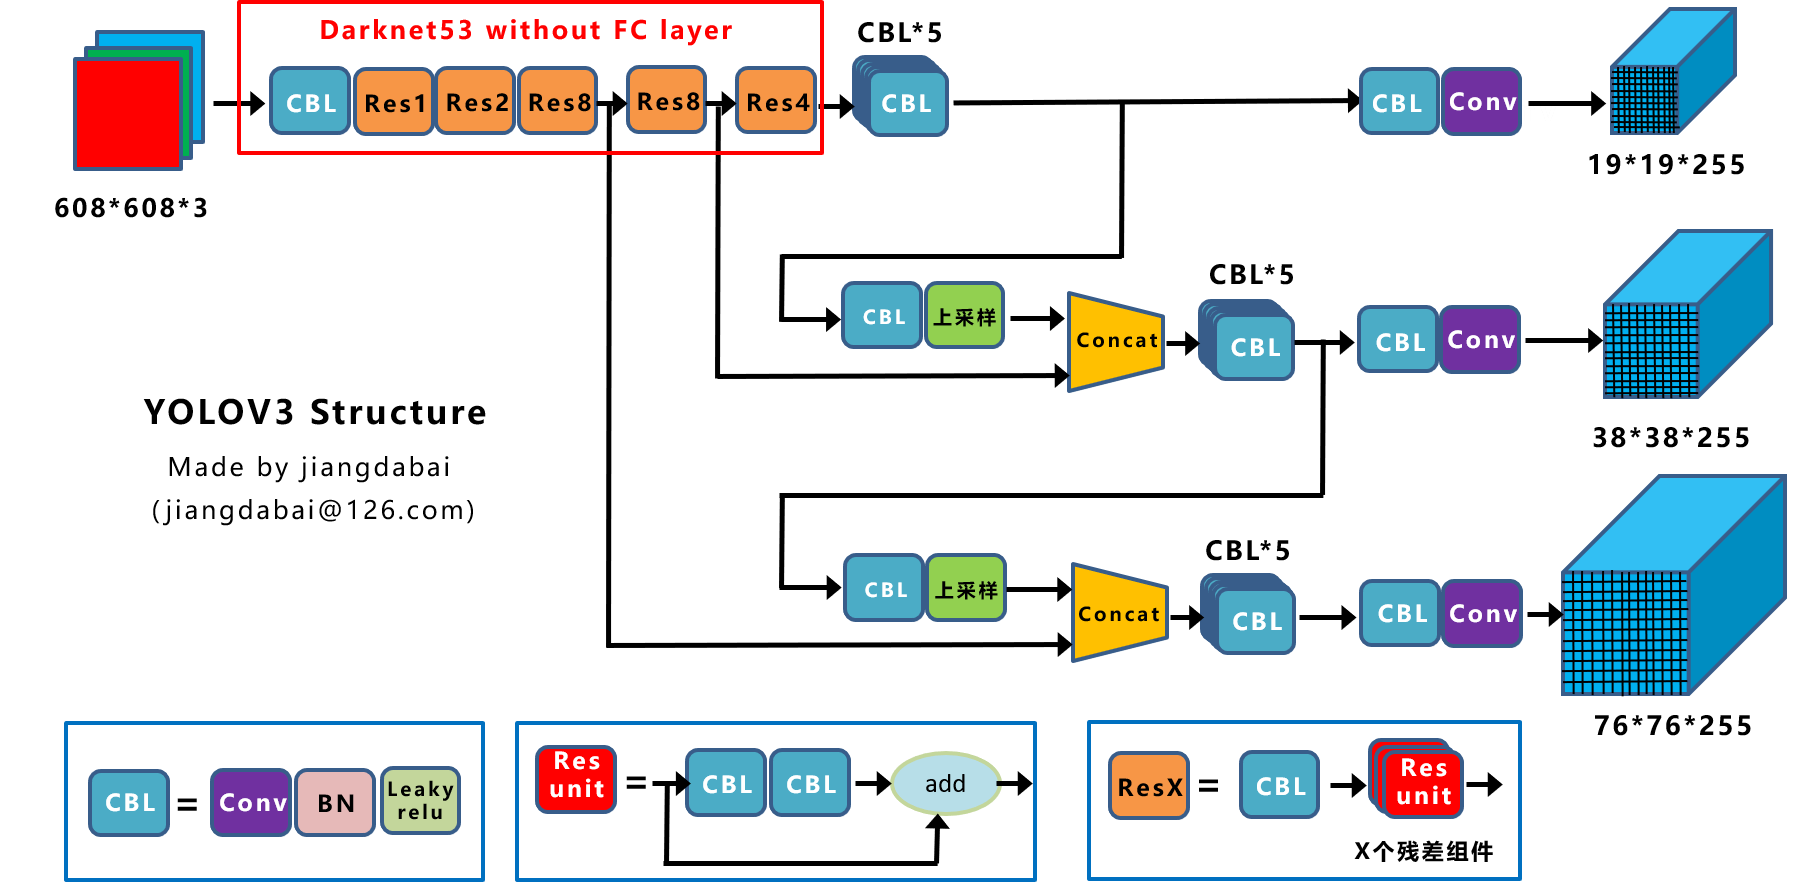
Yolov3的三个基本组件:
(1)CBL :Yolov3网络结构中的最小组件,由Conv+Bn+Leaky_relu激活函数三者组成。
(2)Res unit :借鉴Resnet网络中的残差结构,让网络可以构建的更深。
(3)ResX:由一个CBL和X个残差组件构成,是Yolov3中的大组件。每个Res模块前面的CBL都起到下采样的作用,因此经过5次Res模块后,得到的特征图是608->304->152->76->38->19大小。
其他基础操作:
(1)Concat :张量拼接,会扩充两个张量的维度,例如26×26×256和26×26×512两个张量拼接,结果是26×26×768。Concat和cfg文件中的route功能一样。
(2)Add:张量相加,张量直接相加,不会扩充维度,例如104×104×128和104×104×128相加,结果还是104×104×128。add和cfg文件中的shortcut功能一样。
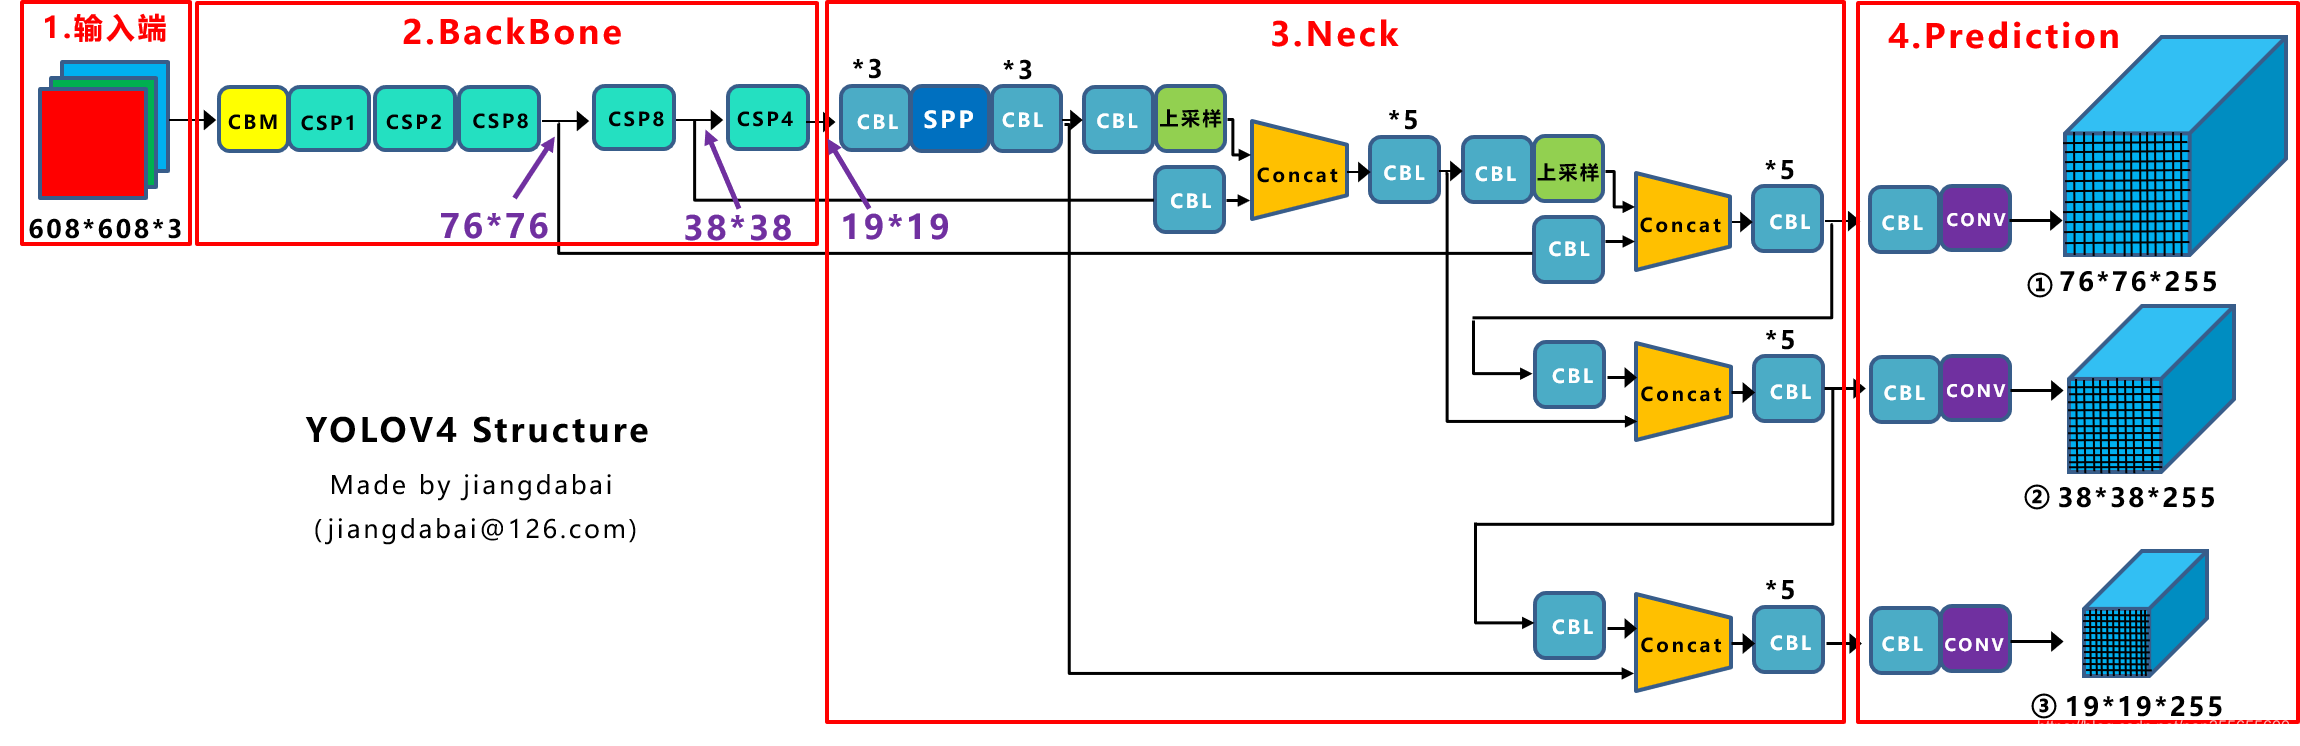
YoloV4网络结构图
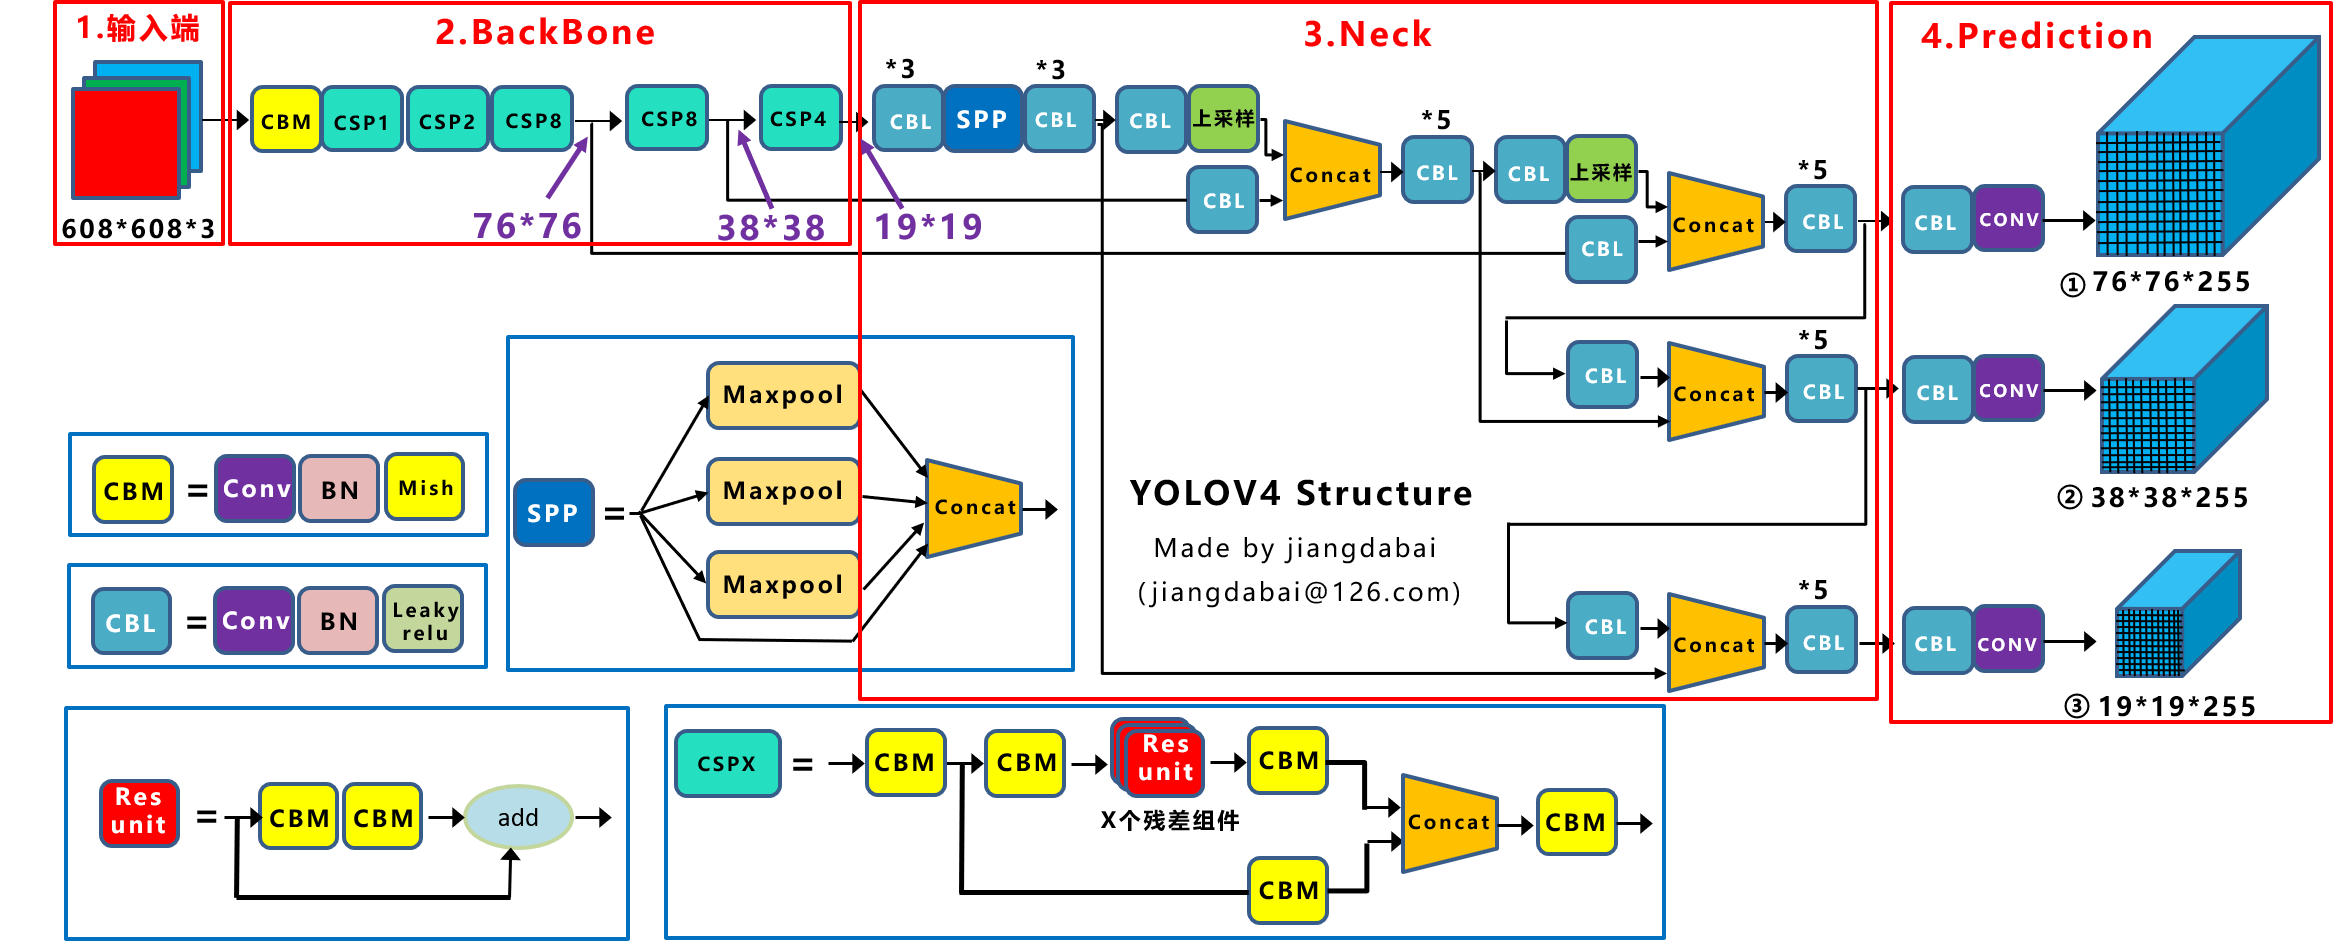
Yolov4的结构图和Yolov3相比,多了CSP结构,PAN结构,Yolov4的五个基本组件:
1. CBM:Yolov4网络结构中的最小组件,由Conv+Bn+Mish激活函数三者组成。
2. CBL:由Conv+Bn+Leaky_relu激活函数三者组成。
3. Res unit:借鉴Resnet网络中的残差结构,让网络可以构建的更深。
4. CSPX:借鉴CSPNet网络结构,由卷积层和X个Res unint模块Concat组成。
5. SPP:采用1×1,5×5,9×9,13×13的最大池化的方式,进行多尺度融合。 报名编程课程
其他基础操作:
1. Concat:张量拼接,维度会扩充,和Yolov3中的解释一样,对应于cfg文件中的route操作。
2. Add:张量相加,不会扩充维度,对应于cfg文件中的shortcut操作。
(1)Mosaic数据增强
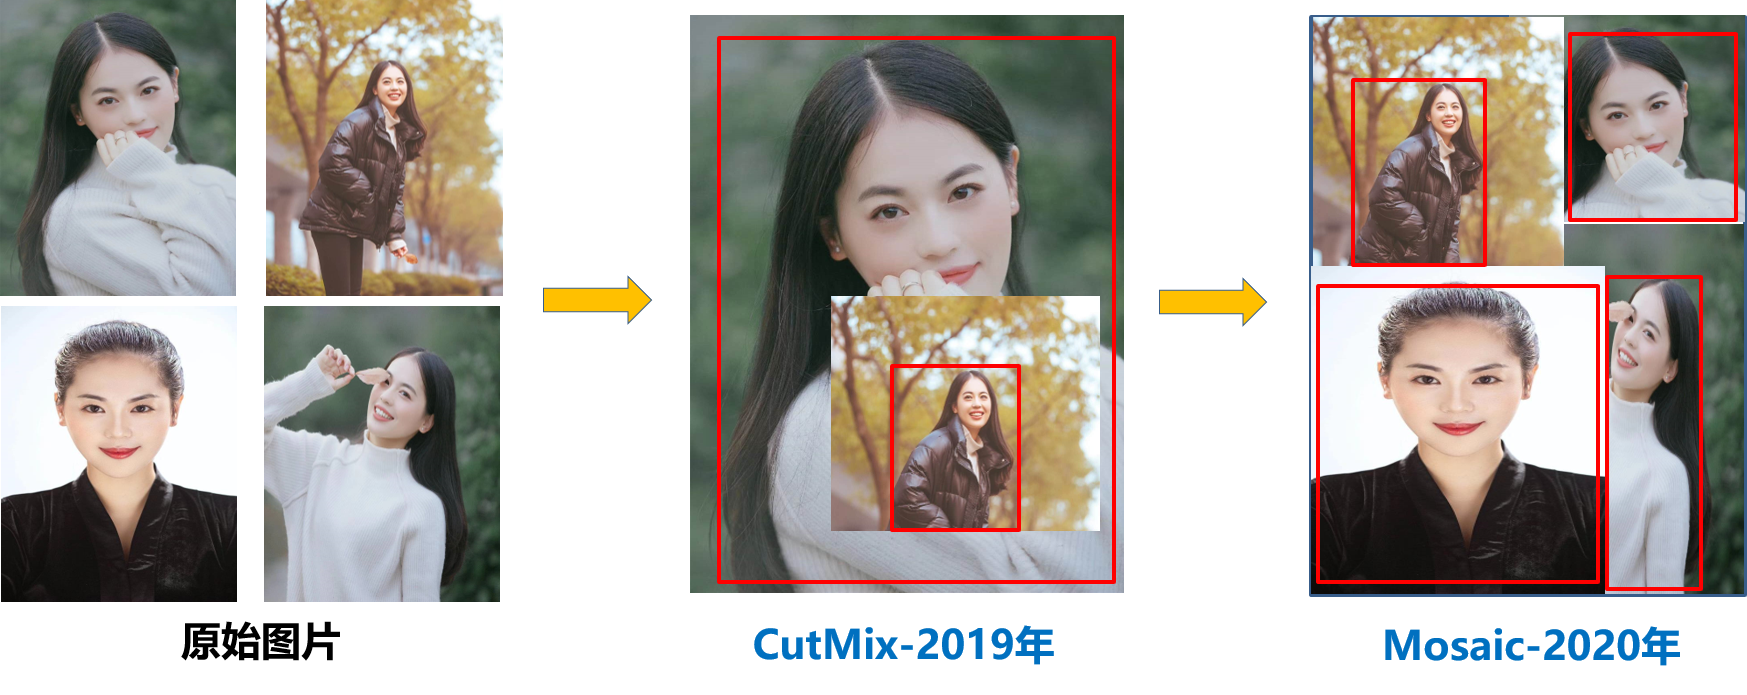
Yolov4中使用的Mosaic是参考2019年底提出的CutMix数据增强的方式,但CutMix只使用了两张图片进行拼接,而Mosaic数据增强则采用了4张图片,随机缩放、随机裁剪、随机排布的方式进行拼接。
小目标的AP一般比中目标和大目标低很多。而Coco数据集中也包含大量的小目标,但比较麻烦的是小目标的分布并不均匀。2019年发布的论文《Augmentation for small object detection》对小、中、大目标的定义进行了区分
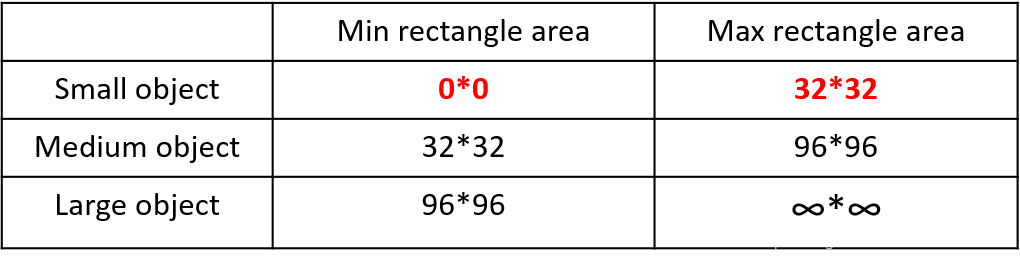
可以看到小目标的定义是目标框的长宽0×0~32×32之间的物体。
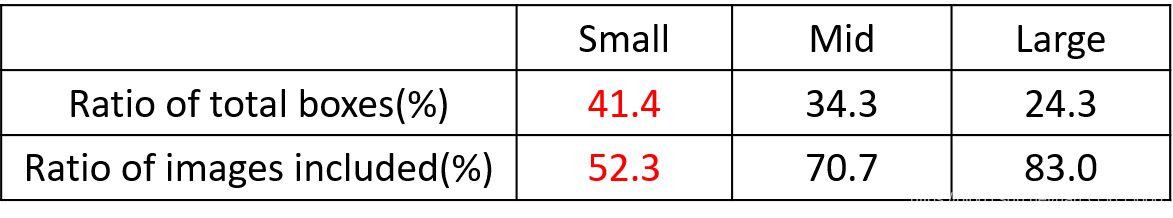
但在整体的数据集中,小、中、大目标的占比并不均衡。如上表所示,Coco数据集中小目标占比达到41.4%,数量比中目标和大目标都要多。但在所有的训练集图片中,只有52.3%的图片有小目标,而中目标和大目标的分布相对来说更加均匀一些。
针对这种状况,Yolov4的作者采用了Mosaic数据增强的方式。主要有几个优点:
a. 丰富数据集:随机使用4张图片,随机缩放,再随机分布进行拼接,大大丰富了检测数据集,特别是随机缩放增加了很多小目标,让网络的鲁棒性更好。
b. 减少GPU:Mosaic增强训练时,可以直接计算4张图片的数据,使得Mini-batch大小并不需要很大,一个GPU就可以达到比较好的效果。
(2)CSPDarknet53
CSPDarknet53是在Yolov3主干网络Darknet53的基础上,借鉴2019年CSPNet的经验产生的Backbone结构,其中包含了5个CSP模块。每个CSP模块前面的卷积核的大小都是3×3,步长为2,因此可以起到下采样的作用。输入图像是608*608,经过5次CSP模块后得到19*19大小的特征图。作者只在Backbone中采用了Mish激活函数,网络后面仍然采用Leaky_relu激活函数。
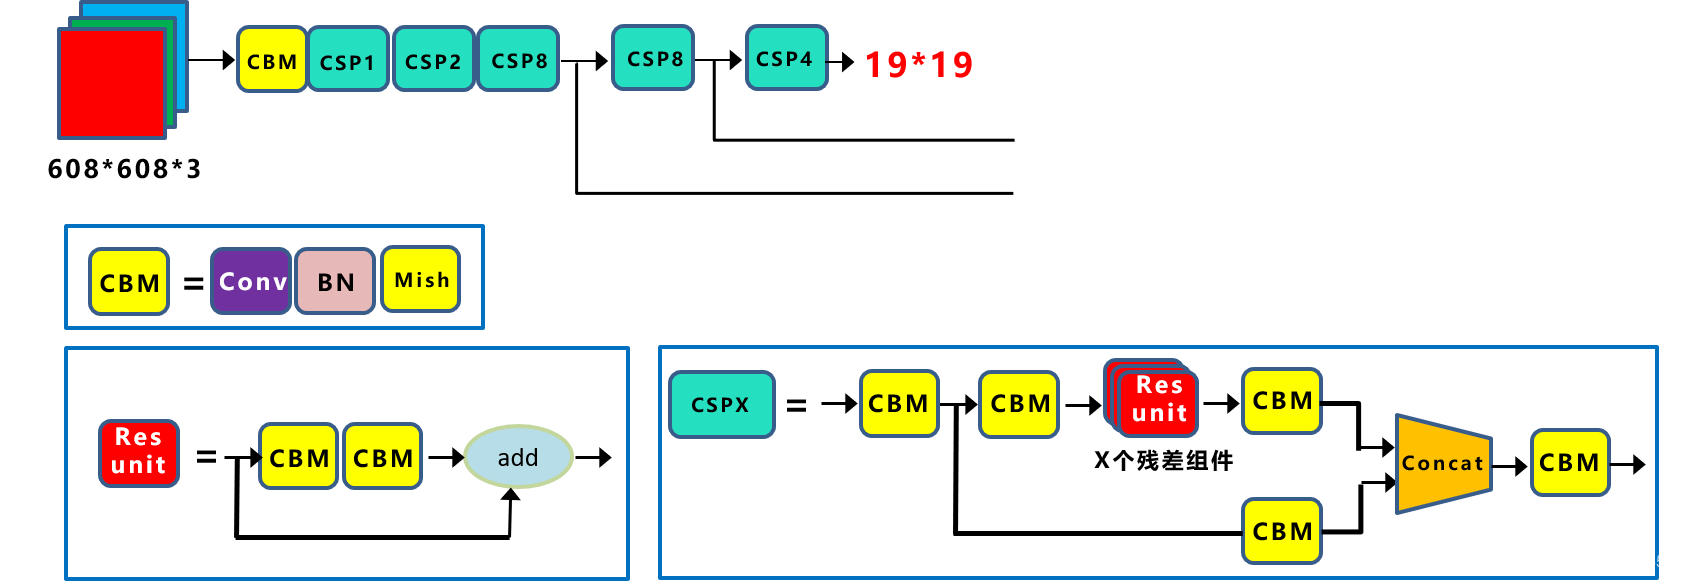
CSPNet全称是Cross Stage Paritial Network,主要从网络结构设计的角度解决推理中从计算量很大的问题。CSPNet的作者认为推理计算过高的问题是由于网络优化中的梯度信息重复导致的。因此采用CSP模块先将基础层的特征映射划分为两部分,然后通过跨阶段层次结构将它们合并,在减少了计算量的同时可以保证准确率。
(3)Mish激活函数
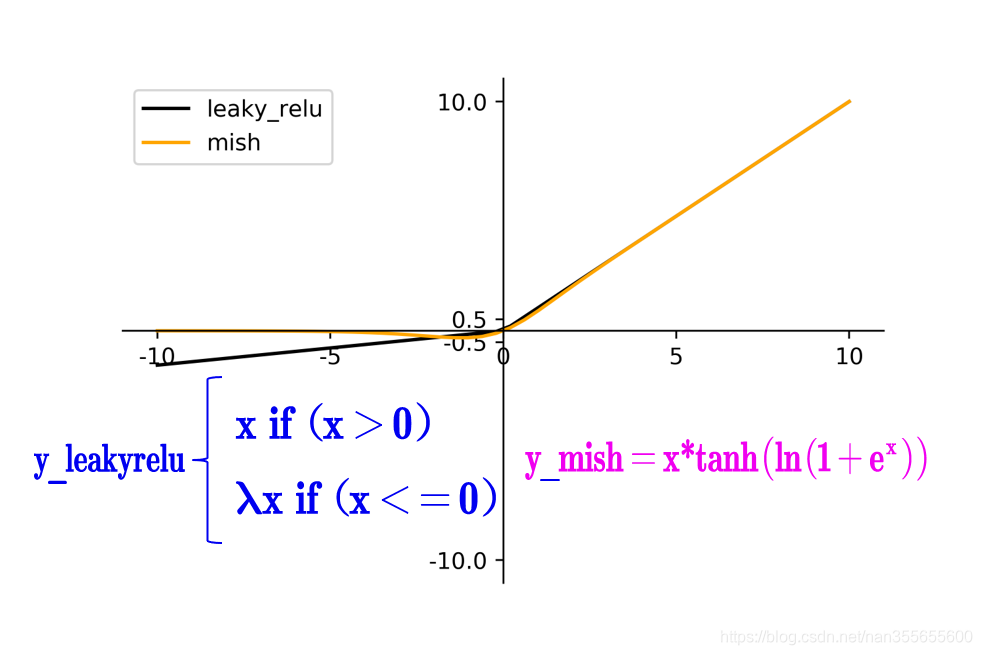
Mish激活函数是2019年下半年 提出的激活函数,和leaky_relu激活函数 的图形对比如下:
-
处处平滑(
连续)与连续可导:
-
Leaky ReLU 在 x=0 处存在分段转折点,一阶导数不连续,容易产生突变。
-
Mish 全区间平滑可导,能够在梯度下降和反向传播中提供更稳健的梯度流动,显著改善模型的优化地形(Loss Landscape),使训练更易收敛且拟合能力更强。
-
-
非单调性(Non-Monotonicity):
-
Leaky ReLU 在负数区为单调线性函数(斜率通常取 0.01)。
-
Mish 在负值区存在轻微的下凹负值(在 x ≈ -1.19 处取得极小值约为 -0.31)。这一微小的非单调特性保留了强烈的非线性表征能力,有助于捕捉负权重的复杂语义。
-
-
避免梯度死锁与更好的正则化效果:
- Mish 属于无上界、有下界(Bounded Below, Unbounded Above)函数。无上界避免了正区间的饱和现象,有下界则带来了强正则化约束,在保持信息流高效通过的同时防止神经元过拟合。
| 特性 | Leaky ReLU | Mish |
|---|---|---|
| 数学公式 | ||
| 0点导数 | 不连续(突变) | 平滑连续 |
| 单调性 | 全区间单调 | 非单调(负值区微凹) |
| 计算复杂度 | 极低(仅需条件判断和乘法) | 较高(包含指数、对数与双曲正切) |
| 典型应用场景 | 轻量级网络、边缘部署 | YOLOv4 等追求高精度的深度网络 |
(4)SPP模块
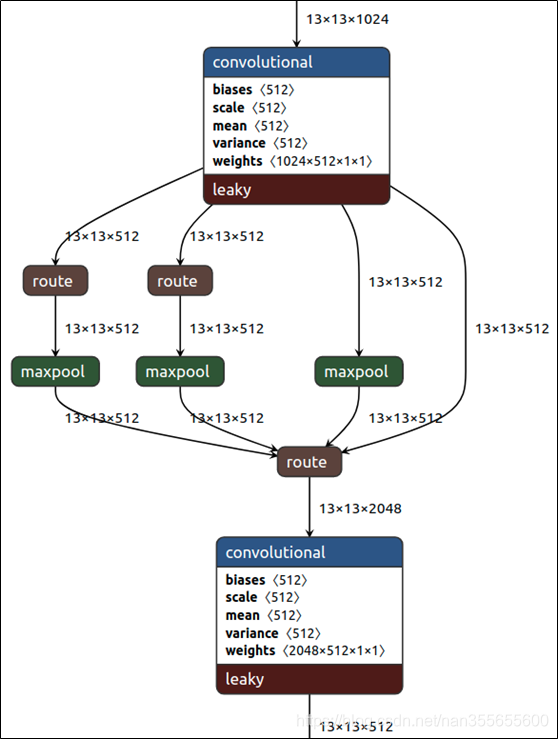
虽然在 YOLOv3 原始论文中未提及,但作者在主干网络(Backbone)中添加了一个改进的 SPP 模块。该模块将多个无下采样(步长 stride = 1)的最大池化(Max Pooling)输出进行拼接(Concatenate),每个池化核的大小不同(k x k,其中 k = 1, 5, 9, 13),从而获得了更大的感受野(Receptive Field)。这个版本被称为 YOLOv3-spp。
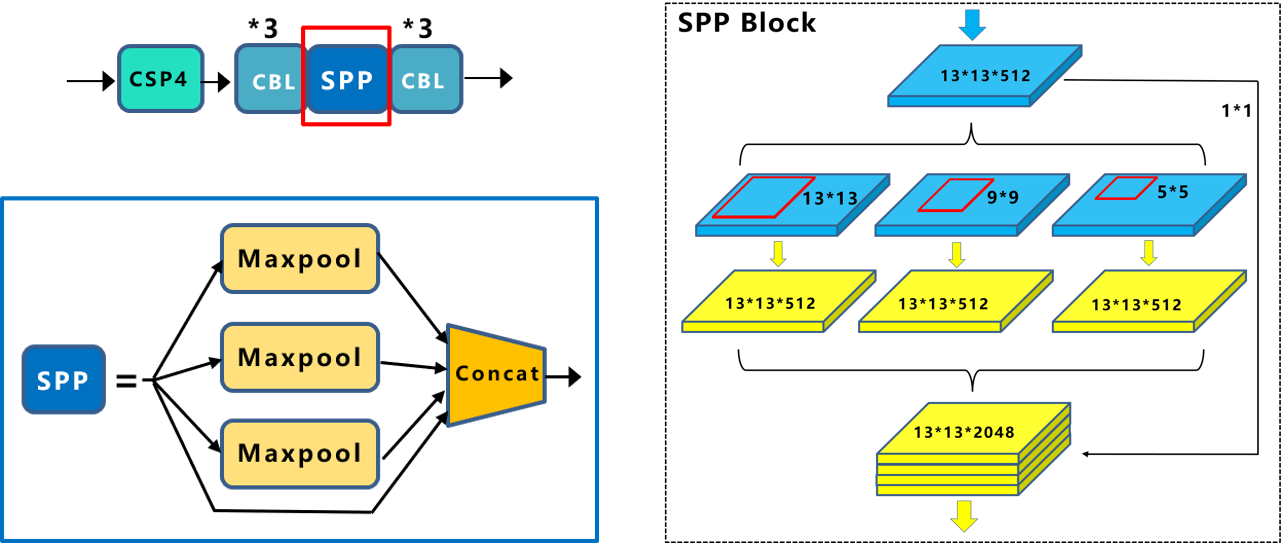
在SPP模块中,最大池化采用padding操作,移动的步长为1,比如13×13的输入特征图,使用5×5大小的池化核池化,padding=2,因此池化后的特征图仍然是13×13大小。
(5)FPN+PAN
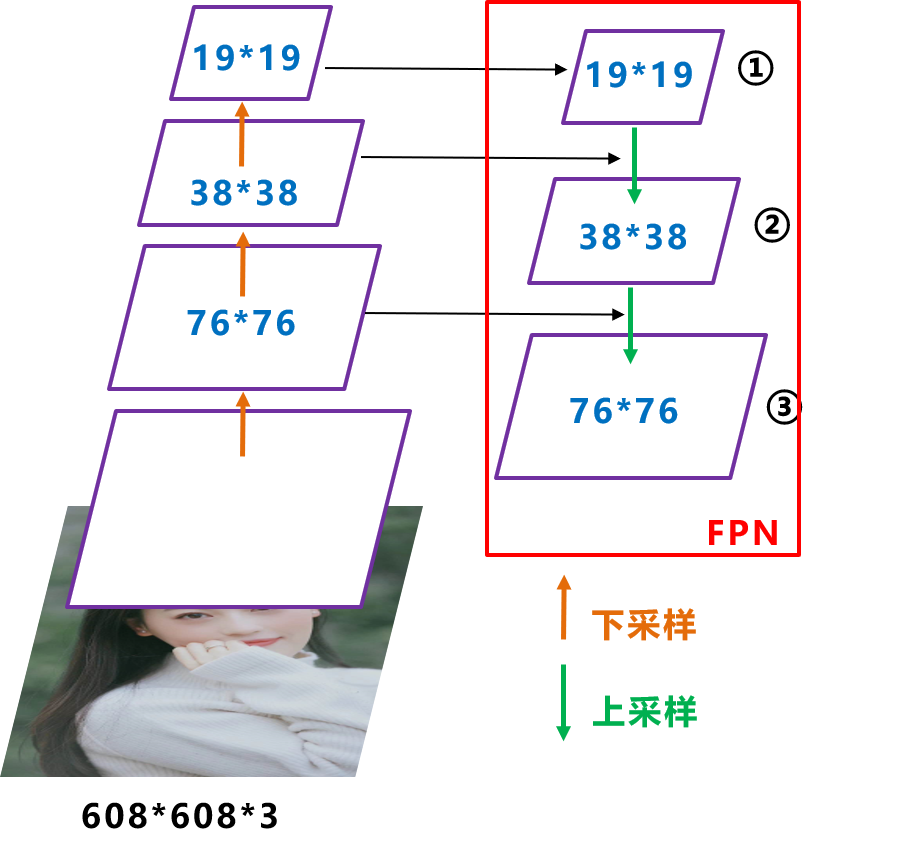
FPN 是自顶向下的,将高层的特征信息通过上采样 的方式进行传递融合,得到进行预测的特征图。Prediction 中用于预测的三个特征图①19×19×255 、②38×38×255 、③76×76×255,
将Yolov3中Neck 部分用立体图画出来,更直观的看下两部分之间是如何通过FPN结构融合的。
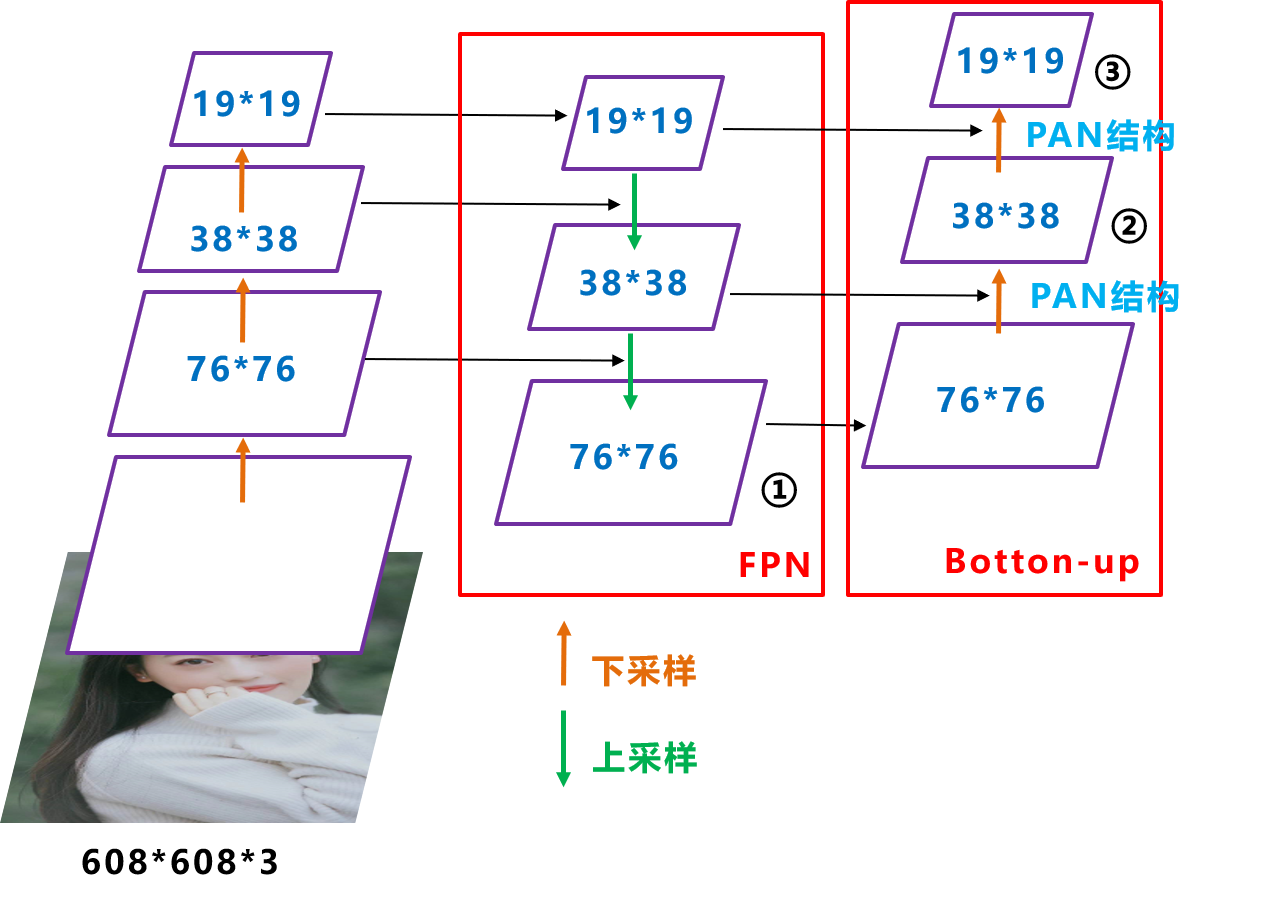
Yolov4在FPN层后面添加了一个自底向上的特征金字塔 。其中包含两个PAN结构 。这样结合操作,FPN层自顶向下传达强语义特征 ,而特征金字塔则自底向上传达强定位特征。 Prediction中用于预测的三个特征图:①76×76×255 ,②38×38×255 ,③19×19×255。
将Yolov4中Neck 部分用立体图画出来,更直观的看下两部分之间是如何通过FPN结构融合的。
(6)回归损失函数
目标检测任务的损失函数一般由Classificition Loss(分类损失函数)和Bounding Box Regeression Loss(回归损失函数)两部分构成。Bounding Box Regeression的Loss发展过程是:Smooth L1 Loss-> IoU Loss(2016)-> GIoU Loss(2019)-> DIoU Loss(2020)->CIoU Loss(2020)
a. IOU_loss
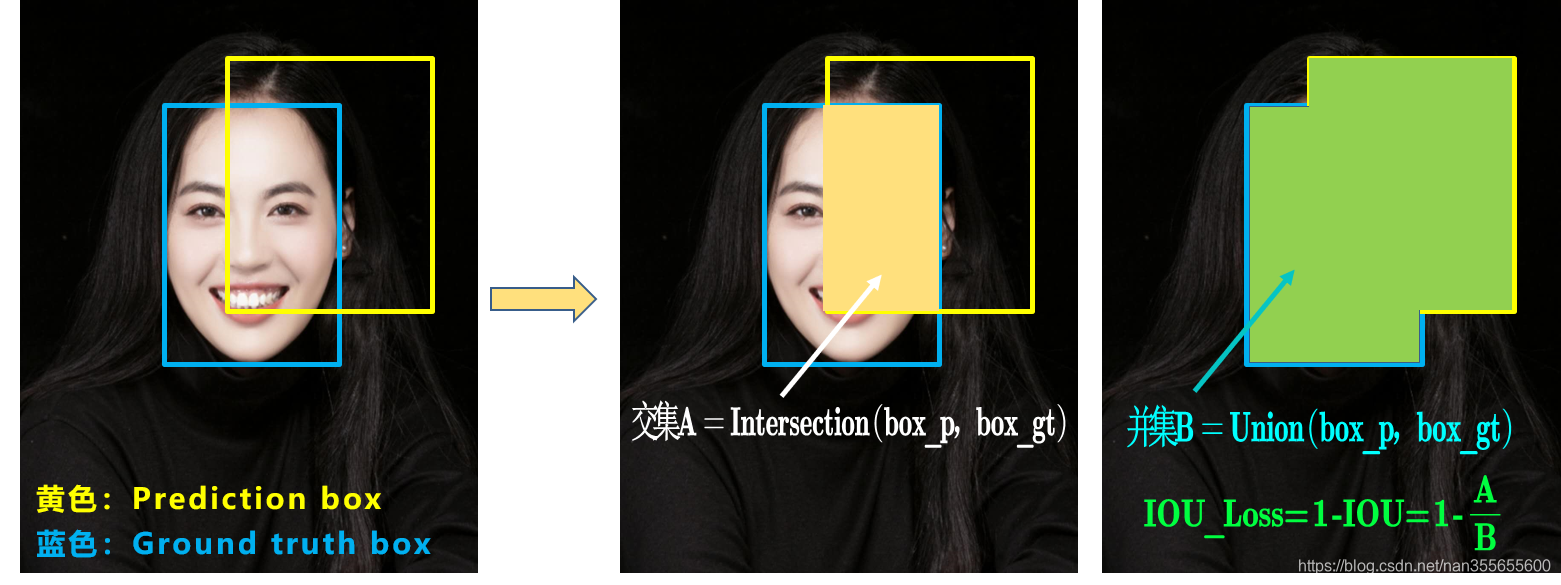
可以看到IOU的loss其实很简单,主要是交集/并集,但其实也存在两个问题。
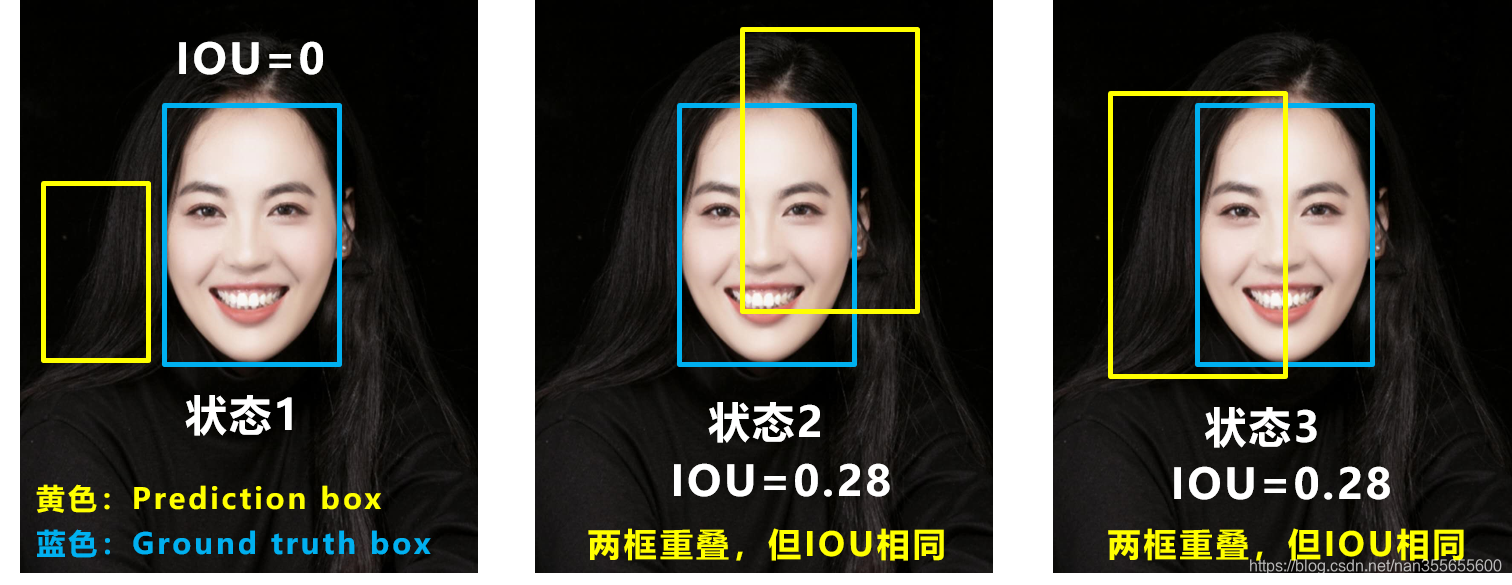
问题1 :即状态1的情况,当预测框和目标框不相交时,IOU=0,无法反应两个框距离的远近,此时损失函数不可导,IOU_Loss无法优化两个框不相交的情况。
问题2:即状态2和状态3的情况,当两个预测框大小相同,两个IOU也相同,IOU_Loss无法区分两者相交情况的不同。
b. GIOU_loss
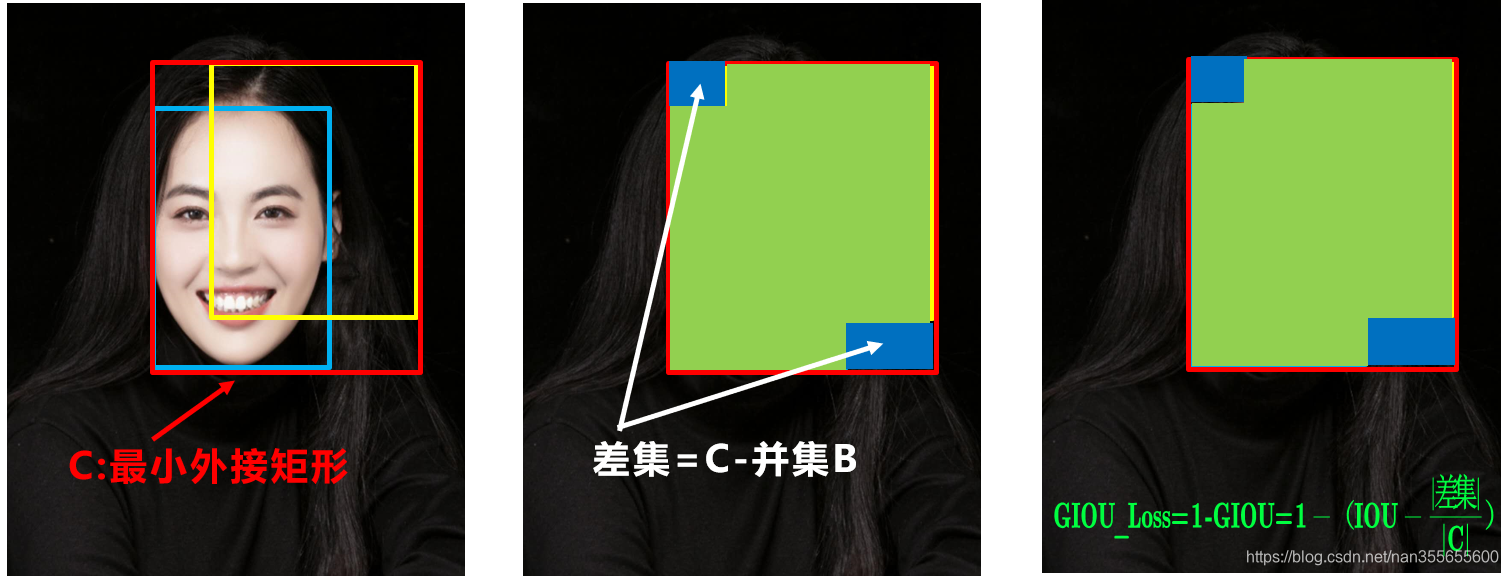
可以看到右图GIOU_Loss中,增加了相交尺度的衡量方式,缓解了单纯IOU_Loss时的尴尬。但还存在一种不足:
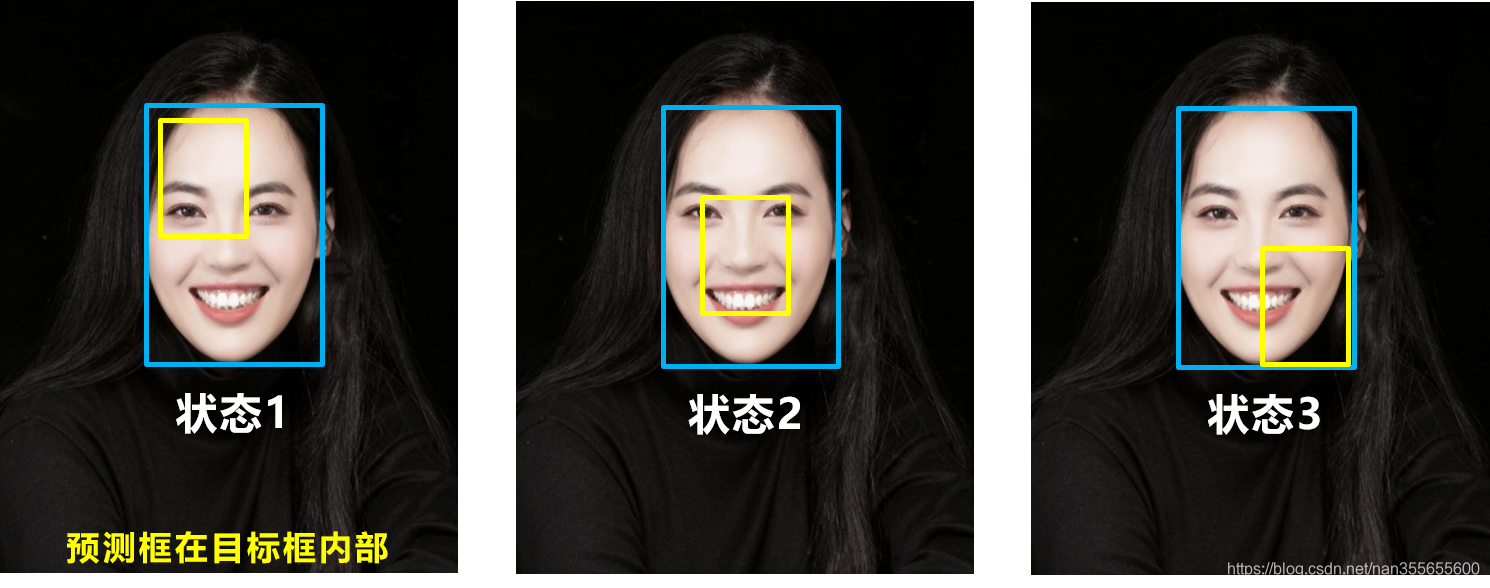
问题:状态1、2、3都是预测框在目标框内部且预测框大小一致的情况,这时预测框和目标框的差集都是相同的,因此这三种状态的GIOU值也都是相同的,这时GIOU退化成了IOU,无法区分相对位置关系。
c. DIOU_loss
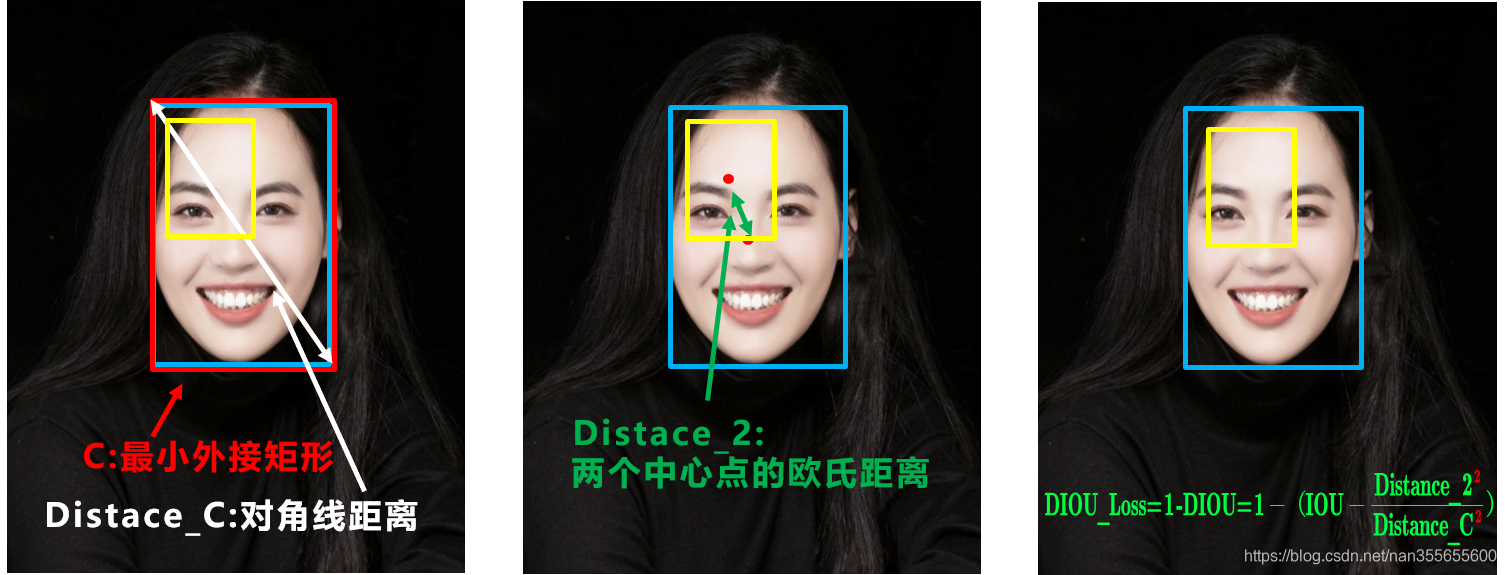
DIOU_Loss考虑了重叠面积和中心点距离,当目标框包裹预测框的时候,直接度量2个框的距离,因此DIOU_Loss收敛的更快。但并没有考虑到长宽比。
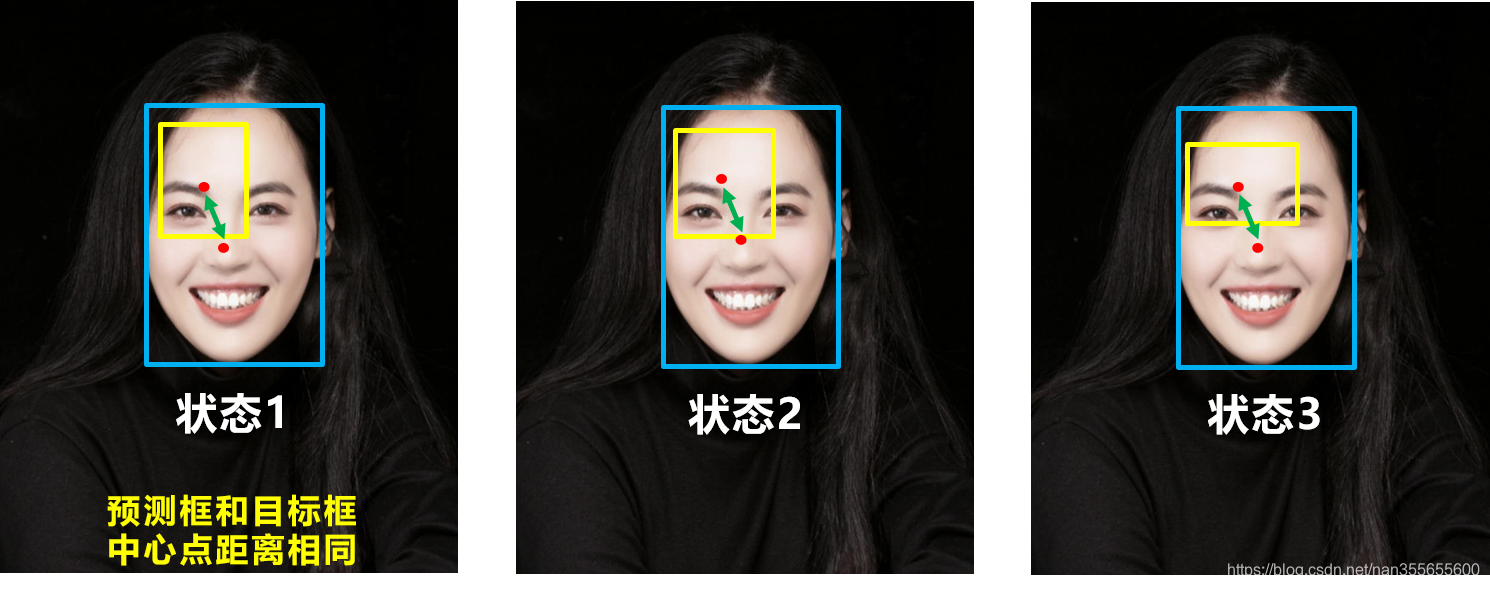
问题:上面三种状态,目标框包裹预测框,本来DIOU_Loss可以起作用。但预测框的中心点的位置都是一样的,因此按照DIOU_Loss的计算公式,三者的值都是相同的。
d. CIOU_loss
CIOU_Loss和DIOU_Loss前面的公式都是一样的,不过在此基础上增加了一个影响因子,将预测框和目标框的长宽比都考虑了进去。
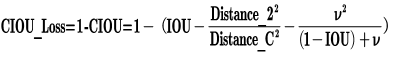
其中v是衡量长宽比一致性的参数,也可以定义为:
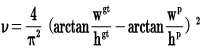
CIOU_Loss将目标框回归函数应该考虑三个重要几何因素:重叠面积、中心点距离,长宽比全都考虑进去了。Yolov4中采用了CIOU_Loss 的回归方式,使得预测框回归的速度和精度 更高。
IOU_Loss:主要考虑检测框和目标框重叠面积。
GIOU_Loss:在IOU的基础上,解决边界框不重合时的问题。
DIOU_Loss:在IOU和GIOU的基础上,考虑边界框中心点距离的信息。
CIOU_Loss:在DIOU的基础上,考虑边界框宽高比的尺度信息。
参考资料:
深入浅出Yolo系列之Yolov3&Yolov4&Yolov5&Yolox核心基础知识完整讲解_yolo4理解江大白-CSDN博客