一、代码运行后长什么样
在讲原理和代码之前,先让你看看最终做出来的东西长什么样。
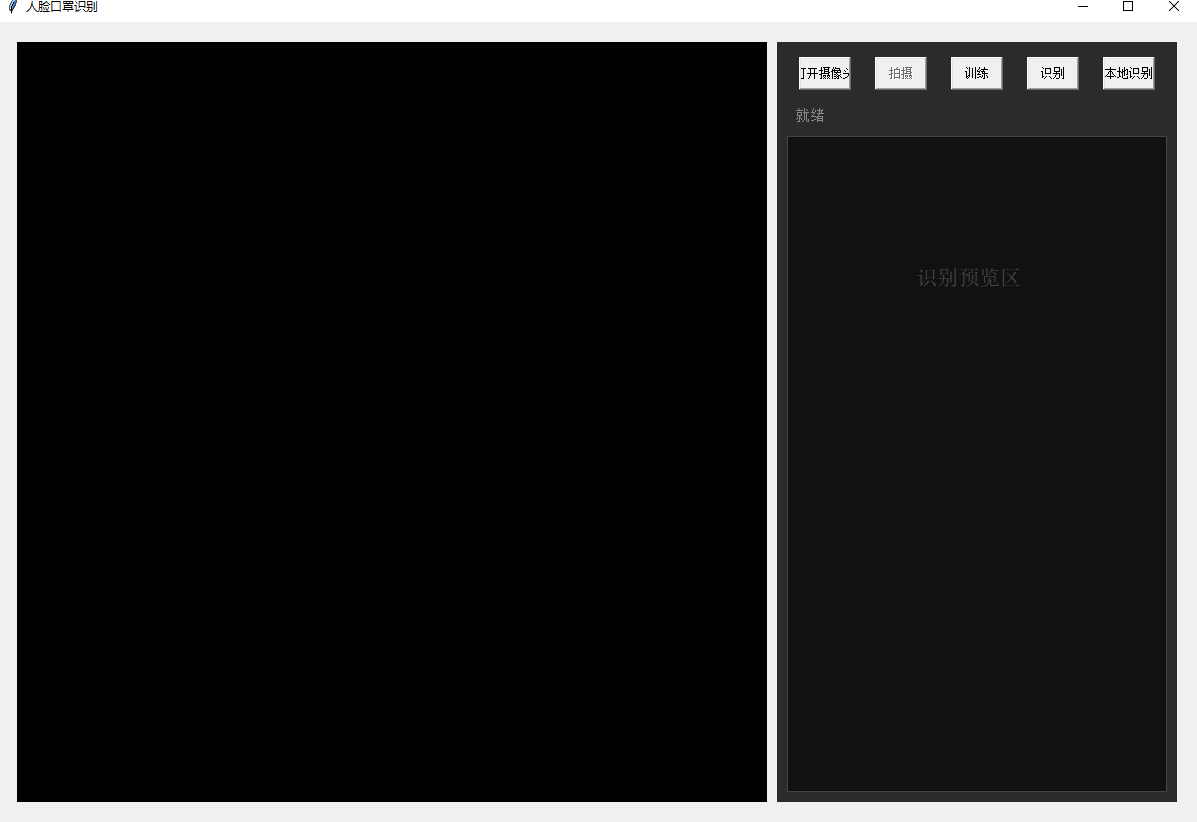
运行代码后,会弹出一个图形化窗口。左边占 70% 是摄像头实时预览区,右边占 30% 是控制面板------顶部 5 个按钮横向排列(打开摄像头、拍摄、训练、识别、本地识别),中间是状态栏,下方是大尺寸的识别预览区。
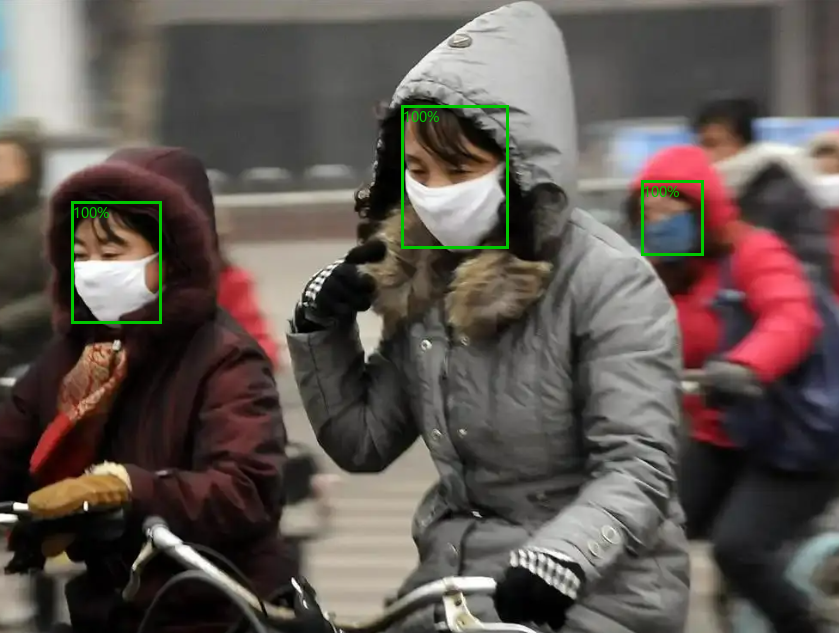
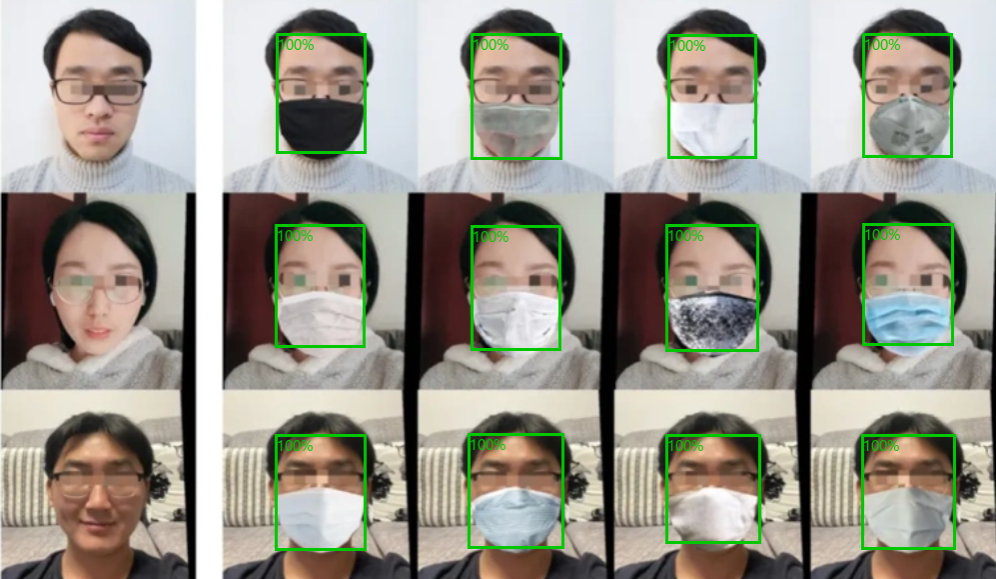
最终效果是这样的:我们准备了一张含有 15****张人脸 的合影------一排 5 个人,共 3 排,其中混杂着戴口罩和不戴口罩的人。点击识别后,系统一下全部识别出来------谁戴了口罩、谁没戴,一目了然。戴口罩的人脸被绿色框标出,没戴的人不框(但在左上角用黄色文字提示"X 人戴口罩 / Y 人没戴")。
如下图:
二、两阶段 Pipeline 思想
2.1 类比:保安检查法
上一篇文章我们解决了"找到人脸在哪"的问题------用 YOLOv8 可以把图中所有人脸都框出来。但这只是第一步。就像商场门口的保安,他的工作分两步:
- 先数人头 :看到来了 15 个人
- 再逐个检查 :看每个人有没有戴口罩
我们的系统也是一样的思路。先用 YOLOv8 找到所有人脸的位置(数人头),然后把每张人脸裁出来,送进我们之前训练好的口罩 CNN 分类器(逐个检查)。这就是两阶段****Pipeline 。
2.2 两阶段对比
| 维度 | 第 1 阶段:人脸检测 | 第 2 阶段:口罩分类 |
|---|---|---|
| 任务 | 找到图中所有人脸的位置 | 判断每张人脸有没有戴口罩 |
| 技术 | YOLOv8(目标检测模型) | CNN(图像分类模型,第 7 篇训练的那个) |
| 输入 | 一整张图片 | 裁剪出的一张张人脸小图 |
| 输出 | 每张人脸的坐标框 (x1, y1, x2, y2) | "戴口罩"或"没戴口罩" + 置信度 |
| 模型来源 | 预训练模型,直接拿来用 | 自己收集样本训练的 |
2.3 串联流程
把两阶段串起来的完整流程是这样的:
- 原图 → YOLOv8 检测 → 得到 N 个人脸坐标框
- 逐个裁剪每张人脸(加一点边距,避免裁太紧)
- 裁剪后的人脸 → 预处理(缩放到 128×128、归一化)→ 送入口罩 CNN
- CNN 输出分类结果:戴口罩 or 没戴口罩
- 在原图上绘制标注:绿色框 = 戴口罩,黄色文字 = 没戴口罩
这个串联逻辑的核心在 human_mask_identifier.py 的 identify() 函数里。
注意:两个阶段用的模型都是已经训练好的------YOLOv8 是别人训练好的人脸检测器,口罩 CNN 是我们第 7 篇自己训练的。这里不需要重新训练任何模型,只需要把两个模型"接"起来用。
三、项目文件目录结构
sample/humanmaskdetect/
├── face_recog_model/
│   └── yolov8n-face.pt       # YOLOv8 人脸检测模型(约 6MB,第 8 篇已下载)
├── identify/                  # 待识别图片目录
├── outputs/                   # 识别结果输出目录
├── samples/
│   ├── positive/              # 戴口罩样本(321 张)
│   └── negative/              # 没戴口罩样本(323 张)
├── model/
│   ├── config.json            # 口罩 CNN 模型配置
│   └── mask_cnn.pth           # 口罩 CNN 模型权重
├── logs/                      # 训练日志
├── main.py                    # 公共模块(配置、模型定义、数据增强)
├── train_mask.py              # 训练脚本
├── human_mask_identifier.py   # 串联识别模块(检测 + 分类 + 标注)
└── human_mask_sample.py       # GUI 界面
今天我们聚焦 4****个核心 Python 文件 :main.py、train_mask.py、human_mask_identifier.py、human_mask_sample.py。它们各司其职,串联起完整的训练和识别流程。
四、项目依赖说明
运行今天的代码,需要以下 Python 依赖(都已在根目录 requirements.txt 中):
bash
numpy>=1.24,<2.0
opencv-python>=4.8
Pillow>=10.0
torch>=2.0
torchvision>=0.15
ultralytics>=8.0
tqdm>=4.66| 依赖包 | 作用 | 说明 |
|---|---|---|
| torch + torchvision | 深度学习框架 | 口罩 CNN 模型的训练和推理 |
| ultralytics | YOLOv8 框架 | 提供人脸检测能力(第 8 篇已安装) |
| opencv-python | 图像处理 | 读取图片、颜色转换、视频流处理 |
| Pillow | 图像绘制 | 在图片上画框、写中文标注 |
| numpy | 数值计算 | 处理坐标数组、图像数组运算 |
| tqdm | 进度条 | 训练时显示进度 |
五、核心代码讲解
5.1 main.py --- 公共模块
main.py 是整个项目的"基础设施",其他三个文件都从这里导入共用逻辑。它包含:路径配置、数据增强开关、设备检测、CNN 模型定义、图像预处理。
数据增强开关
python
AUGMENT_MIRROR = True       # 水平镜像
AUGMENT_NOISE = False        # 高斯噪点
AUGMENT_BRIGHTNESS = False   # 亮度变化
这三个开关控制训练时的数据增强策略。目前只开启了水平镜像------为什么关掉另外两个?这是实战中踩坑后的结论,后面第六章详细讲。
路径配置
python
BASE_DIR = os.path.dirname(os.path.abspath(__file__))
POSITIVE_DIR = os.path.join(BASE_DIR, "samples", "positive")
NEGATIVE_DIR = os.path.join(BASE_DIR, "samples", "negative")
MODEL_DIR = os.path.join(BASE_DIR, "model")
MODEL_PATH = os.path.join(MODEL_DIR, "mask_cnn.pth")
IMG_SIZE = 128
所有路径都基于脚本所在目录,用 os.path.join 拼接,保证跨平台兼容。IMG_SIZE = 128 是 CNN 的输入尺寸------所有人脸图片都会被缩放到 128×128 再送进网络。
设备检测
python
def get_device():
    if torch.cuda.is_available():
        return torch.device("cuda")
    elif torch.backends.mps.is_available():
        return torch.device("mps")
    else:
        return torch.device("cpu")
CUDA → MPS → CPU 三级回退。有 NVIDIA 显卡用 GPU 加速,Mac 用 MPS(Apple Silicon GPU),都没有就用 CPU。这段代码让你在不同电脑上都能跑,只是速度不同。
MaskCNN 模型
python
class MaskCNN(nn.Module):
    def __init__(self, num_classes=2):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 16, kernel_size=3, padding=1),
            nn.BatchNorm2d(16), nn.ReLU(inplace=True), nn.MaxPool2d(2),
            nn.Conv2d(16, 32, kernel_size=3, padding=1),
            nn.BatchNorm2d(32), nn.ReLU(inplace=True), nn.MaxPool2d(2),
            nn.Conv2d(32, 64, kernel_size=3, padding=1),
            nn.BatchNorm2d(64), nn.ReLU(inplace=True), nn.MaxPool2d(2),
        )
        self.classifier = nn.Sequential(
            nn.Dropout(0.3),
            nn.Linear(64 * 16 * 16, 128), nn.ReLU(inplace=True),
            nn.Dropout(0.3),
            nn.Linear(128, num_classes),
        )
3 层卷积 + 2 层全连接的轻量级二分类网络。这个模型结构在第 7 篇已经逐层详细讲解过,这里不再重复。简单回顾:通道数 3→16→32→64 逐层增加,每层卷积后跟批归一化和池化;分类头用 Dropout 防过拟合,最终输出 2 个值对应"没戴口罩"和"戴口罩"的得分。
5.2 train_mask.py --- 训练脚本
训练脚本负责加载样本、拆分数据集、执行训练循环、保存最佳模型。
超参数
python
EPOCHS = 50                 # 训练轮数
BATCH_SIZE = 10             # 批大小
LEARNING_RATE = 0.001       # 学习率
VAL_RATIO = 0.2 # 验证集比例- EPOCHS = 50 :把整个训练集过 50 遍。
- BATCH_SIZE = 10 :每次喂 10 张图片。比第 7 篇的 8 稍大,因为现在样本更多了(321+323)。
- LEARNING_RATE = 0.001 :Adam 优化器的经典默认值。
数据集拆分:按类别分别拆分
python
pos_train_raw, pos_val_raw = _split(pos_all)
neg_train_raw, neg_val_raw = _split(neg_all)正样本和负样本分别拆分 train/val,保证验证集中正负比例均衡。如果随机混着拆,可能出现验证集里全是正样本的极端情况,验证准确率就不真实了。
数据增强只作用于训练集正样本
python
# 训练集:原始图 + 数据增强(仅正样本增强)
train_samples = []
for img, lbl in pos_train_raw:
    for aug_img in apply_augmentations(img):
        train_samples.append((aug_img, lbl))
train_samples.extend(neg_train_raw)  # 负样本不增强

# 验证集:只用原始图,不做增强
val_samples = pos_val_raw + neg_val_raw
正样本经过增强后数量翻倍(开了 mirror,每张变 2 张)。负样本不增强,验证集也不增强------验证集必须反映真实数据,才能评估模型的泛化能力。
训练循环
训练循环是标准的"训练 → 验证 → 保存最佳模型"模式,和第 7 篇完全一致,这里不再展开。核心就是每个 epoch 先用训练集算损失、反向传播、更新权重,再用验证集评估准确率,只在验证准确率更高时才保存模型。
5.3 human_mask_identifier.py --- 串联识别模块(重点)
这是今天最核心的文件------它把 YOLOv8 人脸检测和口罩 CNN 分类串联起来,实现"一张图 → 检测所有人脸 → 逐个判断有没有戴口罩 → 绘制标注"的完整流程。
两阶段串联流程
python
def identify(frame_bgr):
    yolo = _get_yolo()

    # ---- 第 1 阶段:YOLOv8 检测人脸 ----
    results = yolo.predict(source=frame_bgr, conf=0.25, verbose=False)

    # 提取边界框
    boxes = []
    if results[0].boxes is not None and len(results[0].boxes) > 0:
        for box in results[0].boxes:
            x1, y1, x2, y2 = box.xyxy[0].cpu().numpy()
            boxes.append([x1, y1, x2, y2])

    # ---- 第 2 阶段:逐张人脸裁剪 + CNN 分类 ----
    face_results = []
    for box in boxes:
        x1, y1, x2, y2 = [int(v) for v in box]
        margin = 5
        face_crop = pil_img.crop((x1-margin, y1-margin, x2+margin, y2+margin))
        label, conf = _classify_face(face_crop)
        face_results.append((x1, y1, x2, y2, label, conf))

    # ---- 统计 + 绘制标注 ----
    mask_count = sum(1 for r in face_results if r[4] == 1)
    ...
整个流程分三步:
- YOLOv8 检测 :输入整张图,输出所有人脸的坐标框。conf=0.25 是置信度阈值,超过 25% 就认为是人脸。
- 逐张分类 :把每张人脸裁出来(加 5 像素边距),送入口罩 CNN 得到分类结果。
- 统计绘制 :根据分类结果在原图上画标注。
模型懒加载
python
_model = None
_yolo = None

def _get_model():
    global _model
    if _model is None:
        _model = torch.load(MODEL_PATH, map_location=_device, weights_only=False)
        _model.eval()
    return _model

def _get_yolo():
    global _yolo
    if _yolo is None:
        _yolo = YOLO(YOLO_FACE_MODEL)
    return _yolo
两个模型都只在第一次调用时加载,后续复用。这样批量识别多张图片时不用每次重新加载模型,速度更快。
四种情况的标注逻辑
识别完成后,根据图中人脸的口罩情况,有四种不同的标注策略:
| 情况 | 条件 | 标注方式 |
|---|---|---|
| 无人脸 | 检测到 0 张人脸 | 左上角红色文字"未检测到人脸" |
| 全没戴 | mask_count = 0 | 左上角黄色文字"没有带口罩" |
| 全戴了 | mask_count = 总人数 | 全部绿色框出 + 置信度 |
| 部分戴了 | 0 < mask_count < 总人数 | 只框戴口罩的人(绿色)+ 置信度 |
python
if mask_count == 0:
    draw.text((10, 10), "没有带口罩", fill=COLOR_YELLOW, font=font)
elif mask_count == total:
    for x1, y1, x2, y2, label, conf in face_results:
        draw.rectangle([x1, y1, x2, y2], outline=COLOR_GREEN, width=3)
else:
    for x1, y1, x2, y2, label, conf in face_results:
        if label == 1:
            draw.rectangle([x1, y1, x2, y2], outline=COLOR_GREEN, width=3)
颜色方案:绿色 = 戴口罩,黄色 = 没戴口罩,红色 = 未检测到。部分戴口罩时,只框戴口罩的人(绿色),没戴的不框------这样一眼就能看出谁没戴。
5.4 human_mask_sample.py --- GUI 界面
human_mask_sample.py 用 Python 自带的 tkinter 搭建图形化界面,不需要额外安装任何 GUI 库。
界面布局
窗口左右分栏:
- 左侧 70% :摄像头预览区(Canvas 组件)
- 右侧 30% :顶部 5 个按钮 + 状态栏 + 识别预览区
5 个按钮:
| 按钮 | 功能 |
|---|---|
| 打开摄像头 | 开启/关闭摄像头,左侧实时显示画面 |
| 拍摄 | 从摄像头画面中抽帧保存为正样本 |
| 训练 | 后台运行 train_mask.py 训练脚本 |
| 识别 | 批量处理 identify/ 目录下所有图片 |
| 本地识别 | 选择一张本地图片进行识别 |
摄像头采集线程
python
def _read_frames(self):
    while self.running:
        ret, frame = self.cap.read()
        if not ret:
            break
        with self.frame_lock:
            self.latest_frame = frame
摄像头画面在独立的守护线程中采集,通过 threading.Lock 保护共享帧。主线程用 after() 定时读取最新帧并刷新 UI,避免界面卡死。这是 GUI 程序中处理实时视频的标准做法。
扫描线动画
识别时右侧预览区播放从上往下的青色扫描线,营造"正在扫描"的科技感。通过 Canvas 的 create_line() 定时重绘实现,识别完成后自动停止。
本地识别流程
python
def _on_identify_local(self):
    path = filedialog.askopenfilename(...)
    frame = cv2.imread(path)

    def _run():
        from human_mask_identifier import identify
        result = identify(frame)
        annotated = cv2.imread(result["saved_path"])
        self._show_on_scan_canvas(annotated)

    threading.Thread(target=_run, daemon=True).start()
点击"本地识别"→ 弹出文件选择框 → 选图 → 在后台线程中调用 identify() 函数 → 识别完成后在预览区显示标注结果。整个调用链很清晰:GUI → 识别模块 → YOLOv8 + CNN → 返回结果 → 显示。
六、训练样本与数据增强------实战经验总结
今天这篇文章最有价值的部分,可能就是这一章了。这些都是我们在实战中翻车、摸索、总结出来的经验。
6.1 样本规模
这次我们大幅扩充了训练样本:
- 正样本(戴口罩) :321 张
- 负样本(没戴口罩) :323 张
相比第 7 篇的 100+100,这次样本量翻了 3 倍多。为什么要扩充?因为我们要面对的场景更复杂了------不再只是"对着摄像头的一张脸",而是一张合影里 15 张各种角度、各种光照的人脸。
6.2 数据增强开关的最终取舍
代码里有三个数据增强开关,我们最终的选择是:
python
AUGMENT_MIRROR = True       # 水平镜像 ✅ 开启
AUGMENT_NOISE = False        # 高斯噪点 ❌ 关闭
AUGMENT_BRIGHTNESS = False   # 亮度变化 ❌ 关闭
只开了 mirror,关掉了 noise 和 brightness。为什么?因为后两个翻车了。
翻车一:高斯噪点让 V 字手势变成了"口罩"
开启 AUGMENT_NOISE = True 后,训练出来的模型在测试时发现:有人对着摄像头比 V 字手势放在脸前面,模型居然把 V 字手势识别成了"戴口罩"。
原因分析:加了噪点后,图片的局部纹理变得模糊。CNN 在噪点干扰下,把 V 字手势的两根手指之间的区域误判成了口罩的色块。噪点改变了脸部的细节特征,让 CNN "看花了眼"。
翻车二:亮度变化让高领毛衣变成了"口罩"
开启 AUGMENT_BRIGHTNESS = True 后,模型把冬天穿高领毛衣的人识别成了"戴口罩"。
原因分析:亮度变化后,高领毛衣的衣领在 CNN 看来和口罩的颜色块非常相似------都是一个覆盖在下半张脸的深色区域。亮度增强让这种"视觉相似性"被放大了。
结论
对于口罩识别这个特定任务,水平镜像是最安全的增强方式------它只是把图片左右翻转,不改变任何视觉特征。戴口罩的脸翻转后还是戴口罩,不会引入新的"假特征"。
而噪点和亮度变化会改变图片的像素值分布,可能引入和口罩相似的干扰特征。CNN 是很"死心眼"的------你给它看什么,它就学什么。如果增强后的图片里有"看起来像口罩"的东西,它就会学错。
6.3 样本收集的教训------多样性比数量重要
这是今天最重要的经验。
翻车案例:证件照陷阱
一开始我们收集的样本大多是证件照风格------正面、光线均匀、表情标准。结果在实际测试时翻车连连:
- 侧头的人 被误认成"戴口罩"------因为侧脸的轮廓线在 CNN 看来和口罩边缘很像
- 戴眼镜的人 被误认------因为眼镜腿在 CNN 看来像口罩的带子
- 冬天高领羽绒服 被误认成"戴口罩"------因为高领遮住了下半张脸,和口罩的视觉效果一样
- 更离谱的是,人的后背、后脑勺被误认成了人脸------因为后脑勺的圆形轮廓加上头发的纹理,在某些角度下和正面人脸确实有点像
正确做法
我们重新调整了样本收集策略:
- 不再只收集证件照风格 ,而是收集大约 **80%**路上行人、路人的人脸
- 覆盖的场景包括:
- 不同肤色
- 背光(背景比脸亮)
- 照光(脸部迎着阳光)
- 后背、侧面
- 有阴影的场景
- 戴眼镜、戴帽子、围巾围脖
- 不同角度(不只是正脸)
核心原则
样本要反映真实世界的多样性,而不是只包含"标准"场景。
如果你的样本全是正脸、正常光线、标准表情,那模型在真实世界里一定会翻车。因为真实世界充满了侧脸、逆光、遮挡、特殊角度这些"不标准"的场景。
这和第 7 篇讲的"困难负样本挖掘"是一脉相承的------模型在哪些场景翻车,就针对性地补充哪些场景的样本。只不过这次的教训更深刻:不要等翻车了再补,一开始就要收集多样化的样本。
七、运行效果
7.1 启动程序
bash
cd sample/humanmaskdetect
python human_mask_sample.py
7.2 识别 15 人合影
准备一张含有 15 张人脸的合影(一排 5 个,共 3 排,混杂戴口罩和不戴口罩),点击"本地识别"按钮选择这张图片。
系统会:
- 先用 YOLOv8 检测出所有 15 张人脸的位置
- 逐张裁剪,送入口罩 CNN 分类
- 在图上绘制标注------戴口罩的绿框,没戴的不框
- 左上角显示黄色文字摘要:"X 人戴口罩 / Y 人没戴"
15 张人脸一下全部识别出来,哪些戴了口罩、哪些没戴,清清楚楚。
如下图:
八、总结
今天我们完成了一个重要的跨越------从"检测人脸在哪"到"判断每张脸有没有戴口罩"。回顾一下核心收获:
1. 两阶段 Pipeline 思想
先检测、再分类,是计算机视觉中最常用的架构模式。YOLOv8 负责"找到目标在哪",CNN 分类器负责"判断目标是什么"。这个模式不仅适用于口罩识别,还可以用于任何"先找后判"的场景------比如先找到商品、再判断是否合格;先找到车辆、再判断是否违章。
2. 样本多样性 > 网络深度
644 张多样化样本 + 简单 3 层 CNN,效果远好于 100 张单一风格样本 + 复杂网络。CNN 的能力上限取决于你给它看什么样的数据,而不是网络有多少层。
3. 数据增强不是越多越好
水平镜像是安全的,但噪点和亮度变化反而引入了干扰特征。增强方式的选择取决于具体任务------有些增强对某些任务是"帮忙",对另一些任务可能是"帮倒忙"。
4. 样本必须反映真实世界
如果你的训练样本全是"标准证件照",模型在真实场景中一定会翻车。80% 的路人样本比 100% 的证件照样本更有价值。
一定要自己动手。 把代码跑起来,收集自己的样本,训练自己的模型,观察翻车案例,分析原因,改进样本。只有亲手做过,这些知识才会真正变成你的能力。
你已经走到了这里,从 CNN 的基本概念一路走到了两阶段 Pipeline。这已经不再是"玩具级别"的项目了------"先检测再分类"的架构,和工业界做人脸识别、商品检测的思路是一模一样的。
继续加油,动手干吧!
附录:全代码
以下是本项目涉及的全部文件,请自行对照查看完整代码:
requirements.txt --- 项目依赖
bash
numpy>=1.24,<2.0
matplotlib>=3.7
torch>=2.0
torchvision>=0.15
mammoth>=1.6
markdownify>=0.13
pymupdf4llm>=0.1
opencv-python>=4.8
Pillow>=10.0
tqdm>=4.66
debugpy>=1.8
facenet-pytorch>=2.5
ultralytics>=8.0
insightface>=0.7
onnxruntime>=1.14
qdrant-client>=1.7
main.py --- 公共模块(配置、模型定义、数据增强、预处理)
python
"""
main.py - 人脸口罩识别公共模块
=================================
公共配置、设备检测、模型定义、图像预处理、数据增强。
train_mask.py 和 human_mask_identifier.py 都从这里导入共用逻辑。
"""

import os
import json
import numpy as np
from PIL import Image, ImageEnhance

import torch
import torch.nn as nn
import torchvision.transforms as transforms

# ============================================================
#  数据增强开关 ------ 改 True/False 即可控制是否启用
# ============================================================
AUGMENT_MIRROR = True       # 水平镜像
AUGMENT_NOISE = False        # 高斯噪点
AUGMENT_BRIGHTNESS = False   # 亮度变化

# ============================================================
#  路径配置(所有路径基于本文件所在目录)
# ============================================================
BASE_DIR = os.path.dirname(os.path.abspath(__file__))
POSITIVE_DIR = os.path.join(BASE_DIR, "samples", "positive")
NEGATIVE_DIR = os.path.join(BASE_DIR, "samples", "negative")
MODEL_DIR = os.path.join(BASE_DIR, "model")
MODEL_PATH = os.path.join(MODEL_DIR, "mask_cnn.pth")
CONFIG_PATH = os.path.join(MODEL_DIR, "config.json")
IDENTIFY_DIR = os.path.join(BASE_DIR, "identify")
OUTPUTS_DIR = os.path.join(BASE_DIR, "outputs")
LOGS_DIR = os.path.join(BASE_DIR, "logs")

# 图像预处理参数
IMG_SIZE = 128

# ============================================================
#  设备检测:CUDA → MPS → CPU 三级回退
# ============================================================
def get_device():
    """检测可用设备,CUDA → MPS → CPU 三级回退"""
    if torch.cuda.is_available():
        device = torch.device("cuda")
        print(f"[设备] 使用 CUDA GPU 加速: {torch.cuda.get_device_name(0)}")
    elif torch.backends.mps.is_available():
        device = torch.device("mps")
        print("[设备] 使用 MPS (Apple GPU) 加速")
    else:
        device = torch.device("cpu")
        print("[设备] 使用 CPU 训练")
    return device

# ============================================================
#  CNN 模型(3 层卷积 + 2 层全连接,轻量级二分类网络)
# ============================================================
class MaskCNN(nn.Module):
    """
    轻量级 CNN,适合 CPU 训练的二分类网络。

    结构:
        3层卷积 + 池化  →  提取空间特征
        2层全连接        →  分类决策
    """

    def __init__(self, num_classes=2):
        super().__init__()

        # 特征提取:3 组 卷积→BN→ReLU→池化
        self.features = nn.Sequential(
            # 第 1 组:3 → 16 通道,128 → 64
            nn.Conv2d(3, 16, kernel_size=3, padding=1),
            nn.BatchNorm2d(16),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(2),

            # 第 2 组:16 → 32 通道,64 → 32
            nn.Conv2d(16, 32, kernel_size=3, padding=1),
            nn.BatchNorm2d(32),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(2),

            # 第 3 组:32 → 64 通道,32 → 16
            nn.Conv2d(32, 64, kernel_size=3, padding=1),
            nn.BatchNorm2d(64),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(2),
        )

        # 分类头:64×16×16 → 128 → 2
        self.classifier = nn.Sequential(
            nn.Dropout(0.3),
            nn.Linear(64 * 16 * 16, 128),
            nn.ReLU(inplace=True),
            nn.Dropout(0.3),
            nn.Linear(128, num_classes),
        )

    def forward(self, x):
        x = self.features(x)
        x = x.view(x.size(0), -1)  # 展平
        x = self.classifier(x)
        return x

# ============================================================
#  数据增强函数(每个独立,互不耦合)
# ============================================================
def augment_mirror(img):
    """水平镜像翻转"""
    return img.transpose(Image.FLIP_LEFT_RIGHT)


def augment_noise(img, std=12):
    """添加低强度高斯噪点(模拟摄像头画质波动)"""
    arr = np.array(img).astype(np.float32)
    noise = np.random.normal(0, std, arr.shape)
    arr = np.clip(arr + noise, 0, 255).astype(np.uint8)
    return Image.fromarray(arr)


def augment_brightness(img, factor_range=(0.7, 1.3)):
    """随机亮度变化(模拟不同光照环境)"""
    factor = np.random.uniform(*factor_range)
    enhancer = ImageEnhance.Brightness(img)
    return enhancer.enhance(factor)


def apply_augmentations(img):
    """根据开关配置,对一张图片应用所有启用的增强,返回增强后的图片列表"""
    results = [img]  # 原始图始终保留

    if AUGMENT_MIRROR:
        results.append(augment_mirror(img))

    if AUGMENT_NOISE:
        results.append(augment_noise(img))

    if AUGMENT_BRIGHTNESS:
        results.append(augment_brightness(img))

    return results

# ============================================================
#  图像预处理 transform
# ============================================================
def get_train_transform():
    """训练时的预处理(含随机翻转,配合 apply_augmentations 使用)"""
    return transforms.Compose([
        transforms.Resize((IMG_SIZE, IMG_SIZE)),
        transforms.RandomHorizontalFlip(p=0.3),
        transforms.ToTensor(),
        transforms.Normalize(mean=[0.485, 0.456, 0.406],
                             std=[0.229, 0.224, 0.225]),
    ])


def get_eval_transform():
    """验证/识别时的预处理(不做数据增强)"""
    return transforms.Compose([
        transforms.Resize((IMG_SIZE, IMG_SIZE)),
        transforms.ToTensor(),
        transforms.Normalize(mean=[0.485, 0.456, 0.406],
                             std=[0.229, 0.224, 0.225]),
    ])

# ============================================================
#  工具函数
# ============================================================
def ensure_dirs():
    """确保输出目录存在"""
    for d in [MODEL_DIR, OUTPUTS_DIR, LOGS_DIR]:
        os.makedirs(d, exist_ok=True)


def save_config(**kwargs):
    """保存训练配置到 JSON"""
    config = {
        "input_size": IMG_SIZE,
        "classes": ["negative", "positive"],
        "class_labels": {0: "没戴口罩", 1: "戴口罩"},
        "augment": {
            "mirror": AUGMENT_MIRROR,
            "noise": AUGMENT_NOISE,
            "brightness": AUGMENT_BRIGHTNESS,
        },
    }
    config.update(kwargs)
    with open(CONFIG_PATH, "w", encoding="utf-8") as f:
        json.dump(config, f, ensure_ascii=False, indent=2)
    print(f"[配置] 已保存到 {CONFIG_PATH}")
train_mask.py --- 训练脚本
python
"""
口罩识别 CNN 训练脚本

用法:
    python train_mask.py

数据目录结构:
    samples/positive/   --- 戴口罩样本(标签 1)
    samples/negative/   --- 没戴口罩样本(标签 0)

输出:
    model/mask_cnn.pth      --- 训练好的模型
    model/config.json        --- 模型配置元信息
"""

import os
import sys
import shutil
import numpy as np
from PIL import Image

import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import Dataset, DataLoader
from tqdm import tqdm

# 导入公共模块(同目录下的 main.py)
from main import (
    POSITIVE_DIR, NEGATIVE_DIR, MODEL_DIR, MODEL_PATH,
    get_device, MaskCNN, apply_augmentations,
    get_train_transform, get_eval_transform,
    ensure_dirs, save_config,
    AUGMENT_MIRROR, AUGMENT_NOISE, AUGMENT_BRIGHTNESS,
)

# ================================================================
#  训练超参数
# ================================================================
EPOCHS = 50                 # 训练轮数
BATCH_SIZE = 10             # 批大小
LEARNING_RATE = 0.001       # 学习率
VAL_RATIO = 0.2             # 验证集比例
RANDOM_SEED = 42            # 随机种子(保证可复现)


# ----------------------------------------------------------------
#  数据集
# ----------------------------------------------------------------
class MaskDataset(Dataset):
    """
    从 positive / negative 两个目录加载图片。
    训练集的正样本会根据开关配置进行数据增强。
    """

    def __init__(self, samples, transform=None):
        """
        参数:
            samples: [(PIL.Image, label), ...] 列表
            transform: 图像预处理 transform
        """
        self.samples = samples
        self.transform = transform

    def __len__(self):
        return len(self.samples)

    def __getitem__(self, idx):
        img, label = self.samples[idx]
        if self.transform:
            img = self.transform(img)
        return img, label


# ----------------------------------------------------------------
#  训练主函数
# ----------------------------------------------------------------
def main():
    torch.manual_seed(RANDOM_SEED)
    np.random.seed(RANDOM_SEED)

    # ---- 清理并创建模型输出目录 ----
    if os.path.exists(MODEL_DIR):
        shutil.rmtree(MODEL_DIR)
        print(f"已清理旧模型目录: {MODEL_DIR}")
    os.makedirs(MODEL_DIR)
    print(f"模型输出目录: {MODEL_DIR}")

    # ---- 预处理 transform ----
    train_transform = get_train_transform()
    val_transform = get_eval_transform()

    # ---- 加载原始图片 ----
    def _load_original(dir_path, label):
        """从目录加载原始图片,返回 [(PIL.Image, label), ...]"""
        samples = []
        if os.path.isdir(dir_path):
            for fname in sorted(os.listdir(dir_path)):
                if fname.lower().endswith((".jpg", ".jpeg", ".png")):
                    img = Image.open(os.path.join(dir_path, fname)).convert("RGB")
                    samples.append((img, label))
        return samples

    pos_all = _load_original(POSITIVE_DIR, 1)
    neg_all = _load_original(NEGATIVE_DIR, 0)

    if len(pos_all) == 0:
        print(f"[错误] 正样本目录为空: {POSITIVE_DIR}")
        sys.exit(1)
    if len(neg_all) == 0:
        print(f"[错误] 负样本目录为空: {NEGATIVE_DIR}")
        sys.exit(1)

    # ---- 按类别分别拆分 train/val,保证验证集正负比例均衡 ----
    rng = np.random.RandomState(RANDOM_SEED)

    def _split(samples):
        indices = rng.permutation(len(samples)).tolist()
        n_val = max(1, int(len(samples) * VAL_RATIO))
        val_idx = set(indices[:n_val])
        train = [s for i, s in enumerate(samples) if i not in val_idx]
        val = [s for i, s in enumerate(samples) if i in val_idx]
        return train, val

    pos_train_raw, pos_val_raw = _split(pos_all)
    neg_train_raw, neg_val_raw = _split(neg_all)

    print(f"  原始图片: 正样本 {len(pos_all)} 张, 负样本 {len(neg_all)} 张")

    # ---- 训练集:原始图 + 数据增强(仅正样本增强) ----
    train_samples = []
    for img, lbl in pos_train_raw:
        for aug_img in apply_augmentations(img):
            train_samples.append((aug_img, lbl))
    train_samples.extend(neg_train_raw)  # 负样本不增强

    # ---- 验证集:只用原始图,不做增强 ----
    val_samples = pos_val_raw + neg_val_raw

    print(f"  训练集: {len(train_samples)} 张 "
          f"(正 {sum(1 for _, l in train_samples if l == 1)} / "
          f"负 {sum(1 for _, l in train_samples if l == 0)})")
    print(f"  验证集: {len(val_samples)} 张 "
          f"(正 {sum(1 for _, l in val_samples if l == 1)} / "
          f"负 {sum(1 for _, l in val_samples if l == 0)})")

    # ---- 构建 DataLoader ----
    train_dataset = MaskDataset(train_samples, train_transform)
    val_dataset = MaskDataset(val_samples, val_transform)

    train_loader = DataLoader(train_dataset, batch_size=BATCH_SIZE, shuffle=True)
    val_loader = DataLoader(val_dataset, batch_size=BATCH_SIZE, shuffle=False)

    # ---- 设备选择:CUDA → MPS → CPU 三级回退 ----
    device = get_device()
    model = MaskCNN(num_classes=2).to(device)
    criterion = nn.CrossEntropyLoss()
    optimizer = optim.Adam(model.parameters(), lr=LEARNING_RATE)

    total_params = sum(p.numel() for p in model.parameters())
    print(f"  模型参数量: {total_params:,}")
    print(f"  增强开关: 镜像={AUGMENT_MIRROR}, 噪点={AUGMENT_NOISE}, 亮度={AUGMENT_BRIGHTNESS}")
    print()

    # ---- 训练循环 ----
    best_val_acc = 0.0

    for epoch in range(1, EPOCHS + 1):
        # 训练阶段
        model.train()
        running_loss = 0.0
        correct = 0
        total = 0

        pbar = tqdm(train_loader, desc=f"Epoch {epoch}/{EPOCHS}", unit="batch")
        for images, labels in pbar:
            images, labels = images.to(device), labels.to(device)

            optimizer.zero_grad()
            outputs = model(images)
            loss = criterion(outputs, labels)
            loss.backward()
            optimizer.step()

            running_loss += loss.item() * images.size(0)
            _, predicted = outputs.max(1)
            total += labels.size(0)
            correct += predicted.eq(labels).sum().item()

            pbar.set_postfix(loss=f"{loss.item():.4f}")

        train_acc = correct / total

        # ---- 验证阶段 ----
        model.eval()
        val_correct = 0
        val_total = 0
        with torch.no_grad():
            for images, labels in val_loader:
                images, labels = images.to(device), labels.to(device)
                outputs = model(images)
                _, predicted = outputs.max(1)
                val_total += labels.size(0)
                val_correct += predicted.eq(labels).sum().item()

        val_acc = val_correct / val_total

        print(f"  Train Acc: {train_acc:.4f}  |  Val Acc: {val_acc:.4f}", end="")

        # 保存最佳模型
        if val_acc > best_val_acc:
            best_val_acc = val_acc
            torch.save(model, MODEL_PATH)
            print("  ★ 最佳模型已保存")
        else:
            print()

    # ---- 保存最终模型和配置 ----
    torch.save(model, MODEL_PATH)

    save_config(
        best_val_accuracy=round(best_val_acc, 4),
        epochs=EPOCHS,
        batch_size=BATCH_SIZE,
        learning_rate=LEARNING_RATE,
        total_params=total_params,
    )

    print()
    print("=" * 50)
    print(f"训练完成!")
    print(f"  最佳验证准确率: {best_val_acc:.4f}")
    print(f"  模型文件: {MODEL_PATH}")
    print(f"  配置文件: {os.path.join(MODEL_DIR, 'config.json')}")
    print("=" * 50)


if __name__ == "__main__":
    main()
human_mask_identifier.py --- 串联识别模块(检测 + 分类 + 标注)
python
"""
人脸口罩识别模块 - Station 4

核心流程:YOLOv8 检测人脸 → 裁剪每张人脸 → 送入口罩 CNN 分类 → 绘制结果

标注规则:
  - 无人脸         → 左上角红色"未检测到人脸"
  - 全部没戴口罩   → 左上角黄色"没有带口罩"
  - 部分戴口罩     → 只框戴口罩的人(绿色),没戴的不框
  - 全部戴口罩     → 全部绿色框出
"""

import os
import cv2
import numpy as np
import torch
from PIL import Image, ImageDraw, ImageFont
from torchvision import transforms
from datetime import datetime
from ultralytics import YOLO

from main import (
    MODEL_PATH, BASE_DIR, OUTPUTS_DIR, IMG_SIZE,
    MaskCNN, get_device,
)

# YOLOv8 人脸检测模型目录(与 model/ 并行,不被训练清空)
FACE_RECOG_MODEL_DIR = os.path.join(BASE_DIR, 'face_recog_model')
YOLO_FACE_MODEL = os.path.join(FACE_RECOG_MODEL_DIR, 'yolov8n-face.pt')

# 推理时的预处理流程(必须与训练时完全一致)
_infer_transform = transforms.Compose([
    transforms.Resize((IMG_SIZE, IMG_SIZE)),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406],
                         std=[0.229, 0.224, 0.225]),
])

# 颜色定义(RGB 格式,给 PIL 用)
COLOR_GREEN = (0, 200, 0)       # 戴口罩 - 绿色
COLOR_YELLOW = (220, 200, 0)    # 没戴口罩 - 黄色
COLOR_RED = (220, 50, 50)       # 未检测到人脸 - 红色

# ----------------------------------------------------------------
#  加载模型(全局只加载一次)
# ----------------------------------------------------------------
_model = None
_device = None
_yolo = None


def _get_model():
    """懒加载:第一次调用时载入模型,后续复用"""
    global _model, _device
    if _model is None:
        _device = get_device()

        # 全量模型保存时类引用记为 __main__.MaskCNN,
        # 加载前需将其注册到 __main__ 命名空间
        import sys as _sys
        _sys.modules['__main__'].MaskCNN = MaskCNN

        _model = torch.load(MODEL_PATH, map_location=_device, weights_only=False)
        _model.eval()
        print(f"[识别] 口罩模型已加载: {MODEL_PATH}")
    return _model


def _get_yolo():
    """懒加载 YOLOv8 人脸检测器(从本地 model/ 目录加载)"""
    global _yolo
    if _yolo is None:
        if not os.path.exists(YOLO_FACE_MODEL):
            raise FileNotFoundError(
                f"YOLOv8 人脸模型不存在: {YOLO_FACE_MODEL}\n"
                f"请从 HuggingFace 下载: https://huggingface.co/Bingsu/adetailer/resolve/main/face_yolov8n.pt"
            )
        _yolo = YOLO(YOLO_FACE_MODEL)
        print(f"[识别] YOLOv8 人脸检测器已加载: {YOLO_FACE_MODEL}")
    return _yolo


def _load_chinese_font(size=24):
    """加载中文字体,按优先级尝试多个系统字体(Win10 + macOS)"""
    for font_path in [
        # ---- Windows 10/11 ----
        "C:/Windows/Fonts/msyh.ttc",      # 微软雅黑
        "C:/Windows/Fonts/msyhbd.ttc",     # 微软雅黑 Bold
        "C:/Windows/Fonts/simhei.ttf",     # 黑体
        "C:/Windows/Fonts/simsun.ttc",     # 宋体
        # ---- macOS ----
        "/System/Library/Fonts/STHeiti Medium.ttc",
        "/System/Library/Fonts/STHeiti Light.ttc",
        "/System/Library/Fonts/Hiragino Sans GB.ttc",
    ]:
        if os.path.exists(font_path):
            try:
                return ImageFont.truetype(font_path, size)
            except Exception:
                continue
    return ImageFont.load_default()


def _classify_face(face_pil):
    """
    对一张裁剪好的人脸图片进行口罩分类

    参数:
        face_pil: PIL RGB 格式的人脸图片

    返回:
        (label, confidence): label=1 戴口罩, label=0 没戴口罩
    """
    model = _get_model()
    tensor = _infer_transform(face_pil).unsqueeze(0).to(_device)

    with torch.no_grad():
        outputs = model(tensor)
        probs = torch.nn.functional.softmax(outputs, dim=1)
        confidence, predicted = probs.max(1)

    return predicted.item(), confidence.item()


# ----------------------------------------------------------------
#  核心识别函数
# ----------------------------------------------------------------
def identify(frame_bgr):
    """
    对一帧 BGR 图片进行人脸检测 + 口罩识别。

    参数:
        frame_bgr: OpenCV BGR 格式的 numpy 数组

    返回:
        dict:
            - saved_path: 标注后的图片保存路径
            - summary: 结果摘要文字
    """
    yolo = _get_yolo()

    # ---- 检测人脸(YOLOv8 直接接受 numpy 数组)----
    results = yolo.predict(source=frame_bgr, conf=0.25, verbose=False)

    # ---- 提取边界框 ----
    boxes = []
    if results[0].boxes is not None and len(results[0].boxes) > 0:
        for box in results[0].boxes:
            x1, y1, x2, y2 = box.xyxy[0].cpu().numpy()
            boxes.append([x1, y1, x2, y2])

    # ---- 转 PIL 供绘制使用 ----
    rgb = cv2.cvtColor(frame_bgr, cv2.COLOR_BGR2RGB)
    pil_img = Image.fromarray(rgb)

    # ---- 在原图上准备绘制 ----
    annotated_rgb = pil_img.copy()
    draw = ImageDraw.Draw(annotated_rgb)
    font = _load_chinese_font(24)
    small_font = _load_chinese_font(14)   # 小字体,用于显示置信度

    # ---- 情况 1:未检测到人脸 ----
    if boxes is None or len(boxes) == 0:
        draw.text((10, 10), "未检测到人脸", fill=COLOR_RED, font=font)
        annotated_bgr = cv2.cvtColor(np.array(annotated_rgb), cv2.COLOR_RGB2BGR)
        save_path = _save_result(annotated_bgr)
        print(f"[识别] 未检测到人脸 → {save_path}")
        return {"saved_path": save_path, "summary": "未检测到人脸"}

    # ---- 逐张人脸裁剪 + 分类 ----
    face_results = []  # [(x1, y1, x2, y2, label, confidence), ...]
    for box in boxes:
        x1, y1, x2, y2 = [int(v) for v in box]
        # 裁剪人脸(加一点边距)
        margin = 5
        x1c = max(0, x1 - margin)
        y1c = max(0, y1 - margin)
        x2c = min(pil_img.width, x2 + margin)
        y2c = min(pil_img.height, y2 + margin)
        face_crop = pil_img.crop((x1c, y1c, x2c, y2c))

        label, conf = _classify_face(face_crop)
        face_results.append((x1, y1, x2, y2, label, conf))

    # ---- 统计 ----
    mask_count = sum(1 for r in face_results if r[4] == 1)
    no_mask_count = len(face_results) - mask_count
    total = len(face_results)

    # ---- 绘制标注 ----
    if mask_count == 0:
        # 情况 2:全部没戴口罩 → 左上角黄色文字
        draw.text((10, 10), "没有带口罩", fill=COLOR_YELLOW, font=font)
        summary = f"没有带口罩 ({total} 人)"
    elif mask_count == total:
        # 情况 3:全部戴口罩 → 全部绿色框出 + 置信度
        for x1, y1, x2, y2, label, conf in face_results:
            draw.rectangle([x1, y1, x2, y2], outline=COLOR_GREEN, width=3)
            draw.text((x1 + 2, y1 + 2), f"{conf:.0%}",
                      fill=COLOR_GREEN, font=small_font)
        summary = f"全部戴口罩 ({total} 人)"
    else:
        # 情况 4:部分戴口罩 → 只框戴口罩的人(绿色)+ 置信度,没戴的不框
        for x1, y1, x2, y2, label, conf in face_results:
            if label == 1:
                draw.rectangle([x1, y1, x2, y2], outline=COLOR_GREEN, width=3)
                draw.text((x1 + 2, y1 + 2), f"{conf:.0%}",
                          fill=COLOR_GREEN, font=small_font)
        summary = f"{mask_count} 人戴口罩 / {no_mask_count} 人没戴"

    # ---- 保存结果 ----
    annotated_bgr = cv2.cvtColor(np.array(annotated_rgb), cv2.COLOR_RGB2BGR)
    save_path = _save_result(annotated_bgr)
    print(f"[识别] {summary} → {save_path}")

    return {"saved_path": save_path, "summary": summary}


def _save_result(frame_bgr):
    """保存标注后的图片到 outputs 目录"""
    os.makedirs(OUTPUTS_DIR, exist_ok=True)
    timestamp = datetime.now().strftime("%Y%m%d_%H%M%S_%f")[:-3]
    save_path = os.path.join(OUTPUTS_DIR, f"identify_{timestamp}.png")
    cv2.imwrite(save_path, frame_bgr)
    return save_path
human_mask_sample.py --- GUI 界面
python
"""
人脸口罩识别 - GUI 界面

窗口布局:
  左侧 70% --- 摄像头预览区域
  右侧 30% --- 顶部 5 个按钮横向排列
              中间状态标签
              下方大尺寸识别预览区(暗色背景 + 扫描线动画)

按钮:
  1. 打开摄像头   2. 拍摄   3. 训练   4. 识别   5. 本地识别

与 maskdetect GUI 的区别:
  识别模块使用 MTCNN + 口罩 CNN 串联,支持多人脸检测与差异化标注。
"""

import tkinter as tk
from tkinter import filedialog, messagebox
import cv2
from PIL import Image, ImageTk
import threading
import subprocess
import sys
import os
from datetime import datetime

from main import POSITIVE_DIR, IDENTIFY_DIR

# 训练脚本路径(与本文件同目录)
TRAIN_SCRIPT = os.path.join(os.path.dirname(os.path.abspath(__file__)),
                            "train_mask.py")


class HumanMaskSampleApp:
    def __init__(self, root):
        self.root = root
        self.root.title("人脸口罩识别")
        self.root.geometry("1200x800")
        self.root.minsize(1000, 700)

        # ---- 摄像头状态 ----
        self.cap = None
        self.running = False
        self.latest_frame = None
        self.frame_lock = threading.Lock()
        self.after_id = None
        self._photo = None
        self._train_running = False

        # ---- 拍摄抽帧状态 ----
        self._capturing = False
        self._capture_count = 0
        self._capture_saved = 0

        # ---- 扫描动画状态 ----
        self._scanning = False
        self._scan_y = 0
        self._scan_after_id = None
        self._scan_photo = None

        # ---- 批量识别状态 ----
        self._identifying = False

        self._build_ui()
        self.root.protocol("WM_DELETE_WINDOW", self._on_close)

    # ==================================================================
    #  UI 构建
    # ==================================================================
    def _build_ui(self):
        # ---- 左侧:摄像头预览面板(占 70% 宽度)----
        self.left_frame = tk.Frame(self.root, bg="#222")
        self.left_frame.pack(side=tk.LEFT, fill=tk.BOTH, expand=True,
                             padx=(20, 5), pady=20)

        self.preview = tk.Canvas(self.left_frame, bg="black",
                                 highlightthickness=0)
        self.preview.pack(fill=tk.BOTH, expand=True)

        # ---- 右侧:控制面板(占 30% 宽度)----
        right = tk.Frame(self.root, width=400, bg="#2b2b2b")
        right.pack(side=tk.RIGHT, fill=tk.BOTH, padx=(5, 20), pady=20)
        right.pack_propagate(False)

        # ---- 5 个按钮横向排列 ----
        btn_frame = tk.Frame(right, bg="#2b2b2b")
        btn_frame.pack(fill=tk.X, padx=10, pady=(15, 5))

        btn_cfg = dict(width=7, height=2, font=("PingFang SC", 9))

        self.btn_start = tk.Button(
            btn_frame, text="打开摄像头",
            command=self._on_start_camera, **btn_cfg)
        self.btn_start.grid(row=0, column=0, padx=4)

        self.btn_capture = tk.Button(
            btn_frame, text="拍摄",
            command=self._on_capture, **btn_cfg)
        self.btn_capture.grid(row=0, column=1, padx=4)
        self.btn_capture.config(state=tk.DISABLED)

        self.btn_train = tk.Button(
            btn_frame, text="训练",
            command=self._on_train, **btn_cfg)
        self.btn_train.grid(row=0, column=2, padx=4)

        self.btn_identify = tk.Button(
            btn_frame, text="识别",
            command=self._on_identify, **btn_cfg)
        self.btn_identify.grid(row=0, column=3, padx=4)

        self.btn_identify_local = tk.Button(
            btn_frame, text="本地识别",
            command=self._on_identify_local, **btn_cfg)
        self.btn_identify_local.grid(row=0, column=4, padx=4)

        for i in range(5):
            btn_frame.columnconfigure(i, weight=1)

        # ---- 状态标签 ----
        self.status_label = tk.Label(
            right, text="就绪", font=("PingFang SC", 11),
            bg="#2b2b2b", fg="#888", anchor="w")
        self.status_label.pack(fill=tk.X, padx=15, pady=(10, 0))

        # ---- 识别预览区 ----
        scan_frame = tk.Frame(right, bg="#1a1a1a",
                              highlightbackground="#444",
                              highlightthickness=1)
        scan_frame.pack(fill=tk.BOTH, expand=True, padx=10, pady=10)

        self.scan_canvas = tk.Canvas(scan_frame, bg="#111",
                                     highlightthickness=0)
        self.scan_canvas.pack(fill=tk.BOTH, expand=True)

        self.scan_canvas.create_text(
            180, 140, text="识别预览区",
            fill="#444", font=("PingFang SC", 16),
            tags="placeholder")

    # ==================================================================
    #  扫描线动画
    # ==================================================================
    def _start_scan_animation(self):
        self._scanning = True
        self._scan_y = 0
        self._animate_scan()

    def _stop_scan_animation(self):
        self._scanning = False
        if self._scan_after_id is not None:
            self.root.after_cancel(self._scan_after_id)
            self._scan_after_id = None
        self.scan_canvas.delete("scanline")

    def _animate_scan(self):
        if not self._scanning:
            return

        self.scan_canvas.update_idletasks()
        cw = max(self.scan_canvas.winfo_width(), 1)
        ch = max(self.scan_canvas.winfo_height(), 1)

        self.scan_canvas.delete("scanline")

        self.scan_canvas.create_line(
            0, self._scan_y, cw, self._scan_y,
            fill="#00FFFF", width=2, tags="scanline")

        for offset, color in [(4, "#00AAAA"), (8, "#007777"),
                              (12, "#004444")]:
            y = self._scan_y - offset
            if y >= 0:
                self.scan_canvas.create_line(
                    0, y, cw, y,
                    fill=color, width=1, tags="scanline")

        self._scan_y += 3
        if self._scan_y > ch:
            self._scan_y = 0

        self._scan_after_id = self.root.after(33, self._animate_scan)

    # ==================================================================
    #  在扫描预览区显示图片
    # ==================================================================
    def _show_on_scan_canvas(self, frame_bgr):
        self.scan_canvas.update_idletasks()
        cw = max(self.scan_canvas.winfo_width(), 1)
        ch = max(self.scan_canvas.winfo_height(), 1)

        rgb = cv2.cvtColor(frame_bgr, cv2.COLOR_BGR2RGB)
        img = Image.fromarray(rgb)

        scale = max(cw / img.width, ch / img.height)
        new_w = int(img.width * scale)
        new_h = int(img.height * scale)
        img = img.resize((new_w, new_h), Image.LANCZOS)
        left = (new_w - cw) // 2
        top = (new_h - ch) // 2
        img = img.crop((left, top, left + cw, top + ch))

        self._scan_photo = ImageTk.PhotoImage(img)
        self.scan_canvas.delete("all")
        self.scan_canvas.create_image(cw // 2, ch // 2, image=self._scan_photo)

    # ==================================================================
    #  按钮回调
    # ==================================================================
    def _on_start_camera(self):
        if self.running:
            return

        self.cap = cv2.VideoCapture(0)
        if not self.cap.isOpened():
            messagebox.showerror("错误", "无法打开摄像头(index 0)")
            return

        self.running = True
        self.capture_thread = threading.Thread(
            target=self._read_frames, daemon=True)
        self.capture_thread.start()

        self.btn_start.config(state=tk.DISABLED)
        self.btn_capture.config(state=tk.NORMAL)
        self.status_label.config(text="摄像头已开启", fg="#4CAF50")

        self._update_preview()

    def _on_stop_camera(self):
        if not self.running:
            return

        if self._capturing:
            self._stop_capture()

        self.running = False
        self.capture_thread.join(timeout=2)

        if self.cap is not None:
            self.cap.release()
            self.cap = None

        with self.frame_lock:
            self.latest_frame = None

        if self.after_id is not None:
            self.root.after_cancel(self.after_id)
            self.after_id = None

        self.preview.delete("all")
        self._photo = None

        self.btn_start.config(state=tk.NORMAL)
        self.btn_capture.config(state=tk.DISABLED)
        self.status_label.config(text="摄像头已关闭", fg="#888")

    def _on_capture(self):
        if not self._capturing:
            self._capturing = True
            self._capture_count = 0
            self._capture_saved = 0
            os.makedirs(POSITIVE_DIR, exist_ok=True)
            self.btn_capture.config(text="停止拍摄")
            self.status_label.config(text="拍摄中... 请自然转动头部", fg="#FF9800")
            threading.Thread(target=self._capture_loop, daemon=True).start()
        else:
            self._stop_capture()

    def _stop_capture(self):
        self._capturing = False
        self.btn_capture.config(text="拍摄")
        self.status_label.config(
            text=f"拍摄完成,已保存 {self._capture_saved} 张正样本到 positive/",
            fg="#4CAF50")

    def _capture_loop(self):
        while self._capturing and self.running:
            with self.frame_lock:
                frame = (self.latest_frame.copy()
                         if self.latest_frame is not None else None)

            if frame is not None:
                self._capture_count += 1
                if self._capture_count % 5 == 0:
                    timestamp = datetime.now().strftime("%Y%m%d_%H%M%S_%f")[:-3]
                    save_path = os.path.join(POSITIVE_DIR, f"cap_{timestamp}.png")
                    cv2.imwrite(save_path, frame)
                    self._capture_saved += 1

            threading.Event().wait(0.033)

    def _on_train(self):
        if self._train_running:
            messagebox.showinfo("提示", "训练正在进行中,请勿重复点击")
            return

        self._train_running = True
        self.btn_train.config(state=tk.DISABLED, text="训练中...")
        self.status_label.config(text="训练进行中,请查看终端...", fg="#FF9800")

        def _run_training():
            try:
                subprocess.run(
                    [sys.executable, TRAIN_SCRIPT],
                    cwd=os.path.dirname(os.path.abspath(__file__)),
                )
                self.root.after(0, lambda: self.status_label.config(
                    text="训练完成!", fg="#4CAF50"))
            except Exception as e:
                print(f"训练异常: {e}")
                self.root.after(0, lambda: self.status_label.config(
                    text=f"训练异常: {e}", fg="#F44336"))
            finally:
                self._train_running = False
                self.root.after(0, lambda: self.btn_train.config(
                    state=tk.NORMAL, text="训练"))

        threading.Thread(target=_run_training, daemon=True).start()

    def _on_identify(self):
        """批量识别 identify/ 目录下所有图片"""
        if self._identifying:
            messagebox.showinfo("提示", "识别正在进行中,请勿重复点击")
            return

        # 如果摄像头正在运行,先抓取当前帧
        if self.running:
            with self.frame_lock:
                frame = (self.latest_frame.copy()
                         if self.latest_frame is not None else None)
            if frame is not None:
                os.makedirs(IDENTIFY_DIR, exist_ok=True)
                timestamp = datetime.now().strftime("%Y%m%d_%H%M%S_%f")[:-3]
                save_path = os.path.join(IDENTIFY_DIR, f"cam_{timestamp}.png")
                cv2.imwrite(save_path, frame)

        threading.Thread(target=self._batch_identify, daemon=True).start()

    def _on_identify_local(self):
        """本地图片识别:选择一张图片进行识别"""
        if self._identifying:
            messagebox.showinfo("提示", "识别正在进行中,请勿重复点击")
            return

        path = filedialog.askopenfilename(
            title="选择图片进行识别",
            filetypes=[("图片文件", "*.jpg *.jpeg *.png *.bmp")]
        )
        if not path:
            return

        frame = cv2.imread(path)
        if frame is None:
            messagebox.showerror("错误", f"无法读取图片: {path}")
            return

        def _run():
            self._identifying = True
            self.root.after(0, lambda: self.status_label.config(
                text="正在识别...", fg="#00BFFF"))
            self.root.after(0, lambda: self._show_on_scan_canvas(frame))
            self.root.after(0, self._start_scan_animation)

            try:
                from human_mask_identifier import identify
                result = identify(frame)
                self.root.after(0, self._stop_scan_animation)
                self.root.after(0, lambda: self.status_label.config(
                    text=result['summary'], fg="#4CAF50"))

                # 显示标注后的结果图
                annotated = cv2.imread(result["saved_path"])
                if annotated is not None:
                    self.root.after(0, lambda a=annotated: self._show_on_scan_canvas(a))
            except FileNotFoundError:
                self.root.after(0, self._stop_scan_animation)
                self.root.after(0, lambda: messagebox.showerror(
                    "错误", "模型文件不存在,请先训练模型"))
                self.root.after(0, lambda: self.status_label.config(
                    text="模型不存在", fg="#F44336"))
            except Exception as err:
                self.root.after(0, self._stop_scan_animation)
                self.root.after(0, lambda: messagebox.showerror(
                    "识别异常", str(err)))
                self.root.after(0, lambda: self.status_label.config(
                    text="识别异常", fg="#F44336"))
            finally:
                self._identifying = False

        threading.Thread(target=_run, daemon=True).start()

    # ==================================================================
    #  批量识别
    # ==================================================================
    def _batch_identify(self):
        self._identifying = True

        image_files = []
        for fname in sorted(os.listdir(IDENTIFY_DIR)):
            if fname.lower().endswith((".jpg", ".jpeg", ".png")):
                image_files.append(os.path.join(IDENTIFY_DIR, fname))

        if not image_files:
            self.root.after(0, lambda: messagebox.showinfo(
                "提示", "identify/ 目录下没有图片"))
            self._identifying = False
            return

        total = len(image_files)
        self.root.after(0, lambda: self.status_label.config(
            text=f"批量识别中 (0/{total})", fg="#00BFFF"))

        try:
            from human_mask_identifier import identify

            for idx, img_path in enumerate(image_files):
                frame = cv2.imread(img_path)
                if frame is None:
                    continue

                self.root.after(0, lambda f=frame: self._show_on_scan_canvas(f))
                self.root.after(0, lambda i=idx, t=total: self.status_label.config(
                    text=f"批量识别中 ({i + 1}/{t})...", fg="#00BFFF"))
                self.root.after(0, self._start_scan_animation)

                result_holder = [None]
                error_holder = [None]
                done_event = threading.Event()

                def _do_infer():
                    try:
                        result_holder[0] = identify(frame)
                    except Exception as e:
                        error_holder[0] = e
                    finally:
                        done_event.set()

                threading.Thread(target=_do_infer, daemon=True).start()

                done_event.wait(timeout=10)
                threading.Event().wait(1.5)

                self.root.after(0, self._stop_scan_animation)

                if error_holder[0]:
                    print(f"[批量识别] {img_path} 识别失败: {error_holder[0]}")
                    continue

                result = result_holder[0]
                annotated = cv2.imread(result["saved_path"])
                if annotated is not None:
                    self.root.after(0, lambda a=annotated: self._show_on_scan_canvas(a))

                threading.Event().wait(1.0)

            self.root.after(0, lambda: self.status_label.config(
                text=f"批量识别完成,共 {total} 张", fg="#4CAF50"))

        except FileNotFoundError:
            self.root.after(0, self._stop_scan_animation)
            self.root.after(0, lambda: messagebox.showerror(
                "错误", "模型文件不存在,请先训练模型"))
            self.root.after(0, lambda: self.status_label.config(
                text="模型不存在", fg="#F44336"))
        except Exception as e:
            print(f"[批量识别] 异常: {e}")
            self.root.after(0, self._stop_scan_animation)
            self.root.after(0, lambda: self.status_label.config(
                text=f"识别异常: {e}", fg="#F44336"))
        finally:
            self._identifying = False

    # ==================================================================
    #  摄像头采集与预览刷新
    # ==================================================================
    def _read_frames(self):
        while self.running:
            ret, frame = self.cap.read()
            if not ret:
                break
            with self.frame_lock:
                self.latest_frame = frame

    def _update_preview(self):
        if not self.running:
            return

        with self.frame_lock:
            frame = (self.latest_frame.copy()
                     if self.latest_frame is not None else None)

        if frame is not None:
            self._show_frame(frame)

        self.after_id = self.root.after(33, self._update_preview)

    def _show_frame(self, frame):
        self.preview.update_idletasks()
        cw = max(self.preview.winfo_width(), 1)
        ch = max(self.preview.winfo_height(), 1)

        rgb = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)
        img = Image.fromarray(rgb)

        scale = max(cw / img.width, ch / img.height)
        new_w = int(img.width * scale)
        new_h = int(img.height * scale)
        img = img.resize((new_w, new_h), Image.LANCZOS)
        left = (new_w - cw) // 2
        top = (new_h - ch) // 2
        img = img.crop((left, top, left + cw, top + ch))

        self._photo = ImageTk.PhotoImage(img)

        self.preview.delete("all")
        self.preview.create_image(cw // 2, ch // 2, image=self._photo)

    # ==================================================================
    #  退出
    # ==================================================================
    def _on_close(self):
        self._stop_scan_animation()
        if self._capturing:
            self._stop_capture()
        if self.running:
            self._on_stop_camera()
        self.root.destroy()


if __name__ == "__main__":
    root = tk.Tk()
    app = HumanMaskSampleApp(root)
    root.mainloop()