文章目录
- 一、中间件概述
- 二、常用内置中间件的使用
-
- SummarizationMiddleware中间件
- HumanInTheLoopMiddleware中间件
-
- 参数说明
-
- [参数1:interrupt_on ---工具名和中断策略的映射](#参数1:interrupt_on —工具名和中断策略的映射)
- [参数2:description_prefix ---自定义中断描述](#参数2:description_prefix —自定义中断描述)
- 举例过程1:调用前中断
- 举例过程2:指明工具调用请求决策
- PIIMiddleware中间件
-
- 参数说明
-
- [参数1:pii_type ---检测的PII数据类型](#参数1:pii_type —检测的PII数据类型)
- [参数2:strategy ---处理PII信息的策略](#参数2:strategy —处理PII信息的策略)
- [参数3:detector ---自定义 PII检测函数 或者 正则表达式](#参数3:detector —自定义 PII检测函数 或者 正则表达式)
- [参数4:apply_to_input ---是否在调用模型前检测](#参数4:apply_to_input —是否在调用模型前检测)
- [参数5:apply_to_output ---是否在模型调用后检测](#参数5:apply_to_output —是否在模型调用后检测)
- [参数6:apply_to_tool_results ---是否在工具调用后检测其输出](#参数6:apply_to_tool_results —是否在工具调用后检测其输出)
- 举例1:使用内置检测器
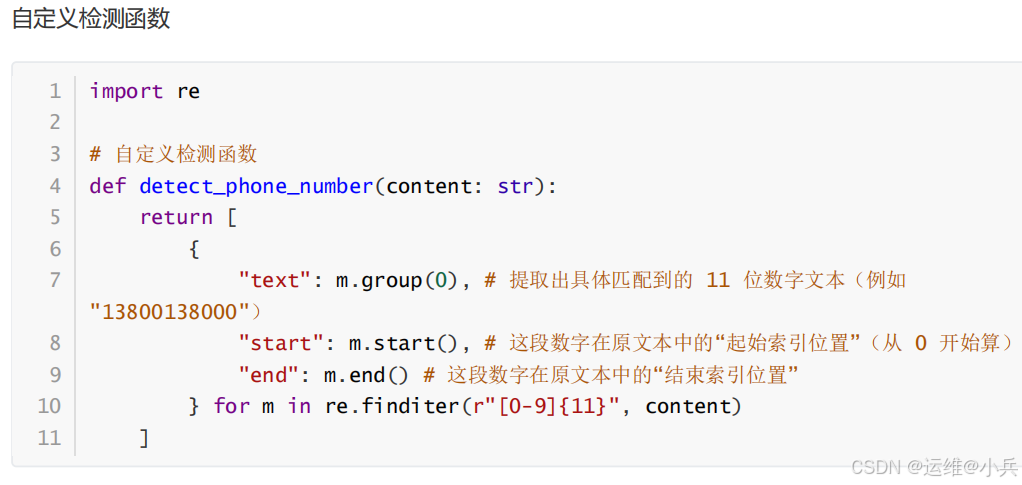
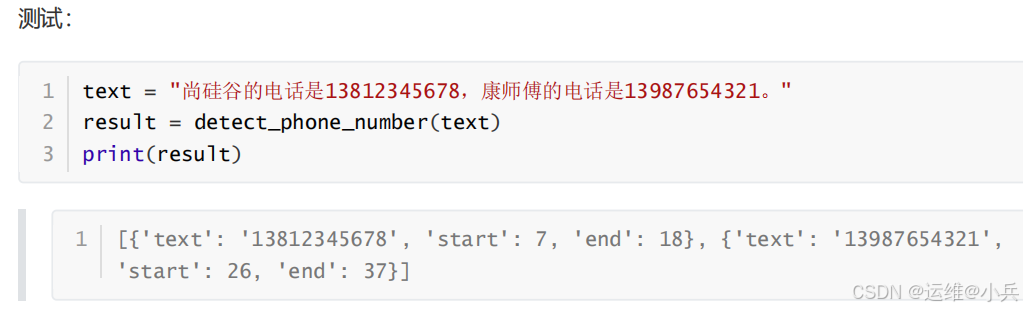
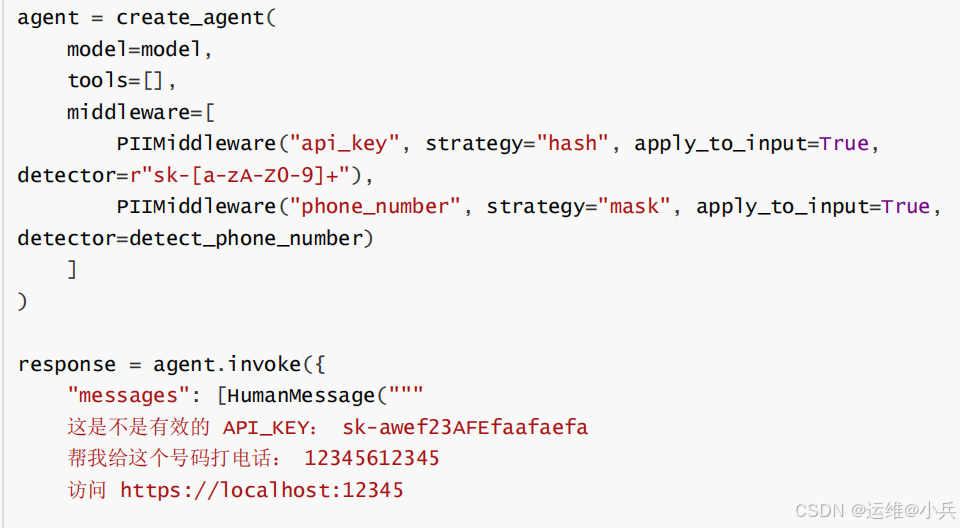
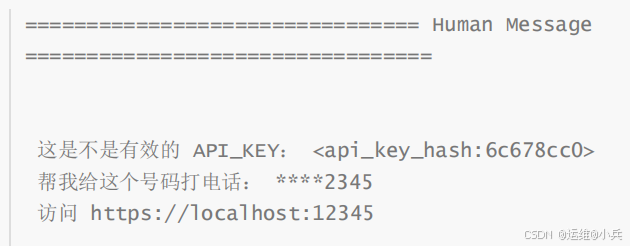
- 举例2:自定义检测器/函数
- TodoListMiddleware中间件
- 三、其它内置中间件
- 四、多个中间件组合及执行顺序
- 五、自定义中间件
-
- 什么是hook函数(钩子函数)
- LangChain的hook函数分类
-
- [类型1:Node-style hooks(节点风格钩子)](#类型1:Node-style hooks(节点风格钩子))
- [类型2:Wrap-style hooks(包装风格钩子)](#类型2:Wrap-style hooks(包装风格钩子))
- [Node-style hooks函数用法](#Node-style hooks函数用法)
- [Wrap-style hooks函数用法](#Wrap-style hooks函数用法)
- 装饰器和类的选择
- hook函数执行顺序(重要)
- 参考视频
一、中间件概述
在 create_agent() 的底层运行机制中,有几个重要的组件,分别是:
- 模型(Model) :Agent 的"大脑",负责理解任务与决策推理。
- 工具(Tools) :Agent 的"手脚",执行模型自己做不到的外部操作。
- 系统提示词(System Prompt) :Agent的"角色",告诉模型该怎么想、参考什么上下文。
- 中间件(Middleware) :Agent的"中枢",在执行流程的关键节点进行拦截、控制和增强。
什么是中间件
Middleware(中间件),简单说就是Agent 执行过程中的钩子函数,是 LangChain 1.x 的"王牌"工程化能力。
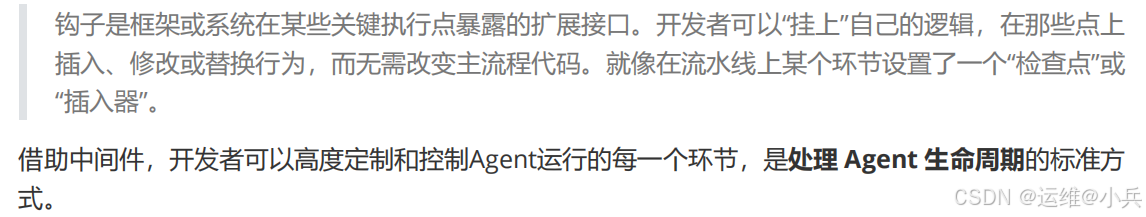
添加中间件之后的Agent架构:
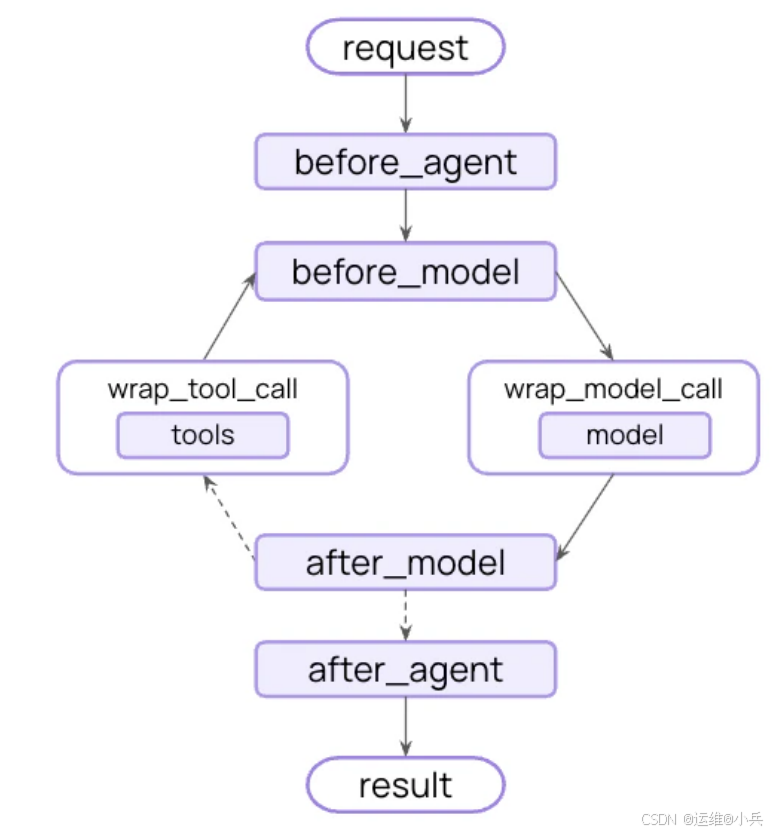
为什么需要中间件
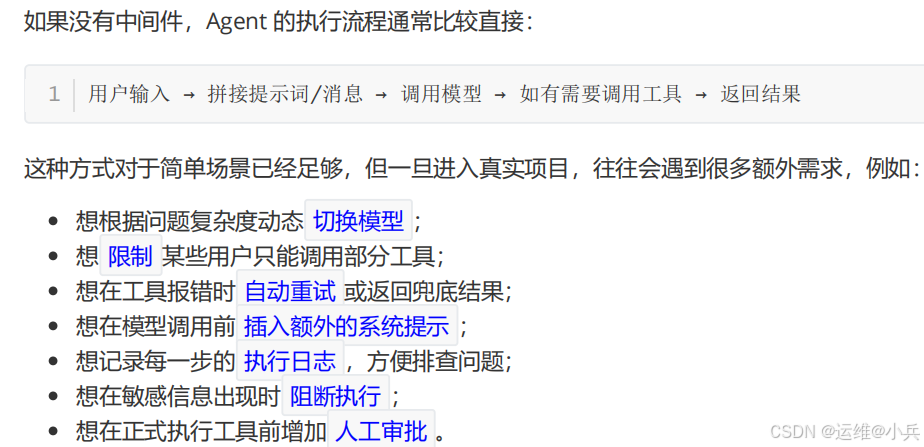
总结:
中间件的分类
链接:https://docs.langchain.com/oss/python/langchain/middleware/overview
和模型供应商无关的内置中间件分类
LangChain提供的和模型供应商无关的内置中间件分为六个类别
类型1:成本与资源控制类
核心目标:控成本、控配额、避免无限调用
这类中间件主要解决" Agent太贵、太能跑、停不下来 "的问题。
包含:
- Model call limit:限制模型调用次数,防止一次任务反复请求 LLM,导致费用失控
- Tool call limit:限制工具调用次数,避免 Agent 无限试错、死循环调工具
- Summarization:在上下文快满时自动总结历史,减少 token 消耗
- Context editing:裁剪上下文、清理工具调用痕迹,本质上也是为了节省上下文成本
业务场景理解:
适合生产环境的成本治理、配额治理、长会话优化、SaaS 产品控费。
类型2:稳定性与容错保障类
核心目标:保证服务不中断、失败后尽量自动恢复
这类中间件主要解决" 调用失败怎么办、模型挂了怎么办、工具超时怎么办 "。
包含:
- Model fallback:主模型失败时切换备用模型
- Model retry:模型调用失败后自动重试
- Tool retry:工具调用失败后自动重试
业务场景理解:
适合线上生产系统,尤其是多模型、多工具依赖的 Agent。
本质上是在做 高可用、容灾、鲁棒性建设。
类型3:安全与合规风控类
核心目标:让 Agent 可控、可审、合规
这类中间件主要解决" Agent乱执行、泄露敏感信息、做危险操作 "的问题。
包含:
- Human-in-the-loop:在关键工具调用前暂停,等人工审批
- PII detection:检测和处理个人敏感信息
- Model call limit / Tool call limit:某种意义上也可归到风控,因为它能防止异常滥用
业务场景理解:
适合企业内部系统、客服系统、审批流、数据查询类 Agent。
尤其是涉及:发邮件、调数据库、调财务/人事系统、导出敏感信息、执行外部动作等
类型4:决策增强与智能编排类
核心目标:提升 Agent 的决策质量和任务拆解能力
这类中间件主要解决" Agent不够聪明、不会规划、不会先筛工具 "的问题。
包含:
- To-do list:给 Agent 增加任务规划、分步骤执行和状态跟踪能力
- LLM tool selector:当工具太多时,用子模型筛选最相关的几个工具交给主模型
- Subagent:允许生成子Agent,把复杂任务拆给不同角色处理
业务场景理解:
适合复杂任务流,比如:研究型 Agent、多步骤分析、报告生成、多角色协作、长链路任务编排等。
这类本质上是在增强 Agent的"脑子"与"组织能力"。
类型5:执行能力扩展类
核心目标:给 Agent 更多"手脚"
这类中间件主要解决" Agent只能聊天,不能真正操作环境 "的问题。
包含:
- Shell tool:给 Agent 持久 shell,会执行命令
- File search:给 Agent 文件搜索能力,能做 Glob/Grep
- Filesystem:给 Agent 文件系统读写与长期存储能力
业务场景理解:
适合工程 Agent、代码 Agent、本地自动化 Agent、运维 Agent。
本质上是把 Agent 从"纯推理"扩展成"能操作环境的执行体"。
类型6:开发调试与测试辅助类
核心目标:方便开发、测试、验证 Agent 行为
这类中间件主要不是直接服务业务,而是服务于 研发和调试阶段 。
包含:
- LLM tool emulator:用 LLM 模拟工具执行,便于测试(最典型)
- Summarization:有时也可辅助调试长会话表现
- Context editing:可用于测试上下文裁剪效果
- Human-in-the-loop:也常用于调试高风险步骤
业务场景理解:
适合开发阶段快速验证流程、做 mock、减少真实工具依赖。
二、常用内置中间件的使用
LangChain 1.0 提供了 16 个预置中间件,开箱即用。
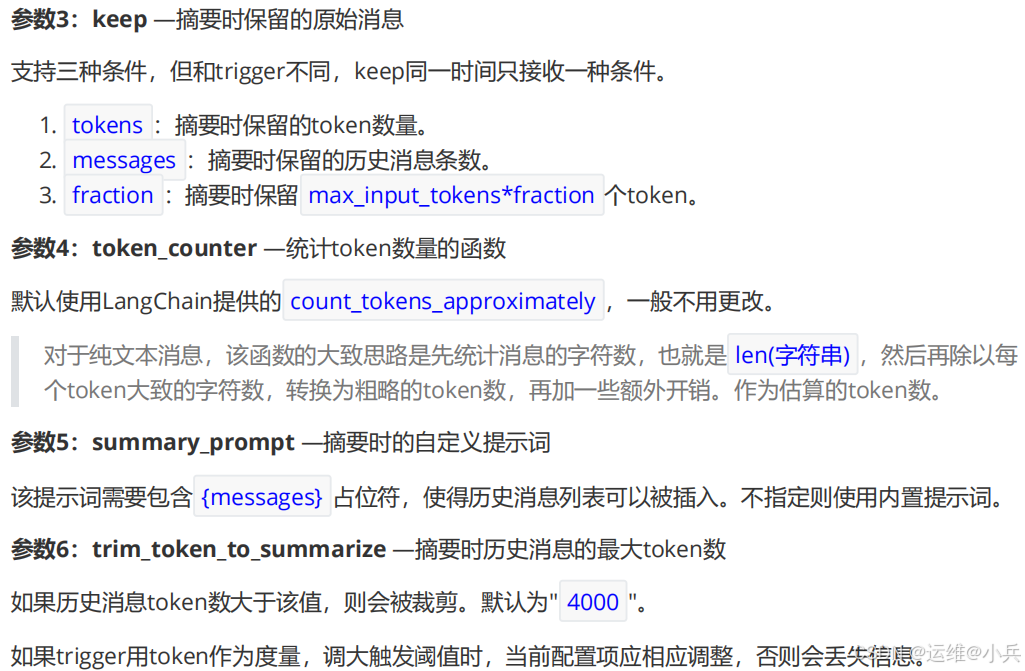
SummarizationMiddleware中间件
参数说明
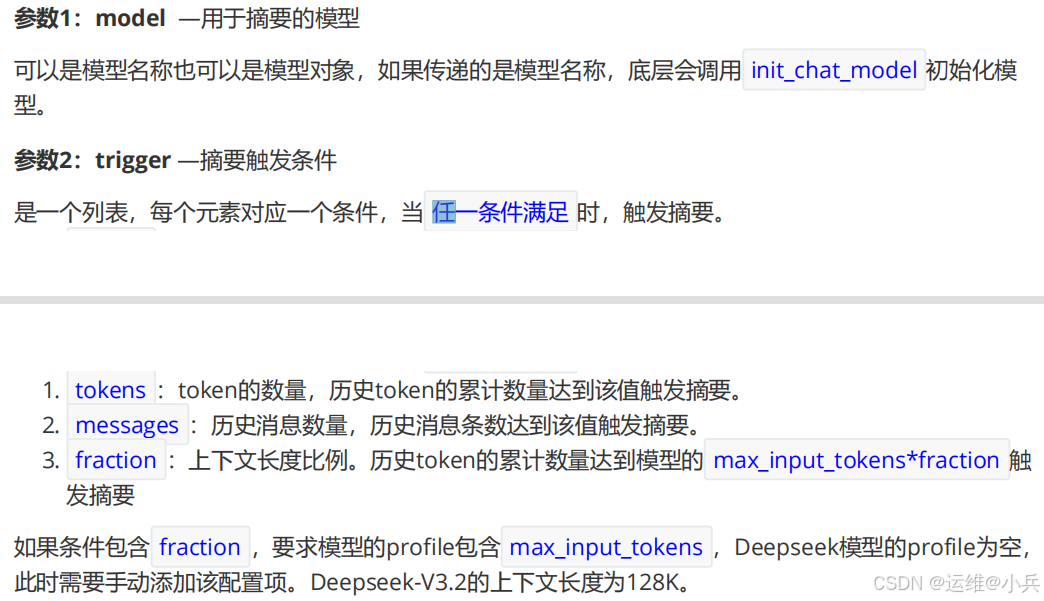
举例1:测试trigger、keep参数
py
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

load_dotenv(override=True)

DASHSCOPE_API_KEY=os.getenv("DASHSCOPE_API_KEY")
DASHSCOPE_BASE_URL=os.getenv("DASHSCOPE_BASE_URL")

custom_profile = {
    "max_input_tokens": 128_000
}

model = init_chat_model(
    model="openai:qwen-plus",   # 底层调用的是ChatOpenAI
    profile=custom_profile,
    api_key=DASHSCOPE_API_KEY,
    base_url=DASHSCOPE_BASE_URL
)

from langchain.agents import create_agent
from langchain.agents.middleware import SummarizationMiddleware
from langchain.messages import SystemMessage, HumanMessage, AIMessage

messages = [
    SystemMessage("你是个非常友好的AI助手"),
    HumanMessage("你好啊,我是老王,你是谁?"),
    AIMessage("你好老王,我是小王"),
    HumanMessage("好的小王,很高兴认识你"),
    AIMessage("你高兴得太早了"),
    HumanMessage("呵呵,你什么意思")
]
agent = create_agent(
    model=model,
    middleware=[
        SummarizationMiddleware(
            model=model,
            trigger=[
                ("tokens", 100),
                ("messages", 6),
                ("fraction", 0.001)
            ],
            keep=("messages", 2)
            )
    ]
)
response = agent.invoke({
    "messages": messages
})
for msg in response["messages"]:
    msg.pretty_print()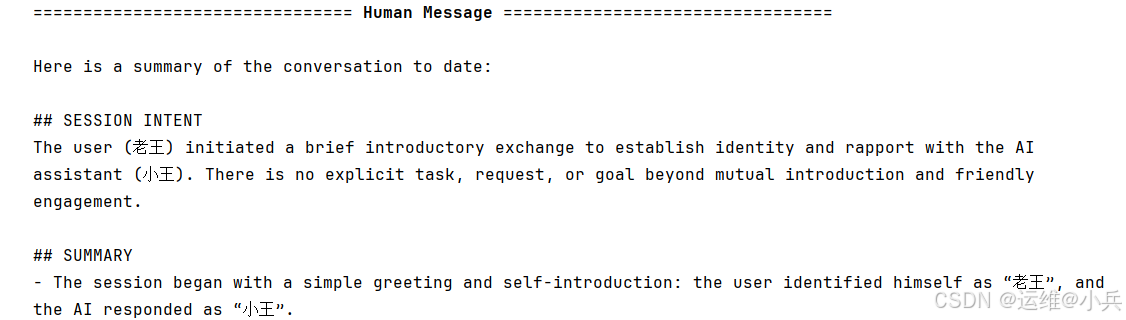
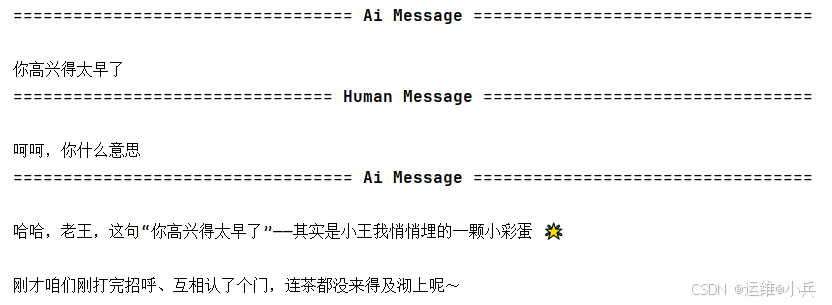
举例2:测试summary_prompt参数
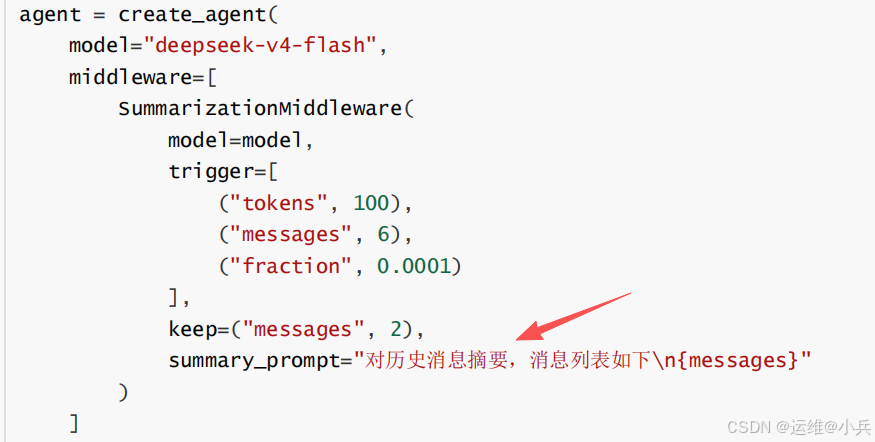
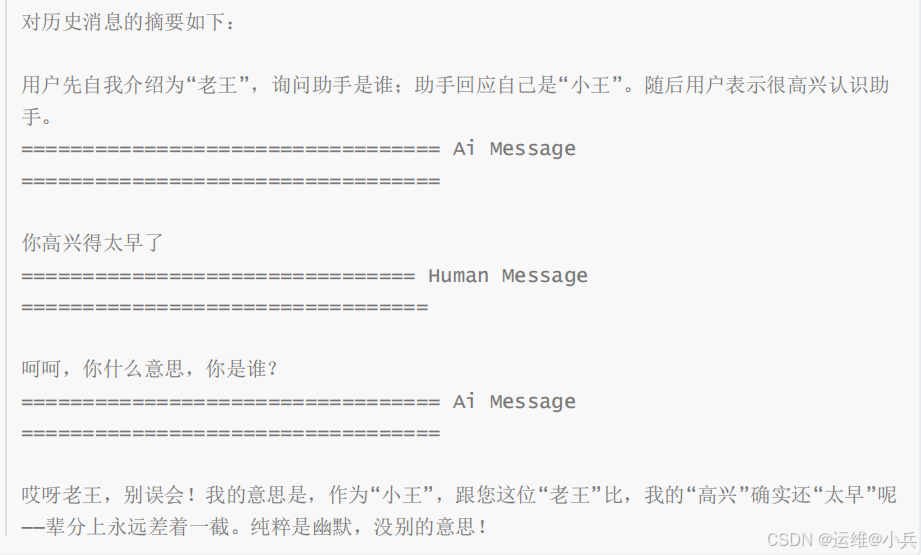
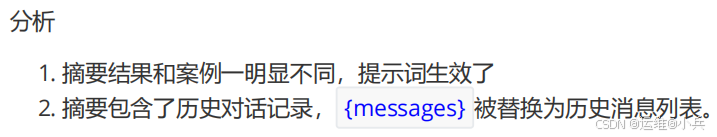
HumanInTheLoopMiddleware中间件
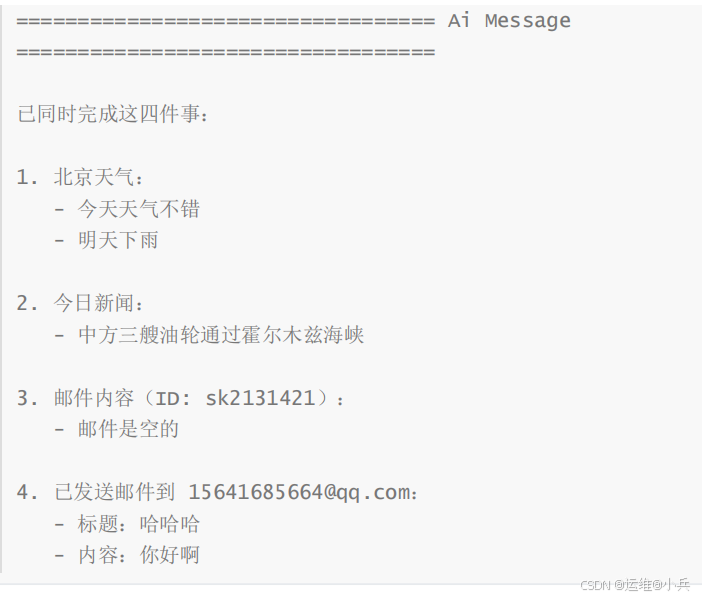
HumanInTheLoopMiddleware(人在环中间件、人工审核中间件)在 工具调用前 中断Agent运行,等待用户对工具调用请求决策。可选的决策有: approve(同意执行) 、 edit(编辑调用配置后执行) 、 reject(拒绝执行) 。
参数说明
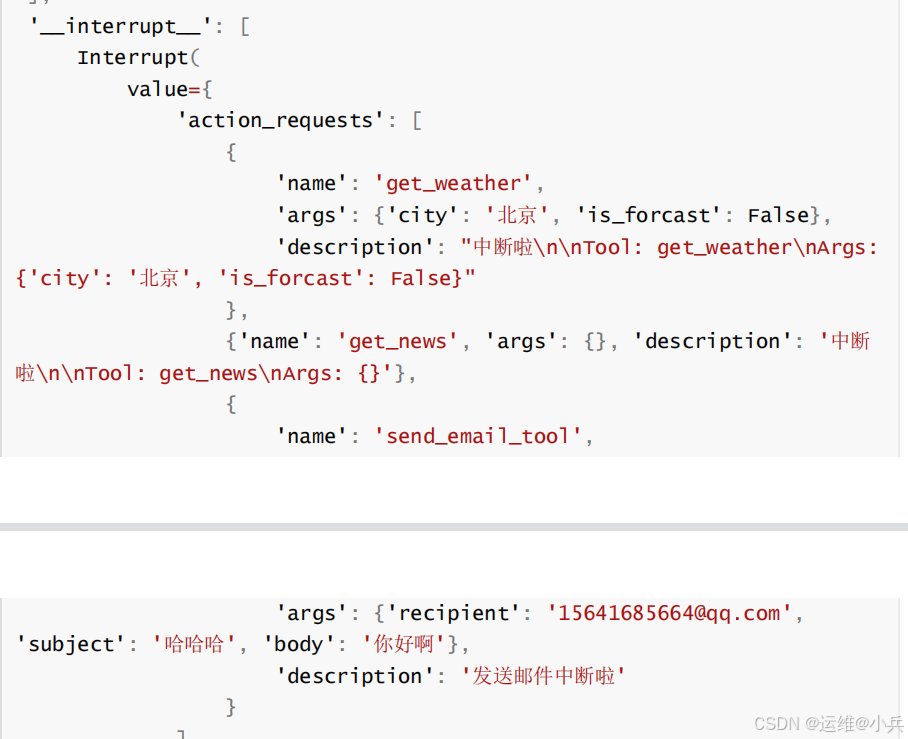
参数1:interrupt_on ---工具名和中断策略的映射
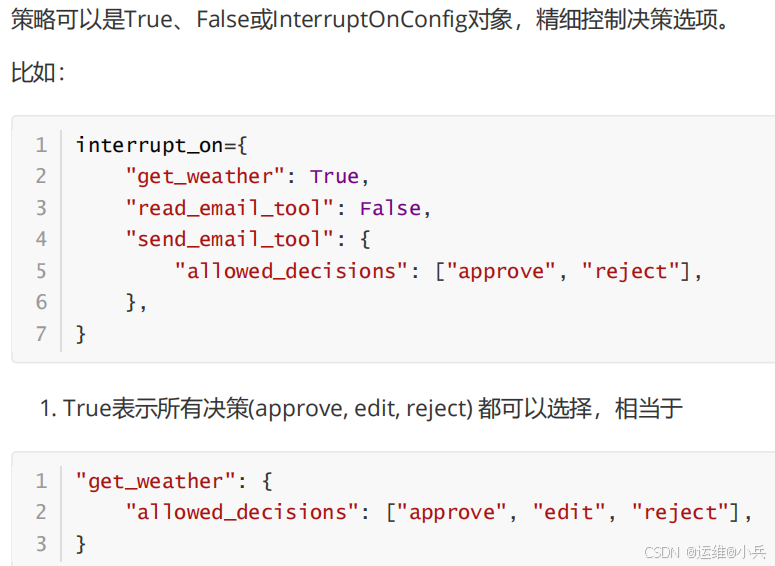
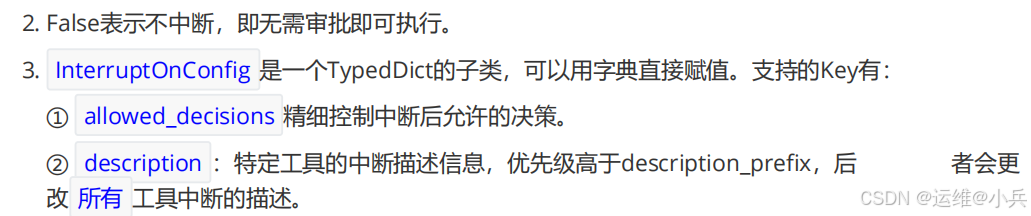
参数2:description_prefix ---自定义中断描述
默认为 "Tool execution requires approval" ,下面的举例可以看到效果
举例过程1:调用前中断
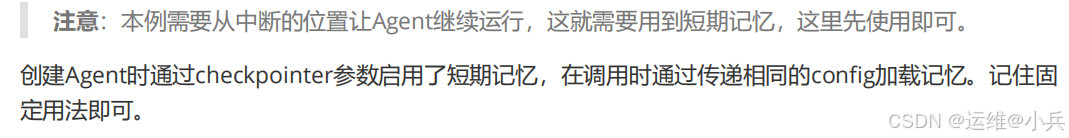
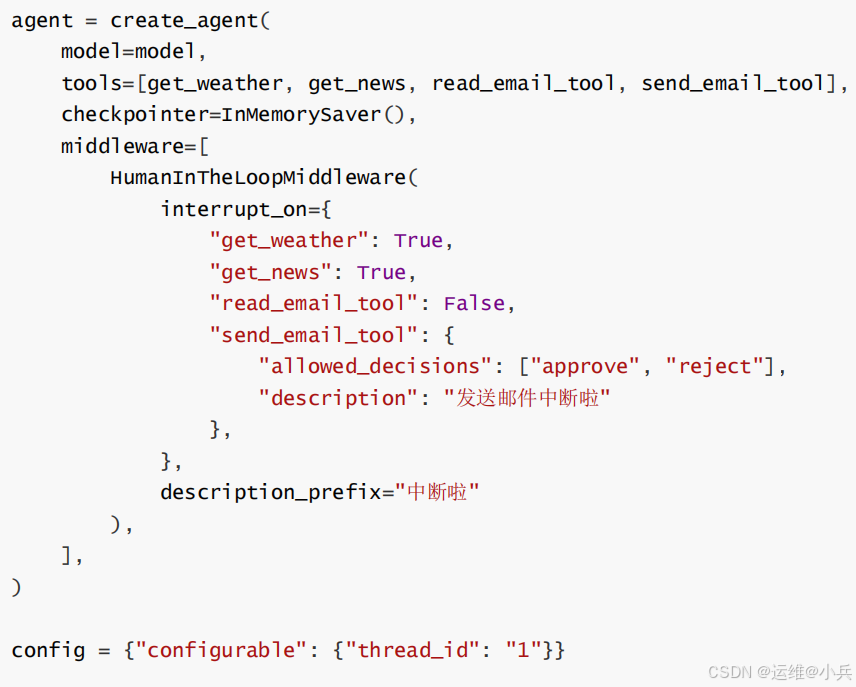
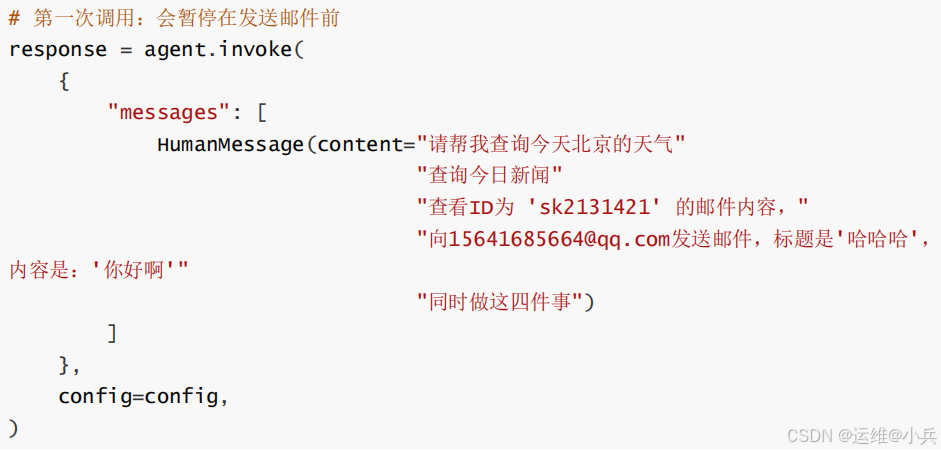
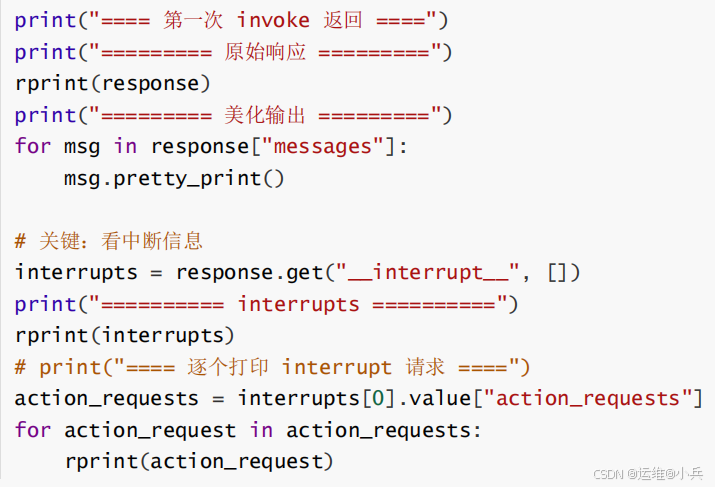
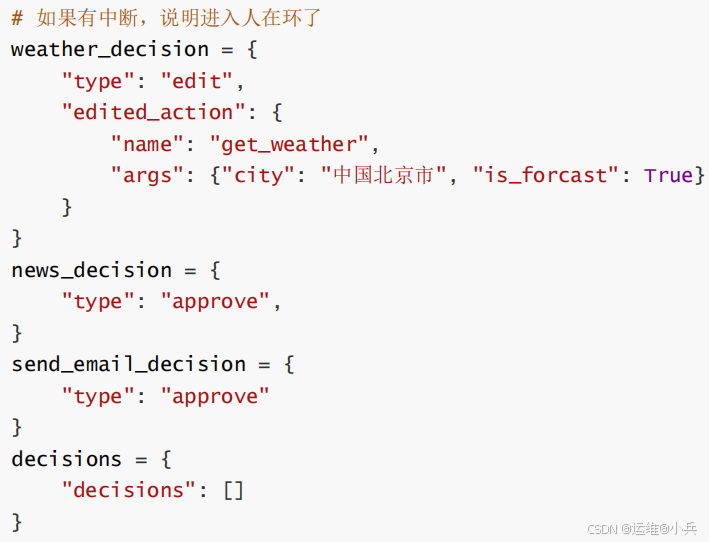
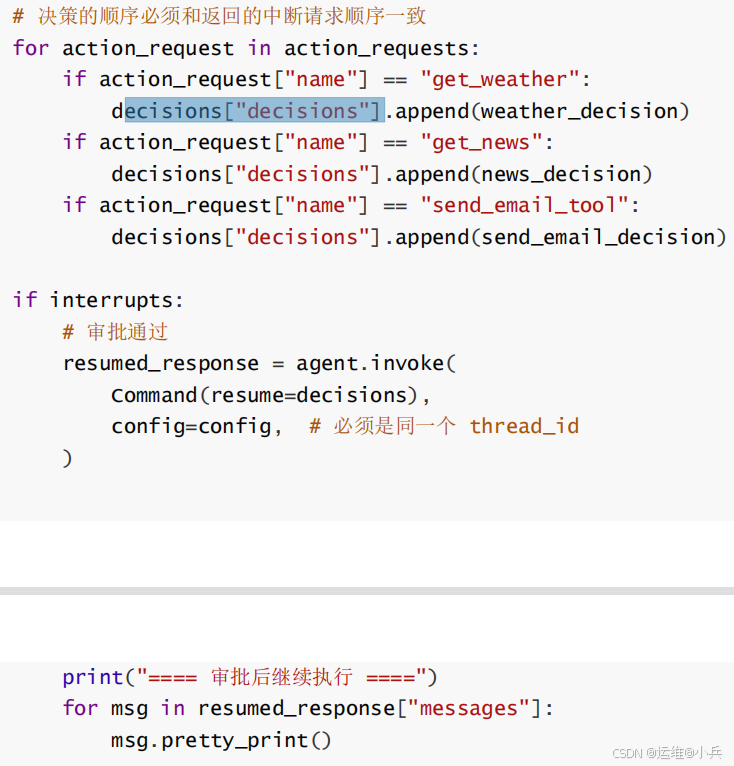
举例过程2:指明工具调用请求决策
北京要改为上海
PIIMiddleware中间件
敏感信息保护。
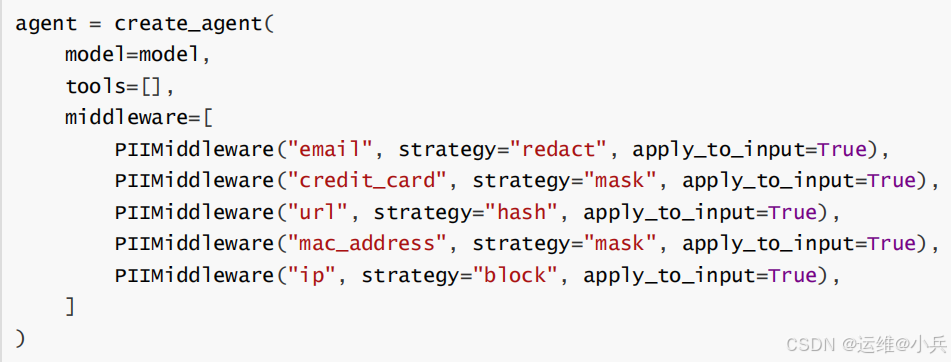
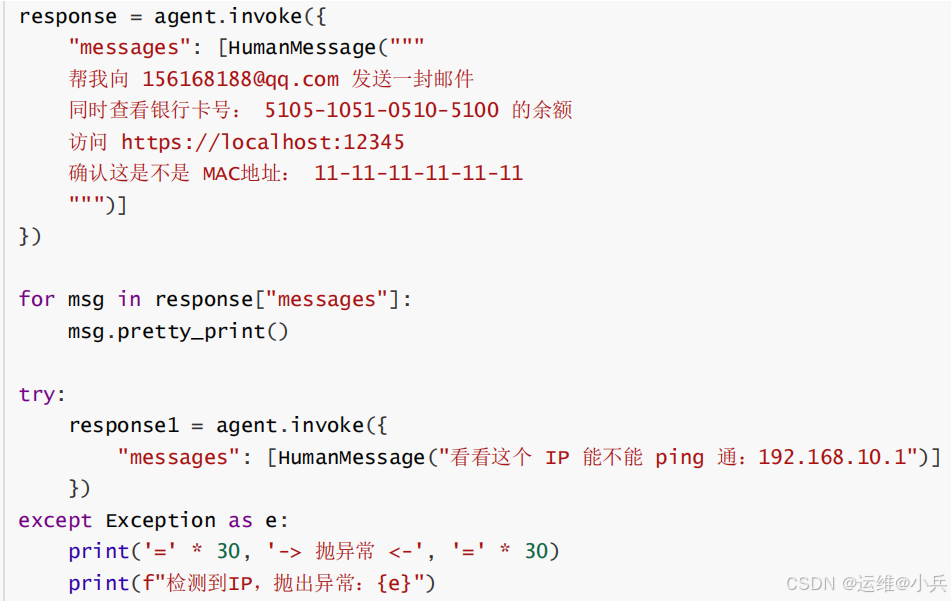
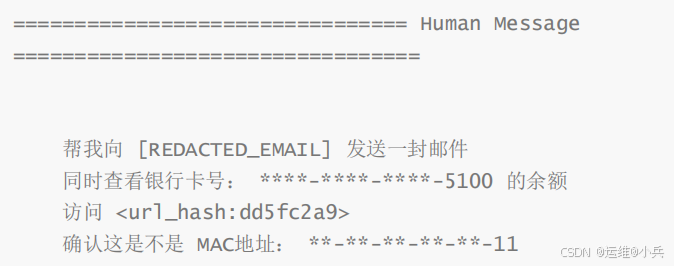
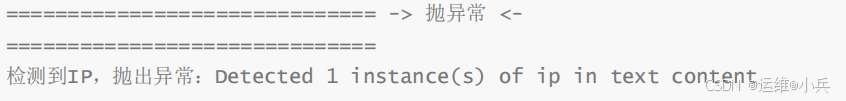
PII中间件用于检测和处理对话中的个人身份信息(Personally Identifiable Information,PII),支持自定义处理策略。
参数说明
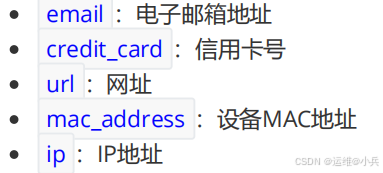
参数1:pii_type ---检测的PII数据类型
可以是内置类型或自定义类型,内置类型有:
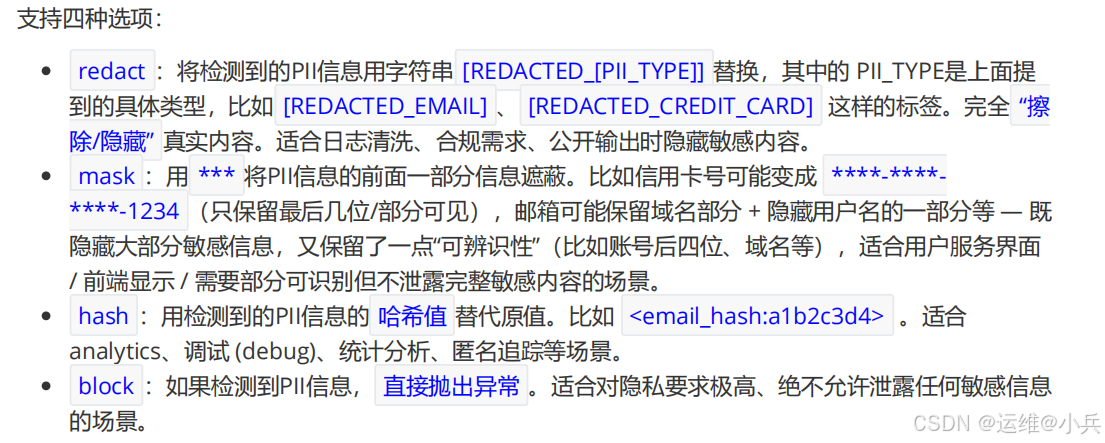
参数2:strategy ---处理PII信息的策略
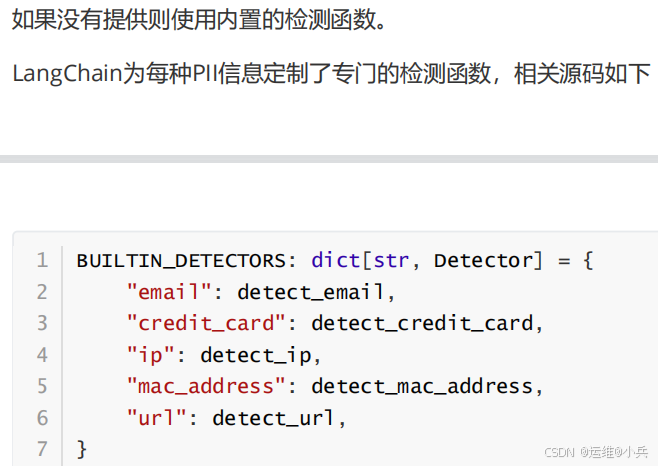
参数3:detector ---自定义 PII检测函数 或者 正则表达式
参数4:apply_to_input ---是否在调用模型前检测
默认为True
参数5:apply_to_output ---是否在模型调用后检测
默认为False。
参数6:apply_to_tool_results ---是否在工具调用后检测其输出
默认为False。
通常我们 只在模型调用前 检测。因为PII检测的主要目的是避免将敏感信息发送给模型服务导致信息泄露
举例1:使用内置检测器
举例2:自定义检测器/函数
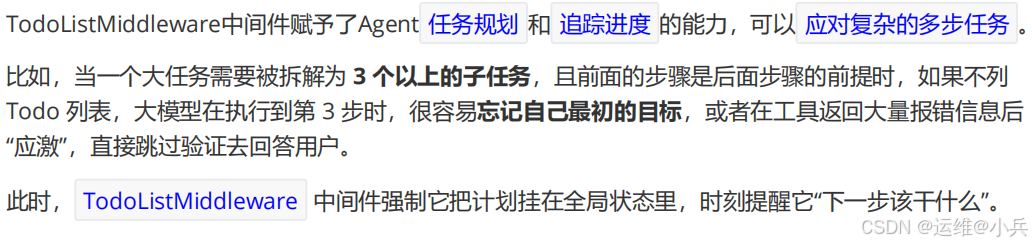
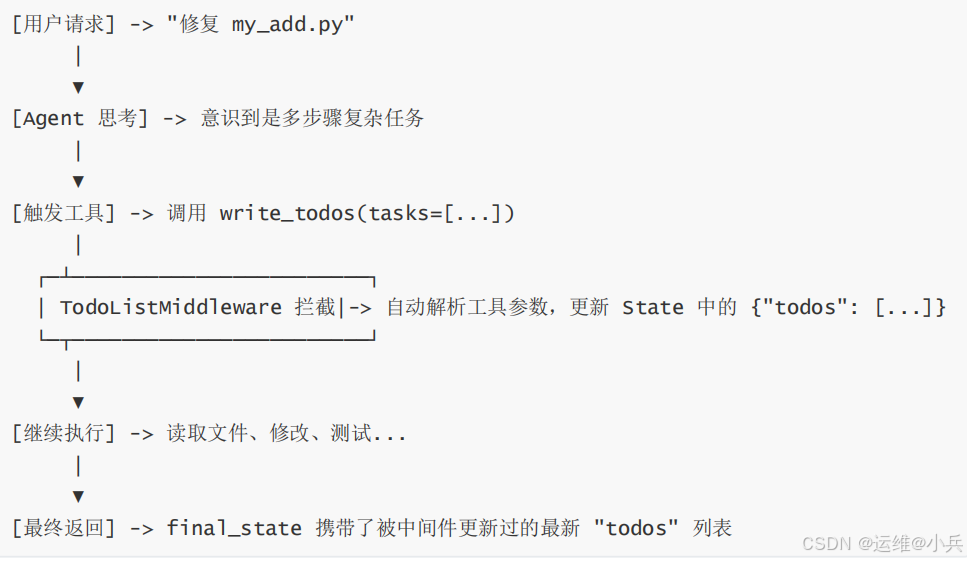
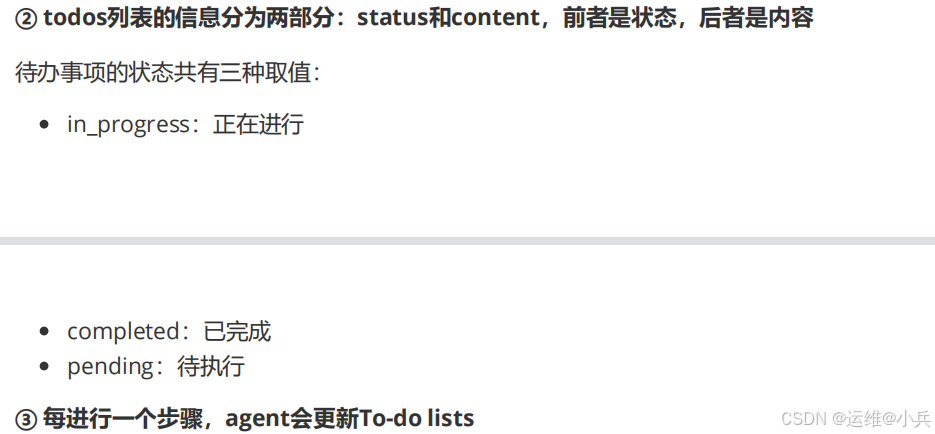
TodoListMiddleware中间件
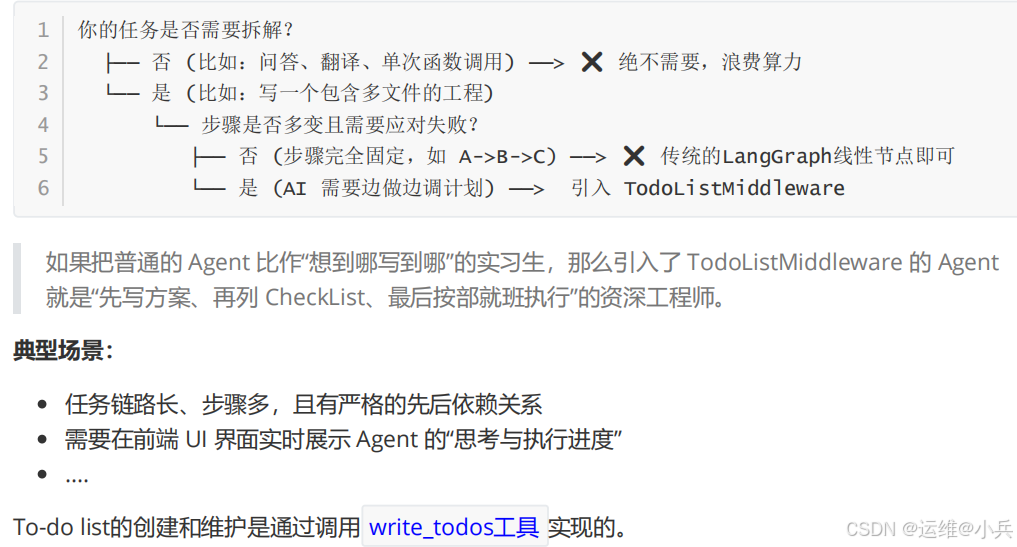
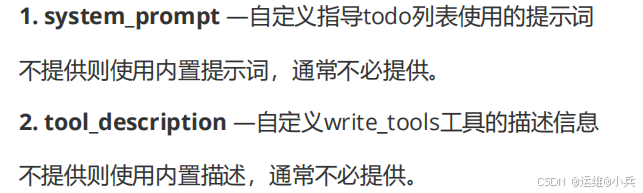
参数说明
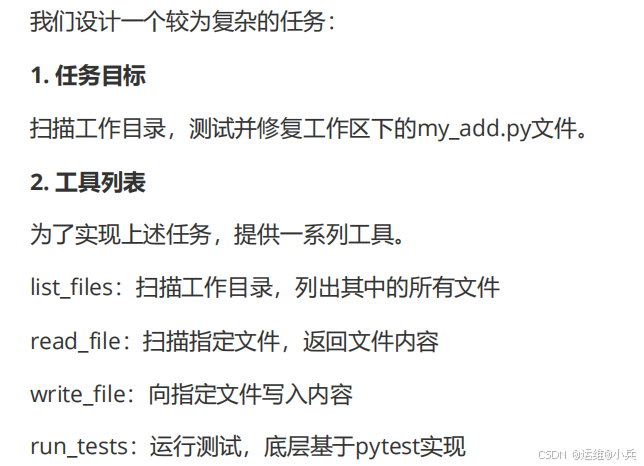
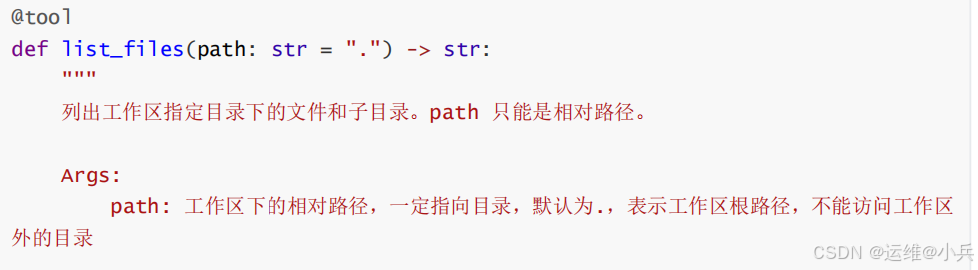
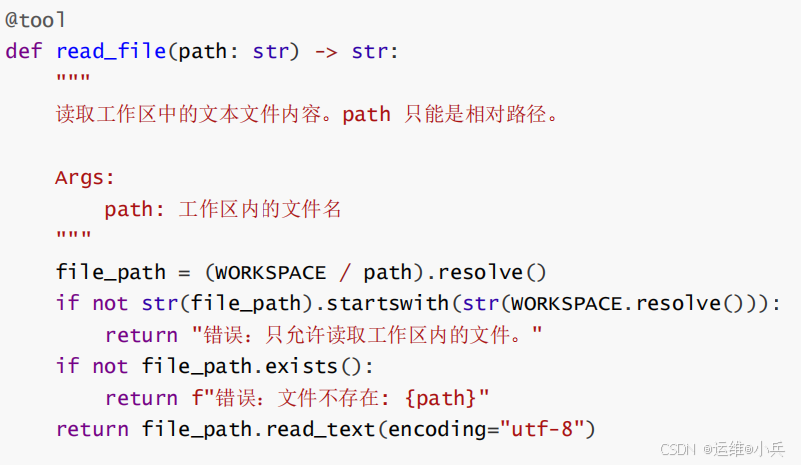
案例设计
代码
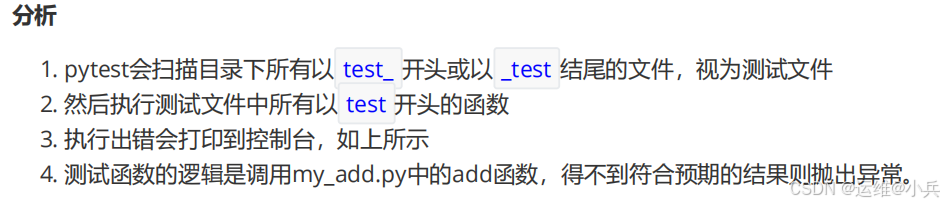
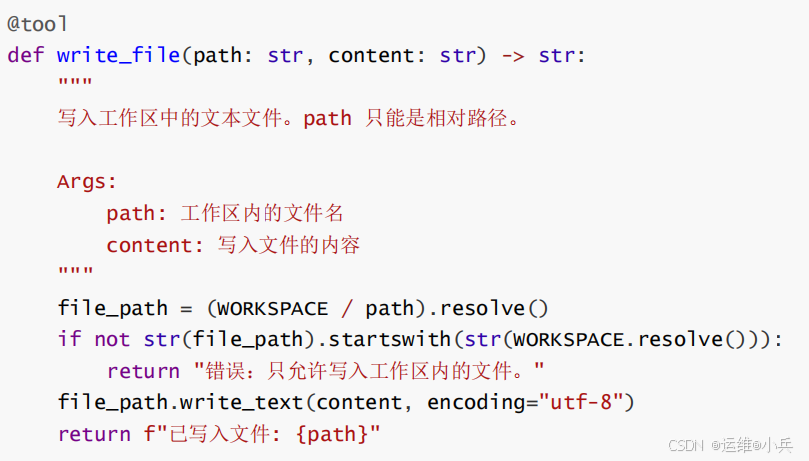
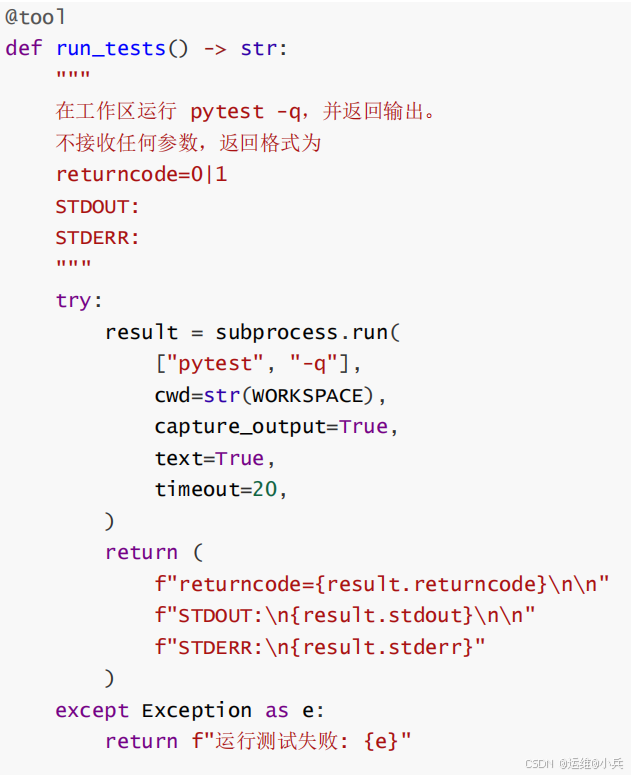
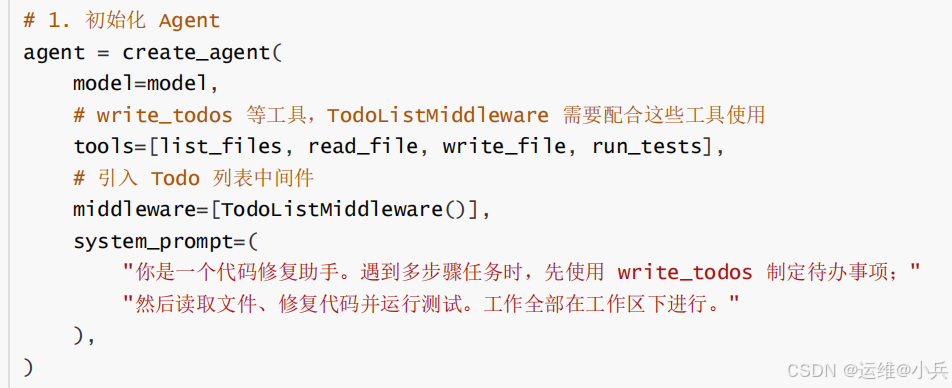
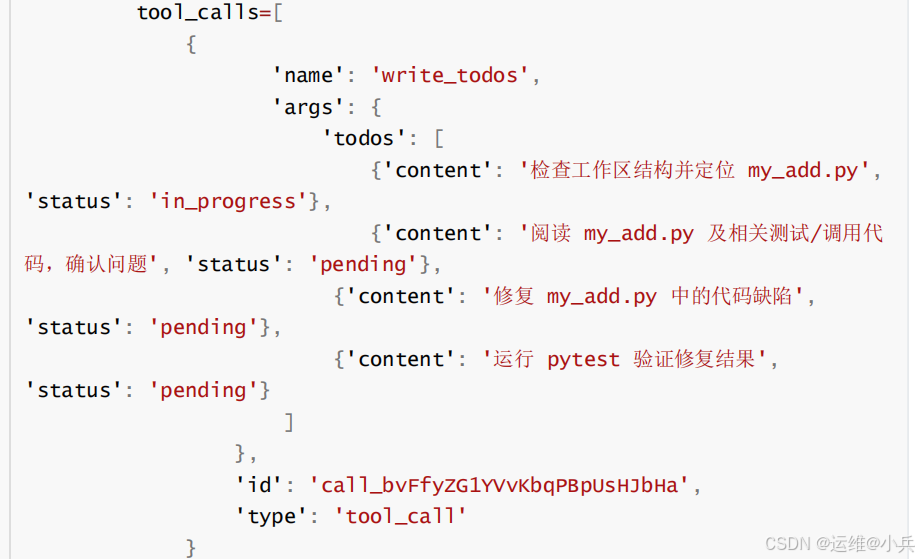
分析
为了让 TodoListMiddleware 生效,Agent、工具和中间件三者之间必须满足特定的协同契约:
三、其它内置中间件
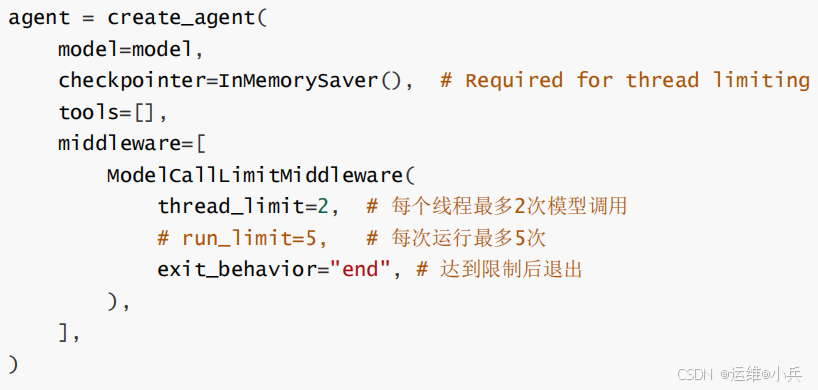
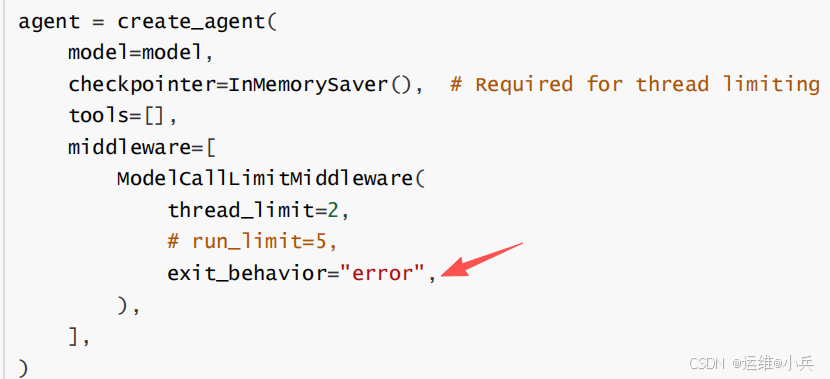
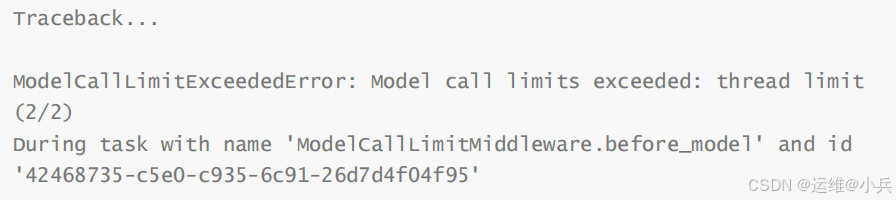
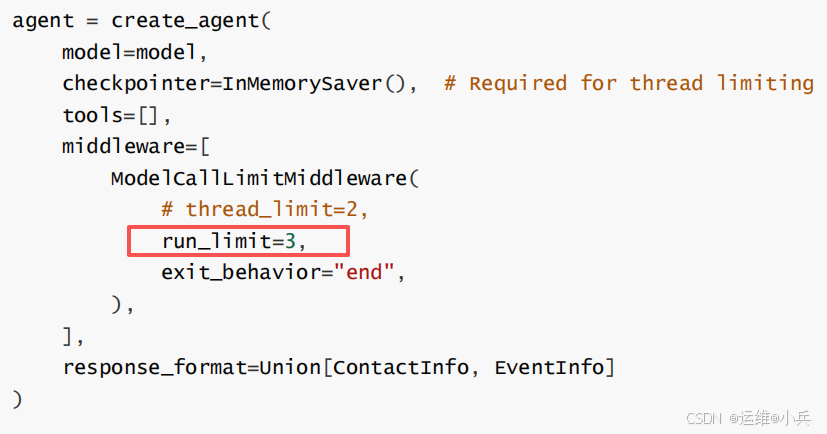
ModelCallLimitMiddleware中间件
限制模型调用次数,避免无限循环,控制调用成本。
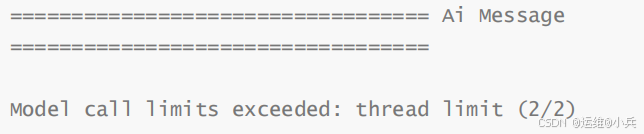
举例1:整个会话限制-优雅退出
举例2:整个会话限制-抛异常
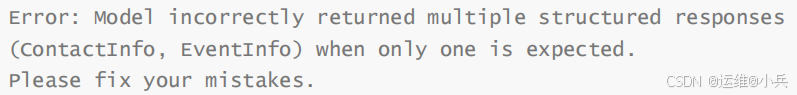
举例3:单次调用限制-优雅退出
需要fake-server重复触发工具调用,代码如下
举例4:单次调用限制-抛异常
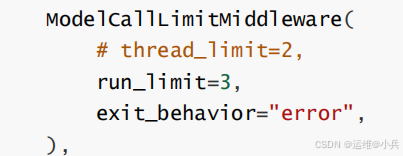
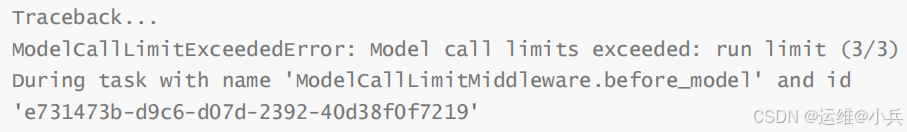
ToolCallLimitMiddleware中间件
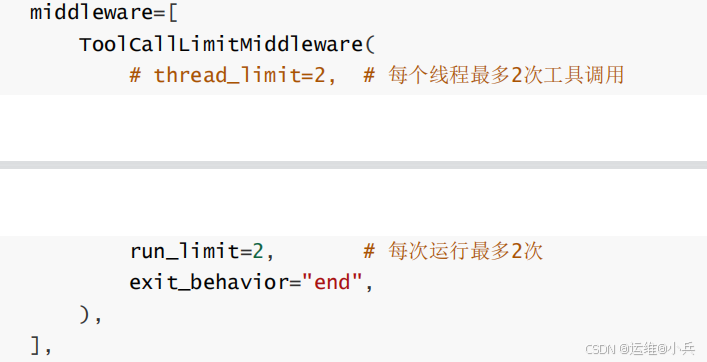
限制工具调用次数,可以 限制所有工具 调用的总次数,也可以 限制特定工具 的调用次数。
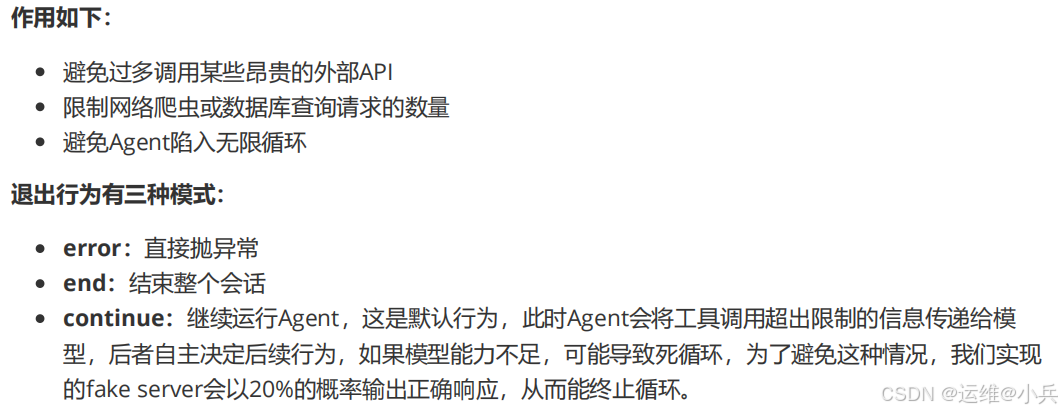
举例1:整个会话限制-优雅结束
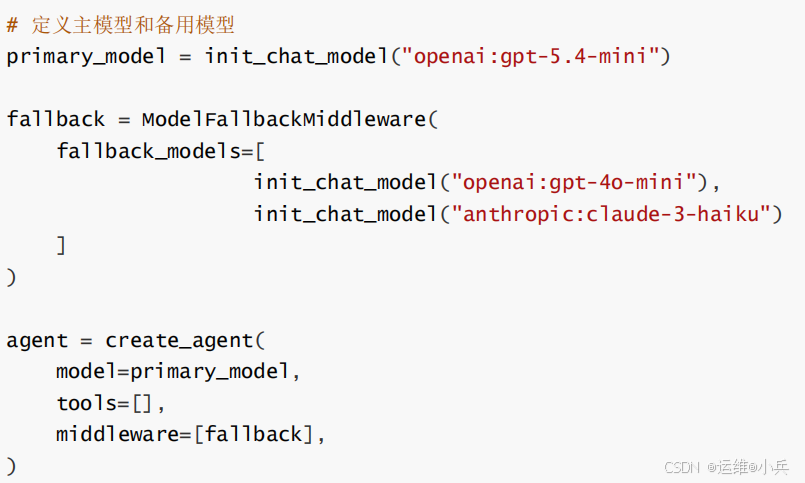
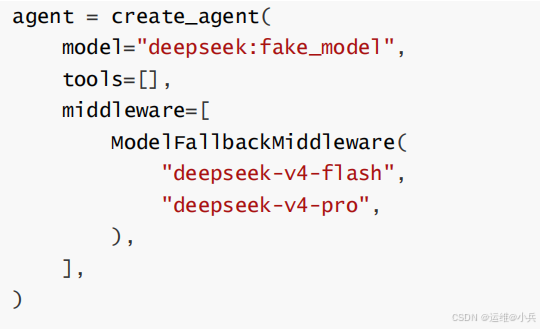
ModelFallbackMiddleware中间件
用于故障转移,当主模型无法访问时,启用备用模型
或者
LLMToolSelectorMiddleware中间件
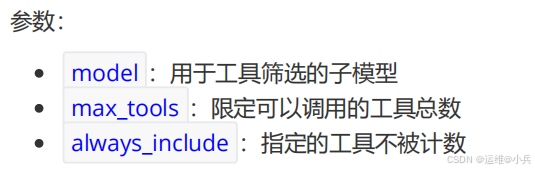
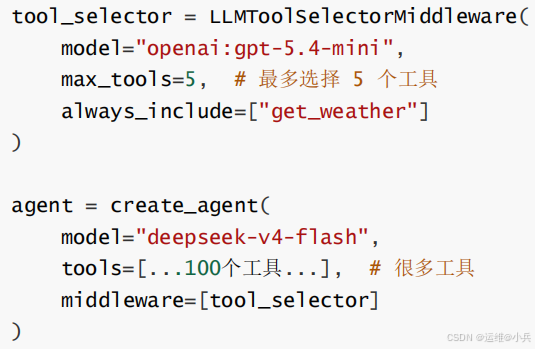
智能工具筛选。
当工具太多时,用子模型筛选最相关的几个工具。
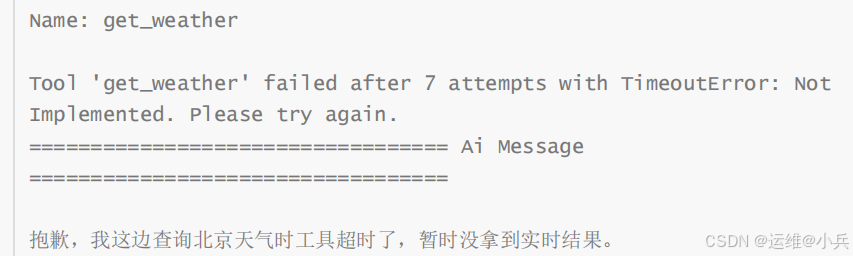
ToolRetryMiddleware中间件
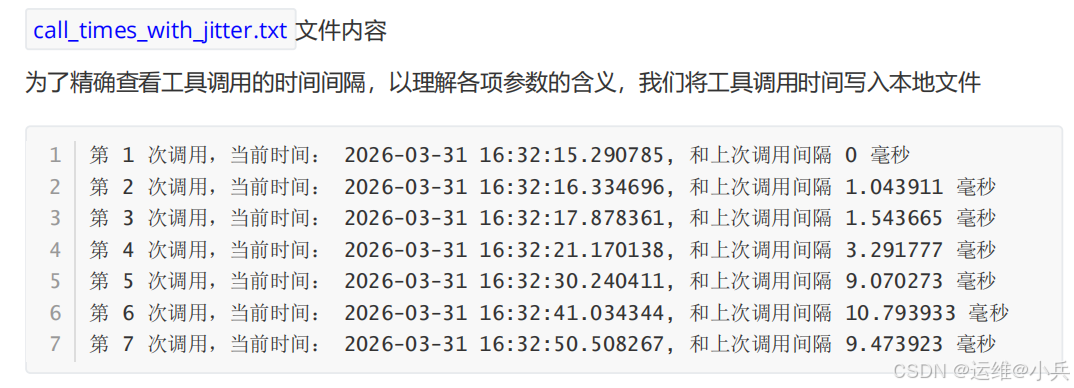
基于指数退避算法,设置工具调用失败时的重试策略。
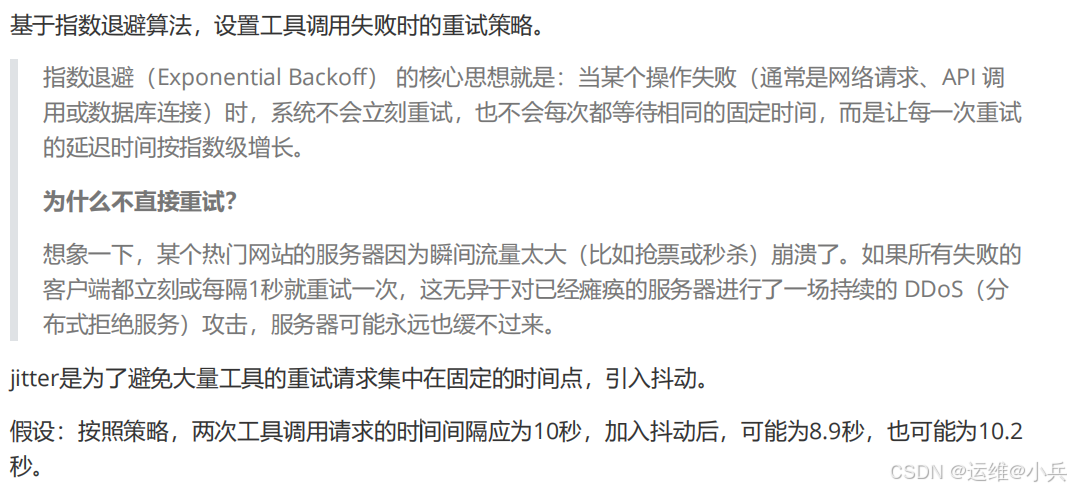
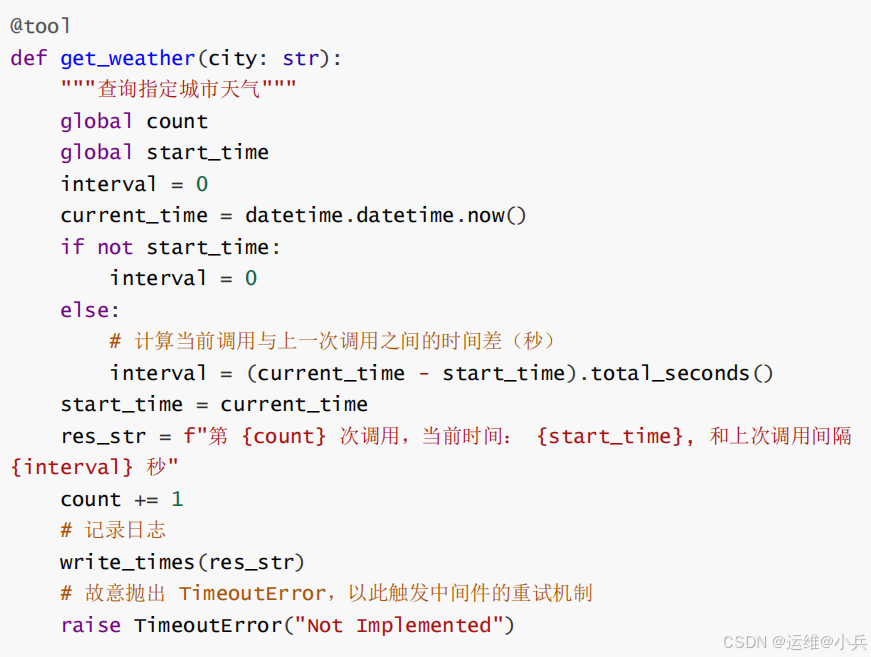
举例1:带抖动
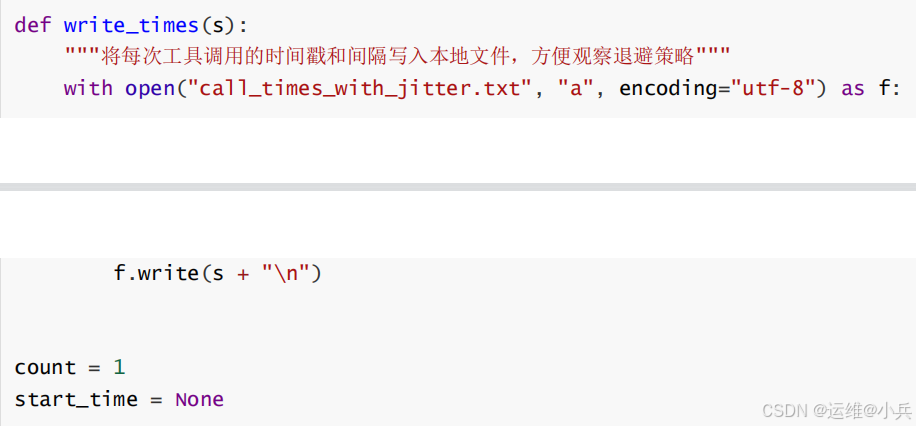
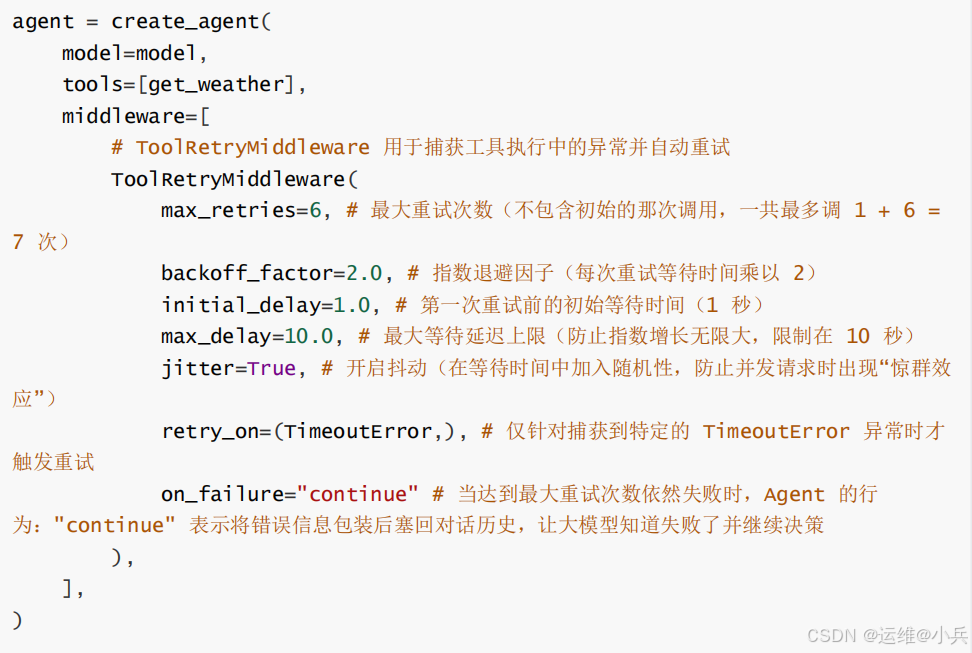
举例2:无抖动
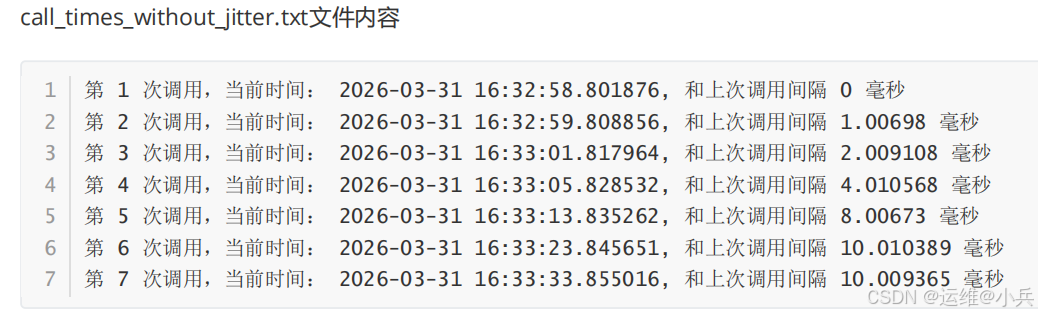
如果你把 backoff_factor = 0,就意味着不使用指数增长,重试之间始终用固定的 initial_delay。
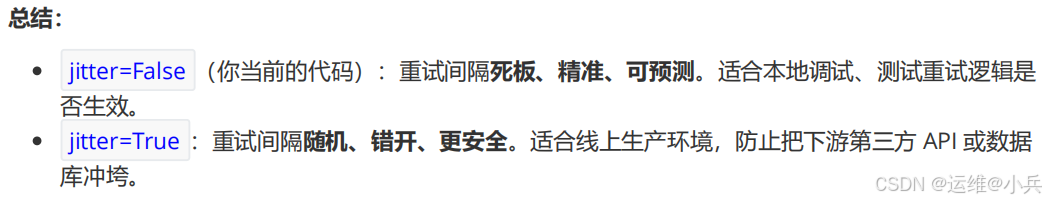
为什么要引入 Jitter(抖动)?关闭它会有什么问题?
在单用户、单并发的测试环境下,关闭 jitter没有任何副作用,甚至能让等待时间非常规律、可预测。
但在高并发的生产环境中,关闭 jitter会引发灾难性的 "惊群效应(Thundering Herd Problem)" :
-
没有 Jitter 的惨剧( jitter=False ):
假设某刻天气 API 服务突然宕机了 1 秒。此时刚好有 1000 个用户同时发起了查询。因为这 1000个请求同时失败,并且它们都严格死板地等待 1 秒、2 秒、4 秒......
这意味着,在第 1 秒、第 2 秒、第 4 秒的那个精准的时间点上,这 1000 个请求会整整齐齐地再次同时轰炸服务器。刚刚复活的服务器瞬间又被这波整齐的峰值流量压垮,形成恶性循环。 -
引入 Jitter 的优势( jitter=True ):
通过给重试时间加上随机性,这 1000 个请求会在 01秒和12的区间内均匀地错开(削峰填谷)。流量被平摊到了整条时间轴上,服务器就能轻松地分批处理完这些请求。
ModelRetryMiddleware中间件
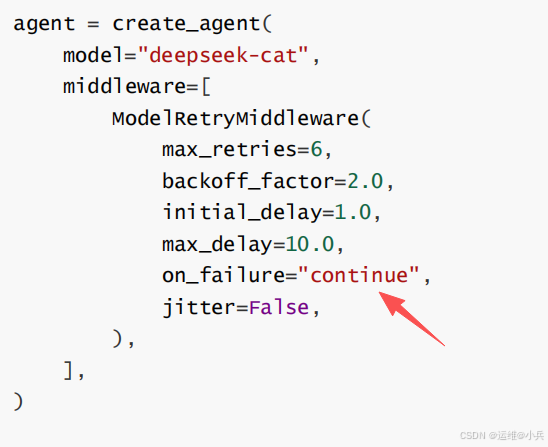
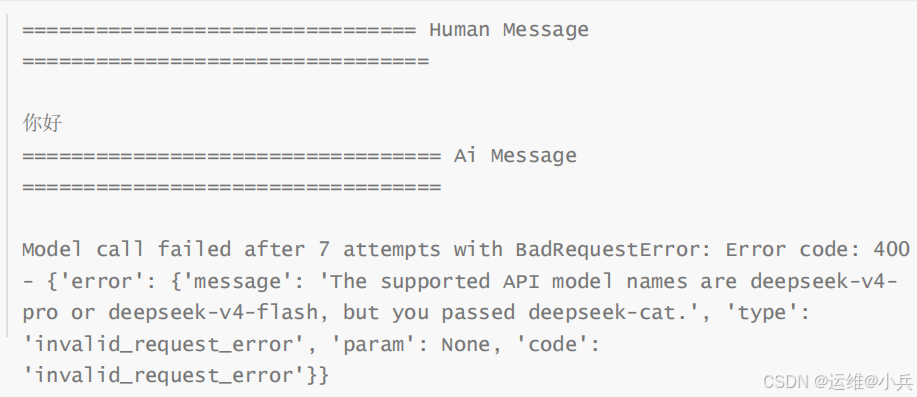
举例1:继续运行
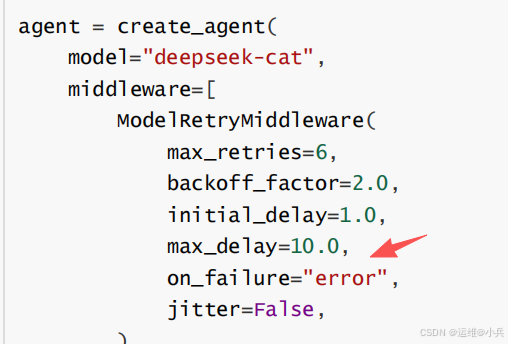
举例2:抛异常
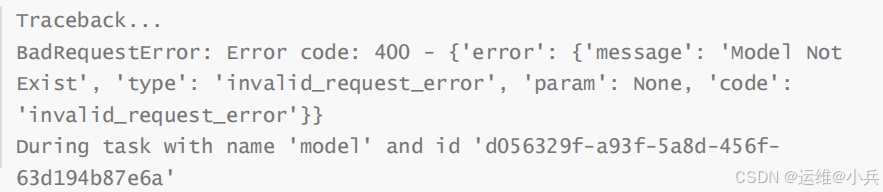
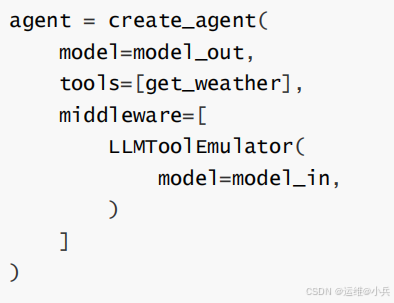
LLMToolEmulator中间件
某些情况下,工具尚未开发完成,我们希望先测试工具调用,可以用LLM tool emulator模拟工具。
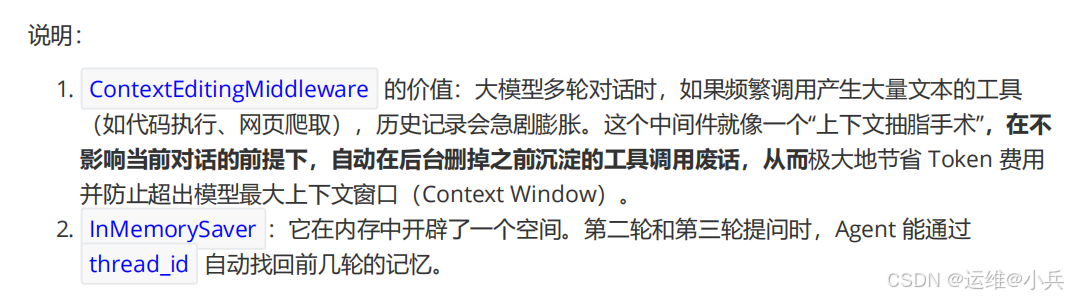
ContextEditingMiddleware中间件
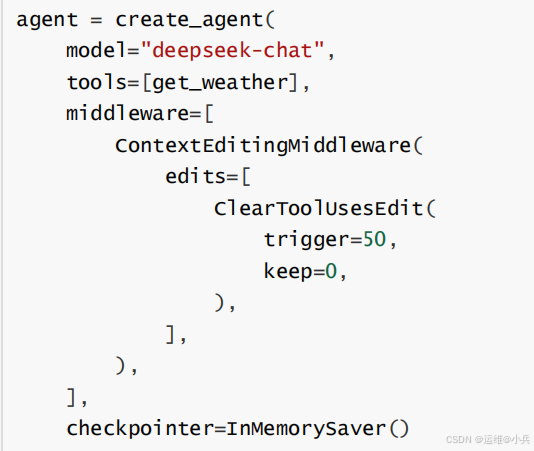
上下文编辑中间件,该中间件提供了上下文管理的一种方式。
通过更改发送给模型的消息列表来控制成本。
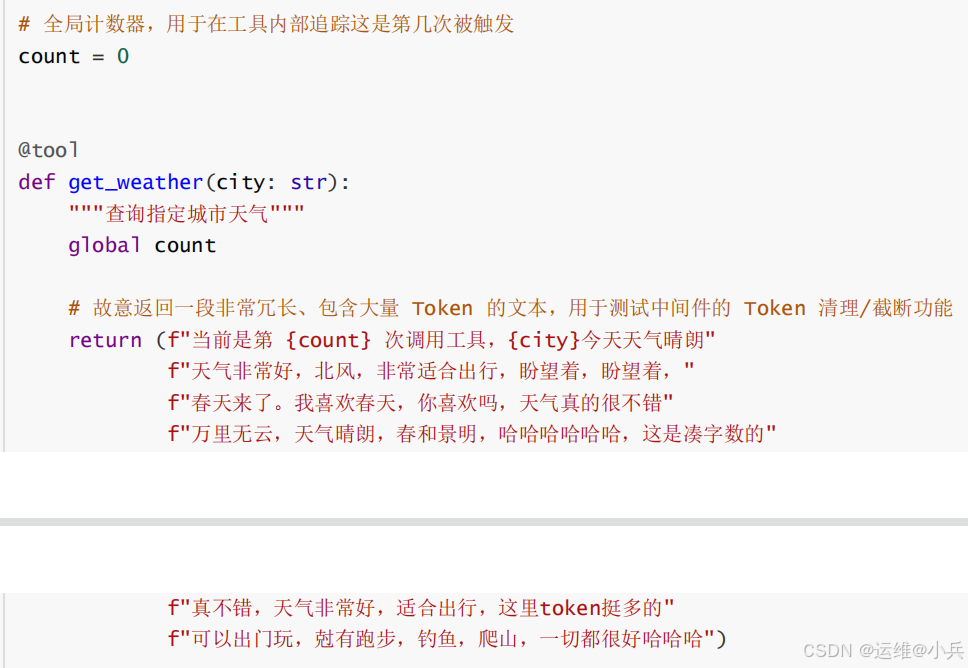
注意:不会更改消息列表。因此我们只能通过token用量来推测是否对消息列表进行了裁剪。
实验组-启用上下文编辑
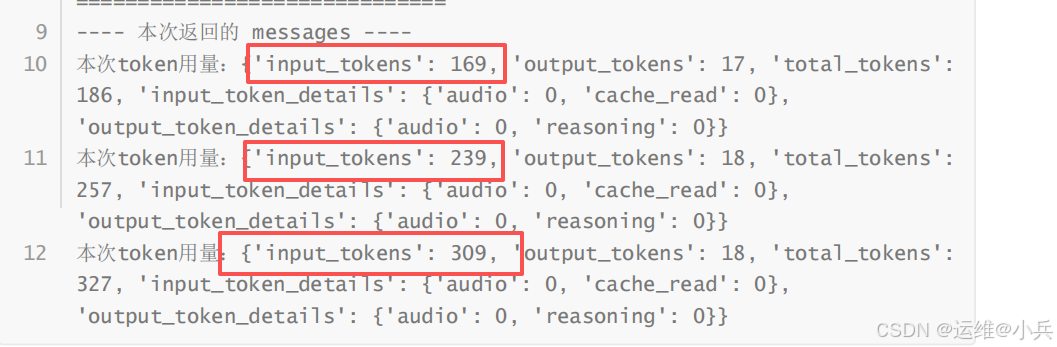
对照组-不裁剪上下文
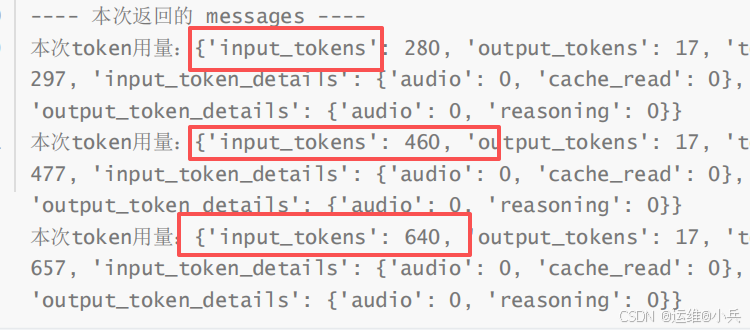
可以观察到,对照组的input_tokens明显大于实验组
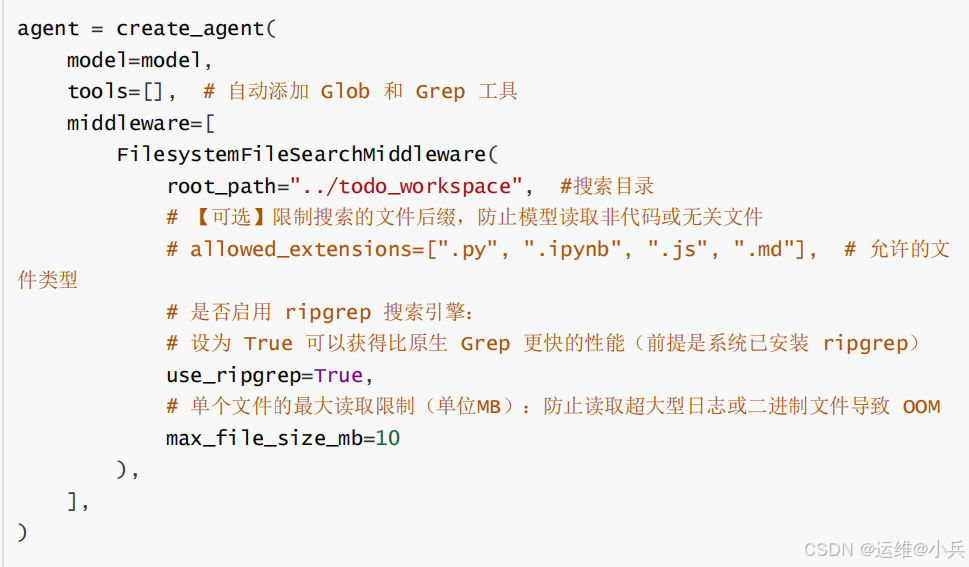
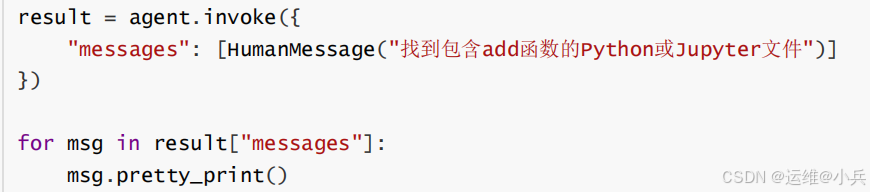
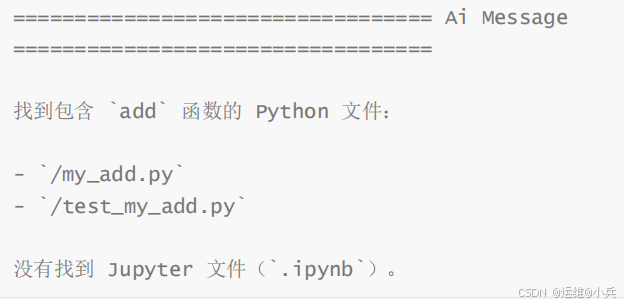
FilesystemFileSearchMiddleware中间件
基于系统的Glob和Grep检索工具,为Agent赋予本地文件搜索和分析的能力。
Shell tool中间件
为Agent提供一个可以执行命令的Shell环境。
Windows下无法测试。
Filesystem中间件
这是源自deepagents(基于LangChain的另一个框架)的中间件
内置了四个工具,分别用于查看目录、读文件、写文件和改文件。
Subagent中间件
也是来自deepagents的中间件
用于便捷地创建子Agent。
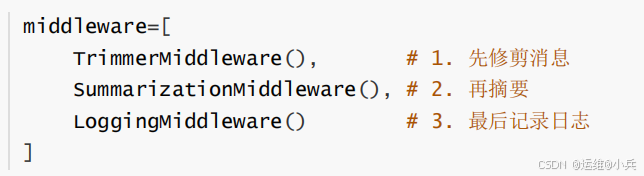
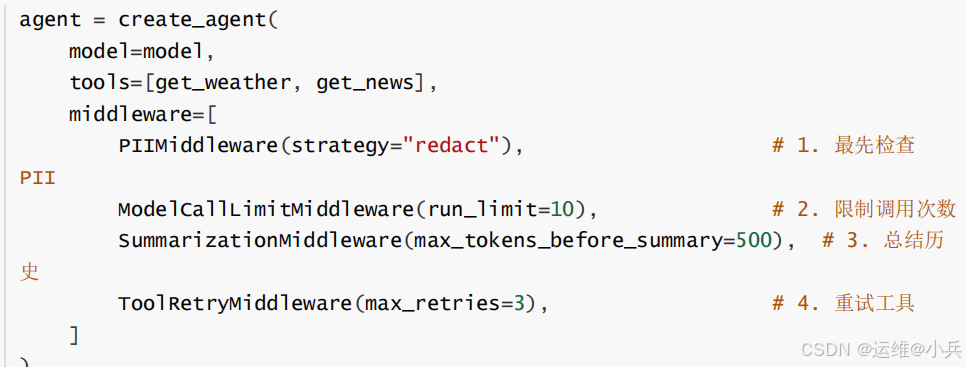
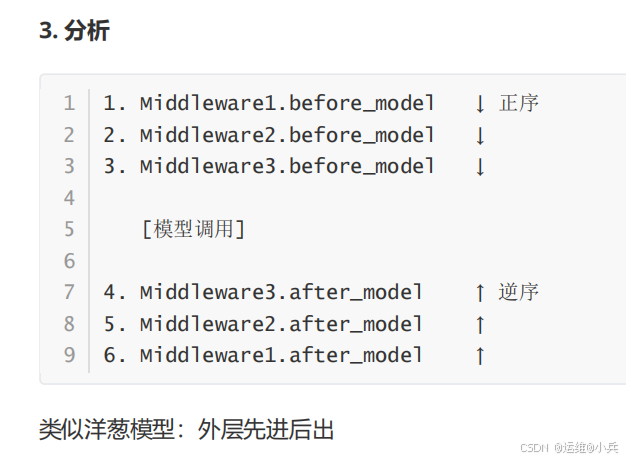
四、多个中间件组合及执行顺序
五、自定义中间件
什么是hook函数(钩子函数)
Hook 函数,中文常叫 钩子函数 ,指的是:在某个既定流程的特定时机,被框架、系统或主程序 自动调用 的扩展函数
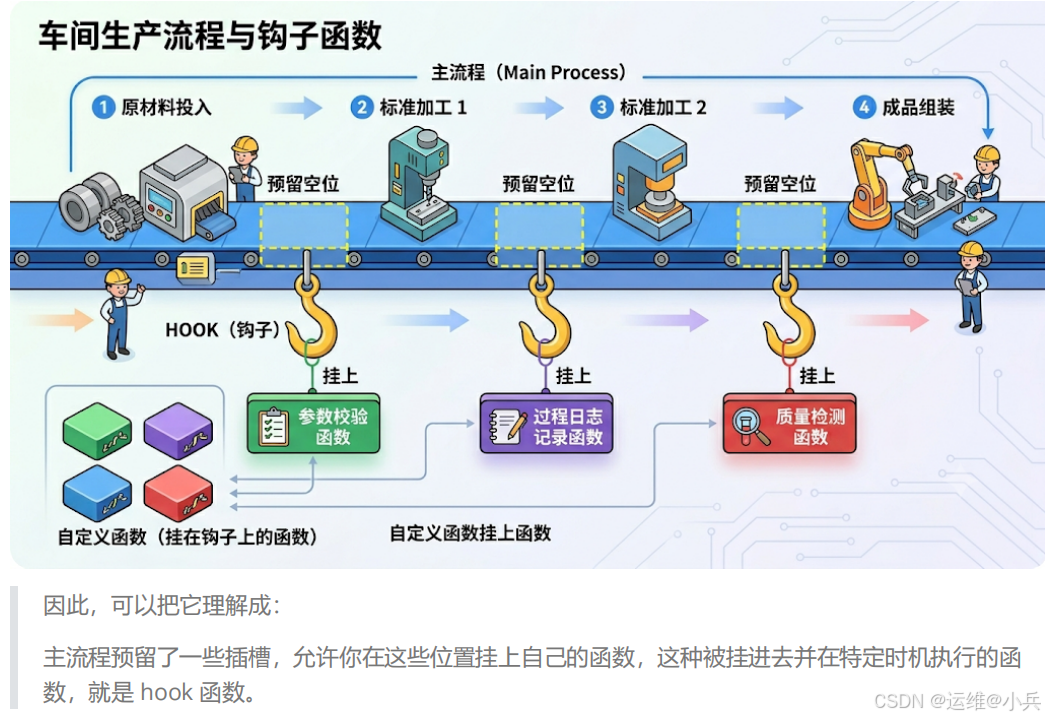
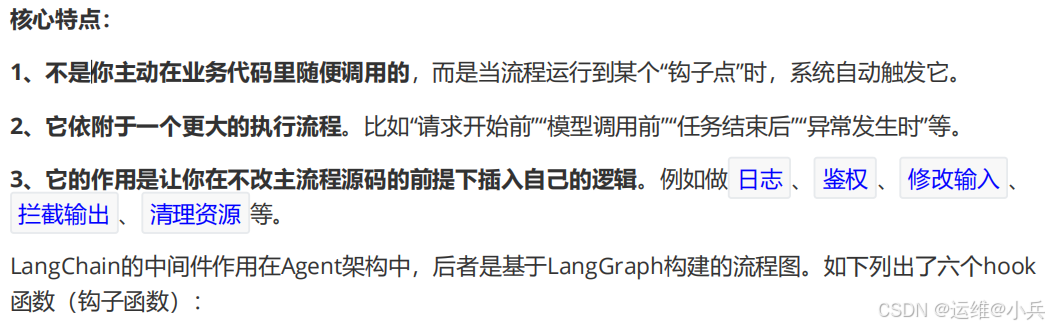
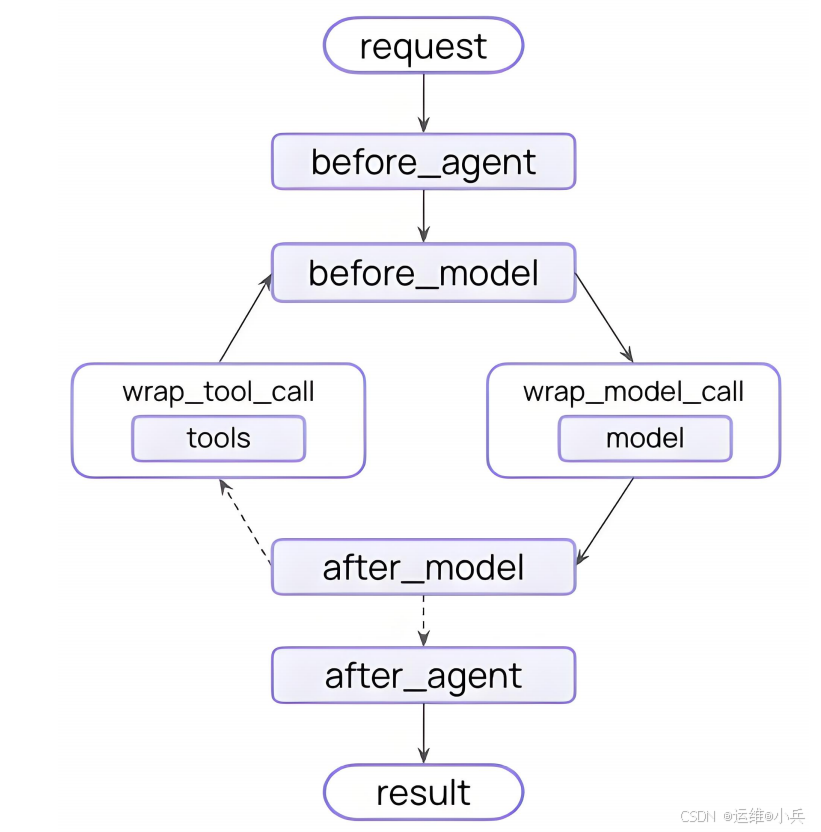
无论是官方内置中间件、自定义中间件、还是下文提到的便捷装饰器中间件,通常都是通过实现其中的一个或多个hook来生效的。
LangChain的hook函数分类
类型1:Node-style hooks(节点风格钩子)
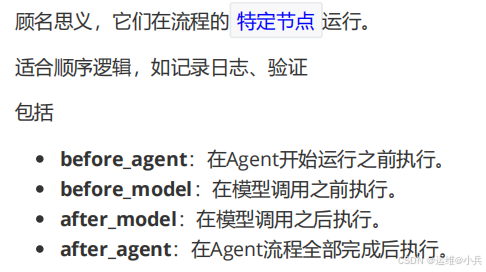
类型2:Wrap-style hooks(包装风格钩子)
Node-style hooks函数用法
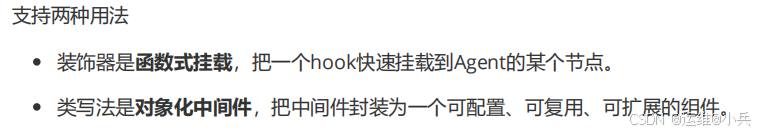
基本用法
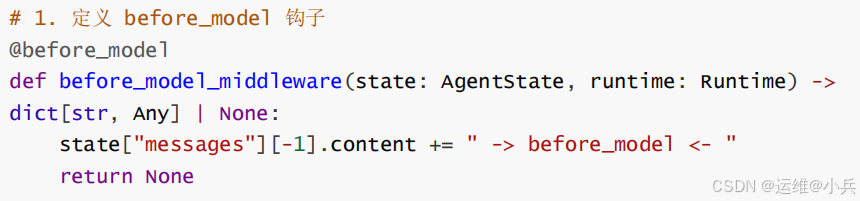
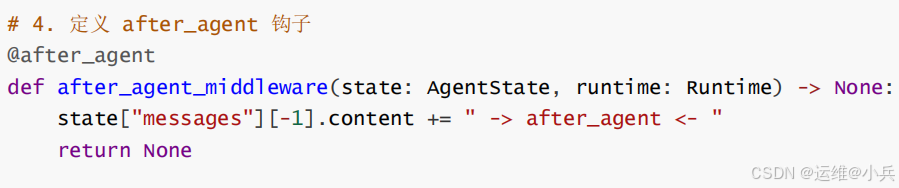
基于装饰器实现
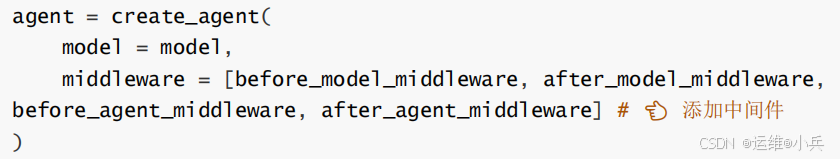
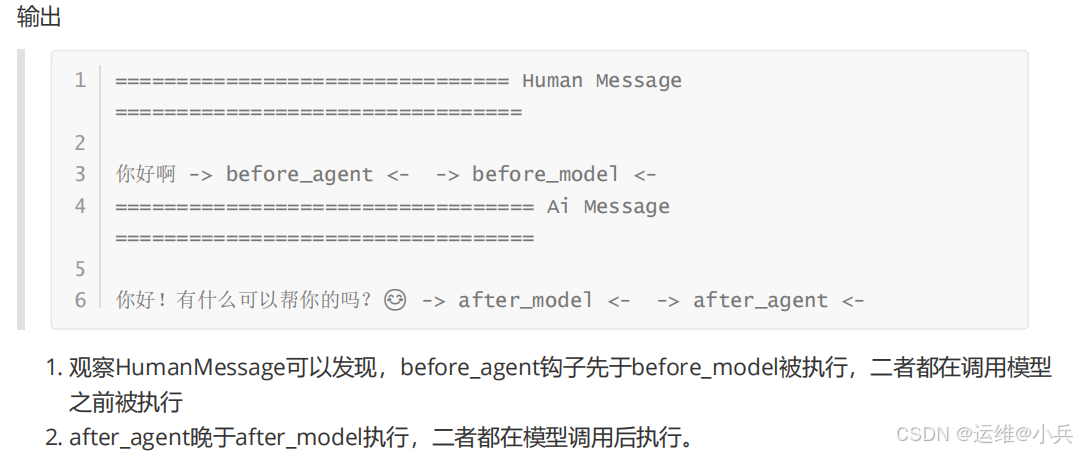
基于类实现
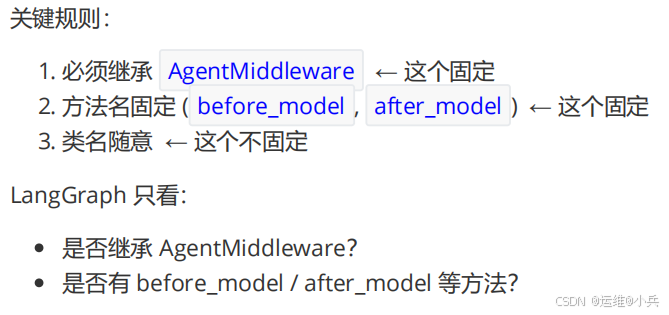
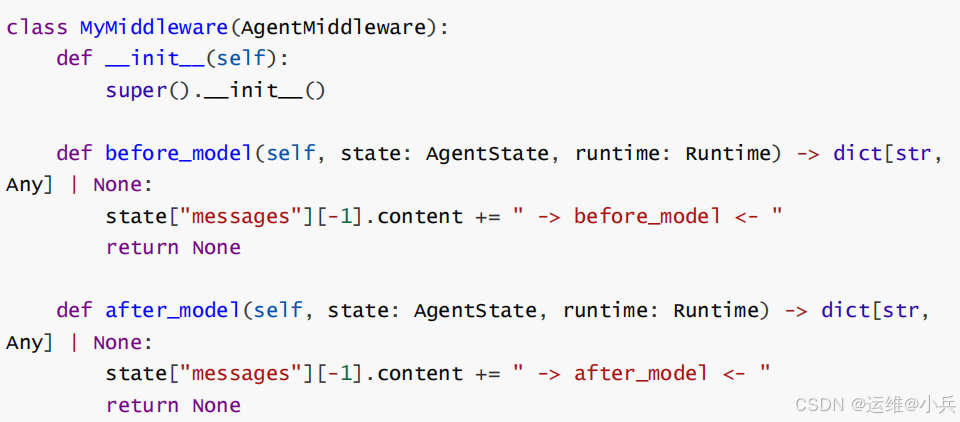
使用场景
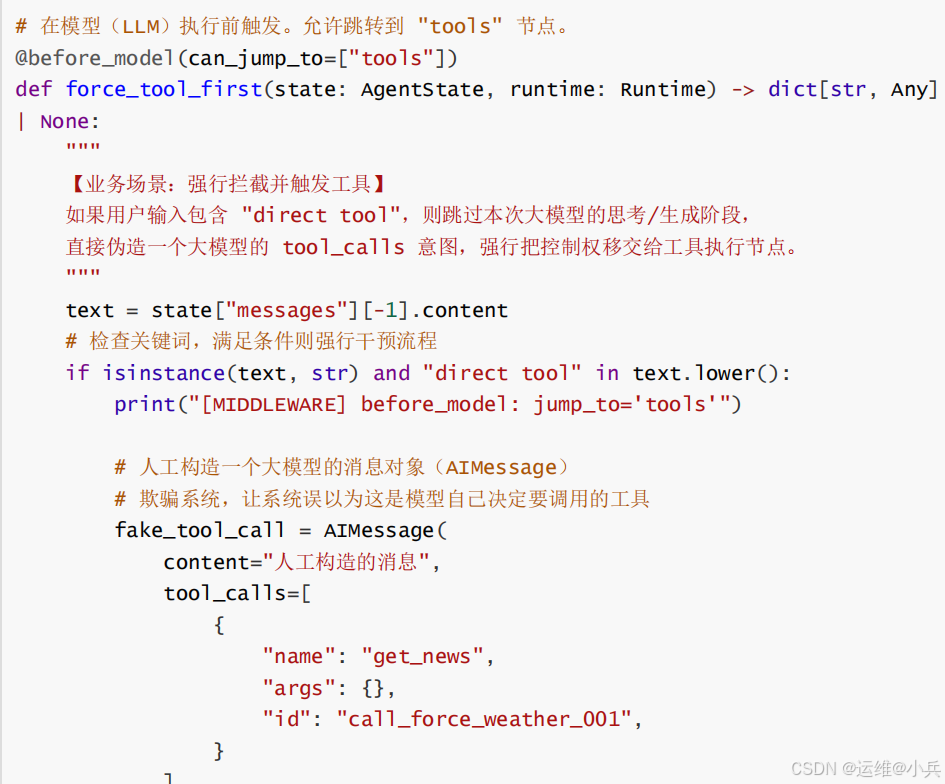
before_model 通常的场景
after_model 通常的场景
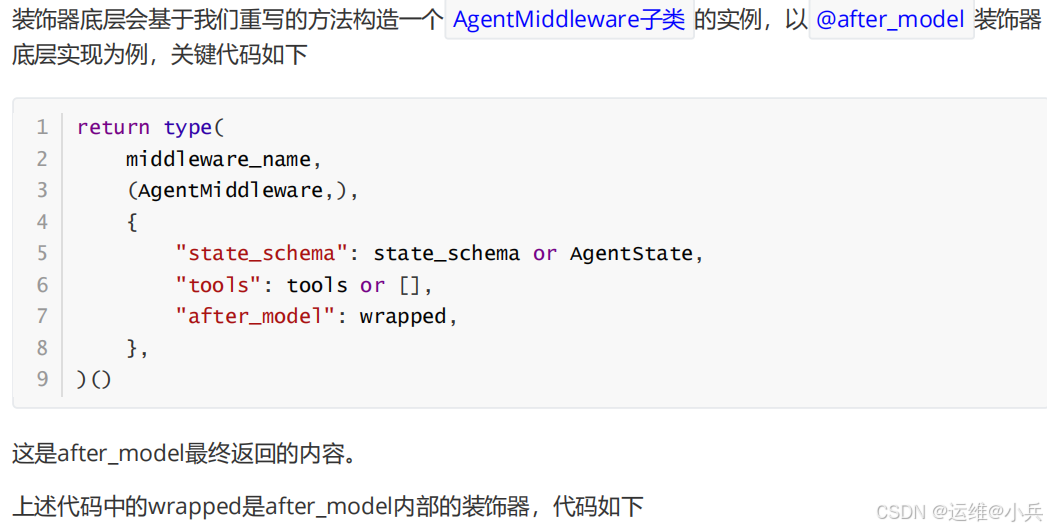
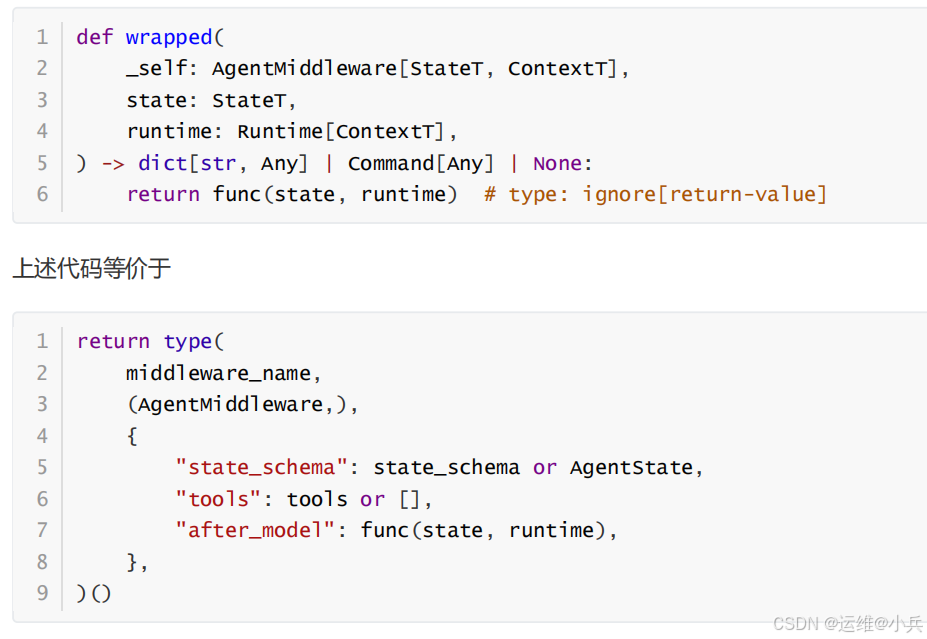
两种方法的统一
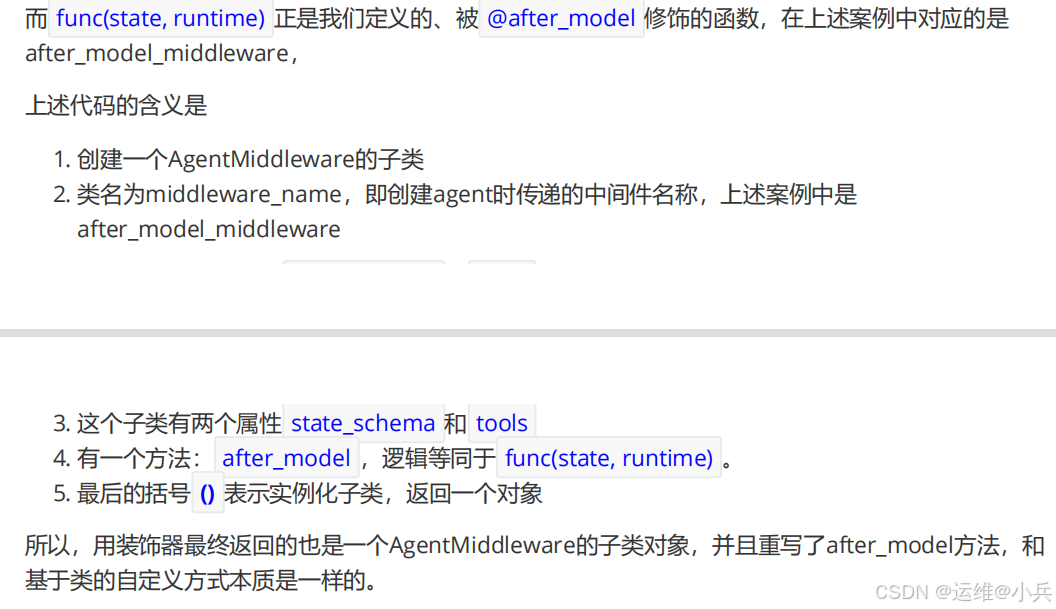
参数说明
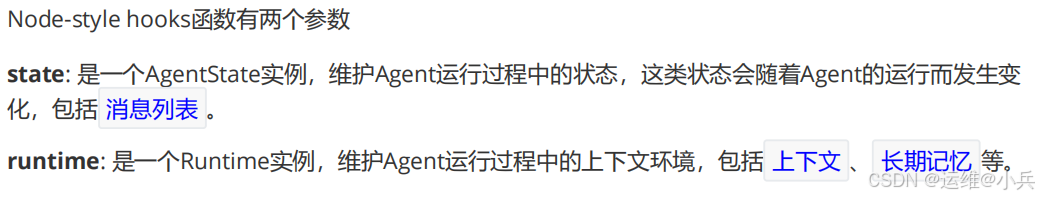
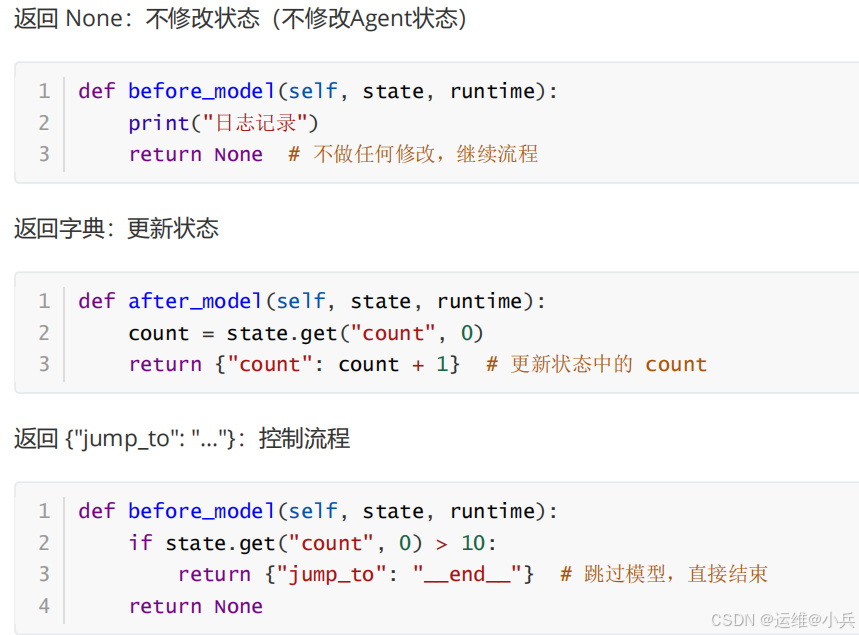
返回值说明
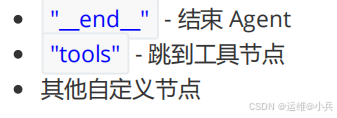
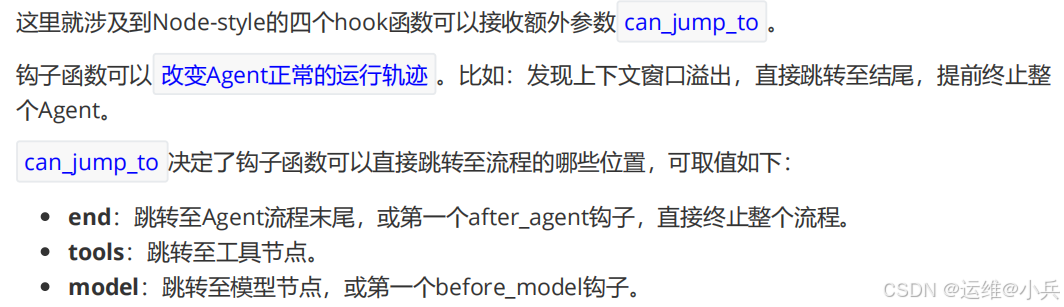
jump_to 目标:
装饰器参数:can_jump_to
基于装饰器实现
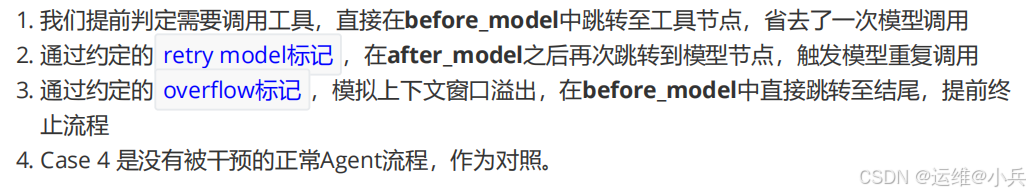
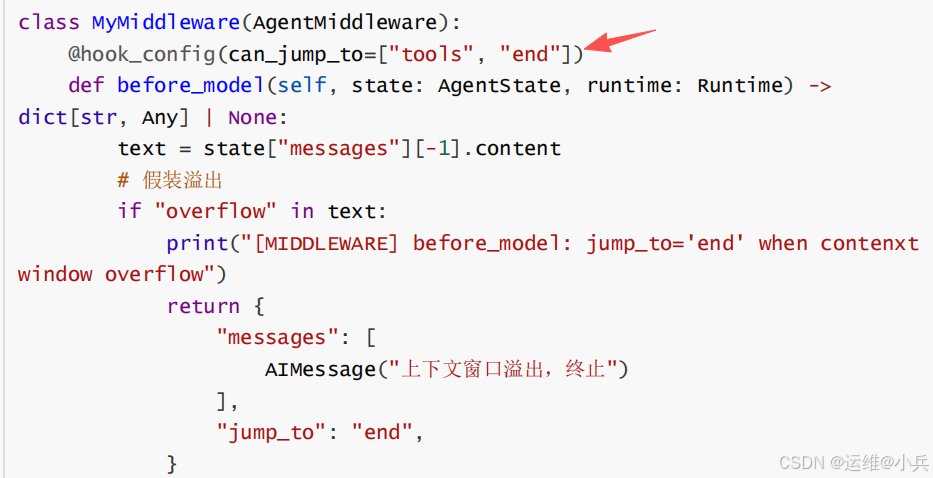
基于类实现
和基于装饰器实现的关键区别在于:需要引入额外的装饰器 @hook_config 为 can_jump_to 传参。
Wrap-style hooks函数用法
基本用法
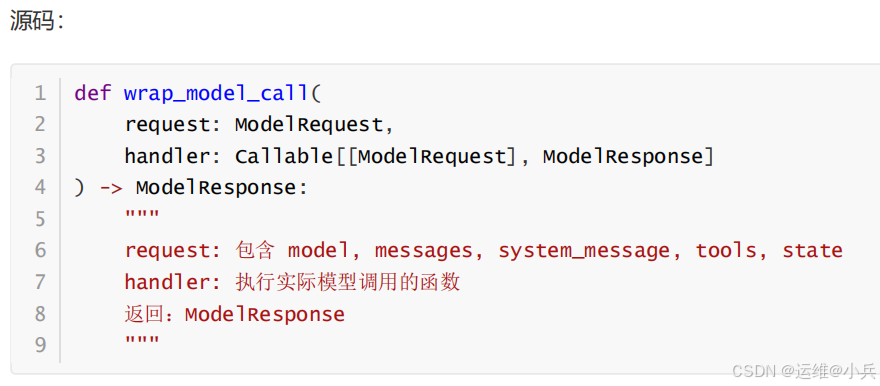
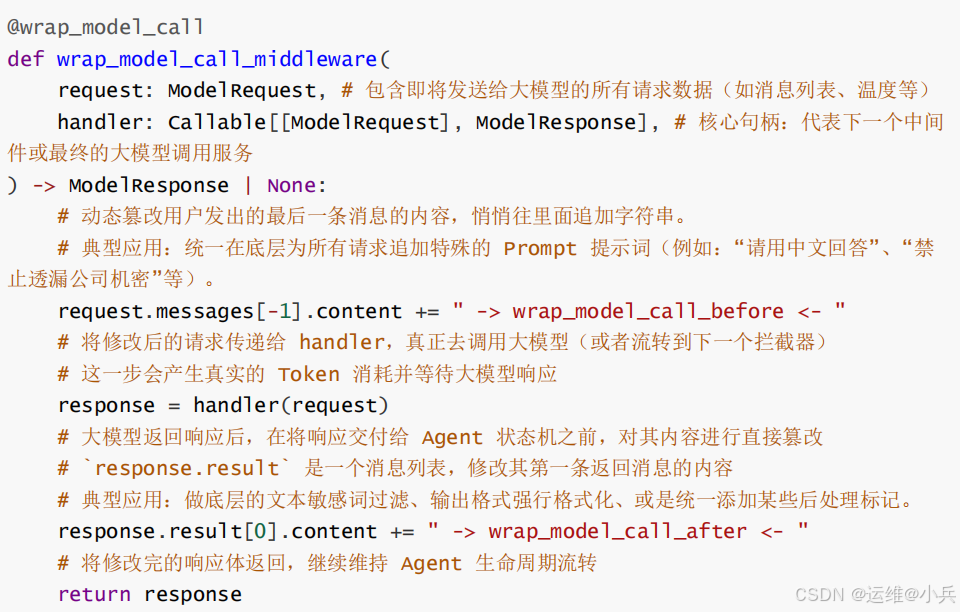
wrap_model_call
我们可以同时在模型调用前后做事,所以命名为 wrap_model_call ,wrap意为 包裹 。
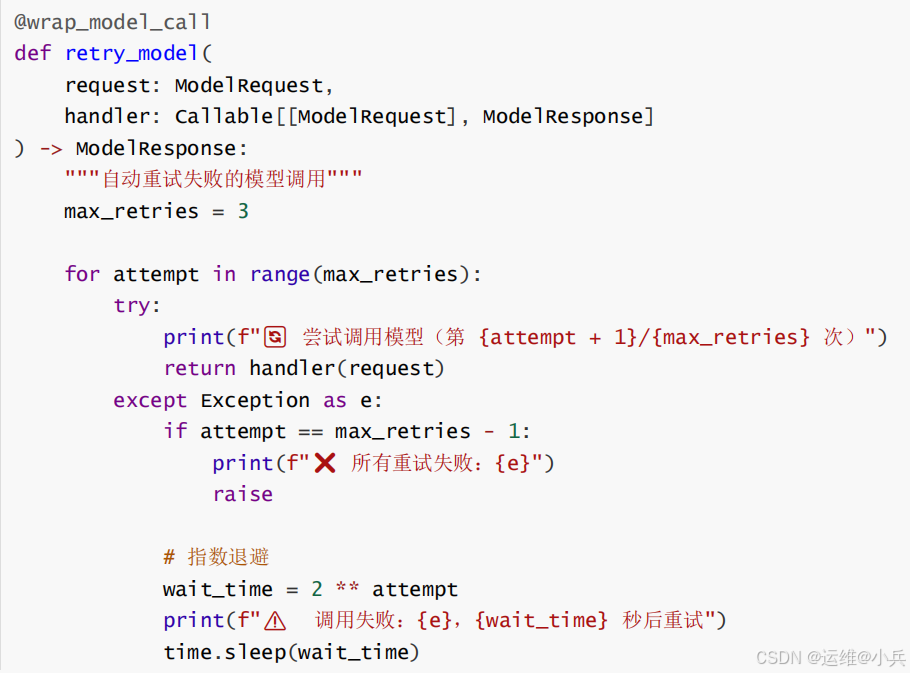
场景1:重试逻辑
wrap_tool_call
我们可以同时在工具调用前后做事,所以命名为 wrap_tool_call 。
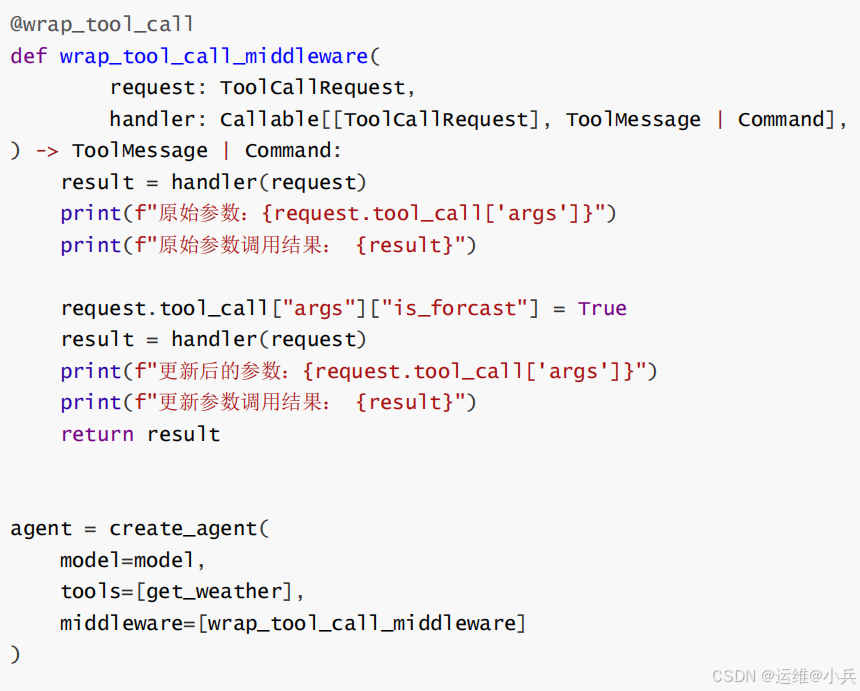
参数说明
装饰器和类的选择
情况1:中间件只用一个钩子函数,推荐用装饰器,需要多个钩子函数推荐类写法
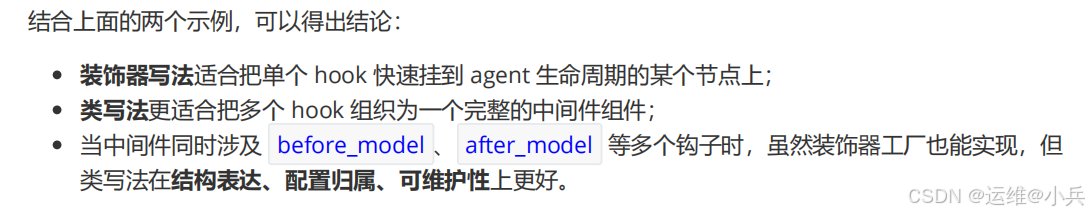
情况2:复杂配置推荐用类实现
装饰器当然也可以通过函数闭包传递参数,但在自省(运行时类型校验)、调试等方面天然不如类写法
方便。
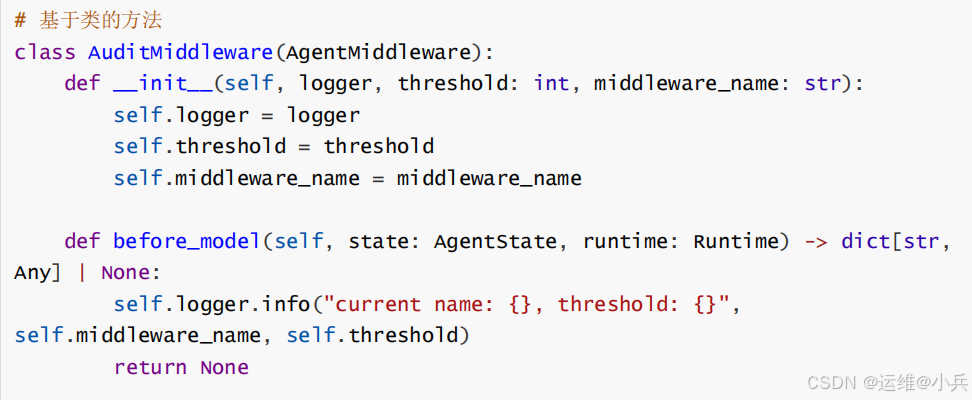
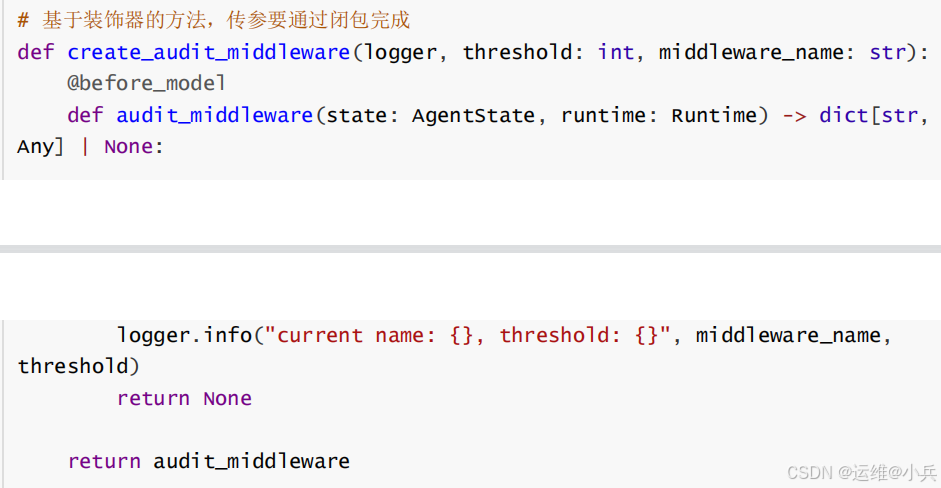
基于类的写法可以随时打印参数信息,而基于装饰器的闭包实现则难以做到。
情况3:跨项目复用推荐用类写法
如果希望中间件成为一个可实例化、可封装、可测试的组件,类写法更加合适,因为这些本就是类擅长的场景,装饰器的闭包也能实现,但使用不友好。
hook函数执行顺序(重要)