有一句被写进无数 Prompt 工程教程的常识:给模型几个示例(few-shot demonstrations),它会更懂你要什么;示例放多了反而会伤害效果,因为示例"扭曲"了模型的内部表征。前半句有人查过,后半句基本没人认真查过。
最近一篇横跨 12 个开源权重模型、两种架构的实验把后半句做了一遍,结论是:直觉是反的。 真正导致倒退的不是示例的内容,而是示例的长度------而长度这个变量,此前的同类研究几乎从未被单独测量过。
这篇的价值不在于"few-shot 有时没用"这个结论,而在于它给出的那个对照方法。这个方法可以搬到你任何一个"我加了 X,分数变高了"的实验上去。
一、现象:同一批模型,一个任务 +24pp,另一个只有 +3.4pp
论文《Few-Shot Degradation Is Not What It Seems》(arXiv:2609.15990,12 页 / 6 图 / 4 表,作者 Volodymyr Ovcharov,机构为乌克兰 LEX AI Platform / legal.org.ua)先做了一件很朴素的事:把 12 个开源权重模型放到两个任务上看行为。
| 任务 | 类型 | few-shot 相对 zero-shot 的变化 |
|---|---|---|
| 乌克兰语新闻分类 | 分类 | 平均 +24 个百分点 |
| 乌克兰语法律案件结果预测 | 分类 | 平均 +3.4 个百分点 ,其中 2 个模型倒退 |
同一批模型,同一套示例格式,一个涨 24 分、一个只涨 3.4 分还有两个掉下去。这说明 few-shot 不是一种通用增益,而是一种高度依赖"任务 × 模型组合"的东西。 这句话本身就值得写进你的上线 checklist------很多线上系统是把 few-shot 示例当作默认组件挂上的。
那么问题来了:为什么有的组合会退?
二、"失真假说":一个自洽但未经检验的解释
论文把那个流传最广的解释命名为 distortion hypothesis(失真假说):
示例会把模型的内部表征推离正确答案的方向;位移越大,伤害越大。
这个解释很顺手,也和表面现象自洽------实验中那些倒退的模型,确实表现出很大的表征位移。问题是:它是从相关性推出来的,从来没人做过因果分离。
而少了一位主角:prompt 长度。
三、被忽略的混淆变量:长度本身就在推动表征
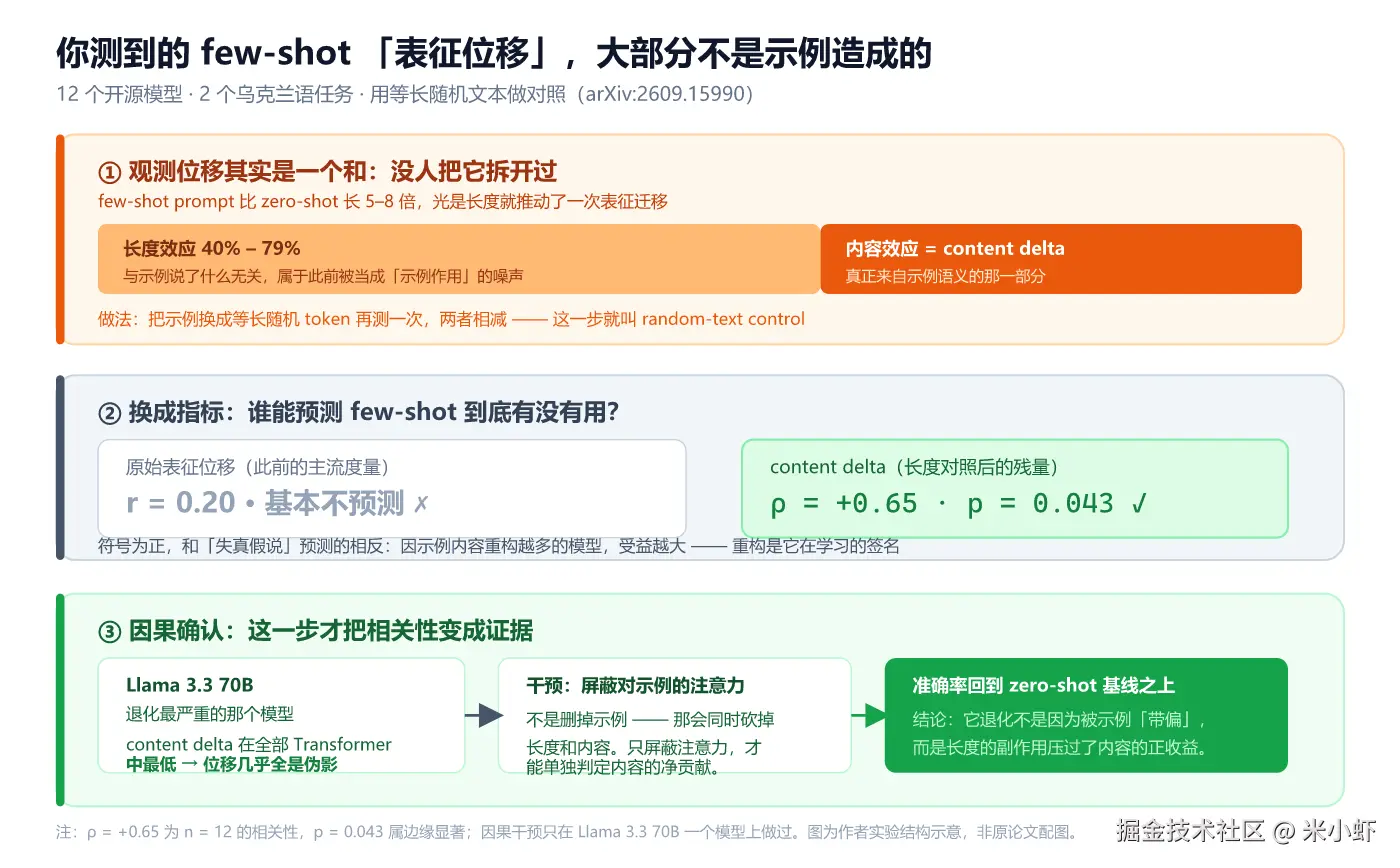
关键的一句数字在这里:在这份实验里,few-shot prompt 比 zero-shot prompt 长 5 到 8 倍。
而之前那些"测量 zero-shot 与 few-shot 之间隐藏状态位移"的研究,是把两者的差距整体当作"示例造成的影响"。但只要 prompt 变长了,哪怕里面塞的是毫无意义的东西,模型的隐藏状态也会移动------这是很朴素的序列处理行为,不涉及任何语义。
论文把这个混淆量化了:prompt 长度的差别,单独解释了观测位移的 40% 到 79%。
换句话说,你测到的"位移"里,可能有一大半跟示例说了什么完全无关。
markdown
    观测位移(此前的做法)
    ┌──────────────────────────────────────────────┐
    │  zero-shot 隐藏状态  ──►  few-shot 隐藏状态     │
    │          ╎                                    │
    │          └──► 总位移 = 长度效应 + 内容效应 ◄── 没人分开过 │
    └──────────────────────────────────────────────┘
                     │                    │
            40% -- 79% 来自长度    真正来自示例语义的部分
            (在此是一记噪声)     (这才是我们想知道的)
四、随机文本对照:content delta
分离方法出奇地简单,这也是它最容易被直接搬用的原因:
随机文本对照(random-text control) ------把 few-shot 里的示例原样替换成等长的随机 token,再测一次隐藏状态位移。这一次测到的就是"纯粹因为 prompt 变长"造成的位移。用原来的总位移减掉它,剩下的才归因给示例说了什么。
拆两段看。
第一层是纯机械的。 Transformer 的残差流是逐层累加的:token 越多,累加步数越多,最后一个位置的隐藏状态自然会被推得更远。注意力汇聚(attention sink)之类常态机制也绑在序列形态上------哪怕你喂进去的是一串乱码,只要长度一样,位置结构、注意力分母(softmax 归一化)、层数、经历的算子数量就完全一样。这些都会移动表征,且完全不需要语义参与。
第二层有意思得多。 长度代表着"模型被允许额外算多少步",而 prompt 里塞的东西又反过来决定了这些额外步被用在哪里。所以当你把示例换成等长随机文本时,你并没有消除计算量,你只是让这部分额外计算失去目标。两者的差,就是"有目标的额外计算"带来的那部分。
这就是为什么之前所有测"zero-shot → few-shot 位移"的工作都拿不到干净结论:它们测的那个量,天生是两个东西的和。
作者把这个残量命名为 content delta(内容增量)。
结果把整个图景翻了过来:
| 指标 | 与"few-shot 是否有帮助"的相关 |
|---|---|
| 原始表征位移(raw shift) | r = 0.20 ------ 基本不预测 |
| content delta | ρ = +0.65,p = 0.043 ------ 显著,且方向为正 |
注意那个符号。正的 ρ 意味着:因为示例内容而重构表征越多的模型,从 few-shot 里受益越多。
这与失真假说预测的符号完全相反。一句话点破:
有意义的重构是有效上下文学习的签名,而不是损伤的签名。
模型读到示例之后把内部空间重新排一遍,说明它真的在读;那些毫无反应的,才是没学到东西的。
五、最强的一处:把它从相关性升级成因果
真正让这篇值得读的是它做了一次干预,而不只是躺拿相关性。
退化最严重的那个模型是 Llama 3.3 70B。 它在全部受测 Transformer 里的 content delta 最低 ------也就是说,它表现出的巨大位移,几乎完全是长度伪影,而不是示例内容起作用了。
作者的干预是直接把这一模型对示例的注意力置零(masking demonstrations)。结果:
准确率回到了 zero-shot 基线之上。
这一步的意义:如果一个模型倒退是因为长度噪声,那把噪声源屏蔽掉,它就不该再倒退------它确实没有。三条证据(相关性、跨模型排序、注意力干预)指向同一个机制,这才算把故事讲圆了。
markdown
还没被证实的版本:  示例 ──► 表征被推歪 ──► 准确率下降
                                  ↑ 只靠相关性支撑

被实验支持的版本:  长度 ──► 表征整体漂移 ──┐
                   示例内容 ─► 有价值的重构 ─┴─► 净效果由两者之和决定
                                  ↑ 屏蔽示例注意力可反向验证
数据已在 HuggingFace 公开:overthelex/attention-analysis-fewshot。
六、这件事的工程含义
先说不该做的推论:别急着得出"few-shot 别用了"或者"示例越多越好"。这篇测的是 12 个开源模型在两个乌克兰语分类任务上的表现,这两个结论它都不支持。
它真正给你的是一个可搬的对照方法,以及下面这四条:
第一,把"内容"和"载体副作用"分开。 回想一下你手里那些已经被默认的组件:
| 你加的东西 | 它附带的、不被单独计量的副作用 |
|---|---|
| few-shot 示例 | prompt 长度 ×5--8、注意力分布变化 |
| 更长的 system prompt | 同上,还有指令在长上下文中的权重衰减 |
| RAG 的 top-k 增大 | 上下文变长 + 无关片段插入位置变化 |
| 输出格式约束 / JSON schema | 解码空间被压缩,可能同时改变内容判准 |
| 更详细的 rubric | 评判时长度歧视(verbosity bias) |
每一项里,"组件本身"和"它带来的形态变化"都是缠在一起的。你看到的增益,可能来自后者。
第二,三步就能做一次长度匹配对照。
成本极低------多跑一遍评测集而已。但如果你的结论要写进技术文档或者对外汇报,这一步能挡掉相当多误判。下面是一个最小骨架,核心就是把"生成 prompt 的那一步"抽出来做成可替换的:
python
def build_prompt(query, demos):
    """demos 是可插拔的:真示例 / 等长随机文本 / 空"""
    if not demos:
        return INSTRUCTION + query               # zero-shot
    return INSTRUCTION + render(demos) + query   # few-shot

# 关键动作:等长意味着逐条对齐 token 数,而不是随手塞一段话
real_demos = select_shots(train_set, k=8, query=query)
fake_demos = make_length_matched_noise(real_demos)          # 随机 token,长度 ±2
assert abs(len(tok(fake_demos)) - len(tok(real_demos))) <= 2   # 守住自变量

acc_zs   = eval_task(build_prompt(q, [])         for q in test_set)  # zero-shot
acc_fs   = eval_task(build_prompt(q, real_demos) for q in test_set)  # few-shot
acc_ctrl = eval_task(build_prompt(q, fake_demos) for q in test_set)  # 长度对照

observed = acc_fs   - acc_zs      # 你平时报出去的那个数字
artifact = acc_ctrl - acc_zs      # 纯粹由 prompt 变长贡献的部分
content = acc_fs - acc_ctrl # 真正来自"示例说了什么"的部分判定规则只有一句话:如果 content 接近 0 而 observed 是正的,你加的那个东西其实没起作用------起作用的是它带来的长度。 反过来,如果 content 明显为正而 observed 接近 0,说明真增益被长度副作用抵消掉了,这时候要动的是 prompt 的结构,而不是继续加示例。
这套骨架不限于 few-shot。把 demos 换成"更长的 system prompt"、"更多检索片段"、"更详细的输出格式说明",流程完全一样------凡是"往上下文里加东西"的改动,都能套。
第三,"扭曲"这个心智模型请先用一次对照再下结论。 模型内部表征发生大幅变化时,我们的默认归因常常是"被带偏了"。但在上下文学习这件事上,论文给的数据说,大幅重构是它在学习的证据。
第四,prompt 优化得按"模型 × 任务"粒度做。 论文的第一组数字(+24pp / +3.4pp)已经说明:同一批示例在不同任务上的收益可以差七倍,还可能有反例。把它当成一次性调好的全局配置,是在赌运气。
三条这篇不支持的误读
读二手解读时最容易踩的三个坑,这里显式排除掉:
| 误读 | 为什么这篇不支持 |
|---|---|
| "few-shot 没用,别加了" | 论文自己测出新闻任务平均 +24pp。它反对的是"无条件默认加",不是示例本身 |
| "给越大 / 越强的模型加示例越危险" | 退化最严重的 Llama 3.3 70B 恰恰是 content delta 最低的那个------它的位移几乎全是长度伪影,不是因为它更大所以更容易被扭曲 |
| "换个模型 / 换个任务都能套用这个结论" | 只有两个乌克兰语分类任务,且错位在模型与任务的组合上。跨模型可迁移的是方法,不是结论 |
为什么这件事在 Agent 时代尤其严重
2022 年我们写 prompt,长度是人手写在模板里的,可控。2026 年写 Agent,上下文是自动生成的:检索回来的记忆、工具结果的回填、历史轨迹的摘要、自动压缩之后残留的片段。这意味着三件事:
- 长度不再是自变量,而是因变量。 你加的每一个模块都在静默地改变上下文长度,而它通常不在你的实验记录里。
- "有效上下文"(effective context)远小于名义长度这件事已经被反复测过------上下文越长,模型能稳定取用的比例在下降。长度效应因此不是常数,它随绝对长度变化。
- 收益归因会越来越难。 当上下文由五个子系统拼装而成,任何一次提升都可能是"某处多塞了三千 token"造成的,而非语义改进。
也就是说,这篇论文给出的方法,本来作为一个技巧价值有限,但放在今天自动装配上下文的系统里,它会从"锦上添花"变成"唯一能把话说清楚的那一招"。
七、这份证据的边界(该泼的冷水)
按重要性排序:
- 因果证据只有一个模型。 注意力屏蔽(masking)只在 Llama 3.3 70B 上做了。ρ = +0.65 是 n = 12 的相关性,p = 0.043 属于边缘显著------这条结论需要更多模型和更多任务来加固,目前应视为"有力但不牢固"。
- 只有两个任务,且都是封闭形式。 乌克兰语新闻分类与法律案件结果预测,都是类别数有限的分类任务。没有覆盖生成任务,也没有覆盖需要多步推理的任务------恰恰是这两类最能体现 few-shot 的价值。不要外推。
- 单作者、单一语言。 独立研究者的个人工作,语料限于乌克兰语。这不降低方法的价值,但意味着结论的外延有限。
- 只看表示层,没看答案层。 content delta 是隐藏状态的度量;而生产环境里你拿到手的是输出 token 的 logprob 或者直接的自述置信度。作者没有建立两者之间的关系------这篇文章告诉你模型内部发生了什么,但没告诉你怎么在生产里观测到它。
- 没有给出 shot 数量的收益曲线。 论文测了"有示例 vs 无示例",没有系统扫描 2/4/8/16 shot。所以"示例多少合适"这个问题它没回答。
- 时间口径需要留意。 该文 arXiv 编号为 2609.15990,出现在 9 月 16 日 cs.CL 的新上列表,但正文标注的日期是 2026 年 5 月。我按"9 月中旬进入推荐范围、初稿写于 5 月"处理,如果你要引用,建议注明这个时差。
八、我的判断
这篇的方法比它的结论值钱。
"加了示例之后准确率涨了"和"加了二十轮自我迭代之后能力强了",是同一类命题:它们都有一个和主效应缠在一起的副效应(prompt 长度 / 算力预算),而这个副效应从来不会被单独计量。今天同一批 arXiv 上那几份递归自我改进(RSI)的工作遇到的正是同一个问题------路线图论文把"机制留存"和"增益可归因"写成判定式,本质上就是在要求一个等价于 random-text control 的对照组。
所以我的建议是这样两句:
- 别急着接受任何"人物变了是因为 X"的单观测叙述,先问它的对照组是什么。
- 你自己的实验里,凡是"加东西"的改动,都可以加一步长度/预算匹配的对照。 成本是一遍评测,收益是你不再被伪信号牵着走。
三个可以立刻自问的问题:
- 我系统里那些默认加上的 few-shot 示例,最后一次验证是在哪个模型、哪个任务上做的?
- 如果把这些示例换成等长随机文本,我的指标还剩多少收益?
- 我最近一次汇报的"提升",有没有一个变量是跟着主改动一起变的,而我没单独测过它?
数据来源说明与免责:
- 本文基于 arXiv:2609.15990《Few-Shot Degradation Is Not What It Seems: Behavioral Evidence, Representation Analysis, and a Random-Text Control Across 12 Models, 2 Tasks, and 2 Architectures》,作者 Volodymyr Ovcharov(乌克兰 LEX AI Platform / legal.org.ua,基辅)。数据集:huggingface.co/datasets/overthelex/attention-analysis-fewshot。
- 文中所有数字(12 个开源权重模型、两种架构、+24pp / +3.4pp、两个模型倒退、5--8 倍长度差、40%--79% 长度解释率、r = 0.20、ρ = +0.65 / p = 0.043、Llama 3.3 70B 的 content delta 最低、注意力屏蔽后回到 zero-shot 之上)均与该文摘要与正文公开内容一致。
- 该文为单作者预印本,未经同行评议;任务限于乌克兰语的两个分类任务。第七节列出的六条边界请一并阅读,不要单独引用结论。
- 标注日期存在 5 月 / 9 月两处口径,详见正文第 7 条第 6 点。