三个人一起改一份方案。
小林写下一段说明,小周删掉其中一句。过了一会儿,刚恢复网络的小陈把本地文档同步到服务器。版本历史里,那句话确实没了。
问题是:这次删除,该记在谁名下?
写下它的人、按下删除键的人、最后把更新传到服务器的人,可能是三个不同的人。只看最终文档,或者把"谁的连接触发了更新"当成"谁删的",都会出错。
这是协同编辑里一个常被低估的地方:让大家看到同一份文档,和准确记录每个人做过什么,是两件事。
下面这套方案来自开源仓库 yjs-v13-deletion-attribution。它的思路是:删除发生时先存证据,生成版本时再把证据对回文档。我也会说清楚,它为什么还不能直接当成审计系统。
先说清范围:我核对的是仓库提交 4bb8b3e。项目声明依赖 yjs: ^13.6.29,锁文件实际固定在 13.6.32。所以"Yjs 14 之前"在这里指的是这套基于 v13 内部结构的实现------它没有验证过所有早期版本,也不对 v14 作任何推断。
一、Yjs 记得"哪一段消失了",但不记得"谁删的"
Yjs 是协作文档背后的同步引擎。它要处理的事不少:多人同时改、更新乱序到达、同一份更新收到两次,最后还要让每个人的屏幕保持一致。
为此,文档里的内容都带着身份。最关键的两个字段是 clientID 和 clock。
clientID 指向这段内容由哪个客户端创建------注意,它不是业务系统里的用户账号。clock 是这个客户端内部递增的编号,也不是真实时间。两个合起来,才能锁定某一段具体内容。
比如下面这条删除范围,读作:"客户端 10 创建的、编号 4 到 7 之前的那段内容,被删了。"
plaintext
client: 10
范围: [4, 7)
[4, 7) 包含 4、5、6,不含 7。它只是方便理解的编号示例,不是你文档里的第 4 到第 7 个字。
Yjs 的 DeleteSet(删除集合)存的正是这类范围。**它告诉你删除落在谁创建的内容上,却不告诉你是谁动的手。**就算你另外维护了"客户端到用户"的映射,也不能顺理成章地把内容创建者当成删除者。
删完之后,内部可能还留着"这块被删过"的结构,俗称墓碑。墓碑是给同步和结构维护用的,不是一张自带签名的删除凭证;原文也可能在垃圾回收里被清掉。
所以这篇文章说的"删除归属",准确讲是删除这个动作归谁 ,不是被删内容的原作者归谁。记录里用的字段叫 author,你把它理解成"这次删除记在谁头上"就对了。
二、关键一步:身份当场记,位置以后再算
只在删除时记下"某人在第 20 个字处删了一刀"是不够的。别人稍后在前面加一段,那个第 20 字的位置就变了。
位置会动,内容的内部身份不动。所以这套实现把活拆成两步。
**第一步,服务器收到更新时:**从这次更新里取出它声明要删的范围,和这次事务真正新产生的删除范围对一遍。对得上,就把范围和认证过的用户身份一起存下来。
**第二步,生成版本快照时:**拿存下来的范围,回到文档里找到对应的删除墓碑,再算出它在这个版本里的位置。
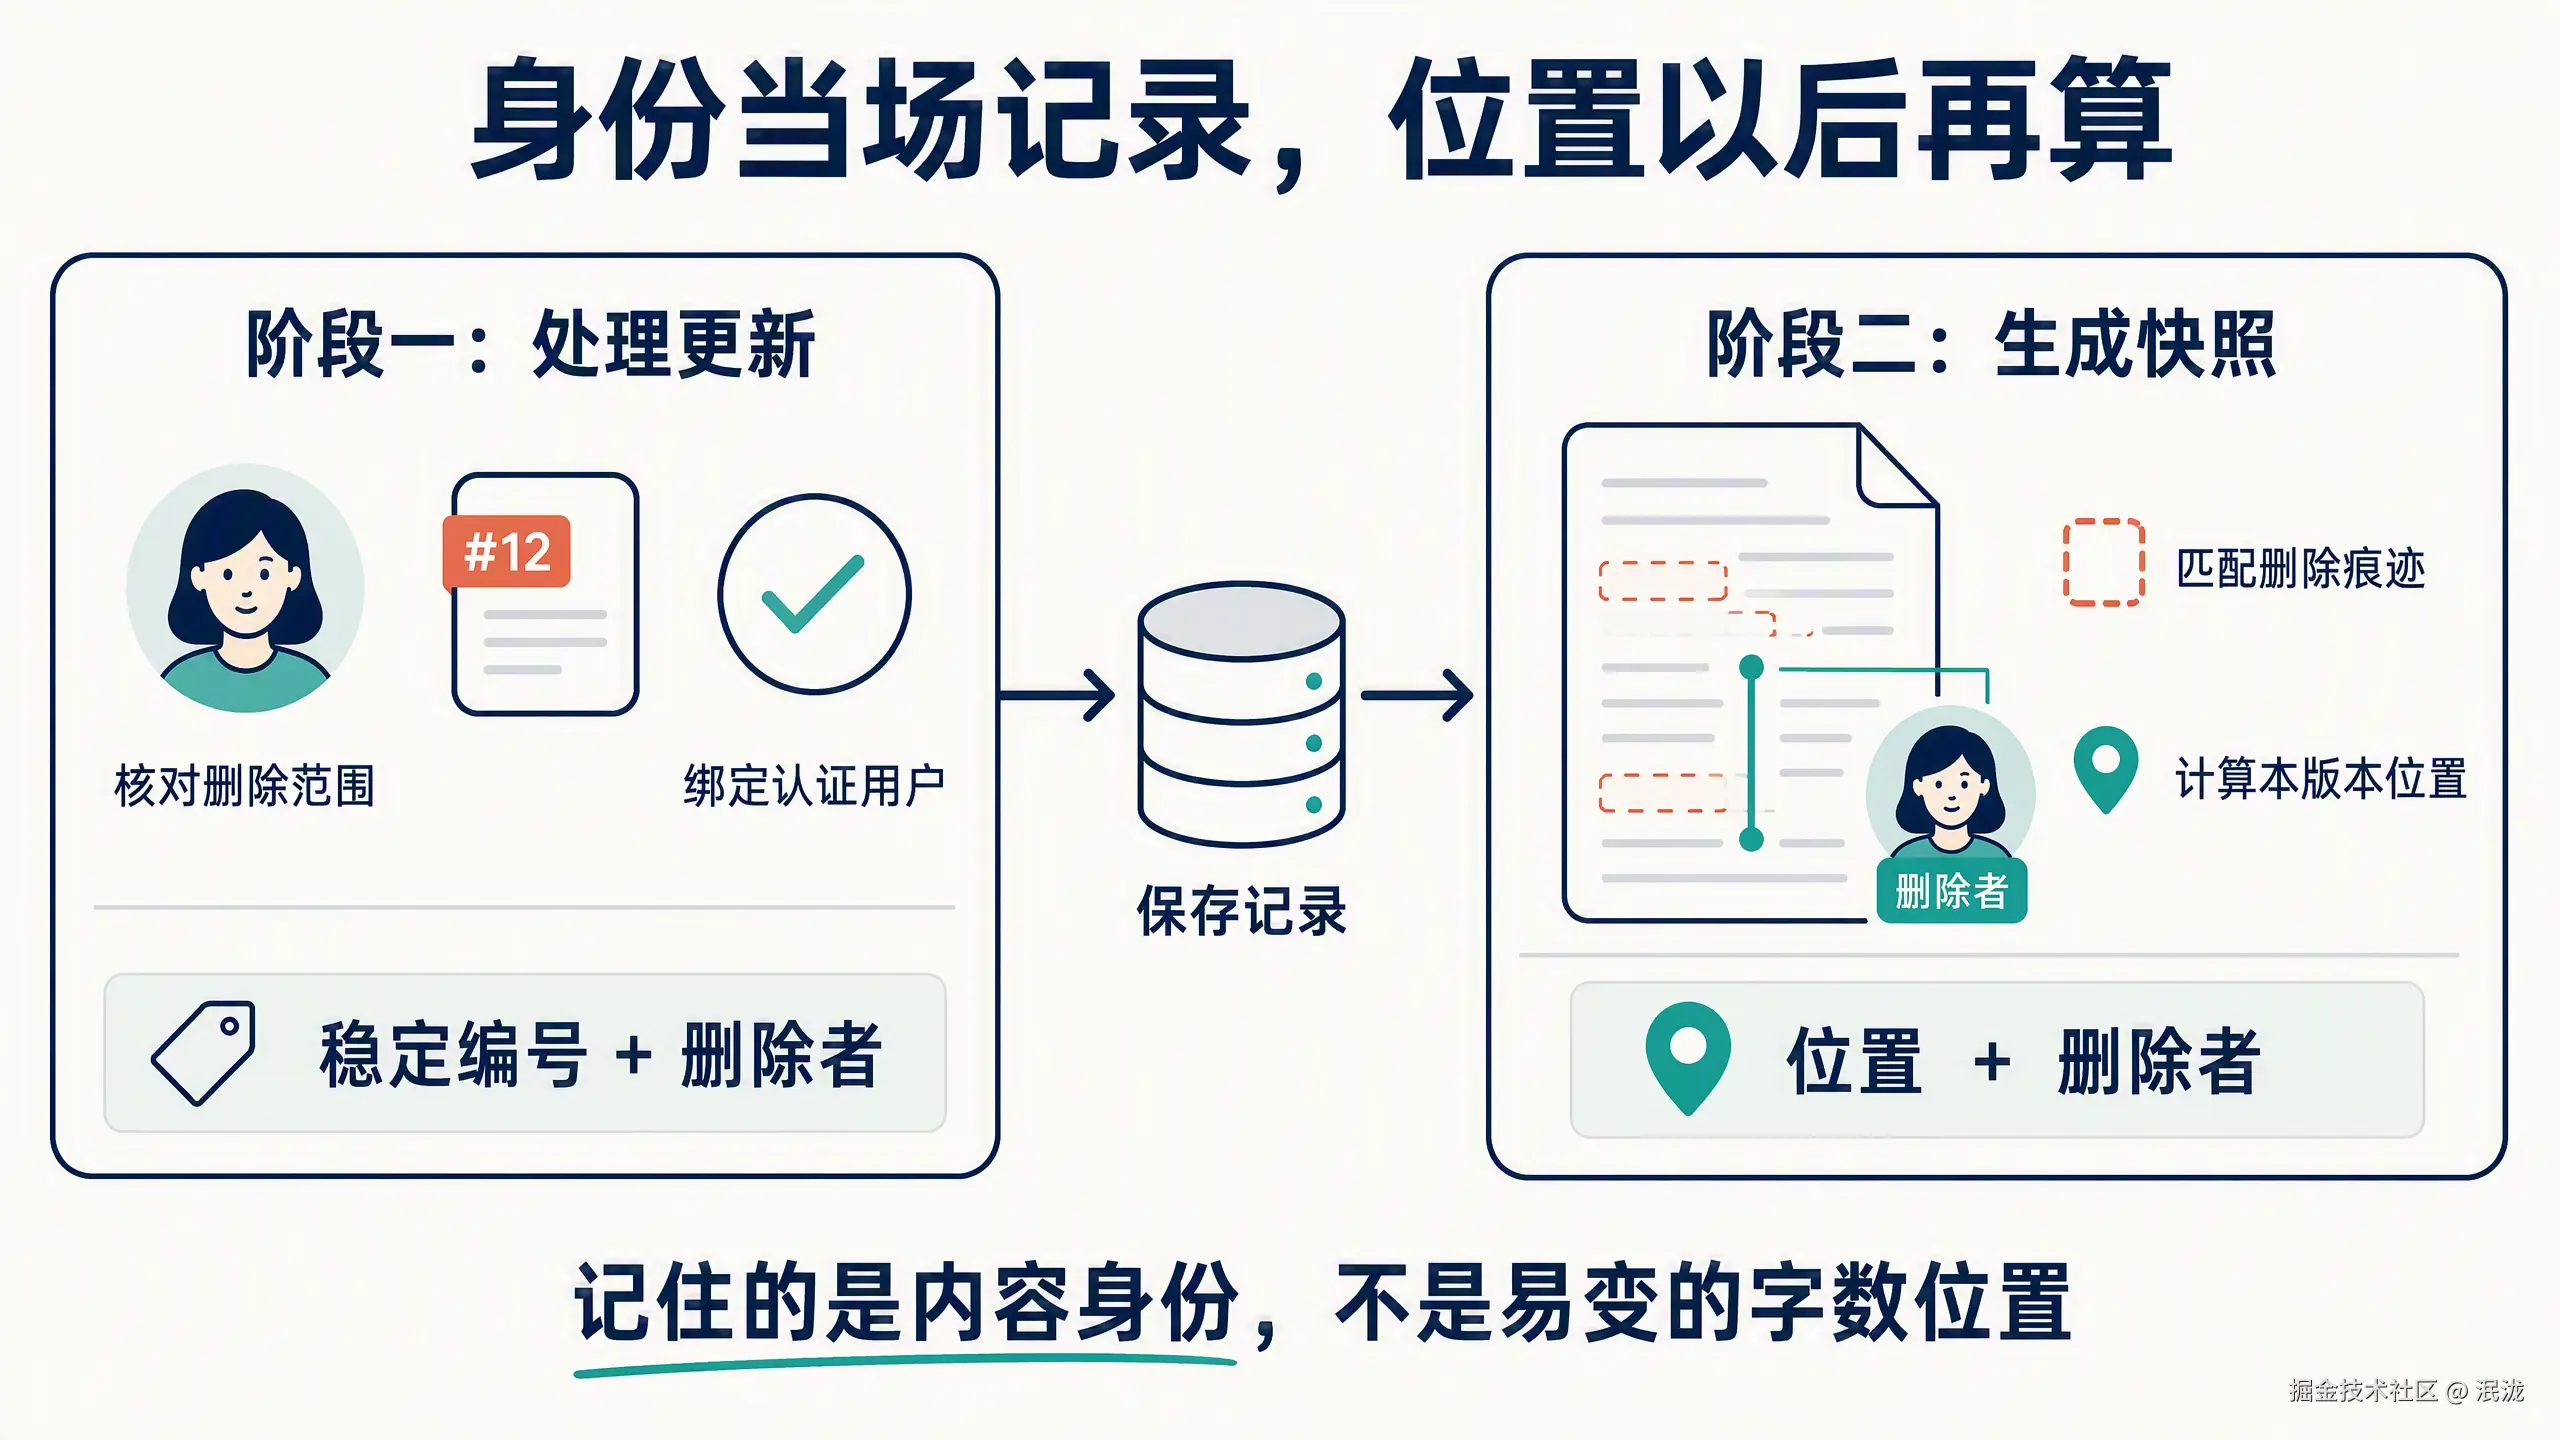
图 1:先保存通过检查的删除证据,再计算它在对应版本中的位置。
第一步存下来的是这样一条记录:
typescript
{
  client: 10,
  from: 4,
  to: 7,
  author: 'bob'
}
它的意思不是"Bob 删了第 4 到第 7 个字",而是"这段用内部编号标记的删除范围,算在 Bob 头上"。
整套算法只做两件事:捕获 和定位------捕获在更新到达时完成,定位在生成快照时进行,中间只靠一份存储记录衔接。骨架大致是这样:
typescript
// 阶段一:更新到达时,先存证据
capture(update, user):
    claimed = 从 update 解析出它声明的删除范围
    actual  = 本事务实际新产生的删除范围
    valid   = claimed ∩ actual
    if valid 为空 or 未通过来源检查:
        return 空
    保存 { client, ranges: valid, author: user }

// 阶段二:生成快照时,再把证据对回文档
attribute(document, stored):
    marks = []
    for { ranges, author } in stored:
        for range in ranges:
            pos = 在 document 里定位 range 对应的删除痕迹
            if pos 存在:
                marks.add({ at: pos, author })
    return 去重(marks)
有点像寄存行李:当场记下行李编号和经手人,以后再回来问它放在哪。不能只记一个货架位置------架子随时会挪。
但真正难的不是存这四个字段,而是:凭什么断定这段删除该算在眼前这个人头上?
三、不是"谁传过来,就算谁删的"
先排除一个常见误判:历史同步不是现场操作
协同编辑里有类消息叫 SyncStep2,作用是补齐对方缺的那部分文档状态。它可能带着别人之前做过的删除。
开头例子里,小陈恢复网络后传来的历史状态,不代表那些旧删除都是小陈干的。
所以这套实现对 SyncStep2 直接返回空声明,只从 SYNC_UPDATE 消息里取出可核对的删除范围。
但这里有个限制要记住:**消息类型只是过滤器,不是作者证明。**如果业务允许客户端把别人的历史更新重新打包成 SYNC_UPDATE 上传,算法没有本事凭空认出原始操作者。
也就是说,这套方案能成立,前提是宿主系统的身份认证和更新来源是可信的。它适合可信协作链路里的归属计算,但别指望靠一个消息类型,就升级成能对抗恶意伪造的审计系统。
再对一遍:声明删了,不等于这次真删了
这套做法每次拿两个集合来比。
一个是这条消息声称要删的范围 ,一个是这次事务实际新产生的删除。只有两边都有的部分,才进入归属记录。一句话讲:
候选归属范围=本帧声明的删除范围∩本事务实际生效的删除范围
举个例子。同一个客户端编号下,消息声明删除 [4, 9),而服务器这次实际新增的删除只有 [6, 10)。两者重叠的是 [6, 9)------也只有这一段能进候选。
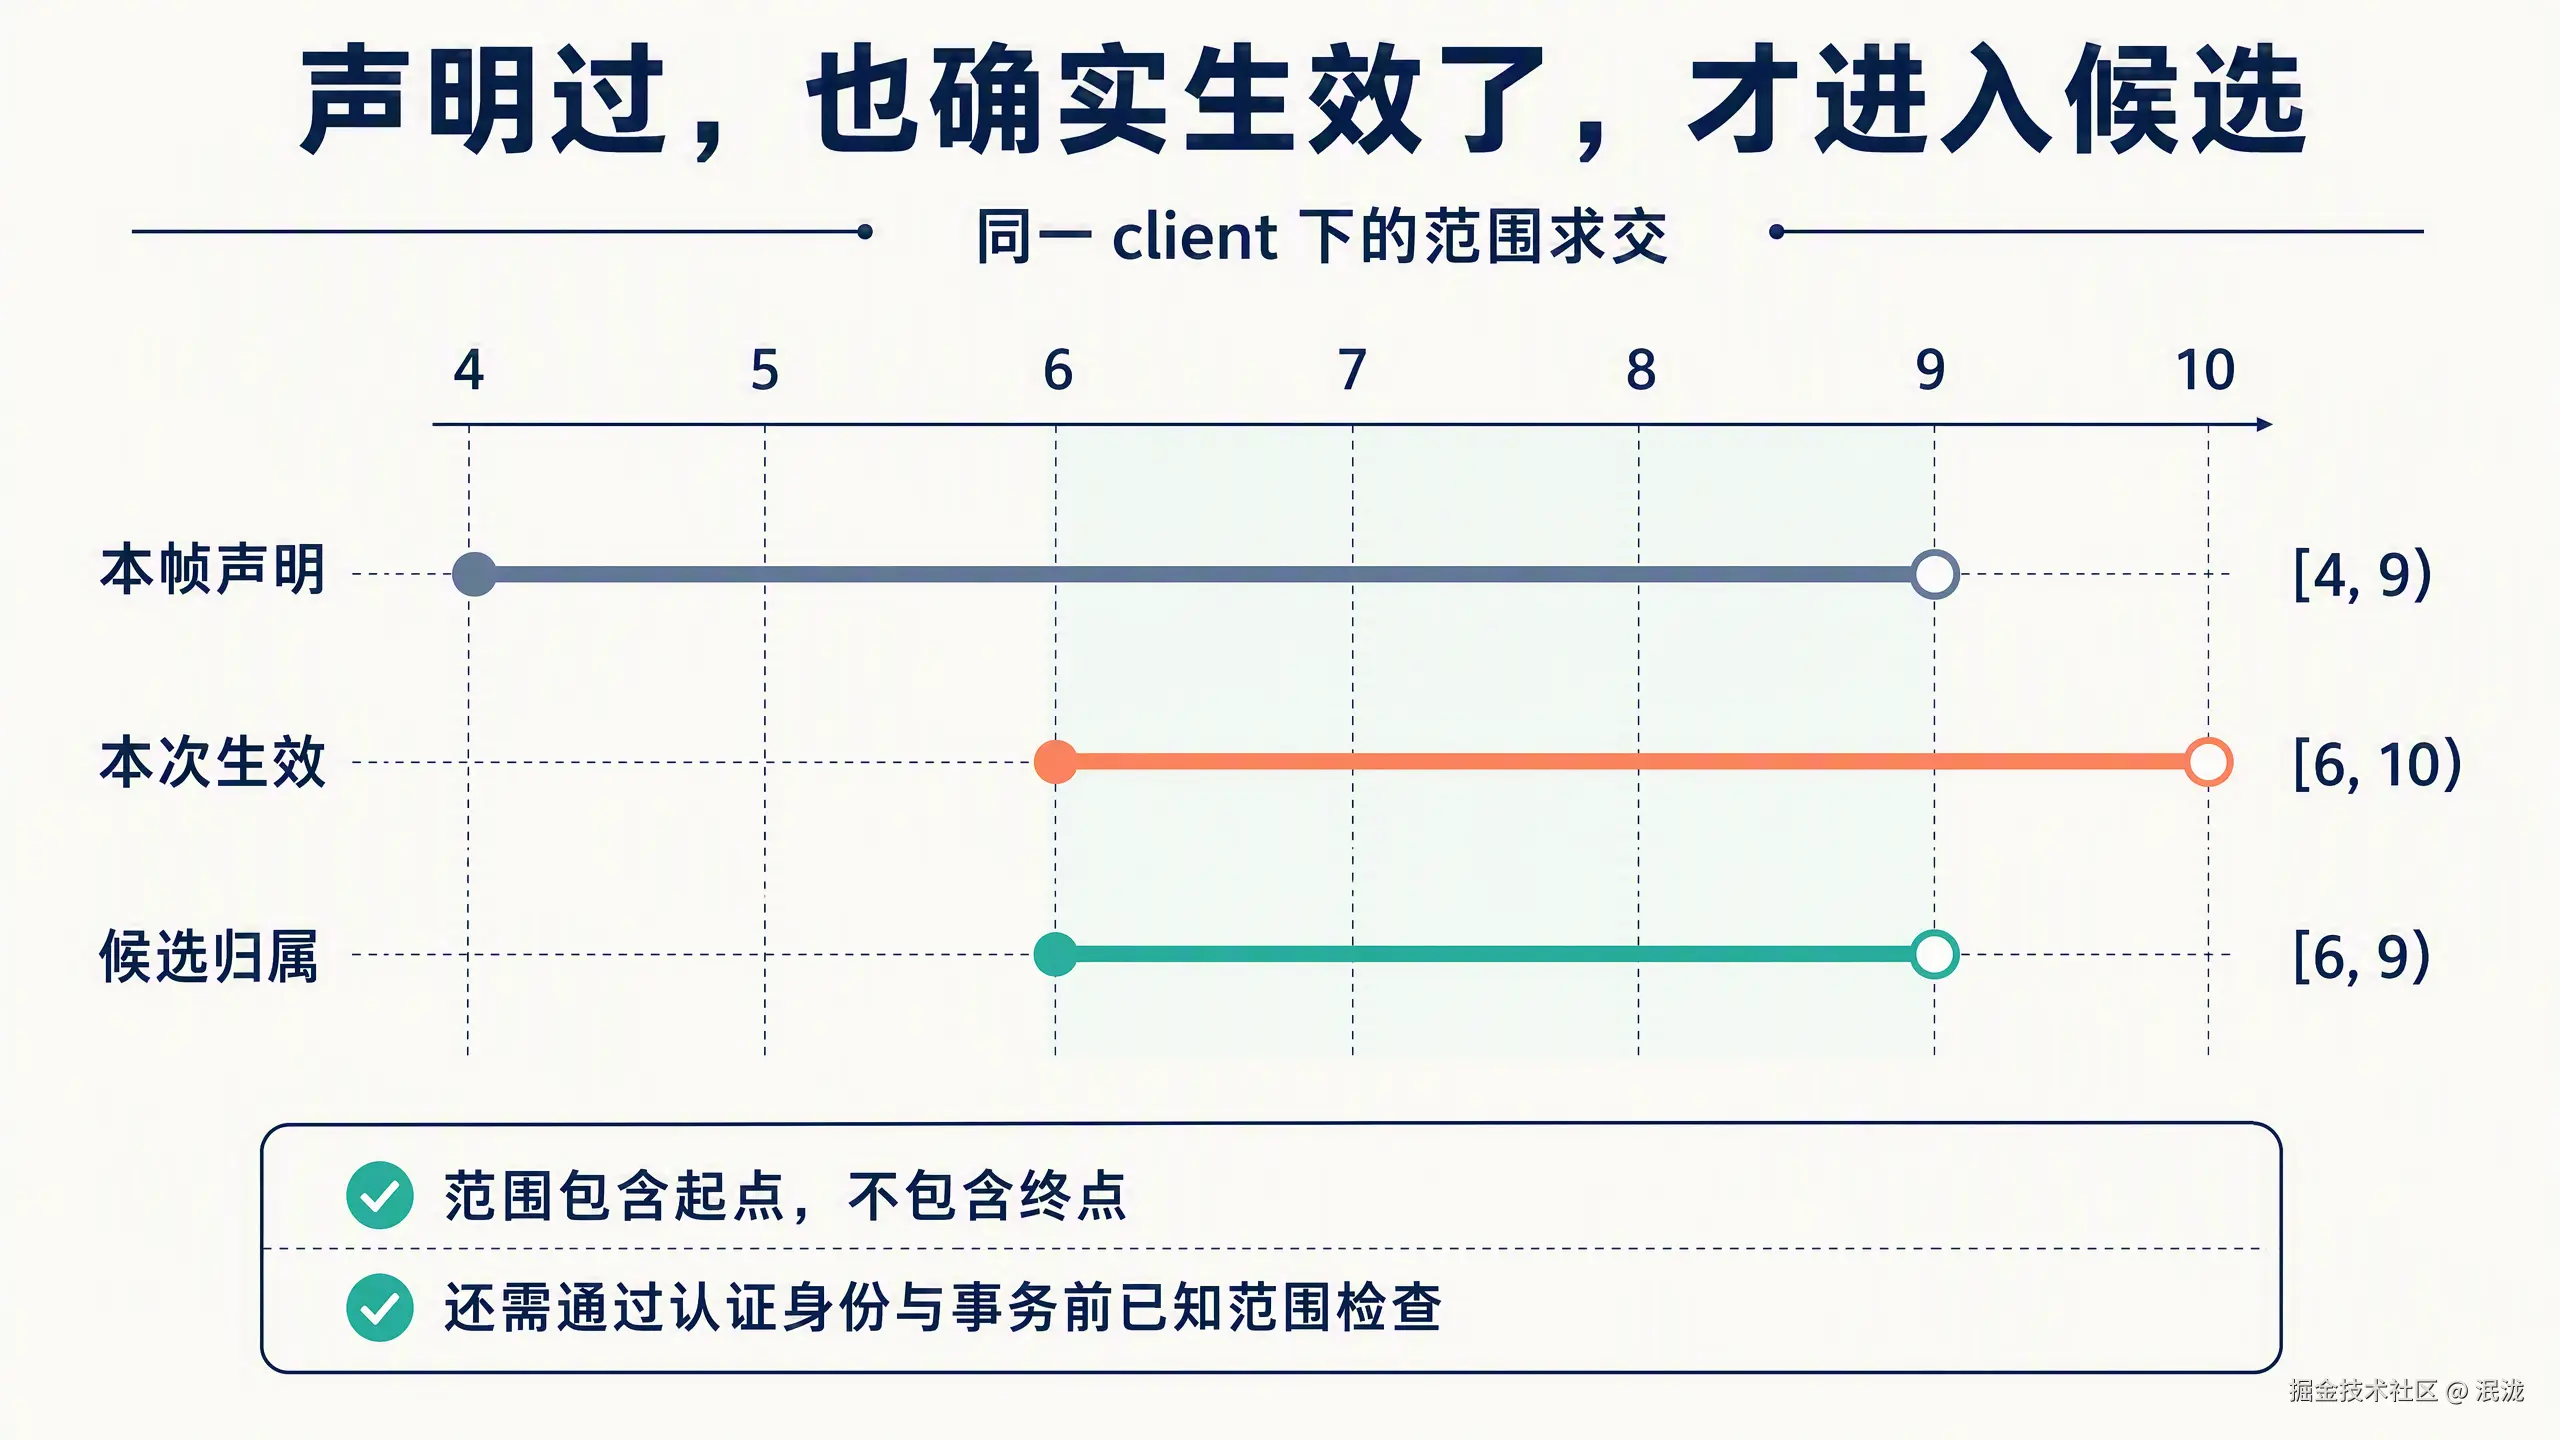
图 2:交集只是候选结果;身份认证和事务前已知范围检查仍不可省略。
求交的逻辑很直接:先看 client 是否相同,起点取大的、终点取小的,起点小于终点才留下。
typescript
intersect(a, b):
    if a.client != b.client:
        return 空
    from = max(a.from, b.from)
    to   = min(a.to, b.to)
    return { client: a.client, from, to } if from < to else 空
这一步同时挡住两种麻烦。
一种是重复删除。Bob 和 Carol 都删了同一段,如果 Bob 的更新先在这个服务端生效,Carol 的更新到时可能根本没产生新的删除。这时就不能凭 Carol 的声明,把同一段再记给 Carol。
这也带出一个重要边界:**这套方案记的是这个副本上实际生效的删除贡献,不是所有用户按过删除键的完整流水。**它没法证明现实中谁先动手,也不保证不同副本各自算出来的归属天然一致。想要统一结果,就得设一个明确的服务端归属入口,并把结果存下来。
另一种是延迟生效的删除。某次删除先到,可它要删的内容还没到,Yjs 会先把这次删除挂起,等目标内容到了再处理。于是一个由某人触发的事务里,可能混进了别人早先留下的删除。
取交集,能把不在本次声明里的那部分筛掉,避免把"刚好让删除生效的人"当成"发起删除的人"。这也是为什么光看 transaction.origin 不够:它能帮你对上事务来源,却没法替事务里所有删除作证。
最后一道门:目标内容必须"事先就在"
这套实现还有一道保守检查:被删的内容,在这次事务开始前,服务器是不是已经知道它?
它看的是 beforeState,也就是事务开始前各客户端已知的下一个 clock。假设某个客户端的值是 20,那 [4, 7) 完全落在已知范围内;而 [18, 22) 越过了边界,就有一部分不能被认定"事先已知"。
为什么非要这道门?
因为离线用户可能先写一段话、又把它删掉,最后才把整个状态同步上来。服务器一下子同时看到"内容到达"和"内容已删",很难分清这是当前用户刚做的,还是转手来的历史。
它的选择是:宁可漏记,也不误记。
而且它比"只把越界的那一小段滤掉"更狠:**只要本次实际删除里有一段越过了事务前的已知边界,整笔事务都不出归属记录。**它不会把安全的部分裁下来留着。
代价就是,一笔事务里本来能记的删除,也可能被整体跳过。这是准确度和覆盖率之间的取舍。产品说明里最好写清楚,别把"没有记录"直接当成"没发生删除"。
四、字没了,名字该标在哪?
捕获做完,还有个展示问题:删掉的内容已经不占位置了,界面往哪儿画标记?
这套实现选的是零宽锚点,也就是一个不占宽度的小点位。
比如原文 hello,Bob 删掉中间的 el,剩 hlo。标记就落在 h 和 l 之间,提示"这里发生过一次删除"。它不是硬把已经不存在的两个字符,画成现在还占着的一段区间。
输出长这样:
typescript
{ at: 2, author: 'bob' }at: 2 用的是这套实现里编辑器的结构坐标,不是你肉眼数的"第二个字"。在这套实现的段落结构里,进入段落算一个位置、走过 h 再算一个,所以锚点落在 2。
这个位置是怎么走出来的?
定位的做法是:从指定的 XmlFragment 出发,沿着内部链表往前走。
typescript
locate(document, range):
    pos = 0
    for node in walk(document):              // 沿内部链表前进
        if node 是已删除内容:
            if node.clientID 与 clock 范围 命中 range:
                marks.add({ at: pos, author })   // 留下标记,位置不前进
        else if node 是叶子:
            pos += 1                             // 图片等叶子各占一位
        else if node 是普通非叶子元素:
            pos += 1                             // 进入
            ...                                  // 递归子树
            pos += 1                             // 离开
        else:
            pos += node 的可见长度               // 活着的文本
    return marks
遇到还在的文本,位置往前走;进入和离开一个普通的非叶子元素,各往前走一位;遇到 isLeaf 判定的叶子节点,按一位算。比如你的编辑器把图片当叶子,就得把这条规则告诉算法。
遇到已删除的内容,位置不动,而是去比对墓碑的 clientID 和 clock 范围,看是不是和外部记录重叠。对上了,就在当前位置留一个作者标记。
这也解释了为什么不能拿一份普通文本来算:段落、图片、嵌套节点各有各的坐标规则。isLeaf 必须和你编辑器的 schema 对齐------但对齐了,也还不等于所有复杂富文本场景都算对。
同一个位置冒出两个作者,并不矛盾
假设原文 abcdef。Bob 删 cd,Carol 接着删 ef,最后只剩 ab。
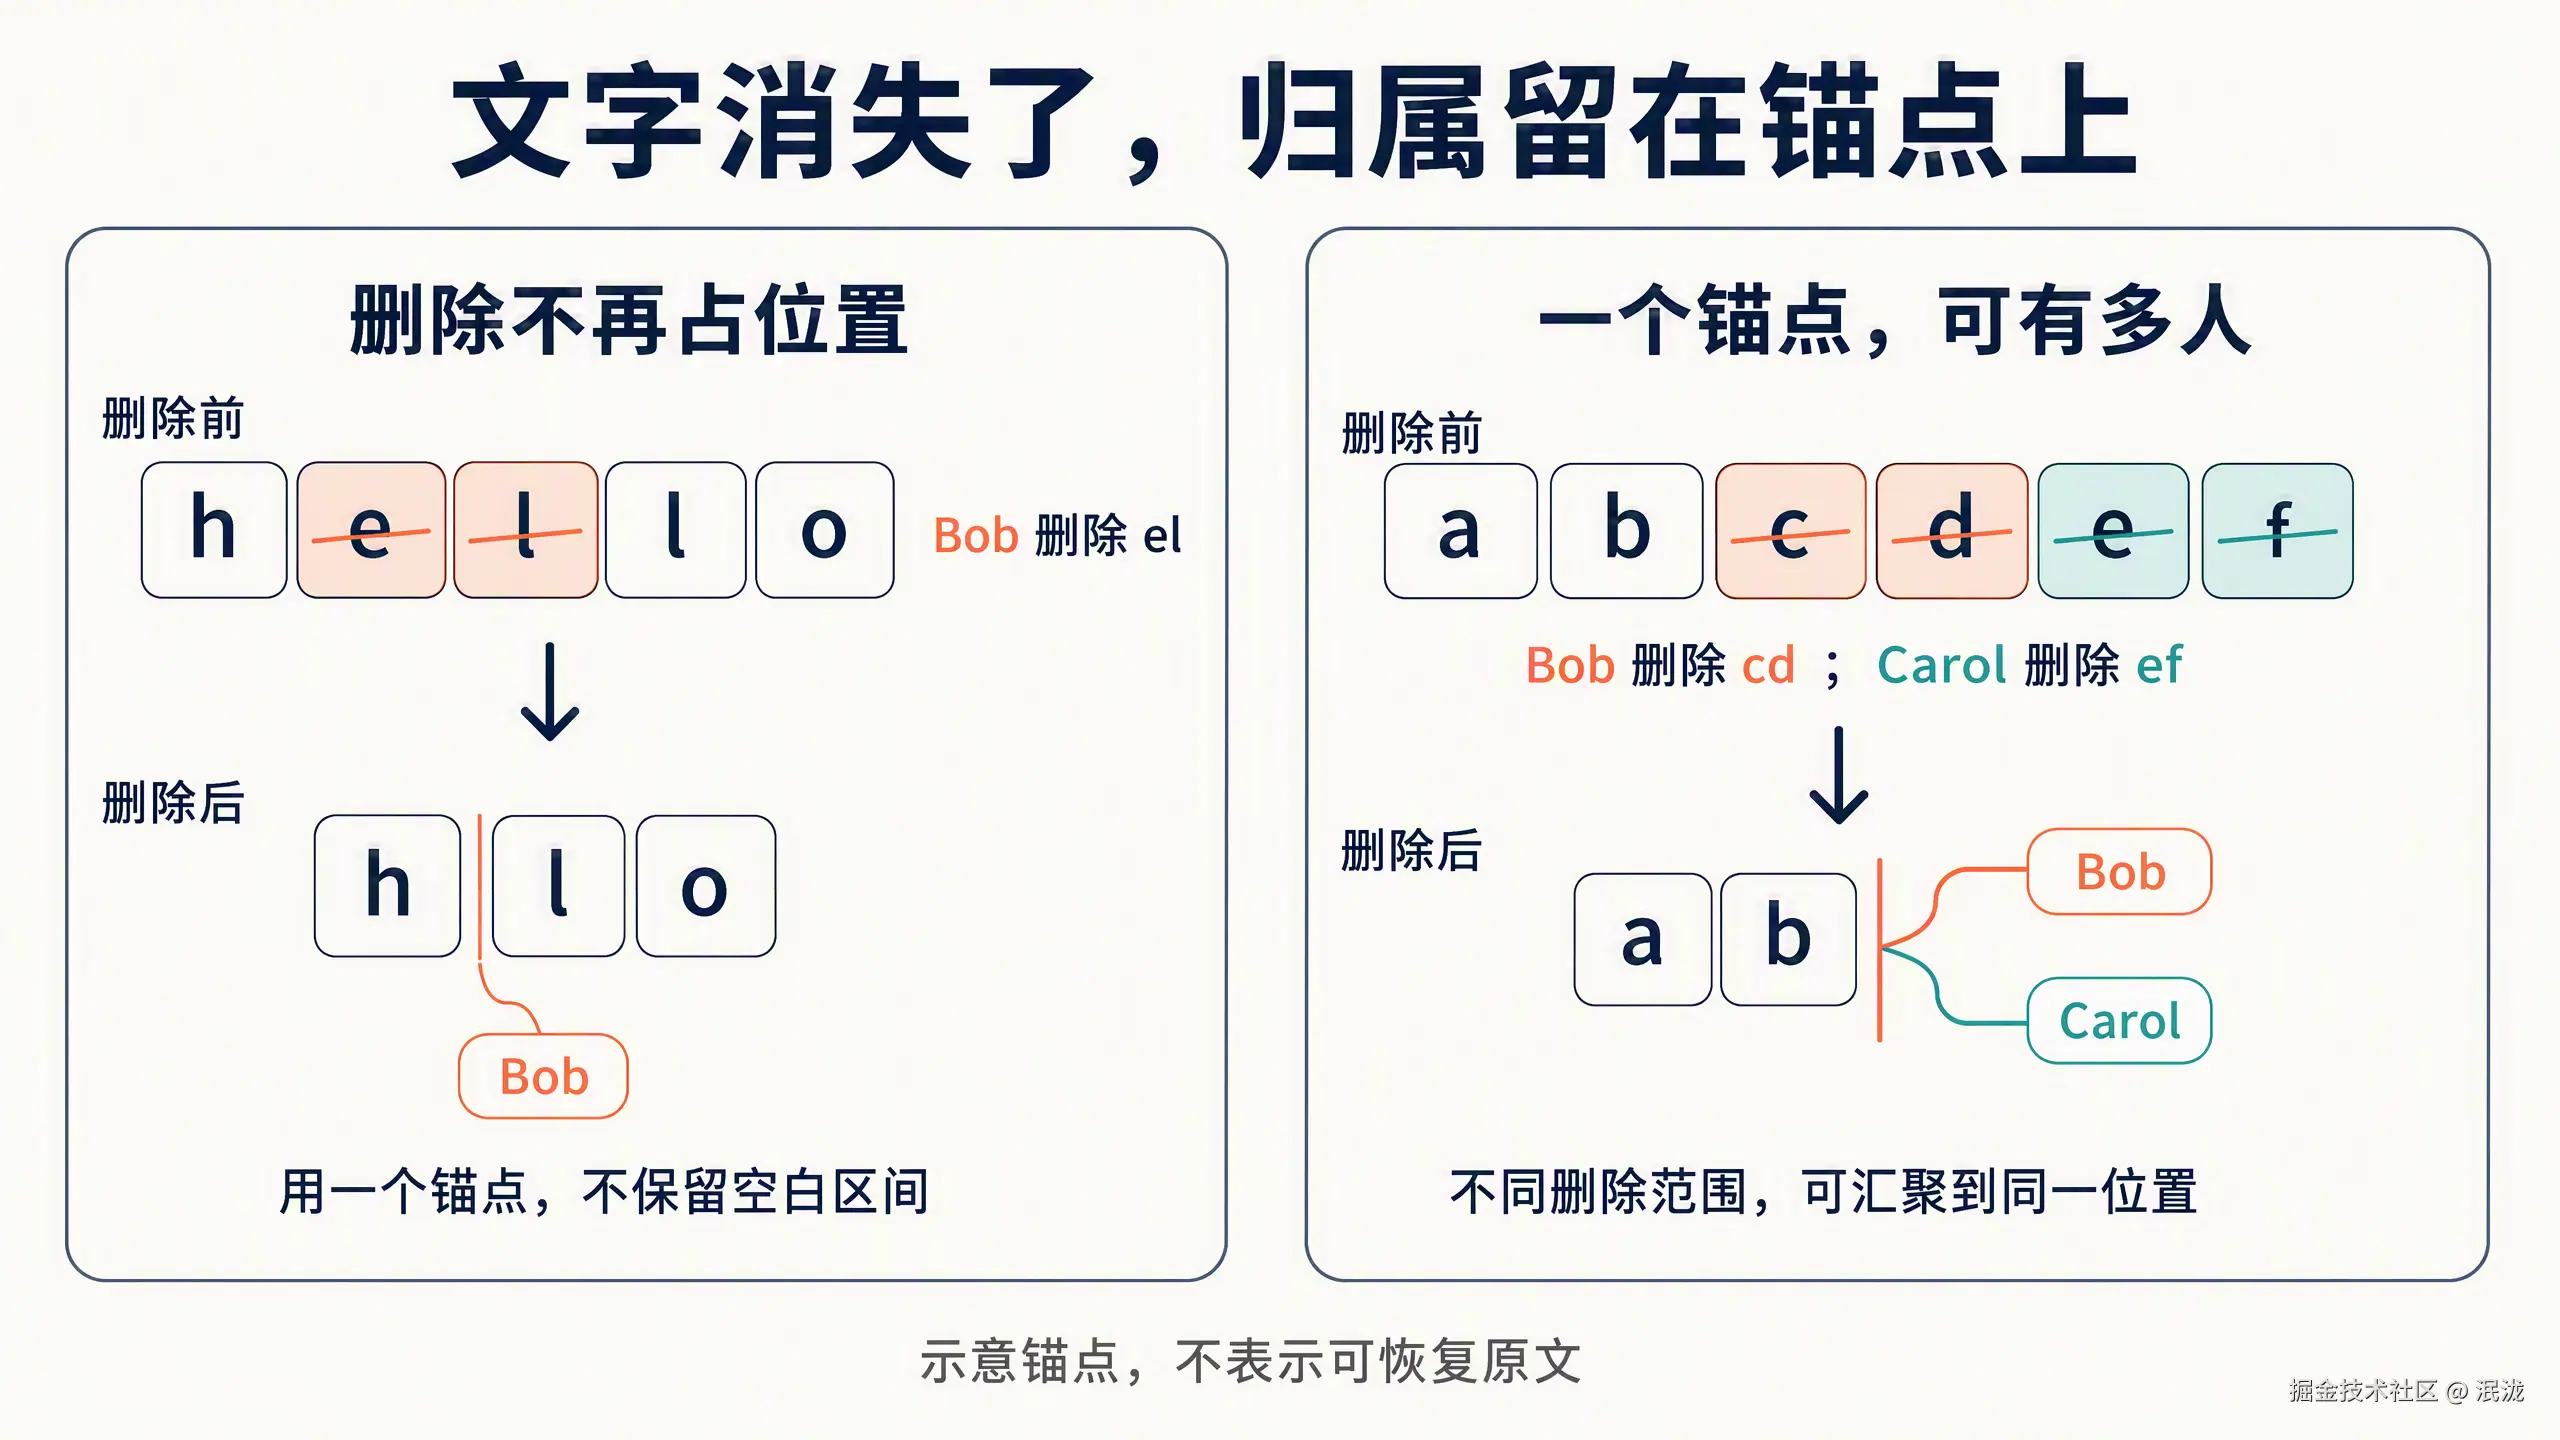
两次删除在当前文档里,可能落到同一个锚点:同一个 at: 3,可能同时对应 Bob 和 Carol 两个人。
图 3:删除内容不再占用当前位置;同一锚点可以保留不同删除者的标记。
这不是说两人删了同一段内容,而是两个不同的已删除范围,在剩下的文档里收到了同一个位置。Yjs 也可能把相邻的删除并到一起,所以别假设"一块墓碑只对应一个人"。
它按"位置 + 作者"去重:同一个位置的不同作者都留着;同一作者在同一位置的多次命中,合并成一个标记。
所以要记住:**标记数量不等于删除次数,标记列表也不是完整操作流水。**界面上可以点开悬浮提示看全部人员,但别随手只留一个名字,更别把数组顺序讲成"谁先动手"。
五、怎么接进真实系统?
从业务角度看,整条链路是:收更新 → 绑事务 → 记范围 → 暂存证据 → 生成快照 → 存下归属。
收到消息时,宿主先确认这条连接的认证用户,再解析消息声明的删除范围。身份要来自服务器验证过的会话,不能让客户端自己填个用户名就算数。生产环境里也建议用稳定的用户 ID,展示时再换成昵称。
接着,必须把这条消息和它实际产生的 Yjs 事务对上。一种稳妥的做法是按连接排队:消息到达时先登记这份声明,等它对应的 Yjs 事务结束后再取走消费。
有个很容易照抄出错的细节:会产生事务的 SyncStep2 **虽然不参与归属,也要留一个空声明占位;不产生对应事务的消息,则不能一律塞进同一条队列。**否则后面的声明会被前面的事务吃掉,作者和删除范围就错位了。
真正接入时,还得盯住鉴权失败、解析失败、中途报错、连接关闭、服务器内部事务这些情况会不会打乱对应关系。这套实现给的是配对工具,不是适配所有版本 Hocuspocus 的完整协议插件。
协议解析也有前提。这套实现按"文档名、Sync 消息类型、同步子类型、payload"这套封装来读消息,再交给 Yjs 的更新解码。如果网关把文档名剥掉了,或者用了别的封装、Update V2,你都得自己适配------不能把任意二进制消息直接丢给它。
事务结束时,用这笔事务自己的 beforeState 和 deleteSet 去捕获,别反复用文档启动时缓存的那份状态向量。核心调用大致是这样,身份解析和事务配对仍然归宿主负责:
typescript
function capture(beforeState, deleteSet, claimed, author):
    actual = deleteSet                        // 本事务实际新增的删除范围
    valid  = claimed ∩ actual                 // 声明与实际求交
    if valid 为空:
        return []                             // 没有可归属的删除
    if valid 越过了 beforeState 的已知边界:
        return []                             // 宁可不记,也不误记
    return [{ client, from, to, author } ...] // 通过检查,写入证据
然后按文档把 records 存起来------可以放在内存里,也可以放进 Redis。生成快照时,先领取还没处理的记录,再算出它们的位置,把文档状态和归属一起落库;写失败就把记录还回去。
长期来看,最好分开存两种数据:原始范围记录是以后重算的依据;算好的 at **只对应生成它的那一版文档。**如果只存锚点、丢掉原始记录,换一份文档状态后,旧坐标就未必还成立。
还有一点要事先想好:领取操作拿到的是当前待处理的记录,不会自动把过去所有版本的记录都累计回来。产品若要展示"截至这个版本的全部删除历史",累计和查询规则得业务层自己做。
六、再往深一层,三处边界不能省
上面讲的思路成立,不等于这套实现已经把所有富文本和审计问题都解决了。下面三点,是真正上项目之前值得先处理的。
1. 内部结构长度,不等于可见字数
当前的文本遍历,会把每个未删除文本 Item 的长度都累加进位置。
但用来表示格式变化的内部内容(比如一段加粗),在内部结构上会算一个长度,却不该占一个可见字符的位置。
于是:**在带这类格式 Item 的文本链上,现有遍历可能把格式标记也当成一个位置,让后面的删除锚点整体偏移。**光补一个 isLeaf 回调,解决不了这个问题。
这和"加粗等于多一个字"恰恰相反:内部为了表示加粗多加的结构,本来就不该算成一个字。
真要补强,得把"用来做身份匹配的 clock 长度"和"用来显示的可见长度"分开:活着的格式标记不该推进文本位置;纯格式删除算不算"删字记录",也该单独定规则。必要的话,还得赶在垃圾回收之前留住足够的类型信息。
说明一下,这是对着源码推出来的风险判断,不是我已经跑过的复现实验。
2. 先删句子、再删整段,旧归属可能找不到锚点
设想 Bob 先删掉一段字,Carol 随后把整个段落删掉,系统直到这时才生成快照。
当前遍历碰到已删除的父级 Item,会匹配父级本身,然后直接跳到右边,不再进它的子树。Bob 早先那条指向子内容的记录,就不一定还找得到。
垃圾回收会让情况更糟:Yjs 回收内部子项时,还会清掉类型节点的入口指针。所以别假设任何历史删除的墓碑,永远都能从最终文档树里走出来。
关掉垃圾回收也不是一键解决,因为当前算法本身就会跳过已删除父节点的子树。
如果业务要求长期留住这类历史,就得扩展设计:趁结构还定位得到时留下父链或锚点依据,维护历史文档状态,或者扩展对已删除子树的定位规则。光靠当前这份文档和一个 clock 区间,没法承诺所有旧删除都找得回位置。
3. Redis 原子领取,不代表证据绝不丢
Redis 实现用 Lua 做原子操作:领取时一次性读取并删除列表项;写快照失败,还能把记录还回去。
它解决了一部分并发领取的问题,但没把 Redis 和快照库变成同一个事务。
如果进程在领取成功、写数据库之前崩了,异常处理根本没机会把记录还回去,记录照样丢。追加失败、归还失败也需要监控,不能只靠一句没处理结果的异步调用。
另外,队列默认保留 24 小时,每个文档最多存 5000 条范围记录,超了会裁掉更早的。**它更像一个有容量上限的中转站,不是无限期的审计档案。**串行队列只管当前存储实例内的操作;Redis 脚本的原子性,也不会自动给你跨实例的快照一致性。
要更稳,得考虑持久事件表,或者带领取凭证、超时恢复、确认机制的队列,用幂等标识处理重试,并把"文档状态"和"记录批次"的一致性边界划清楚。这些都是建议补强,不是它已经有的能力。
特别要避开一个时序坑:生成快照时文档还在收更新,最后存下的是时刻 A 的状态,却贴上了在时刻 B 算出来的坐标。状态和锚点,必须来自同一份确定的文档版本。
七、这些测试说了什么,又漏了什么?
这套实现的测试覆盖了四件事:删除范围捕获与已知状态检查、真实文本墓碑到零宽位置的映射、相邻不同作者的删除,以及同步消息解析、SyncStep2 不参与归属。
其中,"删掉 hello 里的两个字符"和"两人依次删相邻内容"用的是真实 Yjs 文档和事务,能给核心示例撑腰。
但这离上线验收还差得远。
前面说的格式 Item 坐标问题、已删除父节点里的旧归属、跨实例快照竞争、领取后进程崩溃,当前测试都没覆盖;并发重复删除、延迟删除重放,也不能仅凭说明文字就当成已有专门的回归测试。
上线前,至少得把这些风险变成针对你实际编辑器 schema 和服务端消息链路的测试。图片、嵌套节点、撤销重做、离线合并、序列化后重新加载、同一事务里混着已知和未知删除范围,这些也都该补上。
性能也得按真实文档量来测。现在求交是双重遍历,墓碑匹配逐条比对,标记去重还要扫一遍已有结果;实现里既没有按 client 建的区间索引,也没有性能基准。长文档或大批记录可以考虑分组、排序后再求交,配上更高效的查找和去重结构------但在没测过之前,别宣称现有实现能扛住某个并发量。
还有一句得讲明:我是对着源码和测试内容做的静态核对,没在真实环境里跑测试或压测。所以"仓库写了这些测试",不等于"这篇文章验证它们全通过了"。
八、它到底能给产品什么承诺?
如果你想在可信协作链路里,给 Yjs v13 文档补上"谁删了这里",这套实现给了个清楚的起点:先核对删除证据,再保存稳定范围,最后把范围映射到对应版本的位置。
它不是从最终快照里猜作者,也没把最后发更新的人当成删除者。
但用它的时候,产品上最好把三件事分开:
"删除归给某人",意思是这条记录通过了来源和范围检查;"没有归属结果",可能是判不准、记录丢了,或者当前文档已经定位不到------都不能反过来说"没发生删除";"完整审计历史",要的就不止这几个零宽标记了,还得有事件身份、时间、原始记录和可靠的持久化。
如果你还想显示被删掉的原文,那得另外留住历史版本或相关内容。一个 { at, author } 不含原文,更不会自动具备恢复能力。
回到开头那个问题:小陈把更新传上来,不足以让系统把这句删除记在他名下。真正该出现在版本历史里的名字,来自删除当下留下的证据;没有这份证据,界面就应该允许答案是------这次删除的执行者无法可靠确定。