燃气轮机的监测数据常常同时面临类别不平衡和类间重叠两大难题:正常运行样本远远多于异常样本,而且异常的早期征兆往往藏在正常工况的边界附近,与正常样本特征高度相似。传统过采样方法在这种场景下很容易生成噪声样本,反而降低检测性能。论文Deep attention SMOTE: Data augmentation with a learnable interpolation factor for imbalanced anomaly detection of gas turbines针对上述问题,提出了一种新的数据增强方法,名为基于编解码器的深度注意力 SMOTE(DA-SMOTE-ED)。其核心思路可以概括为三点:其一,先用基于聚类的欠采样把大类样本的信息保留下来;其二,借助 Encoder-Decoder 把样本映射到一个类间可分的特征空间,弱化原始空间里的重叠;其三,在该特征空间里做 SMOTE,但插值系数 α 不再随机取值,而是用一个注意力模块按样本特点自适应地挑选,使合成样本尽量落在远离正常样本聚集区的位置。下面分四个部分展开介绍:其一,研究背景与挑战;其二,DA-SMOTE-ED 的整体框架;其三,注意力插值与损失设计;其四,实验验证与主要结果。
一、研究背景与挑战
1.1 燃气轮机异常检测为什么难?
燃气轮机是航空、舰船与发电等领域的核心装备,监测系统通常会采集大量气路参数、振动信号、温度等数据。然而两个现实问题长期困扰着智能检测方法。其一是类别不平衡:机组绝大部分时间处于正常状态,采集到的正常样本数量远多于异常样本,比例常常达到几十甚至上百比一;其二是类间重叠:在机组性能退化的早期阶段,异常征兆往往与正常工况的特征非常接近,两类样本在原始特征空间里高度交织在一起。这两类问题叠加之后,传统分类器会倾向于把所有样本都判为正常以获得较高的总体准确率,而真正需要捕获的异常样本却被淹没。
1.2 现有数据增强方法的不足
围绕不平衡问题,主流的应对思路可分三类。其一,传统的随机过采样与 SMOTE 类方法在样本之间做线性插值来生成新样本,简单有效但有两个明显短板:在重叠区域做插值极易生成噪声样本;同时原始 SMOTE 对所有样本一视同仁,不能区分哪些样本对训练更有价值。其二,欠采样方法直接丢弃大类样本,损失信息严重。其三,深度生成式方法如 GAN、VAE 等可以学习样本分布,但训练成本高、稳定性差,而且生成结果同样难以保证不落入正常样本聚集区。下图给出了三类常见思路在重叠区域的表现示意:
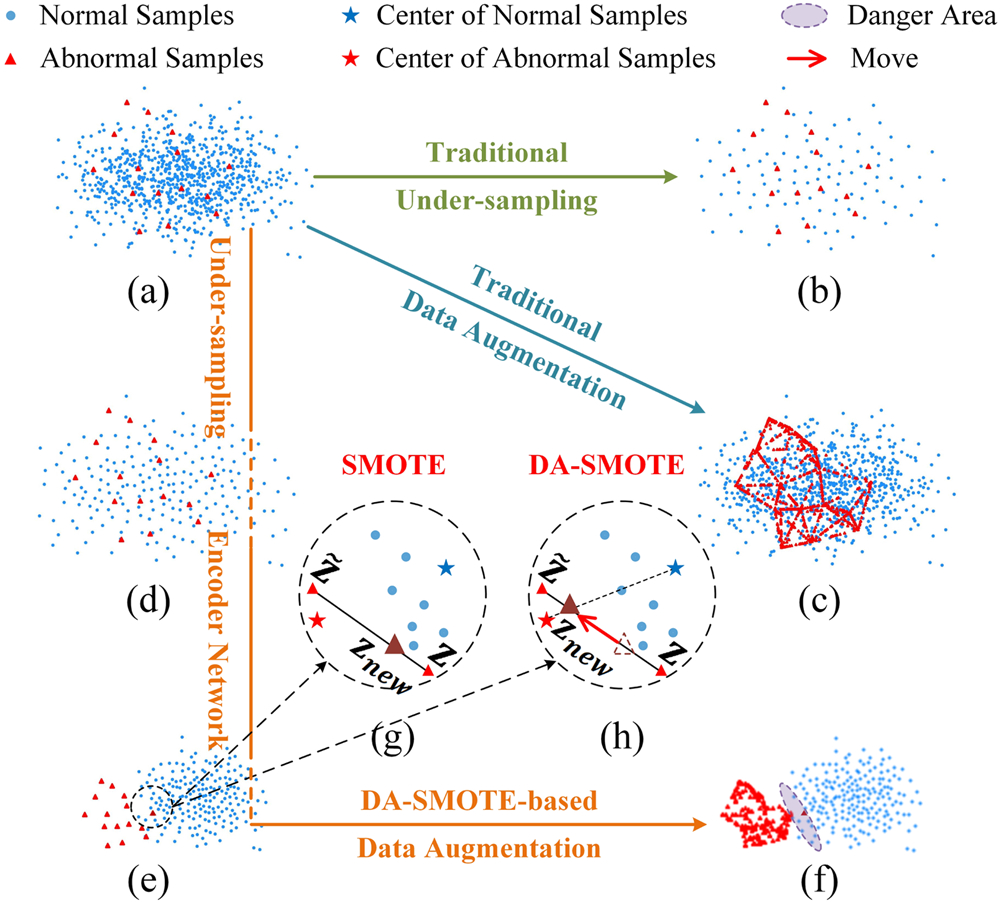
图 1 类别不平衡与类间重叠场景下的常见数据增强思路示意(来自论文 Fig. 1)
1.3 论文的核心立意
论文把视角从造数据本身转向"在什么空间、用什么策略造数据"。作者认为,与其直接在被重叠污染的原始空间里做插值,不如先学一个类间更可分的特征空间,再在这个空间里按样本特性差异化地插值。基于这个想法,论文把 Encoder-Decoder、注意力机制与 SMOTE 思想整合在一起,提出了 DA-SMOTE-ED。
二、DA-SMOTE-ED 的整体框架
2.1 整体思路
下图给出了 DA-SMOTE-ED 在整个异常检测流程中的位置。整体框架可以拆成三块:其一,基于聚类的欠采样(CUS)先把大类(正常样本)按簇压缩到与异常样本相近的数量;其二,把欠采样后的数据送入 Encoder-Decoder 学习一个低维特征空间,让两类样本在特征空间里尽量分离;其三,在特征空间里用一个注意力 SMOTE 模块为每个候选合成样本计算一个合适的插值系数 α,再把合成样本映回原始空间,最终和欠采样数据合并成平衡数据集,供下游分类器训练。
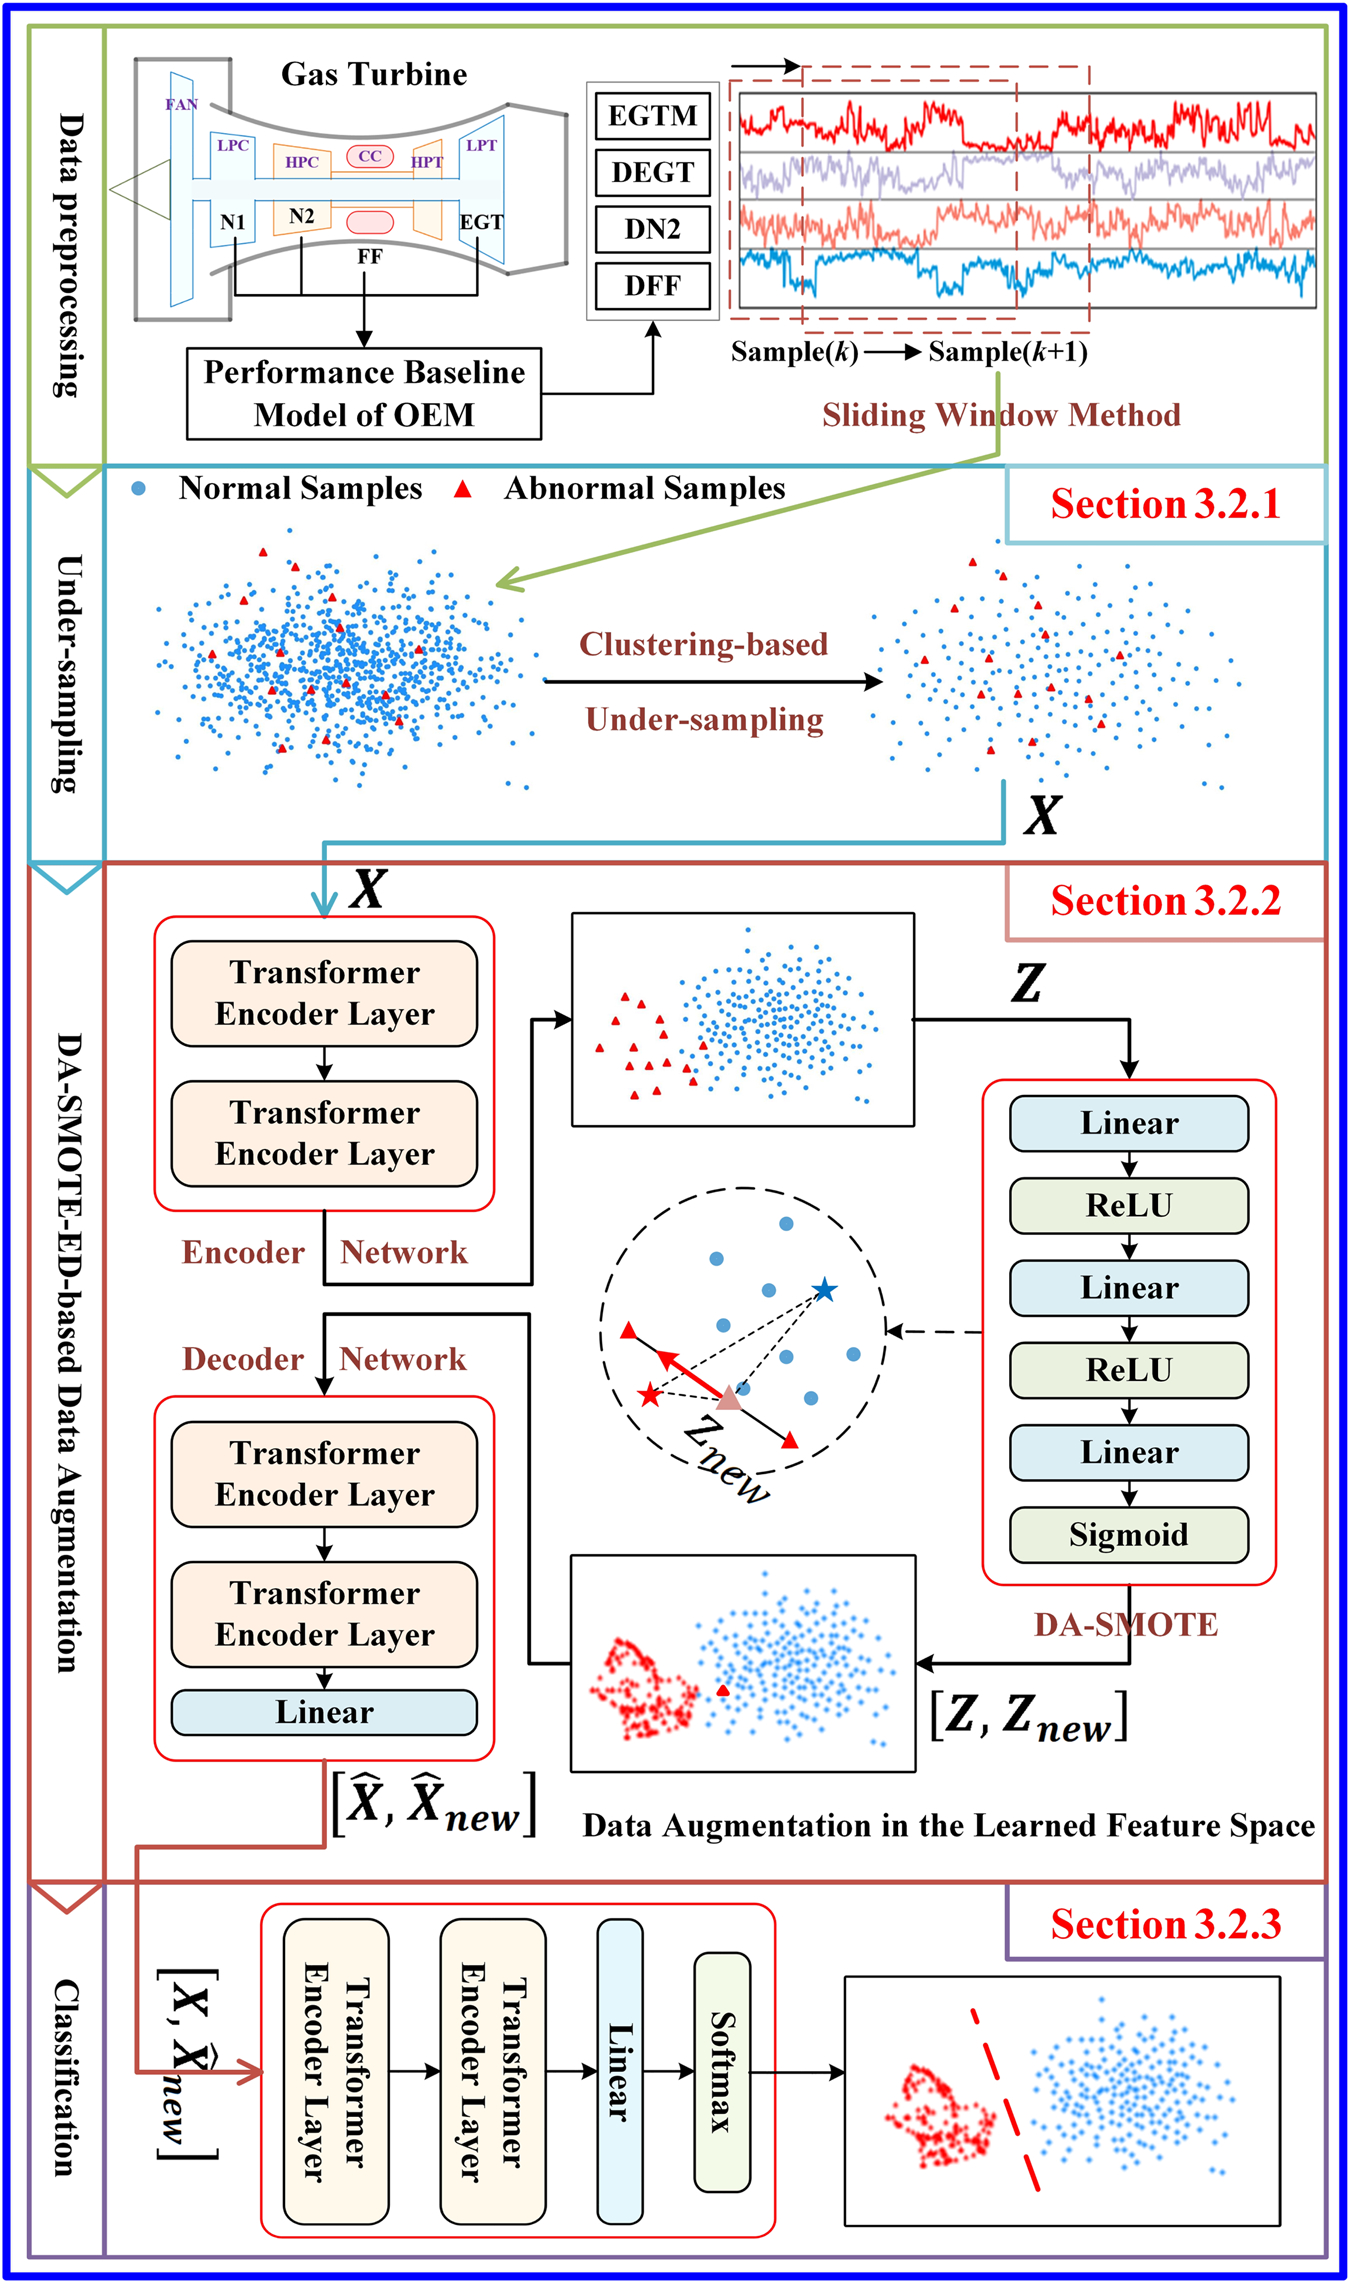
图 2 DA-SMOTE-ED 整体异常检测框架(来自论文 Fig. 2)
2.2 编码器-解码器:为 SMOTE 提供"干净"的空间
Encoder-Decoder 是整条流水线承上启下的核心。其作用可以类比为:把原始特征空间里纠缠在一起的正常与异常样本先解开,再在一个相对干净的特征空间里做数据增强,最后再解回原始空间供分类器使用。编码器输出维度通常较低,因而具备一定的特征筛选能力,让对判别贡献大的特征被保留、对判别贡献小的噪声被压制。
为了让这个特征空间真正"类间可分",论文不只用重构损失来训练 Encoder-Decoder,还额外引入了一个三元组-中心损失(triplet-center loss):同类的样本在特征空间里要更紧凑、不同类的样本要更分散,从而显式地把类间可分性注入到特征学习过程中。这一设计解决了"Encoder-Decoder 单独训练时只关心重构、未必能分清两类样本"的问题。
2.3 基于聚类的欠采样
欠采样部分的设计同样有讲究。简单随机丢弃大类样本会损失重要信息,因此论文先在原始特征空间上对大类样本聚类,再从每个簇里选若干代表样本,使保留下来的大类样本在分布上尽量覆盖原始分布。聚类数一般远大于样本压缩比例,例如把上千个正常样本压缩到几十个,仍能让下游 Encoder-Decoder 看到足够多样的正常模式。
三、注意力插值与损失设计
3.1 经典自注意力网络 SANet
在介绍 DA-SMOTE-ED 之前,先简单回顾一下它所借鉴的 SANet(Self-Attention Network)。SANet 由若干 Transformer Encoder 层组成,每个 Encoder 层包含多头自注意力机制、两次 shortcut 与 layer normalization,以及一个前馈全连接层,最后通过一个线性层与 Softmax 输出。多头机制让模型可以并行学习多种特征子空间,在多维时间序列分析上表现尤为突出。
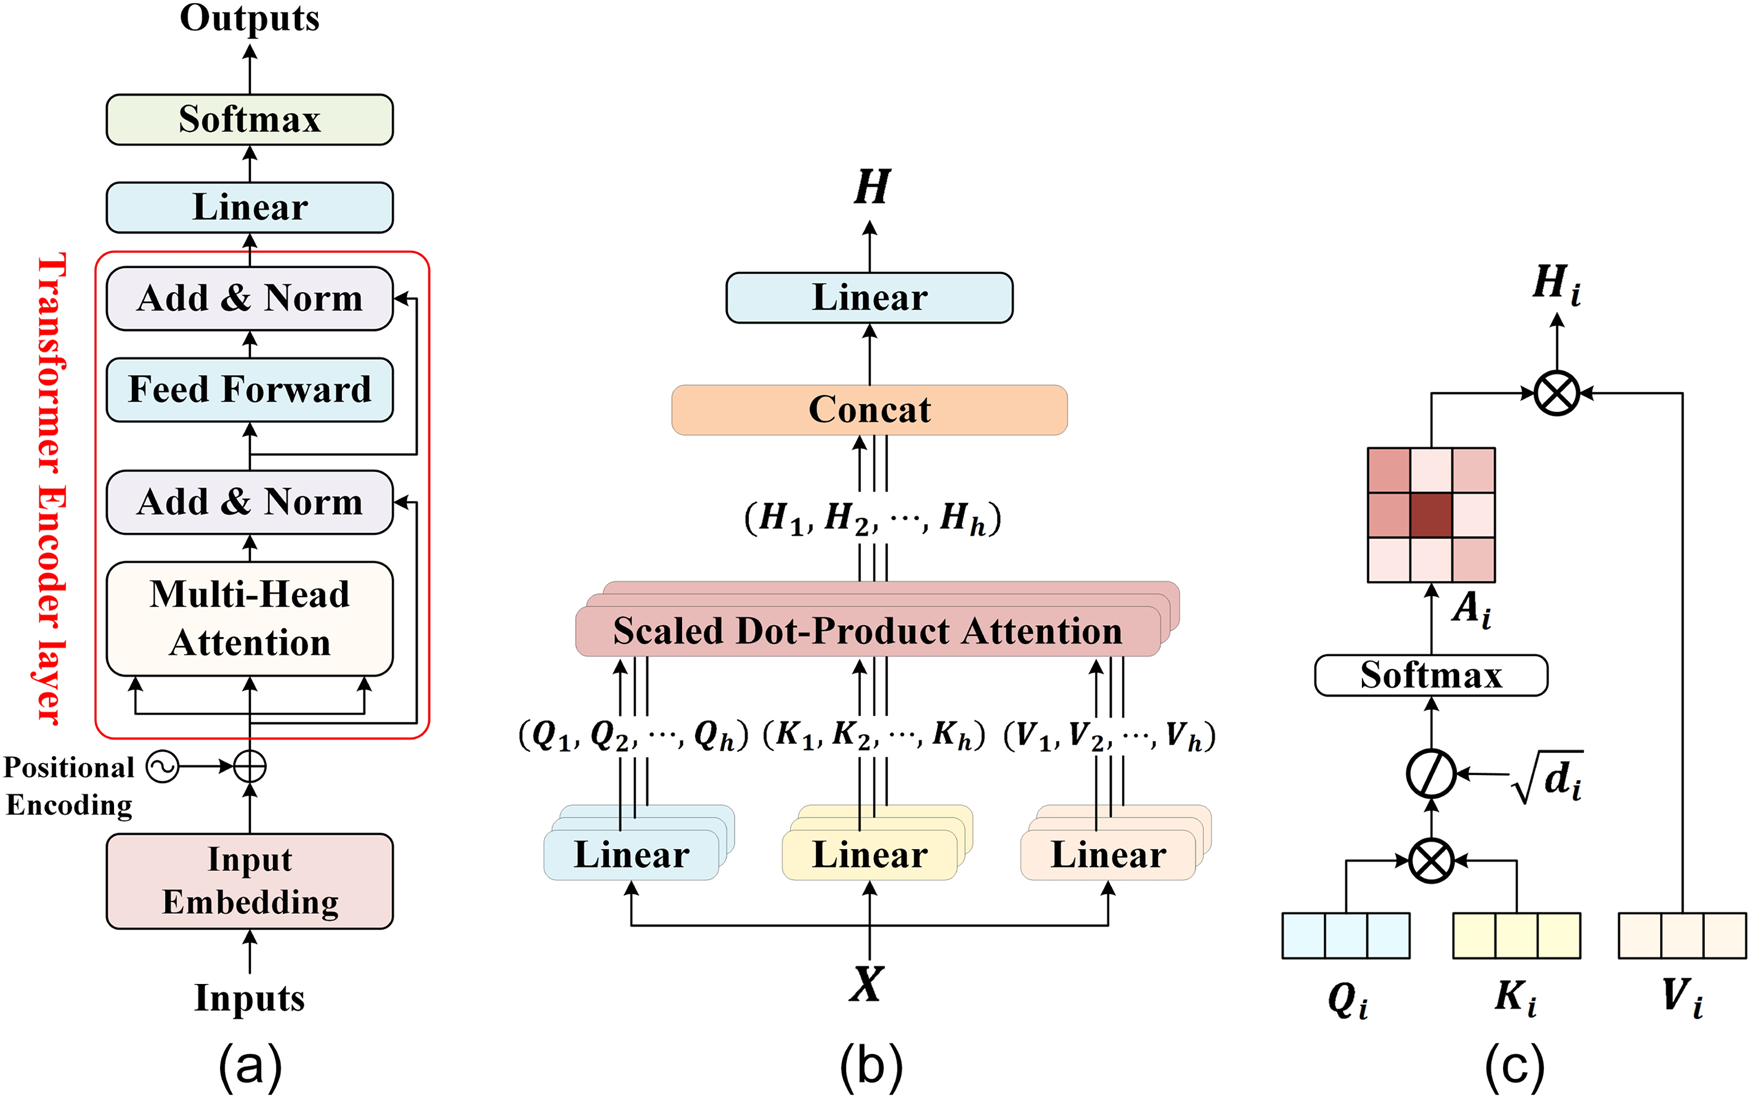
图 3 经典 SANet 与多头自注意力结构示意(来自论文 Fig. 3)
单头自注意力的核心计算如下:输入 X 先经过三个线性投影得到 Q、K、V 矩阵,然后用缩放点积方式计算自注意力权重 A,最后把 A 与 V 相乘得到该头的输出 H。多头的输出再拼接并经一次线性投影得到最终特征。
3.2 注意力 SMOTE:让插值系数变得可学习
传统 SMOTE 在两个样本之间用一个固定的随机插值系数 α 生成新样本,公式可以写成 。当
和
一个来自异常类、一个来自正常类时,α 取大值会让合成样本偏离
较远,容易越过正常样本聚集区、生成有效异常;α 取小值则会让新样本停留在
附近,仍然位于正常样本云团中。
问题在于随机 α 不可控:有可能两次都让新样本掉进正常样本里,"看似"合成了异常,实际上却给训练集引入了噪声样本。DA-SMOTE-ED 的核心改进就是把 α 从随机量改成"由注意力模块预测的可学习量"。具体做法是:在 SANet 上改造出一个注意力分支,输入为当前一对样本的特征表示,输出一个标量 α ∈ (0, 1) 作为插值系数。训练时,这个注意力分支与 Encoder-Decoder、分类器一起端到端优化,学习目标是"让合成样本既能扩充异常类,又尽量远离正常样本聚集区"。
3.3 重构损失与三元组-中心损失
为了让 Encoder-Decoder 学到对数据增强友好的特征空间,论文同时引入两种损失。其一是重构损失 L~{R}:
其中 β 是类别平衡系数(论文取 0.999),表示第 i 个样本所属类别的样本数;正常样本的
取 K(一个簇的代表数),异常样本的
取 M。这样正常样本的重构误差被压制得更狠,可以避免重构损失被大体量的正常样本主导。
其二是三元组-中心损失。它要求每个异常样本离同类中心的距离小于离正常类中心的距离,从而在特征空间里显式地拉大类间间隔。两种损失相加后,Encoder-Decoder 不仅能保留原始信息,还能在特征空间里把两类样本推开,为后续的注意力 SMOTE 提供"重叠少、方向清晰"的插值环境。
四、实验验证与主要结果
4.1 数据集与评价指标
论文用两组数据验证方法的有效性。其一是真实的燃气轮机监测数据;其二是改造后的 C-MAPPS 公开数据集(NASA 商用航空发动机仿真数据)。评价指标除了常规的精度、召回率、F1、准确率外,论文把重点放在平衡精度(balanced accuracy)上,因为它对类别不平衡场景更敏感,能够反映分类器在少数类上的真实表现。
4.2 主对比实验
论文把 DA-SMOTE-ED 与多种过采样、欠采样以及深度生成式方法做了系统对比。在真实燃气轮机数据集上,DA-SMOTE-ED 的平均平衡精度优于对比方法;在 C-MAPSS 数据集上同样取得了较为均衡的提升。这表明 DA-SMOTE-ED 在类别不平衡与类间重叠同时存在的场景下,能够真正帮助下游分类器学到更有判别力的特征,而不是简单地"造一堆新样本凑数"。从实验结果来看,其在多种不平衡比例下都取得了较好的诊断效果。
4.3 聚类数与泛化能力
论文还做了参数敏感性分析,重点关注聚类数 K 的影响。当 K 较小时,正常类被压缩过狠,信息损失较大;当 K 较大时,又会让欠采样后的正常样本过多,平衡效果减弱。论文通过在多种 K 值下做实验,给出了一个相对稳健的取值区间。
此外,作者还在公开 C-MAPSS 数据上验证了方法的泛化能力:训练在燃气轮机数据上得到的 DA-SMOTE-ED 同样能帮助 C-MAPSS 上的分类器提升性能,说明 Encoder-Decoder 加上注意力插值的设计学到的是相对通用的"分离 + 插值"能力,而不是仅仅拟合某一类装备的特定分布。下图给出了一组典型的 2D 可视化结果:
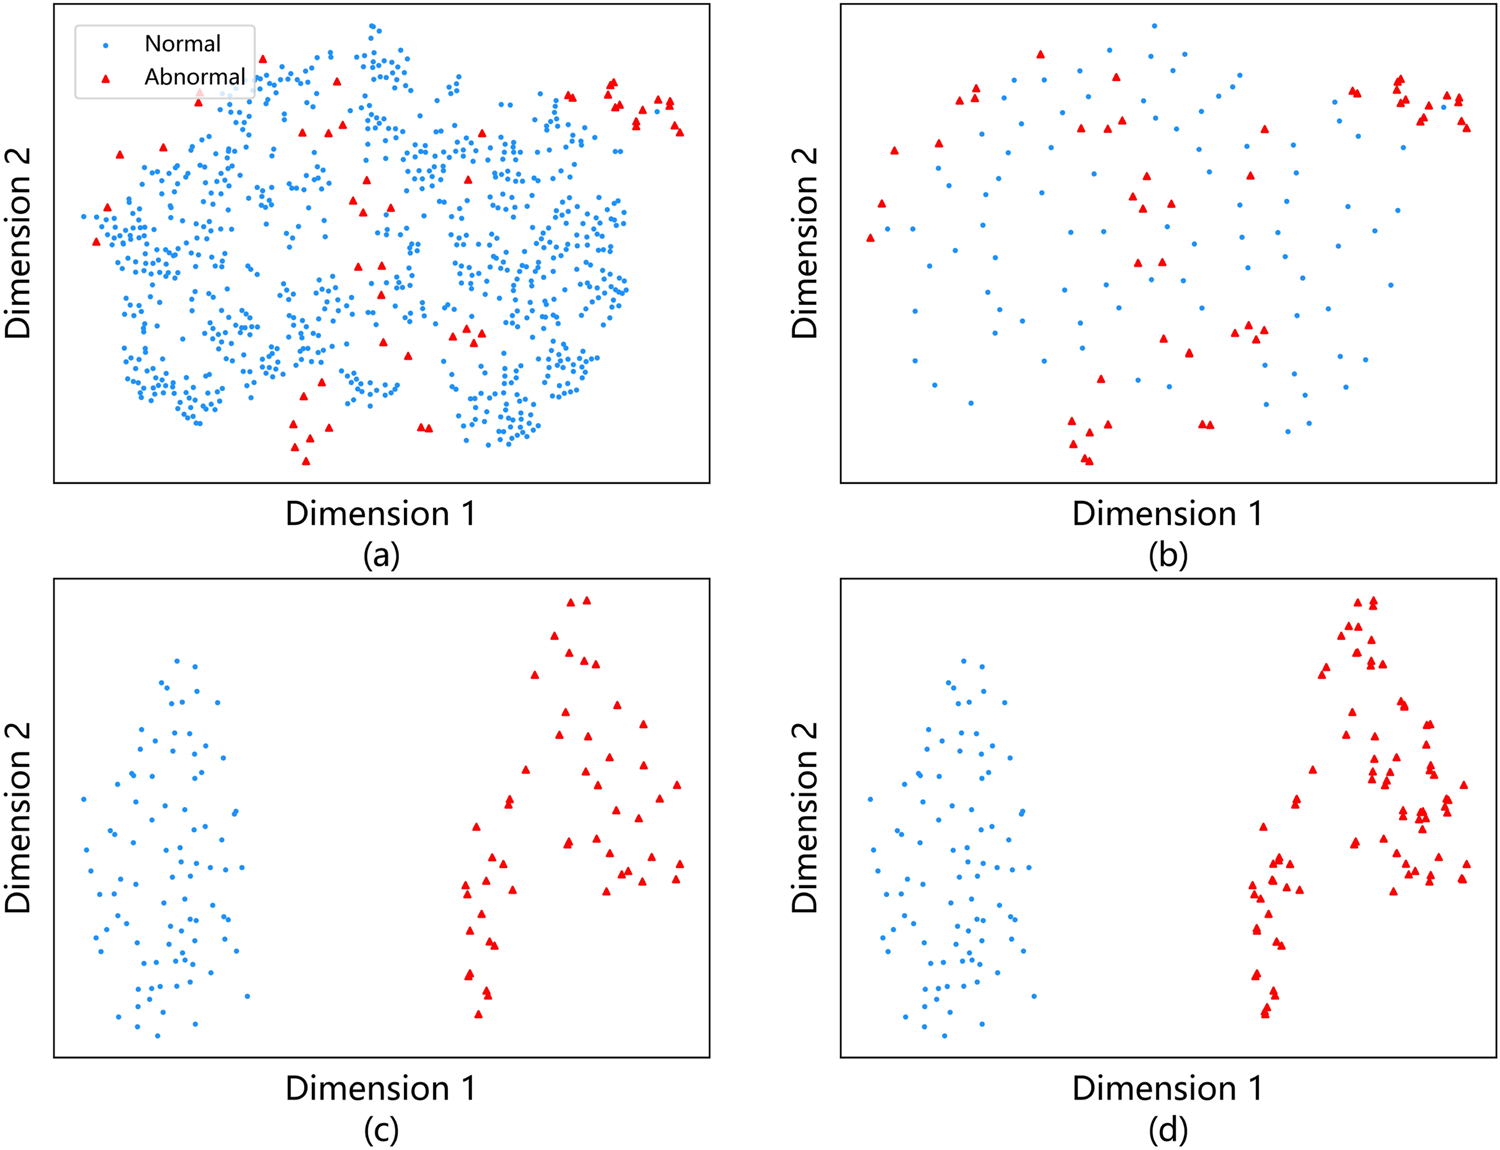
图 4 DA-SMOTE-ED 处理前后的样本分布可视化(来自论文 Fig. 6)
五、小结
综合来看,DA-SMOTE-ED 把燃气轮机异常检测里的两类难题,即类别不平衡和类间重叠,同时纳入考虑。它没有简单地"再造一些样本",而是先借助 Encoder-Decoder 把原始空间里的纠缠解开,再用一个注意力模块为每一对样本自适应地选择插值系数 α,使合成样本既能扩充异常类、又尽量远离正常样本的聚集区。
这套思路对工业现场的少样本与重叠场景具有一定参考价值。其后续值得探索的方向包括:其一,把注意力插值推广到高维插值(如方向向量或核函数参数),进一步提升灵活性;其二,把 Encoder-Decoder 与下游分类器做更深度的端到端联合优化;其三,把该思路推广到更多时序与多模态场景,验证其在跨设备、跨工况下的鲁棒性。
参考资料