本文解读的论文是 Empirical mode reconstruction: Preserving intrinsic components in data augmentation for intelligent fault diagnosis of civil aviation hydraulic pumps,发表在 Computers in Industry。
这篇论文研究的是类不平衡条件下的振动数据增强问题。民用航空液压泵在多数时间里处于健康状态,故障样本非常稀少,直接训练深度模型很容易出现"把样本都判成健康"的情况。常见的补救办法是复制故障样本或对信号做简单变换,但复制不会带来新的信息,简单变换又容易破坏样本的类别属性。作者提出的经验模态重构(EMR)试图在这两者之间找到平衡:既让增强样本与原始样本有区别,又保证它仍然属于同一类。
以下按"为什么需要数据增强、EMD 提供了什么工具、EMR 具体怎么做、实验效果如何"的顺序梳理。本文侧重方法与设计逻辑,不罗列具体数值。
一、为什么需要这样的数据增强
1.1 数据不平衡会把模型"带偏"
如果训练集里健康样本的数量远远多于故障样本,健康类就会在训练过程中占据主导。极端情况下,即使模型把所有训练样本都判为健康,训练损失依然很小,于是模型没有动力去识别故障,漏检比例随之上升。反之,如果各类样本数量接近,少数类样本就更容易被识别出来。因此,让各类样本数量均衡是数据增强最直接的动机。
1.2 只复制样本解决不了问题
最简单的不平衡处理方式是把少数类样本复制若干遍。但是复制之后样本分布本身并没有改变,模型仍然难以学到更合理的分类边界,而且训练集多样性偏低容易引发过拟合:模型可能把样本的细节甚至噪声都记住,却无法泛化到其他相似样本上。所以,增强不仅要增加数量,还要提高多样性。
1.3 类别不变性是不能突破的底线
多样性之外还有一条更重要的底线,即类别不变性。增强样本是从原始样本演化出来的,它必须仍然属于原来的类别。论文举了一个图像领域的例子:如果原始样本属于"杯子"这一类,而经过某些操作后的增强样本看起来已经很像"水桶",却仍然带着"杯子"的标签,就会误导模型训练。对于航空液压泵的振动信号,同样需要保证增强样本与原始样本在类别属性上一致,这也是本文重点考虑的问题。
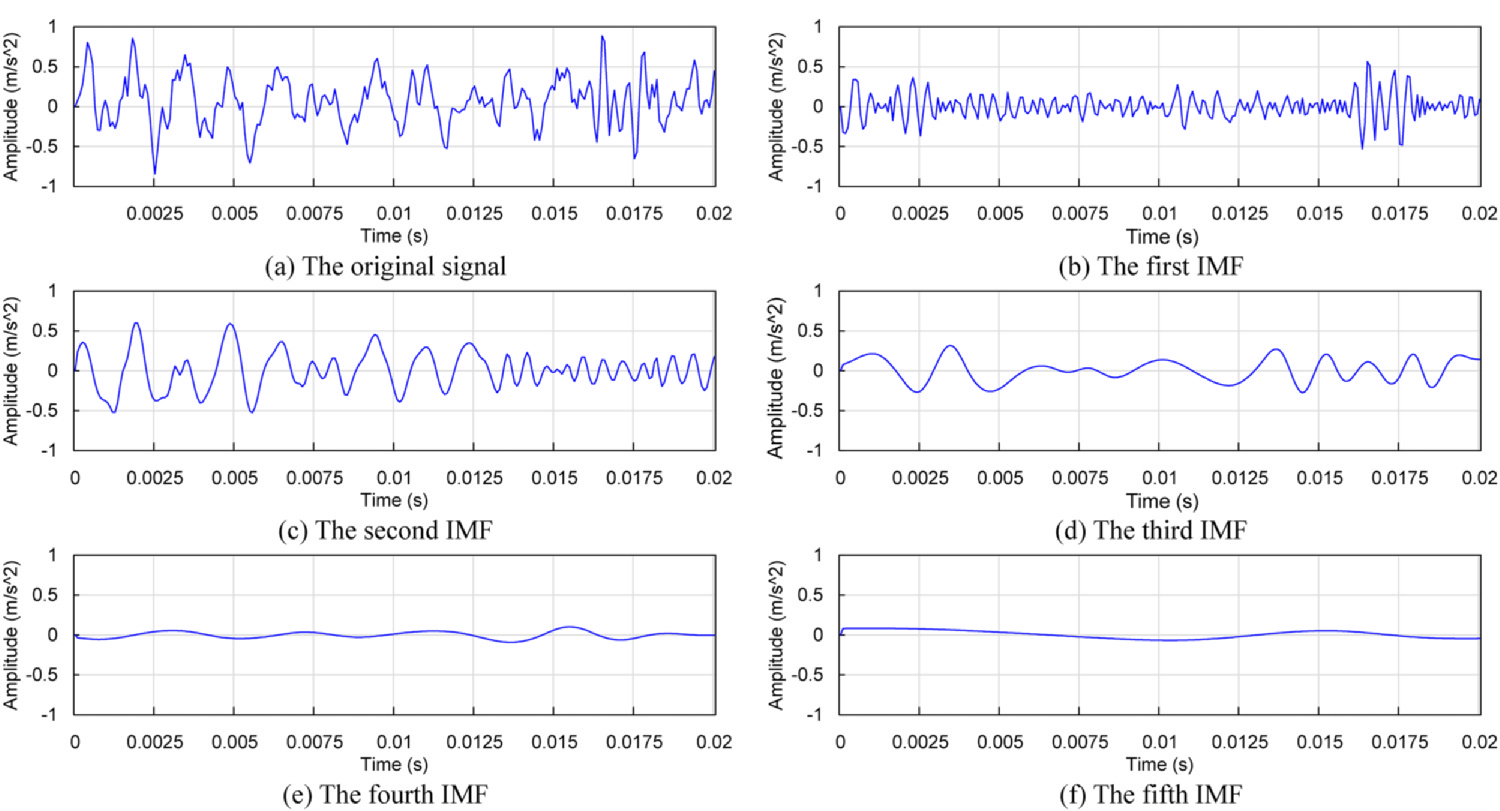
图 1 一段仿真振动信号及其经经验模态分解得到的若干本征模态函数:高频成分主要集中在前几个分量中(来自论文 Fig. 3)
二、EMD:把信号拆成内在成分
航空液压泵的振动信号是多种振动源叠加的产物。理想情况下,如果能把它分解为一系列基本的本征成分,每个成分对应一个振动源,那么与缺陷相关的成分就可以与其他无关成分区分开,缺陷也就更容易被检出。现实中现有的信号分解方法还不够精确,无法把不同来源的振动成分完美分开,但使用它们仍然能带来一些实际收益。论文采用经验模态分解(EMD)来完成本征成分的提取。
EMD 的大致过程是:先找出信号所有的局部极大值和极小值,用三次样条插值分别构造上包络线和下包络线;再取上下包络线的平均得到均值曲线;把均值曲线从原信号中减去,得到一个新的信号;检查这个新信号是否满足本征模态函数的条件,如果不满足,就把它当作新的输入重复上述过程,直到满足为止,此时得到的即是一个本征模态函数。随后从原信号中减去这个分量,对剩余部分重复上述步骤,就可以依次得到其余分量。
论文给出了一个直观的例子:一段振动信号被分解为五个本征成分,其中大部分高频成分集中在前面的分量里,低频成分则分布在后面的分量中。论文也坦率地指出,分解过程中可能存在模态混叠,使某些本征成分失去明确的物理含义,因此像集合经验模态分解、经验小波变换这类更先进的自适应分解方法,是未来可以继续研究的方向。
三、EMR:怎么做数据增强
EMR 的目标是在原始样本的基础上生成新样本,同时保留其内在成分,从而既保证类别不变性,又提高多样性。顾名思义,它包含两个关键环节:经验模态分解和信号重构。整个过程可以概括为八步。
其一是零均值化。原始振动信号的均值未必为零,先把它处理成零均值信号,作为后续处理的训练样本。
其二是计算标准差。标准差是判断机械是否存在缺陷时最重要的统计量之一,这里计算的是零均值化之后信号的标准差,用来刻画训练样本的特性。
其三是信号分解。用 EMD 把零均值化后的信号分解为若干本征模态函数,论文中取五个分量。
其四是随机加权。随机挑选其中一个本征模态函数,并从一个预设区间内随机取一个权重系数,对这个分量做线性放大或缩小。这一步是多样性的来源:由于某个分量被重新缩放,重构出来的信号就与原始信号有所区别。
其五是信号重构。把被随机加权的分量与其余分量直接相加,重构出一条一维信号。
其六是再次零均值化。重构信号的均值未必为零,为保证规律一致,每条重构信号各自减去自身的均值。
其七是计算重构信号的标准差。同样因为标准差是判断缺陷的重要统计量,这里需要把它算出来供下一步使用。
其八是标准差校正。把每条重构样本的标准差强制调整到与其对应的原始样本完全一致。这一步是保证类别不变性的关键:由于分量被缩放会改变信号的整体能量水平,如果不加校正,增强样本在统计特性上就偏离了原样本;校正之后,增强样本与原始样本在能量水平上保持一致,差异主要来自分量之间的相对关系。
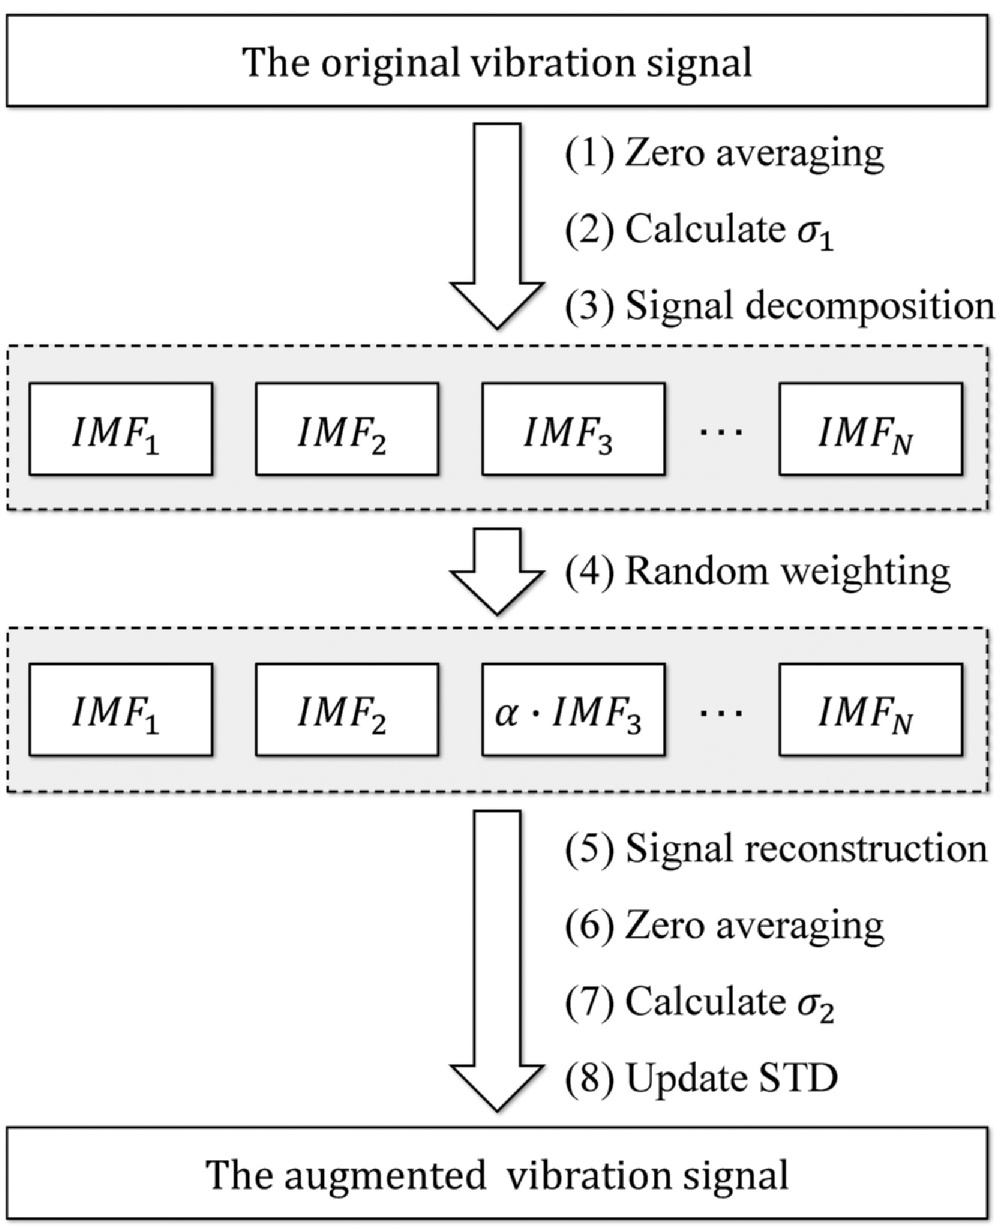
图 2 EMR 的完整流程:零均值化、计算标准差、经验模态分解、随机加权、信号重构、再次零均值化、计算标准差、标准差校正(来自论文 Fig. 4)
把权重区间的选择单独看,它其实是一个需要权衡的超参数。权重离 1 越远,增强样本与原始样本的差异越大,数据集多样性越高;权重恰好取 1 时,增强样本与原始样本完全相同。但多样性也不是越大越好,如果增强数据集的多样性过高,就需要模型具备更强的特征学习能力来应对,否则反而拖累性能。论文在实验中对不同权重区间做了系统考察,这一点在下一节说明。
四、把 EMR 接进诊断流程
论文把 EMR 与卷积网络结合起来,构成完整的诊断方案。整体流程中有几处细节值得留意。
首先,只对故障样本做增强,健康样本不做处理。这样做的目的是得到各类样本数量相等的均衡训练集,因为问题的根源正在于故障样本太少。
其次,数据增强在每一轮训练中都重新执行一次,而不是只在训练开始前做一次。由于 EMR 中的权重是随机选取的,每轮重新生成意味着模型在训练过程中能见到更多不同的增强样本,从而进一步提升训练集多样性、降低过拟合风险。
最后,采用提前停止策略。当训练达到设定的轮数上限,或者训练准确率已经达到较高水平时,就结束训练,以进一步抑制过拟合。训练完成后,模型被用于测试集的诊断。
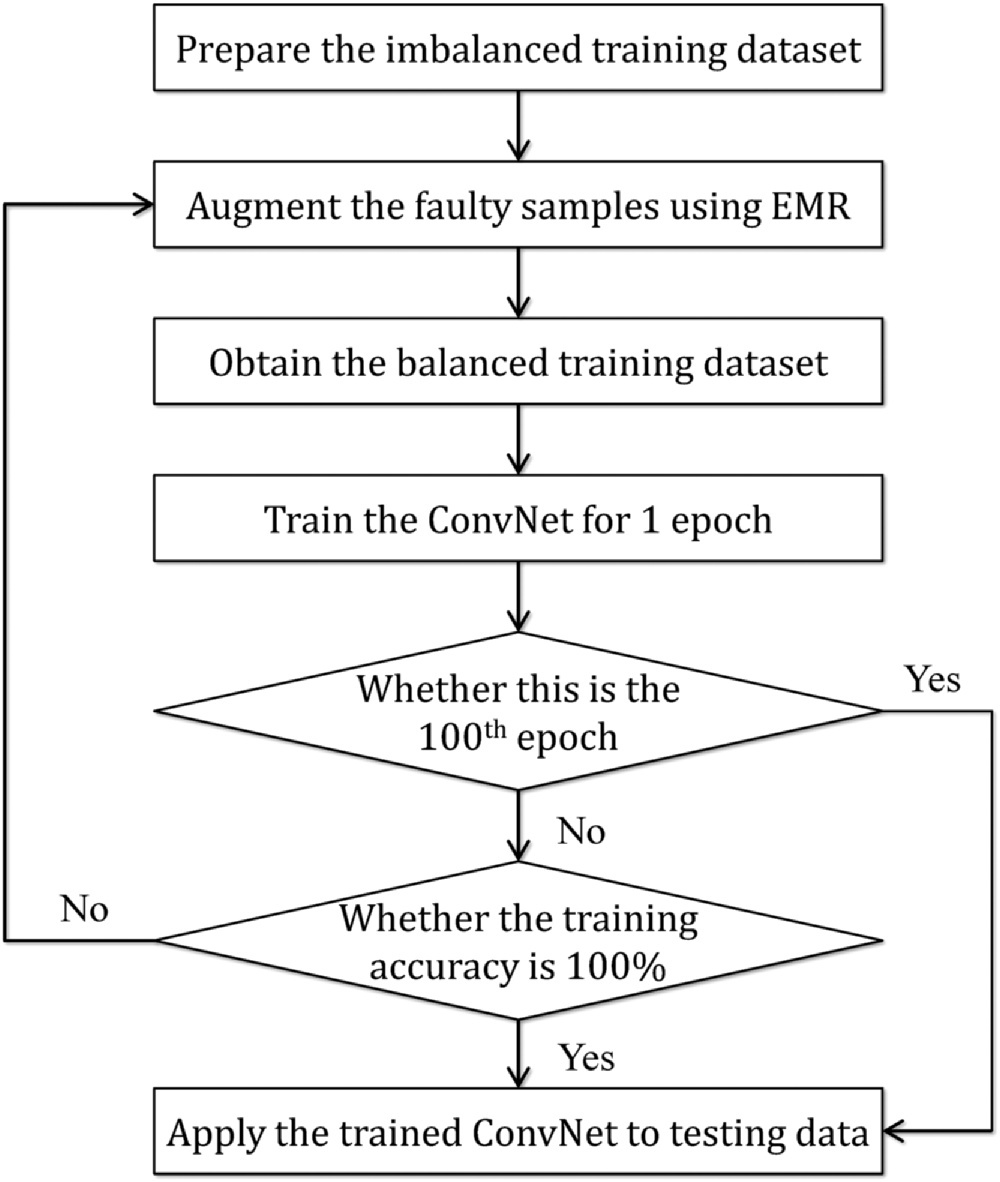
图 3 论文提出的故障诊断整体流程:仅对故障样本做 EMR 增强以构造均衡训练集,并在每轮训练中重新增强(来自论文 Fig. 6)
五、实验设计
5.1 数据与不平衡设置
实验数据来自民用航空液压泵的地面试验,采样频率为 10.24 kHz。数据包含一种健康状态和五种故障状态,覆盖油分布盘磨损、柱塞缸体磨损、入口压力偏低导致的腐蚀、出口压力偏高导致的变形、以及存在间隙的疲劳故障等情形。
为了构造类别不平衡的评价条件,作者的处理方式比较极端:健康状态有较多的训练样本和一定数量的测试样本,而每种故障状态仅保留极少数训练样本,其余样本全部用于测试,使得健康类与故障类的训练样本数量之比达到 100 比 1 左右。在这样的条件下,模型必须依靠极少的真实故障样本来学会识别故障,增强方法的优劣也就更容易显现出来。
5.2 对比方法与评价指标
论文把所提方案与三类处理方式做了对比。其一是不做任何数据增强,直接把不平衡训练集送入网络;其二是下采样,从健康类中随机抽取与故障样本数量相当的样本作为训练集,代价是丢弃大量健康样本的信息;其三是上采样,把故障样本复制多份以达到均衡,代价是训练集缺乏多样性。对比的重点就是看 EMR 能否同时避免这两类方法的缺陷。
评价指标上,论文采用了 F1 分数、精确率和召回率,并进行了多次重复试验以考察稳定性。此外还做了配对样本单侧 t 检验,从统计角度判断性能差异是否可信,而不是只看平均值的表面高低。
5.3 特征分布与训练过程
论文把卷积网络全局平均池化层的高维特征映射到二维平面进行可视化,用来直观判断样本是否可分。在直接使用原始不平衡数据训练的网络中,若干对故障类别之间存在比较严重的重叠,个别故障类的样本还散落在两个相距较远的区域,容易造成误分类;上采样方案下也有类似问题,某些故障样本甚至被归并到了相邻类别所在区域。而采用 EMR 增强的方案中,没有观察到明显的误分类现象。
从训练过程的损失曲线看,EMR 方案在训练结束时取得了较低的测试损失,说明其泛化性能较好;训练集与测试集上的 F1 分数曲线也支持相似的结论。
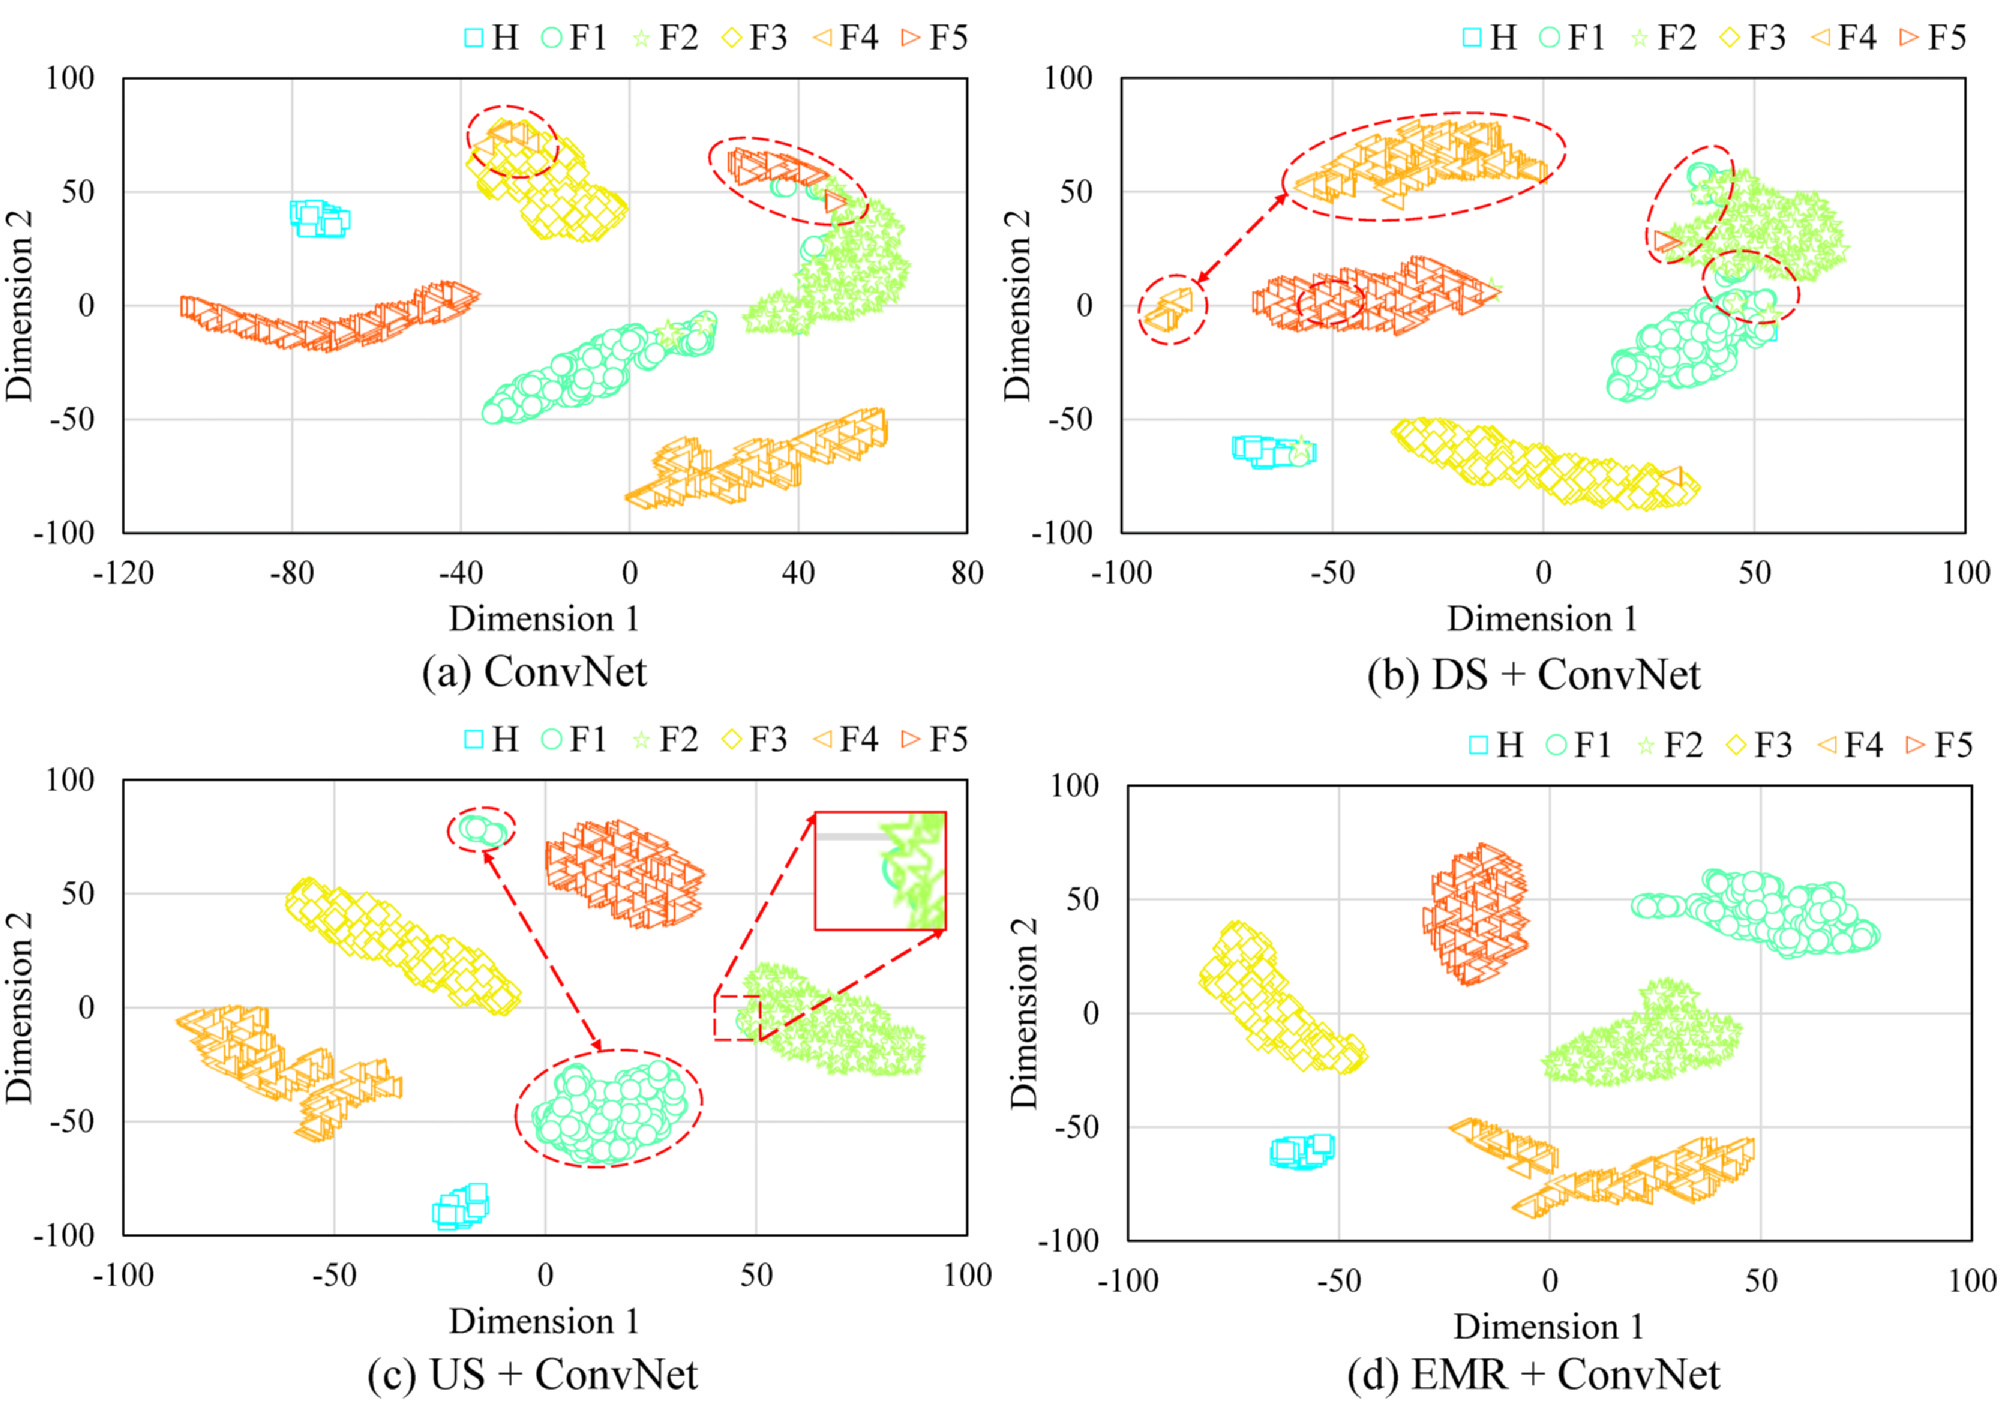
图 4 不同方法下样本在二维空间中的分布可视化:部分严重重叠与分散的样本用圆圈或方框标出(来自论文 Fig. 10)
5.4 权重区间的影响
权重区间的选择是 EMR 中最重要的超参数,论文考察了从较宽到较窄的一系列区间。实验发现,过宽的区间会让增强样本与原样本差异过大,过窄的区间又使增强样本与原样本过于接近、多样性不足;综合来看,中等宽度的区间在多次试验中取得了较高的平均表现。但论文也很谨慎地指出,这一区间并非在每一次试验中都表现最好,因为最终性能同时受到数据集特性、EMR 的随机性和网络超参数的影响,所以合适的区间应当结合具体数据与模型统一考虑、联合优化,而不是当作一个放之四海而皆准的固定值。
六、结论与一点思考
这篇论文提出的 EMR 是一种面向振动信号的数据增强方法,它在增强样本中保留原始信号的内在成分,从而在保证类别不变性的同时实现类别均衡并提升多样性。从实验看,与不做增强、下采样和上采样相比,该方法在多个指标上都取得了较好的效果,且通过统计检验进一步确认了性能优势的可信度。
从方法设计上看,这篇论文最值得借鉴的地方是它对"增强到什么程度"这个度的把握。数据增强很容易走向两个极端:不变则无益,变得太多又可能破坏类别属性。EMR 借助两个机制来守住这条线,一是只对一个内在分量做缩放而保留其余分量,使信号的基本结构不被破坏;二是把重构信号的标准差校正回原始水平,使增强样本在整体能量上与原始样本保持一致。这两点结合起来,实际上是把"变化"限制在了一个可控的范围内。
论文也指出了若干可以继续推进的方向,例如用集合经验模态分解或经验小波变换替代 EMD 以缓解模态混叠问题,把权重区间的选择与网络超参数放在统一框架下联合优化,以及把这一思路推广到其他往复或旋转机械的振动信号乃至声学信号、电流信号等时间序列上。这些方向对于从事智能运维研究的读者来说,都是比较具体的切入点。
论文链接: