目录
前言
学习赵老师讲授的强化学习的数学原理视频,本篇文章记录第九讲 Part 1:策略梯度方法(该方法的基本思路),记录个人学习笔记,和大家一起分享交流😄
1. Outline
这是我们的第九次课,这次我们将会介绍非常重要的 policy gradient 的方法,下面是我们课程的地图:
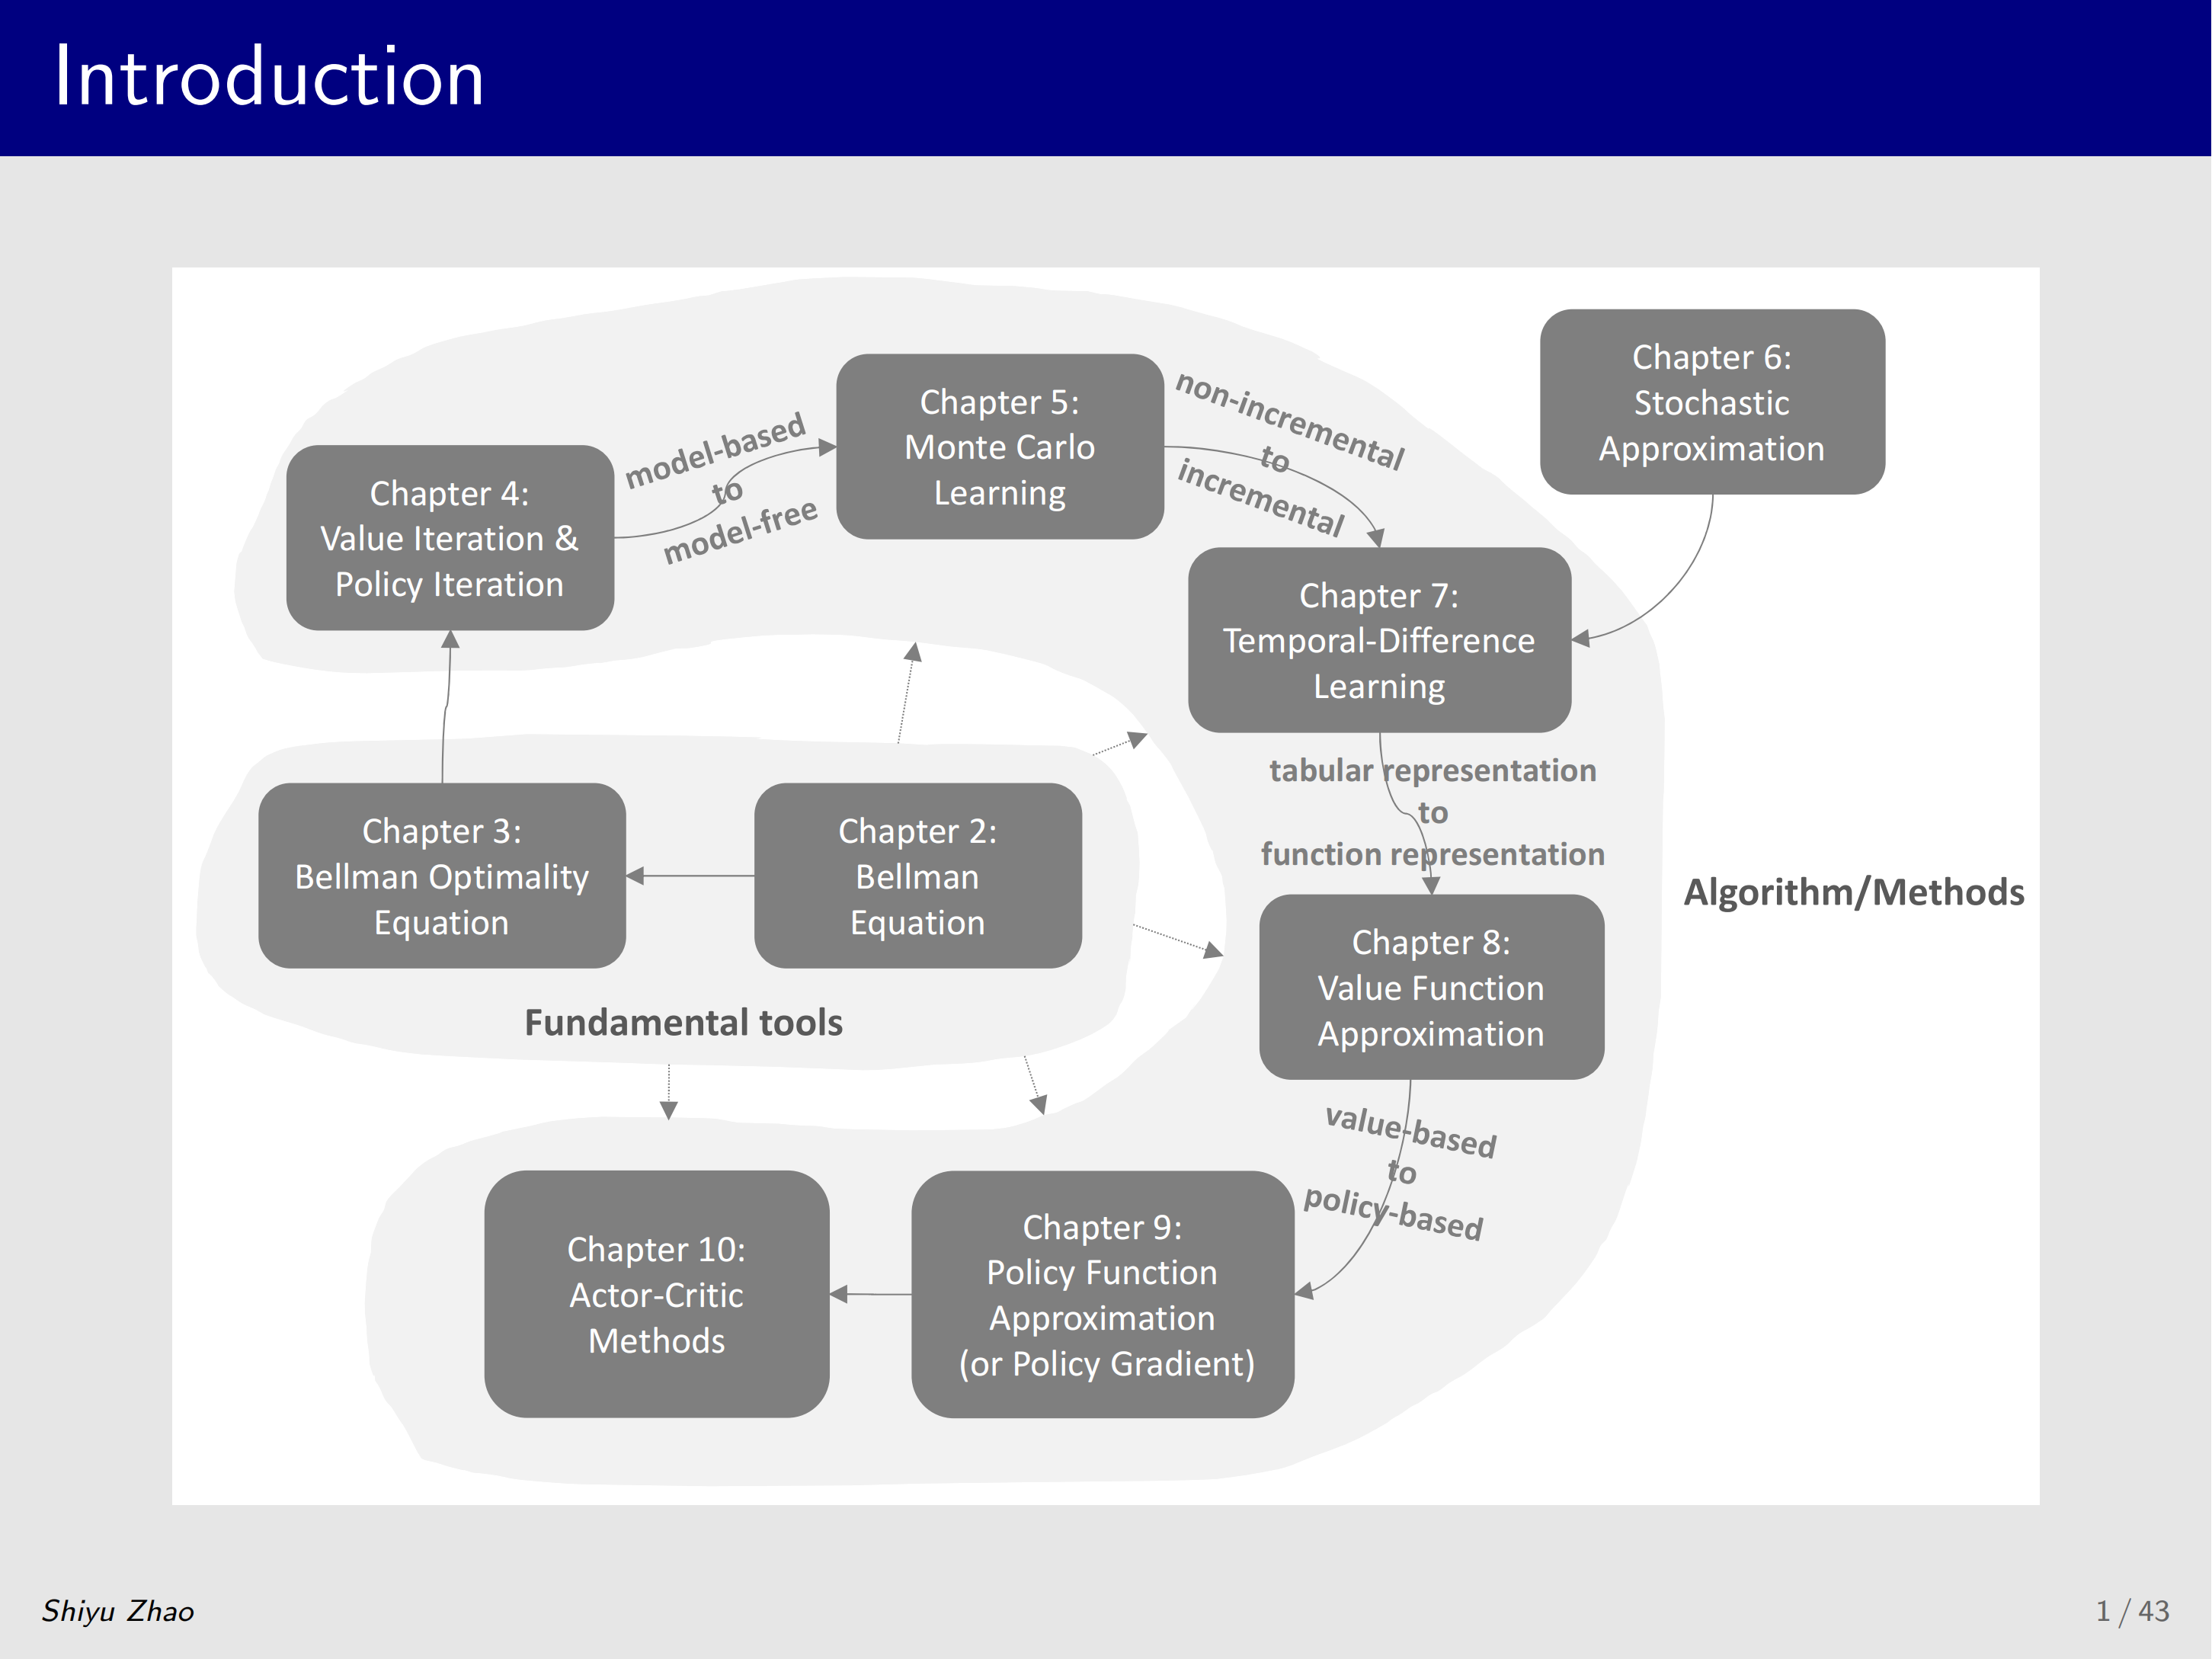
经过长途跋涉,我们进入第九章(第九次课),基本上已经接近课程的尾声了,虽然快到最后,但并不意味着内容不重要,恰恰相反,内容越来越重要,为什么?因为 policy gradient 以及下节课将介绍的 actor-critic,是目前最流行、性能相对也较好的方法。
这节课和上节课的关系是什么呢?上次课我们介绍了 value function approximation ,即 action/state value 之前用表格表达,现在用函数表达,这次课思想类似, 之前我们是用表格来表达策略,现在其实我们也可以用函数来表达策略。
从上节课到这节课有一个跳跃,是什么呢?之前所有方法都叫 value-based ,这次课和下次课的方法都是 policy-based,什么意思呢?所谓 value-based 就是以 value 为核心,比如估计一个策略的 action value,这个就是 policy evaluation,在此基础上选更好的策略、再采样,不断迭代循环,这个过程中 value 发挥了重要作用。
而 policy-based 方法直接建立目标函数,它是策略的函数,通过优化这个目标函数就可以直接得到最优的策略 ,学完这次课大家就会明白,也可以预告一下,下次课所介绍的 actor-critic 方法也非常重要,它把 policy gradient 与 value function approximation 两种方法结合了起来,大家可以关注一下。
下面是我们这次课的大纲:
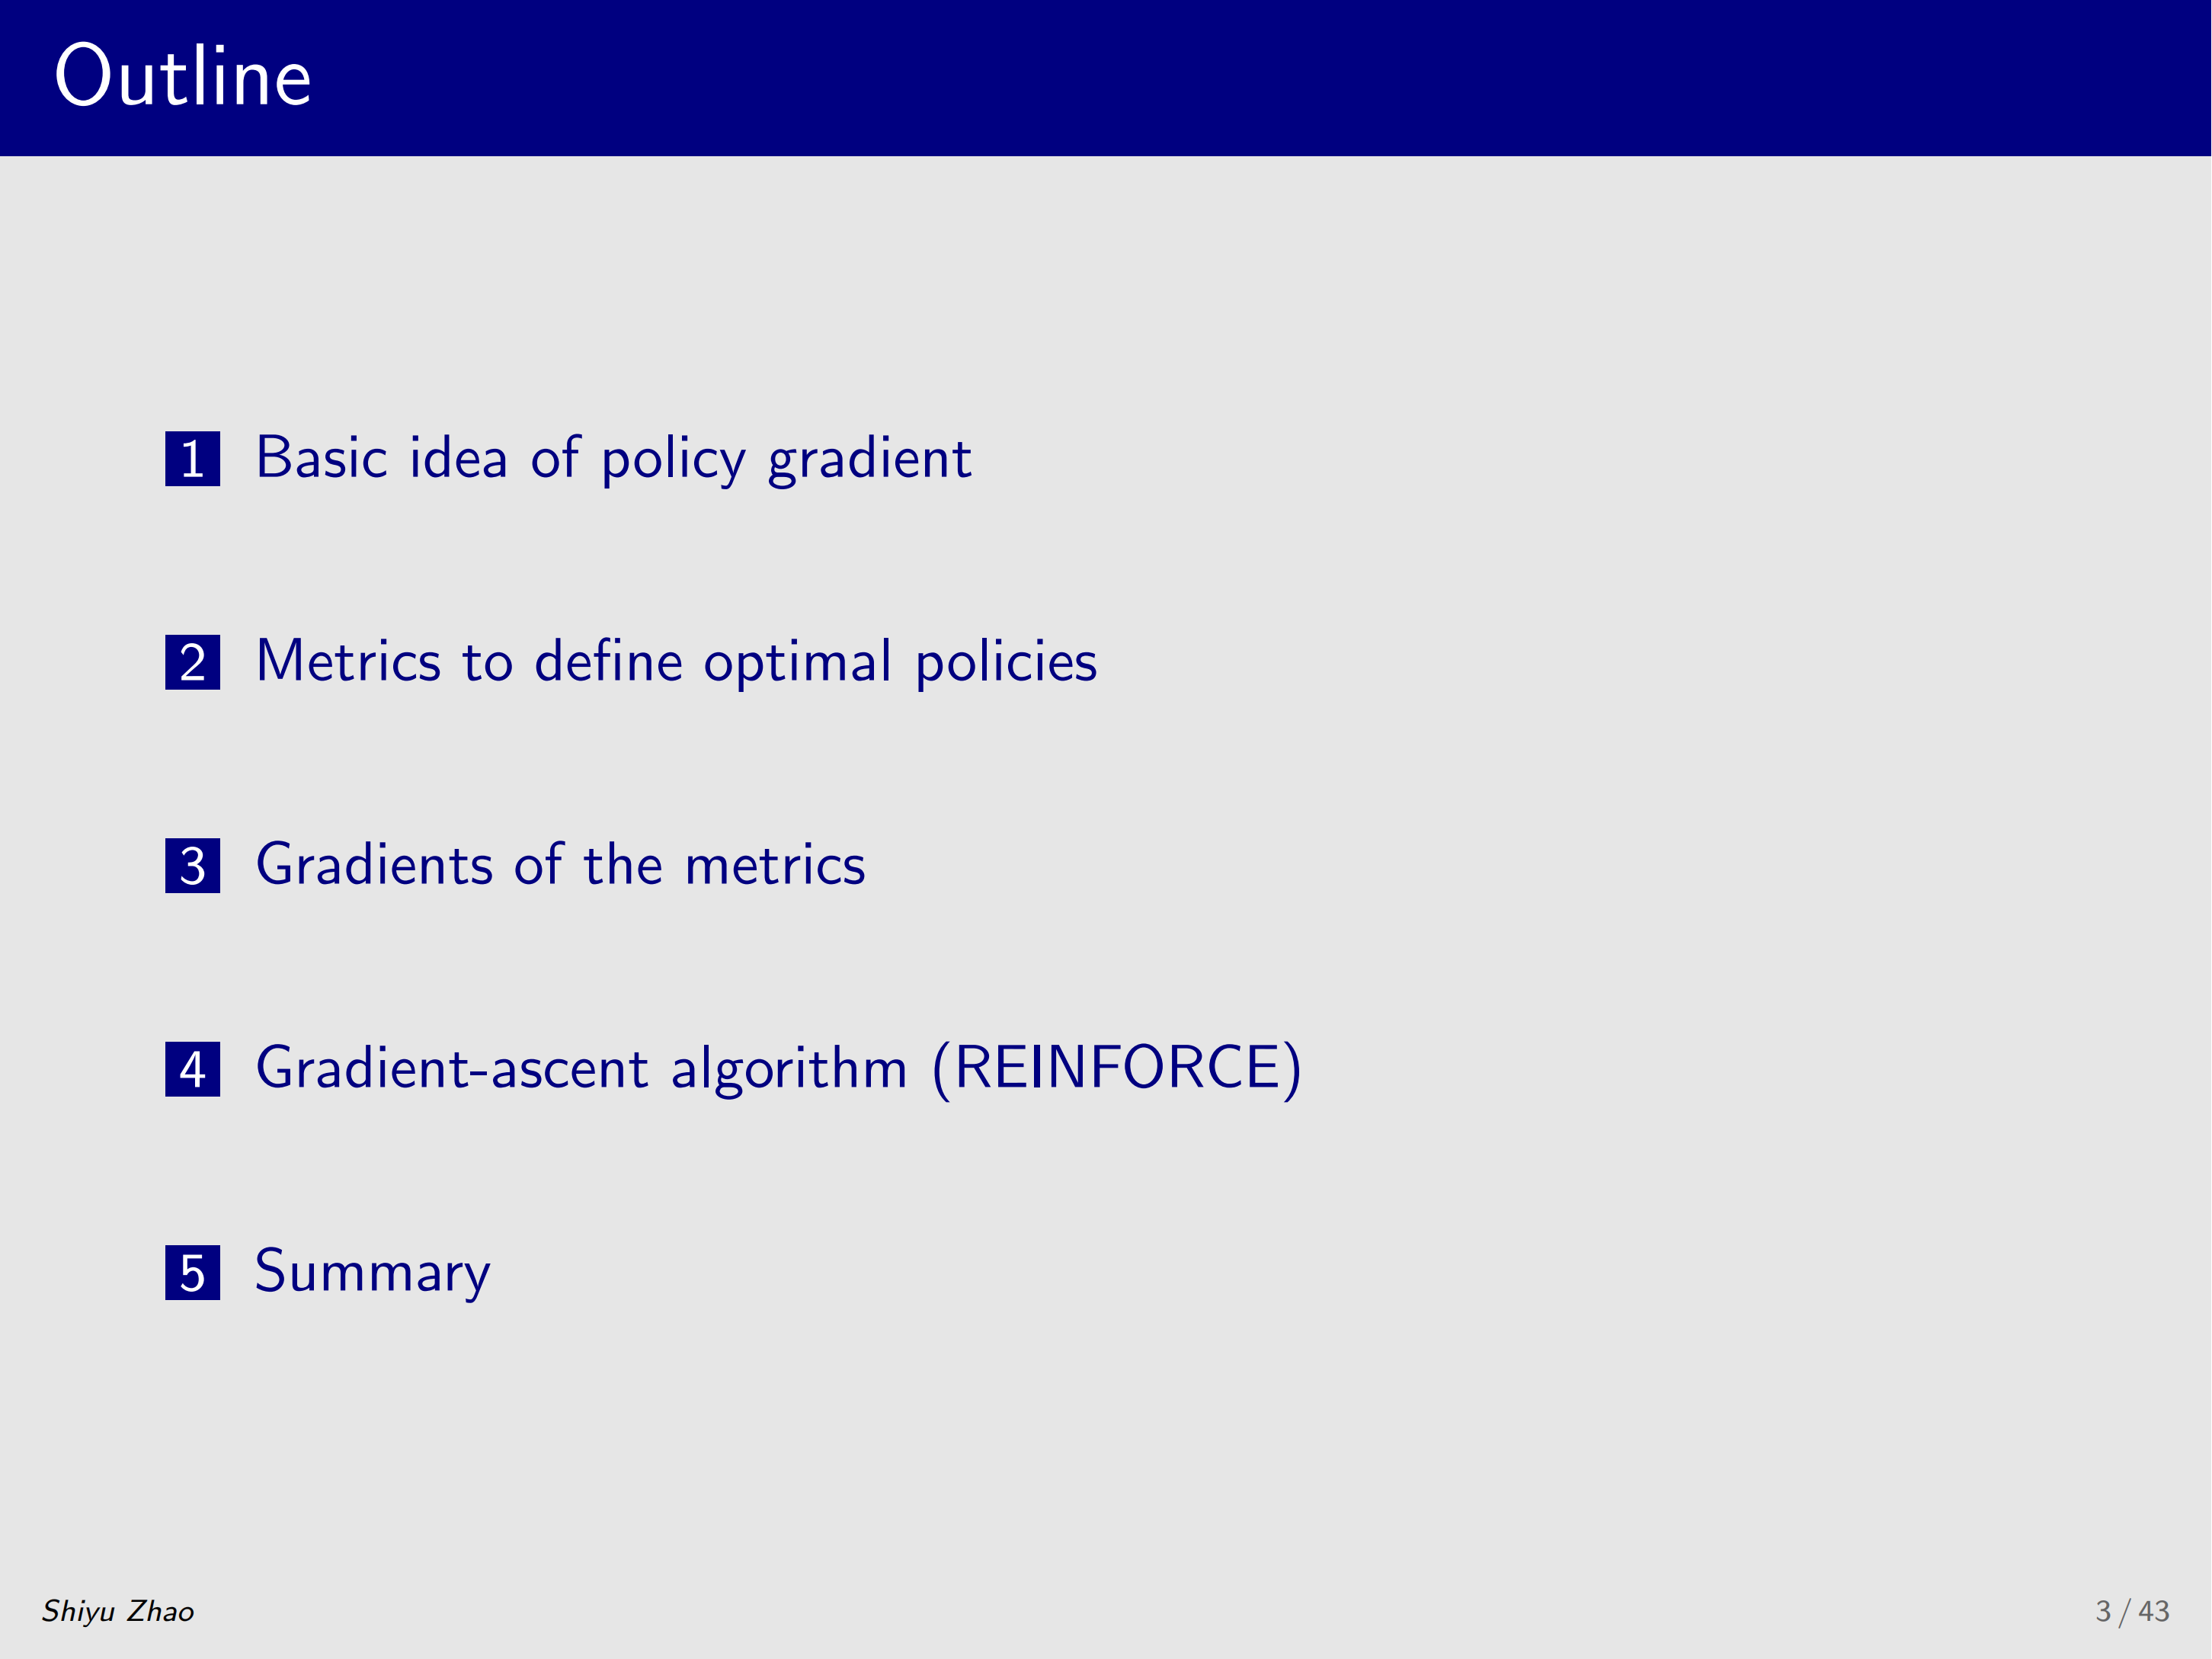
首先介绍 policy gradient 的基本思路,其实非常简单,这也反映在第 2、3、4 节中,也就是首先我们会定义一个 metric ,这个 metric 可以定义什么样的策略是最优的,有了 metric 之后,就去做优化,怎么做优化呢?最简单的方法是 梯度上升,这里要最大化 metric,所以用梯度上升(最小化则用梯度下降)。
应用梯度方法前,先要算出 metric 的梯度,之后给出梯度上升的方法,其中涉及一些技巧,我们会给出一个特别的算法---REINFORCE,它是非常早期的 policy gradient 方法,但非常经典,在此基础之上,可以推广得到许多流行的方法。
2. Basic idea of policy gradient
首先介绍 policy gradient 的基本思路。
| a 1 \textcolor{blue}{a_1} a1 | a 2 \textcolor{blue}{a_2} a2 | a 3 \textcolor{blue}{a_3} a3 | a 4 \textcolor{blue}{a_4} a4 | a 5 \textcolor{blue}{a_5} a5 | |
|---|---|---|---|---|---|
| s 1 \textcolor{blue}{s_1} s1 | π ( a 1 ∣ s 1 ) \pi(a_1\mid s_1) π(a1∣s1) | π ( a 2 ∣ s 1 ) \pi(a_2\mid s_1) π(a2∣s1) | π ( a 3 ∣ s 1 ) \pi(a_3\mid s_1) π(a3∣s1) | π ( a 4 ∣ s 1 ) \pi(a_4\mid s_1) π(a4∣s1) | π ( a 5 ∣ s 1 ) \pi(a_5\mid s_1) π(a5∣s1) |
| ⋮ \vdots ⋮ | ⋮ \vdots ⋮ | ⋮ \vdots ⋮ | ⋮ \vdots ⋮ | ⋮ \vdots ⋮ | ⋮ \vdots ⋮ |
| s 9 \textcolor{blue}{s_9} s9 | π ( a 1 ∣ s 9 ) \pi(a_1\mid s_9) π(a1∣s9) | π ( a 2 ∣ s 9 ) \pi(a_2\mid s_9) π(a2∣s9) | π ( a 3 ∣ s 9 ) \pi(a_3\mid s_9) π(a3∣s9) | π ( a 4 ∣ s 9 ) \pi(a_4\mid s_9) π(a4∣s9) | π ( a 5 ∣ s 9 ) \pi(a_5\mid s_9) π(a5∣s9) |
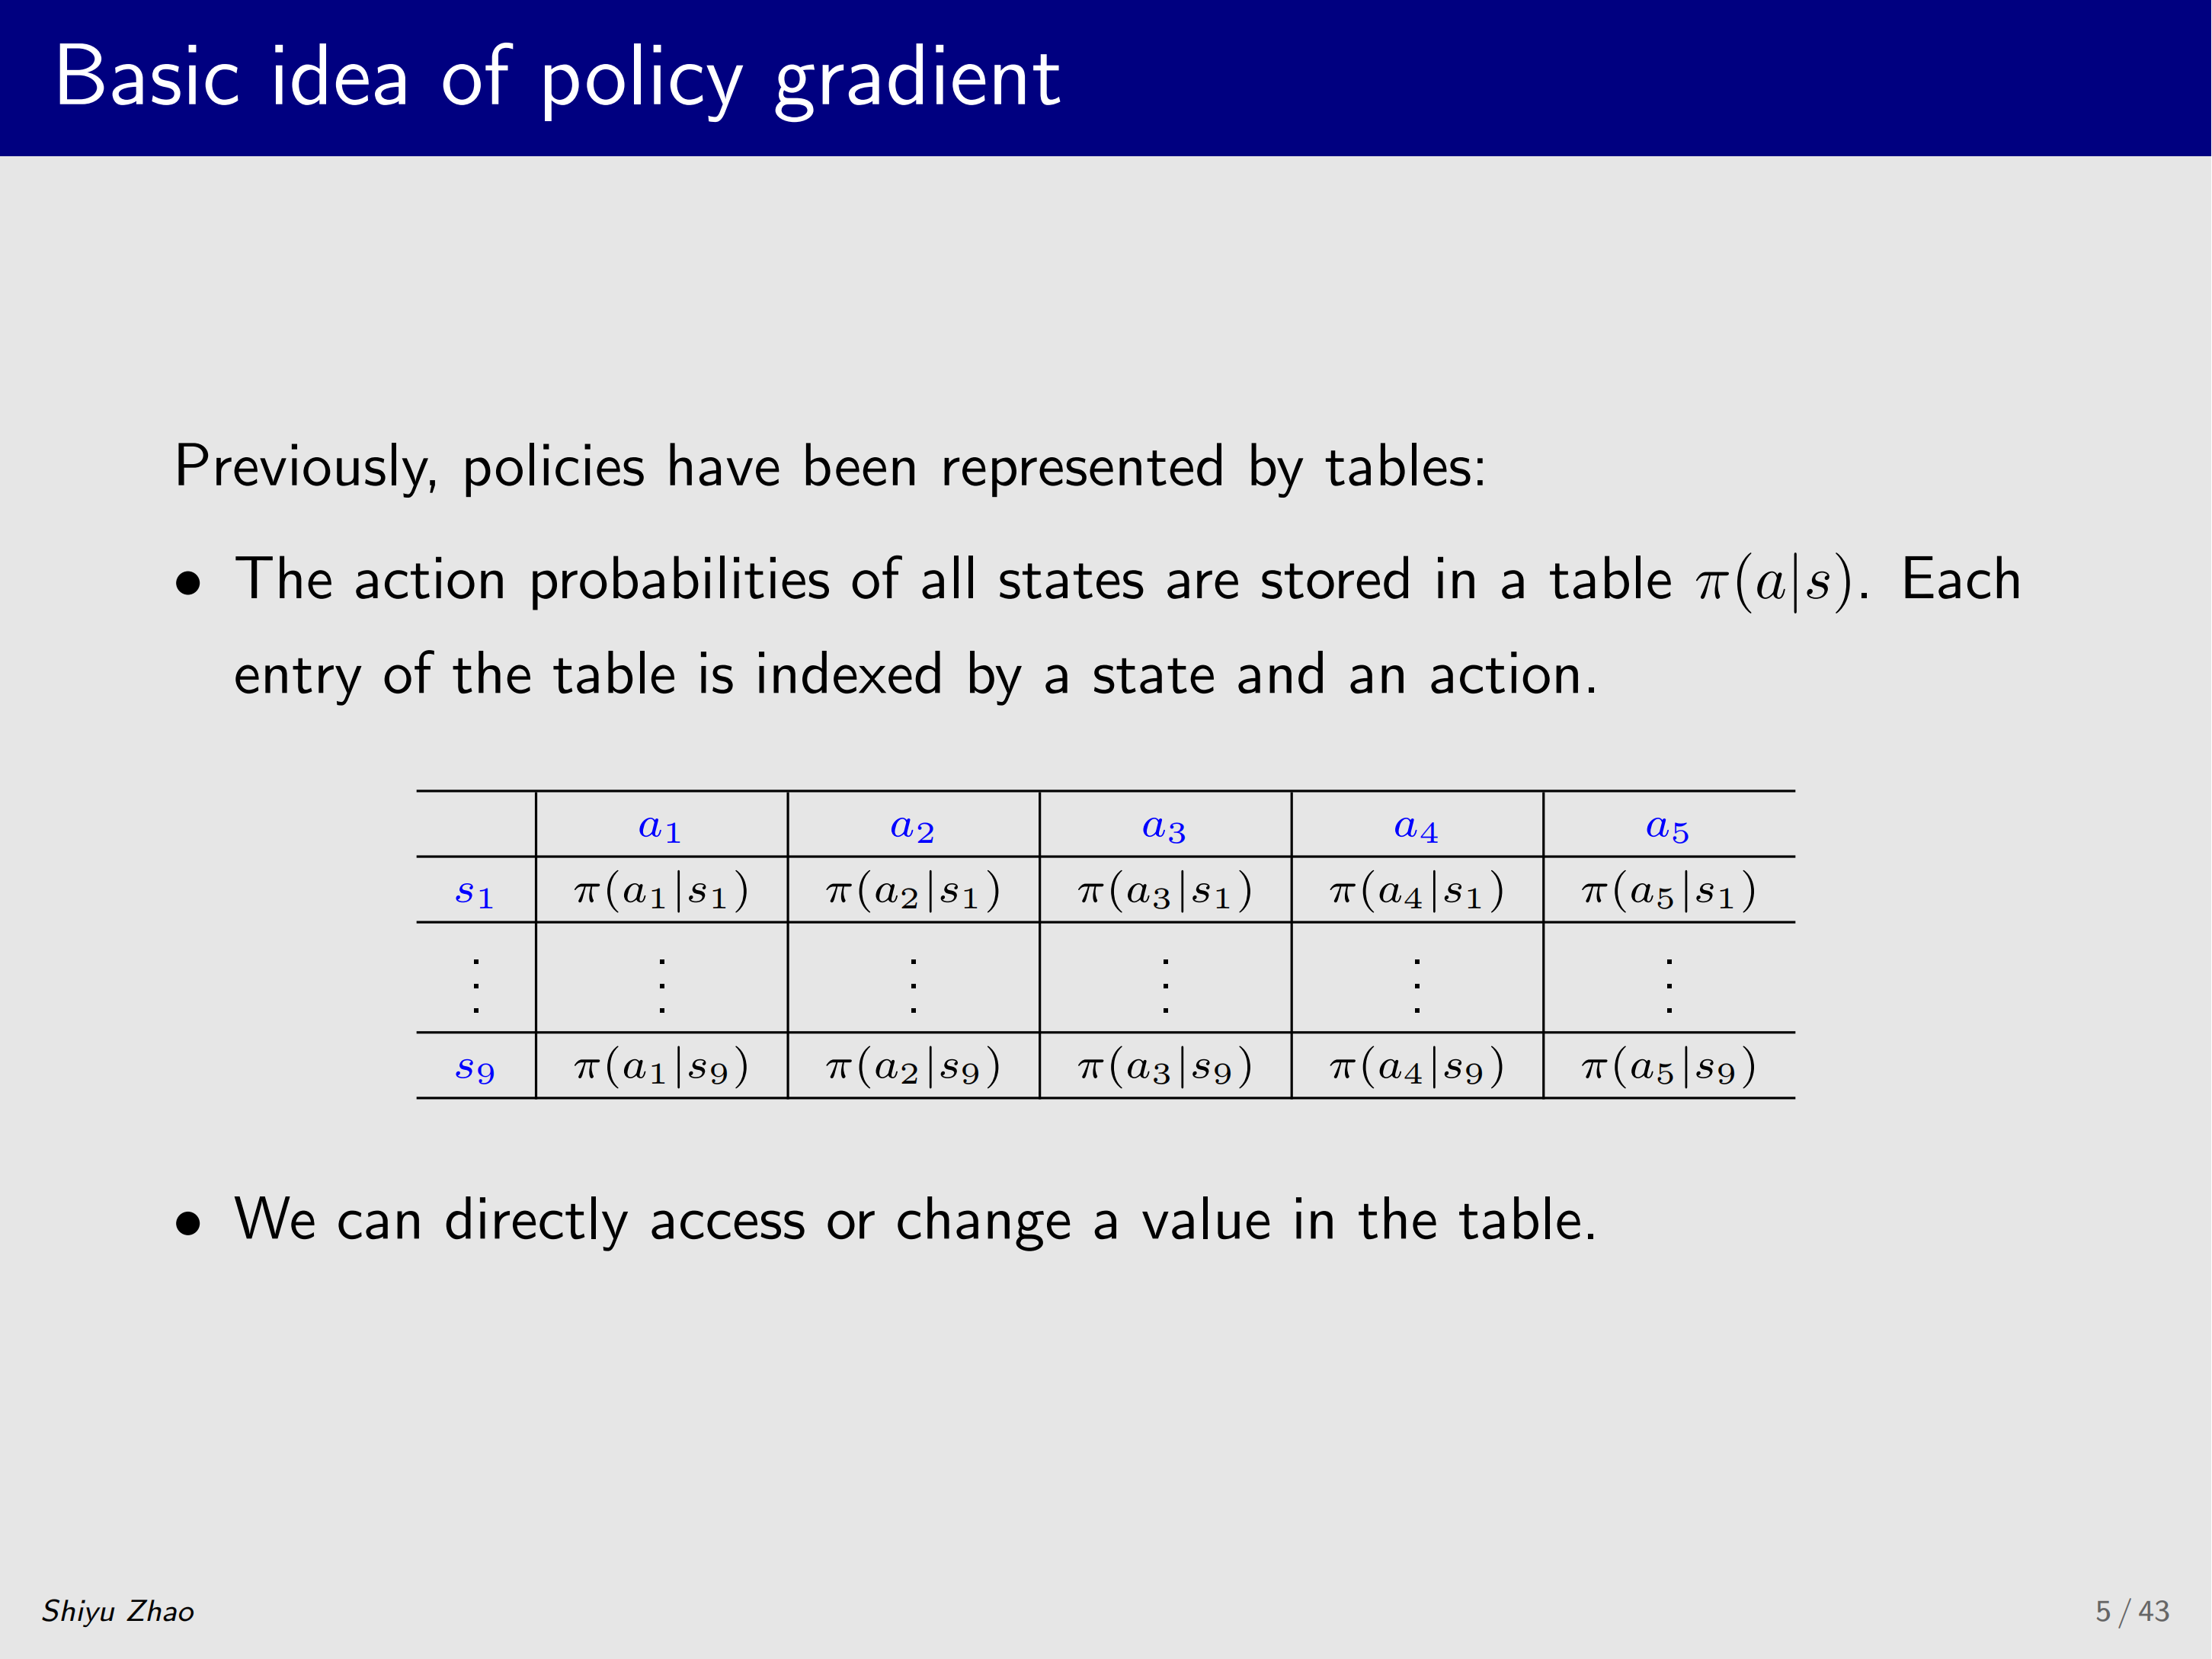
到目前为止,我们所有的策略全都是用 表格 表示的,如上所示,比如:有一些状态,每个状态对应表格的一行;有一些 action,每个 action 对应一列,如果想找某个状态下执行 action a 3 a_3 a3 的概率是多少?直接到表中查即可。
所以之前的策略全部是用表格的形式来表达的,表格的基本操作比较简单,访问或修改一个量,直接通过索引即可,下面我们会把表格改成函数,这时候 π \pi π 的写法也发生了改变:
π ( a ∣ s , θ ) \pi (a \mid s, \theta) π(a∣s,θ)
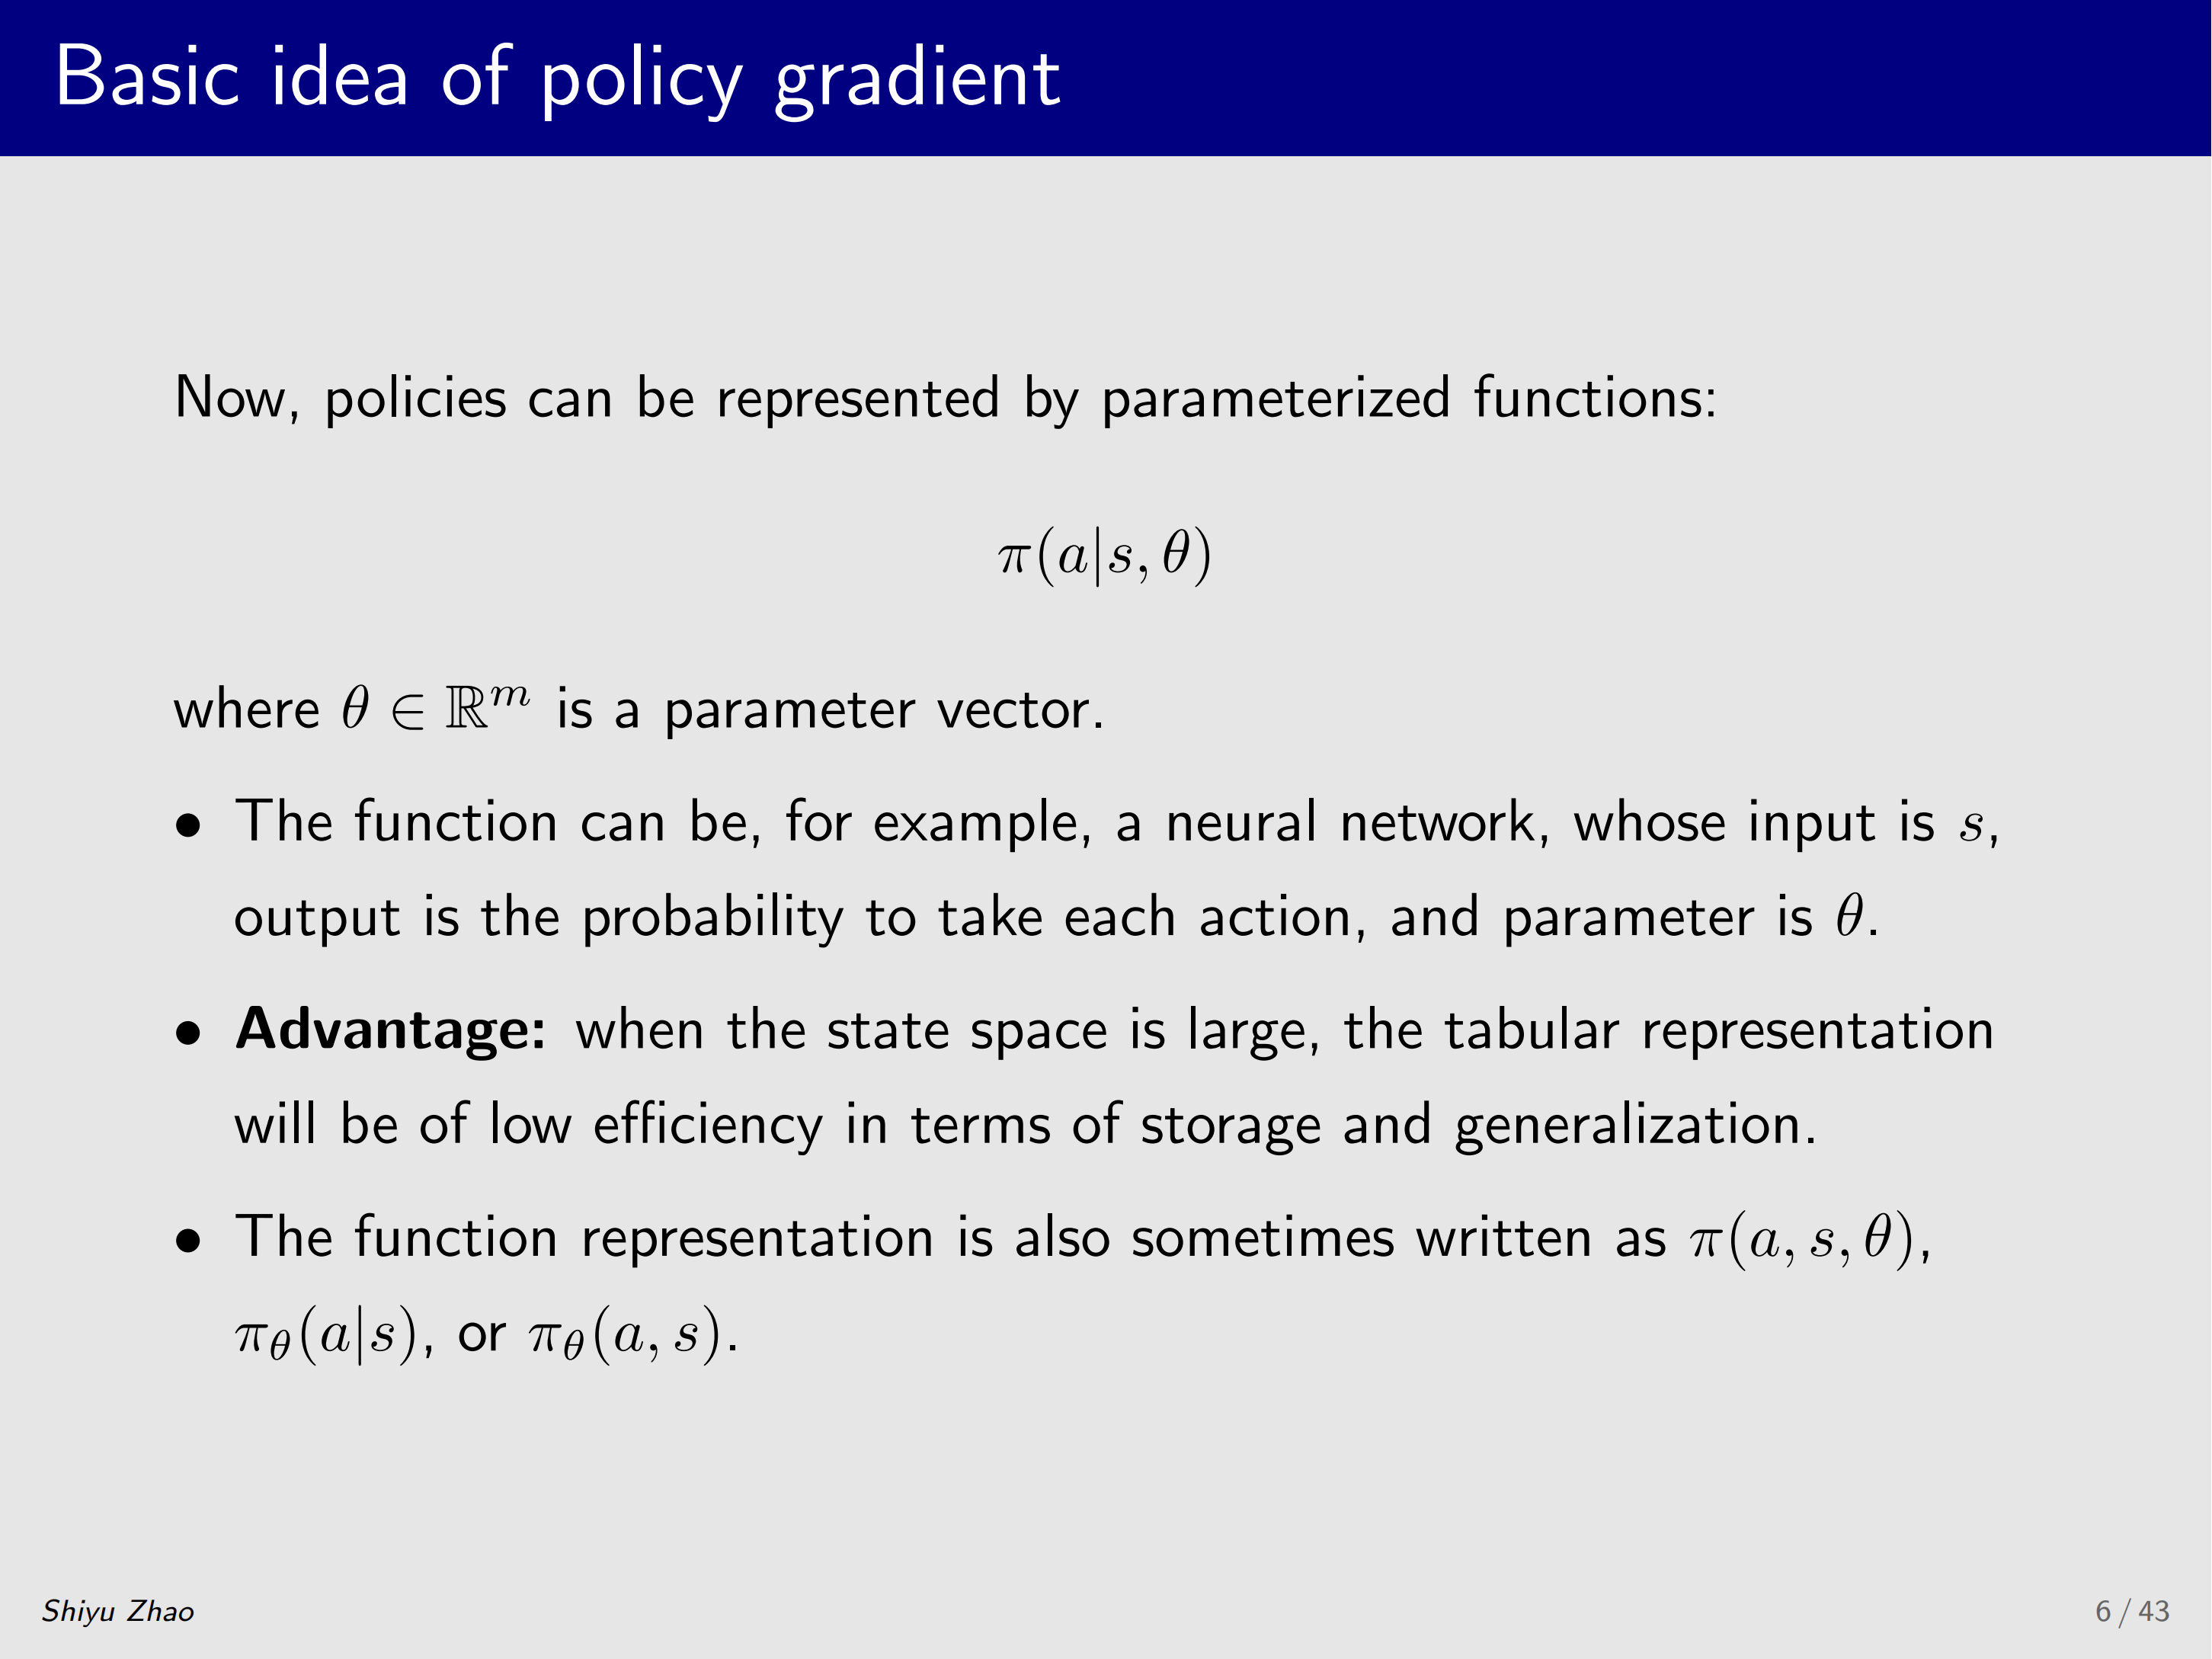
与之前很类似,唯一区别是后面多了 θ \theta θ ,这个 θ \theta θ 是一个向量,表示 π \pi π 这个函数里的参数。目前最广泛使用的函数形式是 神经网络 ,比如:神经网络参数为 θ \theta θ,输入是 s s s ,输出对应所有动作的概率,比如 π ( a 1 ∣ s , θ ) \pi(a_1 \mid s, \theta) π(a1∣s,θ) 一直到 π ( a 5 ∣ s , θ ) \pi(a_5 \mid s, \theta) π(a5∣s,θ)(假设有 5 个 action)。
注意,在 value function approximation 中,value function 的参数用 w w w 来表示, policy 函数的参数用 θ \theta θ 表示。用函数代替表格的好处,与之前介绍的 value function approximation 类似,比如 state space 非常大、状态很多,甚至连续变化(无穷多个),这时表格形式就比较乏力了。
主要体现在两方面:第一,体现在 存储 上:可能要存储非常多数值;另外, 泛化能力 也不如函数形式。稍微说一下泛化是怎么回事:比如说要更新 π ( a ∣ s ) \pi(a|s) π(a∣s) ,如果用表格的话,必须要访问到 s s s 和 a a a 才能更新,但用函数则不需要,因为 访问相邻的 ( s ′ , a ′ ) (s',a') (s′,a′) 并更新参数 θ \theta θ 后,感兴趣的 ( s , a ) (s,a) (s,a) 的概率也随之改变,这就意味着用更少的访问和数据就能得到较好的效果,这就是泛化能力,我们上节课介绍 value function approximation 时也讲过。
π \pi π 的形式可以有多种,可以写成 π ( a ∣ s , θ ) \pi(a | s,\theta) π(a∣s,θ) 这种形式,也可以把竖线去掉写成 π ( a , s , θ ) \pi(a,s,\theta) π(a,s,θ) ,或者把 θ \theta θ 放到下标上写成 π θ ( a ∣ s ) , π θ ( a , s ) \pi_{\theta}(a|s), \pi_{\theta}(a,s) πθ(a∣s),πθ(a,s) 等等都可以。
用表格和函数表示的区别是什么?刚才已提到,下面我们再正式介绍一下。基本上有三点:
第一点: 怎么定义最优策略 。表格情形下,大家还记得最优策略的定义吗?设最优策略为 π ∗ \pi^{*} π∗,则对任何其它策略 π \pi π 和所有 s s s,都有 v π ∗ ( s ) ≥ v π ( s ) v_{\pi^*}(s) \ge v_\pi(s) vπ∗(s)≥vπ(s) ,即 π ∗ \pi^* π∗ 的 state value 不小于任何其它策略的 state value。
这是表格情形下最优策略的定义,在函数情况下则不同,此时 定义一个 scalar metric(标量目标函数),然后优化这个目标函数 ,这个标量目标函数是什么,接下来会介绍,总之, 两者对最优策略的定义不同,导致很多细节不同。
第二个不同是什么呢?
怎么获取某个 action 的概率 。表格形式下,想获取 s s s 处执行 action a a a 的概率,直接查表即可,非常简单。现在也很简单,只不过稍麻烦一点:不能直接索引(不是表格),得算一下,比如是神经网络,就把 s s s 输入做一次 前向传播 ,得到 π ( a 1 ∣ s , θ ) , ... , π ( a 5 ∣ s , θ ) \pi(a_1|s,\theta),\dots,\pi(a_5|s,\theta) π(a1∣s,θ),...,π(a5∣s,θ) 全部概率。
第三点与第二点类似: 怎么更新策略。
表格情形下(之前说过):想改变 π ( a ∣ s ) \pi(a|s) π(a∣s) 的值,直接到表里改即可,非常直截了当。但用函数形式表达就不能这么做了,因为此时函数由 θ \theta θ 表示, 想改变 π ( a ∣ s ) \pi(a|s) π(a∣s) 不能直接赋值,只能按一定规则更新 θ \theta θ ,间接地改变 π ( a ∣ s ) \pi(a | s) π(a∣s) 。
这就是三个基本不同点。下面简要概述。
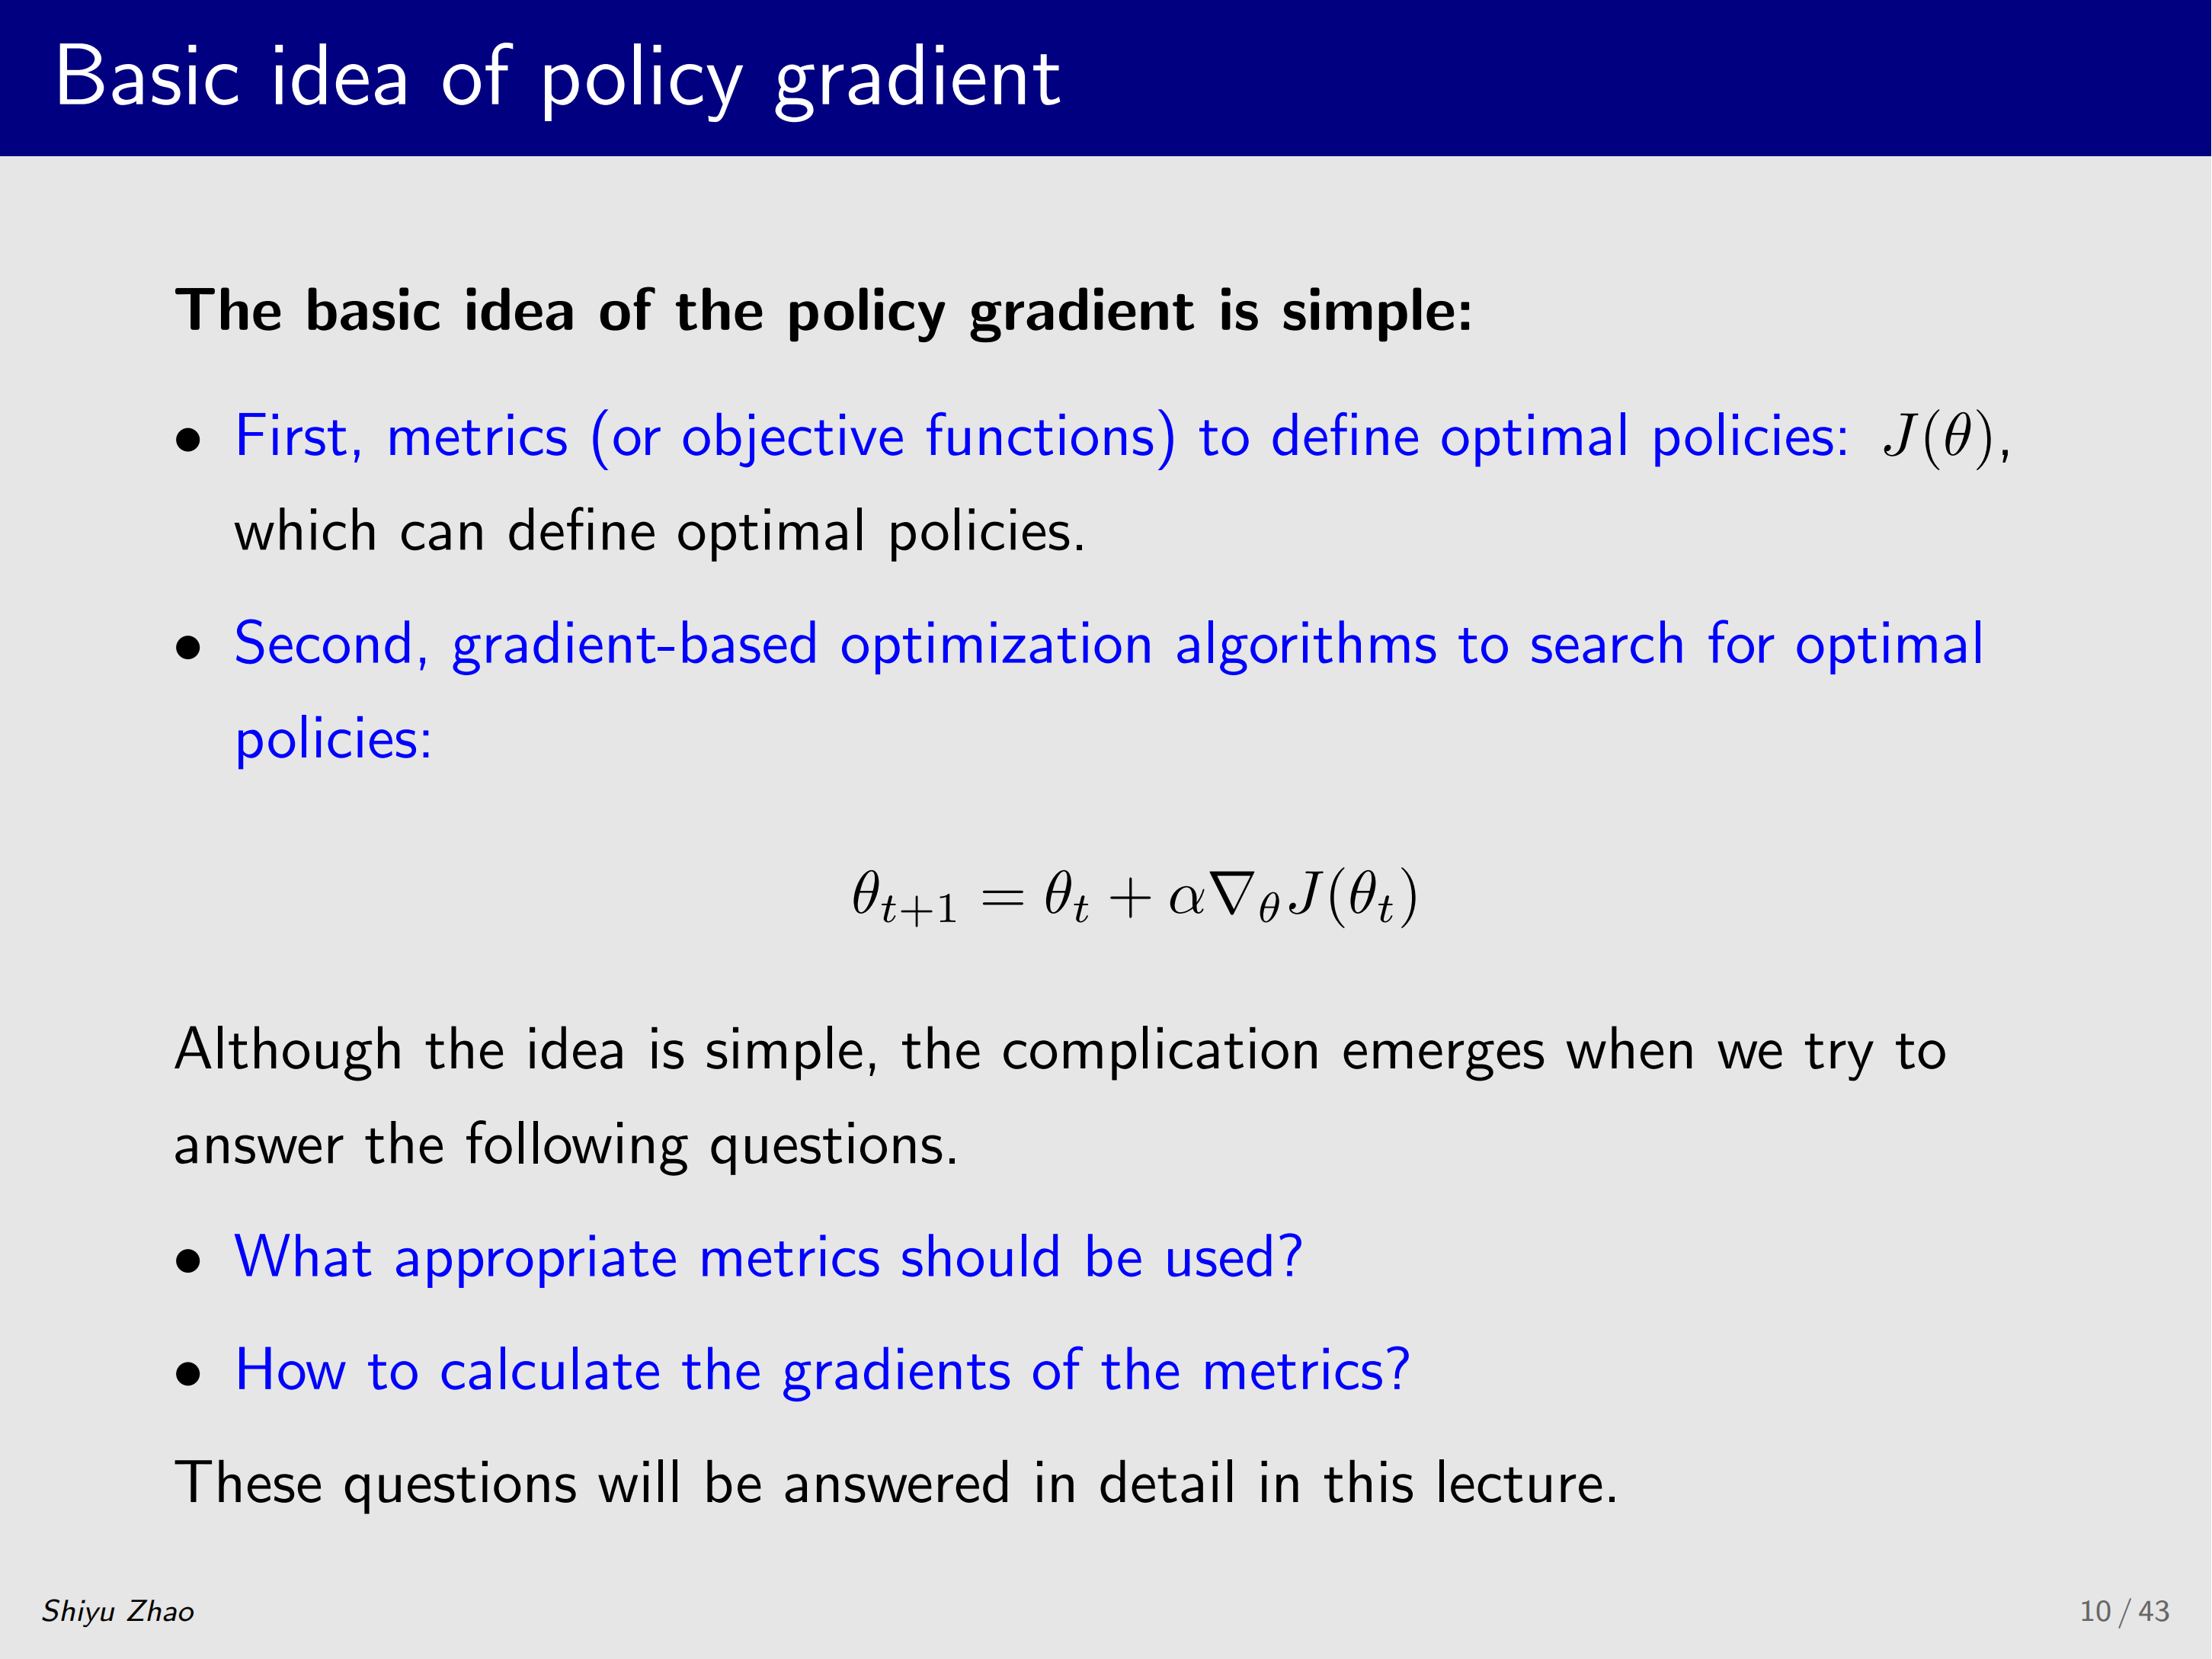
policy gradient 的基本思路 是什么呢?第一:需要一个目标函数来定义最优策略是什么,取 J ( θ ) J(\theta) J(θ) 作为目标函数(具体形式后面详细介绍),这个 θ \theta θ 就是策略所对应的参数,不同参数(不同策略)对应不同的 J ( θ ) J(\theta) J(θ) 值,所以希望这个 J ( θ ) J(\theta) J(θ) 被最大化,最优参数 θ ∗ \theta^* θ∗ 满足 θ ∗ = arg max θ J ( θ ) \theta^* = \arg\max_\theta J(\theta) θ∗=argmaxθJ(θ) 。
有了目标函数就可以做优化,最简单的优化算法就是基于梯度的方法也就是
θ t + 1 = θ t + α ∇ θ J ( θ t ) \theta_{t+1} = \theta_t + \alpha \nabla_\theta J(\theta_t) θt+1=θt+α∇θJ(θt)
所以整个思路非常简单,但是会有比较复杂的东西出现在什么地方呢?第一: 怎么取目标函数,这里面有一些学问 ,第二, 如何求解目标函数的梯度,届时会看到它涉及著名的 policy gradient 定理,也有较复杂之处,这些本节课都会详细介绍。
结语
本讲第一部分完成了从 value-based 到 policy-based 的关键转向。策略从表格表示升级为参数化函数 π ( a ∣ s , θ ) \pi(a|s,\theta) π(a∣s,θ)(最常用的即神经网络),带来了存储与泛化两大优势,也带来了三点本质差异:最优策略的定义从 "逐状态比较 state value" 变为 "最大化标量指标 J ( θ ) J(\theta) J(θ)";获取动作概率从查表变为前向传播计算;更新策略从直接改值变为更新参数 θ \theta θ 间接影响。
Policy gradient 的整体思路因此格外简洁:定义目标函数 J ( θ ) J(\theta) J(θ) → 用梯度上升 θ t + 1 = θ t + α ∇ θ J ( θ t ) \theta_{t+1} = \theta_t + \alpha\nabla_\theta J(\theta_t) θt+1=θt+α∇θJ(θt) 最大化之。真正的难点隐藏在细节之中---目标函数应该如何构造才能正确度量策略的优劣?梯度又该如何计算?后者将由著名的 policy gradient 定理给出答案,这也是本讲后续部分的核心内容。至此,强化学习两大范式(基于值、基于策略)的版图已完整呈现,而即将到来的 actor-critic 将见证二者的融合🤗。