CREATE INDEX CONCURRENTLY:线上建索引不阻塞 DML 的代价与坑
标签:#PostgreSQL #索引 #运维
CREATE INDEX CONCURRENTLY:线上建索引不阻塞 DML 的代价与坑
标签:#PostgreSQL #索引 #运维
一、前言
你有没有遇到过:上线前想给一张千万级大表加个索引,CREATE INDEX 一执行,业务方立刻告警------写入超时、消息积压、订单量暴跌?
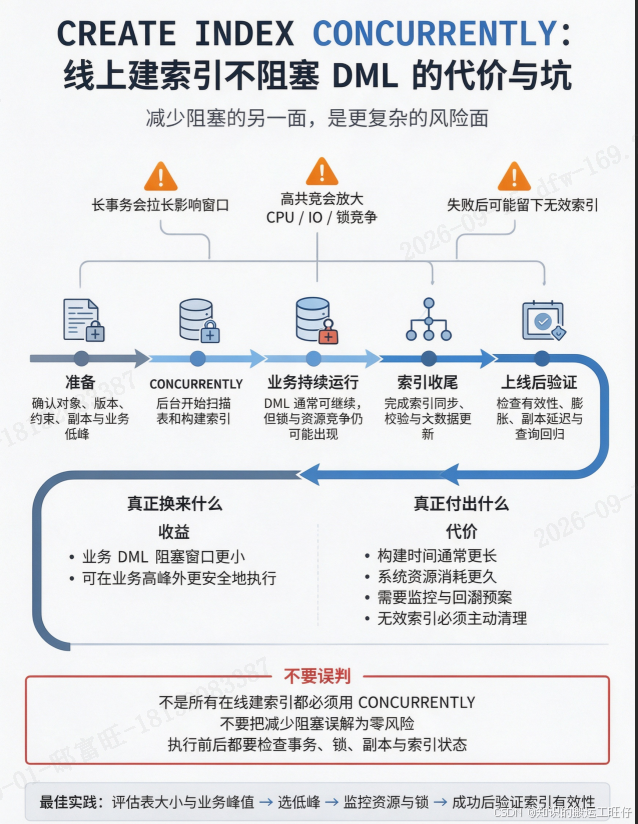
这不是偶发事故,而是 PostgreSQL 的默认行为 :普通 CREATE INDEX 会锁住表的写操作,直到索引构建完成。大表建索引动辄几十分钟甚至几小时,期间所有 INSERT / UPDATE / DELETE 全部排队。解法就在关键字 CONCURRENTLY 里,但它不是免费的,还有几个必须知道的坑。
二、核心开发规范
- 生产环境大表加索引必须用
CONCURRENTLY:普通CREATE INDEX会阻塞 DML(写操作),CONCURRENTLY全程不阻塞写入; - 接受它的代价 :
CONCURRENTLY需要两次扫描全表、等待旧事务结束,耗时显著更长,构建期间额外的 CPU / I/O 负载可能拖慢其他操作; - 失败会留下 invalid 索引 :构建失败后索引以
INVALID状态残留,仍持续消耗更新开销,必须DROP后重试。
三、底层原理通俗讲解
- 普通 CREATE INDEX(默认) :在表上持有排他级别的表锁,锁写不锁读 ------其他事务仍可
SELECT,但INSERT / UPDATE / DELETE全部阻塞到构建完成。整个过程单次扫描全表,速度快,但大表会锁住写入很久; - CREATE INDEX CONCURRENTLY :全程不持有阻塞写入的锁。实现上分 3 个事务:第一个事务先把索引以
invalid状态登记进系统目录,后两个事务各做一次全表扫描 ;每次扫描前等待修改过该表的事务结束,第二次扫描后还要等待快照更早的事务结束,最后标记valid才正式可用; - 为什么更慢:两次扫描 + 多次等待 + 构建期间 DML 还在并发进行(新写入的行也要进索引),总工作量比普通构建大得多,耗时显著变长;
- 不是完全免费:构建期间产生的额外 CPU 和 I/O 负载,可能让其他查询变慢------选业务低峰期执行更稳妥。
四、实战错误案例&优化方案
场景1:线上大表直接 CREATE INDEX(最高频事故)
表设计:orders 表,千万级行,user_id BIGINT
❌ 错误写法(不加 CONCURRENTLY,写操作全被锁住)
sql
CREATE INDEX idx_orders_user_id ON orders (user_id);
-- 构建期间:orders 表所有 INSERT / UPDATE / DELETE 全部阻塞
-- 大表可能阻塞几十分钟到几小时,业务写入超时、积压、告警
✅ 正确写法(加 CONCURRENTLY,DML 无感知)
sql
CREATE INDEX CONCURRENTLY idx_orders_user_id ON orders (user_id);
-- 构建期间 DML 正常执行,索引构建完成后自动标记 valid 生效
关键结论 :生产环境大表加索引,CONCURRENTLY 不是可选项,是必选项 ;SELECT 不阻塞但 DML 阻塞的普通构建,只适合小表或可接受停写的场景。
场景2:CONCURRENTLY 失败,留下 invalid 索引
❌ 危险现象:构建过程中出现死锁 / 唯一索引冲突,命令报错
sql
CREATE UNIQUE INDEX CONCURRENTLY idx_orders_user_id ON orders (user_id);
-- ERROR: deadlock detected(或其他失败)
-- 但索引已以 INVALID 状态残留:
-- 查询系统目录可以看到 INVALID 状态:
SELECT indexname, indexdef FROM pg_indexes WHERE tablename = 'orders';
--   Indexes:
--       "idx_orders_user_id" btree (user_id) INVALID
⚠️ 残留的 invalid 索引:查询会忽略它,但每次 DML 仍会更新它------白白消耗开销,必须清理。
✅ 正确处理:先 DROP 清理,再重试
sql
DROP INDEX IF EXISTS idx_orders_user_id;                    -- 清理 invalid 索引
CREATE INDEX CONCURRENTLY idx_orders_user_id ON orders (user_id);  -- 重试
-- 或者直接用:REINDEX INDEX CONCURRENTLY idx_orders_user_id(PG 12+)
关键结论 :CONCURRENTLY 失败不是"没建成",而是"留了个累赘"------上线脚本里务必带上失败后的清理步骤,否则 invalid 索引会持续吃掉更新性能。
场景3:事务块内使用 CONCURRENTLY(直接报错)
❌ 错误写法(放在 BEGIN ... COMMIT 里)
sql
BEGIN;
CREATE INDEX CONCURRENTLY idx_orders_user_id ON orders (user_id);
-- ERROR: CREATE INDEX CONCURRENTLY cannot run inside a transaction block
COMMIT;
✅ 正确写法(单独执行,走自动提交;普通 CREATE INDEX 才允许在事务块内)
sql
CREATE INDEX CONCURRENTLY idx_orders_user_id ON orders (user_id);关键结论 :CONCURRENTLY 内部依赖多个事务完成构建,不能放进事务块;把它当作独立的一条命令执行。
场景4:同表并发构建 & 分区表限制
❌ 误区:一张表同时发起两个 CONCURRENTLY
sql
-- 会话 A
CREATE INDEX CONCURRENTLY idx_a ON orders (user_id);
-- 会话 B:同一张表的第二个并发构建会一直等待
CREATE INDEX CONCURRENTLY idx_b ON orders (status);
✅ 正确做法:同一张表同一时间只允许一个并发构建,逐个执行;普通(非并发)构建可以多个并行,但生产大表请勿使用。
⚠️ 分区表限制:对分区表本身不支持 CONCURRENTLY(PG 13 及以下),正确姿势是逐个分区并发构建,最后在父表上非并发建一次(仅元数据操作)。
关键结论:并发建索引是"单车道"------同一张表同时只能有一个;分区表要逐个分区处理。
五、绝对禁止的写法汇总
- 生产大表不加 CONCURRENTLY 直接
CREATE INDEX(DML 全阻塞); - 在事务块内 执行
CREATE INDEX CONCURRENTLY(直接报错); - 并发构建失败后不清理 invalid 索引(持续消耗更新开销);
- 同一张表同时发起多个
CREATE INDEX CONCURRENTLY(互相等待); - 对分区表 直接
CREATE INDEX CONCURRENTLY(不支持,应逐分区处理)。
六、最终评审口诀(记住不踩坑)
线上大表建索引,CONCURRENTLY 不能省;
失败留下 invalid,DROP 重来才算成。
七、总结
- 要不要并发 :生产大表加索引一律
CREATE INDEX CONCURRENTLY,小表 / 可停写场景才用普通构建; - 代价要清楚:两次扫描、耗时显著更长、额外 CPU / I/O 负载------选低峰期执行,别在业务高峰硬来;
- 坑要提前排:不能进事务块、同表只能一个并发、分区表逐分区处理、失败必清理 invalid 索引;
- 监控手段 :构建期间可用
pg_stat_progress_create_index视图查看进度,做到心里有数。
标签:PostgreSQL 数据库 运维
参考来源
- PostgreSQL 官方文档 CREATE INDEX(CONCURRENTLY 定义与 Building Indexes Concurrently 完整注意事项)------ https://www.postgresql.org/docs/17/sql-createindex.html
一、前言
你有没有遇到过:上线前想给一张千万级大表加个索引,CREATE INDEX 一执行,业务方立刻告警------写入超时、消息积压、订单量暴跌?
这不是偶发事故,而是 PostgreSQL 的默认行为 :普通 CREATE INDEX 会锁住表的写操作,直到索引构建完成。大表建索引动辄几十分钟甚至几小时,期间所有 INSERT / UPDATE / DELETE 全部排队。解法就在关键字 CONCURRENTLY 里,但它不是免费的,还有几个必须知道的坑。
二、核心开发规范
- 生产环境大表加索引必须用
CONCURRENTLY:普通CREATE INDEX会阻塞 DML(写操作),CONCURRENTLY全程不阻塞写入; - 接受它的代价 :
CONCURRENTLY需要两次扫描全表、等待旧事务结束,耗时显著更长,构建期间额外的 CPU / I/O 负载可能拖慢其他操作; - 失败会留下 invalid 索引 :构建失败后索引以
INVALID状态残留,仍持续消耗更新开销,必须DROP后重试。
三、底层原理通俗讲解
- 普通 CREATE INDEX(默认) :在表上持有排他级别的表锁,锁写不锁读 ------其他事务仍可
SELECT,但INSERT / UPDATE / DELETE全部阻塞到构建完成。整个过程单次扫描全表,速度快,但大表会锁住写入很久; - CREATE INDEX CONCURRENTLY :全程不持有阻塞写入的锁。实现上分 3 个事务:第一个事务先把索引以
invalid状态登记进系统目录,后两个事务各做一次全表扫描 ;每次扫描前等待修改过该表的事务结束,第二次扫描后还要等待快照更早的事务结束,最后标记valid才正式可用; - 为什么更慢:两次扫描 + 多次等待 + 构建期间 DML 还在并发进行(新写入的行也要进索引),总工作量比普通构建大得多,耗时显著变长;
- 不是完全免费:构建期间产生的额外 CPU 和 I/O 负载,可能让其他查询变慢------选业务低峰期执行更稳妥。
四、实战错误案例&优化方案
场景1:线上大表直接 CREATE INDEX(最高频事故)
表设计:orders 表,千万级行,user_id BIGINT
❌ 错误写法(不加 CONCURRENTLY,写操作全被锁住)
sql
CREATE INDEX idx_orders_user_id ON orders (user_id);
-- 构建期间:orders 表所有 INSERT / UPDATE / DELETE 全部阻塞
-- 大表可能阻塞几十分钟到几小时,业务写入超时、积压、告警
✅ 正确写法(加 CONCURRENTLY,DML 无感知)
sql
CREATE INDEX CONCURRENTLY idx_orders_user_id ON orders (user_id);
-- 构建期间 DML 正常执行,索引构建完成后自动标记 valid 生效
关键结论 :生产环境大表加索引,CONCURRENTLY 不是可选项,是必选项 ;SELECT 不阻塞但 DML 阻塞的普通构建,只适合小表或可接受停写的场景。
场景2:CONCURRENTLY 失败,留下 invalid 索引
❌ 危险现象:构建过程中出现死锁 / 唯一索引冲突,命令报错
sql
CREATE UNIQUE INDEX CONCURRENTLY idx_orders_user_id ON orders (user_id);
-- ERROR: deadlock detected(或其他失败)
-- 但索引已以 INVALID 状态残留:
-- 查询系统目录可以看到 INVALID 状态:
SELECT indexname, indexdef FROM pg_indexes WHERE tablename = 'orders';
--   Indexes:
--       "idx_orders_user_id" btree (user_id) INVALID
⚠️ 残留的 invalid 索引:查询会忽略它,但每次 DML 仍会更新它------白白消耗开销,必须清理。
✅ 正确处理:先 DROP 清理,再重试
sql
DROP INDEX IF EXISTS idx_orders_user_id;                    -- 清理 invalid 索引
CREATE INDEX CONCURRENTLY idx_orders_user_id ON orders (user_id);  -- 重试
-- 或者直接用:REINDEX INDEX CONCURRENTLY idx_orders_user_id(PG 12+)
关键结论 :CONCURRENTLY 失败不是"没建成",而是"留了个累赘"------上线脚本里务必带上失败后的清理步骤,否则 invalid 索引会持续吃掉更新性能。
场景3:事务块内使用 CONCURRENTLY(直接报错)
❌ 错误写法(放在 BEGIN ... COMMIT 里)
sql
BEGIN;
CREATE INDEX CONCURRENTLY idx_orders_user_id ON orders (user_id);
-- ERROR: CREATE INDEX CONCURRENTLY cannot run inside a transaction block
COMMIT;
✅ 正确写法(单独执行,走自动提交;普通 CREATE INDEX 才允许在事务块内)
sql
CREATE INDEX CONCURRENTLY idx_orders_user_id ON orders (user_id);关键结论 :CONCURRENTLY 内部依赖多个事务完成构建,不能放进事务块;把它当作独立的一条命令执行。
场景4:同表并发构建 & 分区表限制
❌ 误区:一张表同时发起两个 CONCURRENTLY
sql
-- 会话 A
CREATE INDEX CONCURRENTLY idx_a ON orders (user_id);
-- 会话 B:同一张表的第二个并发构建会一直等待
CREATE INDEX CONCURRENTLY idx_b ON orders (status);
✅ 正确做法:同一张表同一时间只允许一个并发构建,逐个执行;普通(非并发)构建可以多个并行,但生产大表请勿使用。
⚠️ 分区表限制:对分区表本身不支持 CONCURRENTLY(PG 13 及以下),正确姿势是逐个分区并发构建,最后在父表上非并发建一次(仅元数据操作)。
关键结论:并发建索引是"单车道"------同一张表同时只能有一个;分区表要逐个分区处理。
五、绝对禁止的写法汇总
- 生产大表不加 CONCURRENTLY 直接
CREATE INDEX(DML 全阻塞); - 在事务块内 执行
CREATE INDEX CONCURRENTLY(直接报错); - 并发构建失败后不清理 invalid 索引(持续消耗更新开销);
- 同一张表同时发起多个
CREATE INDEX CONCURRENTLY(互相等待); - 对分区表 直接
CREATE INDEX CONCURRENTLY(不支持,应逐分区处理)。
六、最终评审口诀(记住不踩坑)
线上大表建索引,CONCURRENTLY 不能省;
失败留下 invalid,DROP 重来才算成。
七、总结
- 要不要并发 :生产大表加索引一律
CREATE INDEX CONCURRENTLY,小表 / 可停写场景才用普通构建; - 代价要清楚:两次扫描、耗时显著更长、额外 CPU / I/O 负载------选低峰期执行,别在业务高峰硬来;
- 坑要提前排:不能进事务块、同表只能一个并发、分区表逐分区处理、失败必清理 invalid 索引;
- 监控手段 :构建期间可用
pg_stat_progress_create_index视图查看进度,做到心里有数。
标签:PostgreSQL 数据库 运维
参考来源
- PostgreSQL 官方文档 CREATE INDEX(CONCURRENTLY 定义与 Building Indexes Concurrently 完整注意事项)------ https://www.postgresql.org/docs/17/sql-createindex.html