系列文章目录
文章目录
- 系列文章目录
- 前言
- 一、理解内核链表
-
- [1.1 原有链表的不足](#1.1 原有链表的不足)
- [1.2 Linux进程链表](#1.2 Linux进程链表)
- [1.3 连接器结构设计的意义](#1.3 连接器结构设计的意义)
-
- [1.3.1 类型转换和地址偏移定位](#1.3.1 类型转换和地址偏移定位)
- [1.3.2 实现信息的"流动"](#1.3.2 实现信息的“流动”)
-
- [1.3.2.1 组件的体现](#1.3.2.1 组件的体现)
- [1.3.2.2 流动的体现](#1.3.2.2 流动的体现)
- 二、进程优先级
-
- [2.1 进程优先级的定义](#2.1 进程优先级的定义)
- [2.2 进程优先级的意义](#2.2 进程优先级的意义)
-
- [2.2.1 对比:优先级 vs 权限](#2.2.1 对比:优先级 vs 权限)
- [2.3 进程优先级的实现](#2.3 进程优先级的实现)
-
- [2.3.1 分时操作系统](#2.3.1 分时操作系统)
- [2.3.2 时间片轮转](#2.3.2 时间片轮转)
- 三、优先级的查看与实现
-
- [3.1 UID:user id](#3.1 UID:user id)
- [3.2 进程优先级查看](#3.2 进程优先级查看)
- [3.3 进程优先级实现](#3.3 进程优先级实现)
- [3.4 优先级的修改](#3.4 优先级的修改)
-
- [3.4.1 命令行修改](#3.4.1 命令行修改)
-
- [3.4.1.1 nice 与 renice](#3.4.1.1 nice 与 renice)
- [3.4.1.2 top](#3.4.1.2 top)
- [3.4.2 系统调用](#3.4.2 系统调用)
- [3.5 nice的极值问题](#3.5 nice的极值问题)
-
- [3.5.1 nice 的范围](#3.5.1 nice 的范围)
- [3.5.1 范围限定的意义](#3.5.1 范围限定的意义)
- 总结
前言
大家好,我是曦夜日长。在上一节我们了解了进程的状态以及具体的表现形式,本节我们将回到进程的运行过程中------进程优先级,让我们话不多说,开始本节的学习。
一、理解内核链表
从前面的学习可知:计算机都是以进程为基本单位执行的。而PCB作为进程的信息,在os中数量肯定数不胜数,而我们之前所说的队列一般只存储运行态R的PCB,那其他的PCB怎么管理呢?
1.1 原有链表的不足
Linux设定用链表管理,但 "此链表,非彼链表"。我们理解的链表结构belike:
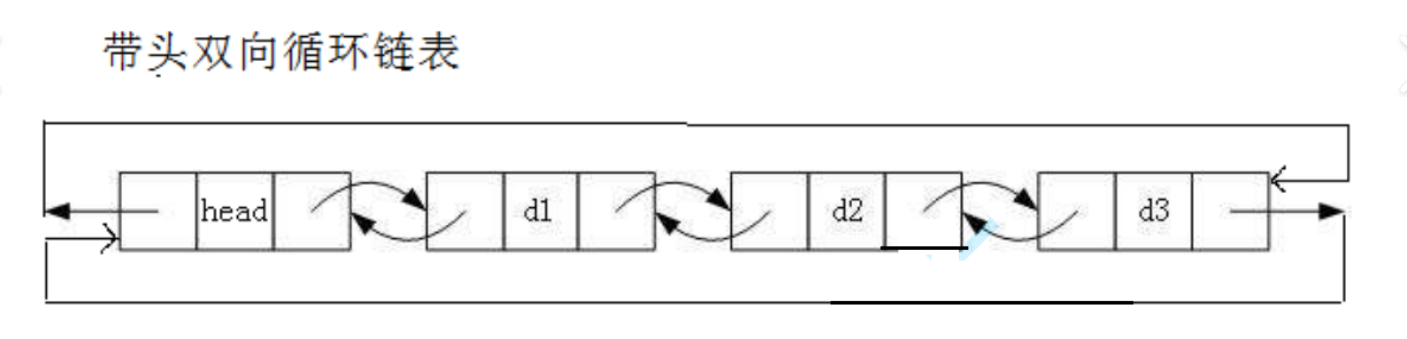
而Linux链表,站在全局考虑,解决原有链表不足:
| 问题 | 说明 |
|---|---|
| 每种类型都要写一套 | task_node、file_node、device_node......代码爆炸 |
| 多一次内存分配 | 挂一个对象,要额外分配一个 node |
| 多一次指针跳转 | node->data->pid,缓存不友好 |
| 对象和节点生命周期不一致 | 节点释放了对象还在?对象释放了节点还在? |
| 一个对象只能挂一条链表 | 因为只有一个 data 指针 |
1.2 Linux进程链表
于是将数据,与封装后的指针解耦,形成连接器结构:
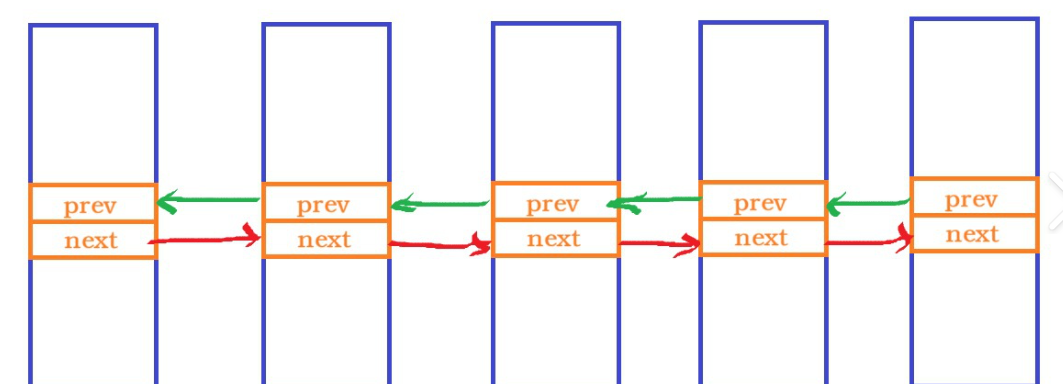
具体的代码:
bash
//部分代码
struct list_head {
    struct list_head *next, *prev;
};
struct task_struct{
    int x, y, z;
    struct list_head links;
};
1.3 连接器结构设计的意义
1.3.1 类型转换和地址偏移定位
通过这样的封装指针便于我们直接获取结构体地址,而这样的指针我们如何去获取其指向的数据呢?
我们之前学习C语言时,有这样一种语法现象:当取结构体地址时,获取的地址等于其第一个变量的地址。同理,我们之前学习的宏定义计算相对偏移:
c
(struct xxx*)0本质:将0号地址模拟成起始地址
同时,结构体首地址=成员地址−偏移量,因此我们就可以从式子中得到结构体的首地址。
对该内核链表,就有这样的操作:
bash
(struct task_struct *)((char *)next - (char *)&((struct task_struct *)0)->links) 当然我们也可以直接使用函数offsetof(struct task_struct, links);
1.3.2 实现信息的"流动"
我们可知Linux:一个单线程进程有一个 task_struct(后面线程知识),而PCB作为进程信息的合集,包含大量的数据,拷贝和自身转移都是非常麻烦的,但struct list_head的设计,使得PCB成为一个组件一样的东西。
1.3.2.1 组件的体现
研究Linux源码,可以看见其多个list_head的结构定义,虽然所有的插口都长在同一个 PCB 上,但每个插口连接的都是不同的、相互独立的、没有交集的独立链表。这就是著名的"用绳子穿过实体"的设计:
bash
struct task_struct {
    // ...
    struct list_head tasks;         // 全局链表节点
    struct list_head run_list;      // 运行队列节点 (RT)
    struct rb_node   run_node;      // 运行队列节点 (CFS)
    wait_queue_entry_t wait;        // 等待队列节点
    // ...
};-
全局链表: 连接所有进程的
tasks,无论哪个PCB,都会存在全局链表这根线上,完成PCB的全局访问 -
运行队列: 连接状态为 "就绪(Ready)" 或 "运行(Running)" 的 PCB 的
run_list的插口 -
等待队列: 每个硬件设备(网卡、键盘、磁盘等)都有自己专属的一条等待队列线。
1.3.2.2 流动的体现
当一个进程的状态发生变化时,os就不会对整个PCB处理,而是通过 "断开" 与 "连接" 的方法,即添加对应的PCB结构体指针,实现数据的变化,体现数据的流动。
二、进程优先级
2.1 进程优先级的定义
即字面意思:进程获得CPU资源的先后顺序,也就是被执行的位置前后
2.2 进程优先级的意义
CPU单位时间运行的程序数量有限,而这种稀缺性就会造成进程在等待时有着先后顺序,而优先级的作用就是对进程在运行队列中顺序的描述**。**
2.2.1 对比:优先级 vs 权限
初学时,这两者常被混淆,其实它们的本质区别是:可不可以运行
- 优先级: 得到资源的先后顺序,如:排队打饭
- 权限: 能否得到资源,如:root和普通用户的区别
2.3 进程优先级的实现
进程优先级作为进程的一种属性,那么一定存在于PCB当中,而优先级肯定是要比较大小的,因此进程优先级就是PCB中一个整数。
想要清楚优先级的实现,我们还应先理解系统对于进程运行的操作方式。
2.3.1 分时操作系统
现代Linux和大量OS都是基于时间片的分时操作系统,这样的设计可以保证可控范围内的公平性。
分时操作系统(Time-Sharing Operating System)是一种允许多个用户或多个进程通过时间片轮流使用 CPU 的操作系统。它的核心目标是:公平、快速响应、支持交互。
而其中的时间片我们应该怎么理解呢?
2.3.2 时间片轮转
时间片轮转是分时操作系统的指导思想,它通过将CPU运行的时间分为多个简短的时间片(通常为毫秒级别),然后以这样的策略运行(后面会详细解释):
-
时间片用完 → 时钟中断 → 调度器换下一个进程;
-
进程主动阻塞(等 I/O、等锁)→ 提前让出 CPU;
-
高优先级进程可抢占。
通过这样的设计可以使得进程的运行出现:宏观并行、微观串行的运行方式。
- 宏观并行: 在人类对秒的敏感单位中,对于多个毫秒级的时间片的运行与切换无法察觉,在肉眼上看到的结果:多个程序同时运行
- 微观串行: 进程的运行都是随着时间片,逐个进行的
总的来说:宏观并行、微观串行,是单处理机分时系统通过时间片轮转和上下文切换制造的"同时运行"假象。用户看到多个程序一起推进,但 CPU 在任一时刻只执行一个程序。多核出现后,微观上才可能真正并行。
三、优先级的查看与实现
3.1 UID:user id
如Linux这样的操作系统,在识别用户时并不是通过用户名这样的字符串,而是根据标识符------UID(用户描述符)辨认的。
/etc/passwd文件保存用户名 ↔ UID 的映射
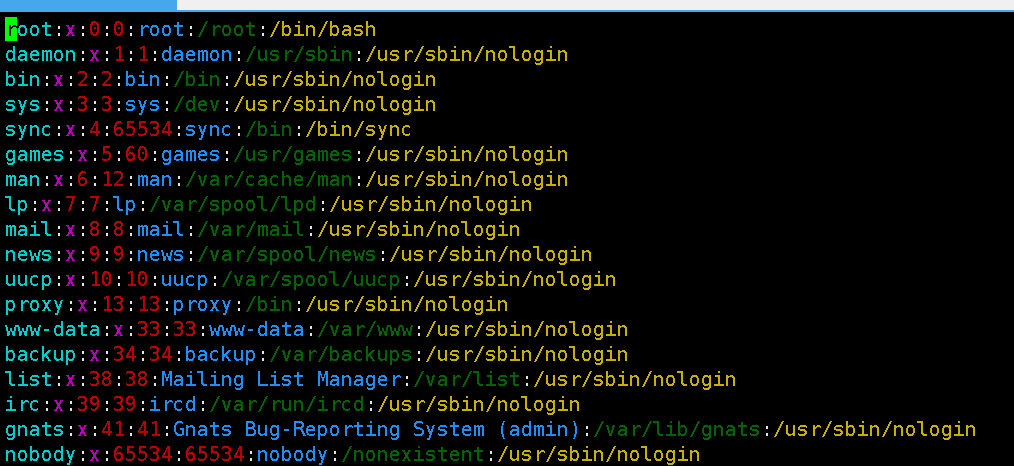
-
内核对身份的绑定: 每当一个用户在终端启动一个程序时,内核在为其创建进程控制块(task_struct)时,会将该用户的 UID 直接写入其中。这意味着,系统中的每一个进程,底层都有那个UID数字。
-
UID划分:
-
UID = 0 : root 超级用户 ,权限最高,只有一个。
-
UID = 1‑999(CentOS7+/RHEL8);1‑1000(Ubuntu) :系统用户(服务账号,nginx、mysql、daemon),无登录 shell,后台进程使用。
-
UID ≥ 1000:普通新建用户,普通人登录账号
-
通过ps -ln指令查看UID:
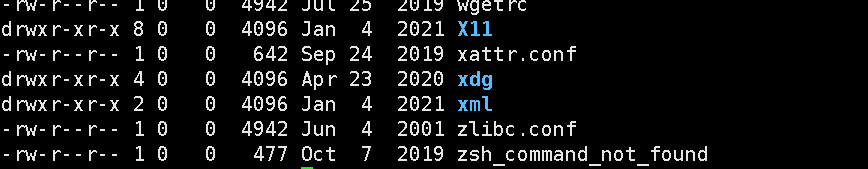
UID的作用:Linux中访问任何资源都是进程访问的,进程代表用户,OS会将进程的UID和资源的创建角色比对,确认后才可以通过。
3.2 进程优先级查看
在Linux中可以通过ps -al的指令,查看用户启动后进行中的进程。

3.3 进程优先级实现
在展现的众多属性中,我们注重的是:CRI和NI
- PRI(Priority,内核动态优先级): 内核真正调度使用的优先级数字;数值越小,优先级越高,越优先抢到 CPU
默认为80 - NI(Nice 值,友好值,静态修正值) 用户可以修改的偏移量 ,用来间接影响 PRI
取值范围:‑20 ~ 19
进程的真实优先级就是由两者决定的:
P R I n e w = P R I b a s e + N I \boldsymbol{PRI_{new}=PRI_{base}+NI} PRInew=PRIbase+NI
PRI基准为80,下文会谈到如何修改
3.4 优先级的修改
优先级的修改不仅可以发生在未执行的进程上,也可在进行的进程中。
3.4.1 命令行修改
3.4.1.1 nice 与 renice
- nice: 修改动进程的时候设置
nice值 (新建时指定 NI)
bash
nice -n NI值 命令
# -n 后面跟nice偏移- renice: 修改已经正在运行进程的
Nice值 (动态改 NI)
bash
renice 新NI值 -p PID普通用户只能将 nice 值调大,只有root才能调小
3.4.1.2 top
top是对执行中的进程的nice进行调整,使用top指令,下方为具体步骤:
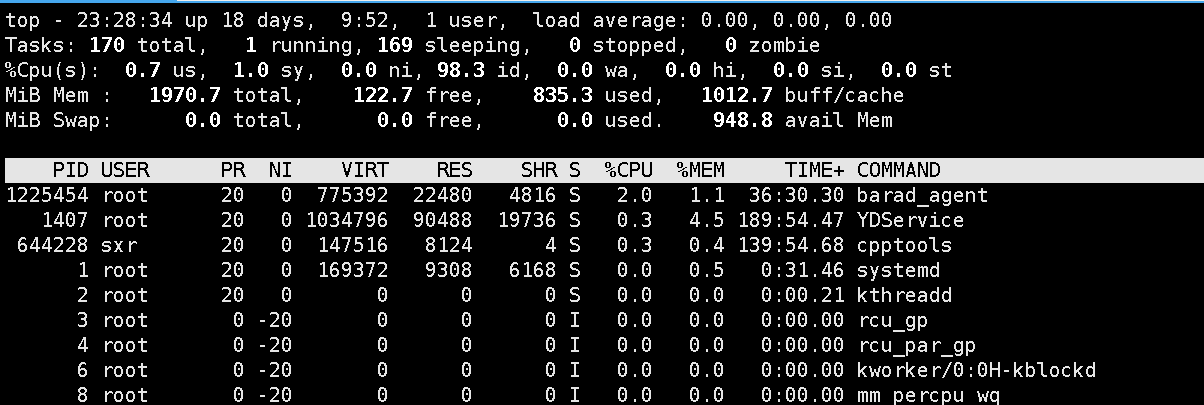
- 进入top: 命令行输入
top指令,打开top面板 - 进入修改模式: 按下
R键,进入renice模式 - 选择目标进程: 输入想要修改进程的UID
- 调整nice值: 随后系统会提示
Renice PID 25110 to value,输入想要改变成的值
3.4.2 系统调用
在代码中通过以下两个调用修改nice值:
c
int getpriority(int which, int who);
int setpriority(int which, int who, int prio);

// 具体代码
errno = 0;
int ni = getpriority(PRIO_PROCESS, 0);
printf("当前进程nice = %d\n", ni);

// 设置nice=5
int ret = setpriority(PRIO_PROCESS,0,5);
if(ret == -1) perror("setpriority");
3.5 nice的极值问题
3.5.1 nice 的范围
为了防止用户肆意的改变进程的nice值,造成os的安全问题,于是规定nice的范围是-20,19。这意味着一个进程的优先级必然处于60,99的区间范围内。
3.5.1 范围限定的意义
Linux这套机制,是为了防止 "进程饥饿"。OS为了确保每个进程都有被调度的公平性,如果由用户随意的拉大或调低某个进程的优先级,就可能造成某个进程长时间占用CPU和某个进程根本没用CPU执行的极端情况。
总结
下一节我们将学习Linux对于进程的调度算法和优先级是如何影响进程执行的先后顺序,感谢您的阅读,我们下节再见。