做过企业数据治理的朋友,肯定对这种场景不陌生:老板突然要求搞数据资产化,IT部门赶紧去调研市面上的元数据管理方案。结果到了落地汇报的时候,发现各家厂商的方案拉得满满当当,从数据集成、数据开发到AI智能问数,什么都有。但真到了落地的时候,业务部门抱怨找不到数,IT部门抱怨理不清血缘,最后几百万的方案买回来,却成了一个没人用的数据字典。听着是不是很熟?你懂我意思吗?
其实,这真不是谁在故意刁难谁,而是很多企业在建设元数据管理 体系时,陷入了唯功能论的误区。说白了,元数据管理 建好了,只是万里长征走完了第一步。如果缺乏清晰的落地逻辑和实施路径,元数据管理 就会变成一个数据仓库的附属品,里面的元数据没人维护、没人更新,最终沦为摆设。用过来人的经验告诉你,元数据管理的价值,不是靠买一套软件就能释放的,而是靠持续的运营、迭代和协同,一步步养出来的。
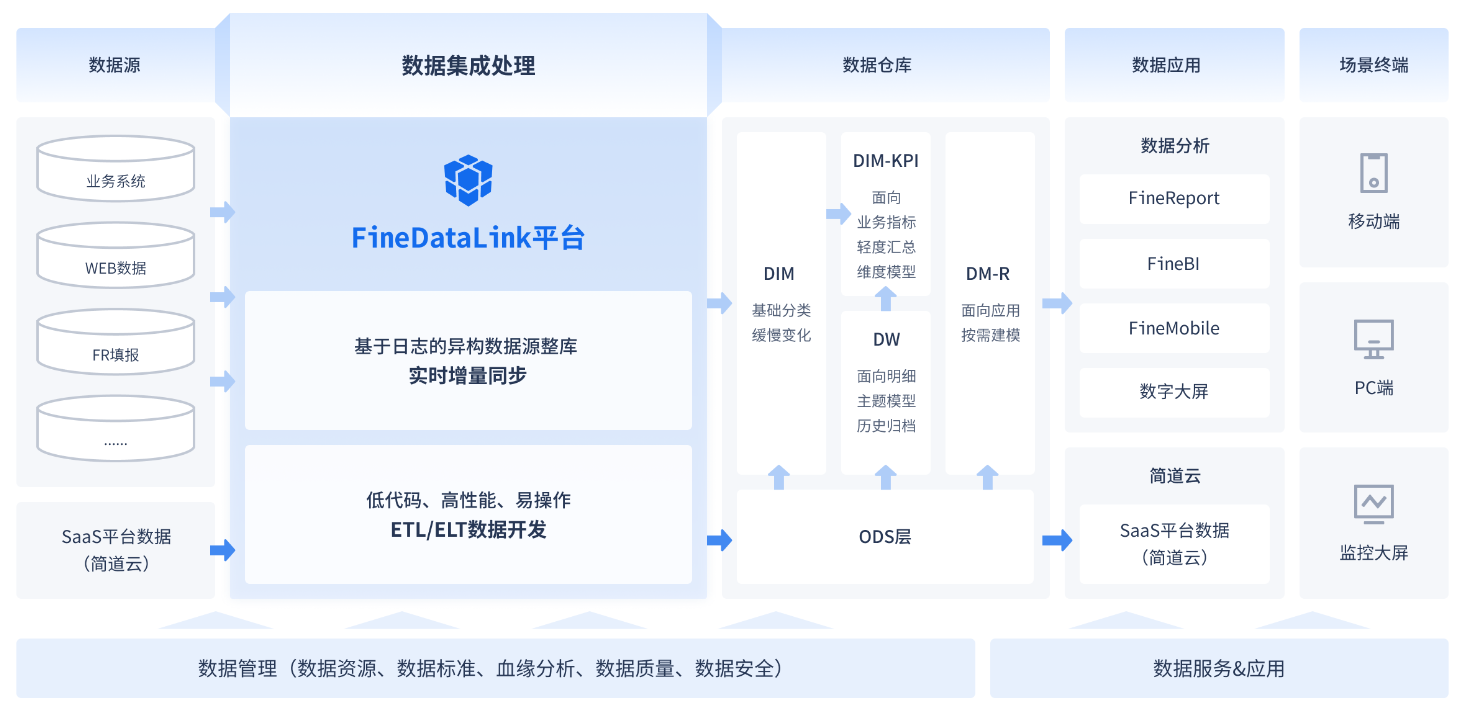
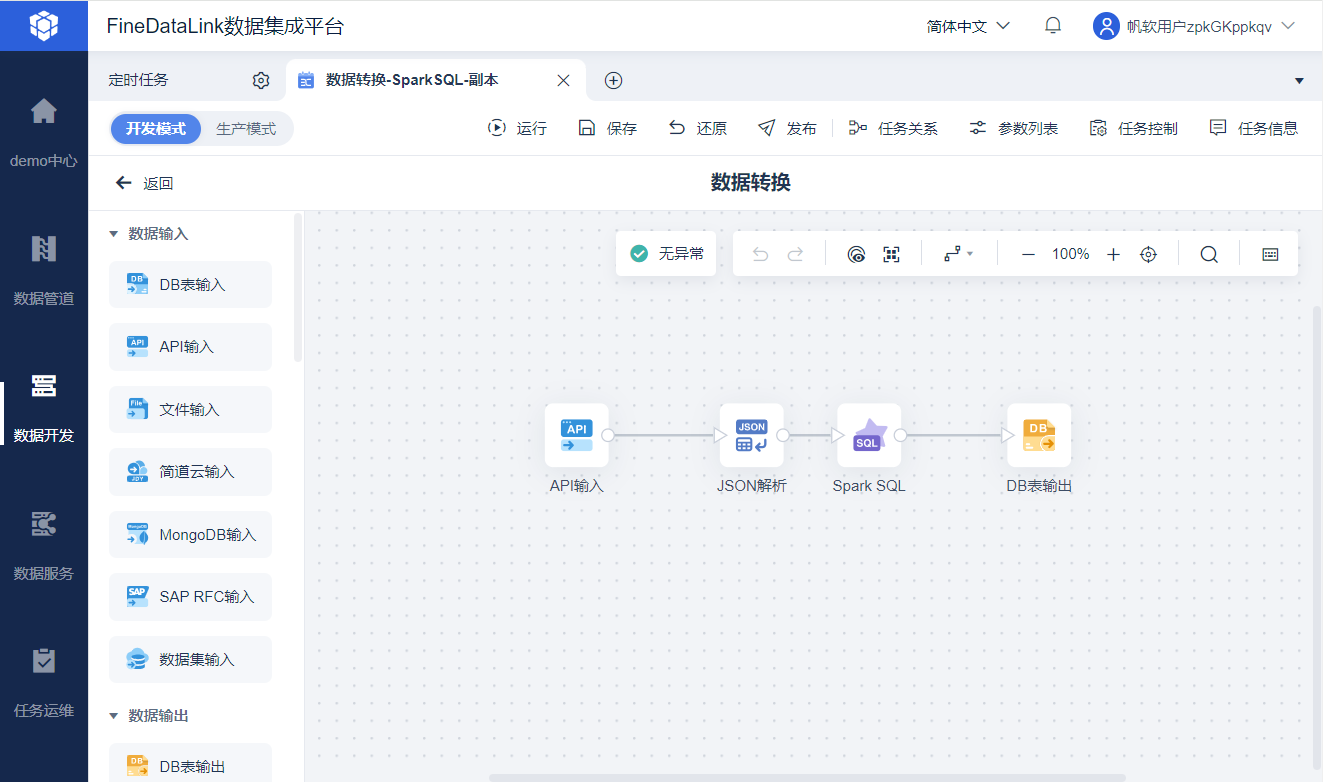
我刚开始负责企业元数据体系建设 的时候,也踩过不少坑。总觉得买个功能最全的平台,数据自然就清楚了。后来慢慢发现,选对工具真的能少走很多弯路。比如FineDataLink这样的数据集成与治理平台,最大的好处就是不需要复杂的底层代码开发,IT人员通过可视化拖拽就能搭建起各类异构数据源的元数据采集链路。这种低门槛、高效率的设计,让数据团队能把精力从繁琐的接口对接中解放出来,真正聚焦于元数据管理的运营本身,而不是天天写代码调接口。
有了这个认知,我们再来看看,元数据管理到底该怎么落地,实施路径又有哪些。
一、元数据管理怎么落地:如何甄别真自研与伪包装?
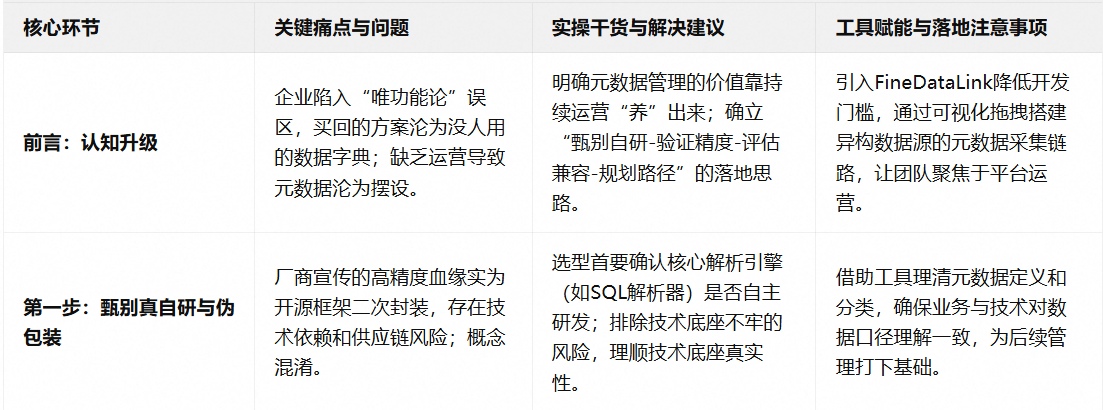
我一直强调,元数据管理落地的第一步,是确认核心引擎是不是真自研。很多时候,厂商宣传的高精度血缘,其实是基于开源框架的二次封装。
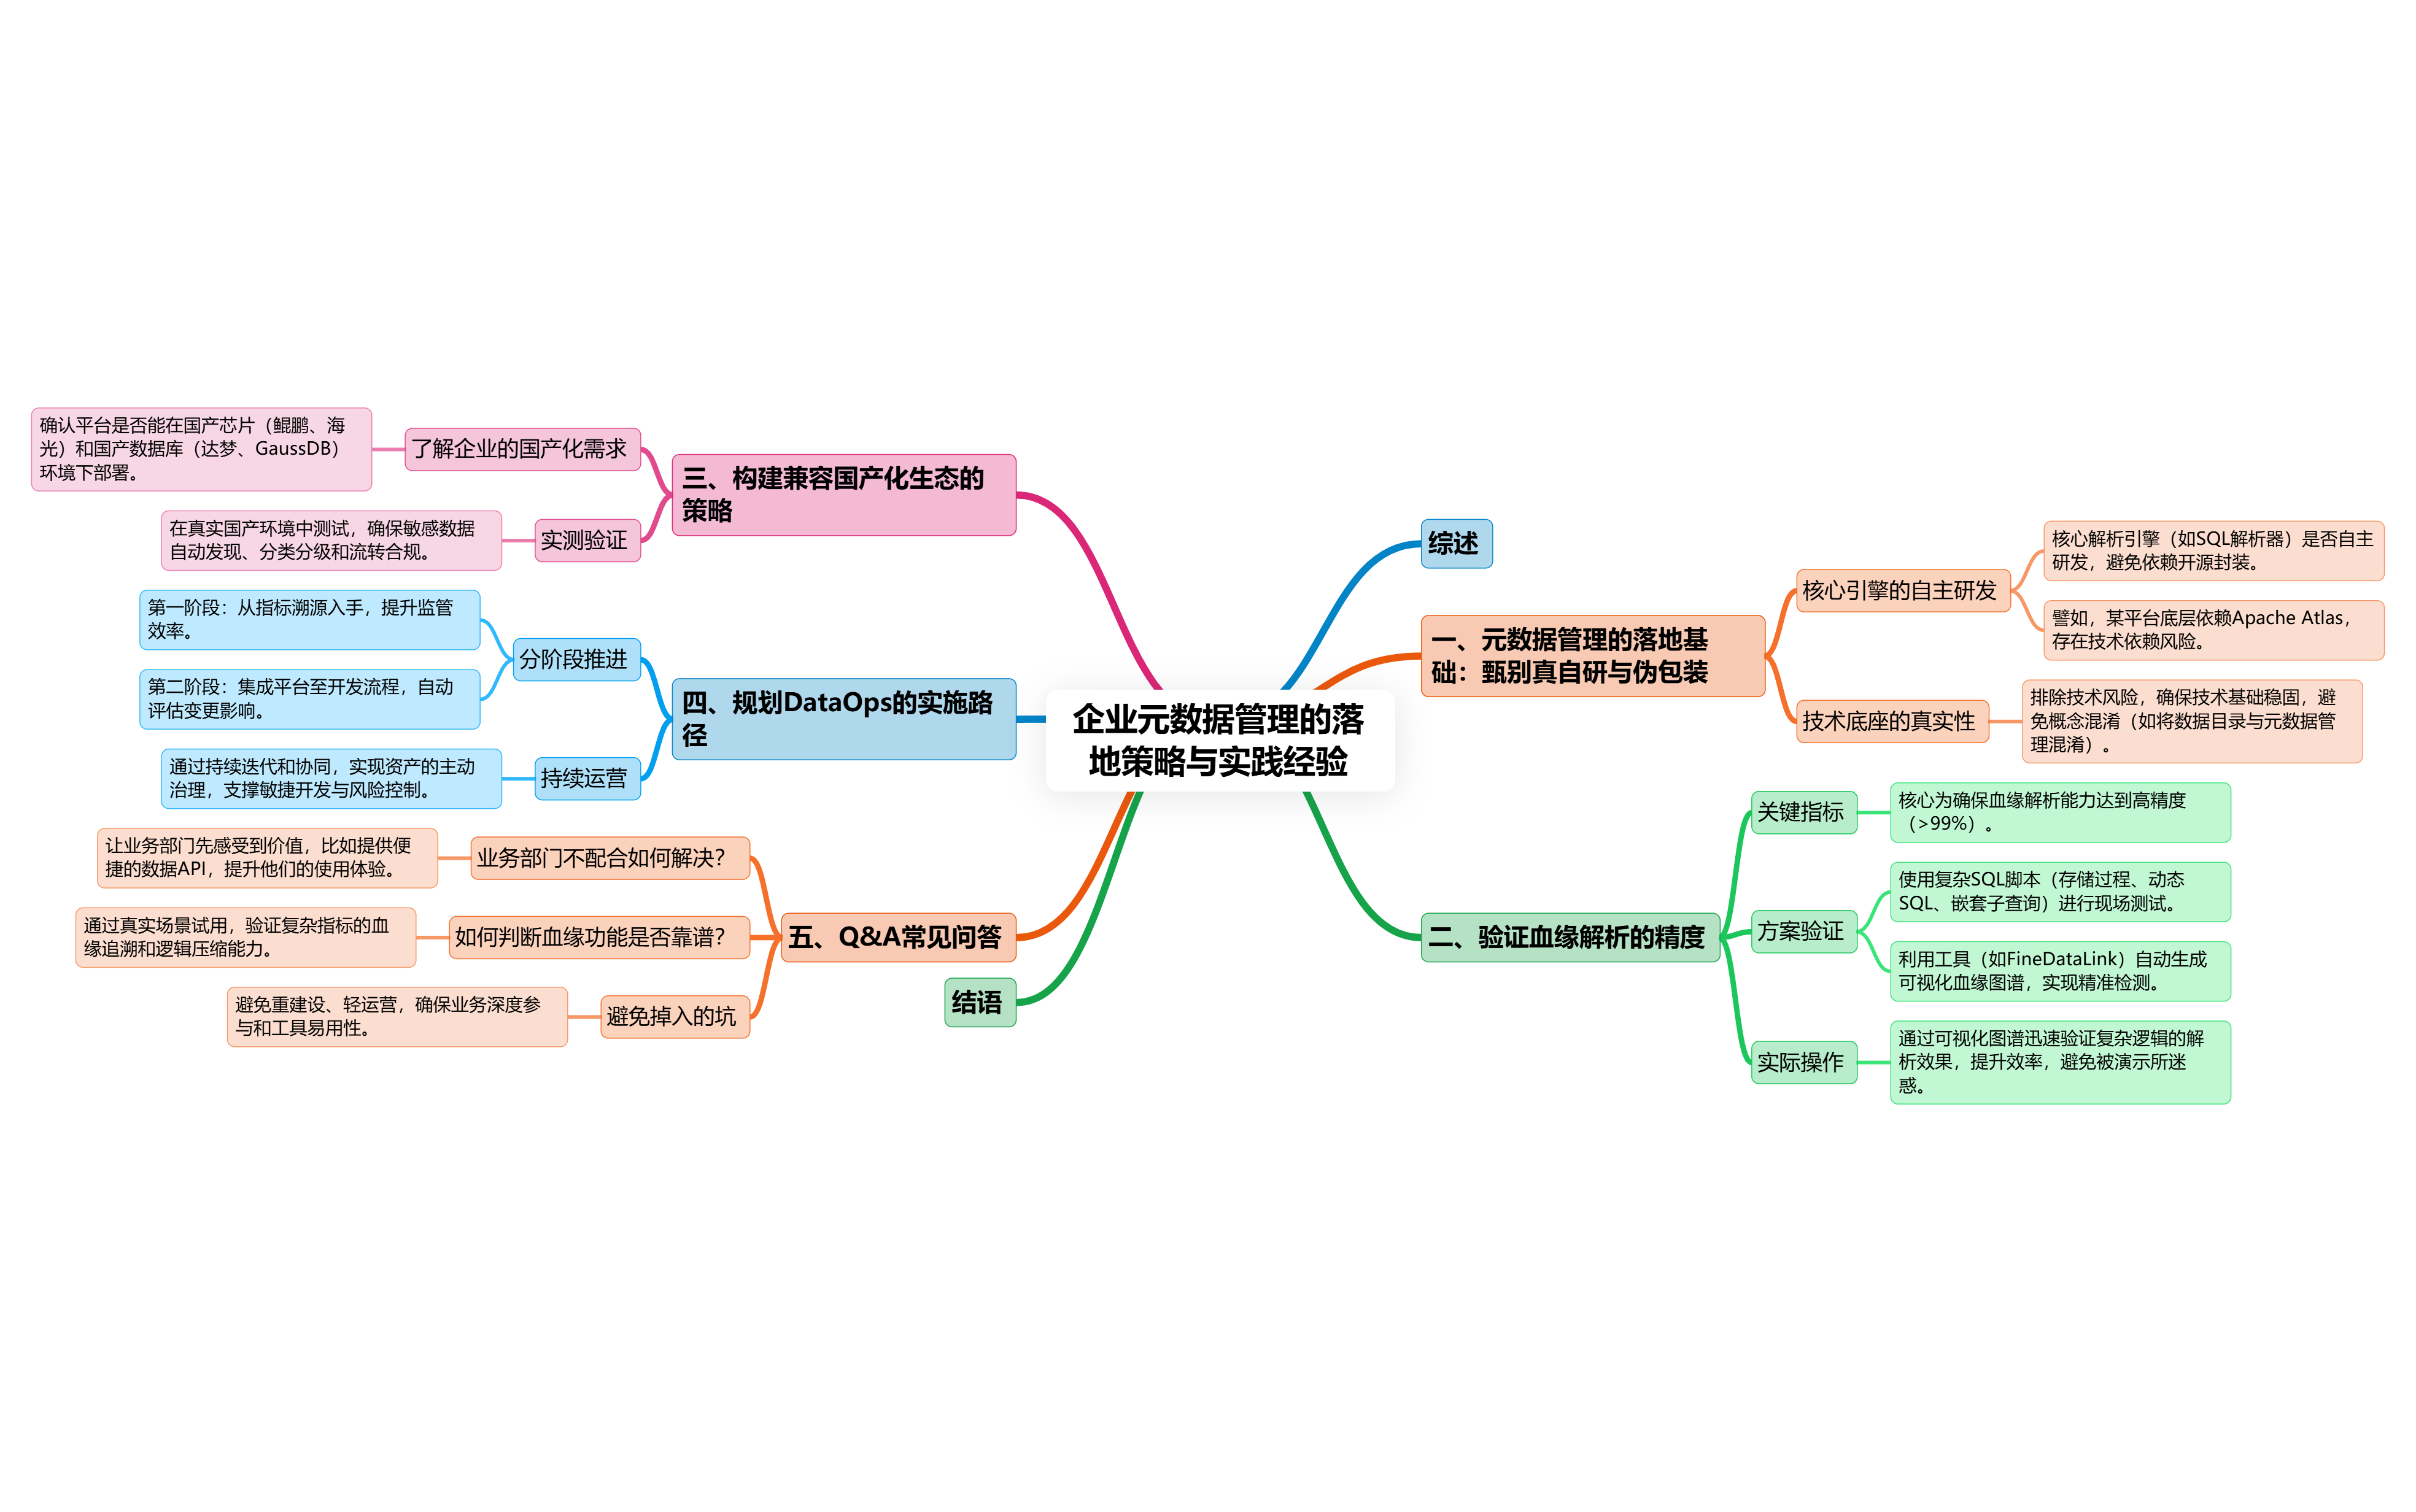
简单来说,就是要先排除技术风险。你需要检查平台的核心解析引擎(比如SQL解析器)是不是自主研发的。比如,你会发现某个平台的元数据采集功能很强大,但底层其实是套壳了Apache Atlas,这就意味着存在技术依赖和供应链风险。或者,业务部门把元数据管理和数据目录混为一谈,认为只要有个搜索框就能找到数据。这种技术底座不牢或概念混淆的问题,就是落地要解决的核心。只有把技术底座的真实性理顺了,元数据管理才能真正发挥作用。
二、元数据管理实施路径有哪些:如何验证血缘解析精度?
用过来人的经验告诉你,如果确认了平台的技术底座,元数据管理落地的核心,就是验证血缘解析精度。如果缺乏高精度的血缘解析能力,元数据管理就像盲人摸象,效率极低。
简单来说,血缘解析就是记录数据从源系统到最终展示的整个流转过程。当方案落地时,你必须拿企业最复杂的真实SQL脚本(包含存储过程、动态SQL、嵌套子查询)进行现场解析测试。我一直强调,工具选对了,落地效率能翻倍。比如FineDataLink的血缘分析功能,能自动生成可视化的数据流转图谱。在落地验证时,数据团队可以直接在图谱上检查解析成功率是否达到99%以上,能否精准识别WHERE条件实现行级裁剪。几分钟就能验证出平台在处理复杂逻辑时的真实水平,再也不用被厂商的演示案例忽悠了。
三、元数据管理怎么落地:如何评估国产化生态兼容?
我一直强调,元数据管理落地,不是IT部门一个部门的事,而是需要结合企业的整体技术战略。如果缺乏国产化生态的兼容性,元数据管理就会出现水土不服、安全合规风险等问题。
简单来说,就是要明确企业的信创要求。你需要检查平台是否能无缝融入国产化技术栈。比如,你会发现某个平台在公有云上跑得很好,但一旦要部署到国产芯片(鲲鹏、海光)和国产数据库(达梦、GaussDB)的环境中,就各种报错。这种生态兼容差的问题,就是落地要解决的核心。用过来人的经验告诉你,生态兼容要落地,离不开实测。我们需要在真实的国产化环境中,验证平台的敏感数据自动发现、分类分级能力,确保数据在流转中的合规可追溯。
四、元数据管理实施路径有哪些:如何规划DataOps实施路径?
我一直强调,元数据管理的价值,不仅体现在管数据,更体现在支撑DataOps协同。如果元数据管理只能提供静态的资产目录,而不能回答如何敏捷开发、如何主动防控风险,那它的价值就大打折扣。
简单来说,元数据管理的落地不是一蹴而就的,而是需要分阶段推进。我一直强调,要把元数据管理从被动盘点升级为主动治理。比如,在落地的第一阶段,我们可以从最痛的监管报送指标溯源切入,利用算子级血缘将盘点时间从数月缩短至几天;在第二阶段,将平台集成至开发流程,实现上线前变更影响自动评估。这种分步走的落地策略,不仅能让业务部门快速看到价值,还能为后续的全面DataOps协同打下坚实基础。
Q&A常见问答
Q1:元数据管理落地,业务部门不配合怎么办?
A1:说实话,这事儿真不是靠行政命令就能解决的。我的建议是,先让业务部门尝到甜头。比如,通过FineDataLink的数据服务API发布能力,将口径统一的指标一键供给各业务系统,让业务部门能够快速、便捷地获取自己需要的数据,解决他们找数难的痛点。当业务部门真正感受到元数据管理带来的价值时,他们自然会主动参与到元数据的维护和运营中。
Q2:元数据管理落地,如何判断一个平台的血缘功能是否真的好用?
A2:这其实是很多企业的通病。关键在于试用和场景验证。首先,一定要让数据团队亲自试用,而不是只听厂商的演示。其次,要用真实的业务场景去验证,比如拿一个最复杂的跨系统指标,看平台能不能快速、准确地追溯其血缘关系。另外,要重点关注平台的白盒化口径提取能力,能否自动将多层复杂逻辑压缩为一段可读的加工口径,这种贴合实际排查需求的能力,才是判断平台好不好用的核心标准。
Q3:元数据管理落地,最怕踩什么坑?
A3:最怕的坑就是重建设、轻运营和脱离业务。选平台和做落地,一定要跟着业务痛点走。核心建议是:一定要让业务部门深度参与。比如,在梳理元数据标准时,必须让业务部门、IT部门、数据部门一起开会确认,不能只由IT闭门造车。另外,工具的选择很重要,要让数据团队和业务团队都能轻松上手,而不是事事依赖外部厂商,这样元数据管理才能真正在企业内部生根发芽。