论文信息 标题:A Comprehensive Survey on Retrieval Methods in Recommender Systems 作者:Junjie Huang, Jizheng Chen, Jianghao Lin, Jiarui Qin, Ziming Feng, Weinan Zhang, Yong Yu(上海交通大学、招商银行信用卡中心)
版本:arXiv:2407.21022v2,2025 年 10 月 11 日更新,以 ACM 期刊排版格式撰写。
定位:这是第一篇专门综述推荐系统召回阶段的工作,收录 100 余篇相关论文,检索区间为 2001---2024 年,来源包括 KDD、ICDM、WWW、SIGIR、ICML、NIPS、AAAI、WSDM、CIKM、RecSys、TKDE、TOIS。
工业推荐系统是一条流水线,而多数论文与教程把笔墨给了排序。这篇综述反其道而行:它只讲召回,并且把"算得准"与"跑得起"两件事分开来讲。本文按论文的框架梳理其脉络,并标出对写论文、做系统最实用的几处结论。
I 召回为什么不是一个"小一点的排序"
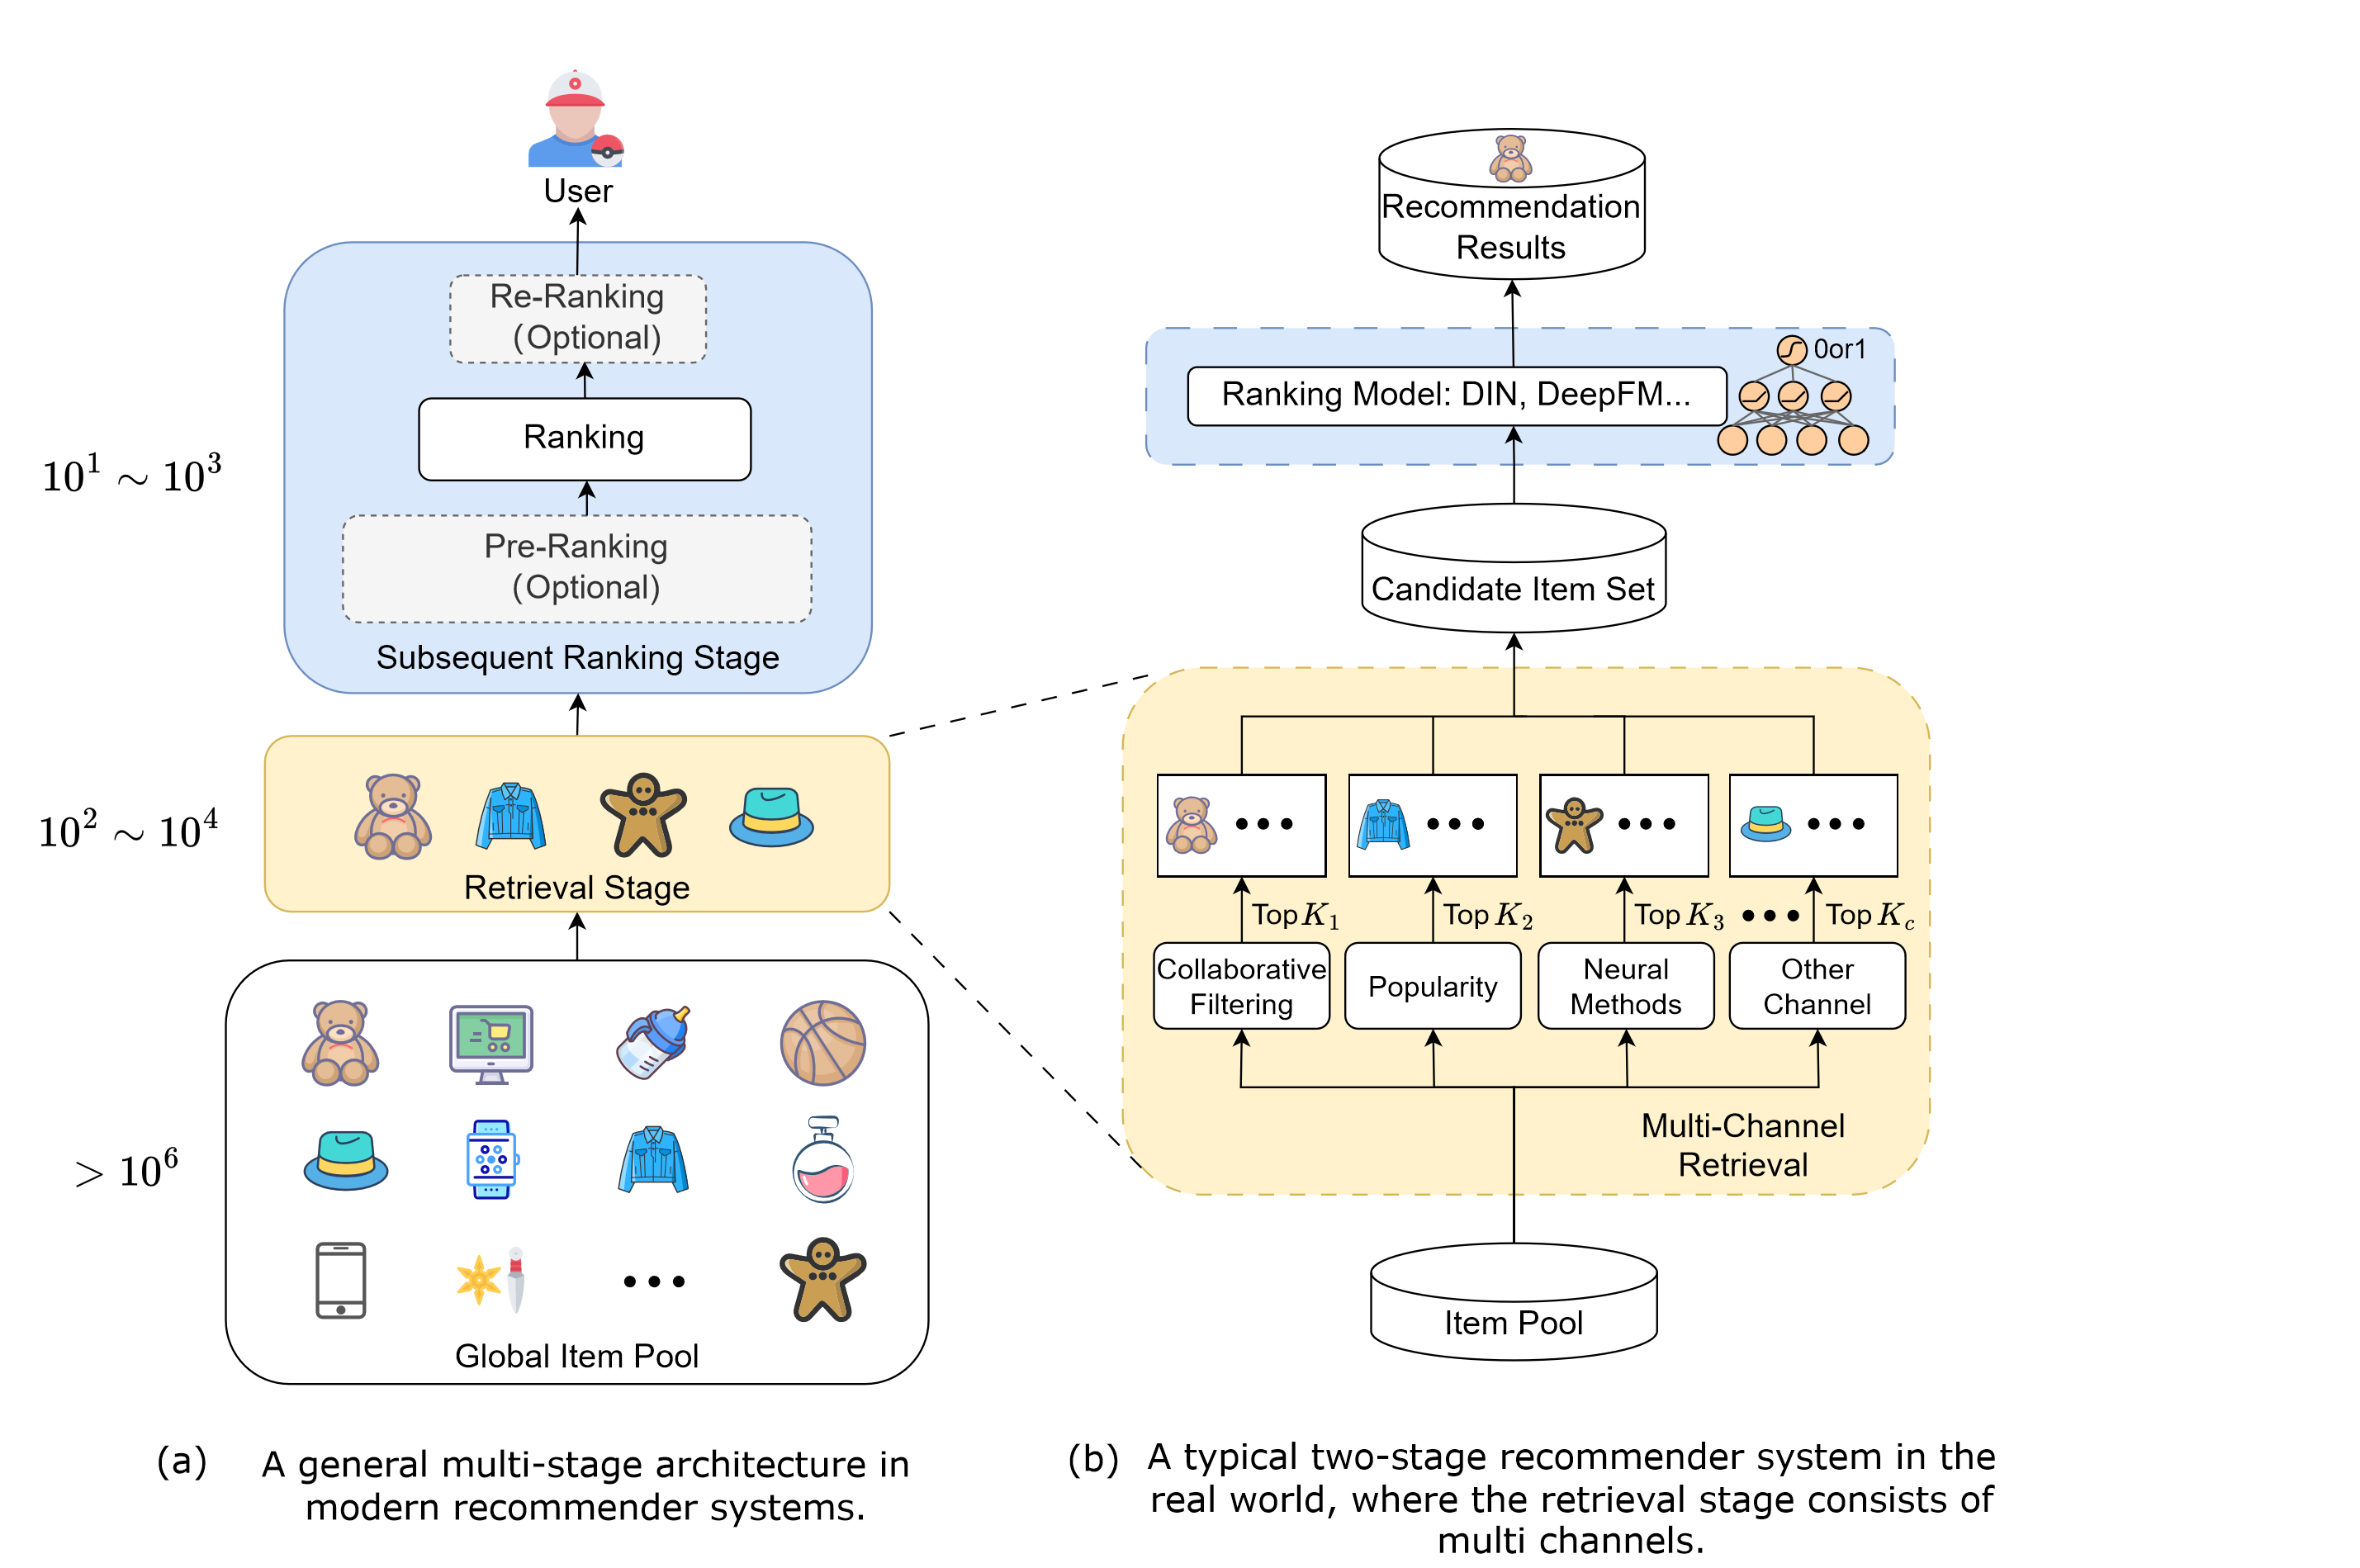
图 1|原文 Figure 1(第 2 页):左为多阶段级联漏斗,右为真实系统中的两阶段架构与多通道召回
论文开篇列了召回与排序的四点结构性差异(§1):候选集规模 ------召回要扫完整个百万级物品池,排序只需处理召回吐出的数百到数千条;输入特征 ------召回受时间预算约束,只能用粗粒度特征,交叉特征不现实;模型结构 ------召回多为双塔(late interaction),排序多为单塔(early interaction);优化目标------召回追求"把相关的都捞进来",排序追求"把最重要的排到最前面"。这四点决定了两个阶段的评价口径与失败代价完全不同。图 1 左侧还标了各阶段的输出量级(>10⁶ → 10²~10⁴ → 10¹~10³),作者提醒这个区间随平台而变,不能当通用常数引用。
§2.5 又把召回与搜索里的多阶段检索做了对照:原理相同(逐级收窄、逐级变贵),差别有三------搜索对所有人返回同一份结果、索引固定,推荐须逐用户定制并随新物品与新交互持续更新;搜索索引可定期重建,推荐往往要求近实时入库;搜索早期用词项统计(如 BM25),推荐召回用的是把用户历史、内容属性与上下文揉在一起的向量表示。
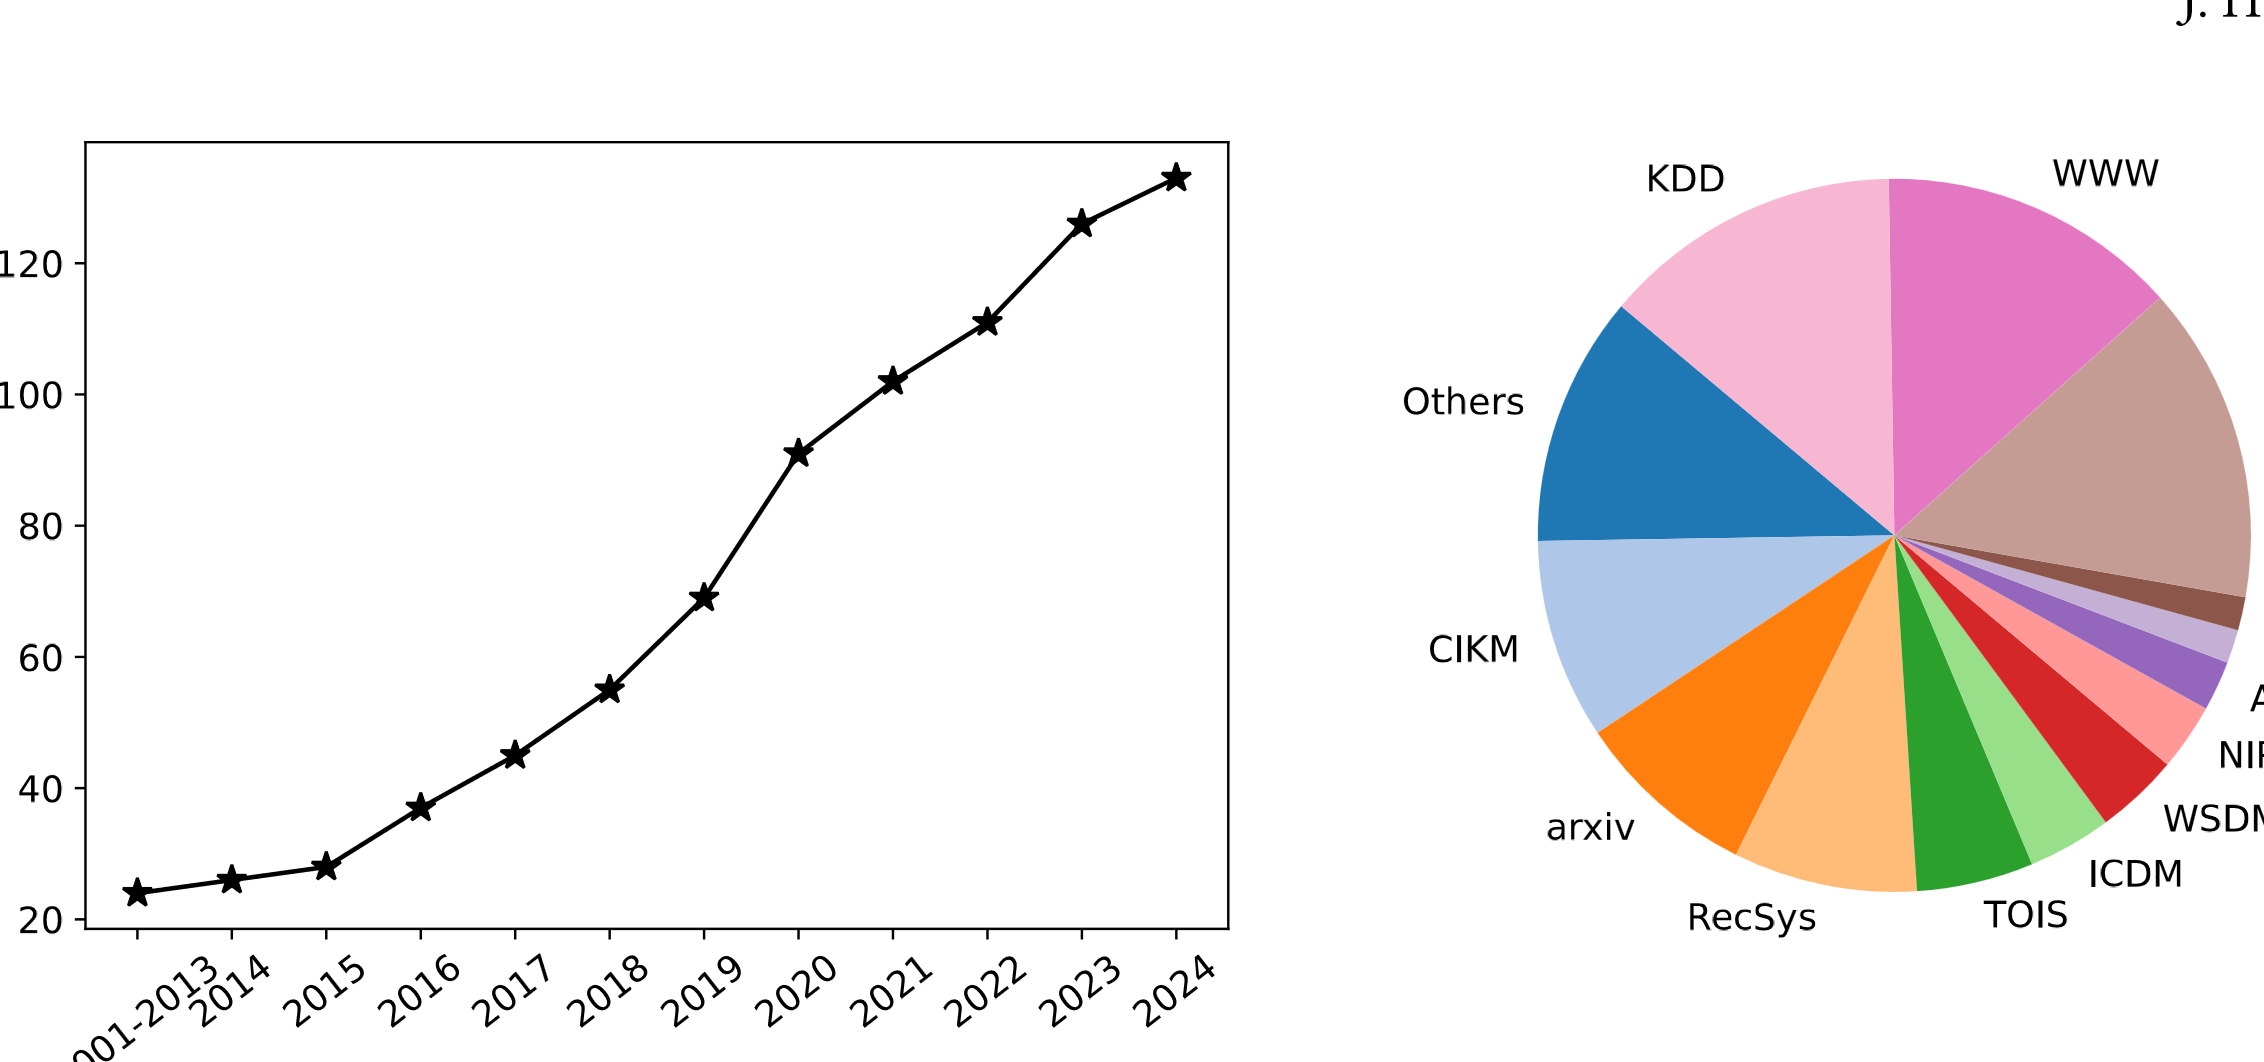
图 2|原文 Figure 2(第 4 页):(a) 召回方向论文累计数量,(b) 按会议与期刊统计的分布
II 任务边界
论文 §2.2 先做了一次干净的二分:非个性化检索 (热门、新品、长尾、运营位)与个性化检索(U2I、U2I2I 即常说的 I2I、U2U2I)。前者不看"你是谁",依据是"群体的智慧",在冷启动与交互数据不足时尤其有用;推新品则为了保持生态新鲜度、鼓励探索。后者对齐个体兴趣,是综述的主体。
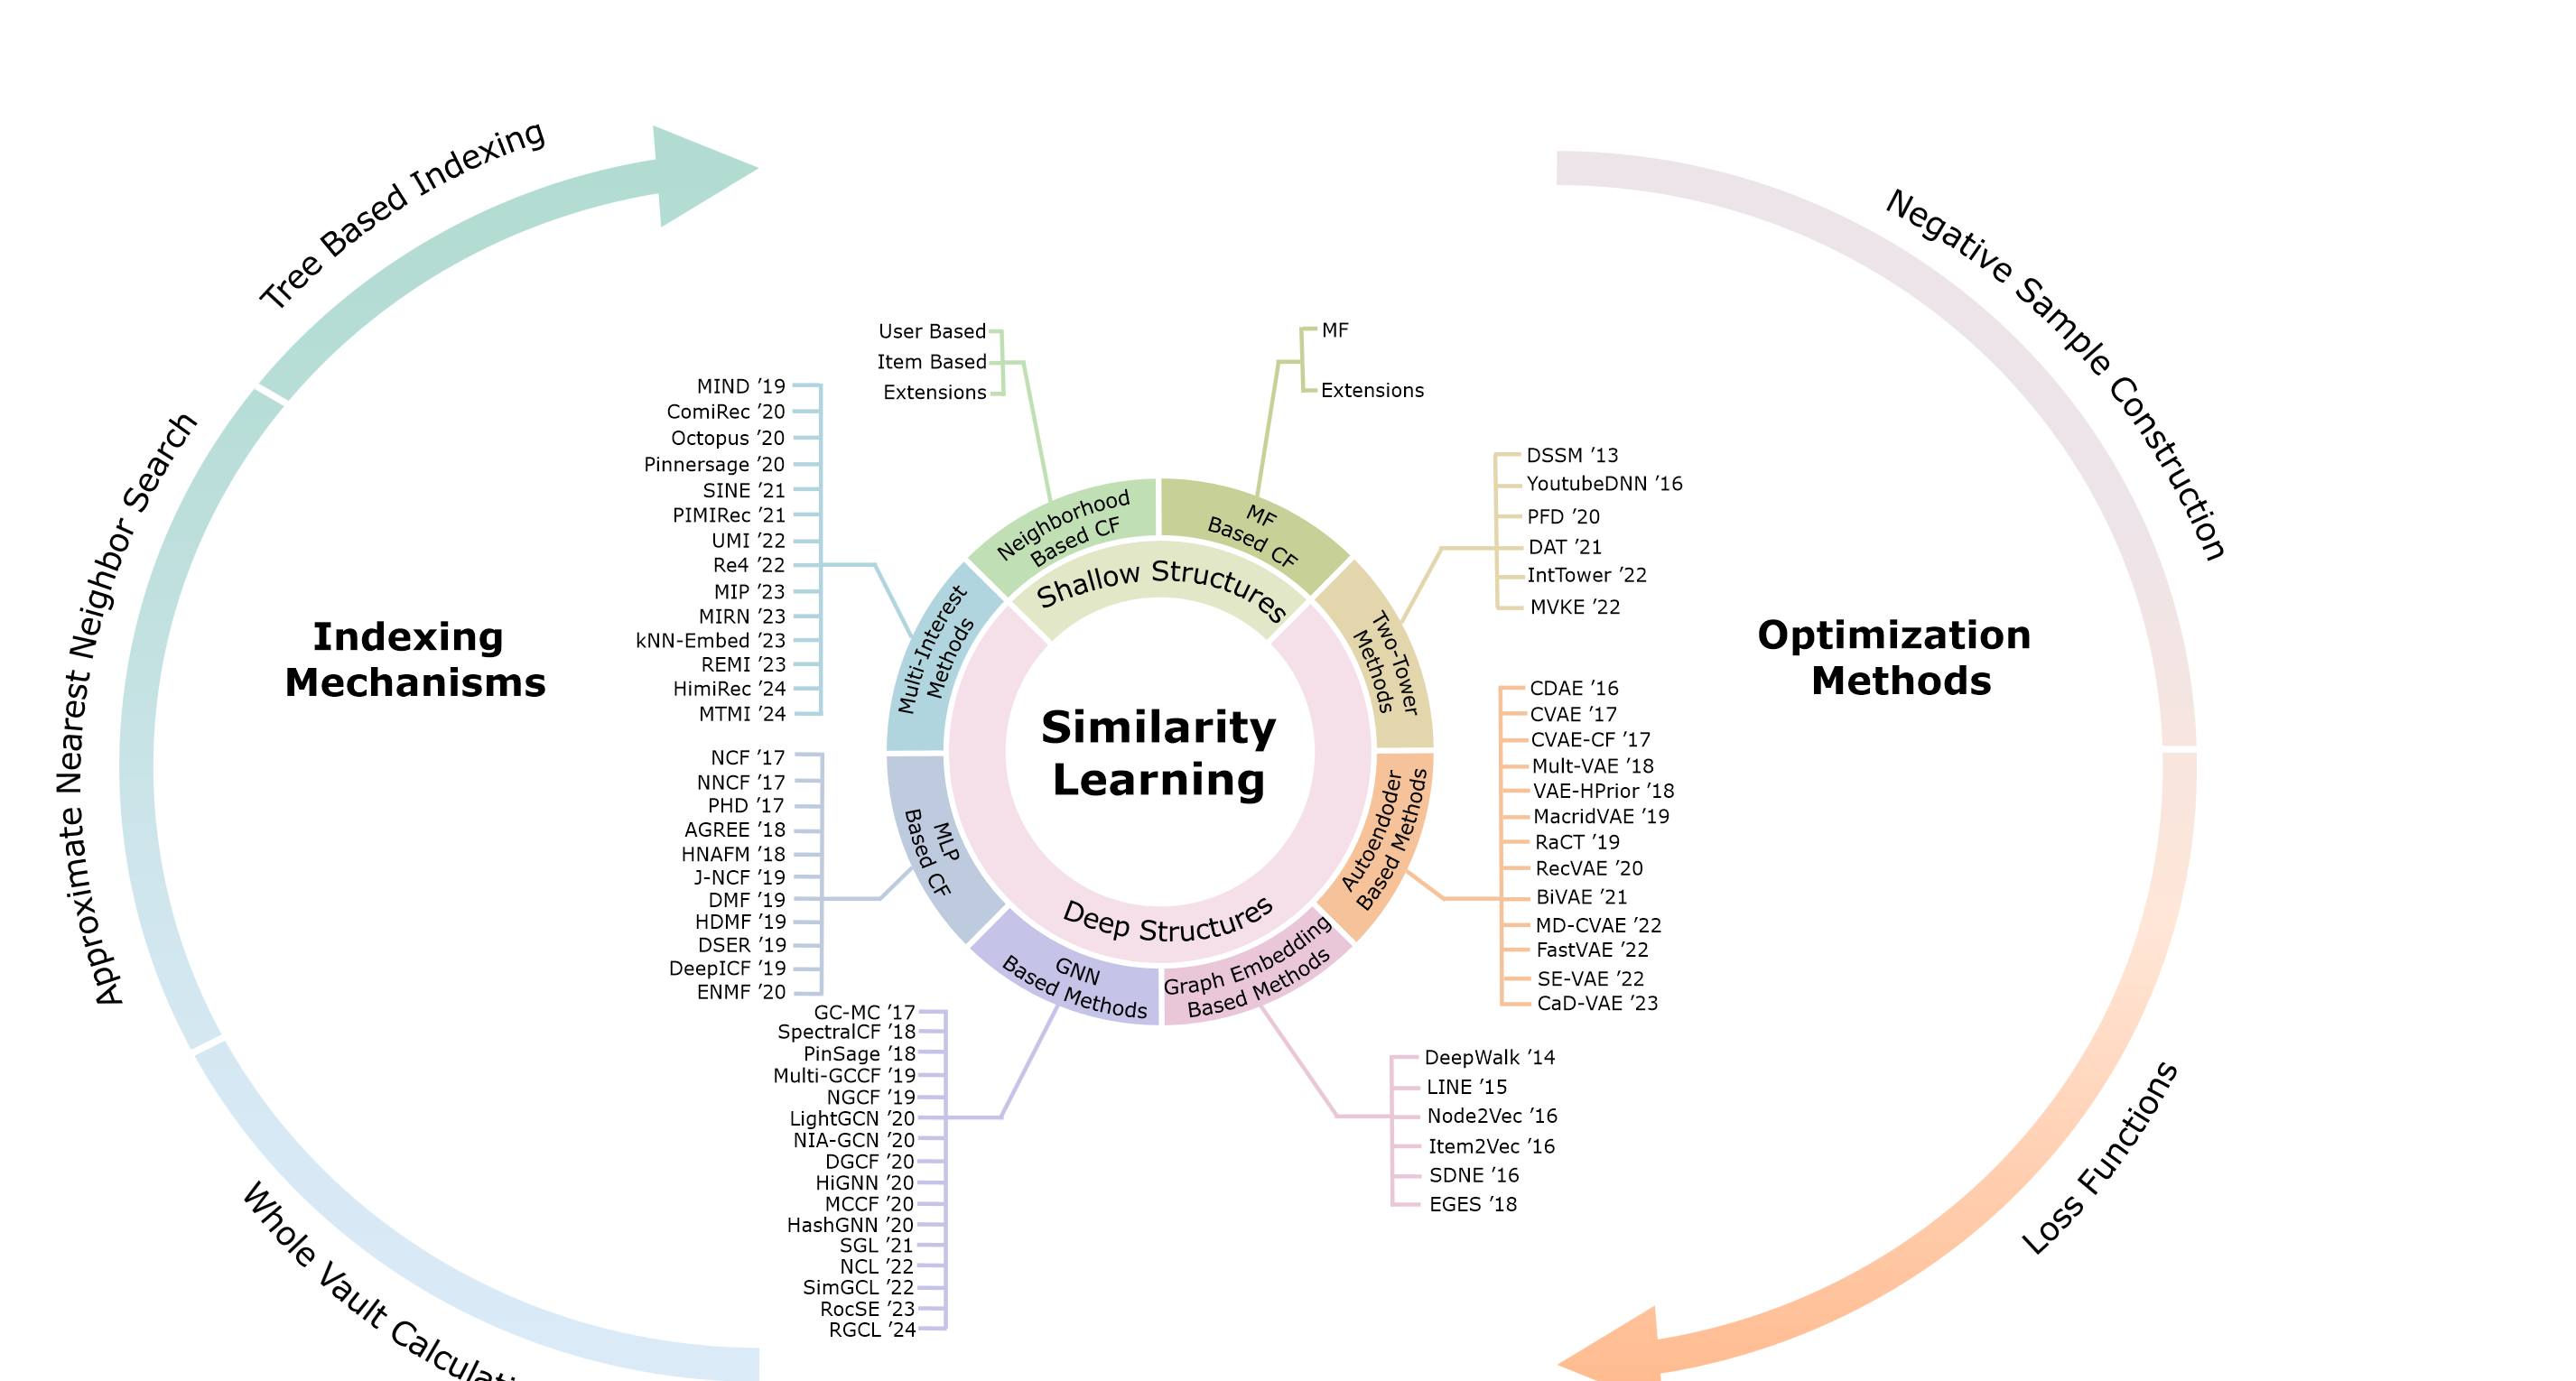
图 4|原文 Figure 4(第 8 页):(a) 非个性化检索、(b) 个性化检索的三条路径、(c) 用户---物品评分矩阵、(d) 侧信息
§2.4 指出工业系统普遍采用多通道检索:若干种独立方法各取 Top-K,再聚合成候选池。各通道取多少条通常由离线评测与线上 A/B 实验共同定配额,动机是最大化兴趣覆盖、提升召回率。
§2.3 讨论输入。除用户---物品交互矩阵(稀疏,未交互格子常被当作负样本)外,侧信息分为用户画像、物品属性、上下文三类,作者又补了近年兴起的 UGC(标签、评论)。这一节给出了量化证据:
| 侧信息增益 | 指标变化 | 数据集 |
|---|---|---|
| 融合标签信息 vs 纯协同过滤 | Recall@10 0.32 → 0.34 | Last.fm |
| SocialMF 引入社交信任传播 | RMSE 1.175 → 1.075 | Epinions |
| 同上,换数据集 | RMSE 0.878 → 0.821 | Flixster |
| 静态 SVD++ 加入时间动态 | RMSE 0.913 → 0.897 | Netflix |
III 方法版图
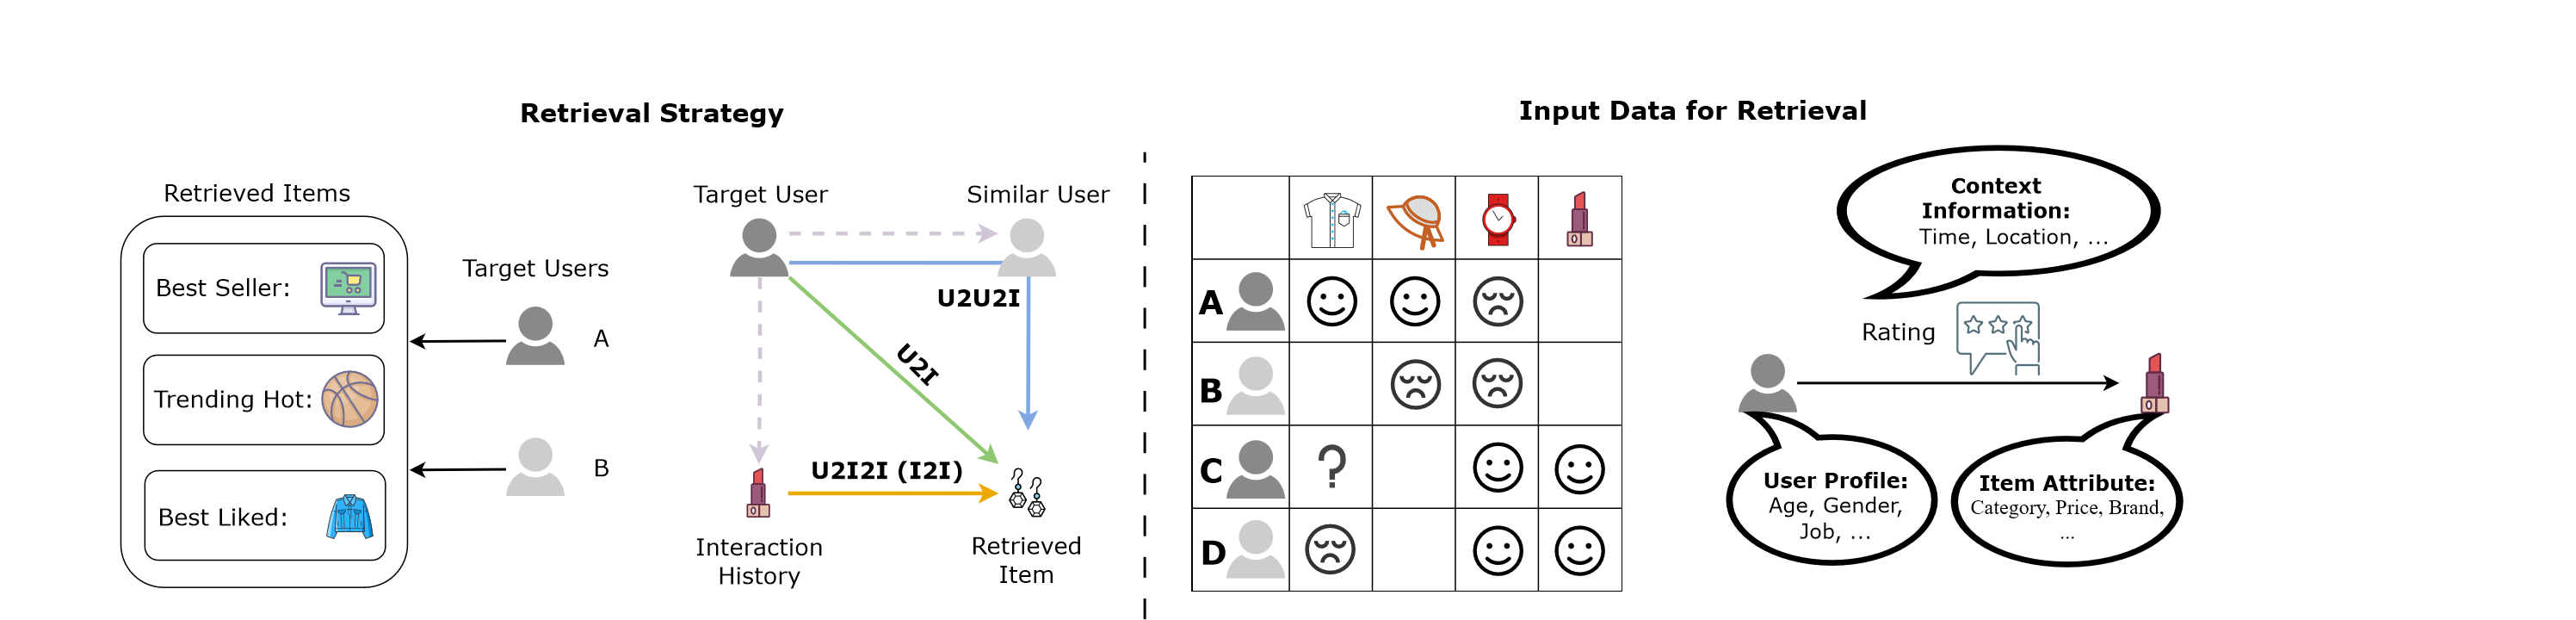
图 3|原文 Figure 3(第 5 页):方法分类环图,内圈为三大板块,外圈标注代表工作与年份
论文的骨架在 §1.1:召回被拆成相似度学习 、索引机制 、优化方法三大块(图 3)。主体(§3---§4)是一条"如何算相似"的主干,分浅层与深层;§5 索引、§6 训练与负样本、§7 评测、§8---§9 实验与工业实践,则决定这套相似度算法能不能真正上线。
浅层(§3) :邻域协同过滤(UserKNN / ItemKNN 及扩展)与矩阵分解(MF、SVD++ 一类隐向量路线)。**深层(§4)**分六类:双塔、自编码器、图嵌入、图神经网络、MLP 型协同过滤、多兴趣。双塔是工业主流,因为它把计算拆成了"可离线预计算的物品塔 + 在线一次用户向量与一次索引查询";代价是两塔顶端才相遇,拿不到早期交叉特征。多兴趣(MIND、ComiRec、REMI 等)则针对"一个用户向量装不下多种兴趣"。
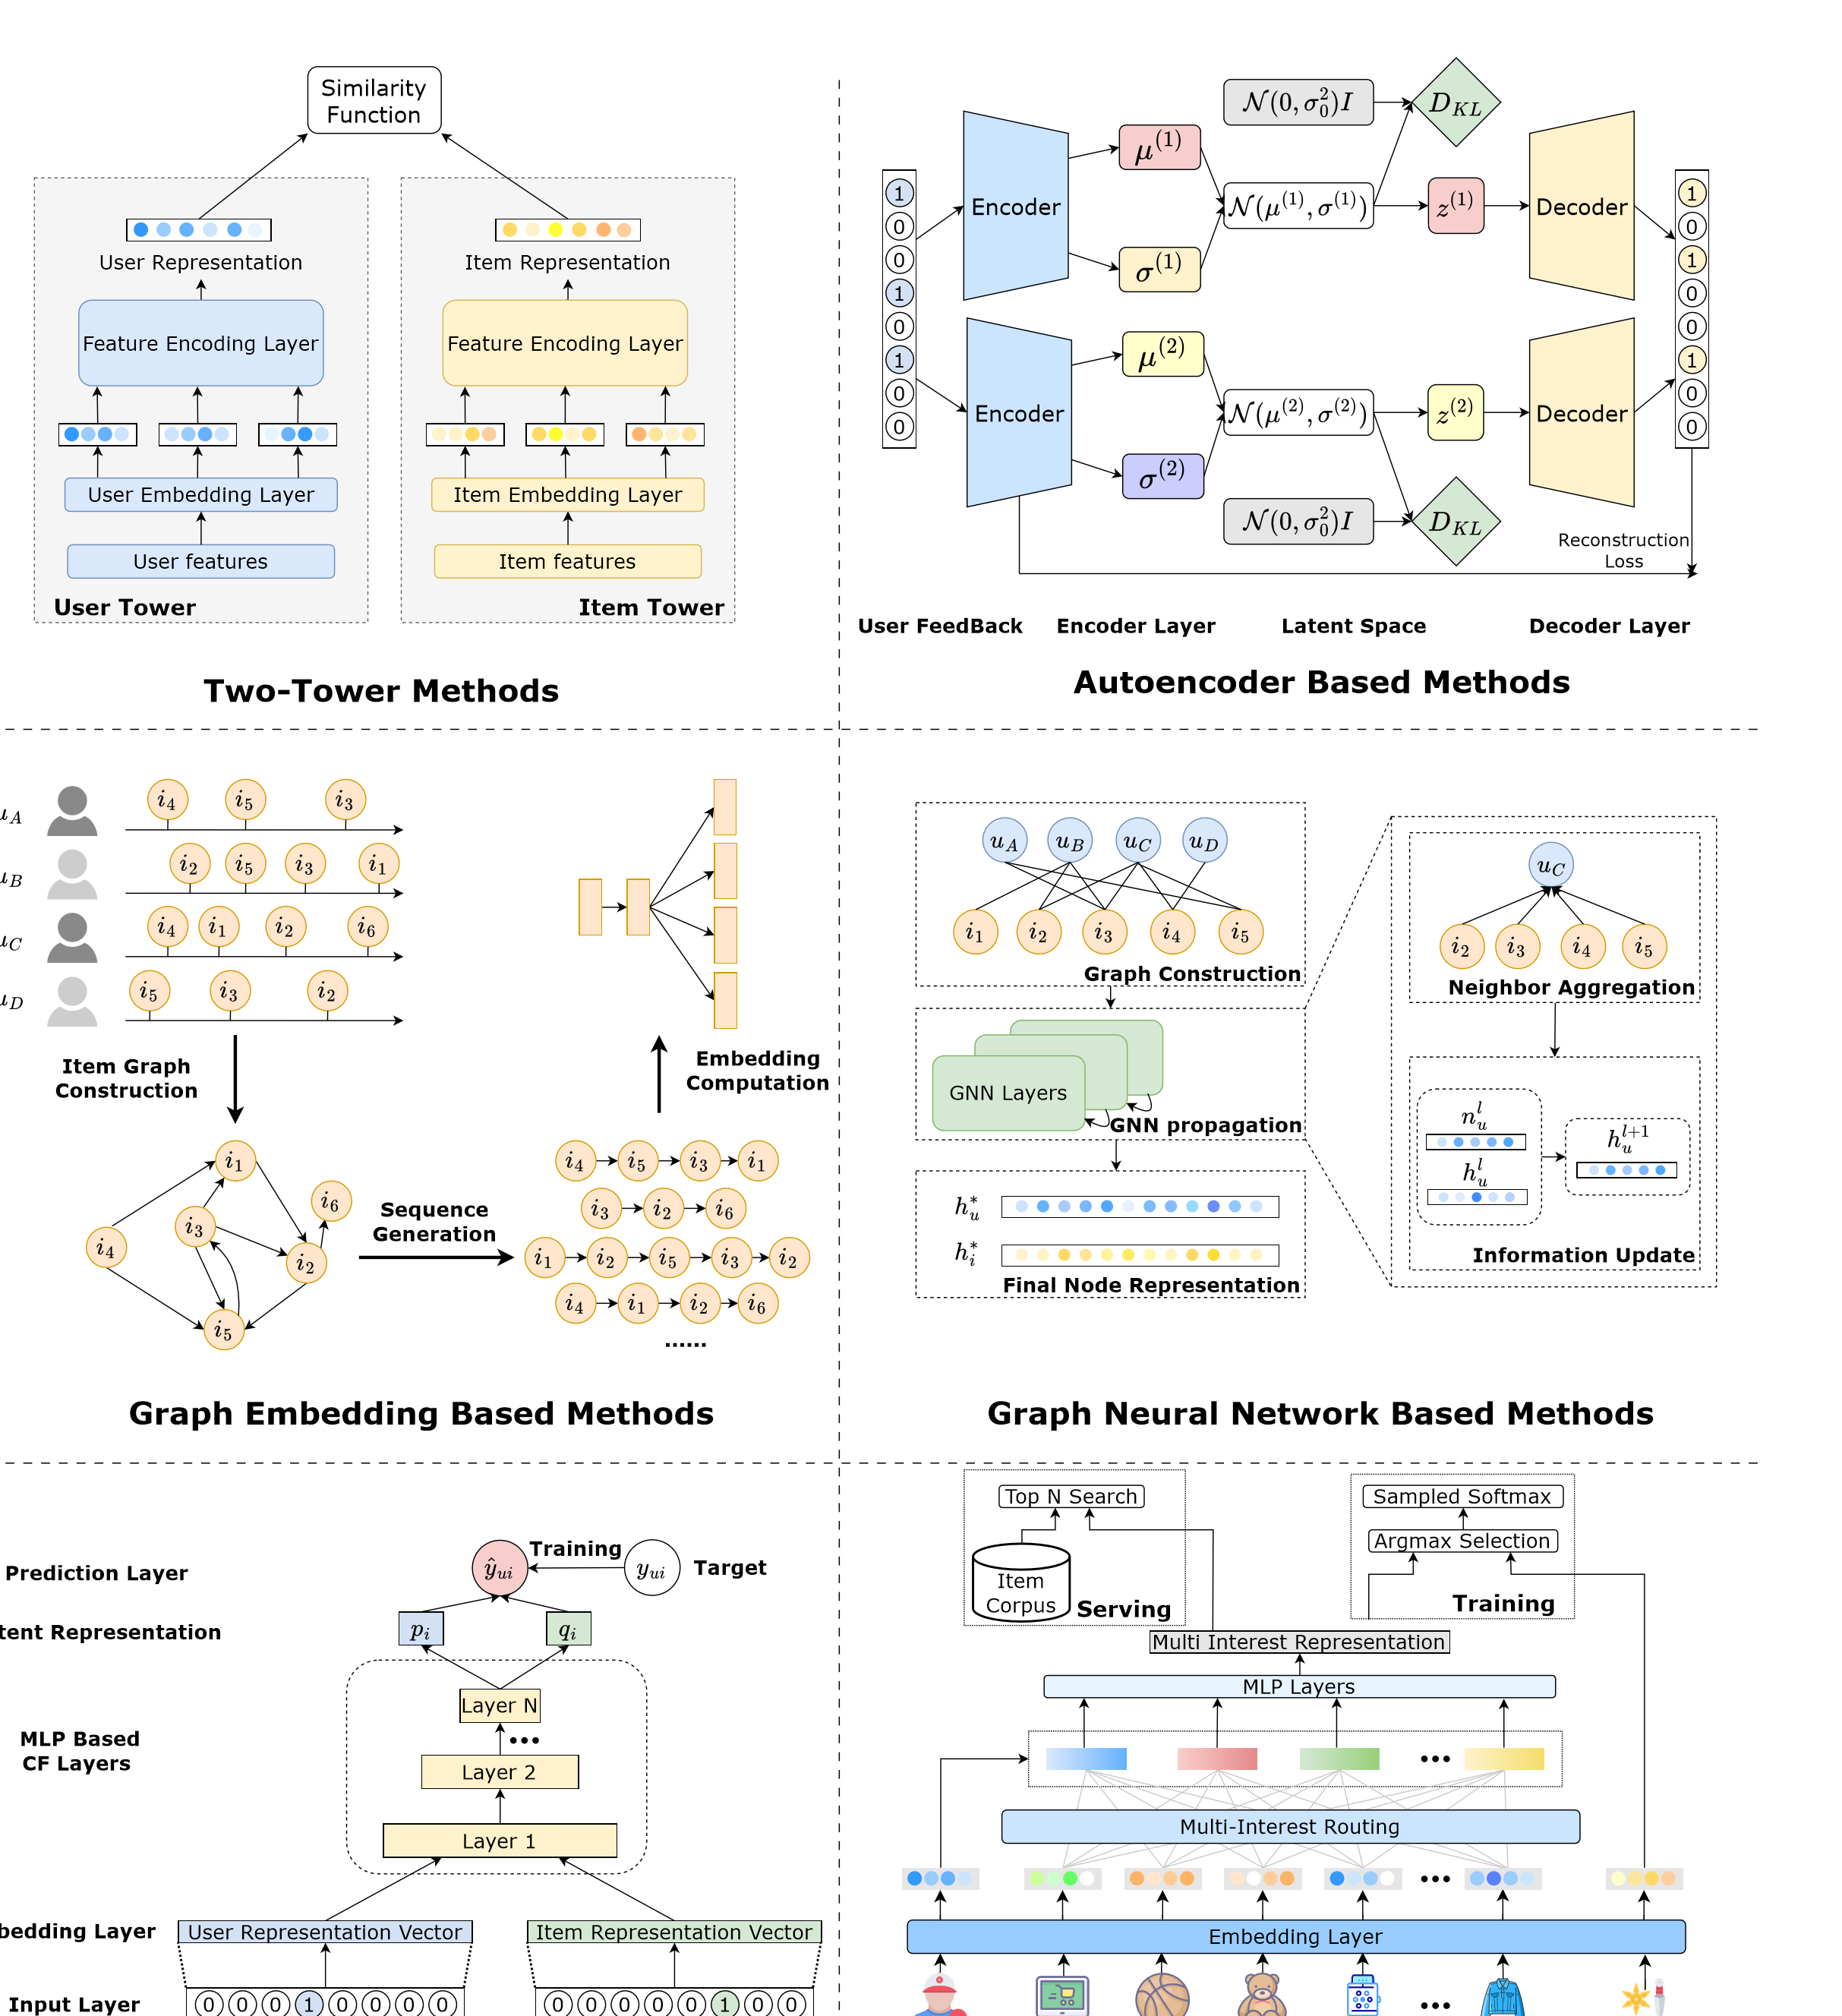
图 5|原文 Figure 5(第 13 页):六类深层相似度学习的网络结构对照
§5 单独讲索引:全库暴力计算是精度天花板;近似最近邻(ANN)用一点精度换量级,论文点名工业界常用的 Faiss、Milvus、ScaNN 及其中的 HNSW、IVFPQ 索引,并提醒这类索引构建要跑聚类等耗时流程;树形索引(如 TDM)把物品层次化展开,预测计算量只与物品池规模成对数关系,还能在模型内部让用户与候选物品交互,表达力更强------代价是与工程系统耦合更紧。
§6 讲训练。隐式反馈下没有可靠负样本,作者把做法分成两类:负采样 (细分静态、困难、对抗、图结构四种)与全数据策略(把未观测项全当负样本但给更低权重,并按物品热度调整)。目标函数一节列了采样 softmax、NCE 与成对 margin hinge 损失。§7 汇总评价口径:离线是 Recall@K、Precision@K、F1@K、Hit Rate、AP/MAP 一族,线上 A/B 是 CTR、CVR、RPM、GMV,两组指标不同源。
IV 实验结论
§8 用 RecBole 的官方最优超参,在 MovieLens-1M、Amazon-Book、Yelp2018 上横向比较了 11 种方法(另设随机与热门基线)。后两个数据集做了 10-core 过滤;每个用户的交互按 8:2 划分训练与测试,训练集内再抽 10% 作验证;指标取 HitRate@K 与 Recall@K,MovieLens-1M 用 K=50,另两个用 K=100。结果值得反复读:
| 数据集 | 最优方法 | 方法类别 |
|---|---|---|
| MovieLens-1M | RecVAE | 自编码器 |
| Amazon-Book | ItemKNN | 传统邻域 CF |
| Yelp2018 | SGL | 图自监督 |
在电影评分上夺冠的是自编码器,在图书上夺冠的是最朴素的 ItemKNN。作者的结论是"没有任何一类模型在所有数据集上稳定占优,召回方向仍然开放"。对投稿人而言,这句话既是鼓励,也是要求:只报一个数据集的结果说服力有限。
V 工业实践
§8.4 汇总了各家论文自报的线上收益(节选):
| 方法 | 对比基线 | 线上提升 |
|---|---|---|
| Swing | 物品协同过滤 | CTR +9.3%,CVR +17.6%,PPM +20.3% |
| EGES(淘宝) | 此前物品 CF 方案 | CTR +1.30% |
| PinSage(Pinterest) | 此前线上方法 | Repin Rate +10%~30% |
| TDM(淘宝) | 此前线上方法 | CTR +2.1%,RPM +6.4% |
(表中基线均为各论文自述的"此前所用方法",指标口径互不相同,只能横向感受量级。)
§9 的案例最有参考价值:招商银行信用卡"掌上生活"App,数百万日活、每天数十亿条隐式反馈日志,召回层同时跑七路------3 路近线 I2I(Word2Vec、Node2Vec、DSSM)、1 路离线 U2I(Node2Vec)、3 路统计规则(Popular、User Tag-Based Popular、New and Niche Item)。
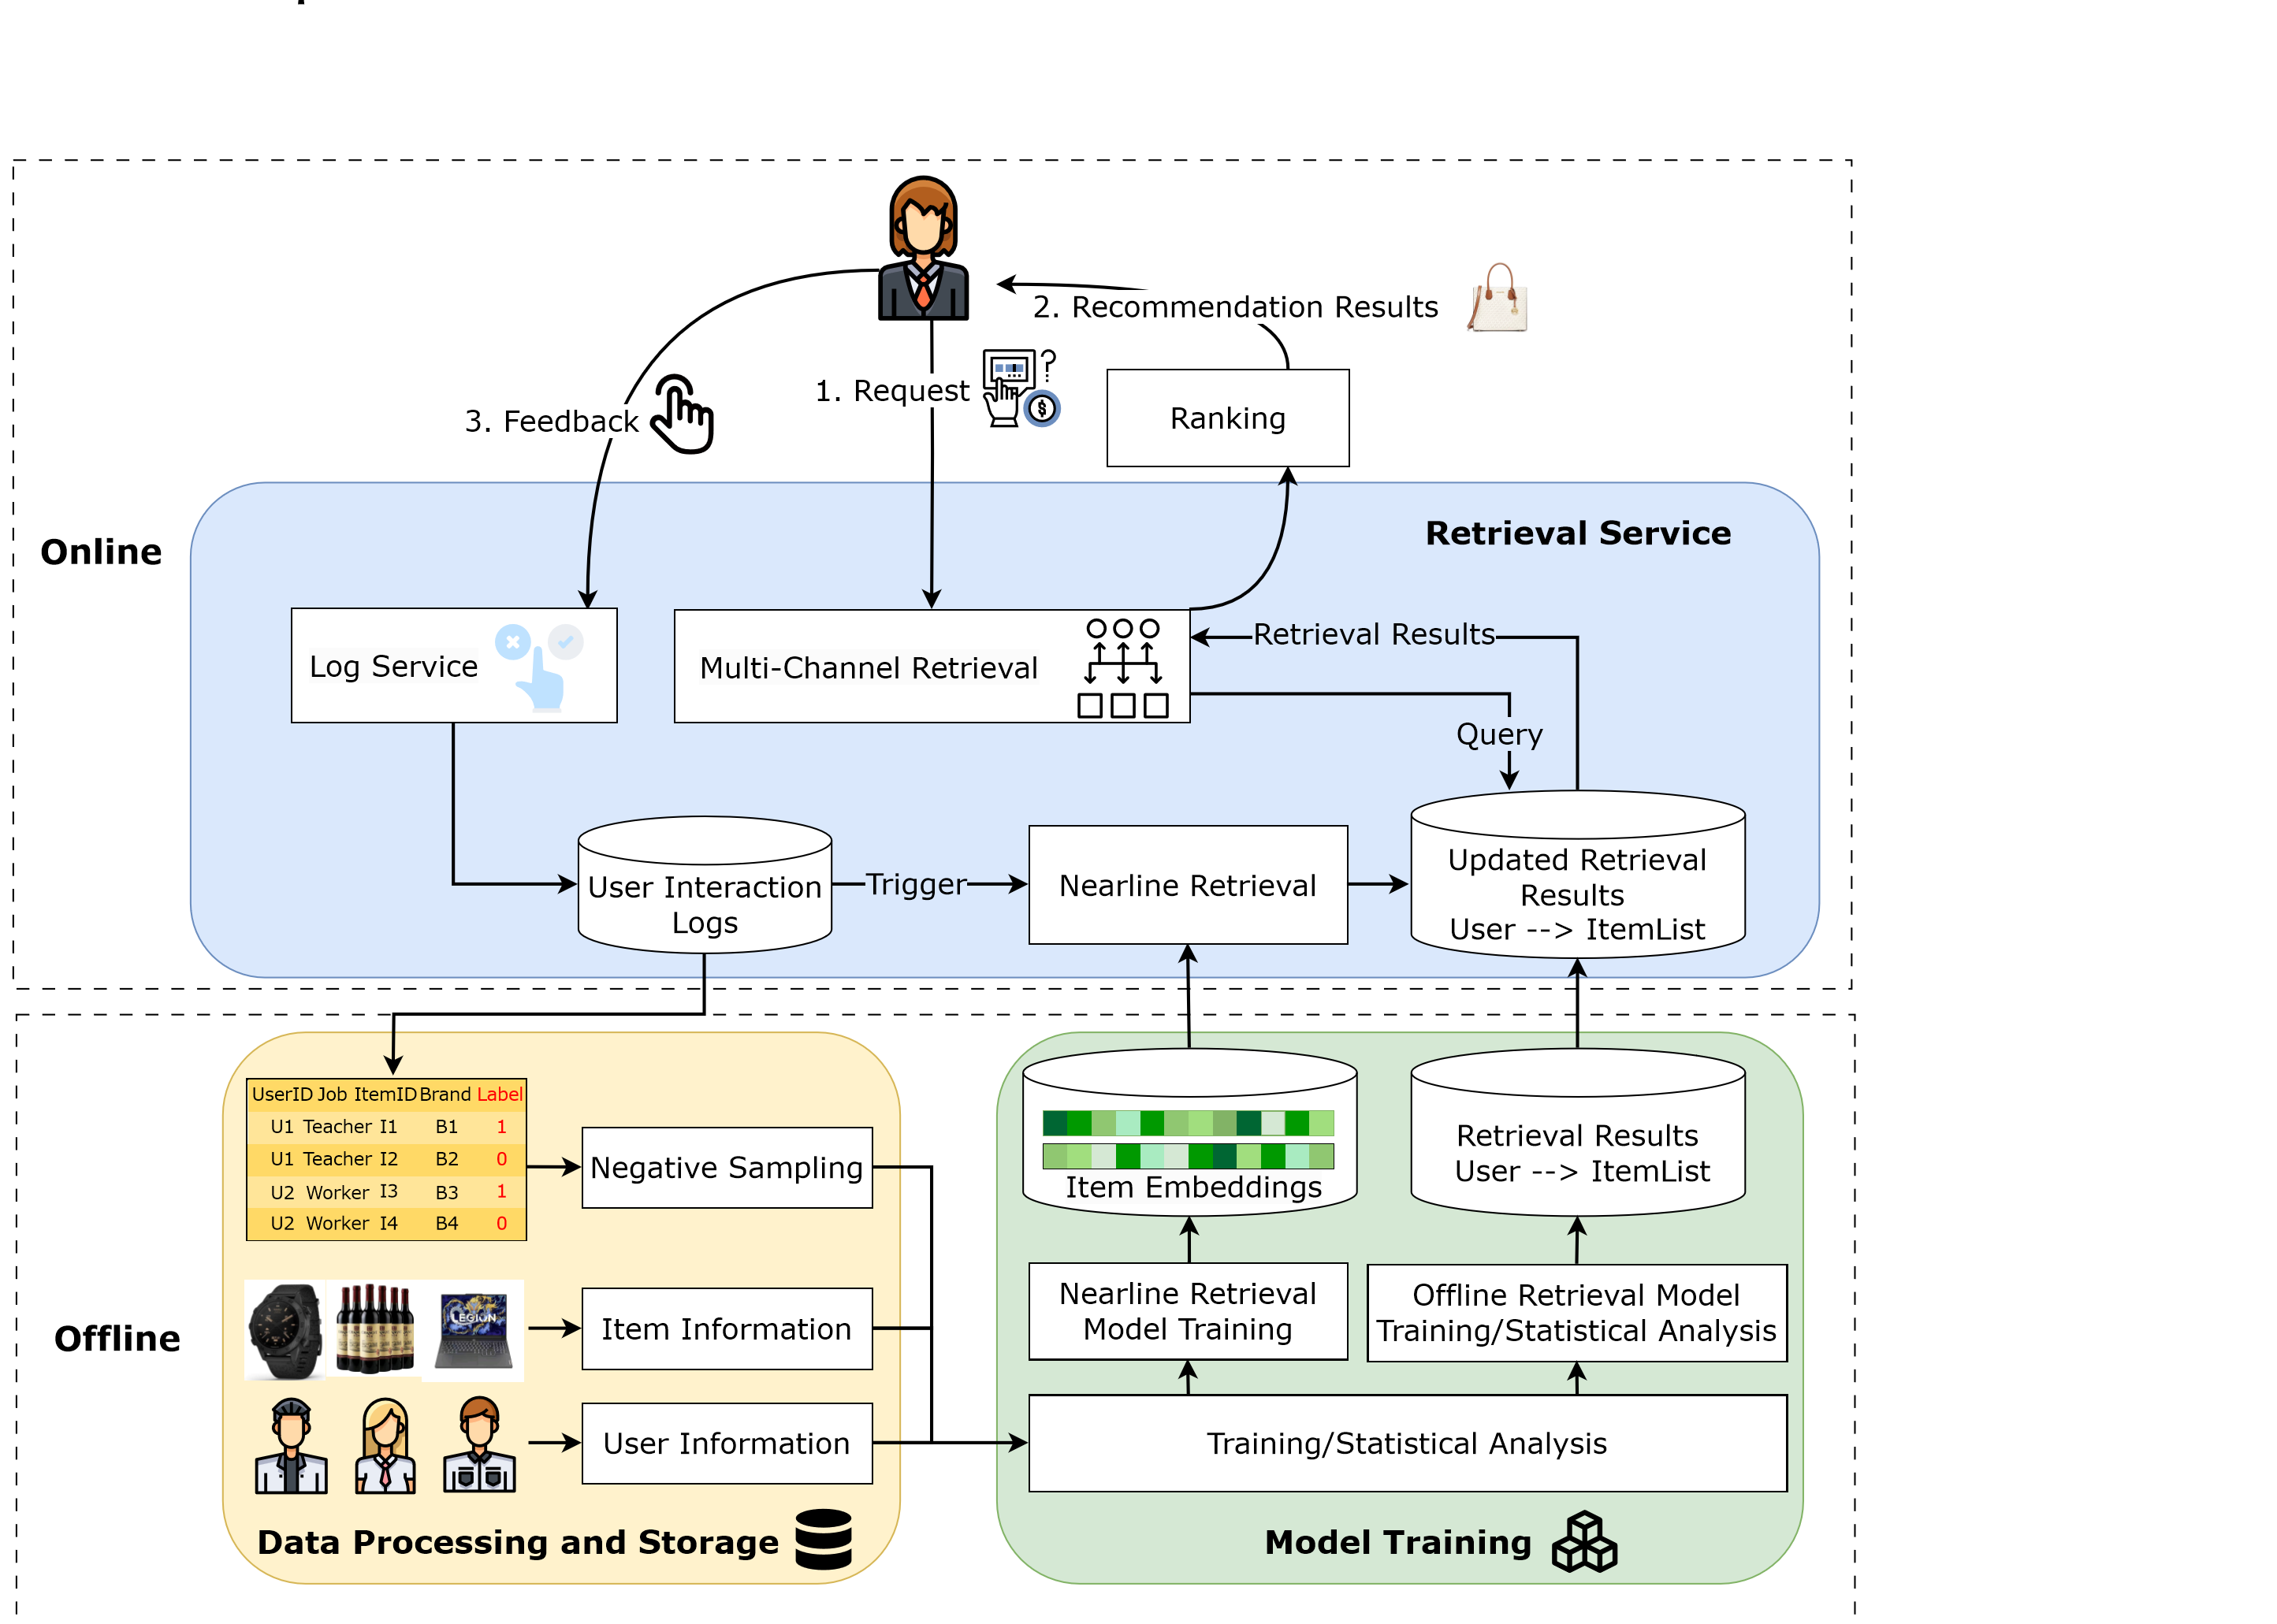
图 6|原文 Figure 6(第 27 页):掌上生活 App 召回管线的在线与离线两部分
图 6 把管线拆成 Online 与 Offline 两半:在线是请求---多通道检索---排序---反馈的闭环,离线做数据处理、负采样、表示训练与近线索引更新再推回线上。这种"在线轻、离线重、近线补"的分工,比任何口号都更能说明召回是个系统工程。
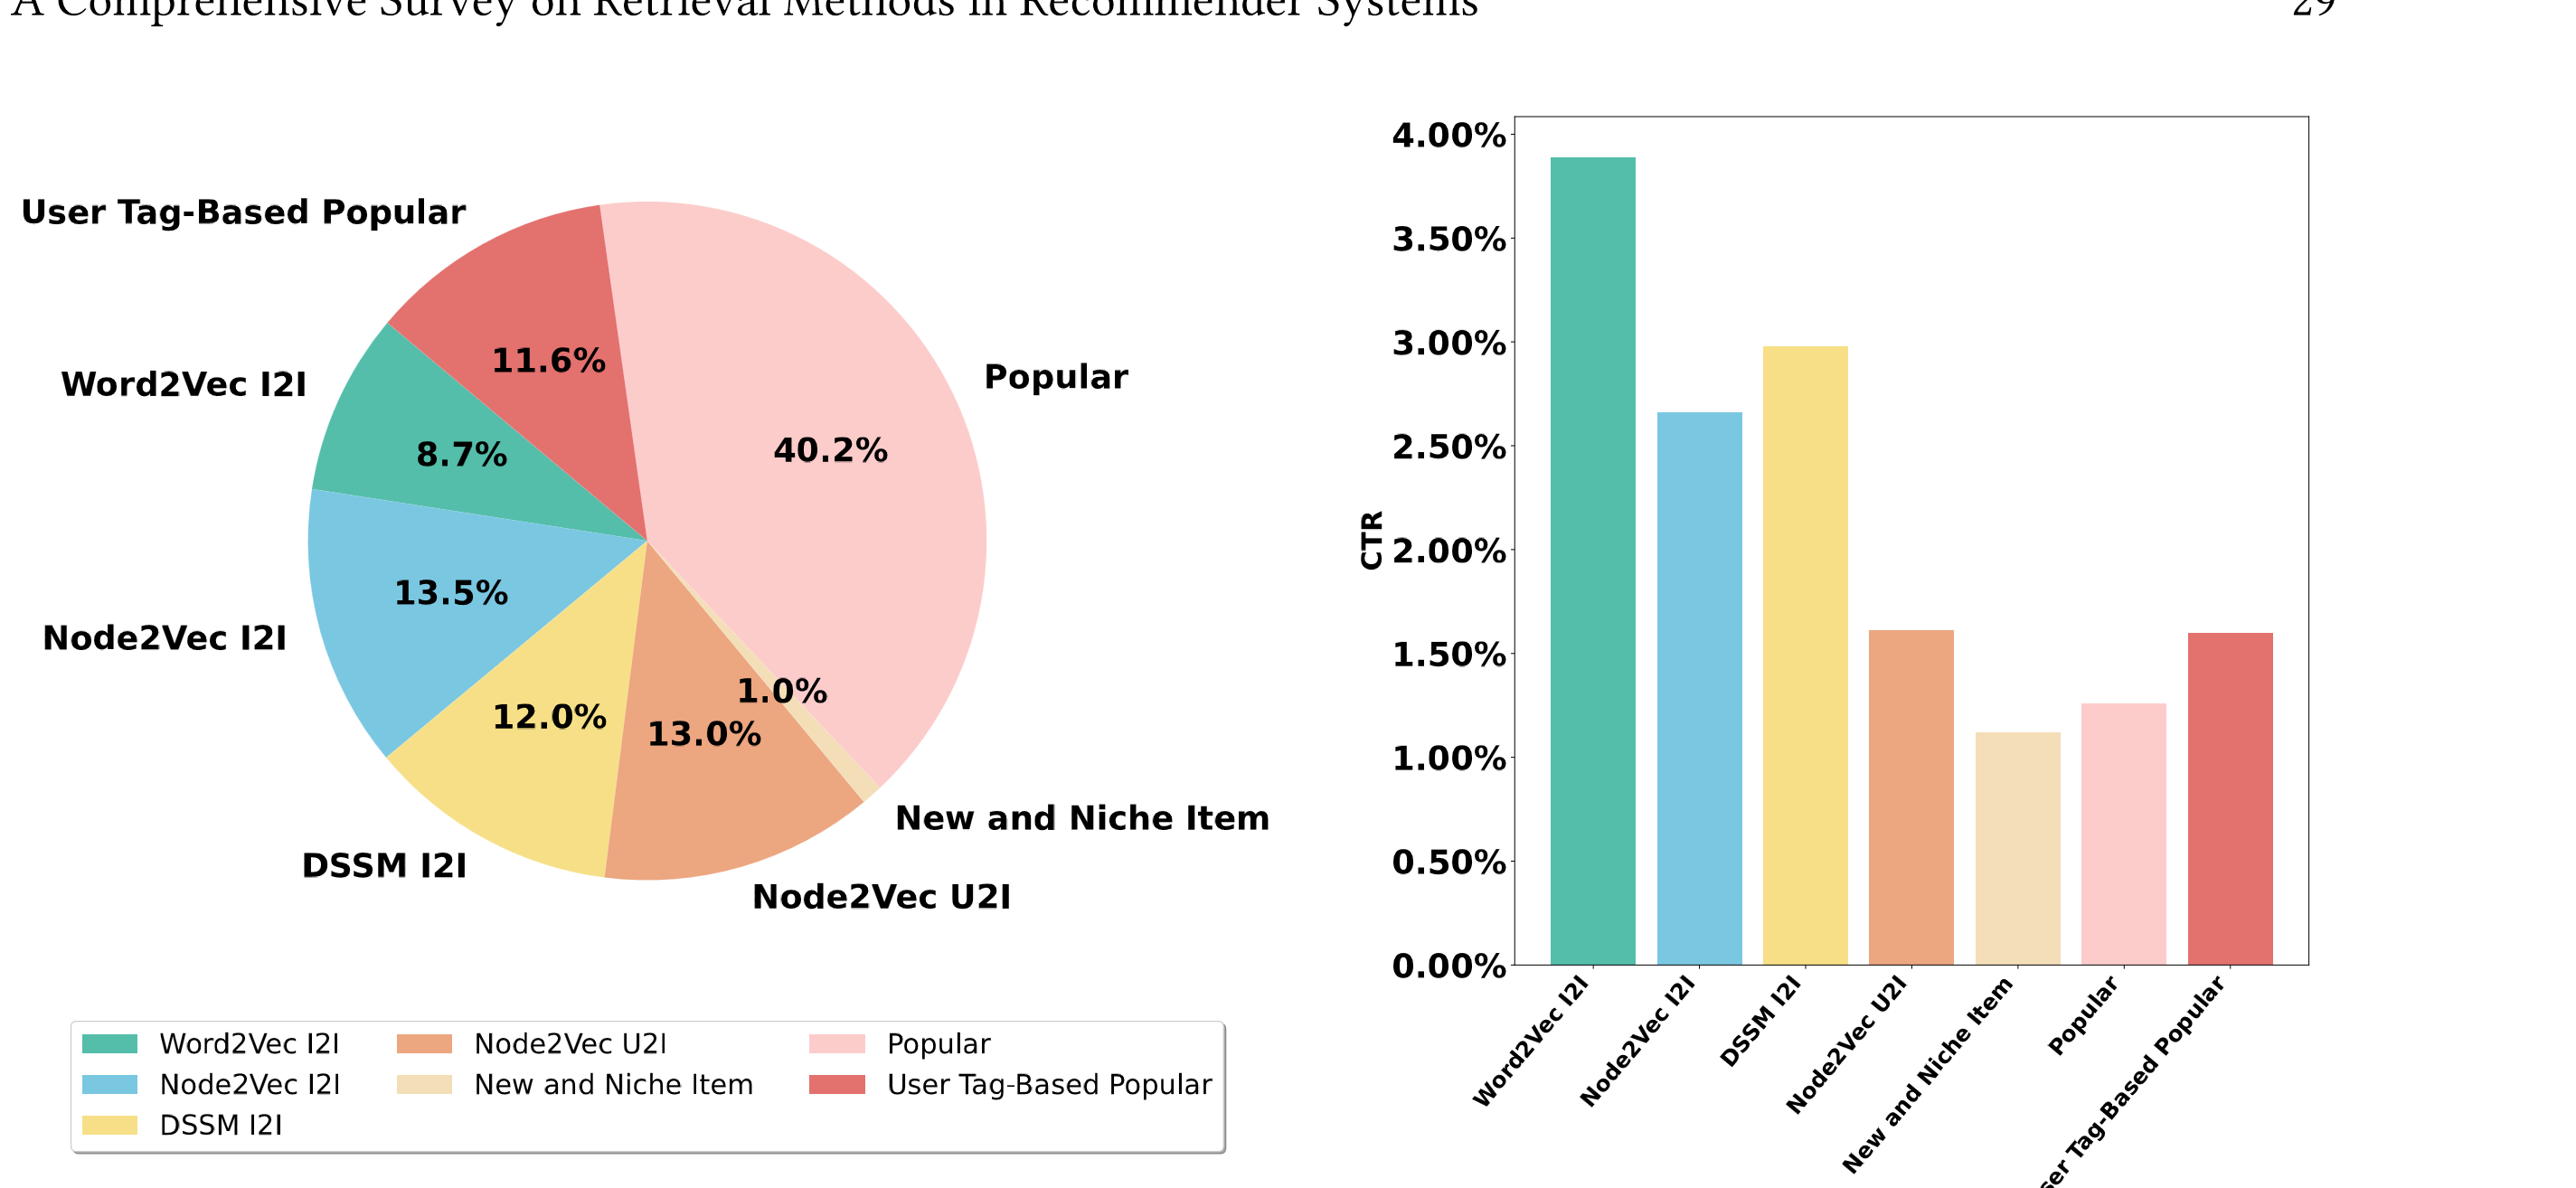
图 7|原文 Figure 7(第 29 页):(a) 各召回通道的占比,(b) 各通道的点击率
两个细节值得注意。其一,Popular 单通道占比 40.2%,热门类补充层合计约五成------用户中不活跃者众,模型召回凑不满配额时需要兜底;而图 7(b) 各通道的点击率高低与占比大小并不一致,说明配额并非按效果线性分配。其二,融合手段在作者看来仍很粗糙:调各通道配额、行业常用的 snake-merge 交替取数都属"原始方法",更好的多通道融合是明确待解的问题。
§9.3 的经验里最值得记住三条:负样本的构造方式与采样比例要像超参一样专门调;召回不直接对 CTR/CVR 负责,离线与线上指标会背离,最终要靠线上实验定夺;多通道并行是提升召回覆盖率的根本手段。
VII 小结
这篇综述的价值不在提出新模型,而在把召回的问题边界、方法分类、索引约束、训练细节与线上代价串成一张完整的图。三点提示:换模型之外要交代索引与延迟,否则"能不能上线"无法回答;召回的离线指标与业务指标不同源,跨数据集比较需谨慎。